حوّلنا Claude Code وCodex وHermes وPi و@opencode وأدوات برمجة أخرى إلى بيئات تعلّم معزّز (RL). دون أي تغييرات على الأدوات، دون أي تغييرات على كود التدريب. أي نموذج مفتوح، أي مجموعة مهام، مفتوح المصدر بالكامل أيها الأصدقاء!
النموذج نفسه، الأوزان نفسها: 62% تحت Mini-SWE-Agent، و33% تحت Claude Code. لكن التدريب داخل أداة حقيقية يعني عادةً إعادة تنفيذها كبيئة، لذا يُدرَّب معظم النماذج في هيكل لا يُشحن فعلياً لأحد.
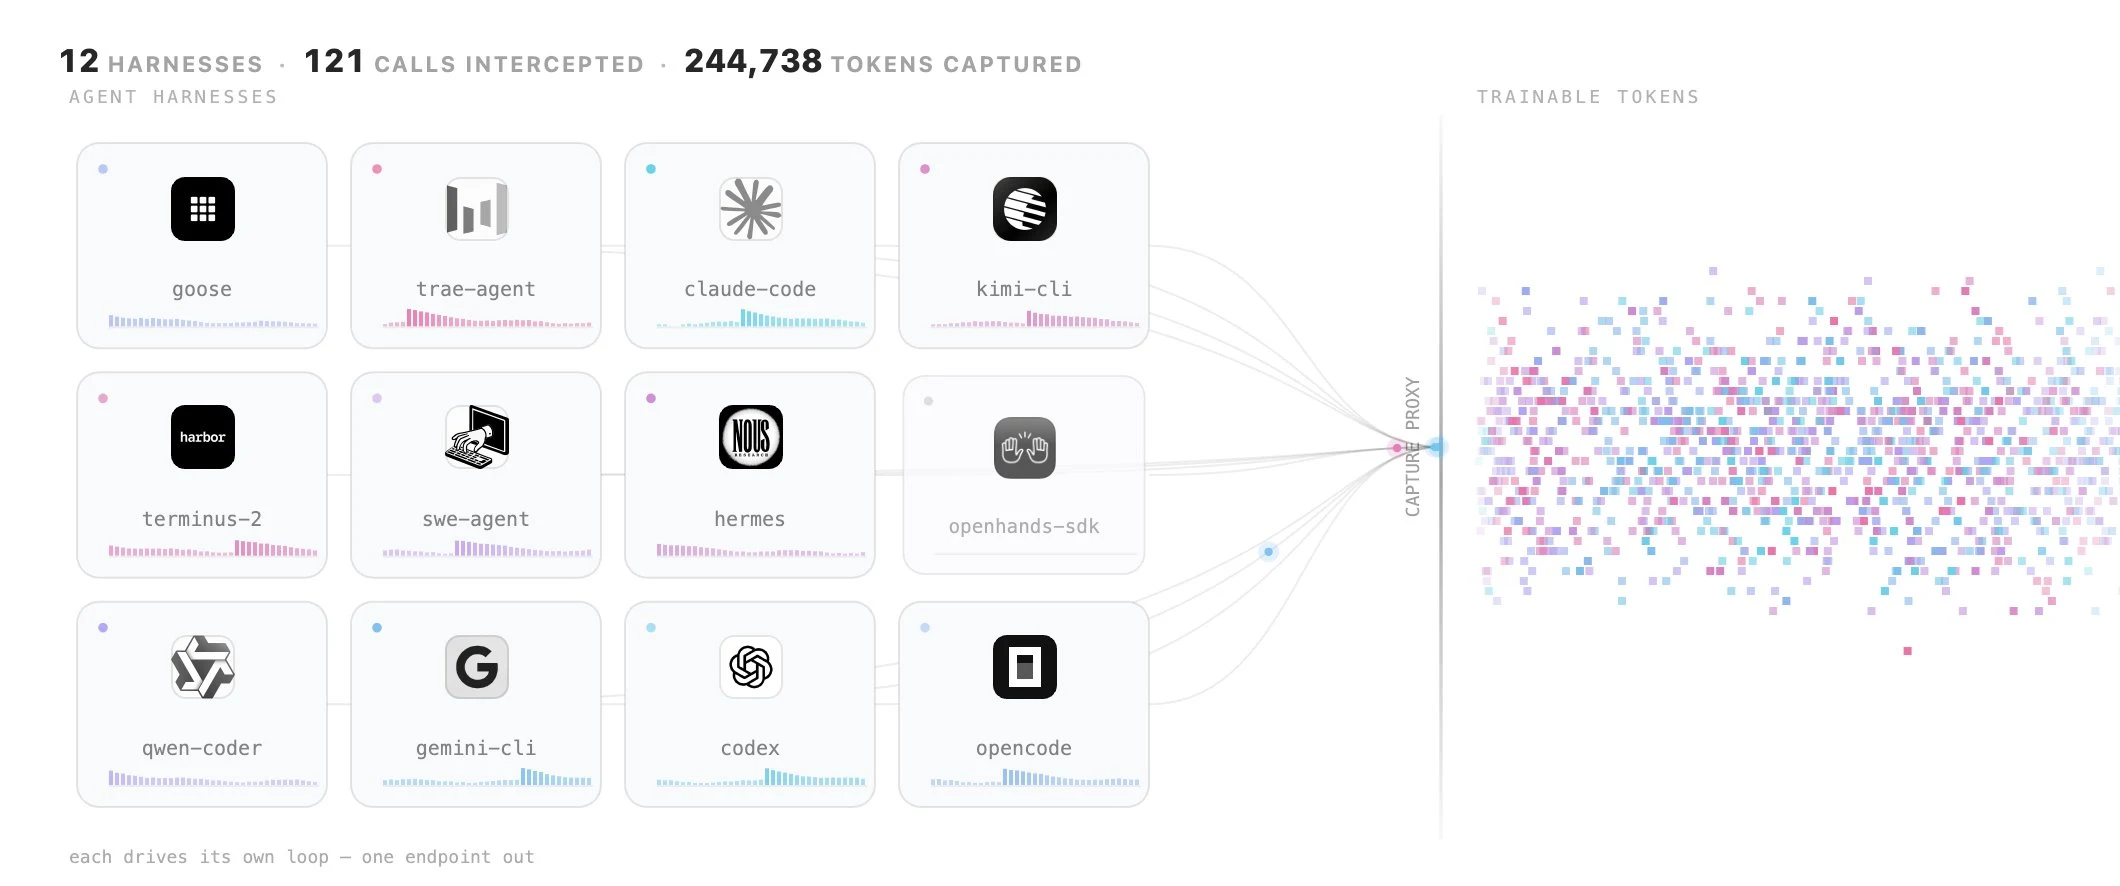
الحل هو وسيط (proxy)، لا إعادة كتابة. الأداة تظن أنها تتحدث مع واجهة برمجة نموذج. هي في الواقع تتحدث مع وسيط التقاط يتحدث بالصيغ الـ4 التي تستخدمها وكلاء البرمجة (OpenAI Chat Completions وOpenAI Responses وAnthropic Messages وGemini)، ويعيد التوجيه إلى @vllm_project، ويسجّل معرفات الرموز (token IDs) والـ logprobs الدقيقة التي أخذها vLLM بالعينة، ويسلّم TRL تسلسلات يمكنه التدريب عليها. تصبح الأداة هي البيئة. مرّت عبرها اليوم 10 أدوات، دون تعديل أي منها.
وبما أنك تتحكم في المكافأة، يمكنك تشكيل سلوك لم تطلبه الأداة قط. أضفنا مكافأة صغيرة لحل مهمة بعدد أقل من نداءات الأدوات: على المهام التي كان قد حلّها أصلاً، يستخدم النموذج الآن نداءات أقل بنسبة 31%، في كل أداة، ونحو النصف تحت Codex.
تم اختباره على LFM2.5-2.6B من @liquidai:
→ التدريب في أداة واحدة: تحسّن في الغالب في تلك الأداة (OpenCode من 34% إلى 58%).
→ التدريب في 4 أدوات دفعة واحدة: تحسّن في الـ4 جميعاً (من 42% إلى 54%).
→ SFT بدلاً من ذلك على 3,189 من عمليات التشغيل (rollouts) من Qwen3.8-27B: يثبّت عند 47.5%، دون كلا التدريبين بالتعلم المعزّز.
كل شيء مفتوح وقابل لإعادة الإنتاج: وسيط التقاط في OpenEnv، والمدرّب في TRL، والمهام، وبيانات SFT، وكود التدريب، وجميع النماذج الـ7 المدربة. نماذج أكبر وتجارب أكبر لاحقاً.
الدليل الكامل: https://huggingface.co/spaces/FineEnvs/multi-harness-rl