
التحدي الحاسم الذي يبرز مع انتقال أنظمة الوكلاء المتعددين من التجريب إلى الإنتاج هو ضمان أن تكون هذه الأنظمة مفيدة ودقيقة وقابلة للتفسير باتساق في السيناريوهات الواقعية. تتبنى المؤسسات بشكل متزايد أنظمة الوكلاء المتعددين لحل مشكلات واقعية معقدة تتطلب التفكير عبر مصادر البيانات والأدوات وقيود الأعمال. من تخطيط سلاسل الإمداد إلى التحليل المالي وعمليات خدمة العملاء، تتجاوز هذه الأنظمة الإجابة البسيطة عن الأسئلة. فهي تنسق بين عدة وكلاء متخصصين لاتخاذ القرارات وتنفيذ سير العمل وتوليد توصيات قابلة للتنفيذ.
بينما تستطيع النماذج اللغوية الكبيرة توليد استجابات سلسة، تتطلب تطبيقات المؤسسات ضمانات أعمق بكثير، حيث يجب على الوكلاء اتباع التعليمات بموثوقية، واختيار الأدوات الصحيحة، واحترام القيود، وتقديم تفكير واضح خلف مخرجاتهم.
Amazon Bedrock AgentCore هي منصة لبناء الوكلاء وربطهم وتحسينهم على نطاق واسع، مع أي إطار عمل أو نموذج. Amazon Bedrock AgentCore Evaluations، وهي إمكانية من Amazon Bedrock AgentCore، مصممة لمواجهة هذا التحدي كقدرة مُدارة بالكامل لتقييم أداء الوكلاء عبر التطوير والإنتاج، بحيث تستطيع الفرق قياس الدقة ونجاح المهام والسلوك عبر أبعاد جودة متعددة. أساليب التقييم التقليدية التي تركز فقط على جودة استجابة النموذج غير كافية للأنظمة الوكيلة، حيث تعتمد الصحيح على اختيار الأدوات وتنفيذ سير العمل والالتزام بقيود الأعمال. إضافة إلى التقييم، يتطلب النشر الإنتاجي للأنظمة الوكيلة ضوابط للذكاء الاصطناعي المسؤول. Amazon Bedrock Guardrails يوفر ضمانات قابلة للتهيئة مثل تصفية المحتوى وكشف المواضيع المحظورة والتحقق من التأسيس، وهي تكمل إطار التقييم. بينما تقيّم Evaluations جودة الوكيل بعد التنفيذ، تفرض Guardrails قيود السلامة أثناء التنفيذ. في هذه المقالة، نركز على تشغيل إطار التقييم هذا بدعم Amazon Bedrock AgentCore Evaluations لكل من المقيمين المدمجين والمقيمين المخصصين. تقدم المقيمون المدمجون تقييمات معرّفة مسبقًا لأبعاد الجودة الشائعة مثل الفائدة ونجاح المهام واتباع التعليمات، بحيث تستطيع الفرق بسرعة إنشاء خط أساس لأداء الوكيل دون إعداد إضافي. ومع ذلك، تتطلب حالات استخدام المؤسسات تحققًا أعمق ومتخصصًا حسب المجال. يعالج المقيمون المخصصون ذلك، بحيث يمكنك تعريف فحوصات واعية بالأعمال.
نركز أيضًا بشكل خاص على قابلية التفسير كبُعد تقييم من الدرجة الأولى. نوضح كيف يمكن للمقيمين المدمجين تقييم وضوح الاستجابة العام. نعرض كيف يُستخدم المقيمون المخصصون للتحقق من أن الوكلاء يوضحون صراحة مبررات القرار، ويشيرون إلى البيانات الداعمة أو مخرجات الأدوات، ويشرحون المقايضات مثل التكلفة مقابل مستوى الخدمة. ومن خلال دمج هؤلاء المقيمين، نبيّن كيف يمكن لـ AgentCore Evaluations تجاوز جودة الاستجابة السطحية وتقديم رؤى منظمة وقابلة للقياس حول كيفية وصول الوكلاء إلى قراراتهم ولماذا.
لجعل هذه المفاهيم ملموسة، تستعرض الأقسام التالية بنية مرجعية وتنفيذًا يوضحان كيف تعمل هذه المكونات معًا عمليًا.
نظرة عامة على الحل
في هذه المقالة، نستخدم شركة تجزئة عالمية خيالية تدعى AnyCompany Retail، وهي بائع تجزئة متعدد الجنسيات يشغّل قنوات التجارة الإلكترونية ومراكز تنفيذ إقليمية ومراكز توزيع وآلاف المتاجر الفعلية. تواجه AnyCompany اختلالات متكررة في المخزون: بعض المناطق تواجه نفاد المخزون أثناء العروض الترويجية، بينما تحمل مناطق أخرى مخزونًا فائضًا. يجب أيضًا على فرق النقل الموازنة بين سرعة التسليم وطاقة الناقل والتكلفة. تريد الشركة مساعدًا وكيلًا يمكنه مساعدة المخططين في تحسين تخصيص المخزون، والتوصية بتعديلات التوزيع، وتحليل صحة المخزون، ومحاكاة سيناريوهات التوجيه أو التنفيذ.
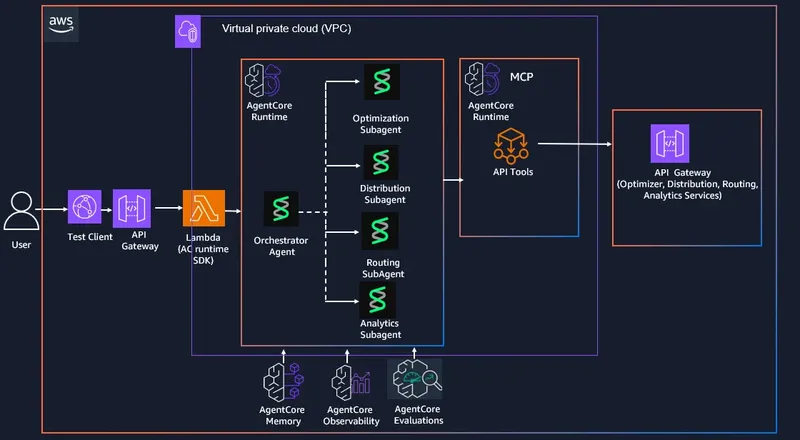
ستقوم ببناء وتقييم نظام قرار سلاسل إمداد متعدد الوكلاء باستخدام Strands Agents SDK, Amazon Bedrock AgentCore MCP Server وAmazon Bedrock AgentCore Evaluations. يستخدم الحل Strands Agents مع وكيل منسق وأربعة وكلاء فرعيين متخصصين: وكيل تحسين، ووكيل توزيع، ووكيل توجيه، ووكيل تحليلات. يعمل كل وكيل على Amazon Bedrock AgentCore runtime مع تفعيل Amazon Bedrock AgentCore memory و Amazon Bedrock AgentCore Observability .
يتلقى وكيل المنسّق طلب الوكيل المخطِّط ويفوّض العمل إلى وكلاء متخصصين مكشوفين كأدوات. يستدعي وكيل التحسين أدوات MCP مدعومة بواجهات REST وهمية عبر Amazon API Gateway تُعيد قرارات التحسين. يستدعي وكيل التوزيع واجهات برمجة التطبيقات الخاصة بالتوصيات لاقتراح إعادة موازنة المخزون عبر مراكز التنفيذ والمتاجر والقنوات الرقمية. يستدعي وكيل التوجيه واجهات برمجة تطبيقات الخدمات اللوجستية للتوصية بخيارات شركات النقل والمسارات، ويجيب وكيل التحليلات على أسئلة تشخيص سلسلة التوريد. يستخدم هذا الحل النماذج الأساسية على Amazon Bedrock لحلقة الوكيل. لمعرفة توفر النماذج حسب المنطقة، راجع النماذج المدعومة حسب منطقة AWS في Amazon Bedrock.
يستخدم الحل مقيّمين مدمجين يقيّمان أبعاد الجودة العامة مثل المفيدة وإتمام المهمة. كما يوفر مقيّمين مخصصين يقيّمان السلوك الخاص بسلسلة التوريد مثل الالتزام بالقيود وجدوى المسار وصحة SQL وسلامة المخزون وجودة الشرح. ويمكن لشركة AnyCompany تقييم جودة اللغة في الاستجابة وصلاحية قرار الوكيل من الناحية التجارية معاً.
يدعم الحل كلاً من الوضع عند الطلب والوضع عبر الإنترنت مع Amazon Bedrock AgentCore Evaluations. الوضع عند الطلب مخصص لقياس الأداء أثناء التطوير، واختبارات الانحدار، وبوابات التكامل المستمر والتسليم المستمر (CI/CD). أما الوضع عبر الإنترنت فهو للمراقبة والتنبيهات المستمرة في بيئة الإنتاج. يساعدك كلا الوضعين على إغلاق الحلقة والتصرف بناءً على ملاحظات مستخدميك. تُعاد استخدام نفس المقيّمين المخصصين (مثل مقيّمي الالتزام بالقيود وجدوى المسار وصحة SQL وقابلية الشرح من حل سلسلة التوريد الخاص بك) المستخدمين في التقييمات عند الطلب مع كائن OnlineEvaluationConfig يشير إلى أسماء موارد Amazon (ARNs) الخاصة بالمقيّمين ويحدد معدل أخذ العينات (على سبيل المثال، 1–10% من آثار الإنتاج) إلى جانب عوامل تصفية اختيارية للجلسات. ثم تقرأ الخدمة الآثار تلقائياً من AgentCore Observability، وتقيّمها وتبث النتائج إلى لوحات وتنبيهات Amazon CloudWatch . في هذه المقالة، ستستخدم الوضع عند الطلب لاختبار الحل.
يوضح مخطط البنية التالي المكونات المختلفة لحلنا.
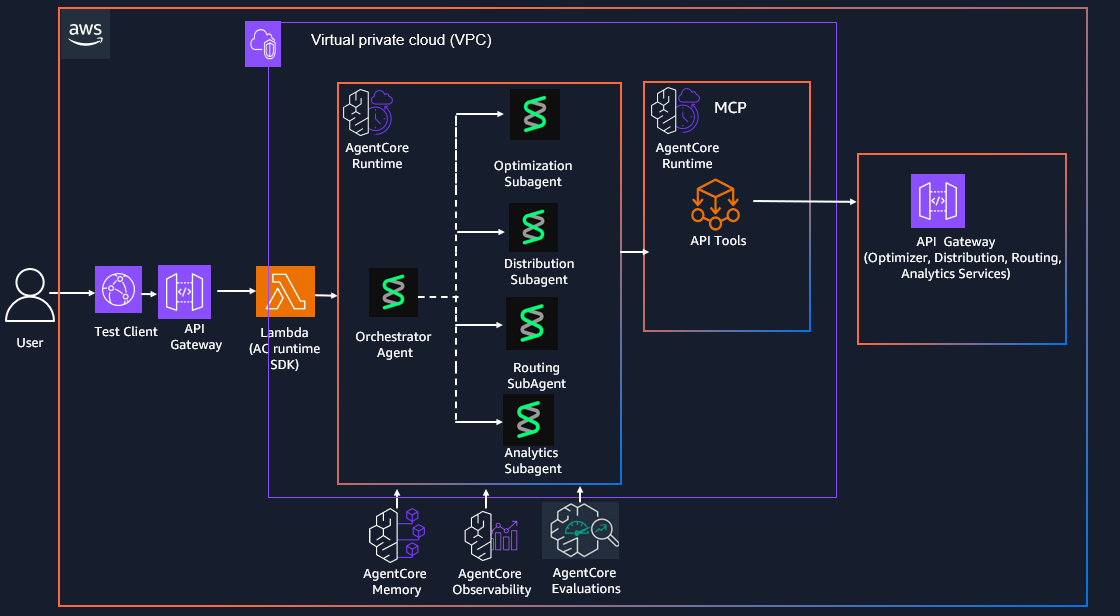
الشكل 1: بنية حل صنع القرار متعدد الوكلاء لسلسلة التوريد
إطار التقييم
في هذه المقالة، ستستخدم منهج تقييم من ثلاث طبقات للأنظمة متعددة الوكلاء يبني تدريجياً ثقة المؤسسة. يتبع هذا المنهج تدرجاً واضحاً بدءاً من المقيّمين المدمجين للجودة العامة، ثم إضافة مقيّمين مخصصين لدقة الأعمال، وأخيراً إضافة مقيّمي قابلية الشرح لتحقيق الثقة وقابلية التدقيق.
تستخدم الطبقة الأولى مقيّمين مدمجين لا يتطلبان أي إعداد. نطبق مقيّم المفيدة كخط أساس عالمي، بالإضافة إلى مقيّم ثانٍ خاص بكل وكيل يستهدف وضع الفشل الرئيسي لكل وكيل: دقة اختيار الأداة للمنسّق، وملاءمة الاستجابة للتحسين والتوزيع، واتباع التعليمات للتوجيه، والأمانة للتحليلات.
تضيف الطبقة الثانية مقيّمين مخصصين يرمّزون قواعد العمل الخاصة بالمجال: الالتزام بالقيود للتحسين، وترسيخ البيانات للتوزيع، وجدوى المسار للتوجيه، وصحة SQL للتحليلات، وتماسك الخطة للتنسيق. تتحقق هذه من الصلاحية التجارية: هل احترم التوصية حدود الميزانية، واستخدم بيانات مخزون حقيقية، وأنتج مخرجات صحيحة تشغيلياً؟
يعرض الجدول التالي المقيّمين المدمجين والمقيّم المخصص المختار لكل وكيل ستطبقهما هنا. يستهدف المقيّم المدمج الثاني وضع الفشل الرئيسي لكل وكيل، بينما يرمّز المقيّم المخصص قواعد العمل الخاصة بالمجال التي تتحقق من الصحة التشغيلية.
| الوكيل | المقيّمون المدمجون | المقيّمون المخصصون |
| وكيل المنسّق | المفيدة؛ دقة اختيار الأداة | مقيّم تماسك الخطة: هل جمع مخرجات الوكلاء الفرعيين في توصية صحيحة وغير متناقضة؟ مقيّم مسار الأداة: هل وجّه الطلب إلى الوكيل الفرعي الصحيح؟ |
| وكيل التحسين | المفيدة؛ ملاءمة الاستجابة | مقيّم الالتزام بالقيود: الميزانية، وتغطية المخزون (الطلب ≤ الكمية ≤ 2× الطلب)، وقيود سعة المستودع. مقيّم تحقيق مؤشرات الأداء الرئيسية (KPI): تحقيق هدف تحسين معدل التعبئة/الإيرادات. |
| وكيل التوزيع | المفيدة؛ ملاءمة الاستجابة | مقيّم رسوخ التوصية: التوصية مرتكزة على بيانات المخزون/الطلب الحالية. مقيّم أثر المخاطر: التوصية تقلل مخاطر نفاد المخزون/تكدسه. |
| وكيل التوجيه | المفيدة؛ اتباع التعليمات | مقيّم جدوى المسار: يحترم المسار نافذة التسليم والتكلفة وسعة الناقل وقيود المنطقة. مقيّم اتفاقية مستوى الخدمة (SLA): التسليم المتوقع يلبي مستوى الخدمة المستهدف. |
| وكيل التحليلات | المفيدة؛ الأمانة | مقيّم صحة SQL: يطابق الاستعلام نية المستخدم. مقيّم الأساس في البيانات: تكون الاستجابة مدعومة بنتائج استعلام Amazon Relational Database Service (Amazon RDS). مقيّم الادعاءات غير المدعومة. |
قابلية التفسير
تُطبّق الطبقة الثالثة من منهج التقييم لدينا مقيّمات قابلية التفسير كفحوصات مميزة وعابرة للوكلاء. وهي تقيّم بشكل مستقل ما إذا كان الوكلاء يوضّحون مبررات القرار، ويستشهدون بالأدلة الداعمة من مخرجات الأدوات، ويشرحون القيود التي شكّلت الاستجابة، ويوضّحون المقايضات بين الأهداف المتنافسة، ويوضّحون لماذا تم استدعاء وكلاء فرعيين محددين، ويكشفون الافتراضات عندما تكون البيانات غير مكتملة. من خلال فصل قابلية التفسير في طبقة تقييم خاصة بها، يمكننا قياس الشفافية بشكل مستقل. يمكن أن تكون التوصية دقيقة لكن غير قابلة للتفسير (تجتاز المقيّمات المخصصة لكنها تفشل في قابلية التفسير)، مما يمنح الفرق إشارات قابلة للتنفيذ حول ما إذا كان الوكلاء بحاجة إلى توضيح أفضل للاستدلال بدلاً من منطق قرار أفضل.
يحدد الجدول التالي مقيّمات قابلية التفسير الستة المستقلة التي تنفذها هنا والتي تُطبّق عبر الوكلاء كطبقة عابرة. وهي تقيّم ما إذا كان الوكلاء يوضّحون الاستدلال، ويستشهدون بالأدلة، ويشرحون القيود والمقايضات، ويكشفون الافتراضات. وتُقاس بشكل منفصل عن الدقة حتى يتمكن الفرق من التمييز بين الاستجابات الصحيحة غير القابلة للتفسير وتلك التي يُشرح جيداً لكنها خاطئة.
| المقيّم | الوكلاء | ما يفحصه |
| جودة مبررات القرار | الكل | هل شرح الوكيل لماذا قدّم التوصية؟ |
| إسناد الأدلة | Analytics، Distribution، Routing | هل استشهد بحقول البيانات أو استجابة API أو نتيجة SQL المستخدمة؟ |
| استدلال القيود | Optimization، Routing | هل شرح القيود التي شكّلت الاستجابة النهائية؟ |
| شرح المقايضات | Optimization، Distribution، Routing | هل شرح المقايضات بين التكلفة ومستوى الخدمة ومخاطر المخزون؟ |
| قابلية تفسير استخدام الأدوات | Orchestrator | هل شرح لماذا تم استدعاء كل وكيل فرعي أو أداة MCP؟ |
| الإفصاح عن الافتراضات | جميع الوكلاء | هل ذكر الافتراضات بوضوح عندما كانت البيانات غير مكتملة؟ |
المتطلبات الأساسية
قبل نشر هذا الحل، قم بإعداد بيئة التطوير لديك بالأدوات التالية.
- قم بتثبيت AWS Command Line Interface (AWS CLI)
- قم بتثبيت AWS Serverless Application Model (AWS SAM) CLI إصدار v1.100.0 أو أحدث
- قم بتثبيت Docker إصدار v20.x أو أحدث
- قم بتثبيت Node.js v18.x+
- التثبيت Python v3.11+
التبعيات
تتطلب أيضاً تنفيذات Strands Agents توفر التبعيات التالية المُدمجة في ملف DockerFile:
- strands-agents # إطار الوكلاء المتعددين Strands Agents
- strands-agents-tools # أدوات وأدوات مساعدة لوكلاء Strands
- requests # مكتبة HTTP لإجراء استدعاءات API
- bedrock-agentcore # وظائف Amazon Bedrock agent core
- boto3 # مجموعة تطوير AWS SDK للغة Python (Boto3)
نشر الحل وتشغيله
الحل متاح للتنزيل من مستودع GitHub الخاص بنا، ويوفر نشراً من خطوة واحدة لنشر الحل والوصول إليه في بيئة AWS لديك:
# Edit terraform.tfvars: set vpc_id and runtime_subnet_azs
cd terraform
cp terraform.tfvars.example terraform.tfvars
terraform init
terraform apply
تشمل المخرجات مُعرّفات ARN الخاصة بوقت التشغيل، ورابط URL الخاص بواجهة برمجة تطبيقات AnyCompany Retail، ورابط URL الخاص بواجهة برمجة تطبيقات المقيّم، ومُعرّف ARN الخاص بالذاكرة.
تشغيل الحل
اتبع هذه الخطوات لتشغيل الحل:
يحتوي مجلد test_client/ على سكربت بلغة Python يستدعي وكيل سلسلة التوريد المنشور بـ 20 استعلاماً نموذجياً (5 لكل وكيل فرعي) للتحقق من صحة الوظائف من البداية إلى النهاية. تُنفَّذ كل فئة كجلسة متعددة الأدوار، وتُطبع مُعرّفات الجلسات في النهاية لاستخدامها مع واجهة برمجة تطبيقات المقيّمات.
cd test_client
pip install -r requirements.txt
cd terraform
terraform output supply_chain_arn
تشغيل جميع الاستعلامات (20 إجمالاً، في 4 جلسات)
cd test_client
python test_agent.py --runtime-arn "<supply_chain_arn>" --region <your_region>
تشغيل فئات محددة من الوكلاء الفرعيين
#Only optimization queries (1 session, 5 turns)
python test_agent.py --runtime-arn "<supply_chain_arn>" --category optimization
#Only routing and analytics (2 sessions, 5 turns each)
python test_agent.py --runtime-arn "<supply_chain_arn>" --category routing analytics
يطبع عميل الاختبار كل استعلام والرد الكامل للوكيل. وفي النهاية يطبع مُعرّفات الجلسات لاستخدامها مع المقيّمات.
إنشاء التقييمات وتشغيلها
يحتوي مجلد test_evaluators/ على سكربتات لتشغيل التقييمات مقابل جلسات الوكيل. تُنفَّذ هذه التقييمات بشكل غير متزامن وتُحفظ النتائج كملفات markdown في S3.
يجب عليك أولاً استدعاء حل الوكلاء المتعددين لاتخاذ قرارات سلسلة التوريد كما هو موضح سابقاً لتوليد جلسات الوكيل مع التتبعات، وتدوين مُعرّفات الجلسات المطبوعة في نهاية تشغيل عميل الاختبار. وأخيراً، انتظر من 3 إلى 5 دقائق بعد تشغيل الحل لتنتشر التتبعات إلى CloudWatch.
cd test_evaluators
pip install -r requirements.txt
cd terraform
terraform output evaluators_api_url
إنشاء مقيّمات مخصصة
python test_evaluator.py --api-url "https://<evaluators-api-url>" createيقوم هذا الأمر بتسجيل المقيّمات المخصصة وطباعة مُعرّفاتها. احفظ هذه المُعرّفات لاستخدامها مع أمر التشغيل.
تشغيل التقييمات
مرّر قائمة مفصولة بفواصل من مُعرّفات المقيّمات (مخصصة أو مدمجة). يلزم وجود 1 على الأقل:
# Run custom + built-in evaluators
python test_evaluator.py --api-url "https://<evaluators-api-url>" run \
--agent-id "supply_chain_orchestrator_agent-<id>" \
--session-id "<session-id-from-test-client>" \
--evaluators " sc_optimization_constraint-<id>,sc_distribution_groundedness-<id>,Builtin.Correctness,Builtin.GoalSuccessRate"
تُعيد واجهة برمجة التطبيقات (API) الرمز 202 فوراً. تُحفظ النتائج بشكل غير متزامن في S3 عند:
s3://<amzn-s3-demo-agent-source-bucket>/evaluations/<session-id>/<timestamp>/EvaluationResults.mdحذف المقيّمات
python test_evaluator.py --api-url "https://<evaluators-api-url>" delete \
--evaluator-ids "sc_optimization_constraint-<id>,sc_distribution_groundedness-<id>"
تشغيل تقييم للتحسين
الآن وقد فهمت إطار التقييم ونشرت الحل، دعنا نستعرض تقييماً موجّهاً من البداية إلى النهاية لوكيل التحسين. توضح هذه الجولة كيفية الجمع بين مُقيّم مخصص لدقة الأعمال (الطبقة 2) ومقيّمات قابلية الشرح (الطبقة 3) لتقييم صحة قرارات التحسين وشفافيتها معاً.
الخطوة 1: تشغيل استعلامات التحسين
أولاً، استدعِ عميل الاختبار مع فئة التحسين فقط لتوليد جلسة موجّهة:
cd test_client
python test_agent.py --runtime-arn "<supply_chain_arn>" \
--category optimization \
--region <your_region>
يُشغّل هذا 5 استعلامات تحسين كجلسة متعددة الأدوار. يعالج الوكيل طلبات مثل «ما هو مستوى المخزون الأمثل للمنتج prod-001 خلال الـ 30 يوماً القادمة؟». يتطلب كل استعلام من وكيل التحسين استدعاء أدوات MCP، واسترداد توقعات الطلب، وتقديم توصيات للتزويد بالمخزون تراعي قيود الميزانية وتغطية المخزون وسعة المستودع. في نهاية التشغيل، يطبع عميل الاختبار مُعرّف جلسة التحسين.
الخطوة 2: تشغيل مُقيّم تلبية القيود (الطبقة 2: دقة الأعمال)
بعد توليد جلسة التحسين، شغّل المُقيّم المخصص لتلبية القيود للتحقق مما إذا كانت توصيات الوكيل للتزويد بالمخزون تراعي قواعد العمل. يتحقق هذا المُقيّم من ثلاثة قيود في الوقت نفسه:
- الميزانية: هل تتناسب تكلفة الاحتفاظ الإضافية ضمن الميزانية المتبقية (budget_limit − budget_used)؟
- تغطية المخزون: هل المستوى الموصى به ≥ توقعات الطلب (لتجنب نفاد المخزون) و ≤ 2× الطلب (لتجنب الفائض)؟
- سعة المستودع: هل يناسب المستوى الموصى به المساحة المتوفرة في المستودع؟
شغّل المقيِّم مع مقيّمَي Helpfulness وResponse Relevance المدمجَين:
cd test_evaluators
python test_evaluator.py --api-url "https://<evaluators-api-url>" run \
--agent-id "supply_chain_orchestrator_agent-<id>" \
--session-id "<optimization-session-id>" \
--evaluators "sc_optimization_constraint-<id>,Builtin.Helpfulness,Builtin.ResponseRelevance"
تُعيد الواجهة البرمجية API الرمز HTTP 202 فورًا. تُنفَّذ التقييمات بشكل غير متزامن. تُحفظ النتائج في S3:
s3://<amzn-s3-demo-agent-source-bucket>/evaluations/<optimization-session-id>/<timestamp>/EvaluationResults.mdالخطوة 3: تشغيل مقيّمات قابلية التفسير (الطبقة 3: الثقة وقابلية التدقيق)
بعد التأكد من أن وكيل التحسين يقدّم توصيات تستوفي القيود، يطرح السؤال التالي: هل يشرح منهجية استدلاله؟ قد تكون التوصية دقيقة لكنها غير مفهومة. مثل هذه التوصية تجتاز مقيّم القيود لكنها تفشل في توضيح سبب اختيار مستوى مخزون محدد.
باستخدام معرّف جلسة التحسين نفسه من الخطوة 1، شغّل الآن مقيّمَي قابلية التفسير المنطبقَين على وكيل التحسين:
- Decision Rationale Quality (جودة مبرّر القرار) — هل شرح الوكيل سبب تقديمه التوصية؟ (على سبيل المثال، «نوصي بـ 1,500 وحدة لأن توقّع الطلب هو 1,200 ونستهدف عامل أمان يبلغ 1.25×»)
- Constraint Reasoning (الاستدلال القيودي) — هل شرح الوكيل القيود التي شكّلت الاستجابة النهائية؟ (على سبيل المثال، «تسمح الميزانية بـ 1,800 وحدة كحد أقصى لكن سعة المستودع تحدّنا بـ 1,600، لذلك نوصي بـ 1,500»)
python test_evaluator.py --api-url "https://<evaluators-api-url>" run \
--agent-id "supply_chain_orchestrator_agent-<id>" \
--session-id "<optimization-session-id>" \
--evaluators "sc_decision_rationale-<id>,sc_constraint_reasoning-<id>"
تقيّم هذه المقيّمات الشفافية بشكل مستقل. وتُقاس بشكل منفصل عن الدقة.
تفسير النتائج المجتمعة
من خلال تشغيل المقيّمات الثلاثة جميعها على جلسة التحسين نفسها، تحصل على صورة كاملة عن جودة الوكيل عبر بُعدين:
| البُعد | المقيِّم | السؤال المطروح |
| دقة الأعمال (الطبقة 2) | Constraint Satisfaction | هل التوصيات صحيحة تشغيليًا؟ |
| قابلية التفسير (الطبقة 3) | Decision Rationale Quality | لماذا يتخذ الوكيل هذه التوصية؟ |
| قابلية التفسير (الطبقة 3) | Constraint Reasoning | أي القيود شكّلت الاستجابة؟ |
الجدول 3: تغطية التقييم عبر أبعاد الجودة
يتيح هذا النهج الطبقي إجراء تحسينات مستهدفة. إذا كانت درجات استيفاء القيود مرتفعة لكن درجات قابلية التفسير منخفضة، فمنطق قرارات الوكيل سليم، لكن تواصله يحتاج إلى تحسين. وعلى العكس، إذا كانت قابلية التفسير مرتفعة لكن القيود تُنتَك، فإن الوكيل يعبّر عن استدلاله جيدًا لكنه يطبّق منطقًا غير صحيح. لكل نمط فشل مسار معالجة مختلف، ويجعل إطار التقييم هذا التمييز قابلاً للقياس.
التنظيف
لتجنّب الرسوم المتكررة، نظّف حسابك في AWS بخطوة واحدة بعد تجربة الحل.
terraform destroyالخاتمة
في هذه التدوينة، أوضحنا كيفية بناء وتقييم نظام متعدد الوكلاء لاتخاذ قرارات سلسلة التوريد باستخدام Amazon Bedrock AgentCore Evaluations، مع التركيز على التحقق من أن سلوك الوكيل ليس وظيفيًا فحسب، بل مفيد ودقيق وقابل للتفسير أيضًا. باستخدام سيناريو AnyCompany Retail Group، بيّنّا كيف يتعاون وكيل منسّق مع وكلاء فرعيين متخصصين لحل مشكلات معقدة مثل توزيع المخزون وتخطيط التوزيع وتحسين التوجيه وتشخيص سلسلة التوريد، مع التكامل مع مصادر البيانات والواجهات البرمجية للمؤسسة. وكما هو موضح في البنية على طول التدوينة، تتجاوز الصحة في الأنظمة الوكيلة جودة الاستجابة؛ فهي تعتمد على اختيار الأدوات الصحيحة، وتنفيذ سير العمل الصحيح، والالتزام بقيود الأعمال، وترسيخ المخرجات في البيانات.
ومن خلال الجمع بين المقيّمات المدمجة والمقيّمات المخصصة، يمكن للفرق التحقق بشكل منهجي من جودة الاستجابة العامة ومن دقة القرارات الخاصة بالمجال على حد سواء. ويضمن دمج المقيّمات التي تركز على قابلية التفسير أن يعبر الوكلاء عن استدلالهم بوضوح، ويشيروا إلى البيانات الداعمة، ويشرحوا المقايضات بطريقة يمكن لمستخدمي الأعمال الوثوق بها والتصرف بناءً عليها. ويتيح هذا النهج القائم على التقييم التحسين المستمر باستخدام بيانات التنفيذ الفعلية، ويُنشئ بوابات جودة قبل الطرح في الإنتاج، ويوفر إطارًا قابلاً للتوسع لتقديم أنظمة متعددة الوكلاء متسقة وشفافة ومتوائمة مع الأعمال.
للبدء، استكشف Amazon Bedrock AgentCore Evaluations وطبّق هذه الأنماط على تطبيقاتك متعددة الوكلاء. يمكنك العثور على الكود المصدري الكامل في مستودع عينات Amazon Bedrock AgentCore على GitHub. ابدأ بتمكين المراقبة، وتحديد أبعاد التقييم الرئيسية لحالة الاستخدام الخاصة بك، ثم تقديم المقيّمات المدمجة والمخصصة تدريجيًا لقياس ما يهم أكثر.
لمعرفة المزيد، تفضل بزيارة Amazon Bedrock AgentCore صفحة الخدمة أو ابدأ مباشرةً من وحدة تحكم Amazon Bedrock.
مقالات ذات صلة:
- بناء وكلاء ذكاء اصطناعي موثوقين باستخدام Amazon Bedrock AgentCore Evaluations
- بناء أنظمة متعددة الوكلاء بمعمارية LangGraph عديمة الخادم وعالية القابلية للتوسع في AWS باستخدام Amazon Bedrock AgentCore
- تقييم وكلاء الذكاء الاصطناعي: دروس من العالم الواقعي من بناء الأنظمة الوكيلية في Amazon