
عندما يطلب المستخدم من مساعد الدعم، وهو تطبيق توليد معزز بالاسترجاع (RAG) مبني باستخدام LangChain، مقارنة منتجين عبر ثلاثة أبعاد، فإنه يطرح في الواقع ستة أسئلة في آن واحد. يستخدم البحث بالتشابه متجه استعلام واحدًا لتغليف جميع النوايا، ثم يولّد المسترجع أفضل تقريب لمتوسط تلك النوايا. تأتي الإجابة الناتجة موجزة، وينفَّذ البحث دون أخطاء، وتبدو درجات الملاءمة معقولة. ومع ذلك، فإن المقاطع المسترجعة، على الرغم من ارتباطها بالموضوع، تغطي جزءًا فقط مما سأله السؤال فعليًا.
في هذه المقالة، نعرض تطبيق RAG على Amazon Bedrock Managed Knowledge Base باستخدام LangChain. نُشغّل السؤال متعدد الأجزاء نفسه عبر الاسترجاع القياسي والاسترجاع الوكيل، ونقرأ أحداث التتبع لرؤية الخطة التي أنتجها النموذج. كما نتناول تكلفة مساري الاسترجاع ومتى يكون الخيار الأرخص هو الخيار الصحيح.
الاسترجاع الوكيل متاح على Amazon Bedrock Managed Knowledge Base. بدلاً من بحث واحد، يخطط Amazon Bedrock Managed Knowledge Base لعملية الاسترجاع. فهو يقسم السؤال إلى استعلامات فرعية، ويشغّلها، ويحكم ما إذا كان لديه أدلة كافية، ويبحث مرة أخرى إذا لم تكن كافية. تعرض حزمة langchain-aws كلاً من الاسترجاع الوكيل والاسترجاع القياسي، بحيث يمكنك استخدام أي منهما من تطبيق LangChain.
نظرة عامة على الحل
Amazon Bedrock Managed Knowledge Base، وهي إمكانية RAG المُدارة بالكامل في Amazon Bedrock، تُزيل مخزن المتجهات المُدار ذاتيًا ونماذج التضمين (embeddings) وإعادة الترتيب من بنية RAG. تقوم بتكوين مصدر بيانات، وتتولى Amazon Bedrock Managed Knowledge Bases معالجة التقسيم إلى مقاطع والتضمين والتخزين والاسترجاع. يستخدم هذا الدليل التطبيقي Amazon Simple Storage Service (Amazon S3).
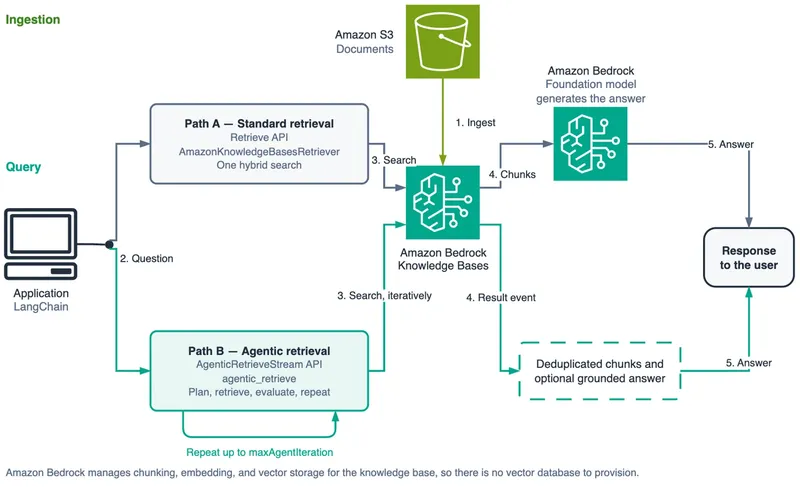
توفر Amazon Bedrock Managed Knowledge Bases واجهتي برمجة تطبيقات (APIs)، ونناقش بإيجاز الفروق بينهما في هذه المقالة. تُشغّل واجهة Retrieve بحثًا هجينًا واحدًا وتعيد مقاطع مع درجات ملاءمة. أما واجهة AgenticRetrieveStream فتشغّل حلقة تخطيط وتبث الخطوات إليك كأحداث تتبع. في حزمة langchain-aws ، تكون الأولى مسترجعًا قياسيًا من LangChain يمكنك إدراجه في سلسلة (chain)، والثانية دالة تسترجع مباشرة من قاعدة معرفة.
يوضح المخطط التالي بنية الحل. يستعلم التطبيق عن Amazon Bedrock Knowledge Bases باستخدام إما واجهة Retrieve API (قياسي، أحادي المرحلة) أو واجهة AgenticRetrieveStream API (حلقة تخطيط متعددة الخطوات). يُعيد كلا المسارين مقاطع مستندات من قاعدة المعرفة، والتي يستخدمها التطبيق بعد ذلك لتوليد رستجاب مستند إلى المصادر.
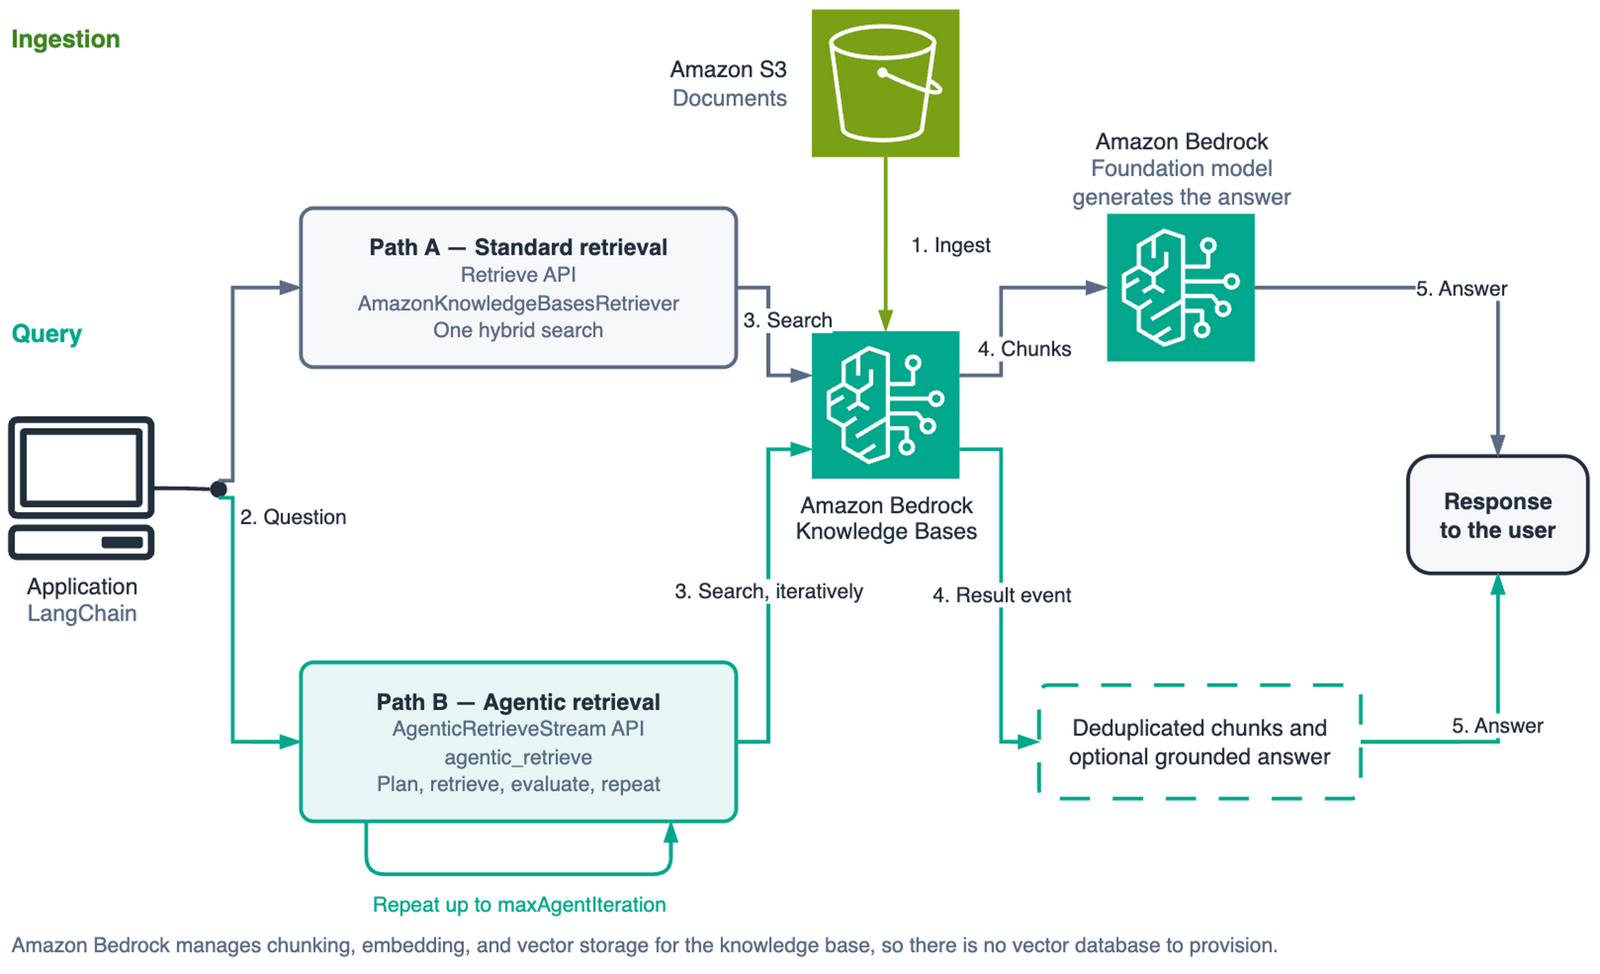
الشكل 1: بنية الحل للاستعلام عن Amazon Bedrock Knowledge Bases باستخدام واجهتي Retrieve وAgenticRetrieveStream
شرح خطوات التنفيذ
ترشدك الأقسام التالية إلى إنشاء قاعدة معرفة، والاستعلام عنها باستخدام طريقتي الاسترجاع، وقراءة أحداث التتبع التي ينتجها المخطط الوكيل.
المتطلبات الأساسية
لمتابعة هذا الدليل، تحتاج إلى:
- حساب AWS مع إمكانية الوصول إلى Amazon Bedrock في إقليم (Region) تتوفر فيه Amazon Bedrock Managed Knowledge Bases والاسترجاع الوكيل. يستخدم هذا الدليل التطبيقي إقليم US East (N. Virginia) (
us-east-1)، ويفترض الكود ذلك على طول الدليل. راجع وثائق AWS للتحقق من التوفر والدعم في الأقاليم الأخرى. - هويتين من AWS Identity and Access Management (IAM)، موصوفين في القسم التالي: دور خدمة تتحمله قاعدة المعرفة، وأذونات على الهوية التي تستدعي منها واجهات البرمجة.
- Python 3.12 أو أحدث.
- دلو S3 يحمل المستندات النموذجية. يحتاج المدخل النصي إلى عدة مستندات تغطي مواضيع متداخلة حتى يكون للسؤال المقارن مكان للإحالة. لا يمكن لمستند واحد مسطّح أن يُظهر تخطيط الاستعلام.
ثبّت الحزم. إصدار Boto3 مهم: agentic_retrieve_stream لم يكن موجودًا قبل 1.43.32.
langchain-aws>=1.6.3
langchain>=1.0
boto3>=1.43.32
الأذونات
توجد هويتان منفصلتان، ومن المفيد الفصل بينهما بشكل مقصود. تعتمد قاعدة المعرفة على دور خدمة لقراءة مستنداتك واستدعاء نموذج التضمين (embedding)، بينما يستخدم تطبيقك هوية مستدعي AWS Security Token Service (AWS STS) لإجراء الاستعلامات. ولا تحتاج أي منهما إلى أذونات الأخرى.
ينشئ Amazon Bedrock دور الخدمة نيابةً عنك إذا سمحت له بذلك. لتوفير دورك الخاص، امنحه سياسة ثقة تتيح لـ Amazon Bedrock افتراضه. حدّد نطاقه باستخدام aws:SourceAccount و aws:SourceArn حتى لا يتمكن حساب آخر من استخدامه كوسيل مخدوع:
{
    "Version": "2012-10-17",
    "Statement": [{
        "Effect": "Allow",
        "Principal": {"Service": "bedrock.amazonaws.com"},
        "Action": "sts:AssumeRole",
        "Condition": {
            "StringEquals": {"aws:SourceAccount": "111122223333"},
            "ArnLike": {
                "aws:SourceArn": "arn:aws:bedrock:us-east-1:111122223333:knowledge-base/*"
            }
        }
    }]
}
يحتاج دور الخدمة أيضًا إلى s3:ListBucket على دلو التخزين الخاص بك و s3:GetObject على محتواها، وكلاهما مشروط بـ aws:ResourceAccount. حدّد نطاق knowledge-base/* الوصول إلى معرفات قواعد المعرفة المحددة باستخدام حرف البدل بعد إنشائها.
تحتاج هوية المتصل في AWS STS إلى مجموعة مختلفة. bedrock:AgenticRetrieveStream و bedrock:InvokeModelWithResponseStream لا يمكن تحديد نطاقها إلى اسم المورد من أمازون (ARN) لقاعدة معرفية. bedrock:Retrieve و bedrock:GetDocumentContent يمكن:
{
    "Version": "2012-10-17",
    "Statement": [
        {
            "Sid": "AgenticRetrievalAndPlannerModel",
            "Effect": "Allow",
            "Action": [
                "bedrock:AgenticRetrieveStream",
                "bedrock:InvokeModelWithResponseStream"
            ],
            "Resource": "*"
        },
        {
            "Sid": "RetrieveAndFullDocumentExpansion",
            "Effect": "Allow",
            "Action": ["bedrock:Retrieve", "bedrock:GetDocumentContent"],
            "Resource": "arn:aws:bedrock:<region>:111122223333:knowledge-base/<knowledge-base-id>"
        },
        {
            "Sid": "GenerateAnswersInTheChains",
            "Effect": "Allow",
            "Action": ["bedrock:InvokeModel", "bedrock:Converse", "bedrock:ConverseStream"],
            "Resource": "*"
        }
    ]
}
bedrock:GetDocumentContent غالبًا ما يتم التغاضي عنه. يستدعي الاسترجاع الوكيلي (Agentic retrieval) عندما FullDocumentExpansion الخطوة تقرر أن المقطع يفتقر إلى السياق اللازم للإجابة. سياسة ذات bedrock:Retrieve يعمل حتى يحاول المخطّط الوصول إلى مستند كامل، ثم يفشل في منتصف الاستعلام.
لإنشاء قاعدة المعرفة نفسها وإدارتها، يحتاج دور الاتصال إضافةً إلى ذلك إلى bedrock:CreateKnowledgeBase على *، و GetKnowledgeBase, UpdateKnowledgeBase, DeleteKnowledgeBase, StartIngestionJob, GetIngestionJob، و ListIngestionJobs إجراءات على knowledge-base/*. إذا كنت تستخدم guardrails، أضف bedrock:GetGuardrail و bedrock:ApplyGuardrail.
قد ينطوي تشغيل هذا الدليل التوضيحي على تكاليف تتعلق بتخزين المستندات و ingested في قاعدة المعرفة، واستدعاءات الاسترجاع، واستدلال نموذج الأساس (FM).
لمزيد من المعلومات حول التسعير، راجع قسم قواعد المعرفة في أسعار Amazon Bedrock.
احذف الموارد عند اكتمالك من هذا التجربة.
إنشاء قاعدة المعرفة وتعبئتها
أنشئ قاعدة المعرفة بواسطة managedKnowledgeBaseConfiguration. إعداد embeddingModelType إلى MANAGED يستخدم نموذج التضمين المُدار من الخدمة.
import boto3
import os

REGION = os.environ["AWS_REGION"]
bedrock_agent = boto3.client("bedrock-agent", region_name=REGION)

response = bedrock_agent.create_knowledge_base(
    name=KB_NAME,
    roleArn=KB_ROLE_ARN,
    knowledgeBaseConfiguration={
        "type": "MANAGED",
        "managedKnowledgeBaseConfiguration": {
            "embeddingModelType": "MANAGED",
        },
    },
)
KB_ID = response["knowledgeBase"]["knowledgeBaseId"]
لا يوجد storageConfiguration في ذلك الطلب. بالنسبة لقاعدة معرفة تديرها بنفسك ستمرر واحداً يصف مخزن المتجهات الخاص بك. أما Amazon Bedrock Managed Knowledge Base فلا يأخذاً، وهي الإشارة الأوضح في الـ API على أن Amazon Bedrock يملك طبقة التخزين.
أرفق حاوية S3 كمصدر بيانات، ثم ابدأ مهمة استيعاب. الاستيعاب غير متزامن، لذا راجع الحالة بشكل متكرر حتى تصل المهمة إلى حالة نهائية بدلاً من النوم لفترة ثابتة والأمل.
import time

SUCCESS_STATES = frozenset({"COMPLETE"})
FAILURE_STATES = frozenset({"FAILED", "STOPPED"})

def wait_for_ingestion(kb_id, ds_id, job_id, timeout_s=1800):
    """Poll an ingestion job until it reaches a terminal state."""
    deadline = time.time() + timeout_s
    while time.time() < deadline:
        job = bedrock_agent.get_ingestion_job(
            knowledgeBaseId=kb_id,
            dataSourceId=ds_id,
            ingestionJobId=job_id,
        )["ingestionJob"]
        status = job["status"]
        if status in SUCCESS_STATES:
            return job
        if status in FAILURE_STATES:
            reasons = job.get("failureReasons") or ["no reason reported"]
            raise RuntimeError(f"Ingestion job {job_id} finished as {status}: " + "; ".join(reasons))
        time.sleep(15)
    raise TimeoutError(f"Ingestion job {job_id} did not finish in {timeout_s}s")
تكوين مصدر البيانات الكامل ومعالجة الأخطاء موجودان في مستودع العينة.
الاستعلام باستخدام مسترجع LangChain
AmazonKnowledgeBasesRetriever يغلّف واجهة Retrieve API ويتصرف مثل أي مسترجع آخر من LangChain. بالنسبة إلى Amazon Bedrock Managed Knowledge Bases، مرّر managedSearchConfigurationفقط. هذا هو الجزء الذي يوقع الناس في الخطأ: vectorSearchConfiguration هو المسار السابق لقواعد المعرفة التي تشغّل فيها مخزن المتجهات بنفسك. وهو ما تُظهره معظم الأمثلة القائمة.
from langchain_aws.retrievers import AmazonKnowledgeBasesRetriever

SIMPLE_QUERY = "What is the restore time objective for the checkout service?"

retriever = AmazonKnowledgeBasesRetriever(
    knowledge_base_id=KB_ID,
    region_name=REGION,
    retrieval_config={
        "managedSearchConfiguration": {
            "numberOfResults": 5,
        }
    },
)
docs = retriever.invoke(SIMPLE_QUERY)
تأتي كل نتيجة على شكل LangChain Document. درجة الصلة موجودة في metadata["score"]، وبيانات التعريف الخاصة بالمصدر نفسه تحت metadata["source_metadata"]، بعد إعادة تسميتها حتى لا تتعارض. إذا أردت إسقاط النتائج منخفضة الثقة، فاضبط min_score_confidence على المسترجع بدلاً من التصفية لاحقاً.
بالنسبة لسؤال ذي نية واحدة واضحة، هذه هي الأداة المناسبة. إنها استدعاء واحد. زمن الاستجابة هو الأدنى بين الخيارين، وتحتفظ بتحكم كامل في كيفية توليد الإجابة. معظم الاستعلامات التي يراها مساعد إنتاجي بهذا الشكل، واللجوء إلى حلقة تخطيط للإجابة عليها يهدر المال والوقت.
حين يتعثر الاسترجاع أحادي الطلب
الآن أعطِ المسترجع نفسه سؤالاً متعدد الأجزاء:
COMPLEX_QUERY = (
    "Compare the checkout and inventory services across on-call escalation, backup and "
    "restore targets, and deployment rollback procedure. Where do they differ?"
)

docs = retriever.invoke(COMPLEX_QUERY)
تعود خمس مقاطع، مرتبة بدرجة هجينة مقابل تضمين واحد لذلك السؤال بأكمله.
يحتوي ذلك السؤال على ست نوايا: خدمتان عبر ثلاثة أبعاد. تقييم النص المسترجع للبحث عن أدلة على كل منها يعطي مقياساً ملموساً لما يستعيده تضمين واحد.
| numberOfResults | المقاطع | نسبة المدونة | النوايا الفرعية المغطاة | المفقود |
| 5 | 5 | 10% | 4 من 6 | checkout on-call, inventory restore |
| 10 | 10 | 19% | 6 من 6 | لا شيء |
عند خمس نتائج، يحجب تضمين واحد يقف نيابة عن ست نوايا اثنتين منها. وعند عشر نتائج يغطي الست جميعها، مع هدر واضح: نوايا فرعية مغطاة مرتين ومقطع واحد لا يحمل أيًا منها.
قام المُسترجع بمهمته. القيد هيكلي: متجه واحد لا يمكنه تمثيل ستة أغراض، ولا توجد خطوة في العملية تسأل عما إذا كانت الأدلة المُرجَعة كافية للإجابة على السؤال.
تشغيل الاسترجاع الوكيلي
الاسترجاع الوكيلي ليس مُسترجع LangChain، بل هو ميزة من Amazon Bedrock Managed Knowledge Bases. الـ langchain-aws يعرضها كدالة مستقلة باسم agentic_retrieveلأن واجهة API الأساسية تبث نتائجها ولا تناسب واجهة BaseRetriever المتزامنة. لا يوجد أي خيار على AmazonKnowledgeBasesRetriever لتفعيلها.
from langchain_aws.retrievers.bedrock import agentic_retrieve

result = agentic_retrieve(
    knowledge_base_id=KB_ID,
    query=COMPLEX_QUERY,
    region_name=REGION,
    generate_response=True,
    number_of_results=10,
)
print(result["generatedResponse"]["answer"])
مع generate_response=Trueتُعيد الخدمة إجابة مستندة مع الاقتباسات إلى جانب المقاطع المُسترجَعة، فتحصل على إجابة دون الحاجة إلى ربط نداء نموذج منفصل. تعمل الدالة فقط مع Amazon Bedrock Managed Knowledge Base.
داخليًا، تخطط الخدمة، وتسترجع، وتقيّم ما إذا كانت الأدلة كافية، وتكرر العملية إن لم تكن كذلك. تُخفي الدالة المساعدة كل ذلك وتُعيد المقاطع النهائية، وهو أمر مريح لكنه يعني أنك لا تستطيع رؤية الخطة.
قراءة أحداث التتبع
لمشاهدة النموذج يفكك السؤال، استدعِ agentic_retrieve_stream على عميل bedrock-agent-runtime مباشرةً. هذا هو الموضع الوحيد في هذا الشرح حيث نتجاوز langchain-awsلأن الدالة المساعدة تتجاهل أحداث التتبع ولا تكشف maxAgentIteration أو نموذج مخطط مخصص.
runtime = boto3.client("bedrock-agent-runtime", region_name=REGION)

response = runtime.agentic_retrieve_stream(
    messages=[{"role": "user", "content": {"text": COMPLEX_QUERY}}],
    retrievers=[{
        "configuration": {
            "knowledgeBase": {
                "knowledgeBaseId": KB_ID,
                "retrievalOverrides": {"maxNumberOfResults": 10},
            }
        }
    }],
    agenticRetrieveConfiguration={
        "foundationModelType": "MANAGED",
        "rerankingModelType": "MANAGED",
        # 5 is the API default. Below 4 the planner stops decomposing entirely.
        "maxAgentIteration": 5,
    },
    generateResponse=False,
)

for event in response["stream"]:
    if "traceEvent" in event:
        attrs = event["traceEvent"]["attributes"]
        print(f"{attrs.get('step')}: {attrs.get('status')}")
        for action in attrs.get("actions", []) or []:
            if "retrieve" in action:
                query = action["retrieve"].get("inputQuery", {}).get("text", "")
                print(f" sub-query: {query}")
    elif "result" in event:
        for chunk in event["result"].get("results", []):
            print(chunk.get("content", {}).get("text", "")[:120])
اضبط generateResponse على False عندما تريد سلوك الاسترجاع فقط. تُنشئ واجهة API إجابة مستندة افتراضيًا، وهو ما يكلّف نداء نموذج إضافيًا قد لا تحتاج إليه أثناء فحص الخطة.
حقل step في حدث التتبع يخبرك أين وصل المخطط. SpeculativeRetrieval يُنفَّذ قبل الخطة الأولى لتقليل زمن الاستجابة ولا يُحتسب ضمن ميزانية التكرار لديك. Planning هي المرحلة التي يقرأ فيها النموذج السؤال والنتائج السابقة ويُصدر استعلامات فرعية. Retrieval تُطلق مرة واحدة لكل استعلام فرعي. FullDocumentExpansion تظهر عندما يقرر النموذج أن مقطعًا ما يفتقر إلى السياق الكافي للإجابة فيسحب المستند كاملًا بدلًا منه. ويحمل كل حدث حالة من نوع IN_PROGRESS, SUCCEEDEDأو FAILEDإضافة إلى رسالة مفهومة للبشر.
تصل المقاطع النهائية بشكل منفصل. الـ result هو نوع حدث مستقل وليس خطوة خامسة، ويحمل المقاطع منزوعة التكرار من كل التكرارات إلى جانب الإجابة المستندة عند تفعيل توليد الاستجابة. تفحص مفتاح الحدث، كما توضح الحلقة السابقة، بدلًا من توقع قيمة خطوة نهائية.
نص الاستعلام الفرعي هو الجزء الذي يستحق التسجيل. فهو يقع في attributes.actions[].retrieve.inputQuery.textوليس في حقول التتبع ذات المستوى الأعلى، لذا فإن أي معالج يقرأ فقط step و status يُريك أن التخطيط حدث دون أن يُريك ما تم اتخاذه كقرار.
يوضح المخطط التالي حلقة التخطيط للاسترداد الوكيلي، بما في ذلك خطوات الاسترداد التخميني، والتخطيط، واسترداد الاستعلامات الفرعية، والتقييم، وإعادة التخطيط الاختيارية.
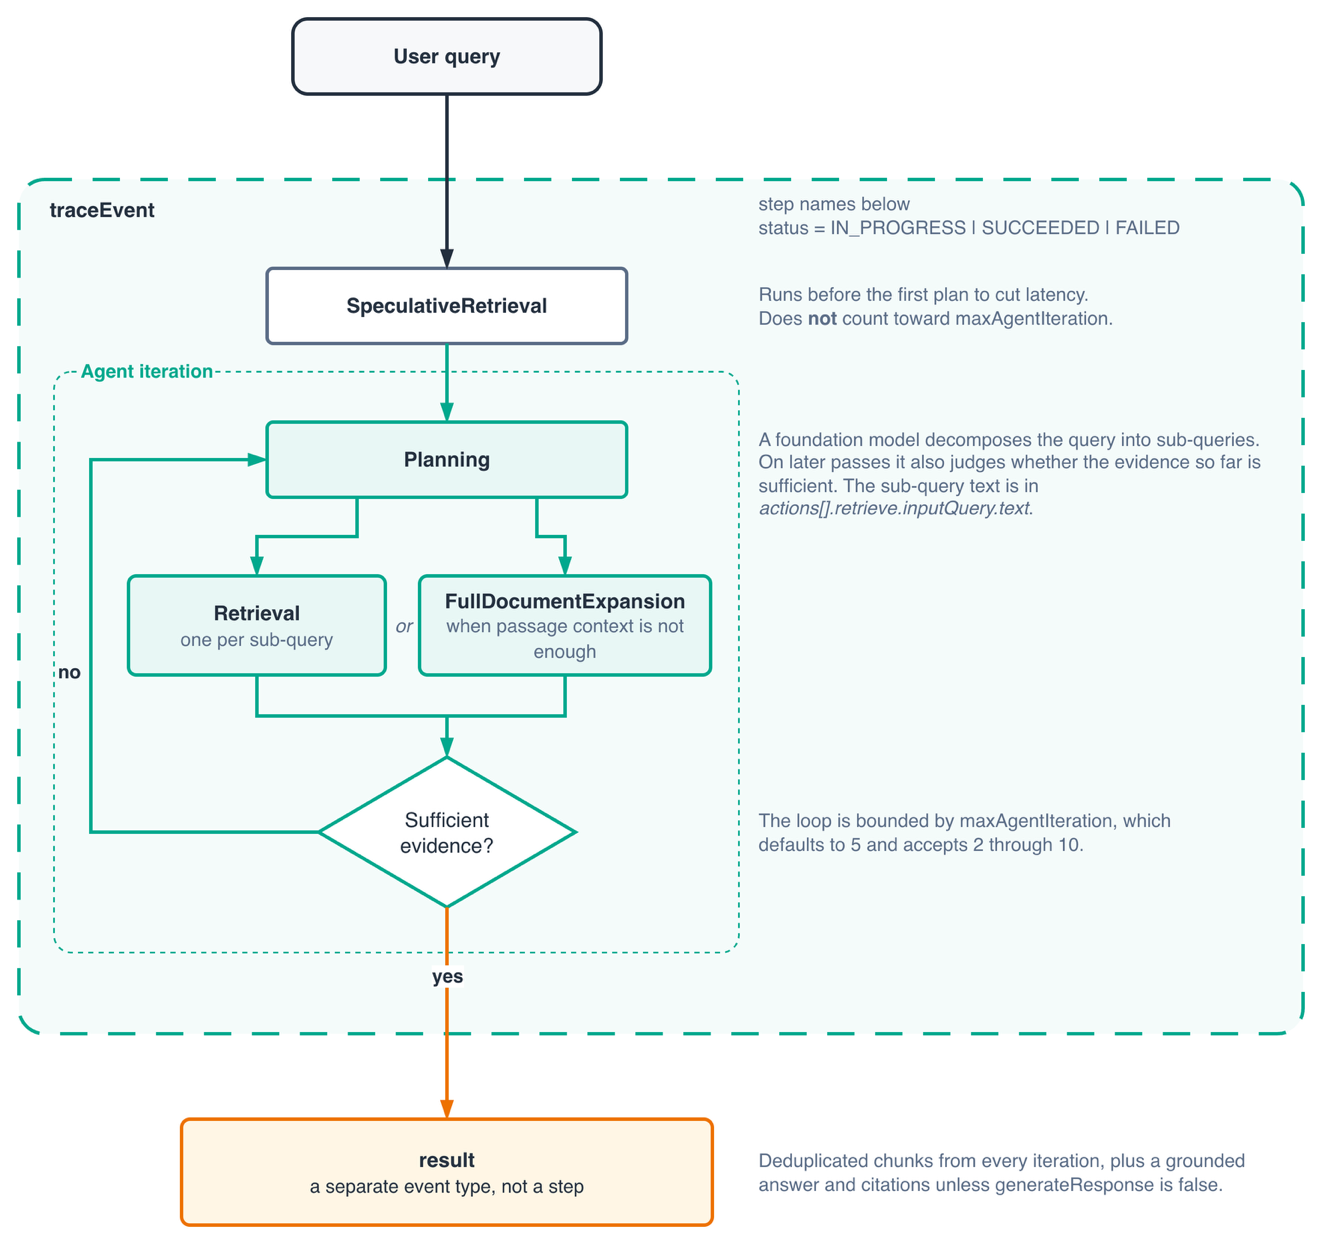
الشكل 2: خطوات حلقة التخطيط للاسترداد الوكيلي
ثبتان تفصيلان يستحقان المعرفة قبل أن تبنِ على هذا. إزالة التكرار تنطبق فقط على حدث result لذا فإن القطعة التي يستردها ثلاثة استعلامات فرعية تظهر مرة واحدة في النهاية لكن ثلاث مرات عبر عمليات التتبع.
التفصيل الثاني يتعلق بالدرجات. فاستجابة Retrieve تمنح كل قطعة حقلًا مكتوب النوع score يحتوي على صلتها بالاستعلام. أما نتائج الاسترداد الوكيلي فهي تحمل content, metadataو sourceRetrieverمن دون حقل مكافئ مكتوب النوع. فالشيفرة التي تقرأ result["score"] بعد التحويل بين الواجهات لا تحصل على شيء. وإذا كنت ترتّب الصلة أو ترشّح وفقها، فخطط لذلك الفرق.
في بيئة الإنتاج، استخدم Amazon Bedrock Guardrails لفرض سياسات المحتوى وفحوصات التأسيس على الاستجابات المولّدة. كلا مساري الاسترداد يدعمان guardrails. الاسترداد الوكيلي يدعم guardrails عبر policyConfiguration.bedrockGuardrailConfiguration بدلاً من الوسيطة guardrail_config التي يتلقاها مسترجع LangChain، ويدعم الوضع BLOCK فقط. وإذا كنت تعتمد على الوضع MASK فذلك سبب للبقاء على واجهة Retrieve API.
maxAgentIteration يقبل القيم من 2 إلى 10 وافتراضيه 5. اتركه على القيمة الافتراضية. فعند 2 أو 3 يشغّل المخطِّط دورة واحدة، ولا يُصدر أي استعلامات فرعية، ويعيد ما وجدته خطوة الاسترداد التخميني مسبقًا. هذا سلوك ذو ضربة واحدة بسعر الأسلوب الوكيلي. ويبدأ التحليل عند 4. وكثيرًا ما يتوقف المخطِّط مبكرًا عندما يحكم أن الأدلة كافية، لذا فإن الحد الأقصى هو قيد وليس هدفًا.
مقارنة مساري الاسترداد
ولتوفير سياق حول كيفية تصرف هذا على نطاق واسع، قيّمت AWS الاسترداد الوكيلي على MuSiQue، وهو معيار عام متعدد القفزات. أظهر التقييم تحسنًا في الاسترجاع مقارنة بالاسترداد ذي الضربة الواحدة، مع أكبر المكاسب على الأسئلة الأصعب. وشهدت الأسئلة ذات القفزة الواحدة مكاسب أقل من خمس نقاط. وتتطابق تلك الحقيلة الأخيرة مع شكل المقايضة: فالتحليل يفيد عندما يكون هناك ما يستحق التحليل.
بناء سلسلة RAG
بالنسبة للمسترجع القياسي، تعمل التركيبة المعتادة عبر LangChain Expression Language (LCEL) مباشرة:
from langchain_aws import ChatBedrockConverse
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnablePassthrough

def format_docs(docs):
    return "\n\n".join(doc.page_content for doc in docs)

llm = ChatBedrockConverse(model=MODEL_ID, region_name=REGION)
prompt = ChatPromptTemplate.from_template(PROMPT_TEMPLATE)

chain = (
    {"context": retriever | format_docs, "question": RunnablePassthrough()}
    | prompt
    | llm
    | StrOutputParser()
)
format_docs أهمية أكبر مما تبدو. المرور Document الكائنات مباشرة في المطالبة يجعل repr، ويتعرض النموذج لضوضاء البيانات الوصفية تختلط بسياقه.
لتوضيع استرجاع الوكلاء في الموقع نفسه، غلّفه داخل RunnableLambda، لأنها دالة وليست أداة استرجاع:
from langchain_core.runnables import RunnableLambda

def agentic_context(question: str) -> str:
    result = agentic_retrieve(
        knowledge_base_id=KB_ID,
        query=question,
        region_name=REGION,
        number_of_results=10,
    )
    return "\n\n".join(
        item.get("content", {}).get("text", "")
        for item in result.get("results", [])
    )

agentic_chain = (
    {"context": RunnableLambda(agentic_context), "question": RunnablePassthrough()}
    | prompt
    | llm
    | StrOutputParser()
)
يُرجى ملاحظة أن generate_response معطّلة هنا. يمكن للخدمة أن تولّد الإجابة بنفسها، لكن داخل سلسلة (chain) عادةً ما تريد أن تستخدم مطالبتك (prompt) ونموذجك الخاصين، لذلك تأخذ المقاطع (chunks) وتولّد ما بعدها بنفسك. استخدم التوليد عبر الخدمة عندما تريد استدعاءً واحداً وكوداً أقل، واستخدم النسخة المُغلَّفة (wrapped) عندما تكون المطالبة تحت سيطرتك.
الاختيار بين الاسترجاع القياسي والاسترجاع الوكيلي
استخدم Retrieve للأسئلة القصيرة محدودة النطاق. فهو أرخص وأسرع، ويعمل مقابل قواعد المعارف المُدارة ذاتيًا، ويعيد الدرجات في النتائج. معظم حركة الإنتاج تبدو هكذا.
استخدم AgenticRetrieveStream عندما تكون الأسئلة متعددة الأجزاء أو مقارنة أو استكشافية، أو عندما تمتد الأدلة إلى أكثر من قاعدة معرفة واحدة. فهو يسجل حتى خمس قواعد معرفة في طلب واحد ويوجه الاستعلامات الفرعية باستخدام وصف بلغة طبيعية ترفقه لكل قاعدة. أما الواجهة البرمجية الأخرى فلا تستطيع القيام بذلك إطلاقًا. فهي تكلّف أكثر لكل استدعاء، وتجري عدة استدعاءات للنموذج، وتتمتع بزمن استجابة أعلى بين الواجهتين.
التوجيه حسب شكل الاستعلام بدلاً من اختيار مسار واحد لكل شيء هو النمط الذي نوصي به. يمكن للمصنِّف أو أسلوب استدلالي على السؤال توجيه معظم حركة المرور نحو المسار الرخيص وحجز المخطِّط للأسئلة التي تحتاجه.
تنظيف الموارد
احذف قاعدة المعرفة ومصدر بياناتها وكائنات S3 والحاوية bucket ودور IAM الذي أنشأته. تستمر قاعدة المعرفة التي تحتوي على مستندات في تح تكاليف تخزين.
bedrock_agent.delete_data_source(knowledgeBaseId=KB_ID, dataSourceId=DS_ID)
bedrock_agent.delete_knowledge_base(knowledgeBaseId=KB_ID)
ـ مستودع يتضمن سكريبت تنظيف يقوم أيضًا بإفراغ الحاوية وإزالة الدور.
الخلاصة
أوضحنا كيفية بناء تطبيق RAG على Amazon Bedrock Knowledge Bases باستخدام LangChain، وكيف يتعامل الاسترجاع الوكيلي (agentic retrieval) مع الأسئلة متعددة الأجزاء التي يجيب عنها الاسترجاع أحادي المرحلة بشكل سيئ. كما أوضحنا أيضاً نقطة الاحتكاك في التكامل الحالي؛ فالاسترجاع الوكيلي دالة وليس مسترجعاً (retriever) في LangChain، لذا يحتاج إلى RunnableLambda للجلوس في سلسلة. أحداث التتبع التي تُظهر خطة الاستعلام تتطلب مباشرة boto3 نداء.
توازن الاسترجاع الوكيلي بين تكلفة أعلى لكل استدعاء وتحسين في معدل الاسترجاع للأسئلة متعددة القفزات، باستخدام نموذج مدمج لتخطيط الاستعلامات. والخطوة المفيدة التالية هي قياس مزيج استعلاماتك الخاص قبل توجيه كل شيء عبر مخطِّط.
للبدء، راجع وثائق Amazon Bedrock Knowledge Bases documentation والرمز البرمجي النموذجي المرفق. للحصول على مساعدة في تطبيق هذا على أعباء العمل الخاصة بك، تواصل مع فريق حساب AWS الخاص بك.