
أكبر عائق أمام تبنّي الذكاء الاصطناعي ليس الوعي. بل هو الفجوة بين الحديث عن الذكاء الاصطناعي والبناء باستخدامه.
المحترفون الذين دورهم الأساسي ليس كتابة الشيفرة البرمجية، لكن عملهم اليومي يعتمد على حلول الذكاء الاصطناعي بشكل متزايد، لا يحتاجون إلى خلفية هندسية لبدء بناء القدرات في الذكاء الاصطناعي. يحتاجون إلى الأدوات المناسبة، والدعم المنظم، والإذن بالفشل. إليك كيف أثبتنا ذلك، وكيف يمكنك تكراره.
المشكلة التي تتجاهلها المؤسسات
فرقك مشاركة بالفعل في محادثات الذكاء الاصطناعي، سواء كانت تجيب عن أسئلة العملاء، أو تقيّم حلول الموردين، أو تحدد فرص الأتمتة في مهامها اليومية. ونظراً للوترة التي أصبحت بها أدوات الذكاء الاصطناعي الوكيل متاحة على نطاق عام، فإن معظمهم لم يبنِ شيئاً قط باستخدام الأدوات التي يناقشونها.
هذه الفرق، بغض النظر عما إذا كانت في المبيعات أو العمليات أو المالية أو المنتج، شاهدت العروض التوضيحية وأكملت شهادات الاعتماد. لكن عندما يسأل أحدهم: "كيف يعمل هذا فعلاً؟"، ليس لديهم الإجابة التي تأتي من بنائه بأنفسهم.
والتكلفة حقيقية: تبنٍّ أبطأ، ومكاسب إنتاجية متأخرة، وفرص ضائعة لتحديد حالات الاستخدام، وفجوة متنامية بين ما تعرفه فرقك عن وما تستطيع تنفيذه.
سألنا محترفي أعمال، أشخاصاً يعملون بأدوات الذكاء الاصطناعي يومياً لكنهم لا يكتبون شيفرات إنتاجية، عمّا كان يعيقهم في تبنّي الذكاء الاصطناعي. لم تكن الإجابة "لا أريد أن أتعلم". فـ90 بالمئة أرادوا خبرة عملية في بناء وكلاء ذكاء اصطناعي. كان ينقصهم النسيج الرابط والبنية الداعمة للبناء بأمان. يوضح المخطط التالي أكثر العوائق شيوعاً التي تواجهها فرق الأعمال عند محاولة البناء باستخدام الذكاء الاصطناعي.
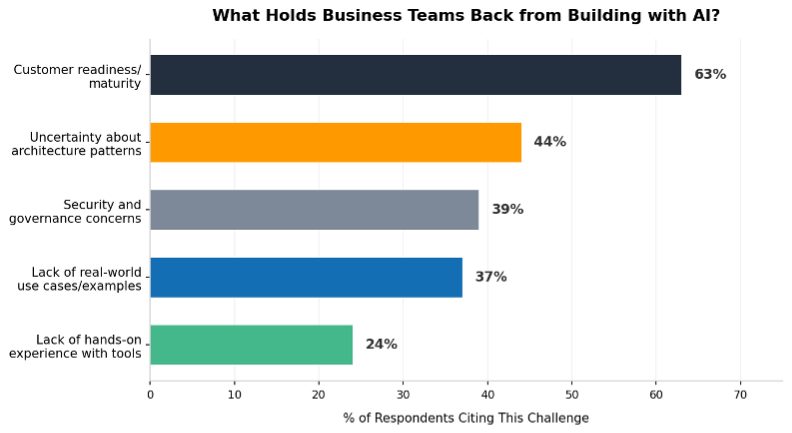
الشكل 1: أهم العوائق التي تذكرها فرق الأعمال عند البناء باستخدام الذكاء الاصطناعي
على مستوى عام، كانوا قادرين على الحديث عن Amazon Bedrock و Amazon Bedrock AgentCore، منصة لبناء الوكلاء وربطهم وتحسينهم على نطاق واسع بأي إطار عمل أو نموذج (استكشفها 80 بالمئة منهم). لكن أقل من 1 من كل 5 كانوا قد جرّبوا Strands Agents SDK أو بنوا وكلاء باستخدام AWS Lambda . وكانوا ينسحبون من فعاليات الهاكاثون وأحداث البناء لأنهم لم يكونوا يعتقدون أن معرفتهم التقنية كافية للمنافسة إلى جانب المهندسين.
لحل هذه المشكلة، صممنا برنامجاً منظماً لمدة ستة أسابيع يجمع محترفي الأعمال مع مدراء لهم وتحتهم أدوات بجودة الإنتاج لبناء نماذج أولية عملية للذكاء الاصطناعي قابلة للتوسع بعد انتهاء البرنامج. الهدف: سد الفجوة بين المعرفة النظرية والقدرة العملية.
ما بناه فريق واحد: الإثبات في ستة أسابيع
شارك في برنامجنا أربعة محترفين يتعاملون مع العملاء لم يعملوا معاً من قبل. لم يكن أي منهم لديه خلفية هندسية. وبعد ستة أسابيع، قدّموا نموذجهم الأولي، WealthWise، أداة استشارات مالية بالذكاء الاصطناعي متعددة الوكلاء، التي فازت بالمركز الأول.
ما بنوه:
- خمسة وكلاء ذكاء اصطناعي متخصصين يقدمون استشارات مالية ذكية: تحليل المحفظة، وتقييم المخاطر، والتخطيط المالي، ورؤى السوق، وتوصيات استثمارية مخصصة.
- بنية خوادم مزدوجة (
Node.js+ Python Flask) مع نماذج Amazon Nova.* - Strands Agents SDK لتنسيق الوكلاء المتعددين وذاكرة المحادثة.
- أربعة جداول Amazon DynamoDB للاحتفاظ بالبيانات في الوقت الفعلي.
- دمج بيانات السوق المباشرة لتقديم توصيات مالية مدركة للسياق.
- أوقات استجابة تقل عن 5 ثوانٍ للاستدلال المالي المعقد.
يتميز النظام باتخاذ قرارات منسّق: يقرر كل وكيل بشكل مستقل أي الأدوات يستدعي ويربط بين عدة أدوات معاً، مؤدياً استدلالاً متعدد الخطوات عبر بيانات المحفظة وقواعد بيانات السوق ونماذج التخطيط المالي.
لقد عزاوا نجاحهم إلى خمسة مبادئ وضعوها منذ اليوم الأول:
- التعلم بدلاً من الفوز – اختيار النهج challenging بدلاً من الطرق المختصرة الآمنة حررهم للتجربة دون خوف.
- إيقاع منتظم – الاجتماعات اليومية الوقائية منعت العزلة واكتشفت المشكلات مبكراً.
- ابدأ بمنتج أولي قابل للتطبيق (MVP)، ثم حسّنه – تدفق عمل كامل من البداية إلى النهاية بحلول اليوم 2، ثم التحسين التدريجي.
- المشاركة في الساعات المكتبية – البحث النشط عن الإرشاد عند التعثر.
- استمتعوا بالمرح – الأمان النفسي قبل الإنتاج التقني.
تأمل المشاركون في كيفية تسريع الصيغة العملية لتعلمهم:
"كان توقيت الهاكاثون مثالياً، وأثبتت الصيغة العملية قيمتها لا تقدر بثمن لتمكين AgentCore – مما سرّع ما كان يمكن أن يكون منحنى تعلم طويلاً."
"مشروع رائع لبناء الفريق والتعلم في مجال الذكاء الاصطناعي! علّمت نفسي الكثير وأصبحت لدي تعاطف إضافي مع العملاء الجدد على حلول الذكاء الاصطناعي."
* نماذج Amazon Nova متاحة على Amazon Bedrock في مناطق AWS منتقاة. للاطلاع على أحدث معلومات التوافر، راجع صفحة AWS Regional Services.
دليل التنفيذ: كيف صممنا البرنامج
تتناول الأقسام التالية هيكل البرنامج، وكل مرحلة، وقرارات التصميم التي جعلته ناجحًا.
هيكل البرنامج
يمتد البرنامج على مدى ستة أسابيع، مع تخصيص المشاركين ما يقارب أربع ساعات أسبوعيًا. لقد قسمناه بهذه الطريقة عمدًا: بناءً على بيانات برنامجنا، احتفظ المشاركون الذين أكملوا برنامجًا مرحليًا بمهارات عملية أكثر بثلاث مرات مقارنة بمن شاركوا في صيغ مكثفة تستغرق يومين. يحتاج المحترفون الذين لا يكتبون التعليمات البرمجية في وظائفهم الأساسية إلى دورات تكرار: وقت للتصارع مع مفاهيم غير مألوفة، والتعافي، والبناء من جديد قبل أن يصبح الثقة راسخة.
المرحلة 0: الاستقطاب وإعداد البرنامج
استقطبنا المشاركين عبر ترشيحات المديرين وحملات Slack والبريد الإلكتروني، مستهدفين المحترفين الذين يعملون مع حلول الذكاء الاصطناعي يوميًا لكنهم لا يبنونها: مديرو الحسابات، ومستشارو الحلول، ومحللو العمليات، ومديرو البرامج، وأدوار مشابهة. جاءت موافقة الإدارة أولًا. أطلعنا قادة الفرق على الالتزام الزمني (أربع ساعات أسبوعيًا لمدة ستة أسابيع) وقدمناه كاستثمار في الإتقان وجودة النقاش، وليس كعبء يشتت عن أدائهم اليومي.
أدار البرنامج أربعة أعضاء من الفريق الأساسي بالإضافة إلى مرشدين شغّلوه إلى جانب مهامهم الوظيفية اليومية. وهذه نقطة أساسية لقابلية التكرار: لا يتطلب هذا فريقًا مخصصًا للبرنامج، لكنه يتطلب شخصًا واحدًا على الأقل يتمتع بثقة تنظيمية كافية لحماية وقت المشاركين.
المرحلة 1: تكوين الفرق والانطلاق
ما يفعله المشاركون: تشكيل فرق من 3–4 أفراد بمستويات خبرة متباعدة عمدًا. تحدد الفرق بيان مشكلة مرتبطًا بسيناريو حقيقي واجهوه في أدوارهم.
ما ينتج عن ذلك: مفهوم مشروع محدد النطاق يمكن عرضه في استعراض توضيحي، وهيكل مساءلة للفريق.
لماذا يهم هذا قبل الانتقال: دون مشكلة ملموسة لحلها، تصبح جلسات التمكين مجردة. الفرق التي تحدد حالة الاستخدام المستهدفة أولًا تستوعب المحتوى التقني بهدف واضح.
المرحلة 2: التمكين
ما يفعله المشاركون: حضور جلسات تدريب مباشرة حول مفاهيم الذكاء الاصطناعي الوكيل وأدوات AWS. هذه ليست محاضرات. يعمل المشاركون داخل الأدوات الفعلية التي سيستخدمونها في مرحلة البناء، ومنجزين تمارين منظمة تحاكي أعمال مشروعهم.
ما ينتج عن ذلك: إتقان تقني أساسي وبيئة عمل محلية جاهزة.
لماذا يهم هذا قبل الانتقال: الفرق التي تنتقل مباشرة إلى البناء تصطدم بعقبة عند إعداد البيئة والمفاهيم الأساسية. هذه المرحلة تتجنب نقطة الانسحاب الأكثر شيوعًا.
المرحلة 3: التفكير والبناء والتطوير
ما يفعله المشاركون: تصميم النماذج الأولية العاملة وتحسينها عبر تكرارها على مدى عدة أسابيع. يقترن كل فريق بمرشد متمكن تقنيًا يوفر شبكة أمان، ويعالج مشكلات البنية التحتية ويقترح أنماطًا معمارية دون أن ينوب عنهم في العمل.
ما ينتج عن ذلك: نموذج أولي وظيفي يمكن عرضه على صاحب مصلحة أو عميل.
لماذا يهم هذا قبل الانتقال: يسمح الجدول الزمني الممتد بـ 2–3 دورات تكرار. الفرق التي بنت نموذجًا أوليًا في الأسبوع 3 كان لديها وقت لتطبيق ما تعلمته حديثًا باستمرار، وهدمه، وإعادة بنائه بشكل أفضل في الأسبوع 5. وهذه الدورة التكرارية هي حيث يحدث التعلم الحقيقي.
المرحلة 4: التحكيم والعروض التوضيحية
ما يفعله المشاركون: تقديم عروض توضيحية مباشرة تُقيَّم عبر خمس فئات: الأثر التجاري، والتميز التقني، وقابلية إعادة الاستخدام وقابلية التوسع، والابتكار، وجودة العرض.
ما ينتج عن ذلك: إثبات للقدرة مُعتمد من الأقران ومكتبة من النماذج الأولية القابلة لإعادة الاستخدام.
لماذا هذا مهم: يعكس تنسيق العرض التجريبي ما سيقوم به المشاركون في محادثات حقيقية مع العملاء والقيادة والشركاء متعددي التخصصات. وتؤكد معايير التحكيم أن أن يكون الشيء قابلًا للتشغيل لا يكفي؛ بل يجب أن يكون مؤثرًا وقابلًا للتوسع ومُبلَّغًا عنه بوضوح.
قرارات التصميم الحاسمة
اختيار الأدوات هو القرار الأكثر أهمية للبنّاءين الذين ليسوا مهندسين. فالأدوات الخاطئة تخلق احتكاكًا يوقف الزخم، بينما الأدوات الصحيحة تجرّد البنية التحتية وتلبي الناس عند مستوى خبرتهم الحالي. اخترنا:
- Kiro بيئة تطوير متكاملة (IDE) للتطوير باللغة الطبيعية: تصف ما تريده، وهي تبني هيكل المعمارية.
- Amazon Bedrock للوصول إلى النماذج الأساسية عبر واجهة برمجة التطبيقات المتوفرة في تلك المنطقة: لا حاجة إلى خبرة في تعلم الآلة (ML) للحصول على استجابة عملية من نموذج.
- Strands Agents SDK لأنماط الوكلاء القابلة للتركيب: يتكوّن الوكلاء مثل قطع البناء.
- خوادم AWS Model Context Protocol (MCP) ووكلاء AWS Lambda لدفع الفرق نحو معماريات قابلة للنشر وجاهزة للإنتاج، وليس مجرد دفاتر محلية.
المبدأ الجوهري لم يتغير أبدًا: أن تبني شيئًا حقيقيًا يمكنك عرضه في عرض تجريبي بإشعار قصير.
إدارة تعطيل العمل اليومي
حدّدنا عمدًا سقف الالتزام الأسبوعي عند أربع ساعات، ومنحنا المشاركين مرونة في تحديد توقيت هذه الساعات. كانت التعليقات الأكثر شيوعًا أن المشاركين طبّقوا ما كانوا يتعلمونه مباشرة في عملهم خلال أول أسبوعين، مما جعل استثمار الوقت يبدو إضافيًا لا متنافسًا.
النتائج
يقارن الرسم البياني التالي تقييمات المشاركين الذاتية قبل البرنامج وبعده عبر ثمانية مقاييس رئيسية، تشمل الكفاءة في الذكاء الاصطناعي، واعتماد الأدوات، والجاهزية لتطبيق ما تعلموه مع العملاء.
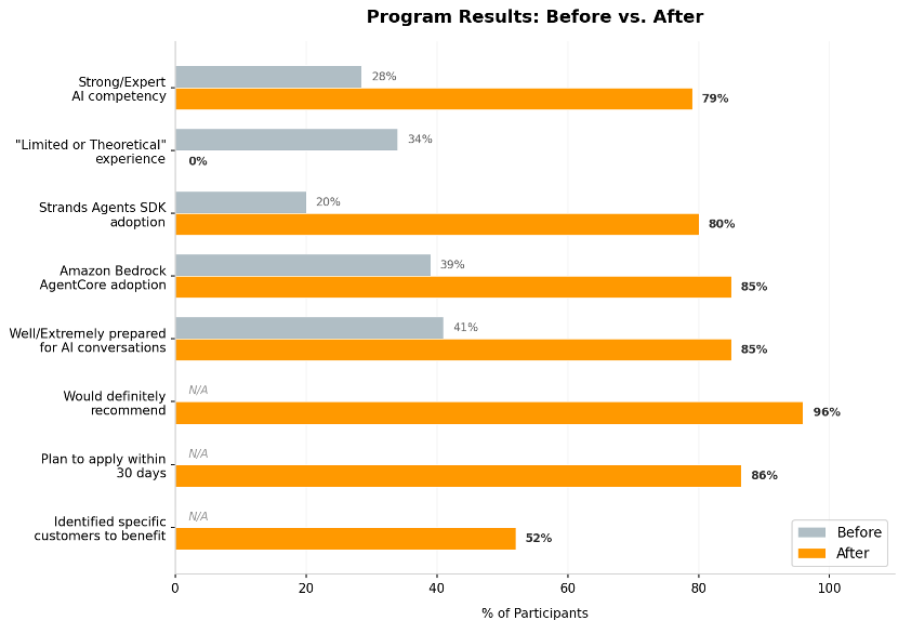
الشكل 2: تقييمات المشاركين الذاتية قبل البرنامج وبعده
قبل البدء، أشار المشاركون إلى "غياب الأمثلة الواقعية" باعتباره العائق الأكبر أمام بناء حلول بالذكاء الاصطناعي. وبعد الانتهاء، قيّم 23 نقطة مئوية (pp) إضافية من المشاركين أنفسهم بأنهم واثقون في تطبيق الذكاء الاصطناعي على حالات استخدام عملية مقارنة بما كان متوقعًا في البداية. غادر المشاركون البرنامج ولديهم نموذج أولي عامل، ومستودع أكواد، ومعمارية مرجعية يمكنهم عرضها على أصحاب المصلحة فورًا.
ما بنوه وما يقدمونه للعملاء:
- تنسيق الرعاية متعدد الوكلاء لمورّدي البرامج المستقلة (ISVs) في القطاع الصحي.
- أنظمة إشراف المحتوى وفرزه.
- تحديد الاحتيال ومنعه.
- التنبؤ بانسحاب العملاء ومنعه.
- تنسيق متعدد الوكلاء لاتخاذ القرارات المستقلة.
- عروض توضيحية لـ Kiro + Amazon Bedrock AgentCore لورش عمل العملاء.
الأثر: من المتفرجين إلى البناة
حين حصل مشاركونا على وصول عملي إلى أدوات الذكاء الاصطناعي، انتقلوا من مناقشة الإمكانيات إلى بناء نماذج أولية عاملة. الأرقام تحكي القصة:
- التقييم الذاتي بالفهم "القوي أو الخبير" للذكاء الاصطناعي الوكيل: ارتفع من 27 بالمئة إلى 82 بالمئة (+55 pp).
- الشعور بأنهم "مستعدون جيدًا أو مستعدون للغاية" لتحديد فرص الذكاء الاصطناعي: ارتفع من 41 بالمئة إلى 85 بالمئة (+44 pp).
- المشاركون ذوو الخبرة النظرية أو المحدودة فقط: انخفضوا من 34 بالمئة إلى 0 بالمئة (أُزيلت هذه الفئة تمامًا).
إليك ما يفتحه الاستثمار في هذا:
لفرقك: يتوقفون عن كونهم متفرجين للذكاء الاصطناعي ويصبحون بناة له. إنهم يعرفون ما هو ممكن، وما هو مكلف، وما يمكن بناؤه في عطلة نهاية أسبوع من خلال التجربة المباشرة. في دفعتنا، حدد 52 بالمئة من المشاركين عملاء محددين قد يستفيدون مما بنوه خلال البرنامج، وتوقع 87 بالمئة منهم تطبيق ما تعلموه مع العملاء خلال 30 يومًا. تجاوز البرنامج التوقعات في حالات الاستخدام العملية لأنه طالبهم بابتكار الأمثلة بأنفسهم.
لمنظمات الهندسة لديك: حين يستطيع نظراء الأعمال بناء النماذج الأولية وتوضيح مقايضات المعمارية، تقضي فرق الهندسة وقتًا أقل في ترجمة المتطلبات ووقتًا أكبر في البناء. يحصل البناة التقنيون على مدخلات أوضح، وطلبات أقل انحرافًا، وشركاء يمكنهم اختبار الجدوى قبل الالتزام بأي سباق تطوير واحد. خذ بعين الاعتبار: غادر 82 بالمئة من المشاركين بفهم قوي لمعمارية الذكاء الاصطناعي الوكيل. وارتفعت الطلاقة على الأدوات عبر الحزمة بأكملها: انتقلت Strands Agents SDK من اعتماد بنسبة 20 بالمئة إلى 80 بالمئة (+60 pp)، وانتقلت AgentCore من 39 بالمئة إلى 85 بالمئة، مما رفع سقف الحُكم الهندسي.
لعملائك: يحصلون على شركاء اجتازوا مقايضات المعمارية نفسها التي يواجهونها بفضل خبرة مباشرة وعملية. تنتقل المحادثات من "سأعود إليك لاحقًا" إلى عروض توضيحية مباشرة. قبل البرنامج، أشار 44 بالمئة من المشاركين إلى عدم اليقين بشأن أنماط المعمارية باعتباره عائقًا. بعد البرنامج، شعر 90 بالمئة منهم بأنهم مستعدون جيدًا أو أكثر لتحديد فرص الذكاء الاصطناعي في محادثات العملاء الواقعية.
لمؤسستك: تحصل على نموذج قابل للتكرار ومتراكم التأثير. إن توسّع برنا��جنا التجريبي من فريق واحد إلى نشر إقليمي ثم عالمي يُظهر النمط: الطلاقة العملية توسّع نفسها بنفسها. حقق البرنامج معدل توصية بنسبة 100 بالمئة، مع قول 95 بالمئة من المشاركين إن البرنامج حقق التوقعات أو تجاوزها.
سبعة دروس لتكرار هذا في مؤسستك
تستوعب هذه الدروس السبعة ما جعل البرنامج ناجحًا وما يجب تكراره في مؤسستك.
1. اختيار الأدوات يغيّر كل شيء
التجارب الوكيلة منخفضة الكود تزيل عائق "أنا لست تقنيًا بما يكفي". هذا قرار في تصميم البرنامج، وليس فكرة لاحقة لعمليات الشراء. إذا كانت أدواتك تتطلب إتقان Python، فقد خسرت نصف الحضور قبل الأسبوع الأول.
2. البناء المنظم يتفوق على الحماس اللحظي
برنامج مرحلي (6 أسابيع) بمعالم واضحة يتفوق على سباق يومين مكثف للجمهور غير التقني. توقع أن يبدو الأسبوع الأول بطيئًا. التراكم يأتي بعد ذلك.
3. الإرشاد هو مضاعِف النتائج
إقران المشاركين غير التقنيين بموجهين ذوي كفاءة تقنية يزيل الخوف من الفشل ويسرّع التعلم. الموجه لا يبني عنهم، بل يوفر شبكة أمان.
4. ابنِ شيئًا حقيقيًا
اشتراط نماذج أولية عاملة مع مستودعات أكواد وهندسات مرجعية (لا عروض شرائح) يجبر على التفاعل العميق مع الأدوات. لا يمكنك التمويه في عرض مباشر. هذا ما يفرق الهاكاثون عن دورة تدريبية.
5. القياس قبل وبعد
تُظهر تقييمات الكفاءة قبل وبعد الأثر الذي أحدثه البرنامج وتبني حالة العمل للتوسع. الثقة المُعلَنة ذاتياً مفيدة، لكن التحول من خبرة عملية "محدودة" إلى "واسعة" هو ما يهم حقاً.
6. اجعله قابلاً للتكرار
يحوّل دليل التشغيل الموثّق جيداً (إرشادات المشاركين، معايير التقييم، أطر إقران الموجهين، أدلة إعداد البيئة) حدثاً لمرة واحدة إلى برنامج قابل للتوسع.
7. أنشئ الأمان النفسي أولاً
عندما لا يخاف الناس من الفشل، يبنون أشياء لم يعتقدوا يوماً أن بإمكانهم بناءها. ذكر الفريق الفائز مبدأ "التعلم قبل الفوز" كمبدأه الأول. وقد أسس كل فريق ناجح الثقة قبل كتابة التعليمات البرمجية.
ابدأ الآن
دليل التشغيل ومعايير التقييم وأدلة إعداد البيئة متاحة للفرق الراغبة في تكرار هذا النموذج. تواصل مع أحد المؤلفين لمعرفة المزيد عن إدخال هذا الإطار إلى مؤسستك.
اعرف المزيد عن Amazon Bedrock | Kiro IDE | Strands Agents SDK