
من نظرة سريعة
- التحكم في الوكيل الذاتي للتعلم العميق: تقدم معهد مايكروسوفت للأبحاث في آسيا نموذجًا تدريبيًا يتم فيه مشاركة الوكيل نفسه المستخدم في التشغيل مشاركًا مباشرًا في التعلم المعزز، مما يلغي الحاجة إلى إعادة تنفيذ الوكيل داخل إطار التدريب.
- خفيف من حيث التصميم: يقدم برنامج Agent Lightning v1.0 طبقة تحكم كاملة للعامل من نوع RL في حوالي 3,500 سطرًا من الكود.
- دعم كوينتيس كيبل أصلي: تعمل الوكالات كأعمال قياسية في كوينتيس، سواء على مجموعات مُدارة ذاتياً، أو كوينتيس السحاب، أو البنية التحتية المحلية، دون أي اعتماد على خدمات الصندوق الخاص المدفوعة.
- وصفة التدريب الفعالة من حيث البيانات: نظام عملية تدريب برمجي يغطي الطريق من البداية إلى النهاية، أدى إلى تحسين Qwen3.5-9B من 41.8% إلى 56.4% Pass@1 على SWE-bench Verified، أي زيادة بنسبة 14.6 نقطة مئوية، باستخدام حوالي 6,000 عينة تدريب فقط بناءً على مجموعة البيانات المفتوحة.
تطورت وكالات الذكاء الاصطناعي من نماذج فردية إلى أنظمة كاملة متعددة الطبقات معقدة، مكونة من نماذج وأدوات وبيئات تنفيذ. وتعتمد قدراتها بشكل متزايد على الجهاز الذي يُحكمها من خارج النموذج. تعتبر التعلم الترويجي طريقة تستخدم فيها أنظمة الذكاء الاصطناعي لتعلمها من خلال التجربة والخطأ، بإرشاد من المكافآت والعقوبات لأفعالها. يمكن لـ RL أن يجعل تلك الوكلاء أفضل، لكن معظم أنظمة RL للوكلاء تتطلب من المطورين إعادة تنفيذ الوكيل داخل إطار التدريب. وهذا مكلف، ويعني أن الوكيل الذي يتم تدريبه ليس بالضبط الوكيل الذي يتم توزيعه.
لحل هذه المشكلة، قدم باحثون من معهد مايكروسوفت للأبحاث في آسيا نموذج تدريب RL العملياتي القائم على الوكالات، وفتحوا ملف Agent Lightning v1.0 (يُفتح في علامة تبويب جديدة) مُعاد بناؤه بالكامل. مقارنةً بالنسخة الأصلية، يركز Agent Lightning v1.0 أكثر على الخفة، ودمجه مع الوكالات الحقيقية، وعلى سيرورة تدريب RL للوكالات الكاملة والقابلة للتكرار.
تم إعادة بناء وكيل Lightning v1.0 على أساس Harnessed Agentic RL، مع تحسينات رئيسية:
- خفيف الوزن: الإطار الكلي يتكون من حوالي 3,500 سطرًا من الكود. تطبيق Agent Lightning v1.0 يحتوي على نظام RL للعوامل الكامل، ويتم تنظيم الكود بشكل صغير وواضح بما يكفي للفهم والتعديل والتوسيع.
- التدريب على أداة العملية الحقيقية: تصل الوكالات إلى النموذج من خلال وسيط النموذج اللغوي الكبير (LLM) في Agent Lightning v1.0، مع البقاء على كود الأداة الحالي دون تغيير.
- دعم أصلي لكوبرنتيس: التطبيقات تُشغَل مباشرة كمهام كوبرنتيس، دون الحاجة إلى خدمات سحابية تجارية خارجية. يمكن للتجمعات التي تديرها بنفسها والبنية التحتية المحلية أن تدعم الإطلاقات على نطاق واسع.
- مثال كامل لتدريب عامل البرمجة: دورة شاملة مبنية على Qwen3.5-9B، حيث ارتفعت نقاط Pass@1 في SWE-bench Verified من 41.8% إلى 56.4%، بمقدار مطلق قدره 14.6 نقطة مئوية، باستخدام حوالي 6,000 عينة تدريب فقط.
حدود الذكاء الاصطناعي التقليدي للأجهزة العميلية
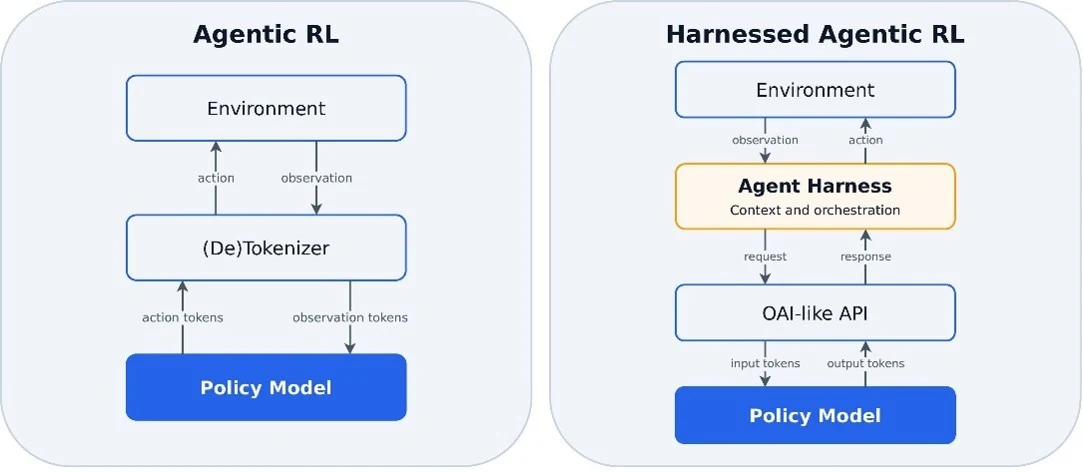
تفترض النماذج التقليدية للتعلم العميق القائمة على الوكلاء أن إطار التدريب يمتلك حلقة التفاعل مع البيئة. في حلقة من نوع ReAct، يقوم النموذج بإنتاج تحرك، بينما يعيد البيئة إرسال ملاحظة، وتُضاف الملاحظة إلى السياق، ثم يقوم النموذج بإنتاج تحرك آخر، بحيث يتطابق العمل الكلي على مسار نصي متصل واحد. تم بناء أنظمة التعلم العميق مثل verl و AReaL و slime بهذه الطريقة، مما يعني أن تدريب الوكيل يتطلب إعادة بناء حلقة التفاعل داخل إطار التعلم العميق.
لقد تخطى الأشرطة الحقيقية هذا الافتراض. فمحطات البرمجة مثل mini-SWE-agent، OpenHands، OpenCode، Claude Code، وCodex تجلب كل منها إدارة سياق خاصة بها، بروتوكولات أدوات، منطق تنفيذ، واعتمادات، تمامًا كما يفعل أنظمة العملاء العامة. إن إعادة بناء واحدة منها لأغراض التدريب مكلفة، وقد لا تكون المحطة المُعاد بناؤها تتصرف بالطريقة نفسها التي كانت عليها المحطة المنشورة.
يتخذ عامل البرق طريقًا مختلفًا. يضع وسيط LLM بين العامل والنموذج. يستمر العامل في العمل كما كان من قبل: فقط ضع نقطة النهاية التي كانت تستدعي واجهة برمجة التطبيقات للنموذج على عامل البرق، ويمكن لإطار عمل التدريب أن يلاحظ ويسجل استدعاءات النموذج. في الإصدار 1.0، يذهب الباحثون إلى أبعد من ذلك ويعرّفون هذا النموذج رسميًا بأنه "الأداة المستخدمة للتعلم العميق القائم على الأنظمة": أي أداة يتم استخدامها في التشغيل هي التي تشارك مباشرة في التعلم المعزز أثناء التدريب (الشكل 1).
أربعة تحديات في التدريب باستخدام حزامات حقيقية
الفرق الأساسي بين RL البشري المُدار وRL البشري التقليدي هو أن دورة تفاعل البيئة يتم التعامل معها بواسطة الجهاز البشري المُدار بدلاً من إطار التدريب. لا يمكن لنظام التدريب سوى مراقبة سلسلة من أزواج طلب واستجابة للنموذج اللغوي الكبير، لذا قد يتم تقسيم عملية التدريب إلى عدد متغير من عينات التدريب. وهذا يخلق أربعة تحديات رئيسية:
- إعادة توليد المفاتيح ودمج العينات: يحافظ على السياق كنص، لكن تدريب الذكاء الاصطناعي يتطلب أرقام المفاتيح المُسحت خلال التدريب. قد يؤدي تمرير النص عبر قالب الدردشة ومُعايرة الكلمات إلى تغيير حدود الكلمات، لذا لا يمكن دمج الاتصالات المتجاورة دائمًا في عينة واحدة.
- حساب الميزة: يمكن لإعادة توليد الأدوار، والوكلاء الفرعيين، وتلخيص السياق أن يفصل إطلاقًا واحدًا إلى عدة عينات. فحساب الأساسيات والمزايا مباشرة على مستوى العينة يؤدي إلى إطلاقات تنتج المزيد من العينات التي يتم احتسابها مرارًا، مما يغير العلاقات الإحصائية الأصلية على مستوى الإطلاق.
- تطبيع الخسارة: يتم توسط الخسارة حسب عدد العينات، مما يعطي وزنًا أكبر للإصدارات التي تنتج المزيد من العينات. وبما أن عدد العينات غالبًا ما يكون مجرد نتيجة لسلوك الجهاز، يجب على تطبيع الخسارة أيضًا تجنب التشويه الناتج عن ذلك.
- تدريب جدولة الخلفية: لا يُعرف عدد العينات وطولها إلا بعد انتهاء العملية، بينما عادةً ما تكون أعداد GPU والتركيبات المتوازية للبيانات/التنس محددة. يجب على الخلفية أن تُحوّل حمل العمل المتغير إلى موارد ثابتة.
Spotlight: نشرة إخبار أبحاث مايكروسوفت
نشرة بحث مايكروسوفت
اشترك اليومبناء طبقة تحكم RL للعامل الكامل بـ 3,500 سطرًا من الكود
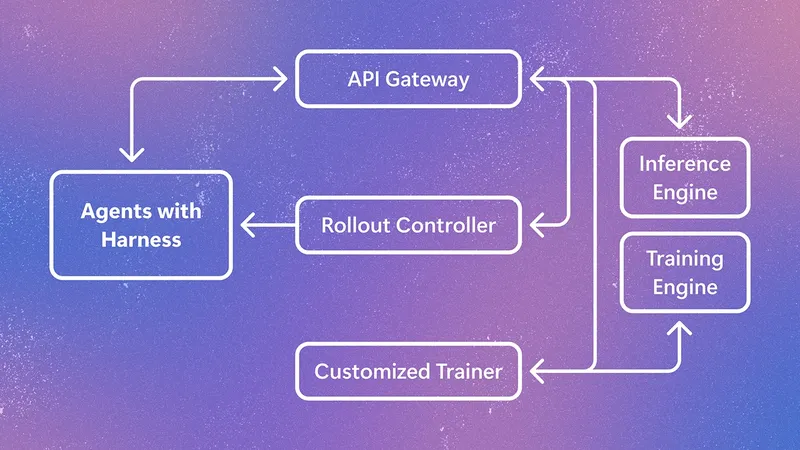
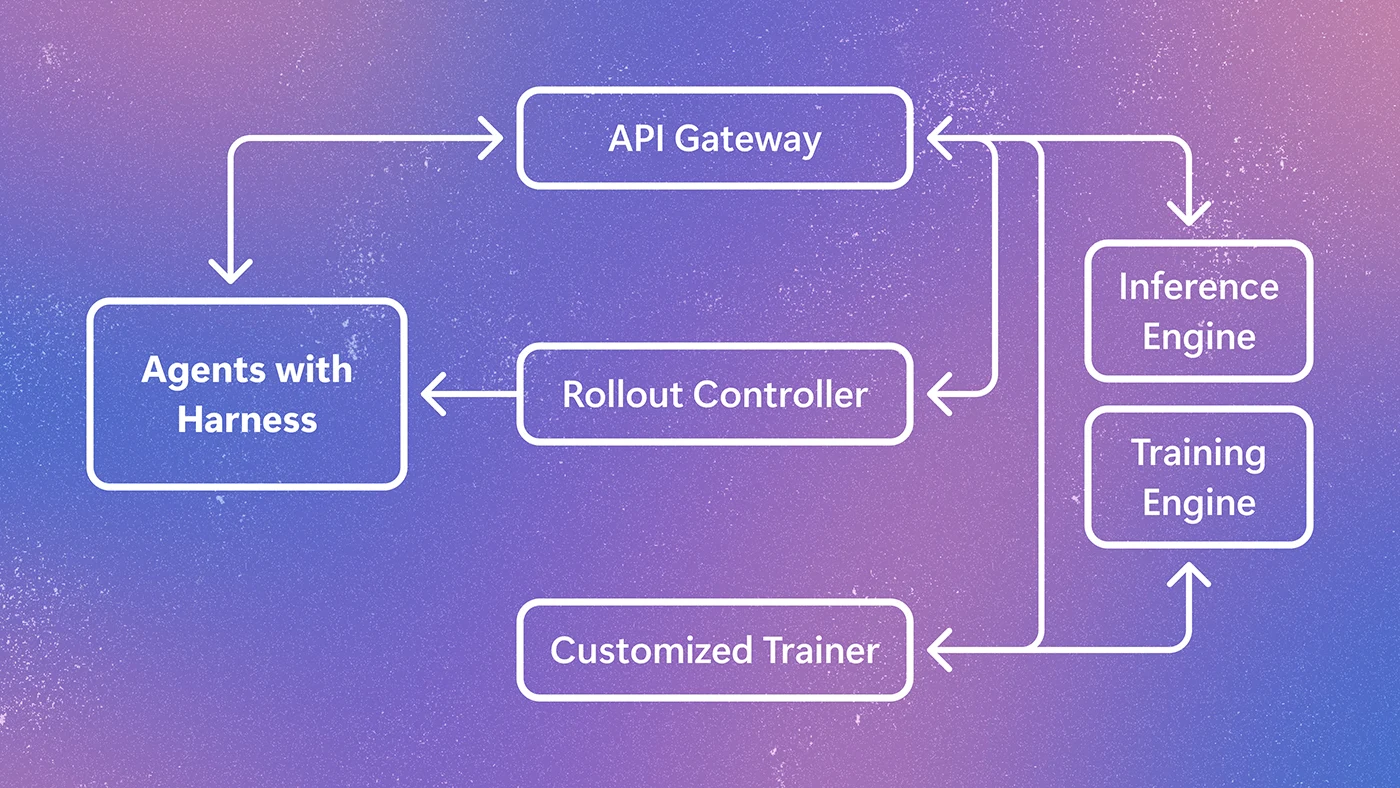
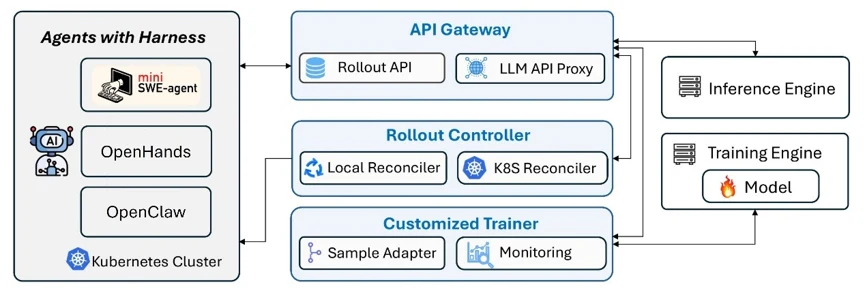
في تصميم النظام، يعتبر برنامج Agent Lightning v1.0 السهولة مبدأه الأولي. يبلغ طول الإطار الكلي حوالي 3,500 سطرًا من الكود، ويحتوي على ثلاثة مكونات أساسية: بوابة API، ومراقب التطبيق، والمدرب المخصص (الشكل 2).
يخزن واجهة API التطبيقات، والنماذج، والأحداث، ويكون كواسيًا لـ LLM المتوافق مع OpenAI. يربط كل استدعاء لنموذج من الجهاز بعملية التطبيق الخاصة به، ويسجل التعليمات، والإجابات، وحظائع السجل التي يحتاجها التدريب. يقوم مُدير التطبيق بتشغيل وإدارة تنفيذ الوكيل، سواء كعمليات محلية أو كوظائف قياسية في Kubernetes، مع الحفاظ على تنفيذ الوكيل منفصل عن مُدرب التدريب. المُدرب المخصص، الذي تم بناؤه على منصة Verl، يقوم بإنشاء عمليات التدريب، وينتظر انتهاء هذه العمليات، ثم يجمع العينات، ويجمع العينات النهائية للتدريب من خلال محول العينات. ونتيجة لذلك، بالنسبة لجهاز التدريب الموجود، فإن توجيه نقطة نهاية النموذج إلى وسيط Agent Lightning يكفي عادةً للتوصيل السريع مع تدريب RL.
متوافق مع RL غير متزامن
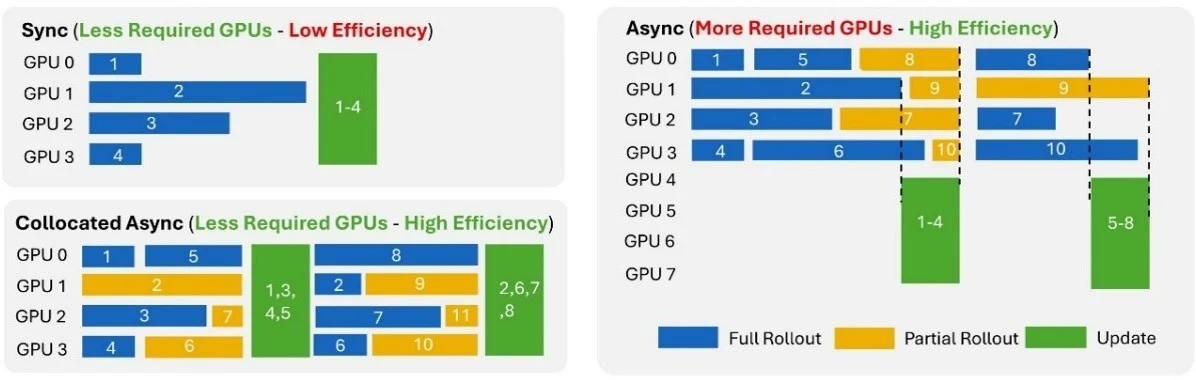
تختلف أوقات التطبيق على المستويات المختلفة للأجهزة. يمكث التعلم العميق المتزامن في انتظار أضعف جهاز في الدفعة، مما يجعل GPU غير مستغلة، بينما يعمل التعلم العميق غير المتزامن بشكل كامل في زيادة الاستخدام، لكنه يتطلب مجموعات GPU منفصلة للتطبيق والتدريب. استجابةً لذلك، يقدم Agent Lightning v1.0 نظام التعلم العميق غير المتزامن الموجود في نفس المكان، الذي يسمح لعملية التطبيق وتحديث النموذج بالاستفادة من نفس مجموعة GPU.
بمجرد أن يجمع النظام عددًا كافيًا من الطلبات، تبدأ عملية التحديث: يقوم بوابة API Gateway بتوقف استقبال الطلبات الجديدة وينتظر انتهاء الطلبات التي قيد التنفيذ، ويستأنف النشر بعد اكتمال التحديث. يكون التحول الكامل في الحالة شفافًا أمام الوكيل الخارجي. في التجارب، حقق هذا النهج زيادة سرعة بنسبة حوالي 2 مرة على طول الرحلة مقارنة بالتنظيم الذاتي المتزامن، مع استخدام عدد أقل من وحدات GPU مقارنة بالتنظيم غير المتزامن التقليدي (الشكل 3).
تشغيل الوكالات على كوينتيسلوس
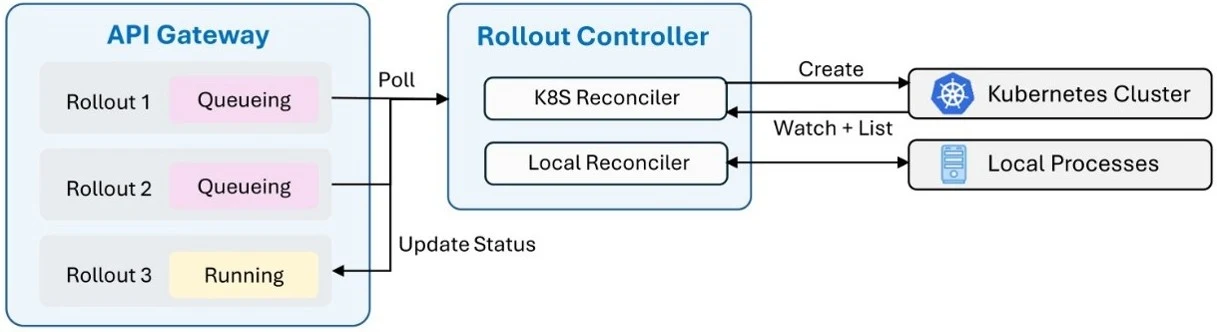
جمع عدد كافٍ من التطبيقات يعني تشغيل العديد من الوكلاء في نفس الوقت، مما يستهلك موارد وحدة المعالجة المركزية والذاكرة والموارد الحاسوبية الكبيرة. غالبًا ما تستضيف أطر RL العمليات الهرمية الهرمية المستخدمة هذه الوكلاء على خدمات الساندبوك التجارية مثل Modal Sandbox أو E2B، حيث يزداد التكلفة بسرعة مع الزيادة في الحجم. بدلاً من ذلك، يعمل Agent Lightning v1.0 عليهم كأعمال قياسية في Kubernetes، مما يسمح بإعادة استخدام المجموعات المحلية التي تم إدارتها بشكل مستقل أو البنية التحتية السحابية (الشكل 4). تُستخدم موارد الحوسبة الموجودة بشكل أكثر كفاءة، وتكون تكاليف الإطلاقات الكبيرة أقل، كما يظل الطريق الكامل للتطوير مفتوح المصدر وقابلًا للتكرار.
6,000 عينة تدريب، مكسب في الأداء بمقدار 14.6 نقطة
لاختبار النهج، بنى الباحثون خطوة كاملة على SWE-smith، mini-SWE-agent، وQwen3.5-9B، وتضمنت الخطوة تنظيف البيانات، إنشاء البيئة، إجراءات حماية من الهجمات على المكافآت، وتدريب نمذجة الذكاء الاصطناعي. يحتوي مجموع التدريب على حوالي 6,000 عينة ولا حاجة إلى حوسبة كبيرة. تدريب نمذجة الذكاء الاصطناعي بمفرده رفع نسبة Qwen3.5-9B من 41.8% إلى 56.4% على SWE-bench Verified، بزيادة قدرها 14.6 نقطة مئوية.
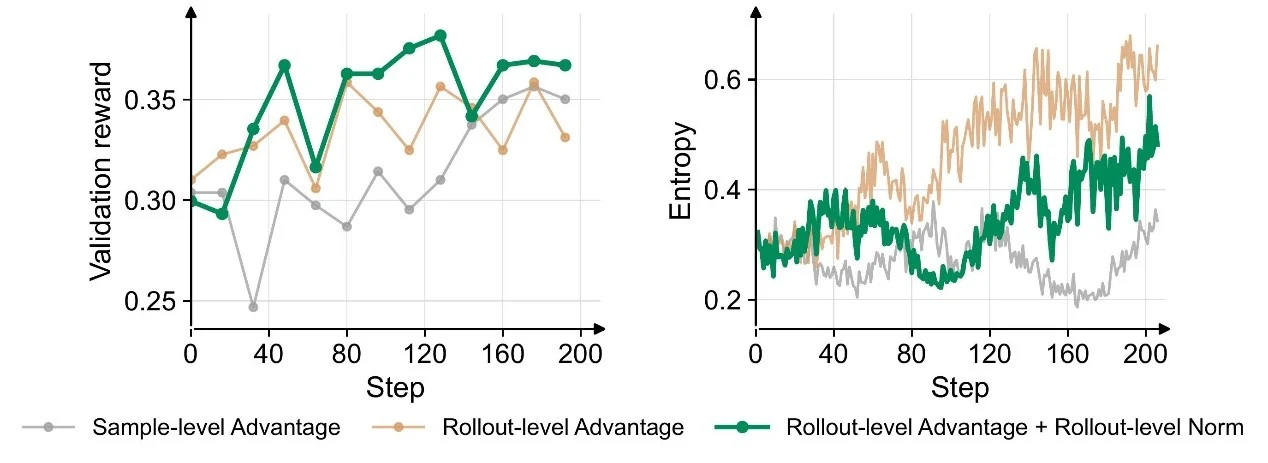
تؤكد التجارب الإضافية للعامل الترميزي التحليل السابق لصعوبتين: حساب الميزة وتنظيم الخسارة. مقارنةً مع التعامل على مستوى العينات، فإن الميزة على مستوى النشر المشترك مع تنظيمه على مستوى النشر يحققان مكافأة التحقق الأعلى ويحافظان على استقرار الهرمزية للسياسة أثناء التدريب (الشكل 5).
المنشور Agent Lightning v1.0: إطار عمل RL الخفيف بـ 3,500 سطرًا لتدريب العوامل مع أجهزة حقيقية ظهر لأول مرة في Microsoft Research.