
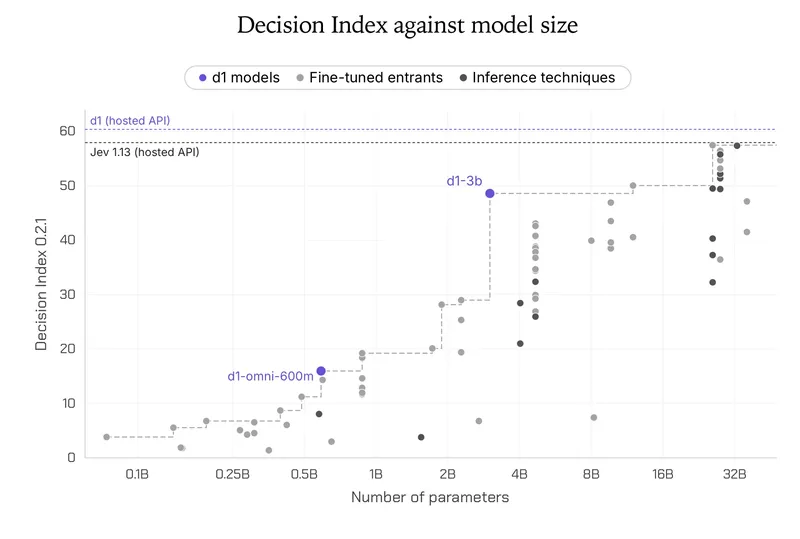
اليوم، نطلق نموذجي قرار مفتوحين في عائلة نماذج قرار d1: d1-3B و d1-omni-600M (تجريبي).
- أفضل نموذج قرار تحت 10B على مؤشر القرار Decision Index 0.2.1: تسجل d1-3B نتيجة 48.57، متقدمة على كل نماذج 4B و9B وعلى Decider 35B-A3B (47.11).
- متعددة الوسائط: تدعم d1-3B النصوص والصور، بينما تدعم d1-omni-600M النصوص والصور أو النصوص والصوت
- سريعة: تجيب d1-3B على سؤال في 16 ms على NVIDIA Jetson AGX Thor، وفي 26 ms على Jetson AGX Orin، وفي 50ms على Jetson Orin Nano
كيف بنينا نماذج قرار للأنظمة الطرفية
هذه النماذج المفتوحة d1 مبنية على نماذجنا Liquid Foundation Models (LFMs). وعلى عكس نماذجنا التوليدية، لا تنتج نماذج القرار رموزاً بل تجيب في تمريرة أمامية واحدة.
تم تدريب d1-3B وd1-omni-600M من هيكلين أساسيين مختلفين تماماً:
- d1-3B مدرَّب من LFM2.5-VL-3B، أحدث نماذج VLM لدينا، وهو من نوع decoder-only. يقبل النصوص والصور كمدخلات.
- d1-omni-600M مدرَّب من LFM2.5-Encoder-350M، وهو مشفّر ثنائي الاتجاه. يضيف مشفّرات رؤية وصوت للتعامل مع الوسائط الثلاث جميعها. يقبل إما نصاً وصورة، أو نصاً وصوتاً كمدخلات. هذا النموذج حالياً في إصدار بحثي مبكر وهو قيد مزيد من التطوير.
نتائج المقارنة المرجعية
أجرينا مقارنة مرجعية لـ d1-3B وd1-omni-600M على سبع مجموعات بيانات عامة تشمل فهم المقروء، وكشف السمية، وتصنيف النوايا، والأسئلة الطبية، والفهم عبر اللغات. تحقق d1-3B متوسط نتيجة 82.9، وهو الأعلى في الجدول وفوق Decider 4B. تسجل d1-omni-600M نتيجة 78.4، متجاوزةً Decider 2B (77.1) بربع المعاملات فقط.
| المقارنة المرجعية | d1-omni-600M | d1-3B | Decider 2B | Decider 4B |
|---|---|---|---|---|
| SQuAD 2.0 | 74.0 | 83.3 | 67.7 | 76.0 |
| Civil Comments | 95.8 | 93.3 | 93.6 | 92.8 |
| MASSIVE intent | 86.1 | 86.9 | 81.1 | 88.3 |
| PubMedQA | 61.3 | 68.3 | 65.7 | 63.3 |
| BoolQ | 77.7 | 86.3 | 87.3 | 89.0 |
| XNLI | 74.7 | 85.6 | 85.0 | 88.6 |
| PAWS-X | 79.5 | 76.4 | 59.5 | 69.8 |
| المتوسط | 78.4 | 82.9 | 77.1 | 81.1 |
تحققنا من أن d1-3B يحتفظ بقدرات الرؤية الخاصة بنموذج LFM2.5-VL-3B الأساسي على معايير الرؤية القياسية، وأن d1-omni-600M يتعامل مع الأنماط الثلاثة جميعها. لا نُبلّغ عن أي معايير للرؤية أو الصوت، نظرًا لأن Decision Index v0.3 يتضمن فقط شريحة رؤية خاصة، ومعايير القرار الصوتي لا تزال مشكلة مفتوحة حاليًا.
السرعة
بالتعاون مع NVIDIA، قيّمنا d1-3B على منظومة NVIDIA عبر NVIDIA GeForce RTX 4090 وNVIDIA Jetson AGX Thor وJetson AGX Orin 64 GB وJetson Orin Nano. وبما أن d1-omni-600M هو إصدار بحثي مبكر، فلا نُبلّغ عن أي أرقام سرعة له في هذا الإصدار.
الاستدلال على الأجهزة الطرفية. يجيب d1-3B على سؤال واحد في أقل من 50 ms على كل جهاز تم قياسه. ثلاثة أسئلة تستغرق 1.3x فقط من زمن السؤال الواحد، حيث ينتقل AGX Thor من 16 ms إلى 20 ms.
| سؤال واحد | 3 أسئلة | حالة بحجم 3.4K توكن | صورة بدقة 384px | 64 حالة، مضغوطة | |
|---|---|---|---|---|---|
| Apple M5 Pro | 30 ms | 41 ms | 640 ms | 62 ms | 78 / s |
| Jetson AGX Thor | 16 ms | 20 ms | 220 ms | 35 ms | 262 / s |
| Jetson AGX Orin بسعة 64 GB | 26 ms | 35 ms | 560 ms | 83 ms | 110 / s |
| Jetson Orin Nano | 50 ms | 73 ms | 1,640 ms | 202 ms | 38 / s |
استدلال على وحدة معالجة الرسومات. على وحدة معالجة الرسومات، يجيب d1-3B على سؤال في أقل من 10 ms ويعالج صورة بدقة 384px في أقل من 18 ms على المنصتين معًا.
| سؤال واحد | 3 أسئلة | حالة بحجم 3.4K توكن | صورة بحجم 384px | 64 حالة، مكدسة | |
|---|---|---|---|---|---|
| NVIDIA RTX 4090 | 8 ms | 21 ms | 102 ms | 17 ms | 475 / s |
| AMD MI325X | 9 ms | 14 ms | 44 ms | 18 ms | 1,106 / s |
كيفية استخدام نماذج القرار d1 المفتوحة
استخدم نماذج القرار d1 عندما تحتاج إلى قرارات سريعة ومنظمة، بما في ذلك المدخلات متعددة الوسائط. يقدم d1-3B أعلى جودة قرار في حجمه، بينما يناسب d1-omni-600M الحالات التي تهم فيها المساحة.
ثبّت التبعيات (يتطلب transformers>=5.14):
pip install "transformers>=5.14" torch torchvision pillow
هذه النماذج تأتي مع شيفرتها البرمجية الخاصة، لذا حمّلها باستخدام trust_remote_code=True:
import io
import urllib.request

import torch
from PIL import Image
from transformers import AutoModel

device = "cuda" if torch.cuda.is_available() else "mps" if torch.backends.mps.is_available() else "cpu"
model = AutoModel.from_pretrained("LiquidAI/d1-3B", trust_remote_code=True,
                                  dtype=torch.float32 if device == "cpu" else torch.bfloat16).to(device)

# Several named questions over one text state, answered in one pass
questions = {
    "refund": {"type": "noul", "instructions": "Is the customer asking for a refund?"},
    "team": {"type": "choice", "instructions": "Which team should handle this?",
             "criteria": {"billing": "Charges, refunds, invoices", "technical": "App or site faults",
                          "fraud": "Suspected unauthorised use"}},
    "urgency": {"type": "score", "instructions": "How urgent is this?",
                "criteria": ["Can wait", "Today", "Blocking the customer now"]},
}
print(model.system_one("I was charged twice this month, please refund one of them.", questions))

# An image as the whole state
url = "http://images.cocodataset.org/val2017/000000039769.jpg"  # two cats on a sofa
photo = Image.open(io.BytesIO(urllib.request.urlopen(url).read()))
print(model.system_one(None, {"cats": {"type": "choice", "instructions": "How many cats are there?",
                                       "criteria": {"one": "One", "two": "Two", "more": "Three or more"}}},
                       images=[photo]))

# Many requests, packed together with no padding
tickets = ["Where is my parcel? It was due Monday.", "The app crashes when I open settings."]
print(model.system_one_batch([(t, {"team": questions["team"]}) for t in tickets]))
للاختصار، ندرج فقط المثال الخاص بـ d1-3B. راجع بطاقة نموذج d1-omni-600M للحصول على تعليمات حول كيفية تشغيله.
ابدأ مع نماذج القرار d1 المفتوحة
كلا نموذجي القرار مفتوحا الأوزان ومتاحان اليوم على Hugging Face:
- التنزيل: d1-3B و d1-omni-600M على Hugging Face.
- الجرّب: شغّل العروض التوضيحية في System One Arcade مساحة Hugging Face الخاصة بنا.
لا نطيق الصبر لنرى ما ستبنيه.
اقتباس
إذا استخدمت هذا العمل، يُرجى الاستشهاد بمدونة الإصدار:
@article{liquidAI2026opend1,
  author  = {Liquid AI},
  title   = {Open d1: Edge decision models for text, vision, and audio},
  journal = {Liquid AI Blog},
  year    = {2026},
  note    = {www.liquid.ai/blog/open-d1},
}