
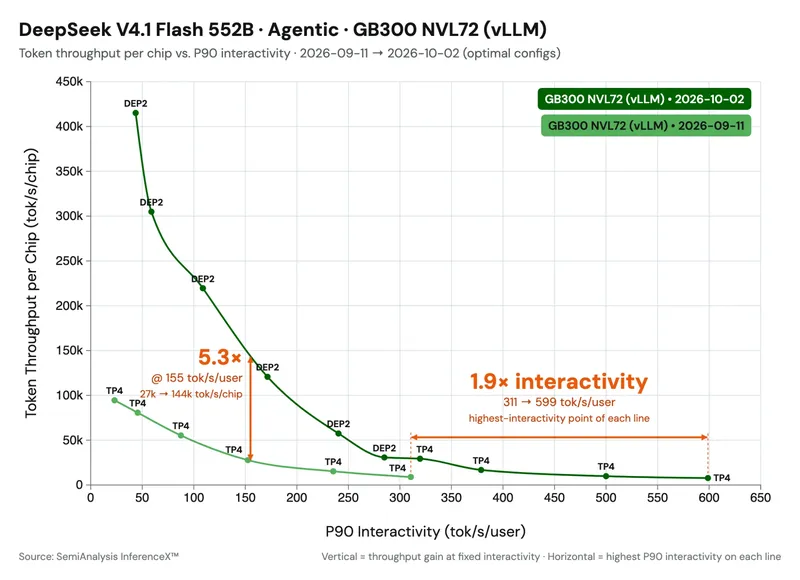
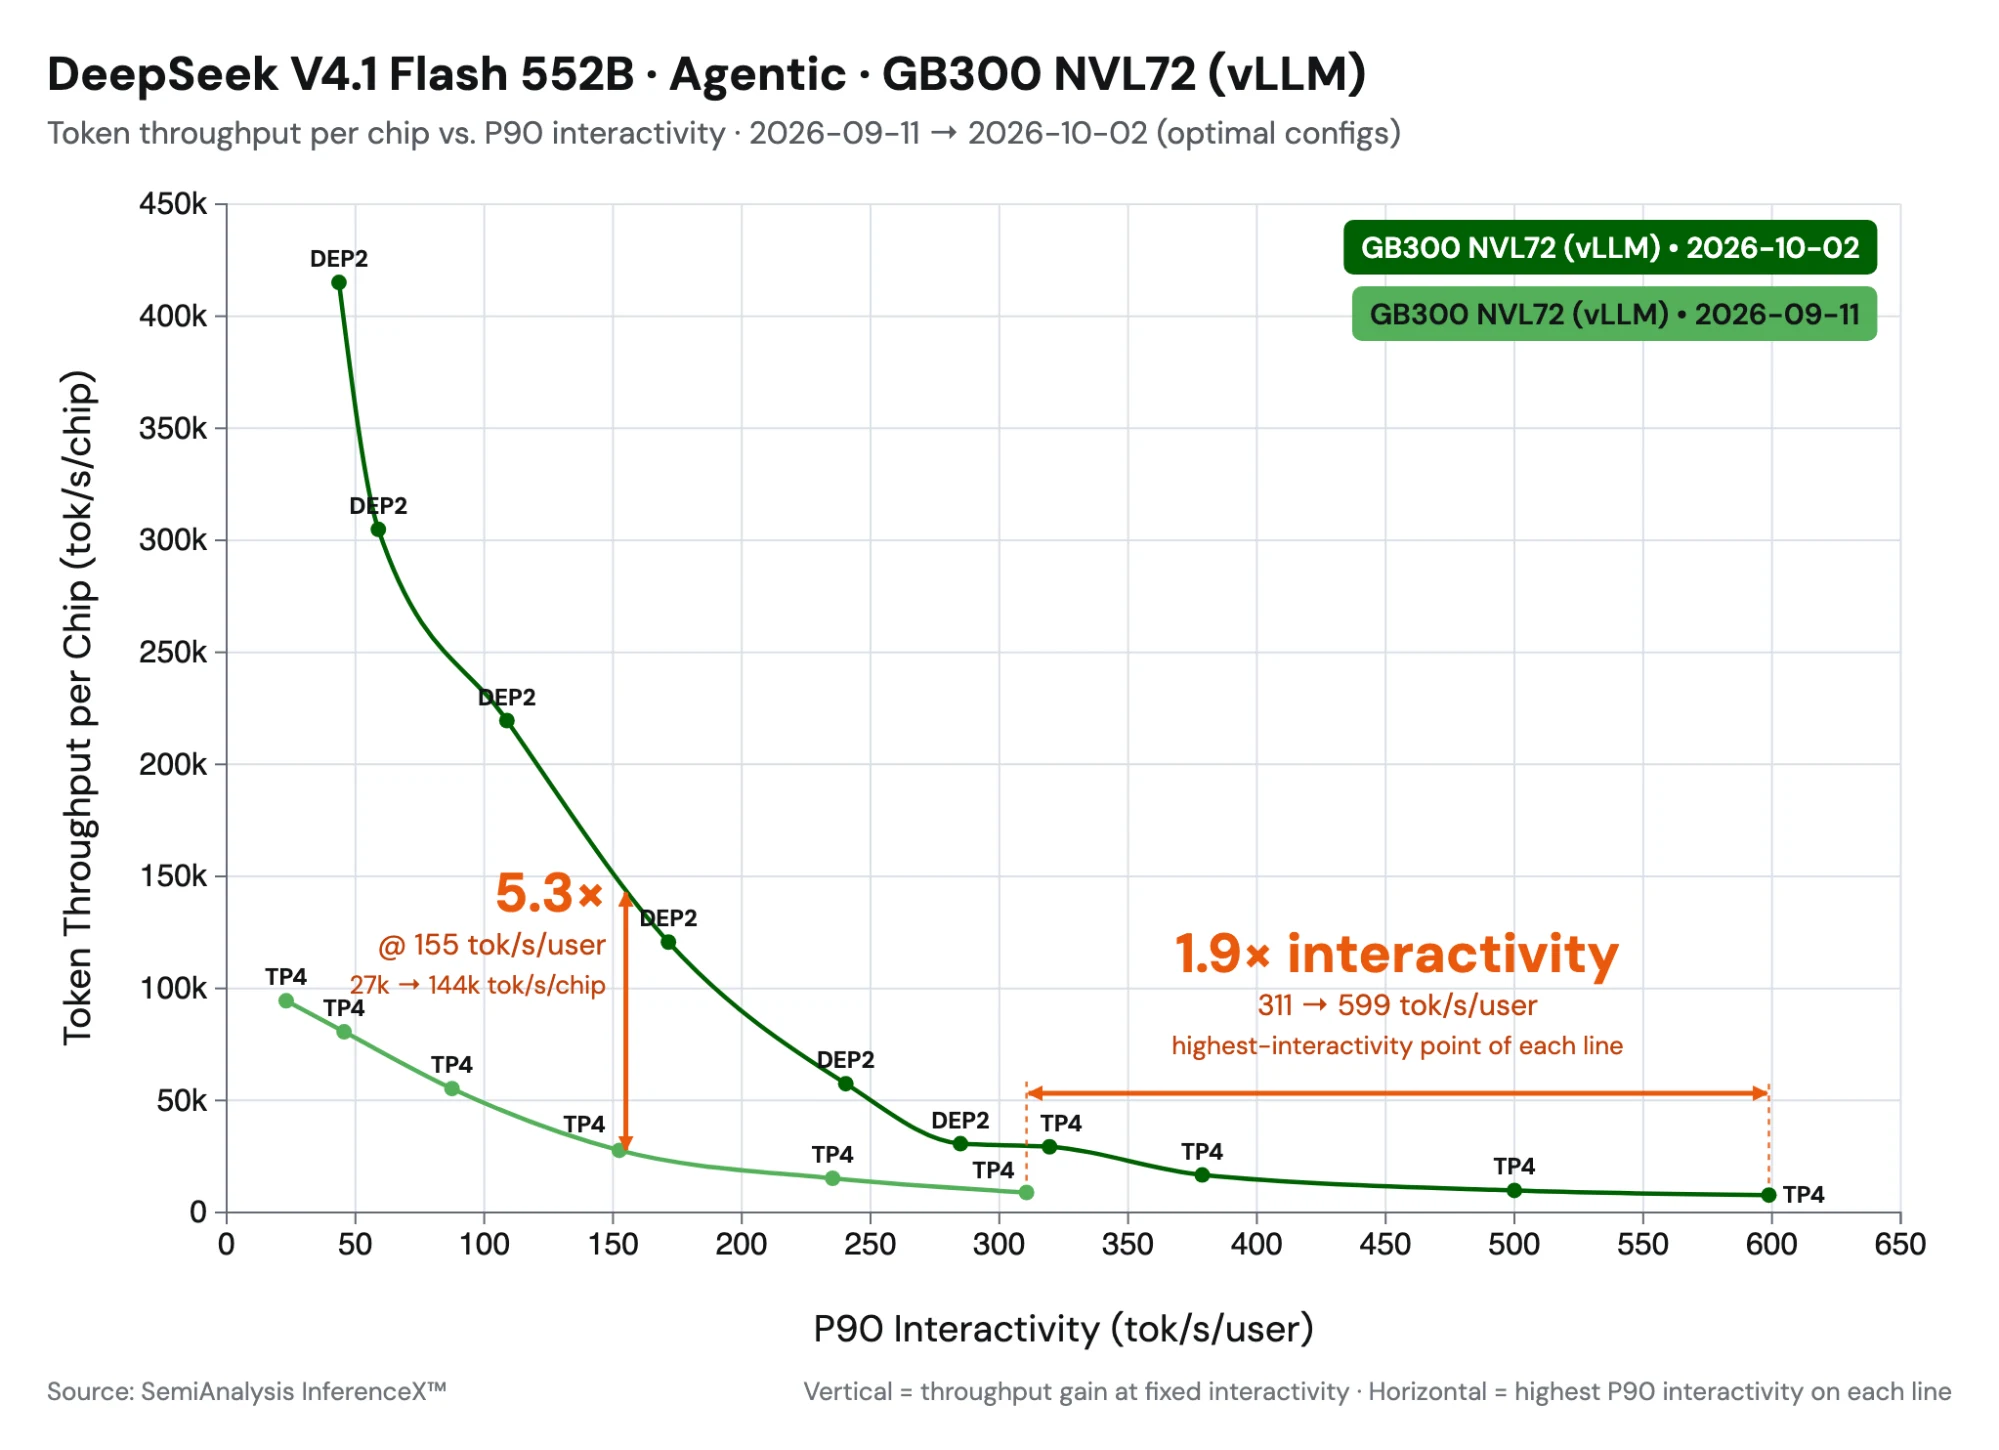
الخلاصة السريعة: في الأسابيع الثلاثة التي تلت إطلاق DeepSeek-V4.1-Flash، قامت Inferact ومجتمع vLLM بتحسين النموذج، محققين تسريعًا بمقدار 1.9× عند التزامن المنخفض وتحسينًا في الإنتاجية بمقدار 5.3× في ظل قيد 150 TPS. يأتي تحسين الأداء من:
-
نفّذنا إعادة تشغيل SWA المحدودة مع رسوم CUDA البيانية، محققين انخفاضًا في TTFT بنحو 30%.
-
دمجنا النوى التي أصدرتها DeepSeek حديثًا، بما في ذلك MegaAttention وMega-mHC وMega-Gate وDeepSelect.
-
دمجنا بقية النوى وجازيناها بشكل مكثف، بما في ذلك تدفقات mHC الجانبية، ودمجنا all-reduce مع العمليات السابقة واللاحقة لها في نواة واحدة.
يقدّم DeepSeek V4.1 بنية عالية الكفاءة لمهام الخدمة الوكيلة طويلة المدى: فمن خلال بنية المرمّز وفك الترميز السببية (CED)، يُنشّط النموذج 16B من المعاملات لكل رمز أثناء فك الترميز ولكن 8B من المعاملات فقط أثناء الترميز المسبق. كما يُعدّ النموذج فعّالًا للغاية في استهلاك الذاكرة. فهو يجمع بين عدة تقنيات لتقليص حجم ذاكرة KV المؤقتة: Compressed Sparse Attention 2 (CSA2)، وذاكرة FP4 KV المؤقتة، ومشاركة ذاكرة KV بين الطبقات، بما يدفع البصمة العالمية لذاكرة KV إلى 890 بايت لكل رمز. يوضح هذا المقال كيف نجمع بين هذه التحسينات على مستوى النموذج من DeepSeek مع تحسينات النظام على جانب vLLM لتحقيق إنتاجية أعلى بمقدار 5× على معيار الخدمة الوكيلة SemiAnalysis AgentX. نُبرز تحسيناتنا في فئتين: إعادة التشغيل المحدودة SWA والتحسينات المتعلقة بالنوى.
إعادة تشغيل SWA المحدودة
يحتفظ DeepSeek-V4.1-Flash بنوعين من ذاكرات KV المؤقتة. ذاكرة KV العالمية مضغوطة ومشتركة بين الطبقات ومخزنة بصيغة FP4، بحجم حوالي 890 بايت لكل رمز (تقرير V4.1). أما ذاكرة النافذة المنزلقة (SWA) KV فغير مضغوطة بصيغة FP8، وتغطي آخر 128 موضعًا في كل من الطبقات الـ 40.
تُنشئ ذاكرة SWA KV تكلفة اثنتين:
-
يجب على التخزين المؤقت للبادئة أن يخزّنها عند كل حد إصابة محتمل، بمكلفة تفوق 10 أضعاف مساحة تخزين ذاكرة KV العالمية.
-
يُشغّل الترميز المسبق الطبقات 21–39 على كل رمز من رموز الطلب، في حين يقرأ فك الترميز آخر 128 موضعًا منها فقط.
أحد الأساليب المباشرة هو إعادة حساب ذاكرة SWA KV بدلاً من تخزينها المؤقت. إلا أن إعادة الحساب الدقيقة مكلفة، لأن نافذة الـ 128 رمزًا لكل طبقة تعتمد على مواضع سابقة في الطبقة الأدنى، لذا فإن إعادة بنائها عبر L طبقات تعني إعادة تشغيل ما يقارب L × 128 رمزًا.
تُقدّم DeepSeek V4.1 ميزة إعادة تشغيل SWA المحدودة التي تستبدل الدقة بالكفاءة. فهي تُعيد تشغيل آخر 128 رمزًا فقط وتقتطع نافذة SWA عند بداية إعادة التشغيل. النتيجة ليست مطابقة بتًا ببت، لكن DeepSeek أعلنت عن فقدان جودة ضئيل (التفاصيل أدناه). يطبّق vLLM هذه الميزة في مكانين، واحد لكل تكلفة.
جانب المرمّز: إعادة بناء النافذة عند إصابة التخزين المؤقت
مع إعادة التشغيل على جانب المرمّز، يخزّن vLLM ذاكرة KV العالمية فقط ويتخطى ذاكرة SWA KV. عند إصابة بادئة بطول H، يُعيد تشغيل الرموز [H − 128, H) لإعادة بناء ذاكرة SWA KV، مع اقتطاع النوافذ عند s = H − 128.
جانب فك الترميز: تخطي معظم الترميز المسبق للطلب
في بنية CED لنموذج DeepSeek V4.1، تحسب الطبقة 20 ذاكرة KV العالمية لفك الترميز وتعيد الطبقات 21–39 استخدامها. لذلك يشغّل vLLM الطبقة 20 على كل رمز لإنتاج ذاكرة KV العالمية تلك، ويشغّل الطبقات 21–39 فقط على آخر 128 رمزًا من كل طلب. بالنسبة للطلبات الطويلة، يخطّي هذا ما يقارب نصف النموذج.
رسوم CUDA البيانية للطبقات المقتطعة
بعد الاقتطاع، تؤدي الطبقات 21–39 عملًا على وحدة GPU يكاد يكون معدومًا لدرجة أنه عند تشغيلها بحماس (eagerly) يطغى حمل إطلاق النوى وتبقى وحدة GPU خاملة. كما تختلف أشكال مدخلاتها عن الطبقات 0–20، لذا لا يمكن التقاط الجزأين في رسم CUDA بيانٍ واحد. رسم PIECEWISE القابل للكسر في vLLM يكسر النموذج أصلًا في منتصفه، مما يوفر تقسيمًا طبيعيًا: تُلتقط الطبقات 0–20 على الدفعة الكاملة، وتُلتقط الطبقات 21–39 بشكل منفصل على الدفعة المقتطعة. هذا يجعل رسوم CUDA البيانية قابلة للاستخدام في الترميز المسبق المقتطع، ويسمح للطبقات 21–39 باستخدام أحجام التقاط خاصة بها لتغطية أفضل للرسوم البيانية.
إعادة تشغيل SWA المحدودة مفعّلة افتراضيًا لـ DeepSeek-V4.1 ويتم التحكم فيها عبر --[no-]swa-bounded-replay.
نتائج الدقة والأداء
رغم أن إعادة تشغيل SWA المحدودة ليست دقيقة تمامًا، إلا أن DeepSeek أبلغت عن فقدان جودة ضئيل فقط. وقد أكّدنا هذا في vLLM على معايير تشمل GSM8K وGPQA ولاحظنا عدم وجود فرق دال في الدقة (فجوات ضمن حوالي 1.5 خطأ معياري).
على صعيد الأداء، يبادل جانب المرمّز نافذة ترميز مسبق واحدة لكل إصابة بمساحة تخزين مؤقت، لذا فإن التسريع يأتي من جانب فك الترميز. نقيس TTFT للترميز المسبق لطلب واحد في ثلاثة إعدادات: إعادة التشغيل معطلة؛ إعادة التشغيل مفعّلة بدون رسوم CUDA البيانية لفك الترميز (الطبقات 21–39 تعمل بحماس، وتُقتطع الخطوات الحماسية فقط)؛ وإعادة التشغيل مفعّلة مع رسوم CUDA البيانية لفك الترميز.
إعادة تشغيل فك الترميز مع رسوم CUDA البيانية تقتطع 30–40% من وقت حساب الترميز المسبق. تُعد رسوم CUDA البيانية الأكثر أهمية للطلبات القصيرة، حيث تمثل عمليات إطلاق النوى عنق الزجاجة: بدونها، يتجاوز حمل الإطلاق وفورات وحدة GPU وتصبح إعادة التشغيل أبطأ من خط الأساس (حتى +12% عند 1K على DEP2). أما للطلبات الطويلة، فإن عمل وحدة GPU كبير بما يكفي لإخفاء حمل الإطلاق، لذا تلتقط إعادة التشغيل الحماسية معظم المكسب وتضيف رسوم CUDA البيانية نقاطًا إضافية قليلة.
النوى
أصدرت DeepSeek نموذج DeepSeek-V4.1-Flash مع نوى جديدة في ثلاثة من مستودعاتها. DeepSelect هي مكتبة top-k جديدة لآلة DeepSeek Sparse Attention. وأضاف DeepGEMM نوى المفهرس المتناثر وعدة نوى دمج متعلقة بـ GEMM. وأضافت FlashMLA دعم ذاكرة NVFP4 KV المؤقتة ونواة انتباه مدمجة، MegaAttention. لقد دمجنا عدة نوى مفتوحة المصدر من هذه في vLLM ونتابع التقدم في #57448.
Mega-mHC (#56962). يدمج Mega-mHC سلسلة mHC في نواة واحدة: خطوة post، وخطوة delayed-pre، وRMSNorm. فهو يستبدل مسار TileLang مدمجًا موجودًا سابقًا أصبح تنفيذ DeepGEMM الآن يتفوق عليه. النواة أسرع بنسبة 1.14–1.51× من نسخة TileLang على NVIDIA GB200.
Mega-Gate (#56266). يدمج Mega-Gate موجّه MoE (GEMM للبوابة، وتقييم الخبراء، والانحياز، واختيار top-k) في نواة واحدة. في السابق، كانت هذه العمليات تُنفَّذ كـ GEMM واحد تتبعه نواة top-k منفصلة، مما كان يكلّف إطلاقًا إضافيًا وذهابًا وإيابًا عبر الذاكرة للدرجات. يؤدي هذا الدمج إلى تسريعات نواة بمقدار 1.18–1.31× عند أحجام الدُفعات المتوسطة.
تداخل mHC متعدد التدفقات (#57603). في V4.1، تُزاح معاملات mHC بمقدار طبقة فرعية واحدة، بحيث تقرأ GEMM معاملات السدادة التالية فقط التدفقات المتبقية الموجودة بالفعل قبل تشغيل الانتباه أو FFN. ولا يحتاج أي من الطرفين إلى مخرجات الآخر حتى تجمعهما خطوة post/pre التالية. عند أحجام الدُفعات الصغيرة، يحسب vLLM الآن معاملات كتلة mHC التالية على تدفق CUDA جانبي، بالتوازي مع الانتباه وFFN. هذا يخفي عملًا كان سيظل وإلا على المسار الحرج لفك الترميز المحدد بزمن الاستجابة. في سيناريو TP4 منخفض زمن الاستجابة، يقلل هذا زمن الاستجابة بنحو 4%.
سجلات MQA المتناثرة (#56254). في V4.1، تختار طبقات الفهرسة اللاحقة top-k الخاص بها من مجموعة ثابتة من 16K موضعًا مرشحًا. كانت التطبيقات السابقة تحسب الدرجة لسياق كامل وتقنّع جميع الكتل غير المرشحة قبل التقييم. نوى DeepGEMM المتناثرة تقيّم المرشحين فقط، فلم تعد التكلفة تنمو مع السياق. لكل طبقة على NVIDIA GB300، تكون أسرع بنسبة 1.2× عند 8K رمزًا وأسرع بنسبة 14–23× عند 512K. من البداية إلى النهاية على 4× NVIDIA GB300، يتحسن فك الترميز بنسبة 3–6%. التعبئة المسبقة أسرع بنسبة 1.43× عند 512K وأسرع بنسبة 2× عند سياق 1M.
MegaAttention مع KV مضغوطة بصيغة NVFP4 (#56935). تنفذ نواة MegaAttention في FlashMLA RoPE للاستعلام، والانتباه المتناثر، وRoPE العكسي على المخرجات، والتحويل إلى FP8 في إطلاق واحد، وتكتب مباشرة في المخزن المؤقت الذي تقرأه إسقاطة المخرجات. وهذا يزيل النوى المنفصلة والرحلات الذهاب والإياب في الذاكرة بين الانتباه والطبقة التالية. كما تقرأ تنسيق KV جديدًا مضغوطًا بصيغة NVFP4، وهو أصغر بنسبة 45% من ذاكرة KV المؤقتة السابقة بصيغة FP8. تحسّن MegaAttention أيضًا كفاءة النواة بمقدار 1.45× من خلال دمج جريء يلغي عمليات الكتابة على HBM بين العمليات.
نواة WO-A مدمجة منخفضة زمن الاستجابة (#58634). لدفعات فك الترميز الصغيرة على Blackwell، ندمج RoPE العكسي، وتكميم FP8، وGEMM الدفعي لـ WO-A، وإعادة تكميم MXFP8 في نواة CuTe-DSL واحدة، مما يقلل سلسلة ما قبل WO-B من ثلاث نوى إلى واحدة. الفكرة الأساسية هي إبقاء التنشيطات الوسيطة على الشريحة وتوصيل حركة البيانات بالحوسبة بشكل خط أنابيب، متجنبين إطلاقات النوى الإضافية والرحلات الذهاب والإياب عبر الذاكرة العامة التي تهيمن عند أحجام الدُفعات الصغيرة. يحسّن هذا مسار WO-A المدمج بما يصل إلى ~2.1× ويقدم زمن استجابة بين الرموز أقل بنسبة تصل إلى ~6–7% عند التزامن المنخفض.
Engram. تبحث طبقات Engram في V4.1 عن صفوف من جدولين كبيرين بصيغة FP8 مفتاحهما n-grams للرموز المجزأة. تقرأ كل خطوة بعض الصفوف فقط، لذا فإن موضع الجدول وزمن استجابة البحث أهم من الحوسبة. نقوم بجلب عمليات بحث Engram المُفرَّغة إلى المعالج مسبقًا وبشكل غير متزامن، متداخلين الوصول إلى ذاكرة المضيف مع حوسبة فك الترميز لتسريع فك الترميز منخفض الدُفعات (#56512). تُقسَّم رؤوس Engram وفق مخطط TP/DP موحد، وتتشارك نسخ DP المتواجدة في نفس المكان جداول المضيف نفسها، متجنبين النسخ الزائدة وأي اتصال DP على مسار البحث (#57651). لهذه الجداول الكبيرة المقيمة على المضيف، ندعم أيضًا الصفحات الضخمة الشفافة (THP) لتقليل عبء أخطاء الصفحات، مما يقدم نوى بحث أسرع بنسبة تصل إلى 10× للتعبئة المسبقة (#56926). أضفنا أيضًا تحسينات للحالات التي لا تتوفر فيها صفحات ضخمة كافية (#59327).
الأداء الوكيلي
نقيس الأداء بمعيار SemiAnalysis AgentX كحمل عمل تمثيلي للخدمة الوكيلية (مفصل في منشورنا السابق). معًا، تمنح هذه التحسينات vLLM تحسينات أداء كبيرة مقارنة بتنفيذنا في اليوم 0. كما يوضح الشكل 6، تتحسن نتيجتنا منخفضة زمن الاستجابة بمقدار 1.9× مقارنة بنتيجتنا في اليوم 0، وتتحسن نتيجة الإنتاجية العالية بنحو 5×.
للخدمة منخفضة زمن الاستجابة، نستخدم TP4 مع انتباه FlashInfer. فك الترميز الصغير الدُفعات محدود أساسًا بعرض نطاق الذاكرة، لذا فإن تقسيم أوزان النموذج عبر أربع وحدات معالجة رسومات مناسب جدًا. جربنا أيضًا MegaAttention، لكن ميزتها الرئيسية تكمن في إعدادات الإنتاجية الأعلى حيث يكون للدمج مساحة أكبر للمساعدة. عند TP4، كانت تلك الفائدة أصغر بكثير، وتبين أن FlashInfer أسرع في تجاربنا.
لتحقيق الإنتاجية العالية، ننتقل إلى DEP2، باستخدام انتباه DP مع تقسيم الخبراء عبر وحدات معالجة الرسومات. وبما أن V4.1 يستخدم حالة KV كامنة مشتركة عبر جميع الرؤوس، فإن TP ستكرر ذاكرة KV المؤقتة عبر وحدات معالجة الرسومات. أما DP فتجنب هذا التكرار: تخزّن كل وحدة معالجة رسومات KV فقط للطلبات التي تخدمها، مع الحفاظ على تقارب الجلسات لضمان محلية ذاكرة البادئة المؤقتة عبر الأدوار. كما يقلل MegaAttention بصمة KV لكل طلب باستخدام NVFP4، ما يخفضها إلى النصف تقريبًا مقارنة بـ FP8 ويزيد التزامن لكل وحدة معالجة رسومات.
من الجدير بالذكر أن الإصدار V4.1 عالي الكفاءة في استخدام الذاكرة ولا يحتاج إلى تفريغ ذاكرة KV المؤقتة طوال الاختبار المعياري. نتوقع أن يبدأ تفريغ ذاكرة KV المؤقتة في تقديم فائدة عند مستويات تزامن أعلى مع تفكيك P/D.
كما أن إعادة التشغيل المحدودة لـ SWA، مع تحسينات النواة على جانب التعبئة المسبقة، حسّنت TTFT بشكل كبير.
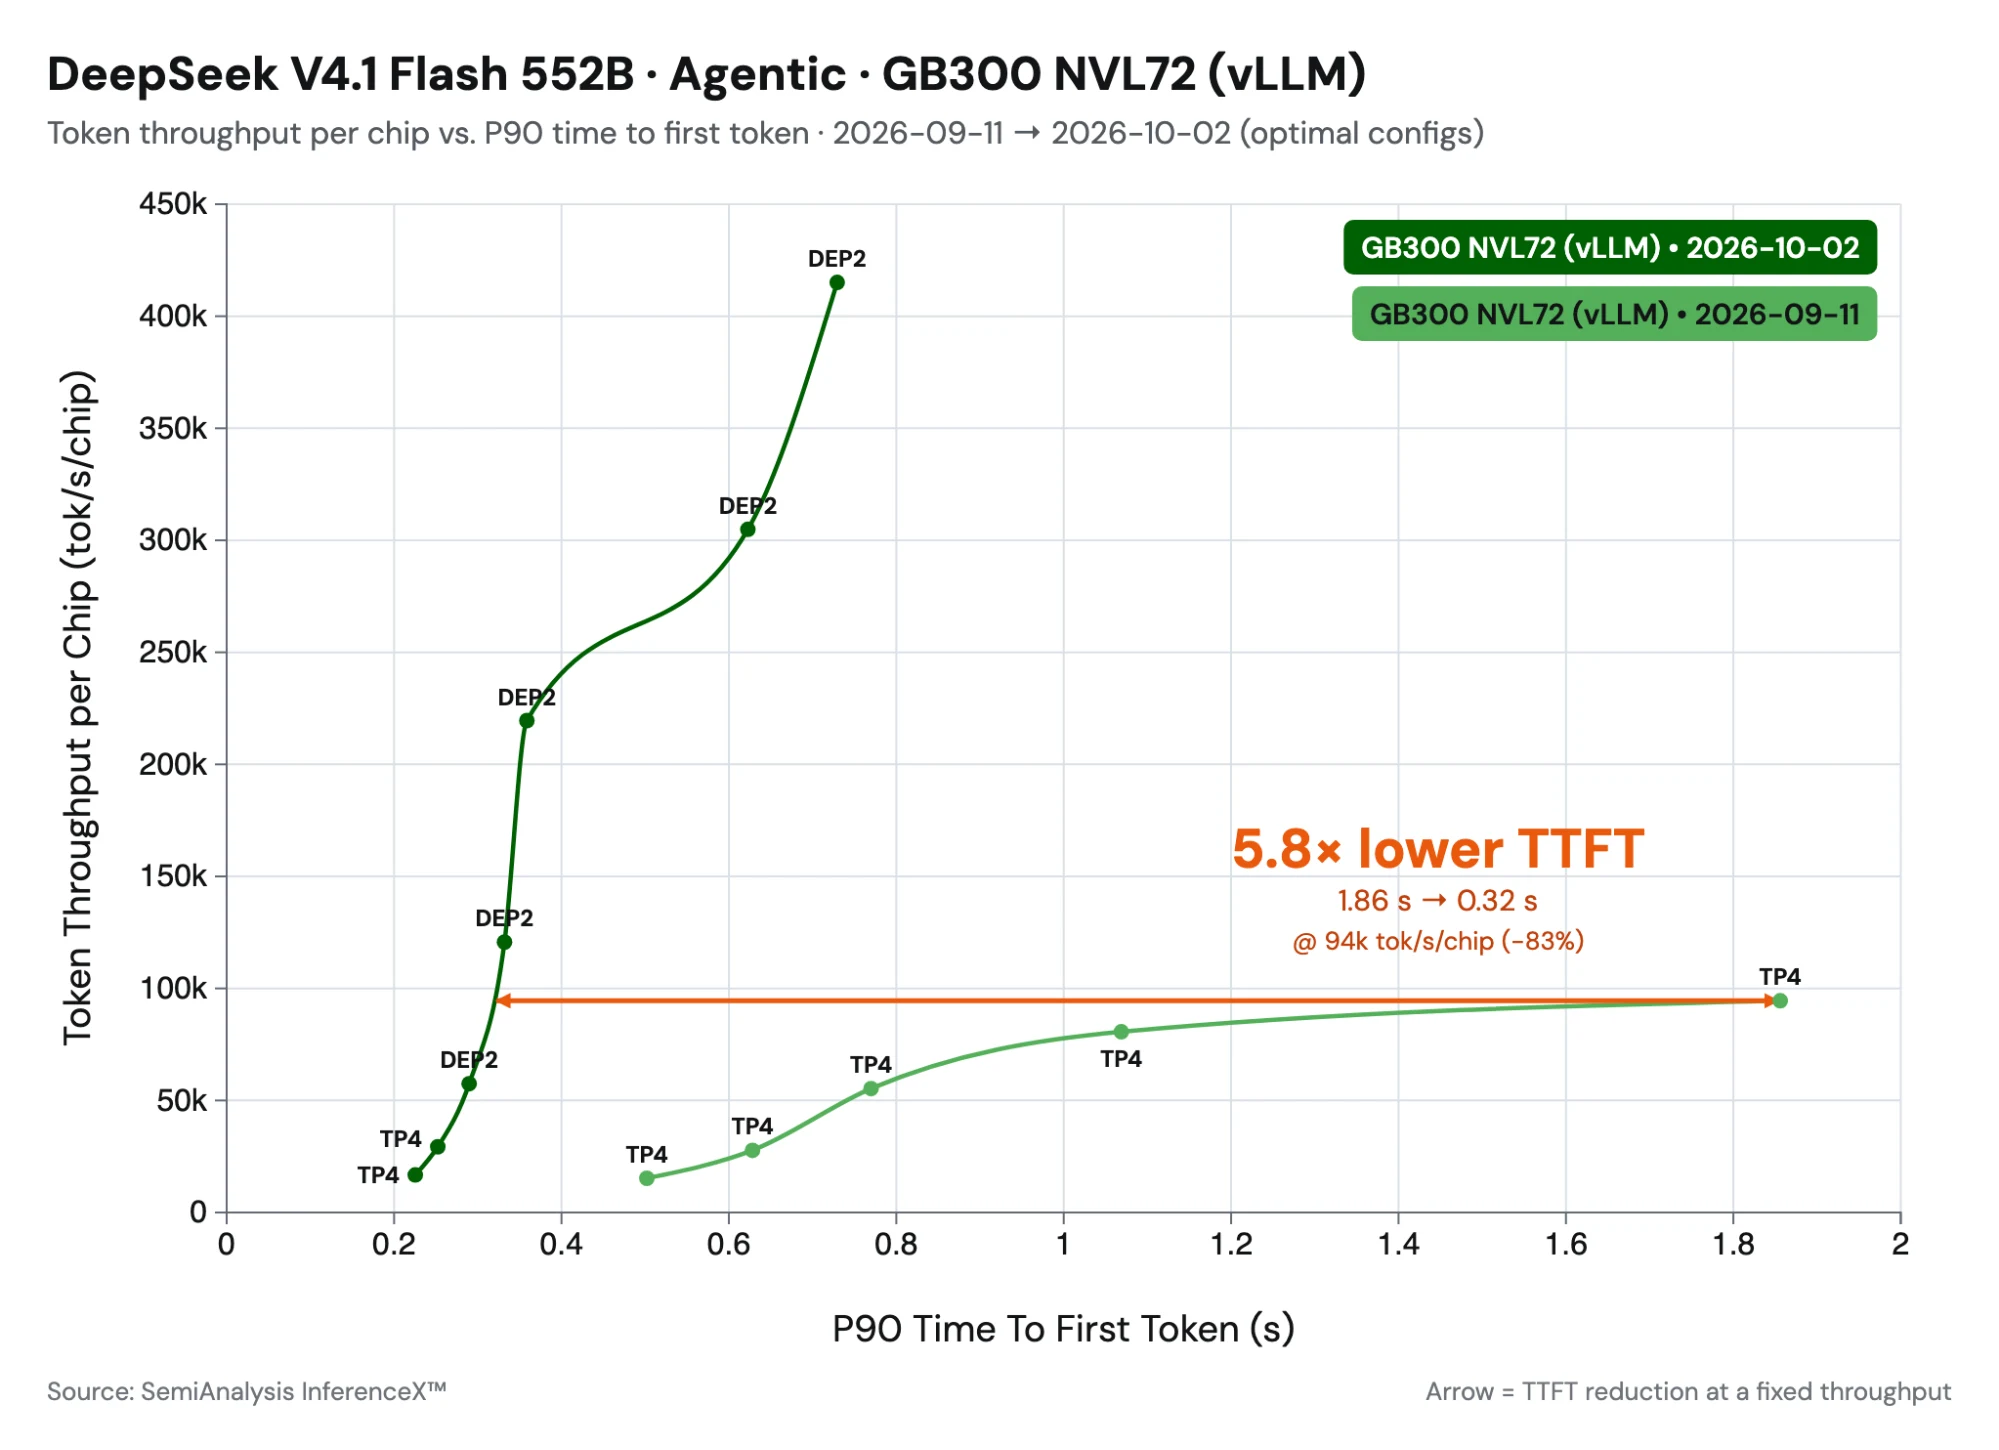
يعرض الشكل 7 المقايضة المحسّنة بين TTFT والإنتاجية. عند إنتاجية تقارب 100K، ينخفض TTFT بنسبة تقارب 70% من خلال ثلاثة تحسينات مجتمعة:
-
تتيح إعادة التشغيل المحدودة لـ SWA للنصف العلوي من النموذج معالجة آخر 128 رمزًا فقط، ما يخفض حساب التعبئة المسبقة إلى النصف تقريبًا.
-
تحافظ رسومات CUDA على سرعة إعادة التشغيل المقتطعة الصغيرة على وحدة معالجة الرسومات بدلًا من أن تكون محدودة بإطلاق النوى من المعالج المركزي، وبالتالي نحقق التسريع الكامل.
-
تعمل تحسينات النوى على تسريع حساب النموذج.
شكر وتقدير
نشكر DeepSeek على إتاحة DeepSeek-V4.1-Flash والنوى المرتبطة بها كمصدر مفتوح، وفريق Inferact على التشغيل الأولي للنموذج والتحسينات، وNVIDIA على تعاونها ودعمها، وSemiAnalysis على اختبار AgentX المعياري.