
من يعلّم الذكاء الاصطناعي حل مسائل الاستدلال التجريدي ARC竟是 قطة؟
طرح فريق He Kaiming في أحدث أوراقه البحثيةNAT-ARC، حل قائم على الرؤية البحتة لحل مسائل ARC.
لا يعتمد على LLM، بل يستخدم القطط والكلاب والزهور والأشجار في ImageNet للتعلم المسبق، ليجعل النموذج يتعلم «الرؤية»، ثم ينقل ذلك إلى استدلال الشبكات المجردة.
نتيجة لذلك، حقق أفضل نموذج فردي لـ NAT-ARC نتيجة pass@2 بلغت 63.4% على ARC-1، ووصلت إلى 70.2% بعد الدمج.
هذه هي المرة الأولى للحل القائم على الرؤية البحتةاقتراب أنظمة LLM المتخصصةالمستوى.
اختبار ARC، الذي يُعتبر أحد أصعب الاختبارات الذكية البصرية للذكاء الاصطناعي، يمنحك عدة أمثلة للمدخلات والمخرجات لشبكات ملوّنة، ويطلب منك استنتاج قاعدة التحويل الخفية الكامنة وراءها، ثم تطبيقها على شبكة جديدة.
كان الحل السائد في الماضي يترجم الخلايا بشكل موحد إلى نصوص أو رموز ويُسلّمها إلى نموذج LLM للاستدلال.
هذه الورقة البحثية على عكس ذلك تمامًا، بل إن مرحلة ما قبل التدريب لم تستخدم حتى شبكات ARC.
القدرات البصرية التي تعلّمها النموذج من العالم الحقيقي انتقلت بسلاسة تامة إلى الاستدلال المجرد تمامًا عبر شبكة من المربعات الملوّنة.
قطاع ARC: صعود الحلول البصرية
ARC هو اختصار لـ Abstraction and Reasoning Corpus، وقد طرحه François Chollet، أبو Keras، في عام 2019.
تنسيق كل مسألة في ARC موحّد للغاية: شبكة ثنائية الأبعاد بحد أقصى 30×30، وبما لا يزيد عن 10 ألوان، وتقدّم المسألة من 2 إلى 5 أمثلة من المدخلات والمخرجات، وعلى المتحدّي أن يستنتج من الأمثلة قاعدة التحويل الخفية، ثم يطبّق هذه القاعدة على شبكة إدخال جديدة تمامًا ليتنبّأ بمخرجاتها.
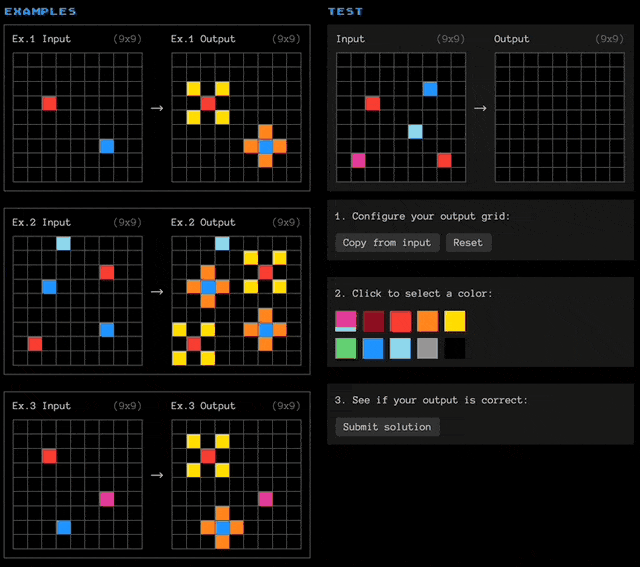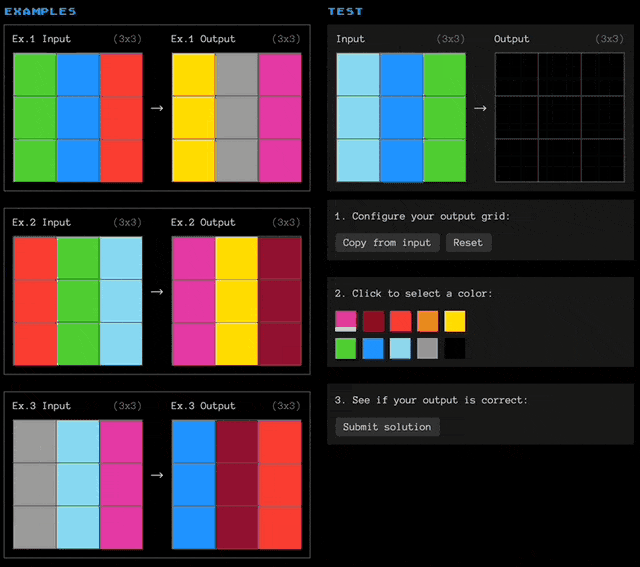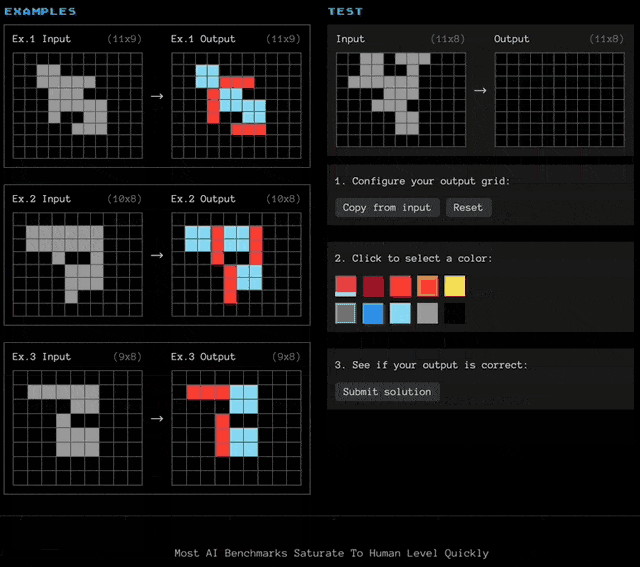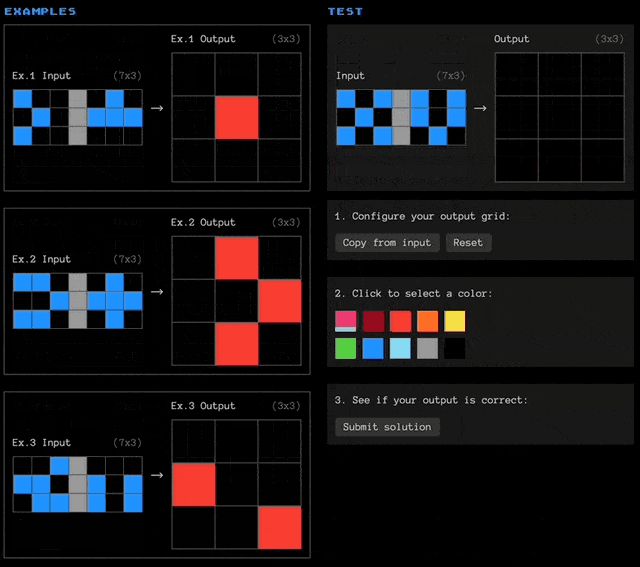
تبدو هذه المسائل وكأنها ألعاب ذكاء للأطفال تعتمد على إيجاد النمط من الصور، لكنها بالغة الصعوبة بالنسبة للذكاء الاصطناعي.
من جهة، قواعد التغيّر في كل سؤال مختلفة عن الأخرى، ولا يوجد قالب ثابت يمكن حفظه.
بالإضافة إلى ذلك، فإن كمية البيانات قليلة جداً؛ إذ يجب استخلاص القواعد المجردة من مثالين أو ثلاثة أمثلة فقط، وتنفيذها بدقة.
جعلت هذه التوليفة من ARCالمعيار القياسي لقياس قدرات الاستدلال التجريدي لدى الذكاء الاصطناعي。
يحتلّ مسار ARC في الوقت الحالي بشكل شبه كامل حلول النماذج اللغوية الكبيرة، ويتمثل الفكرة المشتركة بين هذه الحلول في ترجمة الشبكات إلى نصوص أو متتابعات رمزية وتسليمها إلى النموذج اللغوي لمعالجتها.
أما المسار البصري فقد بدأ في الصعود لاحقًا.
سلكت مجموعة من الباحثين طريقاً مختلفاً تماماً، إذ لم يترجموا المربعات إلى نصوص، بل اعتمدوا بدلاً من ذلك على نموذج بصري لمعالجة صور المربعات مباشرة.
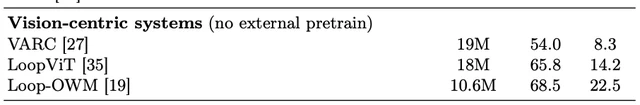
وتأتي أهم خطوة من الفريق نفسه في معهد MIT الذي اقترحVARCتعيد هذه الطريقة تعريف ARC كمهمة ترجمة مشروطة من صورة إلى صورة، مستخدمةً نموذجًا بصريًا بـ 19M معاملًا للوصول إلى 54%.
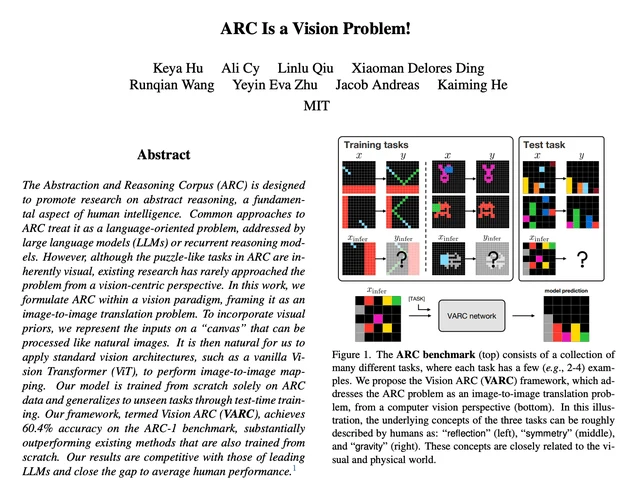
أضاف LoopViT آلية استدلال تكراري إلى هذا الإطار، محققًا 65.8% بـ 18M معاملًا.
استخدم Loop-OWM نموذجًا مدربًا مسبقًا على الفيديو لـ few-shot، محققًا 68.5% بـ 10.6M معاملات.
عدد معاملات هذه النماذج أصغر بعدة مراتب من حلول LLM، لكن أداءها بدأ يلحق بها.
لكن المسار البصري لا يزال يعاني من قصور بنيوي.
تكمن إحدى الأسباب الجوهرية لقدرة LLM على تحقيق نتائج متزايدة الأفضلية على ARC في أنها تراكمت لديها قدرات عامة من خلال التدريب المسبق على كميات هائلة من النصوص؛ وكلما كبر النموذج واكتمل التدريب المسبق أكثر، أصبح تأثير الـ scaling في المهام اللاحقة أوضح.
في المقابل، فإن معظم نماذج حلول ARC البصرية تبدأ التدريب من تهيئة عشوائية، ولم تستفد من مكافأة التدريب المسبق.
على هذا الأساس، هدف NAT-ARC هو سد خطوة التدريب المسبق للمسار البصري، ومحاولة كسر عنق زجاجة الـ scaling الخاص به.
بعد مشاهدة القطط، ننتقل إلى تحدي ARC
الفكرة الجوهرية لـ NAT-ARC هيإدراج خطوة تدريب مسبق بـ ImageNet MAE قبل مسار VARC البصري。
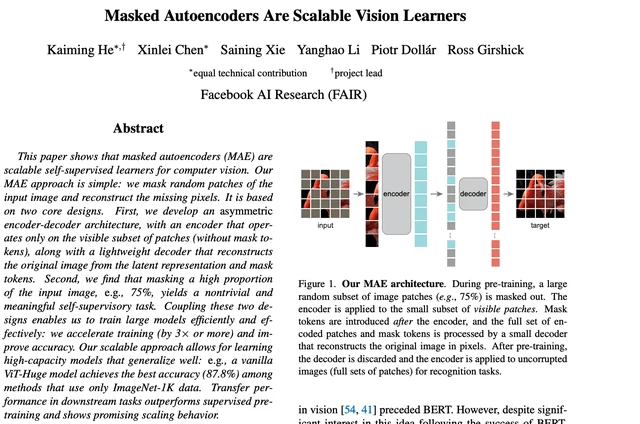
MAE أي Masked Autoencoder هو أسلوب تدريب بصري مسبق ذاتي الإشراف اقترحه كاي مينغ هي خلال فترته في FAIR عام 2022.
عملية تدريبه تكمن في تغطية معظم أقسام صورة ما، وجعل النموذج يستعيد الصورة الأصلية من الشظايا المتبقية.
من خلال هذه المهمة، يمكن للنموذج أن يفهم شكل الأجسام وبنيتها وعلاقاتها المكانية.
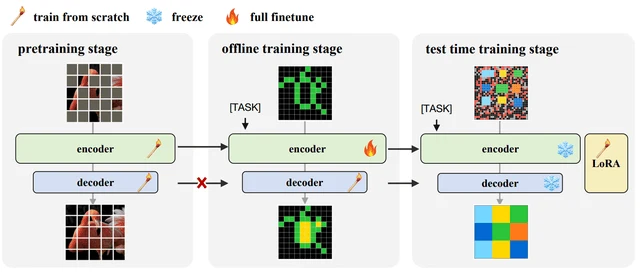
يتمثل نهج NAT-ARC في أخذ أوزان encoder المدرَّبة على ImageNet (وهو مجموعة بيانات تضم نحو 1.30 مليون صورة طبيعية مثل القطط والكلاب والنباتات والأزهار) واستخدامها مباشرة لتهيئة مُشفِّر الرؤية، بينما يبدأ decoder التدريب من تهيئة عشوائية.
تتم العملية الكاملة على ثلاث خطوات.
- الخطوة الأولى: التدريب المسبق للـ encoder باستخدام MAE على ImageNet؛
- الخطوة الثانية: التدريب دون اتصال على مُرمِّز وفك المرمِّز بالكامل على مجموعة تدريب ARC؛
- الخطوة الثالثة: إجراء ضبط دقيق بـ LoRA لكل مسألة على حدة أثناء الاختبار.
في مرحلة الضبط الدقيق، تحتوي كل مسألة على 2 إلى 5 أزواج من الأمثلة التوضيحية فقط، ويحاول النموذج من خلال هذه الأمثلة أن "يتعلم" قواعد المسألة.
وهناك تفصيل يستحق الانتباه: NAT-ARC استخدم مباشرة الـ checkpoint العام الخاص بـ MAE دون إنفاق أي تكلفة إضافية على التدريب المسبق.
غير أن هذا الـ checkpoint كان مصمَّماً أصلاً لصور ImageNet ذات الأبعاد الأكبر، بينما شبكة ARC لا تتجاوز 64×64 بكسل، وهو فرق كبير في الحجم.
وللتوافق، تخلّى NAT-ARC عن patch embedding الأصلي وترميز المواقع، واحتفظ فقط بأوزان الـ backbone، واستبدلها بترميز 2D RoPE كترميز للمواقع.
بعبارة بسيطة، احتفظ NAT-ARC فقط بقدرة استخراج السمات البصرية التي تعلّمها MAE على ImageNet، وتخلّى كلياً عن الجزء المرتبط بالإدراك المكاني المرتبط بأبعاد صور ImageNet، وأعاد تعلّمه بطريقة أكثر مرونة.
لكن لماذا ما تعلّمه من صور القطط والكلاب يمكن أن يفيد الاستدلال على الشبكات المجردة؟
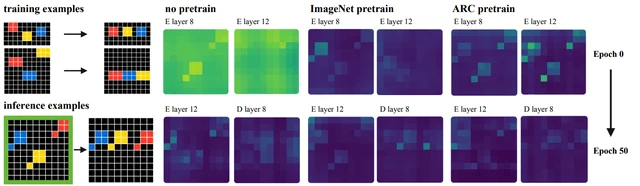
قدّمت الورقة دليلاً عبر تصوّر خريطة الانتباه.
وضع الباحثون ثلاثة نماذج بأساليب تهيئة مختلفة (بدون تدريب مسبق، وتدريب مسبق بـ ImageNet MAE، وتدريب مسبق بـ MAE على شبكات بأسلوب ARC) أمام مسألة ARC واحدة، ولاحظوا توزيع انتباهها قبل البدء في تدريب ARC إطلاقاً.
كانت النتيجة واضحة جداً: كان انتباه النموذج ذي التهيئة العشوائية موزّعاً بانتظام دون أي تركيز، أما النموذج المدرَّب مسبقاً على ImageNet فقد أصبح قادراً على التمييز بين المقدمة والخلفية، وتركّز انتباهه تلقائياً على المناطق ذات الأنماط ذات المعنى داخل الشبكة.
هذا النموذج لم يرَ شبكات ARC قط، لكن قدرته التي تعلّمها على ImageNet في "التعرّف على الأجسام وفصلها عن الخلفية" عملت بشكل تلقائي على شبكات ARC.
أجرى الباحثون كذلك تحليلاً تفصيلياً على مستوى المهام.
اختاروا 15 مسألة من مسائل ARC التي تحسّنت بشكل ملحوظ بعد التدريب المسبق، وبتصنيفها يدوياً وجدوا أنها تتركز في نوعين من المهام.
من بينها 6 مهام تنتمي إلى match-and-copy، حيث يحتاج النموذج إلى التعرّف على الكائن أو اللون أو النمط المطابق، ثم نسخ البنية المقابلة إلى المخرجات؛
أما الـ 6 مهام الأخرى فتنتمي إلى connected-component reasoning، حيث يحتاج النموذج إلى التعرّف على المناطق المتصلة مكانياً أو تعبئتها أو إعادة تلوينها.
وهاتان القدرتان تقابلان تماماً الاستدلالات البصرية في الصور الطبيعية.
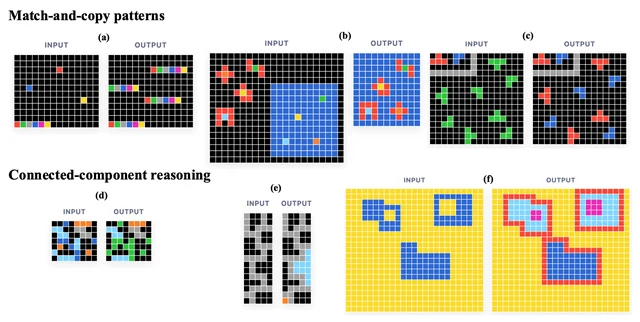
ما تعلّمه النموذج على ImageNet من "فصل القطة عن خلفية العشب" تحوّل في ARC إلى "التعرّف على هذه المنطقة الملونة المتصلة وفصلها عن الشبكة".
يتضح أن المنطق الكامن وراء العالم المرئي والعالم المجرد يتشارك التمثيلات نفسها في عمليات مثل تجميع الأجسام ومطابقة الأنماط وتقسيم المناطق.
من القطط جاء، وإلى القطts يذهب
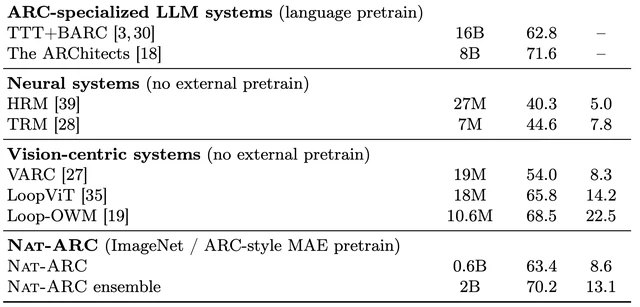
نتائج NAT-ARC النهائية على ARC-1 كالآتي.
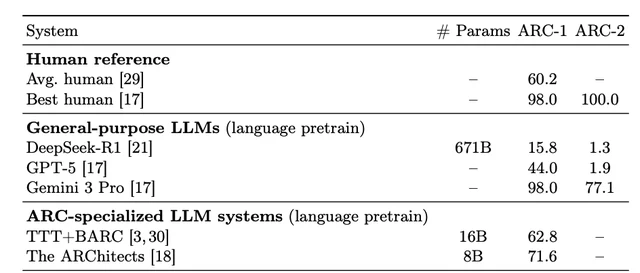
أفضل نموذج منفرد استخدم حجم huge بعدد معاملات 0.6B، وبلغت نتيجته pass@2 إلى 63.4±0.7%.
وعند التجميع، جمع الباحثون نماذج مدرَّبة بثلاث استراتيجيات تدريب مسبق مختلفة (بدون تدريب مسبق، وتدريب مسبق بـ ImageNet MAE، وتدريب مسبق بـ MAE على شبكات بأسلوب ARC) في مجمّع واحد وأجروا تصويتاً بالأغلبية، محققين 70.2±0.6% pass@2، بإجمالي معاملات نحو 2B.
وللمقارنة، حققت The ARChitects، وهي منظومة مُضبوطة بدقة خصيصاً لـ ARC، نتيجة 71.6% باستخدام نموذج لغوي بحجم 8B.
فالنهج البصري بمعاملات تعادل الربع فقط وصل إلى أسوار الأنظمة المتخصصة القائمة على نماذج اللغة الكبيرة.
وبعيداً عن الأرقام، فإن أهم اكتشاف في هذه الورقة هو أن التدريب المسبق كسر عنق الزجاجة المتعلق بقابلية التوسع (scaling) في النهج البصري.
فبدون التدريب المسبق، كانت النماذج الأكبر تعطي نتائج أسوأ؛ أما مع التدريب المسبق، بدأ scaling يجني عوائد إيجابية.
لنبدأ بمنحنيات التدريب. في مرحلة التدريب دون الاتصال بالإنترنت، كانت النماذج المدرَّبة مسبقًا على ImageNet تتقارب بوتيرة أسرع بكثير، وكان ذلك صحيحًا على المقاييس الثلاثة base وlarge وhuge، كما كانت الدقة النهائية أعلى.
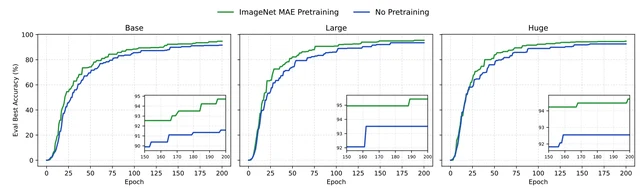
لكن الاكتشاف الأكثر إثارة كان مخفيًا في منحنيات التوسع (scaling).
بدون تدريب مسبق، كان أداء النموذج يتحسن عند الانتقال من base إلى large، لكنه تراجع عند الانتقال من large إلى huge.
زيادة حجم النموذج تؤدي إلى نتائج أسوأ، وهذه ظاهرة غير شائعة في التعلم العميق، مما يدل على أن كمية البيانات في مهمة ARC قليلة للغاية، فزيادة سعة النموذج لم تجلب تعميمًا أقوى بل فرط تخصيص (overfitting).
أما بعد إضافة التدريب المسبق على ImageNet، فقد أصبح منحنى التوسع صحيًا، حيث تصاعد باستمرار عبر المقاييس الثلاثة base وlarge وhuge، وكلما كبر النموذج تحسنت النتائج.
أجمل تجربة في الورقة كانت تحققًا بصريًا.
درَّب الباحثون مشفرًا تلقائيًا (autoencoder) يحوّل صور ImageNet إلى تمثيل شبكي منفصل بحجم 60×60 و10 ألوان، أي ما يعادل «ترجمة» صورة قطة إلى شبكة ARC.
ثم طبّقوا باستخدام NAT-ARC تحويل ARC على هذه الشبكة، وهو تدوير بمقدار 180 درجة وإضافة إطار أزرق حولها، ثم فك الترميز مرة أخرى إلى بكسلات.
والنتيجة: القطة دارت فعلًا، وأُضيف الإطار فعلًا. النموذج الذي دُرِّب على القطط عاد في المهمة إلى عالم القطط من جديد.
هذه التجربة حوّلت فكرة «تشارك الصور الطبيعية وشبكات ARC نفس فضاء التمثيل» من أرقام إحصائية إلى دليل مرئي.
قواعد التحويل المتعلَّمة على شبكات ARC يمكن تطبيقها مباشرة على التمثيلات الكامنة للصور الطبيعية، والعكس صحيح أيضًا.
الصلات بين القواعد المجردة والتمثيلات البصرية موجودة أصلاً في هذين العالمين.
نبذة عن المؤلفين
المؤلفة الأولى للورقة هي Xiaoman Delores Ding، وهي عضوة في MIT CSAIL، ومن فريق He Kaiming (何恺明).
وهي أيضًا المؤلفة الأولى لورقة VARC، وورقة NAT-ARC هذه تمثل في الواقع مواصلة للتقدم انطلاقًا من عملها السابق.
أما بقية المؤلفين فمن بينهم هو كه ياه (Keya Hu)، وهي واحدة من أوائل الطالبات لدى He Kaiming، وتخرجت بمرحلة البكالوريوس منجامعة شنغهاي جياو تونغ。
وهناك أيضًا Katelyn Gan وVictor Yin، وكلاهما من MIT، وكلاهما طالب جامعي، ويعملان كطالبَي باحث (student researcher) في CSAIL.
أما المؤلف المراسل He Kaiming فلا يحتاج إلى تعريف، فهو مؤلف ResNet وMAE، ومن هذين العملين يمكن تقريبًا ربط الخط الرئيسي لتطور الذكاء الاصطناعي البصري خلال العقد الأخير.
ومنذ انضمامه إلى MIT ظل ينتج أعمالًا أساسية في مجال الرؤية، والورقة الحالية تستخدم بالضبط MAE الذي اقترحه هو بنفسه قبل أربع سنوات كأداة تدريب مسبق، أي أنه بسلحته القديمة فتح طريقًا جديدًا.
قد قُبلت ورقة VARC في مؤتمر CVPR 2026، وNAT-ARC هي المتابعة المباشرة لها.
هذا الفريق أصرّ في ورقتين متتاليتين على نهج الرؤية البحتة لحل ARC، وعلى مسار تهيمن عليه النماذج اللغوية الكبيرة (LLM)، فهو يواصل ببياناته التجريبية كسر سقف نهج الرؤية باستمرار.
رابط الورقة:
https://eccv.ecva.net/virtual/2026/poster/5527