
منغ ياو، من凹非寺
QbitAI | الحساب العام QbitAI
يا للعجب!بايتهل تحول توليد الذكاء الاصطناعي هذه المرة إلى عالم مفتوح؟!
انظروا، يكفي أن تكتب جملة واحدة، فيولّد الذكاء الاصطناعي فورًا غرفة من العدم من منظور إنسان مصغّر~
وفورًا بعد ذلك، وبعد سلسلة من العمليات السريعة على لوحة المفاتيح والفأرة، يمكننا الركوب على طائرة ورقية في عالم السايبروالتحليق بحريةوالذهاب إلى أي مكان نشاؤه:
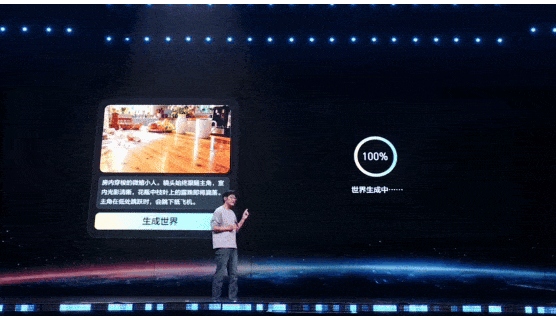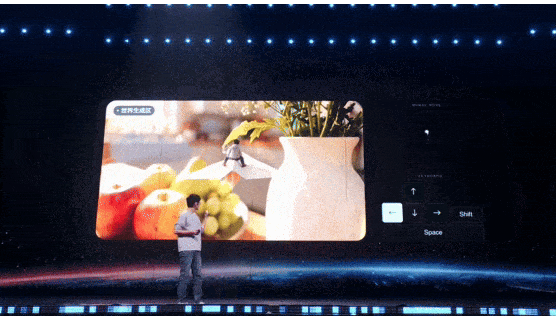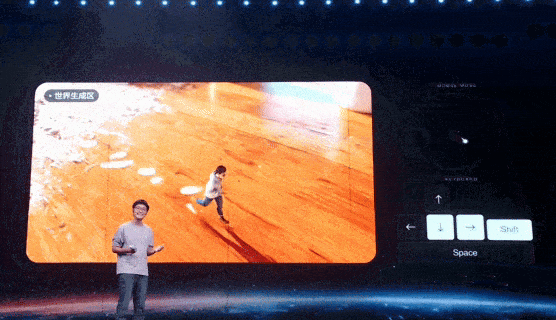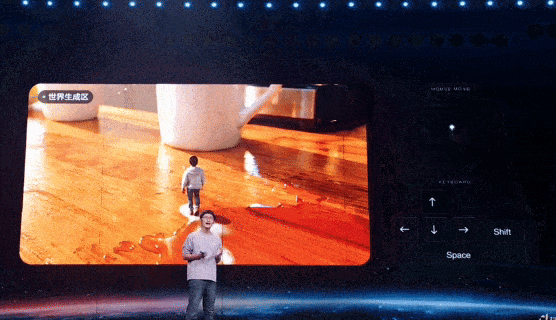
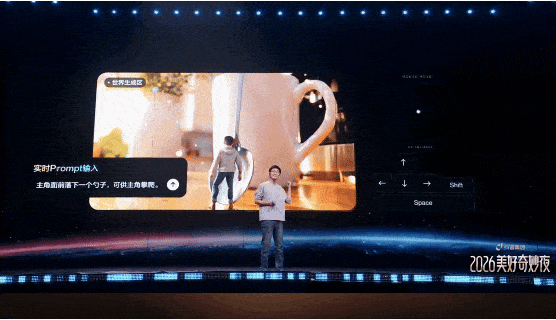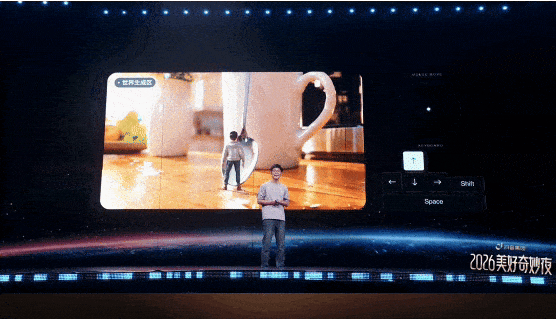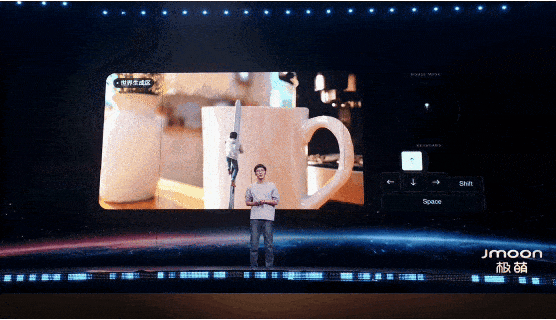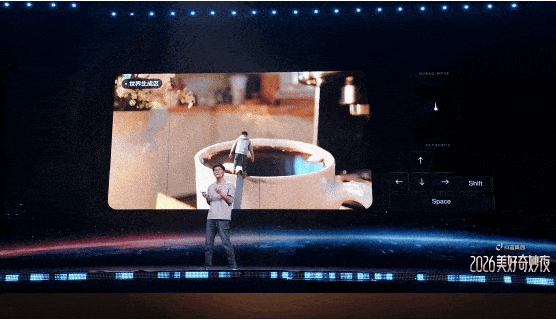
وهذا ليس كل شيء؛ ففي هذا العالم المولَّد بالذكاء الاصطناعي، يمكن حتى خلق الأشياء أمامنا بلمسة يد!
تريد ملعقة؟ تصنعها من العدم مباشرة، وحتى…
كما يمكننا التفاعل مع الملعقةتفاعلًاوتحويل أدوات المائدة اليومية إلى حقل تسلق ضخم—
وبالطبع، ما يستطيع هذا العالم فعله لا يتوقف عند هذا الحد.
فبفضل ميزةالباب السحري، يمكن ربط مشهدين لا صلة بينهما إطلاقًا بشكل مباشر.
في الثانية السابقة كنت في الغرفة، وفي الثانية التالية تدفع الباب فتجد نفسك في الفضاء الخارجي؟!
هذه المشهد السحري ظهر في فعاليات برنامج«ليلة العجائب الجميلة 2026» لمجموعة Douyinالتقنية، ومقدّم العرض هو Tim من FilmStorm.
والأكثر جدارة بالذكر أن هذه السلسلة من العمليات التي تُعد إبداعًا سايبريًا بامتياز، تقف وراءهانموذج العالمالذي تعملByteDanceعلى تطويره بصمت طوال الوقت. (صورة الصدمة.jpg)
وعلى الرغم من أن النموذج لم يُصدر رسميًا بعد، إلا أن ما عُرض في الفعالية يُظهر أنه أبدى بالفعلتوليد مشاهد ثلاثية الأبعاد، والاستكشاف الحر، والتفاعل الفوري، وتحرير العناصر،حتى القدرة علىالاتصال الحربين المساحات المختلفة~
هذه المرة استغلت ByteDance العرض المباشر في البرنامج لتقدم نموذجها العالمي في«ظهور أول»غير متوقع، وهو بصدد إظهار عضلاتها مسبقاً فعلاً.
والحقيقة أن الأمر يبعث على much الإلهام، ففي هذه السنوات، من World Labs التي أسستها لي فاي فاي، إلى Genie من Google DeepMind، وصولاً إلى Cosmos من إنفيديا.
حيث تدافع عمالقة التكنولوجيا للدوران في هذا المجال، ساعيةً إلى جعل الذكاء الاصطناعي يفهم البنية المكانية بشكل أعمق، ومحاكاة قوانين الواقع، بل والتنبؤ بكيفية تغيّر البيئة تبعاً لأفعال الإنسان.
اليوم، يُخرج الذكاء الاصطناعي عوالم الأفلام الخيالية العلمية إلى الواقع.
من رسم عالم، إلى جعل العالم بأكمله «يستيقظ على الحياة»
أخمّن أن أوائل من جربوا AIGC في السنوات الماضية لم يتوقعوا أبداً——
أن يصبح يوماً ما فيديو مولّد بالذكاء الاصطناعي عالماً سيبرانياً ثلاثي الأبعاد يمكن الدخول إليه، يدعم التفاعل، ويتيح التحرير بمرونة.
عدّدت قليلاً، ومنذ مطلع هذا العام حتى الآن، جرّبت بنفسي نحو ستة أو سبعة منتجات لنماذج العالم تقريباً。。。
ومدى الصدمة التي أحدثتها لا يقل عن أن تشاهد فيلم «Interstellar» مساء اليوم، ثم تكتشف في الغد أنك تستطيع الدخول إلى الشاشة، بل ونقل الثقب الأسود إلى غرفة معيشتك في أثناء ذلك.
إذن، كيف تمكن الذكاء الاصطناعي من الانتقال «السلس» من توليد الصور والفيديوهات إلى صناعة العوالم؟!
هذا الموضوع، يجب أن نبدأه من نقطة ضعف تقنية في التوليد متعدد الوسائط التقليدي。(doge)
اليوم، اشتققت نماذج العالم عدة مسارات تقنية، من التنبؤ بالحالات المجردة، إلى النمذجة السببية الفيزيائية، وصولاً إلى العوالم ثلاثية الأبعاد التوليدية، ولكل منها تركيزها الخاص.
أما ما سنناقشه هنا فهو بشكل أساسي المسار المرتبط بالتوليد متعدد الوسائط والذكاء المكاني:
جعل الذكاء الاصطناعي يتعلم البنية المكانية للعالم الواقعي وقوانين تغيّره، ليقوم بعد ذلك بتوليد وترميم ومحاكاة عالم ثلاثي الأبعاد يمكن استكشافه باستمرار والتفاعل معه في الوقت الفعلي.
ويجب التأكيد هنا على وجود كلمتين مفتاحيتين:البنية المكانيةوقوانين التغير。
وإن هاتان القدرتان تستهدفان بالضبط مشكلة أساسية لم تُحلّ بعدُ بالكامل في تقنيات التوليد البصري خلال السنوات الماضية.
△ تم إنشاؤه بواسطة الذكاء الاصطناعي
في عام 2024، أطلقت OpenAI نموذج Sora، وقد جعلت مقاطع الفيديو المولّدة المذهلة الشبكة بأكملها تدور وتُصاب بالدوار وتنهار مذهولة خلف سام ألتمان.
لكن مقارنةً بتلك الفيديوهات التي غمرت الشاشات آنذاك، فإن التقرير التقني الذي نشرته OpenAI في الفترة نفسها يستحق اليوم، على العكس، تدقيقاً أدق —
《Video generation models as world simulators"، الترجمة الحرفية لها هي:«نماذج توليد الفيديو كمحاكي للعالم»。
حينهاً اكتشفت OpenAI أنه مع توسع حجم نماذج توليد الفيديو، بدأت النماذجُ تُظهر قدراً من الاتساق ثلاثي الأبعاد، وثبات الأجسام، بل وحتى محاكاة تفاعلات بيئية بسيطة.
لكن المفارقة المحرجة هي أن النموذج القادر على توليد مشاهد عوالم واقعية قد يظل عاجزاً حتى عن التعامل مع أبسط «العلاقات الفيزيائية».
مثلًا، يستطيع Sora توليد مشهد لشخص يركض على جهاز الجري، حيث تبدو الشخصية والظلال والإضاءة والتصوير كلها مقنعة تمامًا.
ولكن عند النظر عن كثب، فإن العلاقة بين حركات الشخصية وحركة السير الكهربائي قد لا تتوافق مع منطق الفيزياء في الواقع؛ المشهد يبدو واقعياً جداً، لكن قوانين الفيزياء فيها تبدو مرتبطة بالحظ؟؟
△مصدر الصورة: الموقع الرسمي لـ OpenAI
وفي خلفية ذلك، يكشف ما هو أعمق مشكلة جوهرية جدًا في تقنيات التوليد البصري التقليدية.
خلال السنوات القليلة الماضية، سواء كانت نماذج الانتشار أو البنى التوليدية القائمة على Transformer، اعتمدت النماذج الرئيسية للصور والفيديو بشكل أساسي على التعلم من كميات هائلة من البيانات البصريةالانتظام الإحصائي، لإنشاء صور مطابقة لشروط المُدخلات.
لقد نجحت هذه المنهجية بنجاح كبير، حتى إنها أصبحت قادرة على تعلم جزء من الهندسة ثلاثية الأبعاد، والعلاقات بين الأجسام، والقوانين الفيزيائية بشكل ضمني.
لكنالاستمرارية الزمانية المكانية الظاهرية لا تقابل بالضرورة مجموعة مستقرة من حالات العالم يمكن للفعل الخارجي التدخل فيها——
على سبيل المثال، جعل كوب يحافظ على مظهره المتسق طوال الفيديو أصبح أمرًا سهلًا نسبيًا بالنماذج التوليدية الحالية.
لكن عندما يُرفَع الشيء أو يُوضَع أو حتى يُدفَع من حافة الطاولة، يحتاج النموذج أيضاً إلى تتبع الموقع المكاني وعلاقات الأجسام وتغيرات الحالة بشكل مستمر، والتنبؤ بالنتائج الفيزيائية مثل التصادم والسقوط.
بعبارة أخرى، من توليد مقطع فيديو يتوافق مع الحدس الفيزيائي إلى التنبؤ الموثوق بالتغيرات البيئية الناجمة عن الأفعال، لا يزال هناك في المنتوسط مسألة نمذجة حالة العالم.
وهذا بالضبط ما تتفوق فيه نماذج العالم.
في يونيو من هذا العام، أصدر فريق لي فاي فاي مقالاً بعنوان "A Functional Taxonomy of World Models".
يصنف المقال نماذج العالم إلى ثلاثة أنواع من منظور وظيفي، كما يوفر تفسيرًا أوضح لما هي "المهارات الحقيقية" التي تمتلكها نماذج العالم حقًا —
- المُصيِّر: مسؤول عن العالميبدوكيف تبدو، وتُخرج مشاهد بصرية موجّهة للبشر، حيث الهدف الأساسي هو واقعية الصورة والتعبير البصري.
- المحاكي: المسؤول عن العالمفعليكيف يبدو الأمر، والحفاظ على حالة مشهد تتوافق مع الهندسة والسببية الفيزيائية.
- المخطِّط: مسؤول عن تحديد الخطوة التالية للوكيل الذكيالإجراء، وبناءً على الحالة الراهنة للعالم والأهداف المحددة، يُخرج أفعالاً منطقية.
الجانب اللافت في هذا التقسيم هو أنه يفسّر تمامًا لماذا، رغم قدرة الذكاء الاصطناعي على توليد مقاطع فيديو يصعب تمييزها من الحقيقية، ما زلنا نبذل جهدًا كبيرًا في بحث نماذج العالم.
من توليد مشاهد بصرية واقعية، إلى الحفاظ على حالة بيئية تتوافق مع القوانين الفيزيائية، وصولًا إلى دعم الوكلاء الأذكياء في اتخاذ القرارات والتصرفات بشكل مستقل —
فالقدرات المعنية بذلك وراء الكواليس، مثل التمثيل المكاني والتنبؤ الديناميكي وتخطيط الأفعال، هي بالضبط التحديات التقنية التي لم تحلها نماذج التوليد متعددة الوسائط التقليدية بعد بشكل كافٍ.
أما اليوم، فإن أفكار نماذج العالم التي تبدو في الأبحاث بعيدة المنال إلى حد كبير، بدأت تتحقق شيئًا فشيئًا بفضل الذكاء الاصطناعي.
△ المصدر: مقال «A Functional Taxonomy of World Models»
لنأخذ مثلاًعرض "2026 美好奇妙夜" من مجموعة抖音 (Douyin Group)حيث استُعرضت في البرنامج التقني عمليات الإنشاء السيبراني المبنية على نماذج الذكاء الاصطناعي من ByteDance.
توليد صور من جملة واحدة وحدها لم يعد اليوم أمرًا غريبًا على الإطلاق.
لكن عندما يدخل الإنسان فعلًا إلى هذا المشهد الذي ولّده الذكاء الاصطناعي ويتنقل فيه بحرية، ينتقل ما يحتاج النموذج إلى معالجته من توليد هذا الإطار أمام العين وحده إلى الحفاظ على البنية المكانية للمشهد بأكمله.
وأيًا كان الاتجاه الذي يتحرك فيه الإنسان أو الزاوية التي يلاحظ منها، فإن التضاريس والأجسام في المشهد ومواقعها النسبية يجب أن تحافظ على اتساق هندسي كافٍ.
ما يكمن وراء ذلك هوالقدرة على التمثيل المكانيلنموذج العالم، وهو أيضاً الأساس الذي يجعل المشهد المولّد بواسطة الذكاء الاصطناعي قابلاً حقاً للاستكشاف المتكرر.
إذا أردت ملعقة، يولّدها الذكاء الاصطناعي من العدم، بل ويمكن حتى التسلّق على طول الملعقة، مع تحقيق تفاعل حركي في الوقت الفعلي.
خلف هذه الخطوات التي تبدو بسيطة، تقف قدرات نموذج العالم فيالتوليد الفوري، ونمذجة حالة البيئة، والتنبؤ الديناميكي——
يحتاج النموذج إلى تحديث الأجسام والعلاقات المكانية في المشهد لحظة بلحظة وفقاً لعمليات المستخدم، مع التنبؤ المستمر بالتغيرات البيئية الناجمة عن الأفعال والحفاظ على اتساق الحالات بين الماضي والحاضر.
بل إن حتى الفضاء نفسه يمكن تعديله عشوائياً؛ فبما أنك ترسم «بوابة سحرية»، يمكنك ربط غرفة واقعية بالفضاء الخارجي مباشرة.
عند هذه المرحلة، امتدت قدرات نموذج العالم طبقة أخرى إلى الأمام —إعادة بناء المشاهد ثلاثية الأبعاد، والتحرير المكاني المُتحكَّم به، ونمذجة الاستمرارية عبر المشاهد.
يمكن للنموذج، مع الحفاظ على البنية المكانية للمشهد الأصلي، إعادة تركيب العلاقات الهندسية بين المشاهد المختلفة ديناميكياً، بما يدعم الاستكشاف المستمر عبر المشاهد والتفاعل في الوقت الفعلي:
من الحفاظ على البنية المكانية، إلى الاستجابة للتفاعل في الوقت الفعلي، وصولاً إلى دعم تحرير المشاهد وإعادة التركيب عبر الفضاءات، فإن قدرات نموذج ByteDance للذكاء الاصطناعي تتجه جميعها نحو السمة الجوهرية لنماذج العالم —
لم يعد الذكاء الاصطناعي يولّد محتوى فحسب، بل يولّد عالماً رقمياً قادراً على الوجود المستمر والتغيّر المستمر والتفاعل المستمر.
خلال السنوات الماضية، وسّعت النماذج اللغوية الكبيرة باستمرار قدرة الذكاء الاصطناعي على معالجة اللغة والمعرفة، بينما مدّت النماذج متعددة الوسائط قدرة التوليد إلى الصور والصوت والفيديو.
أما اليوم، ومع تطور نماذج العالم، بدأ الذكاء الاصطناعي يستكشف أكثر البنية المكانية وحالة البيئة وقوانين تطورها.
كما أن التطور التقني للذكاء الاصطناعي التوليدي ينتقل من مدى واقعية الصورة إلى ما إذا كانت البيئة المولّدة قادرة على الوجود المستمر والاستجابة للتفاعل، بل ومحاكاة سير العالم الحقيقي.
نماذج العالم تمنح الذكاء الاصطناعي «مهارة حقيقية» يتقنها في العالم الافتراضي
بالطبع، إذا كان نموذج العالم لا يفعل سوى السماح للبشر بالتجول في العالم السيبراني، فذلك بمثابة إهدار لقدراته إلى حدٍّ ما.
وإذا نظرنا إليه ضمن إحداثيات صناعية أوسع، فإنه يحمل قيمة أكثر تخيلاً —
تدريب الآلات على نطاق واسع في العالم الافتراضي، وتجربة الأخطاء بشكل متكرر، ثم نقل القدرات المكتسبة إلى الواقع.
ففي النهاية، يعاني تطور الذكاء الاصطناعي الفيزيائي مثل الروبوتات والقيادة الذاتية منذ فترة طويلة من قيود واقعية، مثل ارتفاع تكلفة جمع البيانات الحقيقية، وطول دورة تجربة الأخطاء، وصعوبة إعادة إنتاج المشاهد الخطرة والقصوى.
بينما يقدّم نموذج العالم مساراً جديداً: تحويل البيئة الواقعية إلى ساحة تدريب افتراضية قابلة للتوليد والتحكم والتحقق المتكرر.
من توليد بيانات تدريب نادرة، إلى محاكاة بيئات معقدة والتحقق من استراتيجيات العمل، يُرجَّح أن تُنقل بعض حلقات التدريب التي كانت تعتمد في الأصل على البيئة الحقيقية لإنجازها في العالم الافتراضي.
وهذا يجعل نموذج العالم يتوسع من توليد المحتوى إلى حلقات تدريب الذكاء الاصطناعي الفيزيائي والتحقق منه، ليصبح اتجاهاً تقنياً مهماً في مجالات مثل الروبوتات والقيادة الذاتية.
△ مولّد بالذكاء الاصطناعي
لنتحدث أولاً عن موضوع «بيانات التدريب».
بالنسبة لأنظمة الذكاء الاصطناعي الفيزيائي مثل القيادة الذاتية، كلما كان المشهد القصوى أكثر أهمية، كانت بيانات تدريبه أكثر ندرة غالباً.
فمثلاً، المشاهد منخفضة التكرار وعالية الخطورة مثل الحوادث المفاجئة والطقس القاسي قد لا تُصادف إلا نادراً حتى بعد قياد مئات الكيلومترات، ونموذج العالم يستطيع بالضبط توليد هذه المشاهد حسب الطلب ومحاكاتها بشكل متكرر.
في حفل التكنولوجيا «ليلة العجائب 2026» لمجموعة Douyin، عرضوا عرضاً تجريبياً للقيادة الذاتية من هذا النوع —
سيارة إسعاف تقترب فجأة، ومشاة يعبرون الطريق، وشرطي مرور يوجّه الحركة في الموقع.
تم نقل مختلف ظروف الطرق المعقدة إلى طريق افتراضي مولّد بالذكاء الاصطناعي، حيث يمكن للسيارات محاكاة القيادة والتعامل مع الحالات الطارئة، إضافة إلى تحليل أداء القيادة من خلال إعادة التشغيل بعدة كاميرات.
المشاهد الطويلة الذيل التي كانت تتطلب في الماضي قيادات ميدانية حقيقية كثيرة لتتراكم، يمكن اليوم توليدها بكميات كبيرة عبر نموذج العالم، واستخدامها في التدريب والتحقق المتكررين لأنظمة القيادة الذاتية.
بالإضافة إلى بيانات التدريب، تتجلى القيمة الصناعية للنماذج العالمية في جانب رئيسي آخر، وهوتحسين كفاءة تدريب وتحقق الذكاء الاصطناعي الفيزيائي.
كما نعلم جميعًا، يجب على الروبوت الحقيقي في كل مرة تدريب تنفيذ الحركات وانتظار الملاحظات، وبعد الفشل قد يحتاج إلى إعادة ضبط يدوية مع تحمّل مخاطر تلف العتاد.
لكن في العالم ثلاثي الأبعاد، تتحول عملية التجربة والخطأ التي كانت تستهلك وقتًا كبيرًا إلى فرصة لتصبح تجارب محاكاة قابلة للتكرار والتوازي.
وقد عكس العرض الحي للروبوتات المنزلية في البرنامج التكنولوجي «ليلة العجائب 2026» المقدم من مجموعة دووين ترحيبًا مماثلاً بهذه الفكرة.
في بيئة منزلية افتراضية مولَّدة بالذكاء الاصطناعي، يمكن للروبوتات التدرب على عمليات منزلية مثل الإمساك بالأشياء ونقلها وترتيبها، كما يمكنها مواجهة المواقع المتغيرة باستمرار للأجسام والتخطيطات المكانية، وتعديل استراتيجيات حركتها ومحاولة إنجاز المهام.
حتى إذا فشلت العملية، يمكن بسرعة إعادة إنتاج المشكلة في البيئة الافتراضية، وتعديل الاستراتيجية، والتدريب والتحقق بشكل متكرر.
بالمقارنة مع العمليات المتكررة وإعادة الضبط اليدوية في الواقع، تمنح النماذج العالمية الروبوتات فرصة للتجربة والخطأ بشكل متوازٍ في سيناريوهات مختلفة، لاكتساب القدرة على التعامل مع البيئة الواقعية بتكلفة أقل وسرعة أكبر~
وبالنظر إلى الصناعة بأكملها، فإن عمالقة التكنولوجيا بدأوا في الواقع استكشاف التطبيق الصناعي لنماذج العالم على طول مسارات مختلفة.
في مارس من هذا العام،إنفيديادمج نموذج Cosmos العالمي مع منصة المحاكاة Isaac، ليتمكن الروبوت من توليد البيانات والتدريب بشكل متكرر في بيئة افتراضية.
ومن المتوقع أن تُخفّض هذه الحلول للمحاكاة الصناعية بشكل كبير تكاليف انتقال الروبوتات من التدريب إلى النشر الفعلي.
△ المصدر: الموقع الرسمي لشركة Nvidia
والأكثر إثارة للذكر أن موجة الحماس هذه جرّت حتى عمالقة الرقائق في المرحلة العليا إلى الدائرة.
فقط في سبتمبر الذي مضى للتو،أعلنت شركة AMD عن استحواذ ضخم بقيمة 8.2 مليار دولار على شركة World Labs التابعة لـ لي فاي فايوذلك بهدف التمركز المسبق لتلبية الطلب على القدرات الحاسوبية لنماذج العالم، وتمهيد الطريق لتطوير الجيل القادم من الرقائق.
من تدريب الروبوتات الافتراضي، إلى المحاكاة الصناعية، وصولًا إلى دخول عمالقة الرقائق إلى الميدان بأنفسهم.
تتنافس الصناعة حول نماذج العالم على طول سلسلة الصناعة، ممتدة من قدرات النماذج والتطبيقات العملية، وصولاً إلى بنية القوة الحاسوبية الأساسية.
سباق عالمي على نماذج العالم، وتراكم الخبرة التقنية لدى اللاعبين الصينيين يبدأ يؤتي ثماره
نماذج العالم رائجة فعلاً بجدارة، لكن خلف هذه الموجة، بدأت تظهر ظاهرة صناعية مثيرة للاهتمام إلى حد ما.
يتسارع السعي لدى الشركات داخل الصين وخارجها لاستكشاف كيفية بناء عوالم ثلاثية الأبعاد مستقرة مكانياً وقادرة على التفاعل في الوقت الفعلي، غير أن الخبرات التقنية المتراكمة ومراكز التركيز على البحث والتطوير ومسارات التطبيق لدى كل جهة تتباين اختلافاً كبيراً —
تتلاقى الأهداف التقنية تدريجياً، لكن كل جهة تمتلك أسلوبها الخاص في تحقيقها.
خذ بعين الاعتبار الأمثلة الخارجية: فكل من Genie من Google DeepMind وWorld Labs لـ لي فايفاي يستكشفان قدرات المحاكاة العامة للعالم، مع التركيز على البنية المكانية والنمذجة الديناميكية للبيئة وتوليد المشاهد التفاعلية.
أما Nvidia Cosmos فهي أقرب إلى الاحتياجات الفعلية للذكاء الاصطناعي الفيزيائي، إذ تجمع بين نماذج العالم ومحاكاة الروبوتات وتوليد البيانات الاصطناعية، محاولةً ربط التدريب الافتراضي بالتطبيقات الواقعية.
هناك عدة مسارات لكل منها توجه مختلف، لكنها جميعًا تشير في النهاية إلى هدف واحد:جعل البيئات الافتراضية المولدة بواسطة الذكاء الاصطناعي تمتلك تدريجياً القدرة على محاكاة العالم الحقيقي.
لنعد الآن أنظارنا إلى الداخل.
وتجدر الإشارة إلى ميزة مهمة تتمثل في أن الشركات الصينية، على عكس المسار الذي تتبعه جهات أجنبية تركز على محاكاة العالم العام، قد قطعت في السنوات الماضيةالقدرات التقنية المتراكمة في مجالي توليد الصور والفيديو توفر للنماذج العالمية مسارًا تطوريًا آخر تنافسيًا للغاية.
في يوليو من هذا العامSeedance 2.5وسّعت مدة إنشاء الفيديو الواحد إلى 30 ثانية، كما عززت قدرات التحكم المرجعي متعدد الوسائط، وحركة الكاميرا، والسرد المتصل.
نموذج توليد الصور الذي أُطلق في الفترة نفسهاSeedream 5.0 Pro، كما عززت من فهم الموقع المكاني، والاتساق البنيوي، والتحرير التفاعلي الدقيق.
يمكن للمستخدم أن يحدد موقعًا على الصورة، أو حتى يرسم بضع خطوط عابرة، ليقوم النموذج بالتعديل على المنطقة المحددة — تعديل حقيقي لما ترسمه بالضبط.
من اتساق البنية المكانية، إلى الاستمرارية الديناميكية على المدى الطويل، ثم الاستجابة الدقيقة للعمليات الخارجية — كل هذه بالضبط هي المسائل التقنية التي لا غنى عنها في بناء عالم ثلاثي الأبعاد تفاعلي.
التقنيات التي راكمتها الشركات الصينية خلال السنوات الماضية في التوليد البصري والتحرير القابل للتحكم، بدأت اليوم تُظهر إمكانات امتدادها نحو نماذج العالم العامة.
في عام 1895، نقل الإخوة لوميير قطارًا يدخل إلى المحطة إلى الشاشة.
لم يكن من السهل على الناس في ذلك الوقت أن يتصوروا أن هذا الاختراع الجديد سيغير خلال أكثر من قرن لاحق الطريقة التي يسجل بها الإنسان العالم ويعرضه تغييرًا جذريًا.
وبعد أكثر من قرن، ومع ظهور رسوميات الحاسوب وتقنيات الواقع الافتراضي تباعًا، بدأ الإنسان يحاول الانتقال من مشاهدة العالم داخل الشاشة إلى التجربة والاستكشاف الغامر للعالم الرقمي.
والآن، ومع ظهور نماذج العالم، وجد هذا التطور التقني الممتد لأكثر من مئة عام منعطفًا جديدًا —
فالآلات بدأت تتعلم البنية المكانية للعالم الواقعي وقوانين عمله، وتحاول توليد بيئات افتراضية قابلة للاستكشاف المستمر والتفاعل الفوري، بل واستخدامها لمحاكاة الواقع.
قبل أكثر من مئة عام، تعلّم الإنسان تسجيل العالم بالصور المتحركة.
وبعد أكثر من مئة عام، بدأنا نحاول أن نصبح الصورة عالمًا يمكننا دخوله بأجسادنا، بل وتغيير الواقع من خلاله.
بعد مرور أكثر من مئة عام، هذه المرة، بدأنا أخيرًا نحاول الدخول إلى الصور التي صنعناها بأنفسنا.