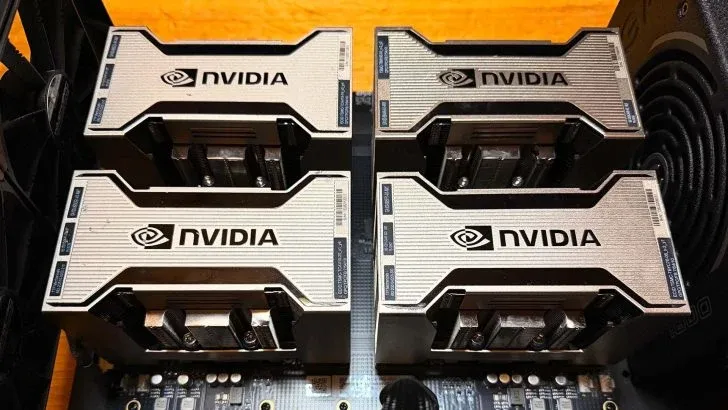
IT之家 أخبار في 13 أكتوبر: نشرت قناة Jun Yamog على يوتيوب أمس (12 أكتوبر) مقطع فيديو يجري فيه اختبارًا لتركيب 4 بطاقات Tesla V100 على لوحة حاملة NVLink، وفي معيار Qwen3.8-Flash-Next،سرعة معالجة المحفزات الطويلة أسرع بنسبة 230% من M5 Ultra وأسرع بنسبة 40% من 2 من أجهزة DGX Spark.
وبعد الاطلاع على المعلومات المتاحة، يذكر IT之家 أن Tesla V100 هي وحدة معالجة رسومية لمراكز البيانات أطلقتها إنفيديا عام 2017، وتعتمد على معمارية Volta، وتُستخدم عادةً في تدريب واستدلال الذكاء الاصطناعي. ويأتي إصدارها بسعة 32GB مزوَّدًا بذاكرة عرض من نوع HBM2، وتتيح عرض نطاق ترددي للذاكرة يبلغ 900GB/s قراءةً سريعةً لمعلمات النماذج الكبيرة وبياناتها.
أما NVLink فهي تقنية إنفيديا للترابط عالي السرعة بين وحدات معالجة الرسوميات، تُستخدم لنقل البيانات مباشرةً بين عدة وحدات. وبالمقارنة مع التواصل عبر PCIe، يمكن لـ NVLink تقليل اختناقات الترابط، وهي شائعة الاستخدام في الخوادم متعددة وحدات معالجة الرسوميات وعناقيد الحوسبة للذكاء الاصطناعي.
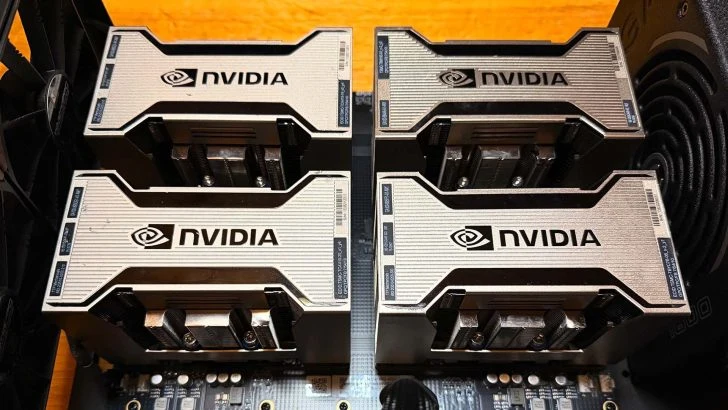
توفر لوحة NVLink الحاملة هذه نطاقًا تردديًا يبلغ 300GB/s وتأتي مزوَّدة بـ 6 وصلات NVLink 2.0. ولإتاحة استيعاب 4 وحدات معالجة رسومية مستقلة، عدّل المُختبِر مِبرّد NVIDIA A100 ليتمكن من تبديد استهلاك طاقة يبلغ نحو 300W لكل وحدة V100، وربط اللوحة عبر واجهة PCIe x8.
استخدم صاحب القناة نموذج Qwen3.8-Flash-Next بكمّية 4-bit للاختبار، وشملت عناصر المقارنة 2 من أجهزة DGX Spark مزودة بذاكرة موحدة بسعة 128GB من نوع LPDDR5X، بالإضافة إلى جهاز Mac Studio المزود بمعالج M5 Ultra.
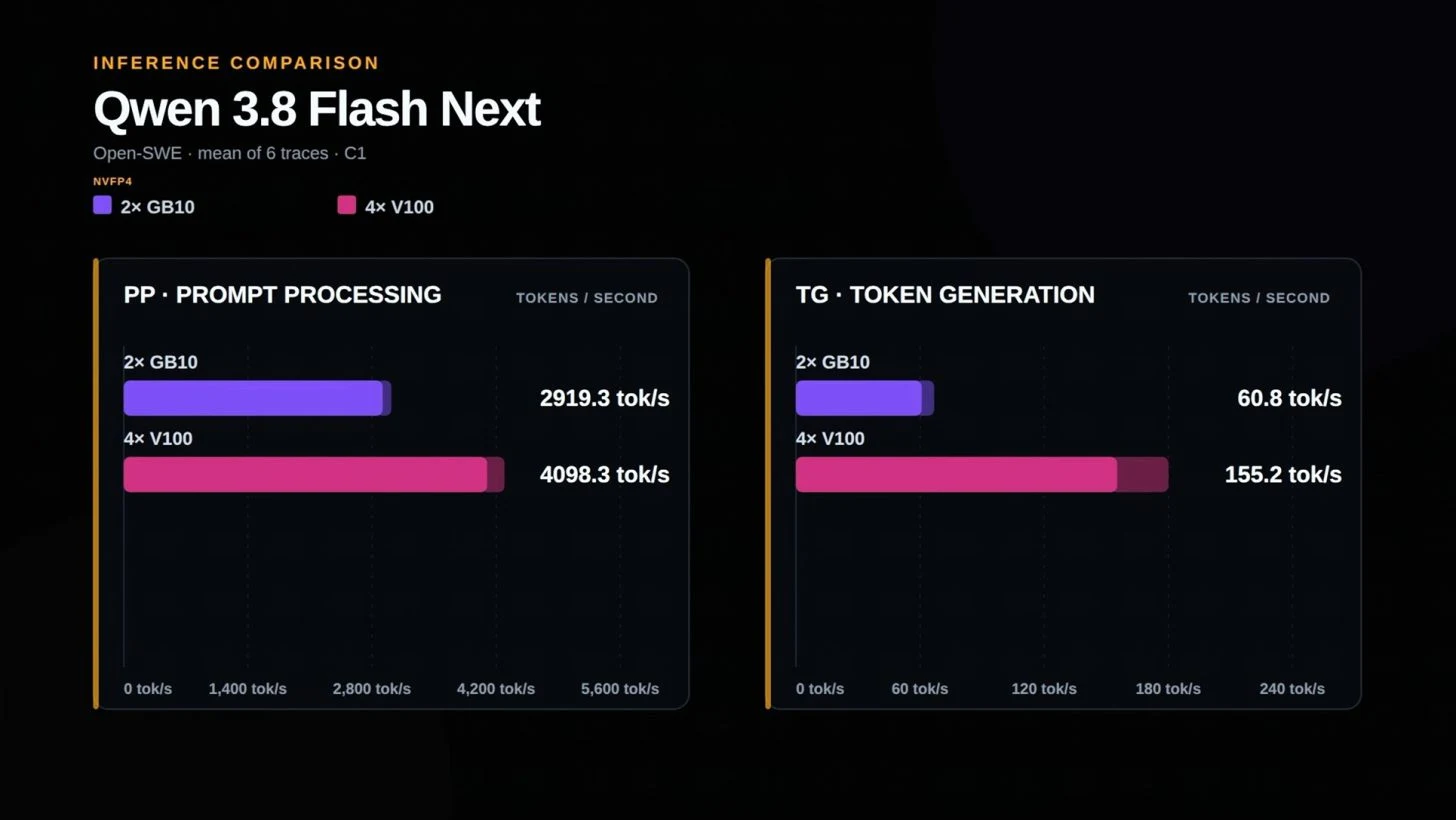
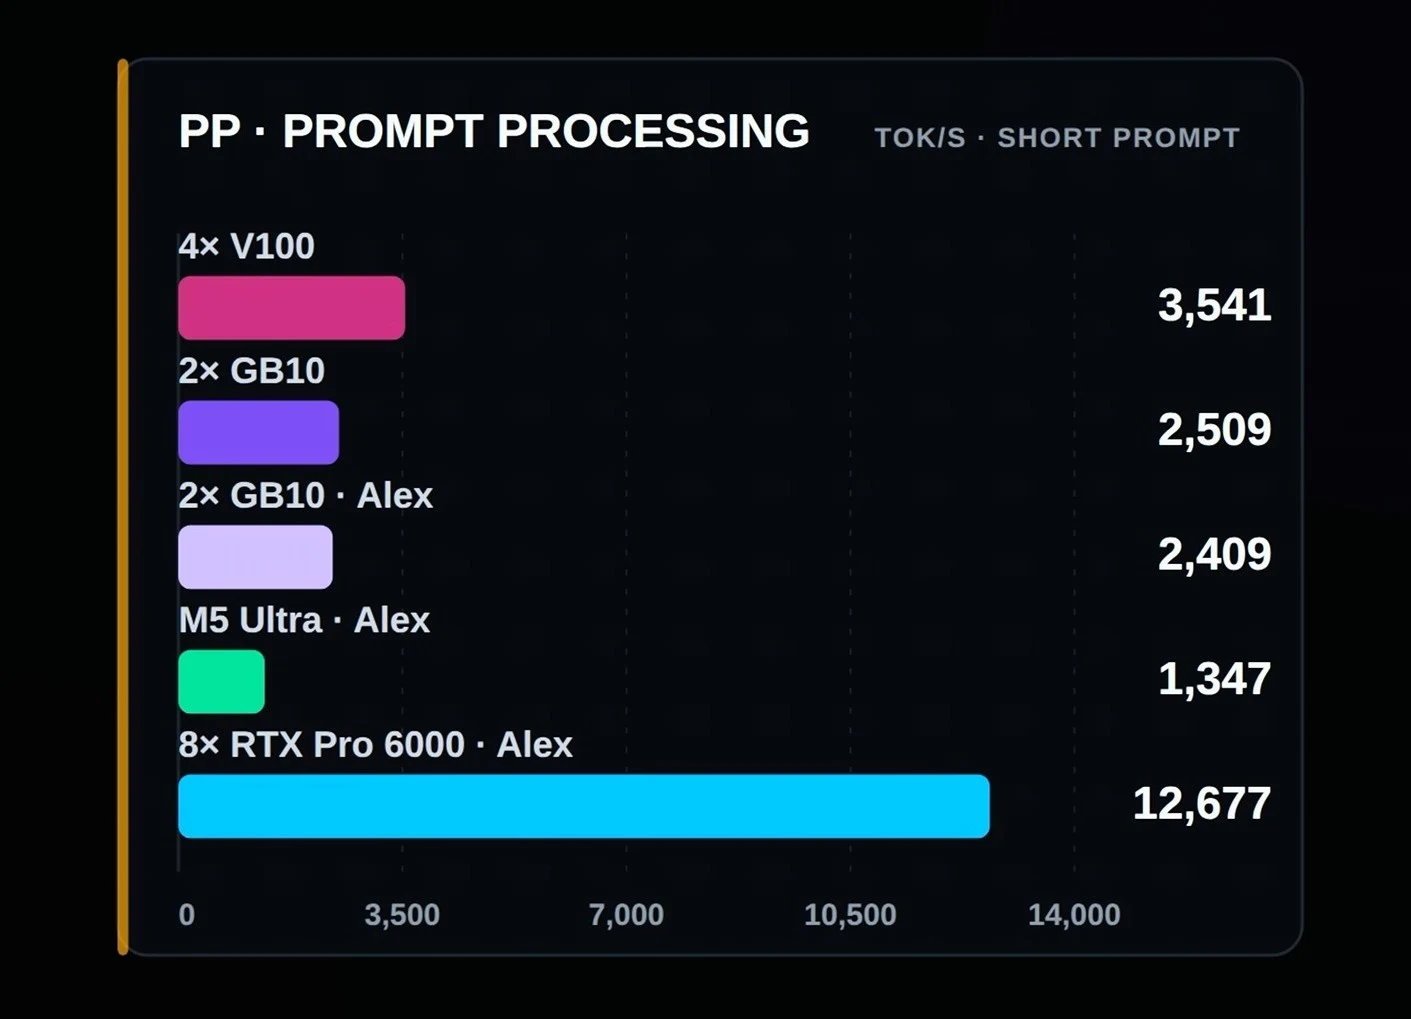
في اختبار معالجة المحفزات الطويلة، تفوقت الوحدات الـ 4 من V100 على مجموعة DGX Spark بنسبة 40% وعلى M5 Ultra بنسبة 230%. وأشار المُختبِر إلى أن الفارق الكبير مقارنة بـ Apple Silicon قد يُعزى جزئيًا إلى نقص التحسين البرمجي.
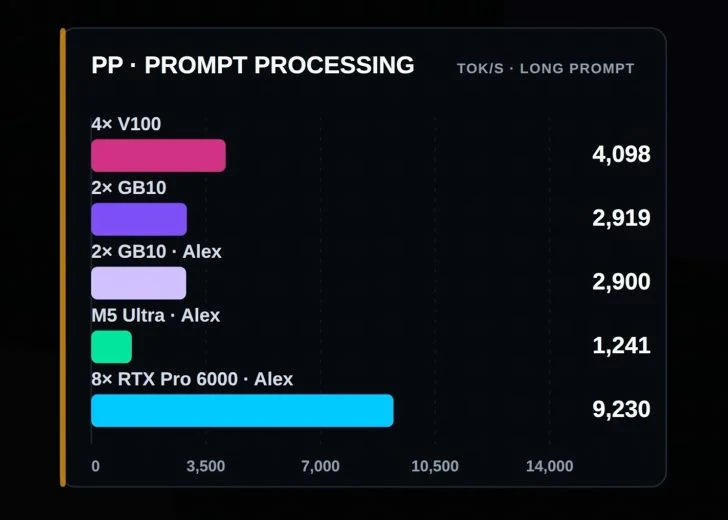
وفي اختبار معالجة المطالبات القصيرة، حافظ عنقود V100 على ميزة سرعة قدرها 40% مقارنةً بـ DGX Spark، وتفوّق على M5 Ultra بنسبة 163%. وتُظهر هذه النتائج أن وحدات معالجة الرسوميات القديمة لمراكز البيانات لا تزال تمتلك قدرة إنتاجية عالية في أحمال استدلال معينة.
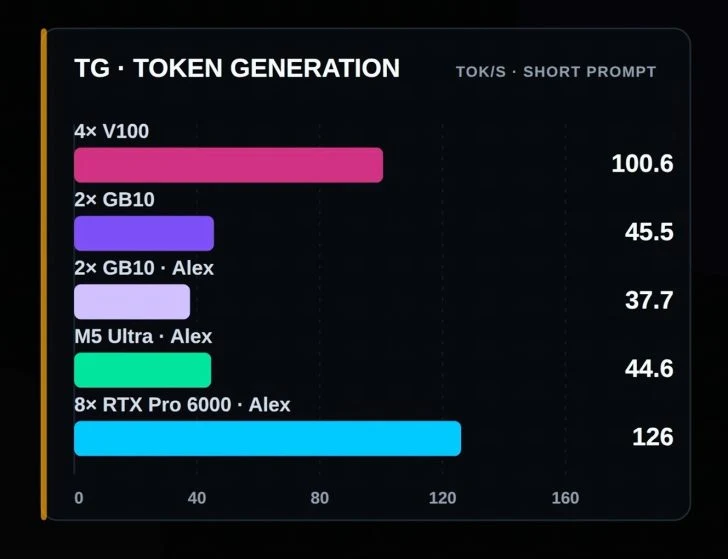
في اختبار توليد الـ Token للمحفزات القصيرة، حققت الوحدات الـ 4 من V100 سرعة 100.6 tok/s، أي أسرع بنسبة 121% من 2 من أجهزة DGX Spark؛ بينما بلغت نتيجة M5 Ultra 44.5 tok/s.