
أهم النقاط
- يتطلب بناء الوكلاء طويلي الأمد إدارةً مستمرة للسياق، واتخاذ تلك القرارات باستخدام نموذج لغوي ضخم من الطراز الأول أمرٌ بطيء ومكلف. توفر نماذج فك الترميز المقيدة (CDMs) من ScaleDown حلاً يجعلها أسرع وأرخص.
langchain-scaledownيجعل استخدام نماذج ScaleDown في وكيلك أمرًا سهلاً، ويأتي مزودًا بواسطة وسيطة (middleware) للتلخيص وضغط نتائج الأدوات والاستخراج.- الآن يتم دعم ScaleDown في LangSmith LLM Gateway، بحيث يتم تتبع نداءاته واحتسابها ضمن إنفاقك وحدود المعدل الخاصة بك.
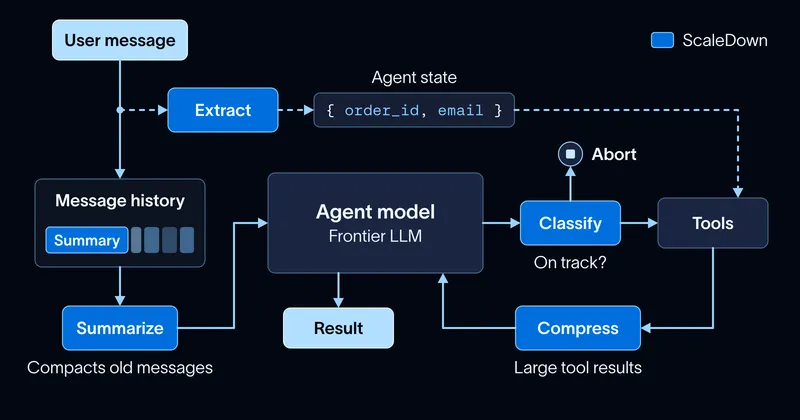
يتلخص بناء الوكلاء طويلي الأمد في فن إدارة السياق: تحديد المعلومات التي تدخل إلى نافذة السياق، ومتى. ذلك يعني تلخيص السجل القديم، وضغط نتائج الأدوات الكبيرة، واستخراج البيانات الصحيحة من المدخلات الطويلة. كل خطوة من هذه الخطوات هي قرار. تاريخيًا كنا نتخذها باستخدام نماذج LLM، وهو أمر بطيء ومكلف بالحجم الذي يحتاجه الوكيل طويل الأمد.
لجعل تلك القرارات أسرع وأقل تكلفة، أصبح لدينا الآن langchain-scaledown التكامل و الدعم في LangSmith LLM Gateway لأجل ScaleDownنماذج فك الترميز المقيّدة (CDMs) الخاصة بها. فبينما يكتب نموذج LLM متعدد الأغراض أي سلسلة نصية رمزاً تلو الآخر، يُدرَّب نموذج CDM على مهمة واحدة ويعيد فقط الإجابات التي تسمح بها تلك المهمة، مثل تسمية من قائمتك أو مقاطع من المدخل. وهذا يجعله أصغر حجماً وأسرع وأرخص بكثير: إذ تشير ScaleDown إلى أن نماذجها أسرع بـ 200 مرة وأرخص بـ 467 مرة من النماذج الرائدة في هذه المهام الضيقة.
تأتي هذه الوحدة المتكاملة مع ثلاث البرمجيات الوسيطة لأجل LangChain و الوكلاء العميقون: واحد يلخّص التاريخ القديم، وآخر يضغط نتائج الأدوات الكبيرة، وثالث يستخرج بيانات منظّمة من المحادثة. في هذا المقال، نستعرض ما هي نماذج ScaleDown وكيفية استخدامها من أجل تقليص النطاق سياق وكيلك.
ما هي النماذج التي يقدمها ScaleDown؟
يقدم ScaleDown أربعة نماذج، كل منها مُدرَّب لمهمة واحدة، لذا يمكن أن يكون كل منها أكثر كفاءة بكثير من نموذج LLM متعدد الأغراض:
- تلخيص يكتب ملخصًا قصيرًا لنص طويل.
- ضغط يقصّ كتلة السياق إلى الأجزاء ذات الصلة بالسؤال.
- استخراج يستخرج الحقول التي تصفها من النص، مع درجة ثقة وموقع في المصدر لكل حقل.
- تصنيف تُقيّم النص مقارنةً بتسميات تحددها أنت وتُرجع احتمالية لكل منها. ويمكنك أن تقرر ما إذا كنت تريد إرجاع سبب بلغة طبيعية يوضح سبب إجراء التصنيف.
كل نموذج يستوعب حتى 1M من الرموز من المدخلات، لذا يتسع عقد كامل أو صفحة سياسات طويلة أو ساعة من سجل الوكيل في استدعاء واحد دون تقسيم. وهي أيضاً متعددة الوسائط: فميزتا الاستخراج والتلخيص والتصنيف تقبلان الصور وملفات PDF الممسوحة ضوئياً مباشرةً إضافةً إلى النصوص غير المهيكلة، وبالتالي تعمل لقطة شاشة أو فاتورة ممسوحة ضوئياً كمدخل.
وفقاً لـ معايير ScaleDown الخاصة, المقاسة مقابل متوسط GPT-5.5 وGPT-5.4 Mini وGPT-5.4 Nano على مجموعات بيانات عامة, فإن التلخيص أرخص بـ 41 مرة وأسرع بـ 2.7 مرة، والضغط أرخص بـ 138 مرة وأسرع بـ 1.8 مرة، مع تحقيق دقة أعلى في كليهما.
إذا كنت قد استخدمت نموذج قرار مثل Jev, فسيبدو لك ScaleDown Classify مألوفاً: كلاهما يُرجع إجابة مُنمَّطة مع احتمالية. يقبل Jev نص فقط، حتى 32K من الرموز من الحالة لكل سؤال. أما Classify فيقبل حتى 1M من الرموز، بما في ذلك الصور، و سبباً من جملة واحدة إلى كل قرار. عندما يوجّه الوكيل تذكرة أو يوقف عملية بناءً على تسمية، يخبرك السبب بالسبب، مما يسهّل تصحيح أخطاء الوكيل.
تلخيص سجل الرسائل
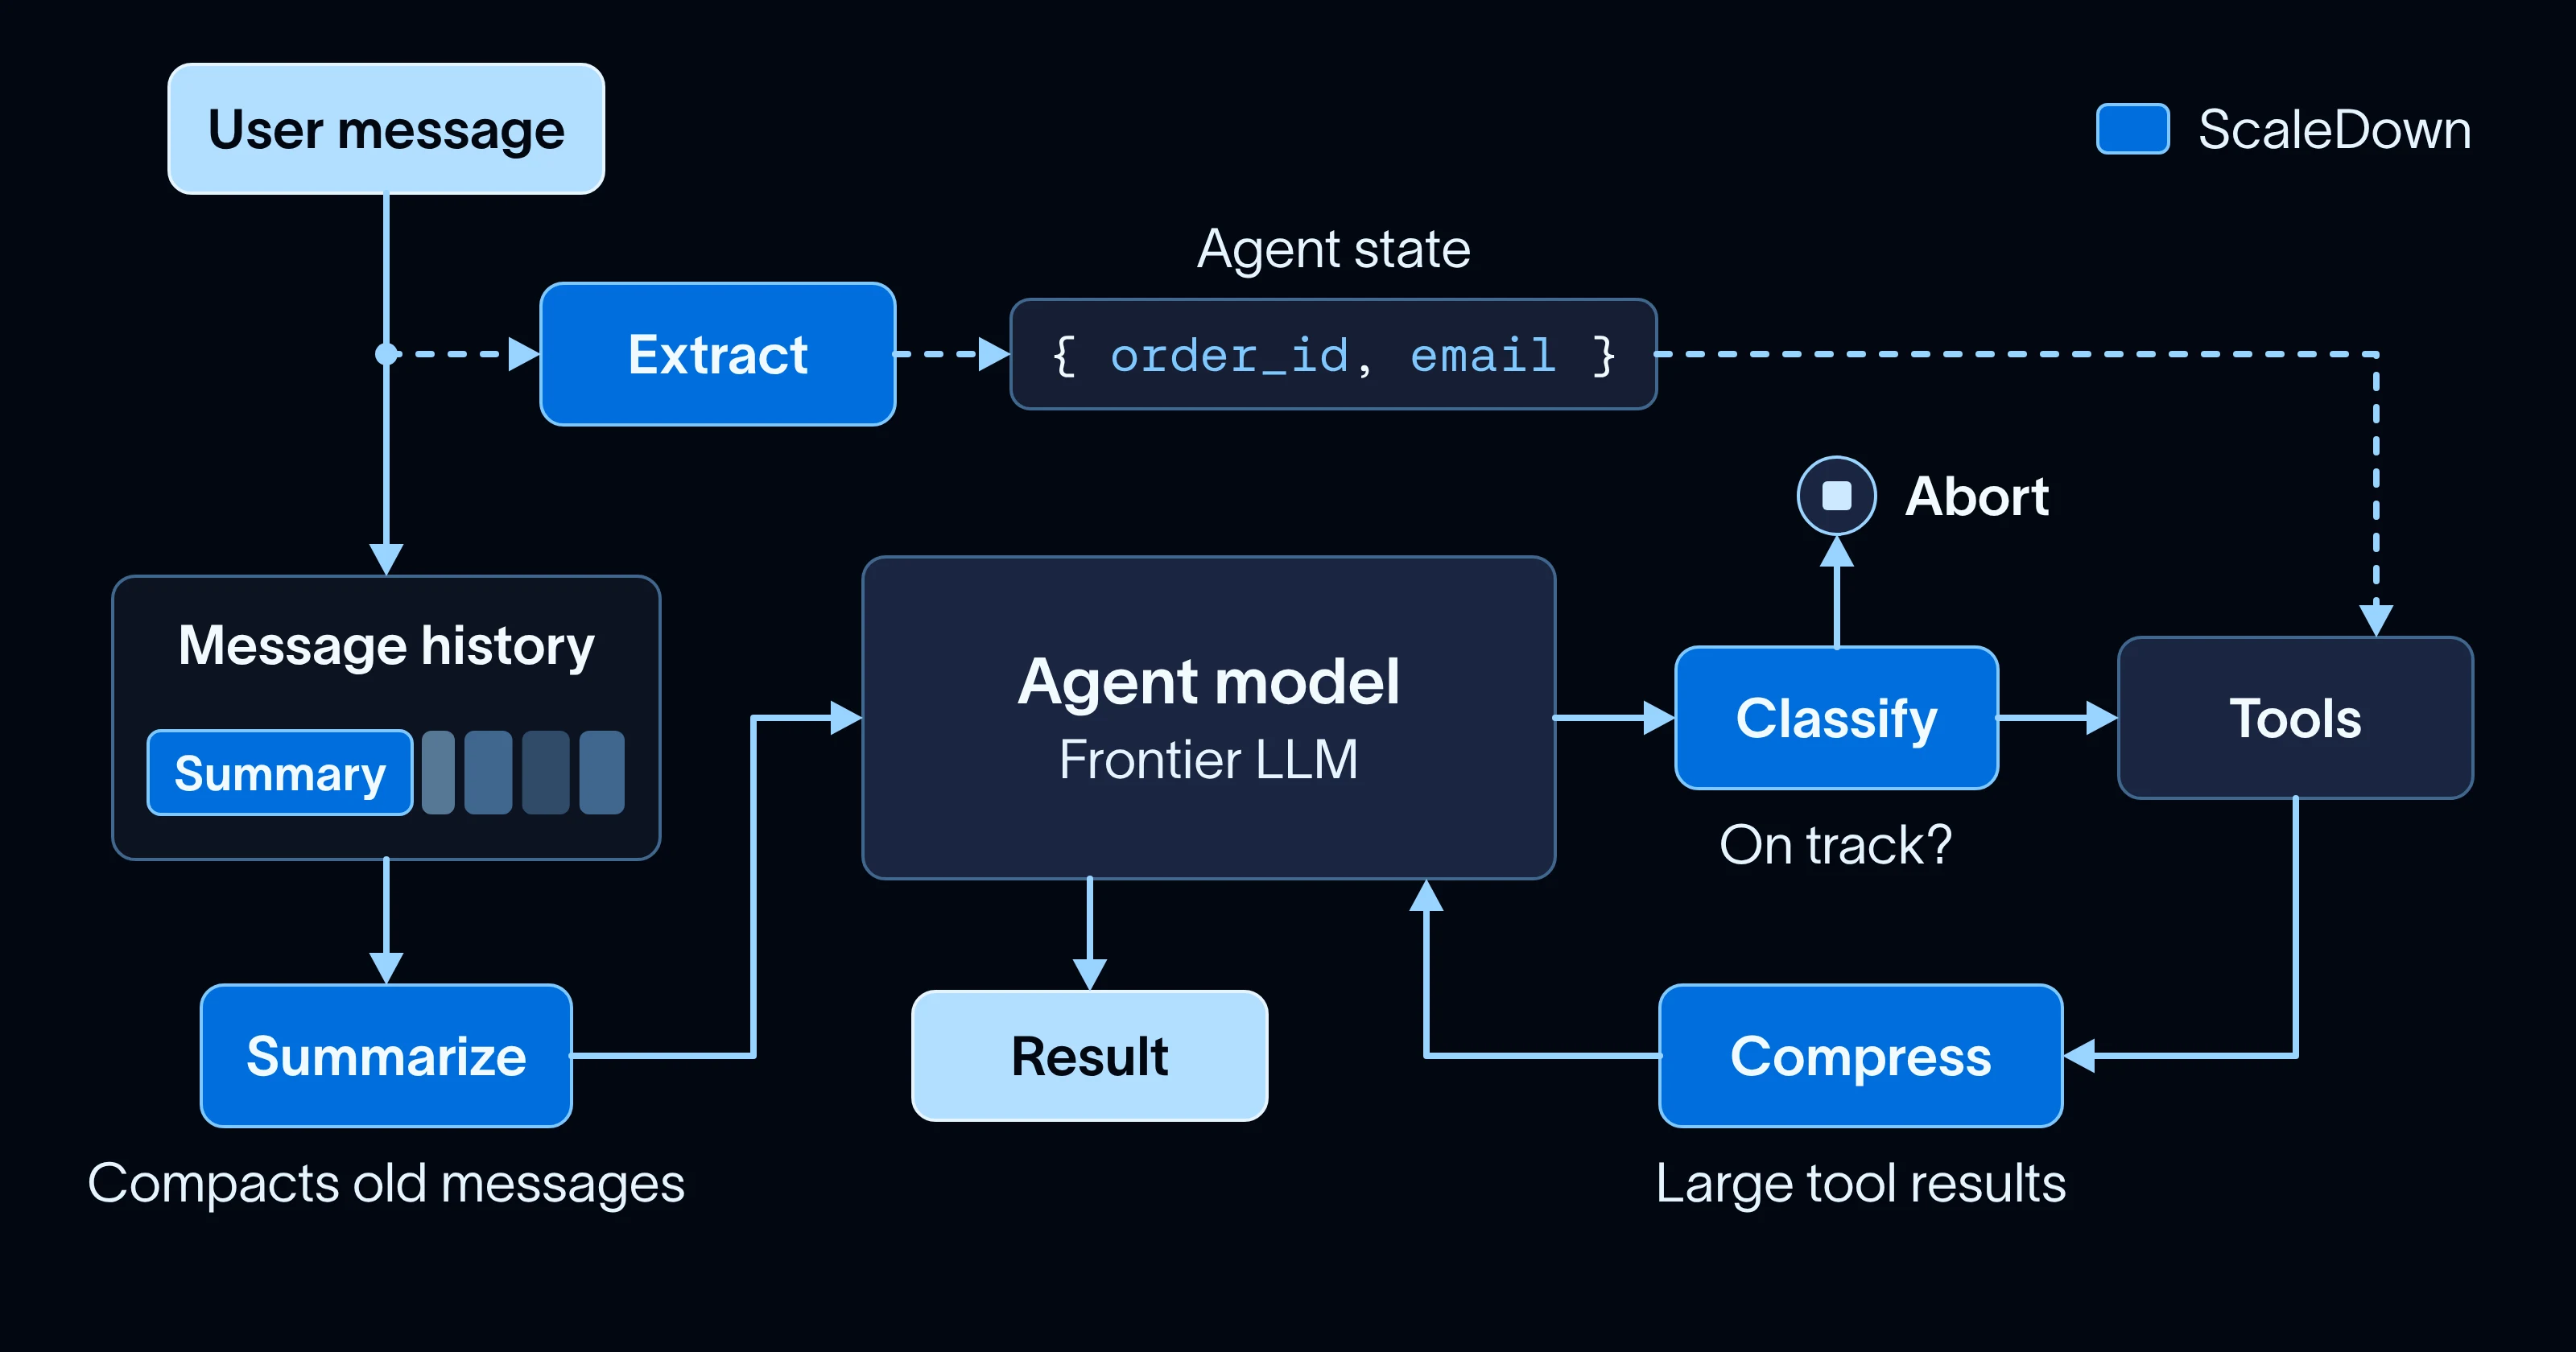
تحتاج الوكلاء طويلو الأمد إلى التلخيص لأن سجلهم يتجاوز في النهاية نافذة السياق. الوكيل البرمجي الذي عمل لمدة ساعة لديه عشرات قراءات الملفات ومخرجات الأدوات في سجله، معظمها لم يعد بحاجة إليها نصياً كما هو. وتلخيصها باستدعاء آخر لنموذج رائد يضيف تكلفة وزمن استجابة في كل مرة يمتلئ فيها السجل.
ScaledownSummarizationMiddleware يستبدل وسيط التلخيص المدمج في Deep Agents وسيط التلخيص. يأخذ نفس خيارات trigger و keep لتحديد متى يلخّص وأي الرسائل الحديثة يُبقي عليها، ويكتب ScaleDown الملخص:
from deepagents import create_deep_agent
from langchain_scaledown import ScaledownSummarizationMiddleware

agent = create_deep_agent(
    model="openai:gpt-6-sol",
    tools=[run_tests],
    middleware=[
        ScaledownSummarizationMiddleware(
            "openai:gpt-6-sol",  # the agent’s model, used for its context window
            trigger=("fraction", 0.8),
            keep=("fraction", 0.1),
        ),
    ],
)
يحتفظ الوكيل بنموذجه الخاص للتخطيط وكتابة الكود. فقط الملخص ينتقل إلى ScaleDown، الذي يعيد افتراضيًا نفس الأقسام التي في مطالبة التلخيص الخاصة بـ LangChain (النية، الملخص، المخرجات، والخطوات التالية). إذا فشلت استدعاء ScaleDown، يترك الوسيط السجل كما هو ويواصل الوكيل العمل. الوسيط نفسه يعمل مع create_agent.
الضغط نتائج الأدوات
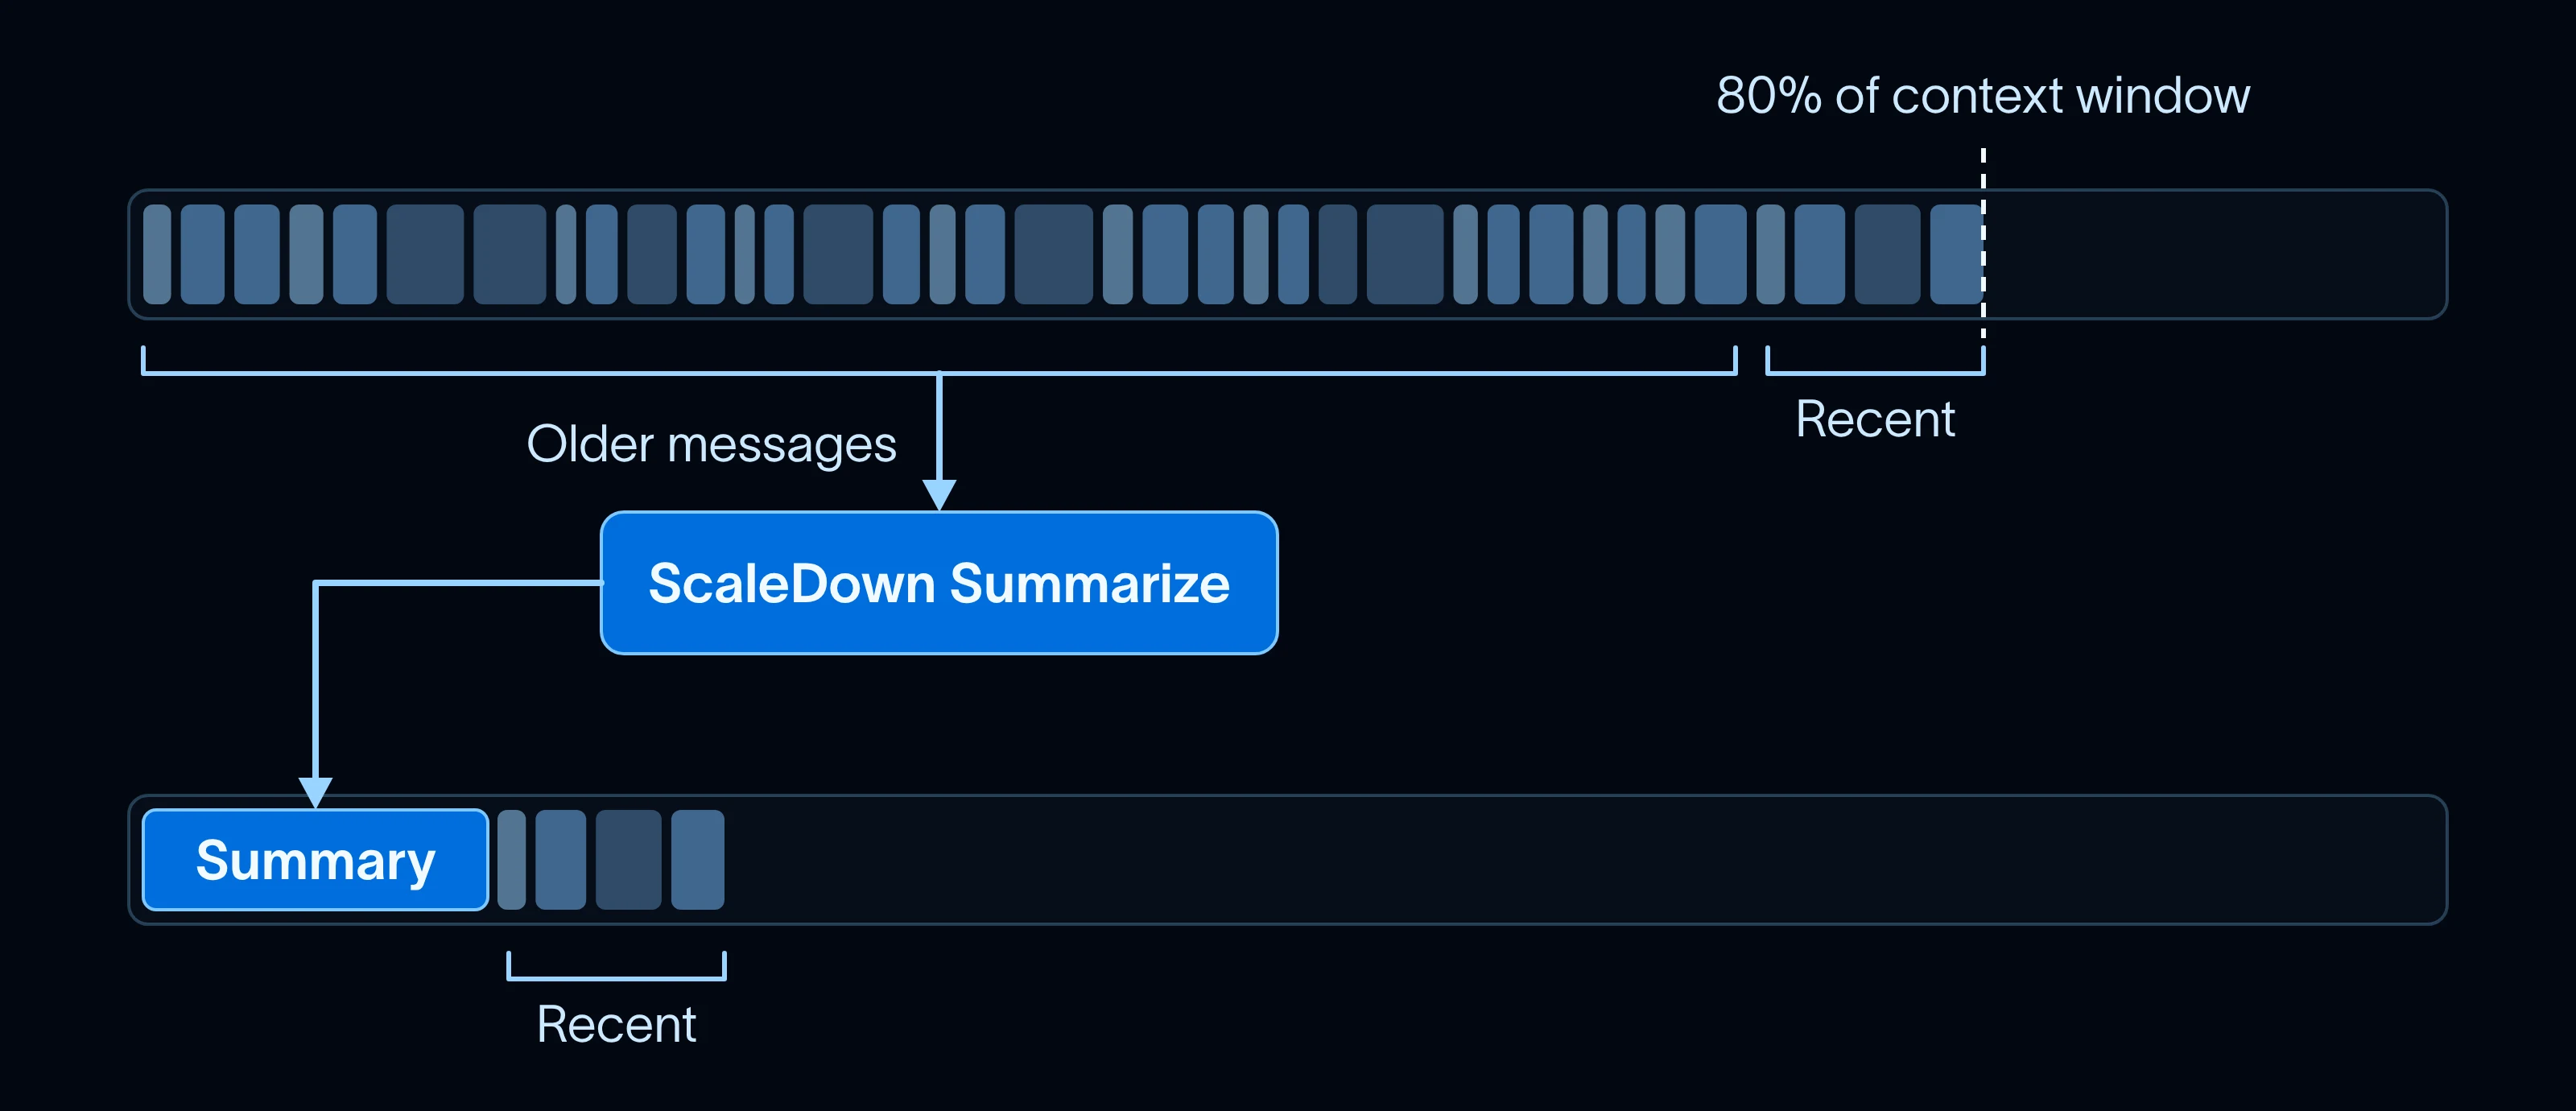
تستدعي الوكلاء طويلة الأمد الكثير من الأدوات، وتبقى كل نتيجة كبيرة في السياق لبقية التشغيل. صفحة ويب مُستخرجة يمكن أن تمتد لعشرات آلاف الأحرف بينما يحتاج الوكيل منها فقرة واحدة فقط. كل خطوة لاحقة تدفع ثمن تلك الرموز من جديد، ويصبح الوكيل أقل قدرة على البقاء في المهمة مع امتلاء السياق الخاص به.
ScaledownToolCompressionMiddleware يضيف معلمة اختيارية compression_query إلى أدواتك. عندما يحتاج النموذج جزءًا فقط من نتيجة، يعبّئ compression_query في استدعاء الأداة، مثلًا "refund policy for EU orders". يزيل الوسيط تلك المعلمة قبل تشغيل الأداة، ثم يضغط ScaleDown المخرجات إلى الأجزاء ذات الصلة قبل أن يراها النموذج:
from deepagents import create_deep_agent
from langchain_scaledown import ScaledownToolCompressionMiddleware

agent = create_deep_agent(
    model="openai:gpt-6-luna",
    tools=[search_docs, fetch_url],
    middleware=[ScaledownToolCompressionMiddleware(tools=["fetch_url"])],
)
أدواتك لا تتغير، لذا يعمل هذا مع أي أداة، بما في ذلك أدوات MCP. في هذا التتبع، قام ScaleDown بتقليص صفحة توثيق طويلة بنسبة تقارب 90% قبل أن يراها النموذج. تبدأ النتيجة المضغوطة بملاحظة تشبه هذه الملاحظة، حتى يستطيع النموذج استدعاء الأداة مرة أخرى دون compression_query إذا احتاج الصفحة الكاملة:
[Compressed by ScaleDown for "refund policy for EU orders":
 18,402 -> 3,110 chars.
 Call this tool again without `compression_query` for the full output.]
استخراج بيانات مهيكلة
يسحب الوكلاء باستمرار قيمًا محددة مما يقرؤونه، مثل معرّف أو تاريخ أو حقل يحتاجه استدعاء الأداة التالي. هذا الاستخراج يقع داخل حلقة الوكيل، لذا يجب أن يكون سريعًا بما يكفي كي لا يضيف تأخيرًا لكل دورة، ودقيقًا بما يكفي لتستطيع الأداة استخدام القيمة كما هي.
على سبيل المثال، قبل أن يستطيع وكيل الدعم فتح تذكرة، يحتاج رقم الطلب ورسالة الخطأ والبريد الإلكتروني للعميل. يمكن للنموذج الرئيسي تعبئتها كوسائط للأداة، لكنه قد يعيد صياغة رمز خطأ أو يخطئ في كتابة عنوان بريد إلكتروني بدلًا من نسخه حرفيًا.
ScaledownExtractionMiddleware يسلّم هذه الخطوة إلى ScaleDown. تصف كل حقل بلغة بسيطة، وينسخ Extract القيمة من النص. ويمكن أن يكون الحقل أيضًا مجموعة من التصنيفات، يجيب عليها ScaleDown عبر Classify، حتى يمكن توجيه التذكرة حسب نوع المشكلة. قبل أول استدعاء للنموذج في التشغيل، يرسل الوسيط رسائل المستخدم إلى Extract ويحفظ الحقول في حالة الوكيل تحت scaledown_extraction، حيث تستطيع أدواتك قراءتها:
from deepagents import create_deep_agent
from langchain.tools import ToolRuntime, tool
from langchain_scaledown import ScaledownExtractionMiddleware

ticket = ScaledownExtractionMiddleware(
    entities={
        "order_id": "Order number the customer mentions",
        "error_message": "Exact error message or code the customer saw",
        "customer_email": "Customer's email address",
        "issue_type": {
            "labels": [
                {"name": "billing", "rubric": "Is this about a charge, refund, or payment?"},
                {"name": "technical", "rubric": "Is this about a bug or something not working?"},
                {"name": "account", "rubric": "Is this about login, password, or account settings?"},
            ]
        },
    },
    context_chars=0,  # skip evidence snippets to keep state small
)


@tool
def file_ticket(runtime: ToolRuntime) -> str:
    """File a support ticket with the details gathered so far."""
    fields = runtime.state.get("scaledown_extraction", {}).get("fields", {})
    return crm.create_ticket(**fields)  # your ticketing system


agent = create_deep_agent(model="openai:gpt-6-sol", tools=[file_ticket], middleware=[ticket])
يقرأ Extract رسائل المستخدم فقط، ولا يقرأ أبدًا ردود الوكيل، لذا كل قيمة هي شيء قاله العميل فعلًا. مع checkpointer، تُعاد عملية الاستخراج في كل دورة، فيكتمل السجل كلما أضاف العميل تفاصيل. بالنسبة لـ "فشل الطلب A-1042 مع رمز الخطأ ERR_PAYMENT_DECLINED. لقد جربت بالفعل بطاقة مختلفة."، تعود الحقول بالشكل التالي:
{
    "order_id": "A-1042",
    "error_message": "ERR_PAYMENT_DECLINED",
    "customer_email": None,  # not mentioned yet
    "issue_type": "billing",
}
التصنيف الانحراف
يقرر الوكيل خطوته التالية بناءً على حالته الحالية، مثل ما إذا كانت المهمة قد اكتملت أو ما إذا كان آخر استدعاء لأداة قد نجح. تصنيف هذه الحالة يتم في كل دورة، لذا يجب أن يكون رخيصًا وسريعًا.
إحدى الحالات التي يستحق أن تُكتشف في الوكلاء طويلي الأمد هي الانحراف: التكرار على نفس الاستدعاء الفاشل للأداة، أو التعثر في دورة غير منتجة. لا توجد وسيط (middleware) جاهز لهذا، لكن يمكنك استدعاء أي نموذج من ScaleDown من خلال وسيط مخصصلديك. إليك قاطع دائرة (circuit breaker) يعمل بعد كل استدعاء للنموذج، ويرسل السجل إلى ScaleDown Classify، ويوقف التنفيذ عند خروجه عن المسار:
import os

import requests
from deepagents import create_deep_agent
from langchain.agents.middleware import after_model
from langchain_core.messages import AIMessage, get_buffer_string

LABELS = [
    {"name": "progressing", "rubric": "Is the agent making new progress on the user's task?"},
    {"name": "looping", "rubric": "Is the agent repeating the same steps without new results?"},
    {"name": "drifting", "rubric": "Is the agent working on something the user did not ask for?"},
]


@after_model(can_jump_to=["end"])
def circuit_breaker(state, runtime):
    result = requests.post(
        "https://api.scaledown.xyz/classify",
        headers={"x-api-key": os.environ["SCALEDOWN_API_KEY"]},
        json={"text": get_buffer_string(state["messages"]), "labels": LABELS},
    ).json()

    label = result["top_label"]
    if label != "progressing" and result["scores"][label] > 0.8:
        return {"jump_to": "end", "messages": [AIMessage(f"Stopped: {result['reasoning']}")]}
    return None


agent = create_deep_agent(model="openai:gpt-6-sol", tools=[run_tests], middleware=[circuit_breaker])
يعيد Classify احتمالًا لكل تسمية، فأنت تختار مدى الثقة المطلوبة قبل تفعيل القاطع. ويظهر سبب السطر الواحد الخاص به في الرسالة النهائية، بحيث يمكنك رؤية سبب توقف التنفيذ. والنسخة الأكثر لطفًا لا تُنهي التنفيذ عند أول تفعيل: بل تضيف السبب إلى المحادثة كتنبيه لتغيير المسار، ولا تتوقف إلا إذا انحرف الوكيل مرة أخرى.
تُظهر هذه الأقسام الأربعة بعض الأماكن التي تناسبها نماذج ScaleDown، والقائمة ليست شاملة. يمكنك مزجها ومطابقتها، مثل تشغيل extract / summarize على نتائج الأدوات الطويلة، أو التصنيف لتوجيه النموذج في وقت التشغيل. اطّلع على ScaleDown Cookbooks لرؤية طرق أخرى لاستخدام نماذج CDM عبر أنواع مختلفة من البيانات.
ScaleDown في بوابة LangSmith LLM Gateway
الـ بوابة LangSmith LLM يتيح لك استدعاء النماذج عبر مزودين متعددين بمفتاح API واحد من LangSmith، ويتتبع كل استدعاء، ويفرض ينفقون و حدود المعدل. أصبح ScaleDown الآن أحد مزودو الوصول المباشر إلى النماذج, في ال /scaledown المسار.
يضيف المسؤول مفتاح ScaleDown الخاص بك إلى مساحة العمل أسرار مزوّدي الخدمة كما SCALEDOWN_API_KEY مرة واحدة. ثم أشر langchain-scaledown عند البوابة وقم بالمصادقة باستخدام مفتاح LangSmith الخاص بك:
export SCALEDOWN_BASE_URL="https://gateway.smith.langchain.com/scaledown"
export SCALEDOWN_API_KEY="$LANGSMITH_API_KEY"
يظهر كل استدعاء لـ ScaleDown بعد ذلك كـ LangSmith trace ويُحتسب ضمن الحدود نفسها المطبقة على استدعاءات النموذج الأخرى لديك.
متى لا تستخدم ScaleDown
احتفظ بنموذج لغوي ضخم (LLM) عام الأغراض للتوليد المفتوح، مثل كتابة التعليمات البرمجية وصياغة الردود والتخطيط. وهذا يتماشى مع نهج "رخيص افتراضيًا، وحدّي عند الاستثناء" من منشورات Jev: استخدام نموذج لغوي كبير عام للأجزاء الصعبة، ونماذج متخصصة للخطوات عالية الحجم المحيطة به.
يتميز ScaleDown بأنه سريع ورخيص بما يكفي للتشغيل في كل دورة، بحيث يستطيع الوكيل الخاص بك اتخاذ القرارات المنظمة التي يعتمد عليها إدارة السياق دون إبطاء الحلقة الرئيسية أو دفع أسعار النماذج الرائدة مقابلها. في الوكيل طويل الأمد، تحدث تلك القرارات في كل دورة تقريبًا، لذا تتراكم الوفر بسرعة.
ابدأ الآن
تثبيت التكامل و قم بتعيين مفتاح API خاص بك في ScaleDown:
uv pip install -U langchain-scaledown
export SCALEDOWN_API_KEY="..."
جديد ScaleDown تحصل الحسابات على 50M من الرموز المجانية. الـ وثائق تكامل ScaleDown تغطي خيارات التهيئة لكل وسيط. جرّب langchain-scaledown وأخبرنا برأيك في منتدى LangChain, Xأو GitHub.