
LFM2.5-24B-A2B هو نموذج استدلال بـ 24B معاملًا مع 2B معاملات نشطة فقط، مصمم لوكلاء سريعين وخاصين يعملون على الجهاز. يفكر قبل أن يجيب، ويستدعي الأدوات، وينجز المهام متعددة الخطوات داخل هياكل الوكلاء الشهيرة. ولأن 2B معاملات فقط نشطة لكل رمز، فإن كل رمز استدلالي رخيص، بحيث يمكنك تشغيل الوكلاء باستمرار على عتادك الخاص.
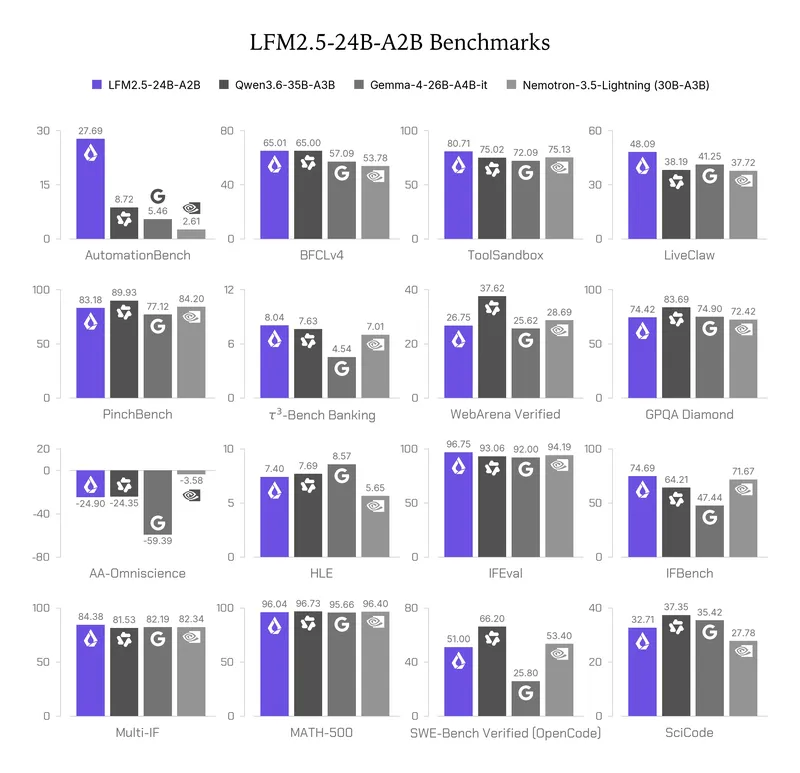
- وكيل في المستوى الأول: تنافسي مع Qwen3.6-35B-A3B، وهو نموذج لديه نحو 50% معاملات إجمالية ونشطة أكثر، في مهام الوكلاء واستخدام الأدوات، بنتيجة 48.09 على LiveClaw مقابل 38.19.
- استدلال بسرعة MoE: يفكر دائمًا قبل أن يجيب. مع 2B معاملات نشطة فقط لكل رمز، فإن كل رمز استدلالي رخيص.
- استدلال فعّال: 184 tok/s على Apple M5 Max وحتى 21K tok/s للمخرجات على وحدة NVIDIA B300 GPU واحدة.

كيف بنينا وكيل استدلال بـ 2B معاملات نشطة
يقوم LFM2.5-24B-A2B على LFM2-24B-A2B ويحافظ على بنيته: 40 طبقة، و64 خبيرًا في كل كتلة MoE مع توجيه top-4، ونفس المزيج من الالتفافات القصيرة المبوّبة وGQA. تتوسع نافذة السياق من 32K إلى 131K رمز، كما أن توسعة المُرمِّز في المكان تضاعف حجم المفردات من 65K إلى 128K رمز لترميز أفضل للغات غير اللاتينية. وعلى عكس سابقه، فهو نموذج استدلالي بحت ينتج سلسلة تفكير صريحة قبل إجابته النهائية.
تم توسيع التدريب المسبق من ~17T إلى ~33T رمز. ثم يضيف التدريب المتوسط 2T رمز عند سياق 32K، بتركيز على الاستدلال والرياضيات والبرمجة واتباع التعليمات والنصوص متعددة اللغات، و300B رمز عند سياق 131K، بتركيز على بيانات السياق الطويل. وتظهر استدعاءات الأدوات والمسارات متعددة الأدوار في كلا الطورين. ويحوّل التدريب اللاحق النموذج الأساسي إلى وكيل في خمس مراحل:
- الضبط الدقيق المُوجَّه (SFT)
- تخصص المعلمين
- التقطير متعدد المجالات على السياسات (MOPD)، غير الوكيلي: تقطير المعلمين المتخصصين في المهام غير الوكيلية.
- MOPD، وكيلي: مرحلة تقطير ثانية تركز على المهام الوكيلية.
- التعلم المعزز الوكيلي (Agentic RL): تدريب النموذج داخل هياكل وكلاء، مثل OpenClaw, Hermes Agent, Piو OpenCode.
نتائج الاختبارات المرجعية
قيّمنا LFM2.5-24B-A2B مقابل Qwen3.6-35B-A3B وGemma-4-26B-A4B-it وNemotron-3.5-Lightning على 16 اختبارًا مرجعيًا تغطي استخدام الأدوات وسير عمل الوكلاء والمعرفة واتباع التعليمات والرياضيات والبرمجة. وهو أصغر نموذج في المجموعة، ومع ذلك فهو تنافسي مع نماذج MoE التي لديها نحو 50% معاملات إجمالية ونشطة أكثر.
| المعيار المرجعي | LFM2.5-24B-A2B | Qwen3.6-35B-A3B | Gemma-4-26B-A4B-it | Nemotron-3.5-Lightning (30B-A3B) |
|---|---|---|---|---|
| AutomationBench | 27.69 | 8.72 | 5.46 | 2.61 |
| BFCLv4 | 65.01 | 65.00 | 57.09 | 53.78 |
| ToolSandbox | 80.71 | 75.02 | 72.09 | 75.13 |
| LiveClaw | 48.09 | 38.19 | 41.25 | 37.72 |
| PinchBench | 83.18 | 89.93 | 77.12 | 84.20 |
| τ³-Bench Banking | 8.04 | 7.63 | 4.54 | 7.01 |
| WebArena Verified | 26.75 | 37.62 | 25.62 | 28.69 |
| GPQA Diamond | 74.42 | 83.69 | 74.90 | 72.42 |
| AA-Omniscience | -24.90 | -24.35 | -59.39 | -3.58 |
| HLE | 7.40 | 7.69 | 8.57 | 5.65 |
| IFEval | 96.75 | 93.06 | 92.00 | 94.19 |
| IFBench | 74.69 | 64.21 | 47.44 | 71.67 |
| Multi-IF | 84.38 | 81.53 | 82.19 | 82.34 |
| MATH-500 | 96.04 | 96.73 | 95.66 | 96.40 |
| SWE-Bench Verified (OpenCode) | 51.00 | 66.20 | 25.80 | 53.40 |
| SciCode | 32.71 | 37.35 | 35.42 | 27.78 |
*تم تقييم جميع النماذج باستخدام vLLM، وباعتماد معلمات التوليد الموصى بها لكل معيار قياس.
بالنسبة لتطبيقك، تتمثل نقاط القوة في استخدام الأدوات واتباع التعليمات. يتصدر LFM2.5-24B-A2B منافسيه أو يوازيهم في خمسة من أصل ثمانية معايير قياس للاستخدام الوكيلي والأدوات (AutomationBench وBFCLv4 وToolSandbox وLiveClaw وτ³-Bench Banking)، وفي AutomationBench يحصل على درجة تفوق بأكثر من ثلاثة أضعاف أفضل نموذج منافس. كما يتصدّر معايير اتباع التعليمات الثلاثة جميعها. تحافظ النماذج الأكبر على أفضلية في معايير قياس المعرفة المكثفة مثل GPQA Diamond وHLE وAA-Omniscience، وفي معايير البرمجة مثل SWE-Bench Verified (OpenCode) وSciCode، لذا اربط LFM2.5-24B-A2B بأدوات الاسترجاع أو البحث في الويب لأحمال العمل كثيفة المعرفة.
تجعل هذه النتائج LFM2.5-24B-A2B أساسًا قويًا للوكلاء الذين يحتاجون إلى التفكير، واستدعاء الأدوات، والعمل بموثوقية على جهازك.
سرعة الاستدلال على المعالج المركزي ومعالج الرسوميات
يأتي LFM2.5-24B-A2B بدعم من اليوم الأول عبر منظومة الاستدلال بأكملها، بما في ذلك llama.cpp وMLX وvLLM وSGLang وONNX.
الاستدلال على الأجهزة الطرفية. LFM2.5-24B-A2B هو الأسرع بين نماذج MoE المقارَنة، إذ يفك شيفرات بمعدل 184 رمزًا/ثانية على M5 Max و114 رمزًا/ثانية على Ryzen AI Max+ 395. وهذا يعني سرعة تصل إلى 1.7 ضعف سرعة أفضل نموذج منافس، مع استخدام أقل قدر من الذاكرة.

استدلال معالج الرسوميات. LFM2.5-24B-A2B هو أسرع نموذج في فئته الحجمية، إذ يصل إلى أكثر من 21K رمز مخرَج في الثانية عند التزامن العالي على شريحة B300 واحدة.

كيفية استخدام LFM2.5-24B-A2B
لجِ LFM2.5-24B-A2B عندما تحتاج إلى وكلاء يفكرون، ويستدعون الأدوات، ويعملون بموثوقية على جهازك.
ثبّت أحدث إصدار من transformers (متوافق مع transformers>=5.0.0):
pip install -U transformers
ثم حمّل النموذج وشغّله:
from transformers import AutoModelForCausalLM, AutoTokenizer, TextStreamer

model_id = "LiquidAI/LFM2.5-24B-A2B"
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    device_map="auto",
    dtype="bfloat16",
#   attn_implementation="flash_attention_2" <- uncomment on compatible GPU
)
tokenizer = AutoTokenizer.from_pretrained(model_id)
streamer = TextStreamer(tokenizer, skip_prompt=True, skip_special_tokens=True)

prompt = "What is C. elegans?"

input_ids = tokenizer.apply_chat_template(
    [{"role": "user", "content": prompt}],
    add_generation_prompt=True,
    return_tensors="pt",
    tokenize=True,
)["input_ids"].to(model.device)

output = model.generate(
    input_ids,
    do_sample=True,
    temperature=0.1,
    top_k=50,
    repetition_penalty=1.05,
    max_new_tokens=512,
    streamer=streamer,
)
استخدمه في إطار عمل الوكيل لديك
شغّل LFM2.5-24B-A2B محليًا خلف أي واجهة خلفية متوافقة مع OpenAI، ثم وجّه إطار عمل الوكيل لديك إليه. على سبيل المثال، مع Hermes Agent:
hermes config set model.provider custom
hermes config set model.base_url http://localhost:8080/v1
hermes config set model.default LFM2.5-24B-A2B
hermes config set model.context_length 131072
hermes config set model.api_mode chat_completions
hermes config set agent.tool_use_enforcement true
يعتمد المنفذ على الواجهة الخلفية للخدمة لديك: llama.cpp وMLX يستخدمان 8080، وvLLM يستخدم 8000، وSGLang يستخدم 30000، وLM Studio يستخدم 1234. انظر بطاقة النموذج للحصول على إعدادات OpenClaw وPi، و دليلنا للإعداد الكامل. كما يمكنك الاطلاع على مدونة الإصدار لأمثلة بالفيديو.
ابدأ الاستخدام مع LFM2.5-24B-A2B
كلٌّ من LFM2.5-24B-A2B وLFM2.5-24B-A2B-Base متاحان اليوم بأوزان مفتوحة على Hugging Face:
- التنزيل: LFM2.5-24B-A2B-Base و LFM2.5-24B-A2B على Hugging Face.
- الاستخدام في بيئة العمل الخاصة بك: اتبع دليلنا حول كيفية تشغيل وكيل محلي، مثل OpenClaw وHermes Agent وPi.
- الضبط الدقيق: كيّف LFM2.5-24B-A2B لمهمتك من خلال دروس الضبط الدقيق.
لا نطيق صبرنا لرؤية ما ستبنيونه.
الاقتباس
إذا استخدمت هذا العمل، يُرجى الاستشهاد بمدونة الإصدار:
@article{liquidAI202624BA2B,
  author  = {Liquid AI},
  title   = {LFM2.5-24B-A2B: Built for Fast On-Device Agents},
  journal = {Liquid AI Blog},
  year    = {2026},
  note    = {www.liquid.ai/blog/lfm2-5-24b-a2b},
}