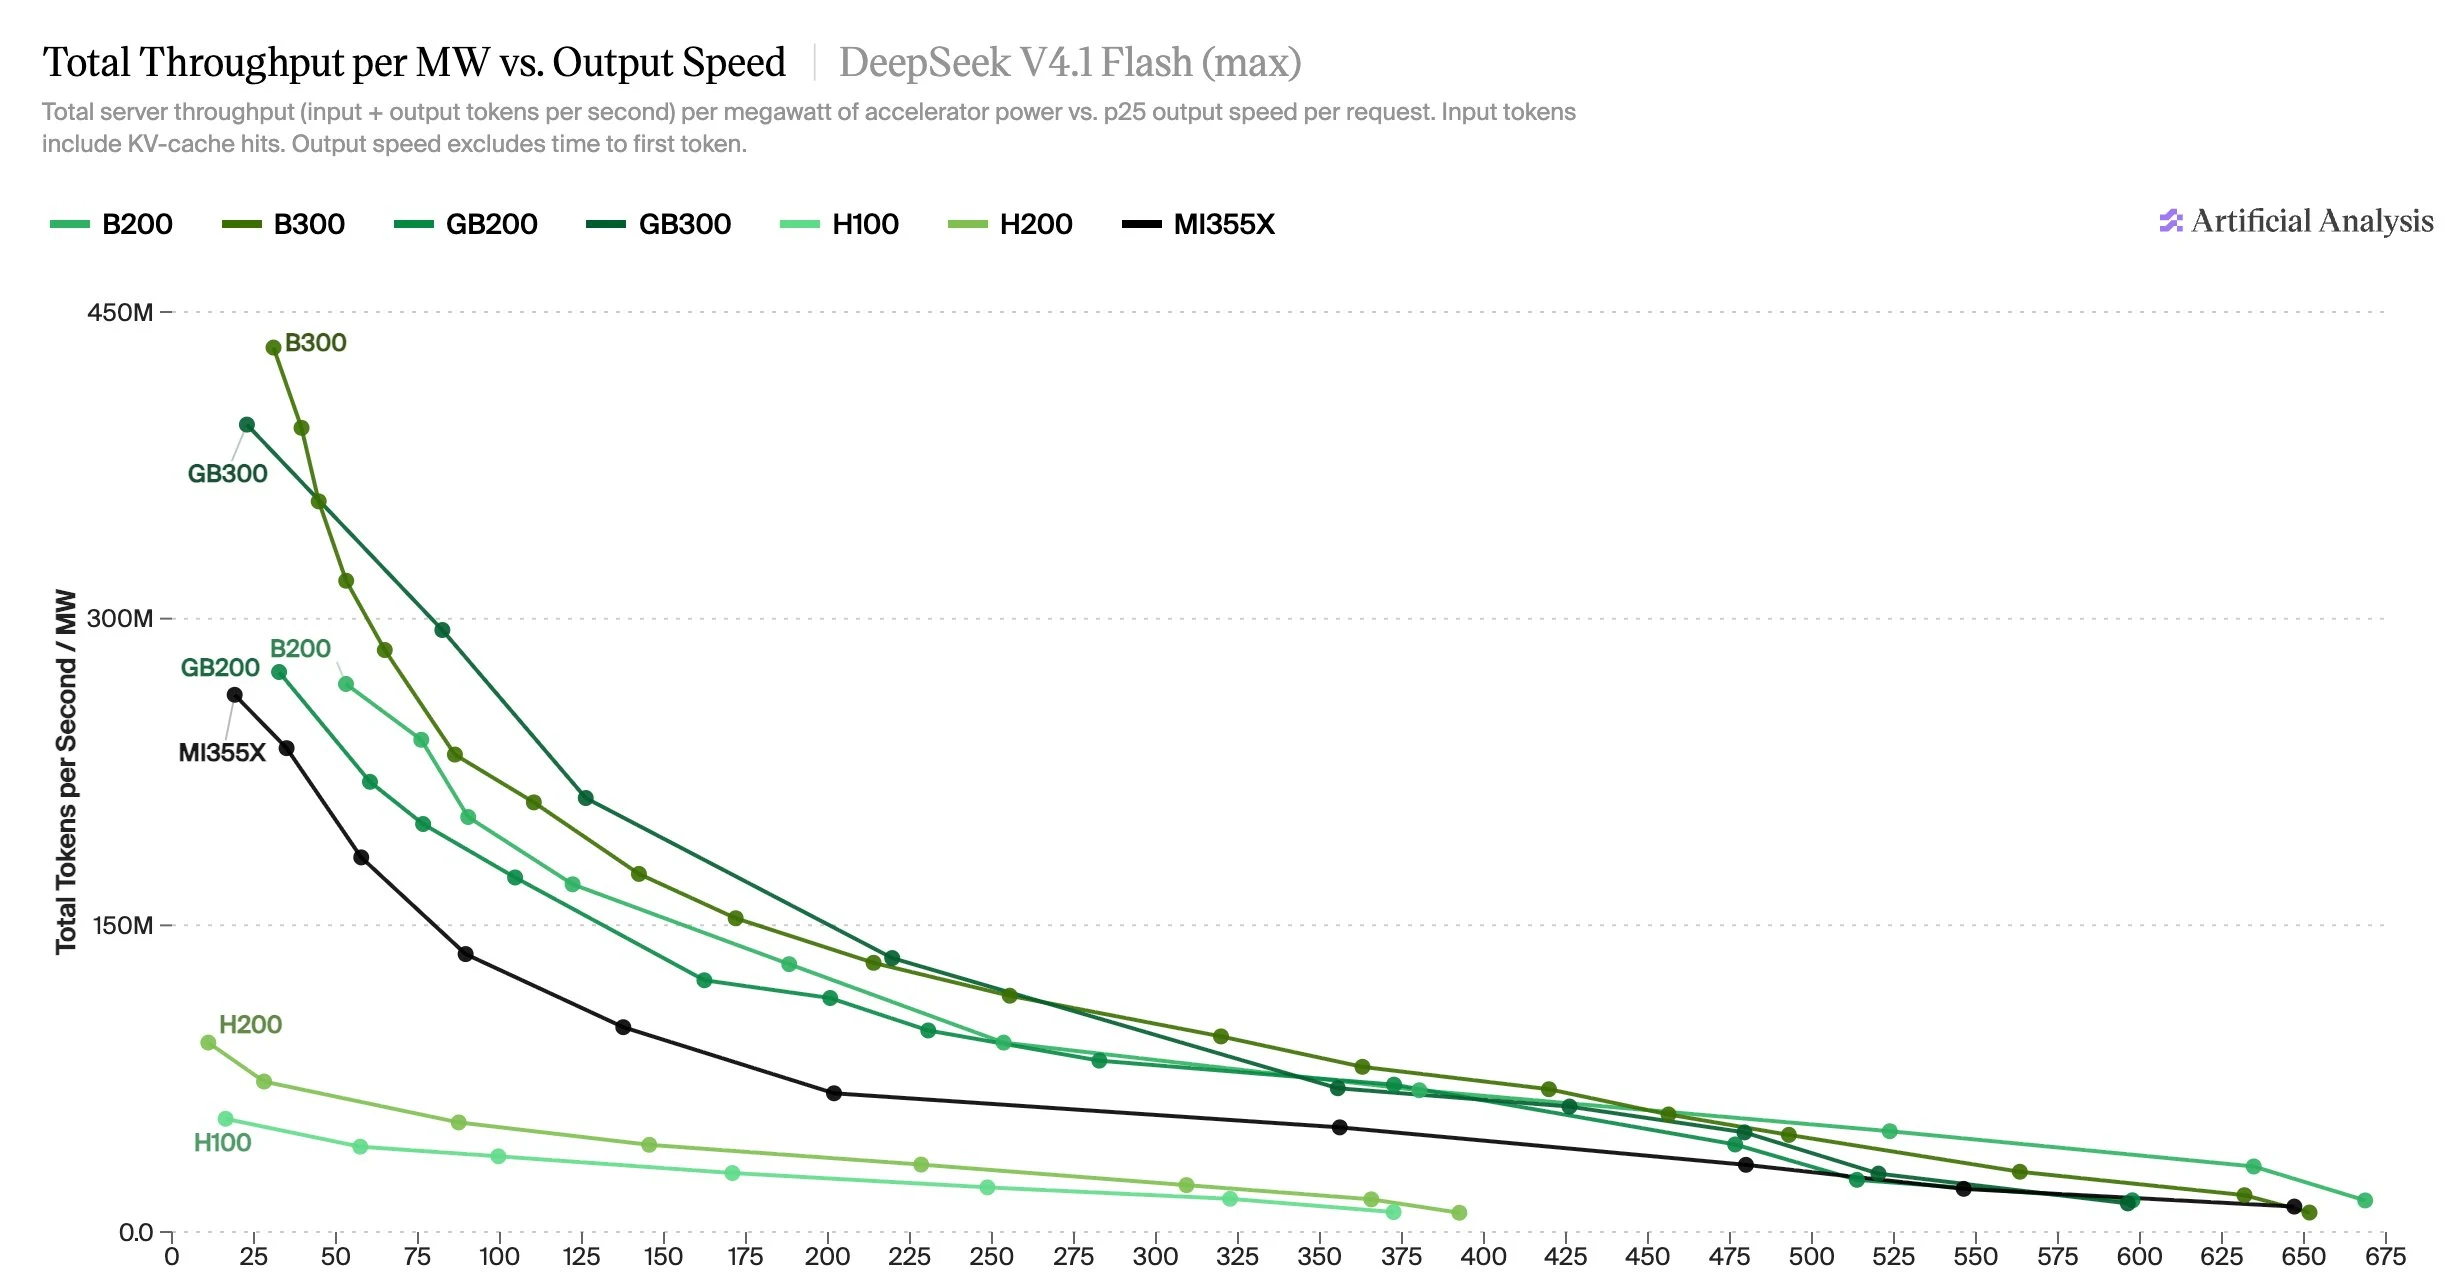
لقد أضفنا DeepSeek V4.1 Flash إلى AA-AgentPerf، مع نتائج لأجهزة NVIDIA وAMD. عند 100 رمز/ثانية لكل مستخدم، تحتل NVIDIA GB300 المركز الأول بمعدل نقل يصل إلى 261M رمز/ثانية لكل ميغاواط.
AA-AgentPerf هو معيار الأداء الخاص بنا للاستدلال الوكيلي. يعيد تشغيل جلسات برمجة وكيلية حقيقية، بما في ذلك التخزين المؤقت للأوامر وتأخيرات استدعاء الأدوات، لتقديم قياس واقعي لأداء الاستدلال في أحمال العمل الوكيلية اليومية. نقيس إجمالي إنتاجية النظام لكل ميغاواط من الطاقة التشغيلية، وسرعة الإخراج لكل وكيل عند مستويات تزامن مختلفة، لإظهار المقايضة بين استغلال النظام وتجربة المستخدم الفردية.
ينضم DeepSeek V4.1 Flash اليوم إلى لوحة الصدارة. ما يرفع عدد النماذج المميزة في اللوحة إلى أربعة، بجانب DeepSeek V4 Pro 0813 وKimi K3 وGLM-5.2/5.3. نحن نطوّر قائمة النماذج المميزة مع صدور نماذج open-weights شعبية جديدة، وسنقدّم نتائج في يوم الإطلاق (day-0) للإصدارات الرئيسية المستقبلية.
خلفية عن DeepSeek v4.1 Flash:
➤ يحصل على 39 في مؤشر الذكاء من Artificial Analysis، متقدمًا على إصدار DeepSeek السابق V4 Pro 0813 الذي حصل على 36، بعدد معلمات يعادل نحو الثلث (552B «عمود فقري» و16B نشطة، مقابل 1.6T و49B)
➤ وهو مبني على بنية جديدة، بتصميم مرمِّز-فاكِّك سببي يُنشِّط 8B من المعلمات لكل رمز إدخال و16B لكل رمز إخراج. يستخدم كذلك 196B معلمة إضافية من ذاكرة n-gram تُسمى Engram يمكن وضعها في ذاكرة المضيف بدلًا من المسرِّع، وانتباهًا متناثرًا مضغوطًا يحتاج إلى نحو ربع ذاكرة KV cache لكل رمز مقارنة حتى بنموذج V4 Flash السابق
➤ هذا يجعله أكثر كفاءة بكثير في التقديم، إذ تتسع الأوزان على عدد أقل من وحدات معالجة الرسومات وتترك ذاكرة KV cache الأصغر مساحةً لعدد أكبر من الوكلاء المتزامنين لكل GPU
النتائج الأولية لـAA-AgentPerf لـDeepSeek V4.1 Flash:
➤ يعمل V4.1 Flash على ما لا يقل عن 2 من وحدات GPU، لذا تحصل أنظمة بمقياس الرف (rack-scale) على ميزة أقل مقارنة بالعقد الفردية ذات 8 وحدات GPU مثل B300، التي تبقى ضمن نحو 20% من GB300 NVL72 بمقياس الرف عبر المنحنى كله، وتتصدّر عند الطرفين
➤ عند 100 رمز/ثانية لكل مستخدم، تتقدم GB300 بنحو 261M رمز/ثانية لكل ميغاواط، متقدمةً على B300 (~220M)، وB200 (~193M)، وGB200 (~178M)، وMI355X (~128M)
➤ كل أنظمة Blackwell وMI355X يمكنها الوصول إلى نحو 600 إلى 670 رمز/ثانية كسرعة إخراج لوكيل واحد (أي بحجم دفعة يساوي واحداً)، مقابل 372 إلى 392 رمز/ثانية على H100 وH200
➤ يُعد V4.1 Flash أكثر ذكاءً من V4 Pro 0813 وأرخص بكثير في التقديم، محققاً ~1.3x (GB300) إلى ~6.2x (B200) من الإنتاجية لكل ميغاواط عند 100 رمز/ثانية لكل مستخدم مقارنة بقريبه الأكبر