
اختيار النموذج المناسب للتطبيق المحدد يتطلب طريقة عملية لاختباره باستخدام مدخلات نموذجية. يوفر Amazon SageMaker JumpStart وصولًا إلى قائمة واسعة من النماذج المدربة مسبقًا. في هذه المقالة، نوضح كيفية تطبيق نموذج متاح من SageMaker JumpStart، إجراء اختبار أداء خفيف وقابل للتكرار باستخدام SDK Python لـ SageMaker، وحذف نقطة النهاية عند انتهاء الاختبار. بالنسبة للنماذج المدعومة والقدرة المتاحة، يوفر هذا سير العمل مسار تقييم قابل للتكرار، على الرغم من أن وقت التشغيل يتغير حسب النموذج، نوع الحاوية، الحصة، ومنطقة AWS.
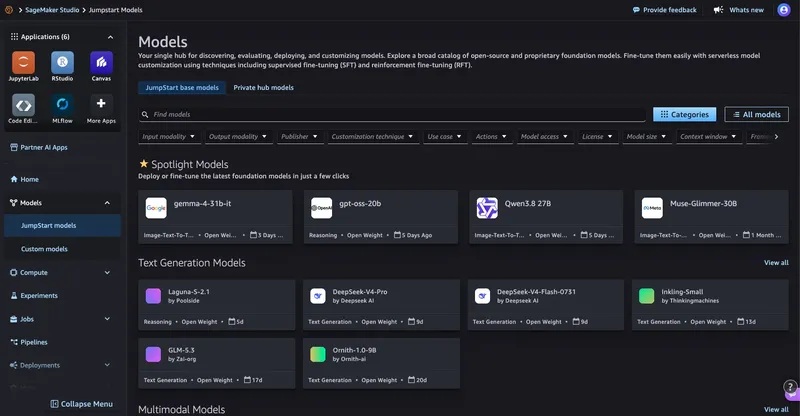
في عام 2026، قدمت SageMaker JumpStart تحسينين يبسطان عملية اكتشاف النماذج وتنصيبها. في قسم Model Hub في لوحة Amazon SageMaker AI، يمكنك تصفح كتالوج SageMaker JumpStart، ومشاهدة دفاتر الملاحظات العينة، وفتحها مباشرة في SageMaker Studio. توفر خيارات توزيع نقاط النهاية المُعدة مسبقًا إعدادات معينة مصنفة حسب الأولويات مثل التكلفة المنخفضة وانتظار الخدمة المنخفض، أو أعمال العملاء العامة عبر مجموعة من نماذج الذكاء الاصطناعي التوليدية، بما في ذلك الإعدادات المُحسّنة لـ Neuron. بالإضافة إلى ذلك، يمكنك الآن الانتقال من اكتشاف النماذج على Hugging Face إلى توزيع الذكاء الاصطناعي على SageMaker في نقرة واحدة باستخدام التكامل الجديد للروابط العميقة.
نظرة عامة على الحل
تستخدمنا الطريقة استخدامًا برنامج بايثون قابل للإعادة الاستخدام الذي يقوم بثلاث خطوات:
- اكتشف ونشر نموذج من SageMaker JumpStart.
- قم بتشغيل تحفيزات العينة الخاصة بالنموذج وقيّم التاخير، واجمع القيمة التقريبية لطول الإخراج، ومعدل توليد الطلب الواحد.
- قم بتنظيف نقطة النهاية.
هذا النمط يناسب العديد من نماذج SageMaker JumpStart المتوافقة، على الرغم من أن تنسيقات البيانات، وأنواع المشتلات المطلوبة، وشروط اتفاقية الترخيص للمستخدم النهائي، وأنظمة الاستجابة قد تتطلب تعديلات خاصة بالنموذج.
الشروط المسبقة
- حساب AWS يحتوي على صلاحيات SageMaker AI.
- بايثون 3+ مع تثبيت منتج SDK لبايثون من SageMaker v3 (
pip install "sagemaker>=3,<4"). - حصة كافية من حالات GPU للنموذج الذي تريد اختباره أو طلب زيادة الحصة.
الخطوة 1.أ: اكتشاف النماذج المتاحة
مسار الواجهة الحرارية للبحث عن النماذج في SageMaker JumpStart:
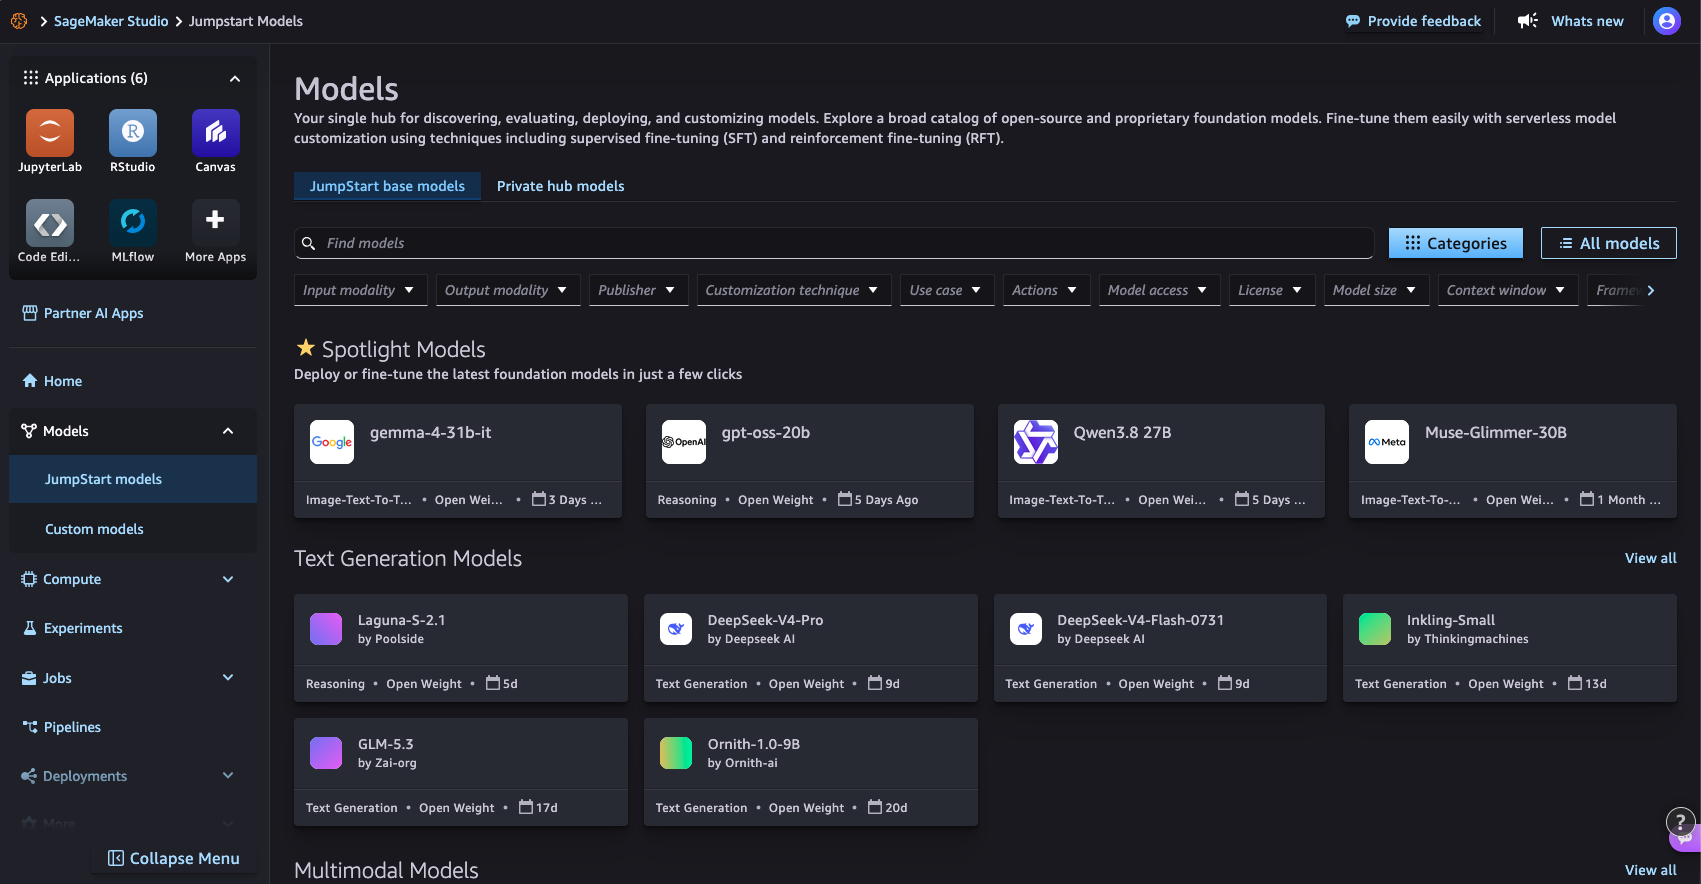
الشكل 1: تصفح كتالوج النماذج على صفحة SageMaker JumpStart Models في SageMaker Studio
مسار الكود باستخدام SDK Python لـ SageMaker:
from sagemaker.core.jumpstart.notebook_utils import (
    list_jumpstart_models,
)

REGION = "us-east-1"

models = list_jumpstart_models(
    filter="task == textgeneration",
    region=REGION,
    list_versions=True,
)

print(f"Found {len(models)} text generation models")

for model_id, model_version in models[:10]:
    print(
        f" - {model_id} "
        f"(version {model_version})"
    )
أو بحث بالاسم الطراز:
from sagemaker.core.jumpstart.notebook_utils import list_jumpstart_models

ids = list_jumpstart_models(
    filter="model_id contains qwen",
    region=REGION,
    list_versions=True,
)

print(f"{len(ids)} models matched in {REGION}\n")

for model_id, version in ids:
    print(f"{model_id:<55} v{version}")
الخطوة 1ب: نشر النموذج
مسار الواجهة الحاسمة لتركيب النماذج من SageMaker JumpStart:
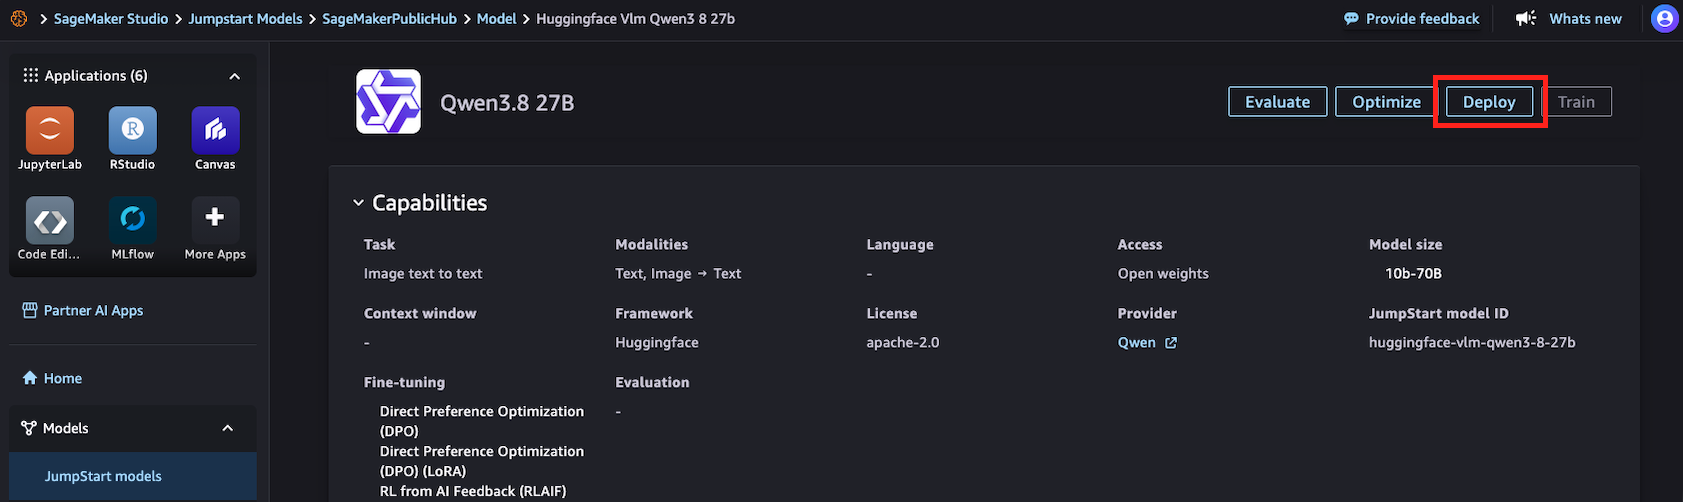
الشكل 2: نشر النموذج من صفحة التفاصيل الخاصة بـ SageMaker JumpStart في SageMaker Studio
مسار الكود باستخدام SDK Python لـ SageMaker:
import time

from sagemaker.core.jumpstart.accessors import JumpStartModelsAccessor
from sagemaker.core.jumpstart.configs import JumpStartConfig
from sagemaker.core.training.configs import Compute
from sagemaker.serve import ModelBuilder

MODEL_ID = "huggingface-vlm-qwen3-5-27b"
MODEL_VERSION = "1.13.0"
REGION = "us-east-1"
ACCEPT_EULA = False  # Set True only after reviewing the model terms

def get_field(value, name, default=None):
    if isinstance(value, dict):
        return value.get(name, default)
    return getattr(value, name, default)

# Resolve the JumpStart-recommended deployment configuration.
specs = JumpStartModelsAccessor().get_model_specs(
    region=REGION,
    model_id=MODEL_ID,
    version=MODEL_VERSION,
)

if isinstance(specs, list):
    if not specs:
        raise ValueError(
            f"No JumpStart specification found for {MODEL_ID}"
        )
    specs = specs[0]

recommended_instance_type = get_field(
    specs,
    "default_inference_instance_type",
)

if not recommended_instance_type:
    raise ValueError(
        f"No recommended instance type found for {MODEL_ID}"
    )

print(f"Model: {MODEL_ID}")
print(f"Region: {REGION}")
print(f"Recommended instance: {recommended_instance_type}")

start = time.time()

jumpstart_config = JumpStartConfig(
    model_id=MODEL_ID,
    model_version=MODEL_VERSION,
    accept_eula=ACCEPT_EULA,
)

model_builder = ModelBuilder.from_jumpstart_config(
    jumpstart_config=jumpstart_config,
    compute=Compute(
        instance_type=recommended_instance_type,
        instance_count=1,
    ),
)

model = model_builder.build()
endpoint = model_builder.deploy()
deploy_time = time.time() - start

print(f"Deployed in {deploy_time:.1f} seconds")
print(f"Endpoint: {endpoint.endpoint_name}")
الخطوة 2: تشغيل التعليمات التجريبية وقياس الأداء
from sagemaker.core.payloads import retrieve_all_examples
import json
import time

MODEL_ID = "huggingface-vlm-qwen3-5-27b"
MODEL_VERSION = "1.13.0"
REGION = "us-east-1"

example_payloads = retrieve_all_examples(
    region=REGION,
    model_id=MODEL_ID,
    model_version=MODEL_VERSION,
    serialize=True,
)

#you can re-create the endpoint pointer using the endpoint name:
#from sagemaker.core.resources import Endpoint
#endpoint = Endpoint.get(endpoint_name="<your_endpoint_name>",region=REGION)

def read_response_body(result):
    body = result.body
    if hasattr(body, "read"):
        body = body.read()
    if isinstance(body, bytes):
        body = body.decode("utf-8")
    if isinstance(body, str):
        try:
            return json.loads(body)
        except json.JSONDecodeError:
            return body
    return body

def extract_output(response):
    """Handle common JumpStart text-generation response formats."""
    if isinstance(response, list):
        response = response[0] if response else ""
    if isinstance(response, dict):
        choices = response.get("choices")
        if choices:
            choice = choices[0]
            message = choice.get("message")
            if isinstance(message, dict):
                return message.get("content", "")
            return choice.get("text", "")
        for field in (
            "generated_text",
            "output_text",
            "text",
        ):
            if field in response:
                return response[field]
    return response

results = []

for payload in example_payloads or []:
    start = time.perf_counter()
    result = endpoint.invoke(
        body=payload.body,
        content_type=payload.content_type,
        accept=payload.accept,
    )
    latency = time.perf_counter() - start
    response = read_response_body(result)
    output = extract_output(response)
    if not isinstance(output, str):
        output = json.dumps(output, indent=2)
    # This is an estimate based on whitespace-separated words.
    output_words = len(output.split())
    results.append(
        {
            "request_preview": payload.body[:50],
            "latency_s": round(latency, 2),
            "estimated_output_words": output_words,
            "words_per_second": round(
                output_words / latency,
                1,
            ) if latency > 0 else 0,
        }
    )
    print("Input:\n", payload.body, end="\n\n")
    print("Output:\n", output, end="\n\n")
    print(
        f"Latency: {latency:.2f} seconds\n"
        f"Estimated output words: {output_words}\n"
        f"Estimated single-request output generation rate: "
        f"{output_words / latency:.1f} words/second\n"
    )
    print("-" * 80)

print("\nSummary:")
for result in results:
    print(result)
النتيجة:
Input:
{"max_tokens": 256, "messages": [{"content": "What is deep learning?", "role": "user"}], "model": "/opt/ml/model"}
Output:
Here's a thinking process that leads to the explanation of deep learning:
1. **Deconstruct the Request:**
* **Question:** "What is deep learning?"
* **Intent:** The user wants a clear, comprehensive, yet accessible definition and overview of deep learning.
* **Target Audience:** Likely someone looking for a general understanding, possibly a student, tech
enthusiast, or professional exploring the field. The tone should be informative, structured, and
not overly jargon-heavy (though key terms need explanation).
2. **Initial Brainstorming & Key Concepts:**
* What is it? A subset of machine learning, which is a subset of AI.
* Core mechanism: Artificial Neural Networks (ANNs).
* "Deep" means many layers (hidden layers).
* How does it work? Learning representations from data (feature learning).
* Key applications: Image recognition, NLP, speech, self-driving cars.
* Why is it popular now? Big data, GPU power, better algorithms.
* Pros/Cons: High accuracy vs. black box, data hunger.
3. **Structuring the Answer:**
Latency: 9.07 seconds
Estimated output words: 153
Estimated single-request output generation rate: 16.9 words/second
--------------------------------------------------------------------------------
Summary:
{'request_preview': '{"max_tokens": 256, "messages": {"content": "What', 'latency_s': 9.07, 'estimated_output_words': 153, 'words_per_second': 16.9}
الخطوة 3: تنظيف
print(f"Deleting endpoint: {endpoint.endpoint_name}")
endpoint.delete()
endpoint.wait_for_delete()
print("Endpoint deleted")
الخلاصة
هذا النمط ينطبق على العديد من نماذج SageMaker JumpStart المتاحة، لكن تنسيق البيانات المدخلة، ونوع المثيل المطلوب، والعقد الإطاري العام، وتحليل الرد قد يتطلب تعديلات خاصة بكل نموذج. باستخدام رسائل اختبار موحدة وقياس التأخير، ومعدل الإنتاجية، وجودة الإخراج بين النماذج المختلفة، يمكنك مقارنة الخيارات واختيار النموذج المناسب لعبء العمل الخاص بك.
جرب هذا النهج مع نماذج مختلفة من Amazon SageMaker JumpStart للعثور على التوازن المناسب بين الجودة والسرعة والتكلفة لتطبيقاتك.
المراجع
- وثائق SDK لبيرتون ساجمير من ساجمير
- تقييم وتحسين نشر SageMaker JumpStart (مقالة مدونة)
- من Hugging Face إلى SageMaker Studio بلمسة زر واحدة (مقالة مدونة)
- Amazon SageMaker JumpStart