
vLLM هو محرك استدلال وخدمة مفتوح المصدر للنماذج اللغوية الكبيرة (LLMs). يتضمن استدلال LLM مرحلتين متميزتين: prefill، التي تعالج الموجّه (prompt) المدخل وتبني ذاكرة التخزين المؤقت للمفتاح والقيمة (KV cache)، وdecode، التي تستخدم تلك الذاكرة المؤقتة لتوليد المخرجات رمزاً (token) تلو الآخر. تتميز هذه المراحل بخصائص مختلفة في الحوسبة والذاكرة والتوسّع. الفصل بين prefill وdecode (P-D disaggregation) يشغّلهما على نسخ محرك منفصلة، مما يتيح لكل مرحلة التوسّع والتحسين بشكل مستقل. يمكن أن يحسّن ذلك استخدام الموارد والإنتاجية وزمن الاستجابة تحت الحمل. ومع ذلك، فإنه يتطلب أيضاً نقل ذاكرة KV المؤقتة من نسخة prefill إلى نسخة decode قبل أن يبدأ توليد الرموز، مما يجعل النقل الفعّال لـ KV أمراً حاسماً لزمن الوصول لأول رمز (TTFT).
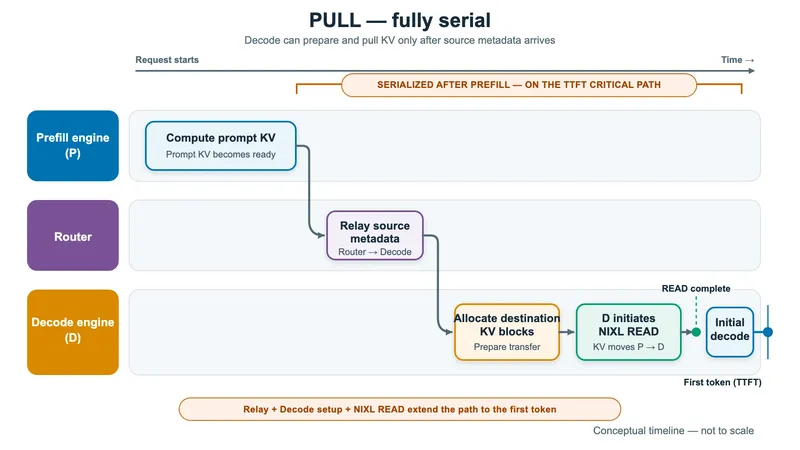
إحدى الطرق التي تنفّذ بها vLLM هذا النقل هي من خلال موصل مكتبة NVIDIA Inference Xfer Library (NIXL)، الذي ينقل كتل KV عبر وسائط اتصال داعمة لـ RDMA مثل AWS Elastic Fabric Adapter (AWS EFA، شبكة RDMA منخفضة زمن الوصول المستخدمة عبر الخوادم في AWS). على أنواع النسخ المدعومة، يدعم AWS EFA كلاً من GPUDirect RDMA وNeuron Direct RDMA، مما يمكّن NIXL من نقل كتل KV مباشرة بين ذاكرة GPU أو ذاكرة جهاز Trainium دون المرور عبر ذاكرة المضيف. الوضع الافتراضي لموصل NIXL هو السحب (pull-based): بعد انتهاء نسخة prefill من حساب ذاكرة KV المؤقتة للموجّه، يقوم الموجّه (router) بترحيل البيانات الوصفية للمصدر، بما في ذلك معرّفات كتل prefill، إلى نسخة decode. ثم تخصّص نسخة decode كتل الوجهة، وتجهّز نقل NIXL، وتبدأ عملية NIXL READ لسحب كتل KV من نسخة prefill. ولأن خطوات التنسيق والإعداد هذه تحدث بالتتابع بعد prefill وقبل بدء فك التشفير، فإنها تطيل المسار الحرج لـ TTFT، كما هو موضح في الجدول الزمني التالي.
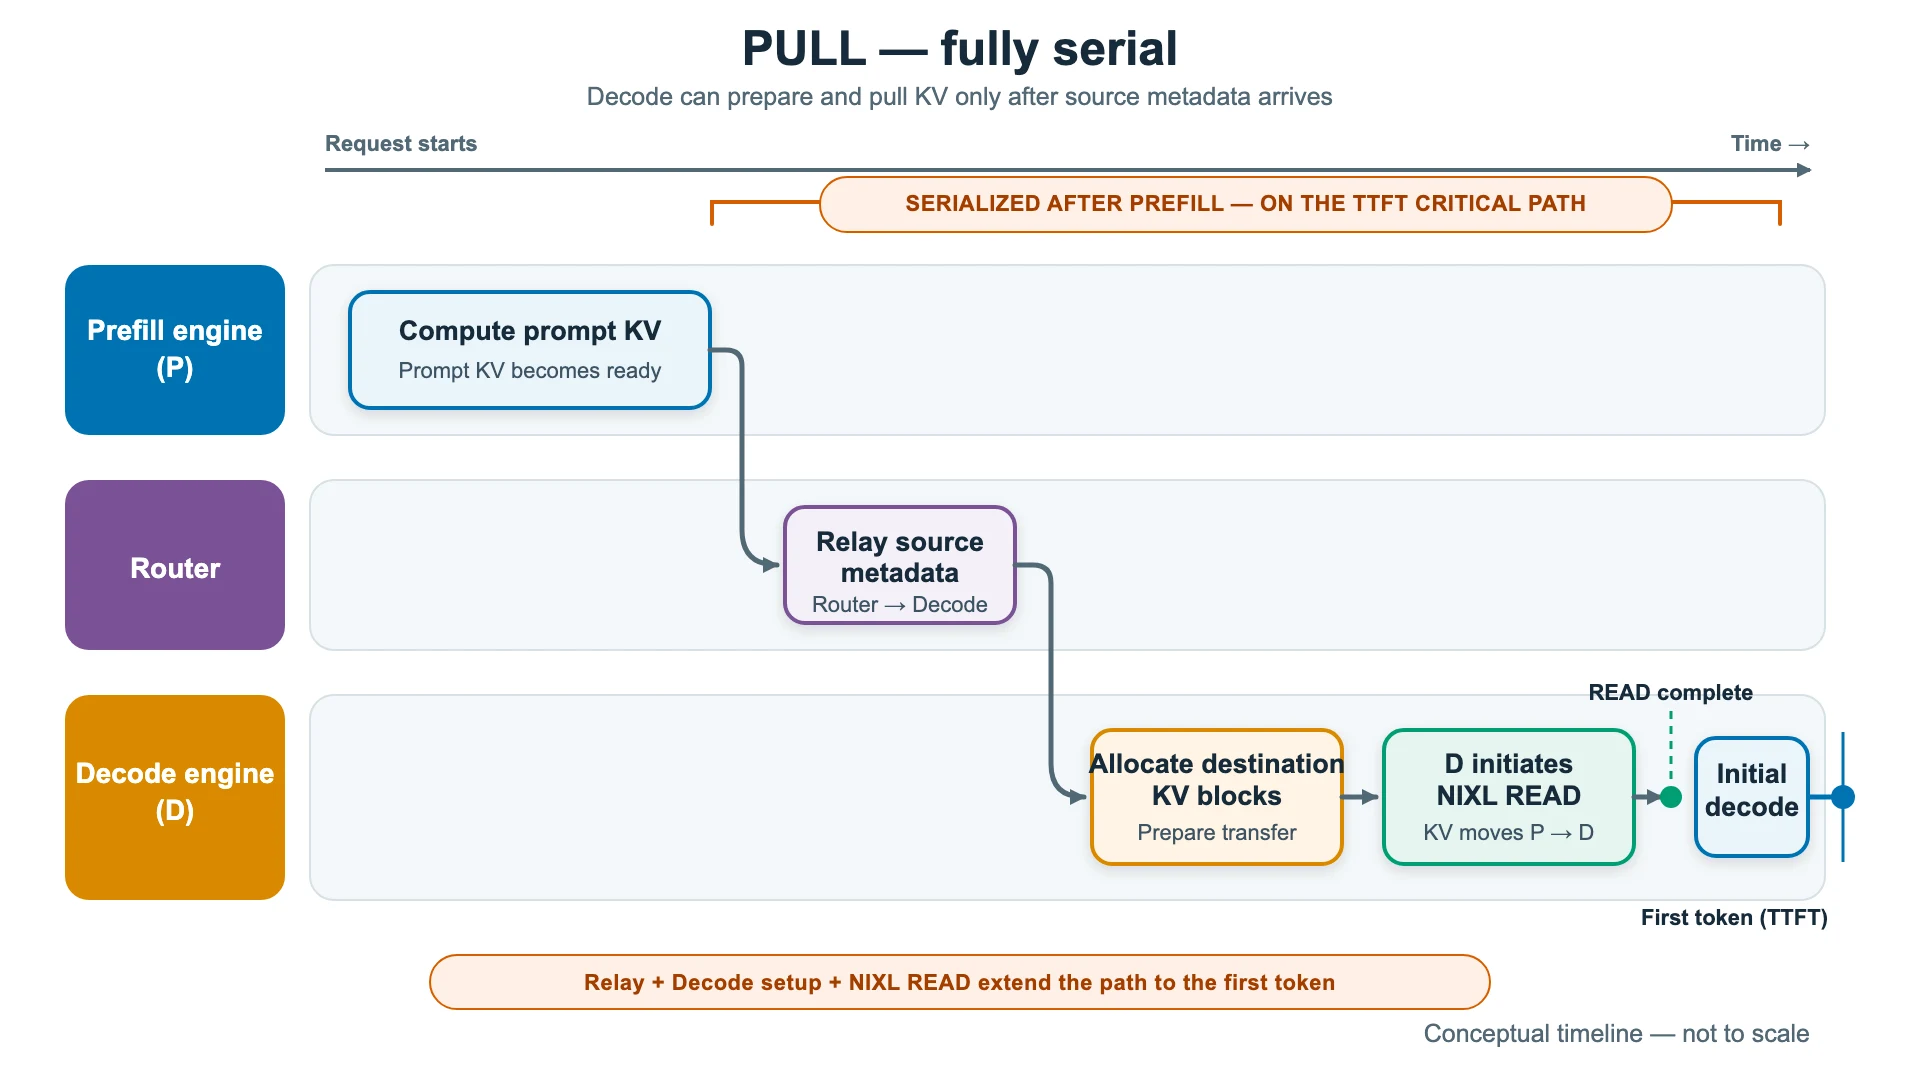
يقدّم هذا المنشور موصل NIXL قائماً على الدفع (push-based) ينقل تنسيق وإعداد النقل ما بعد prefill خارج المسار الحرج. للعملاء الذين يشغّلون استدلال prefill/decode موزّعاً باستخدام vLLM، يمكن أن يحسّن ذلك استجابة التطبيق من خلال تقليل TTFT وTPOT، خاصة عند معدلات طلبات مرتفعة.
في قياسنا المرجعي على نشر 1P1D باستخدام نسخ Amazon EC2 P5en المتصلة عبر EFA، قدّم وضع الدفع (push mode) تحسناً يصل إلى 3 أضعاف في TTFT وتحسناً يصل إلى 30% في زمن كل رمز مخرج (TPOT) مقارنة بوضع السحب (انظر قسم بيانات الأداء ) لنموذج Qwen3-32B؛ وتعتمد النتائج على عبء العمل والتكوين.
بنينا هذه الميزة و验证ناها على عناقيد نسخ AWS Trainium المتصلة عبر EFA، ثم ساهمنا بها في vLLM كميزة محايدة للمسرّعات. النتائج هنا من عنقود AWS p5en (GPU) مزوّد بـ EFA، مما يوضح أن المكاسب تنطبق أيضاً على وحدات GPU. يشرح هذا المنشور معمارية الدفع، وتدفق النقل، ونموذج الخيوط (threading)، ونتائج الأداء، وكيفية إعادة إنتاج القياس المرجعي.
نقل KV القائم على الدفع
نظرة عامة على المعمارية
يحسّن النقل القائم على الدفع TTFT وإنتاجية decode لسببين:
- يزيل التسلسل في نموذج السحب عن طريق تداخل عمل المنتج والمستهلك. تسجّل نسخة decode كتلها الهدف مسبقاً بينما لا يزال المنتج يحسب KV. ثم يبدأ النقل فور جاهزية كتل المنتج، بدلاً من انتظار رحلة ذهاب وعودة لاكتشاف المعرفات من جانب المستهلك، مما يزيل تلك الرحلة من المسار نحو أول رمز.
- ينقل زمن إعداد النقل خارج نسخة decode. ذلك الإعداد — تجهيز واصفات NIXL وإرسال النقل — يعمل على جانب prefill وعلى خيط خلفي (background thread)، فلا تُنفّق نسخة decode تلك الدورات خلال مرحلة توليد الرموز الحساسة لزمن الاستجابة.
النتيجة الصافية هي TTFT أقل وإنتاجية رموز مخرجات أعلى على نسخة decode.
يُنسّق موصّل الدفع (push connector) ثلاثة أطراف فاعلة: نسخة فك الترميز (decode)، التي تُسجّل كتلها المستهدفة مسبقًا؛ ونسخة التعبئة المسبقة (prefill)، التي تطابق كل طلب وتُصدر عملية النقل؛ وخيط خلفي مخصص يحمل كتابة KV خارج حلقة التمرير الأمامي للمحرك. يوضّح المخطط التالي كيف تتلاءم هذه الأجزاء معًا.
تفاصيل التنفيذ
يتكوّن البروتوكول من ثلاث خطوات منطقية.
1. التسجيل (جهة فك الترميز). عندما تخصص نسخة فك الترميز كتلًا محلية لطلب يتطلب التعبئة المسبقة عن بُعد، فإنها تُعدّ سجل تسجيل يصف المكان الذي يجب أن تكتب فيه نسخة التعبئة المسبقة الـ KV: هويتها الخاصة ومواقع الكتل التي حجزتها للتو. ضمن خطوة المحرك نفسها، يرسل العامل سجل التسجيل هذا إلى نسخة التعبئة المسبقة كإشعار NIXL. ولأن التسجيل يحدث وقت التخصيص، يعرف الموصل الكتل الوجهة قبل أن تُكمل نسخة التعبئة المسبقة التعبئة المسبقة.
2. الموعد (جانب التعبئة المسبقة). يصل التسجيل من الديكودر وإتمام prefill على المنتج بأي ترتيب، والموصل يتعامل مع الحالتين. إذا وصل التسجيل أولاً، يحتفظ به المنتج حتى ينتهي الـ prefill الخاص به. إذا انتهى الـ prefill أولاً، يحتفظ المنتج بكتل الطلب حتى يصل التسجيل. وأي حدث يقع ثانيًا يطلق النقل. يقرن الموصل الطلبات حسب المعرّف، ويراعي المطابقة الطلبات المعاد إصدارها، ويربط الطلبات المستبقة أو المعاد محاولتها بشكل صحيح.
3. النقل (جانب التعبئة المسبقة). بمجرد مطابقة الطلب، ينشئ المُنتِج اتصالاً بمثيل فك التشفير (إذا لم يكن موجوداً بالفعل) ويصدر أمر NIXL WRITE الذي ينسخ كتل KV مباشرة إلى الذاكرة المسجلة لدى وحدة فك التشفير، موجهةً كل رتبة من رتب التوازي بين المصفوفات الوجهة. قد يستخدم المُنتِج والمستهلك تخطيطات كتل داخلية مختلفة. يقوم كل طرف بتعيين مواقع الكتل إلى تخطيطه الفيزيائي الخاص وقت النقل، مما يسمح بأحجام كتل مختلفة على كل جانب. تحمل كل عملية WRITE إشعار إتمام يسلّمه NIXL إلى مثيل فك التشفير فور وصول البيانات. يحتسب واضع التشفير هذه الإشعارات، إشعاراً واحداً لكل رتبة مُنتِج تكتب فيه، ويعتبر KV مستلماً فقط بعد وصول جميع الإشعارات المتوقعة، وعند تلك النقطة ينتقل الطلب إلى مرحلة فك التشفير.
نموذج الترابط
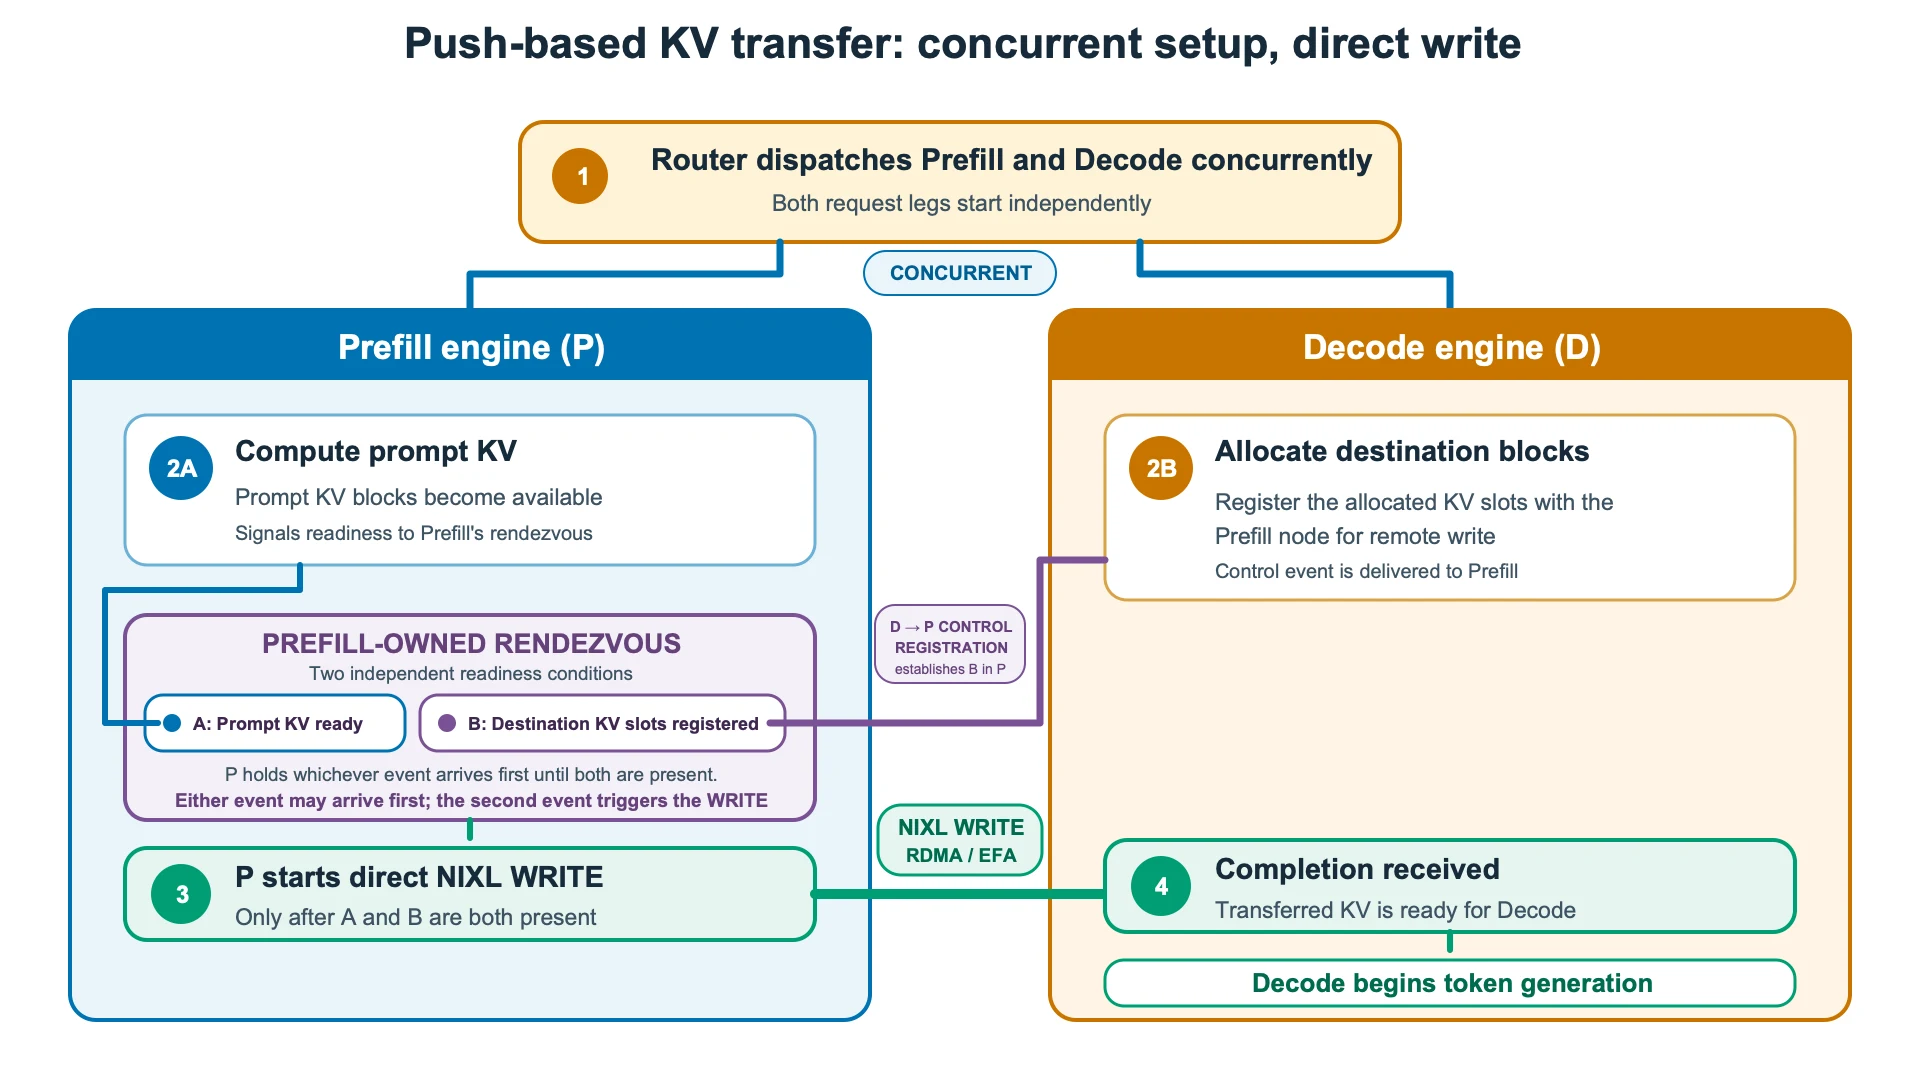
يفصل موصل push بين تنفيذ النموذج وإعداد نقل KV باستخدام خيط نقل خلفي مخصص على كل عامل prefill. في بداية الطلب، تخصص الحلقة الرئيسية للـ decode كتل KV الوجهة الخاصة بها وتسجلها مع نسخة prefill بينما تحسب الحلقة الرئيسية للـ trigger prefill ذاكرة KV المؤقتة للموجّه. بعد جهوزية كل من تسجيل الوجهة وKV للموجّه، تسلّم الحلقة الرئيسية للـ prefill كتل KV إلى الخيط الخلفي وتعود بسرعة إلى تنفيذ النموذج.
يقوم الخيط الخلفي بإنشاء اتصال NIXL أو إعادة استخدامه، ويرمّد معرّفات كتل KV الخاصة بالطلب إلى واصفات الذاكرة، ويدمج الكتل المتجاورة في مناطق نقل أكبر، ويرسل NIXL WRITE إلى مثيل فك التشفير. عندما يُكمل NIXL عملية النقل، يرسل إشعار إتمام إلى مثيل فك التشفير، الذي يبدأ بعد ذلك في توليد الرموز. إن إبقاء تجهيز الواصفات وإرسال النقل خارج الحلقات الرئيسية الحرجة من حيث زمن الاستجابة يمنع هذا العمل الخاص بكل طلب من تأخير تنفيذ النموذج. يوضح المخطط التالي هذه التسليمات بين الحلقة الرئيسية والخيط الخلفي لطلب واحد.
مقارنة التوقيت: السحب مقابل الدفع
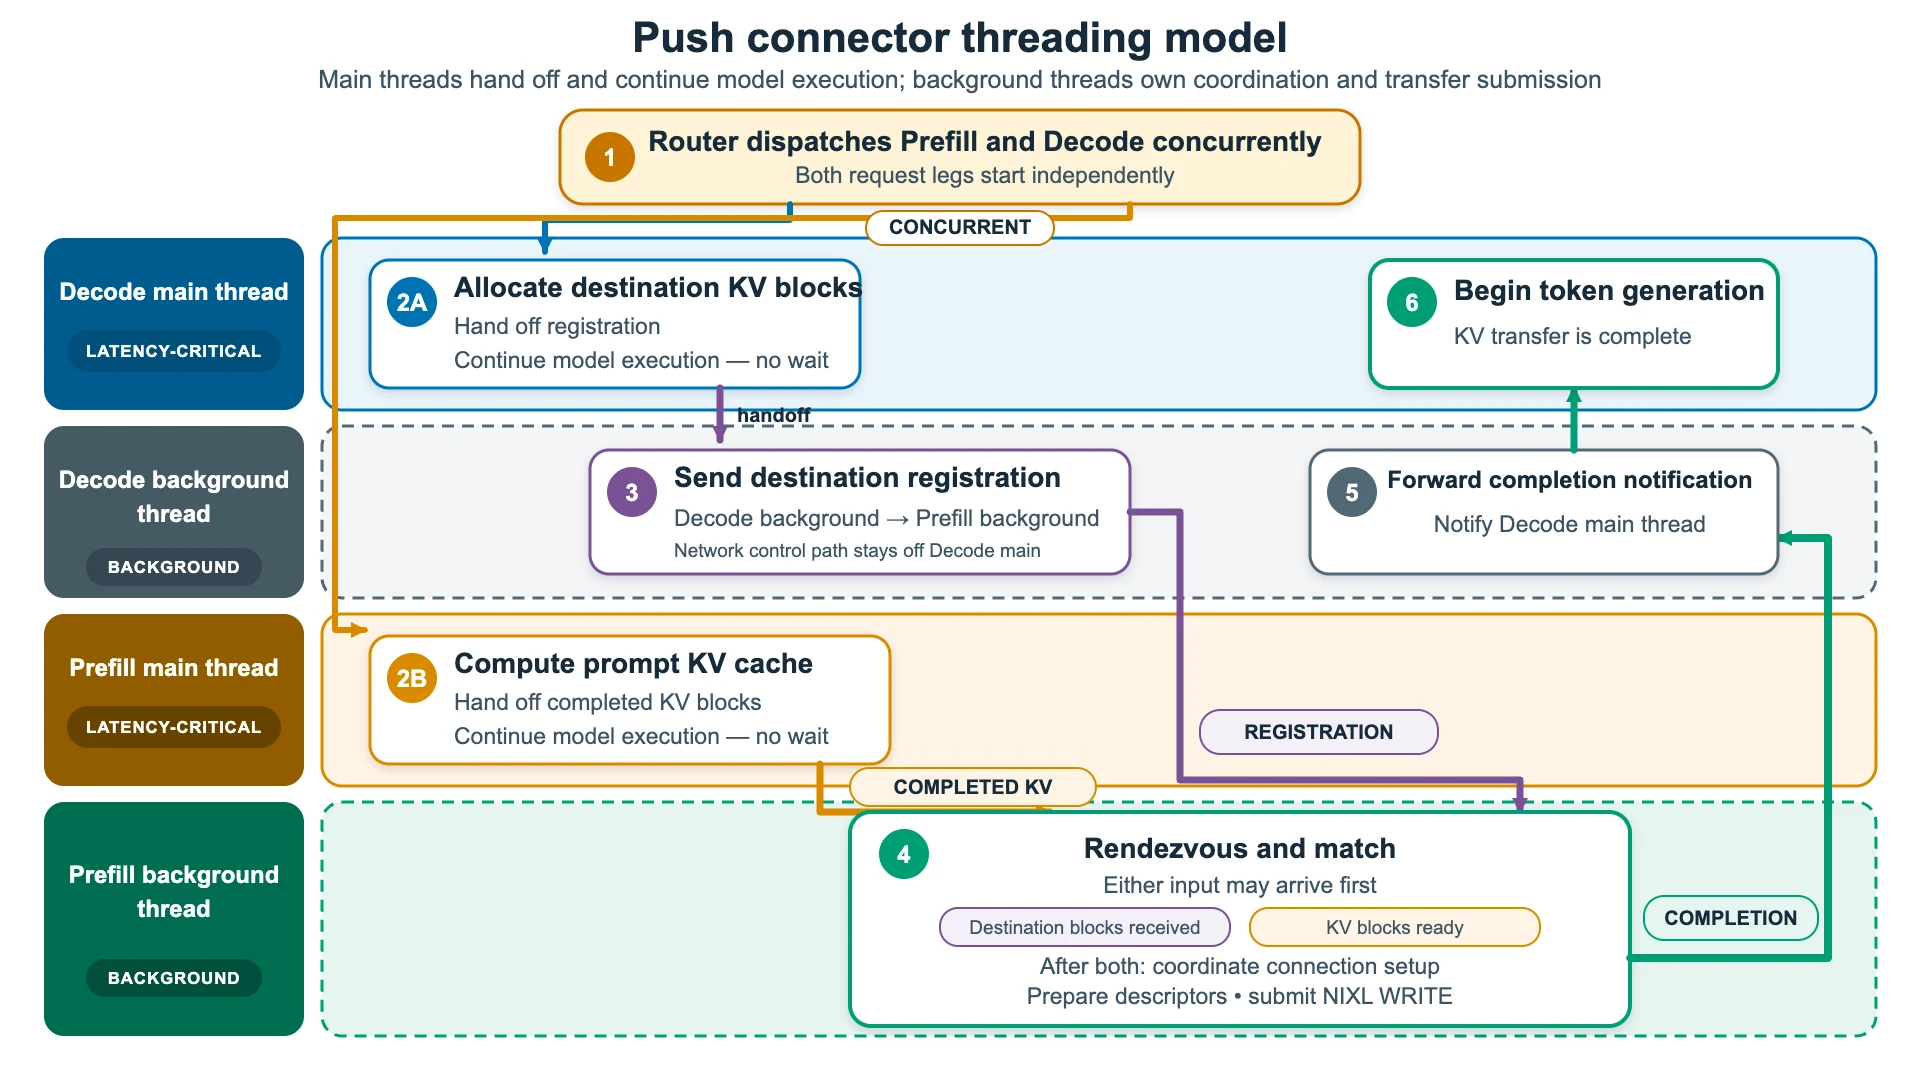
يُلخّص المخطط التالي مسارات نقل السحب والدفع الموضحة في الأقسام السابقة ويُبرز تأثيرها على TTFT. ورغم أن كلا الوضعين يستخدمان نفس مسار البيانات NIXL وEFA/RDMA، فإن وضع السحب ينفّذ ترحيل البيانات الوصفية والإعداد على جانب فك الترميز بعد التعبئة المسبقة، بينما يُداخل وضع الدفع الإعداد على جانب فك الترميز مع التعبئة المسبقة. ونتيجة لذلك، يُزيل الدفع هذه العمليات من المسار الحرج بعد التعبئة المسبقة، مما يسمح ببدء فك الترميز في وقت أسبق.
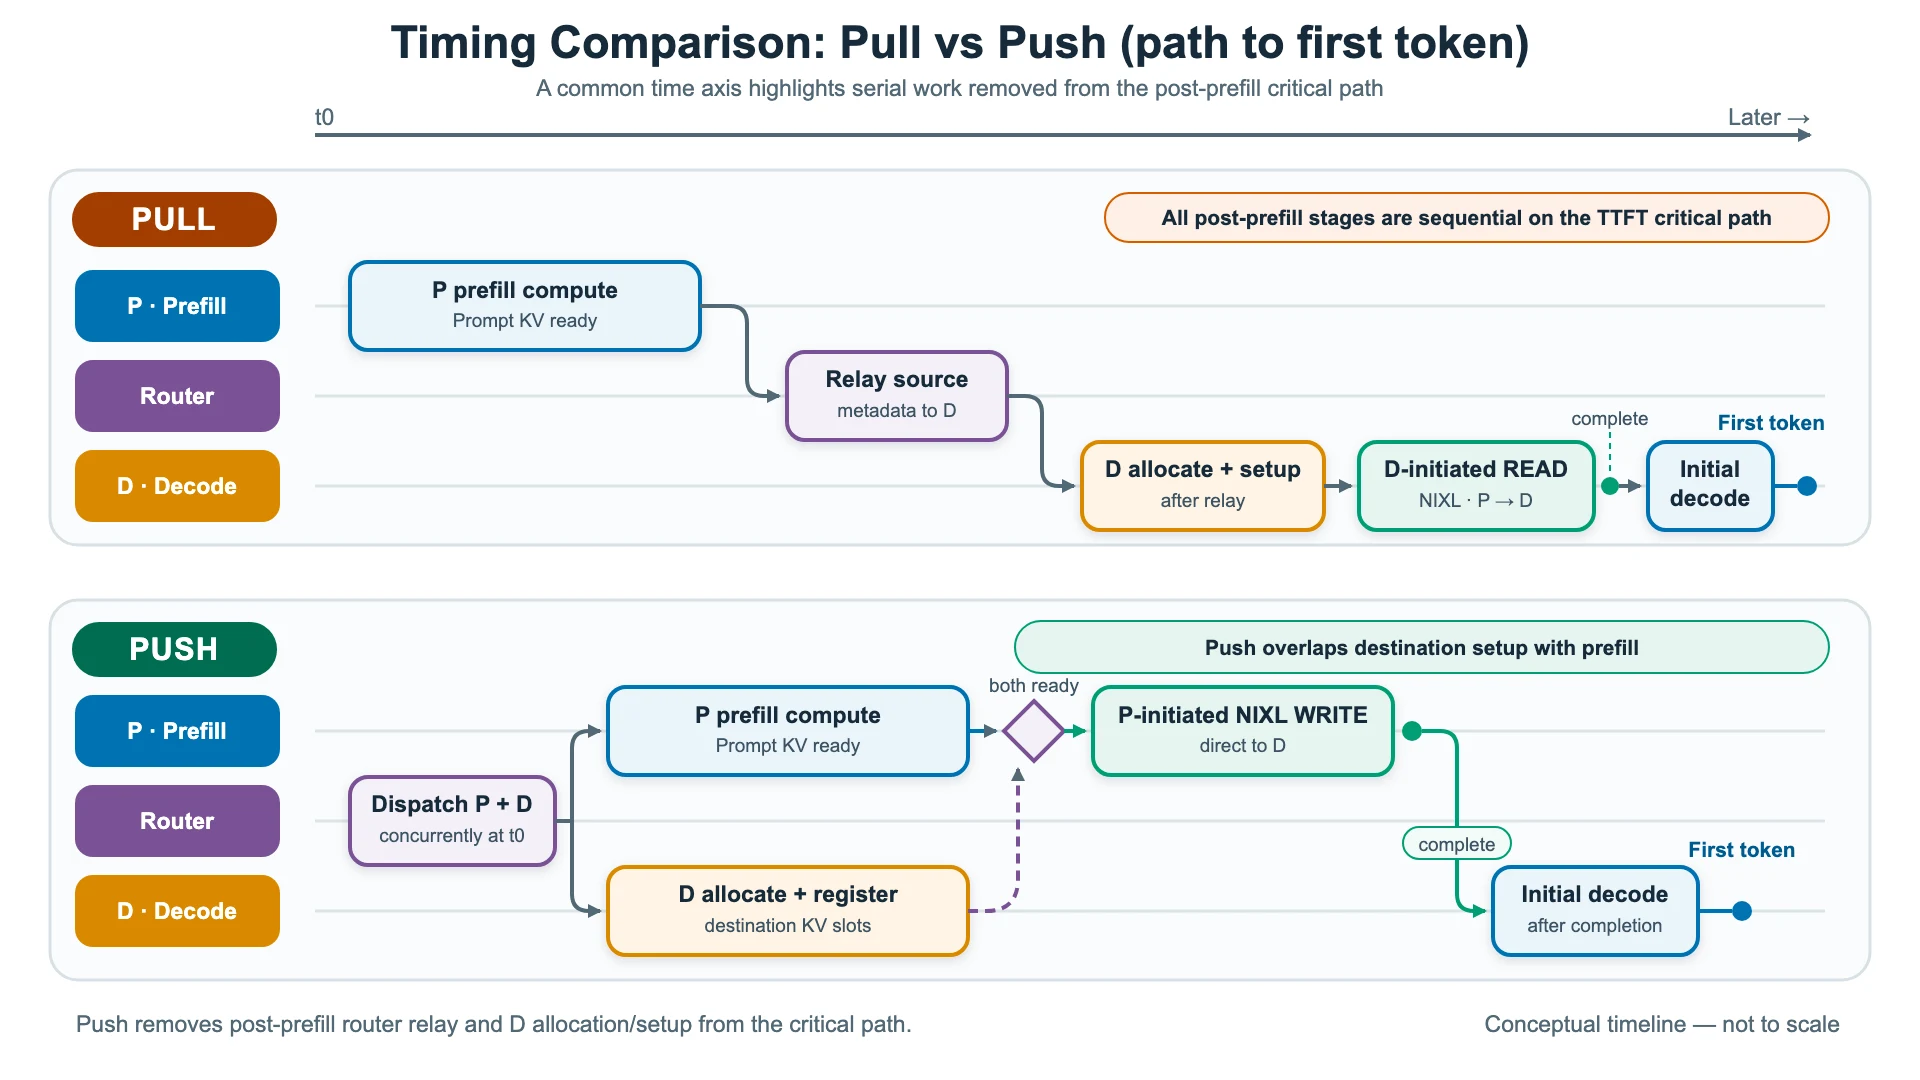
تشمل الأوضيحان أيضًا مقايضة في التوجيه. يتيح وضع السحب (Pull mode) للموجّه اختيار نسخة فك التشفير بعد اكتمال التعبئة المسبقة، مما يوفر مرونة أكبر للتوجيه الواعي بالحمل وإدارة جودة الخدمة. أما وضع الدفع (Push mode) فيختار نسخة فك التشفير في وقت أبكر بحيث يمكن أن يتداخل إعداد الوجهة مع التعبئة المسبقة. وفي المقابل، تحت حمل مماثل، يمكن لنسخة التعبئة المسبقة تحرير كتل KV الخاصة بها في وقت أسرع لأن النقل يبدأ بمجرد جاهزية كل من KV للأمر (prompt) وتسجيل الوجهة.
بيانات الأداء
للتقييم، استخدمنا نموذج Qwen3-32B في نشر بنسبة 1P1D باستخدام مثيلات Amazon EC2 P5en المتصلة عبر EFA. لعزل أداء النقل P→D، قمنا بتكوين أداة القياس لتعطيل تخزين البادئات المؤقت باستخدام --no-enable-prefix-caching. تجعل هذه الإعدادية عقدة فك الترميز تسترجع ذاكرة KV الكاملة من عقدة التعبئة المسبقة لكل طلب. وإلا، فإن الطلبات المتداخلة يمكن أن تعيد استخدام ذاكرة التخزين المحلية لعقدة فك الترميز وتتجاوز النقل، مما قد ينتج نتائج مقارنة مضللة.
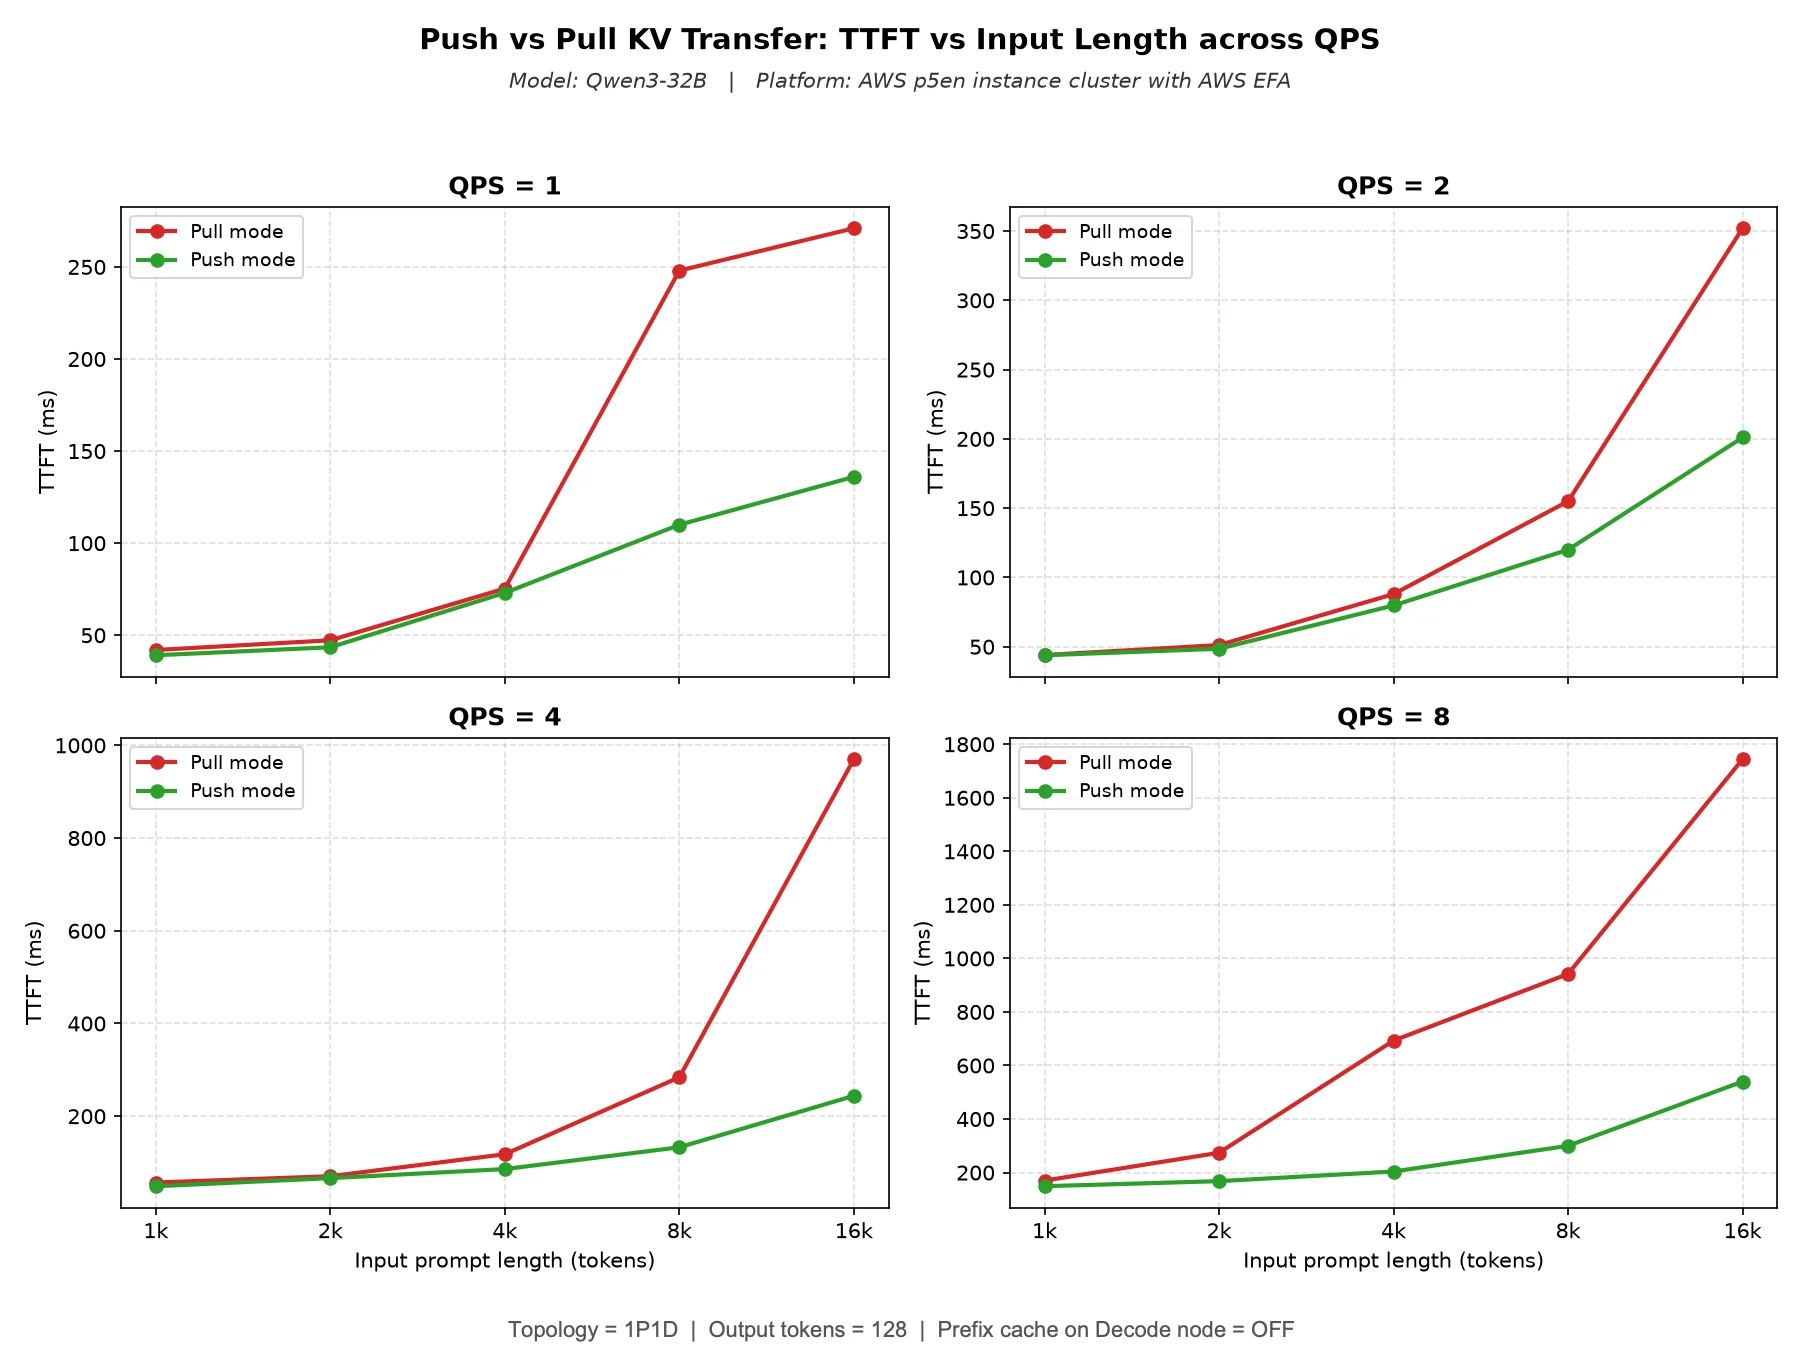
يقارن الرسم البياني التالي زمن TTFT لنقل KV بنمط الدفع والسحب. نحن نمسح أطوال المدخلات من 1k إلى 16k ومعدلات الطلبات من 1 إلى 8 QPS. عند الحمل المنخفض والتعليمات القصيرة، يعمل النمطان بشكل متطابق تقريبًا. مع زيادة QPS وطول المدخلات، يتدهور نمط السحب بشكل حاد، ليصل إلى حوالي 1,744 مللي ثانية عند 8 QPS و16k. أما نمط الدفع فيبقى أقل بكثير عند نحو 540 مللي ثانية، أي انخفاض يقارب 3 أضعاف. تنشأ الفجوة لأن نمط السحب ينشر واصفات NIXL مضمنة على عامل فك الترميز، بشكل متزامن داخل حلقة المحرك الخاصة به، مما يتسبب في توقف توليد الرموز. ينقل نمط الدفع هذه العملية إلى خيط خلفي، بعيدًا عن المسار الحرج.
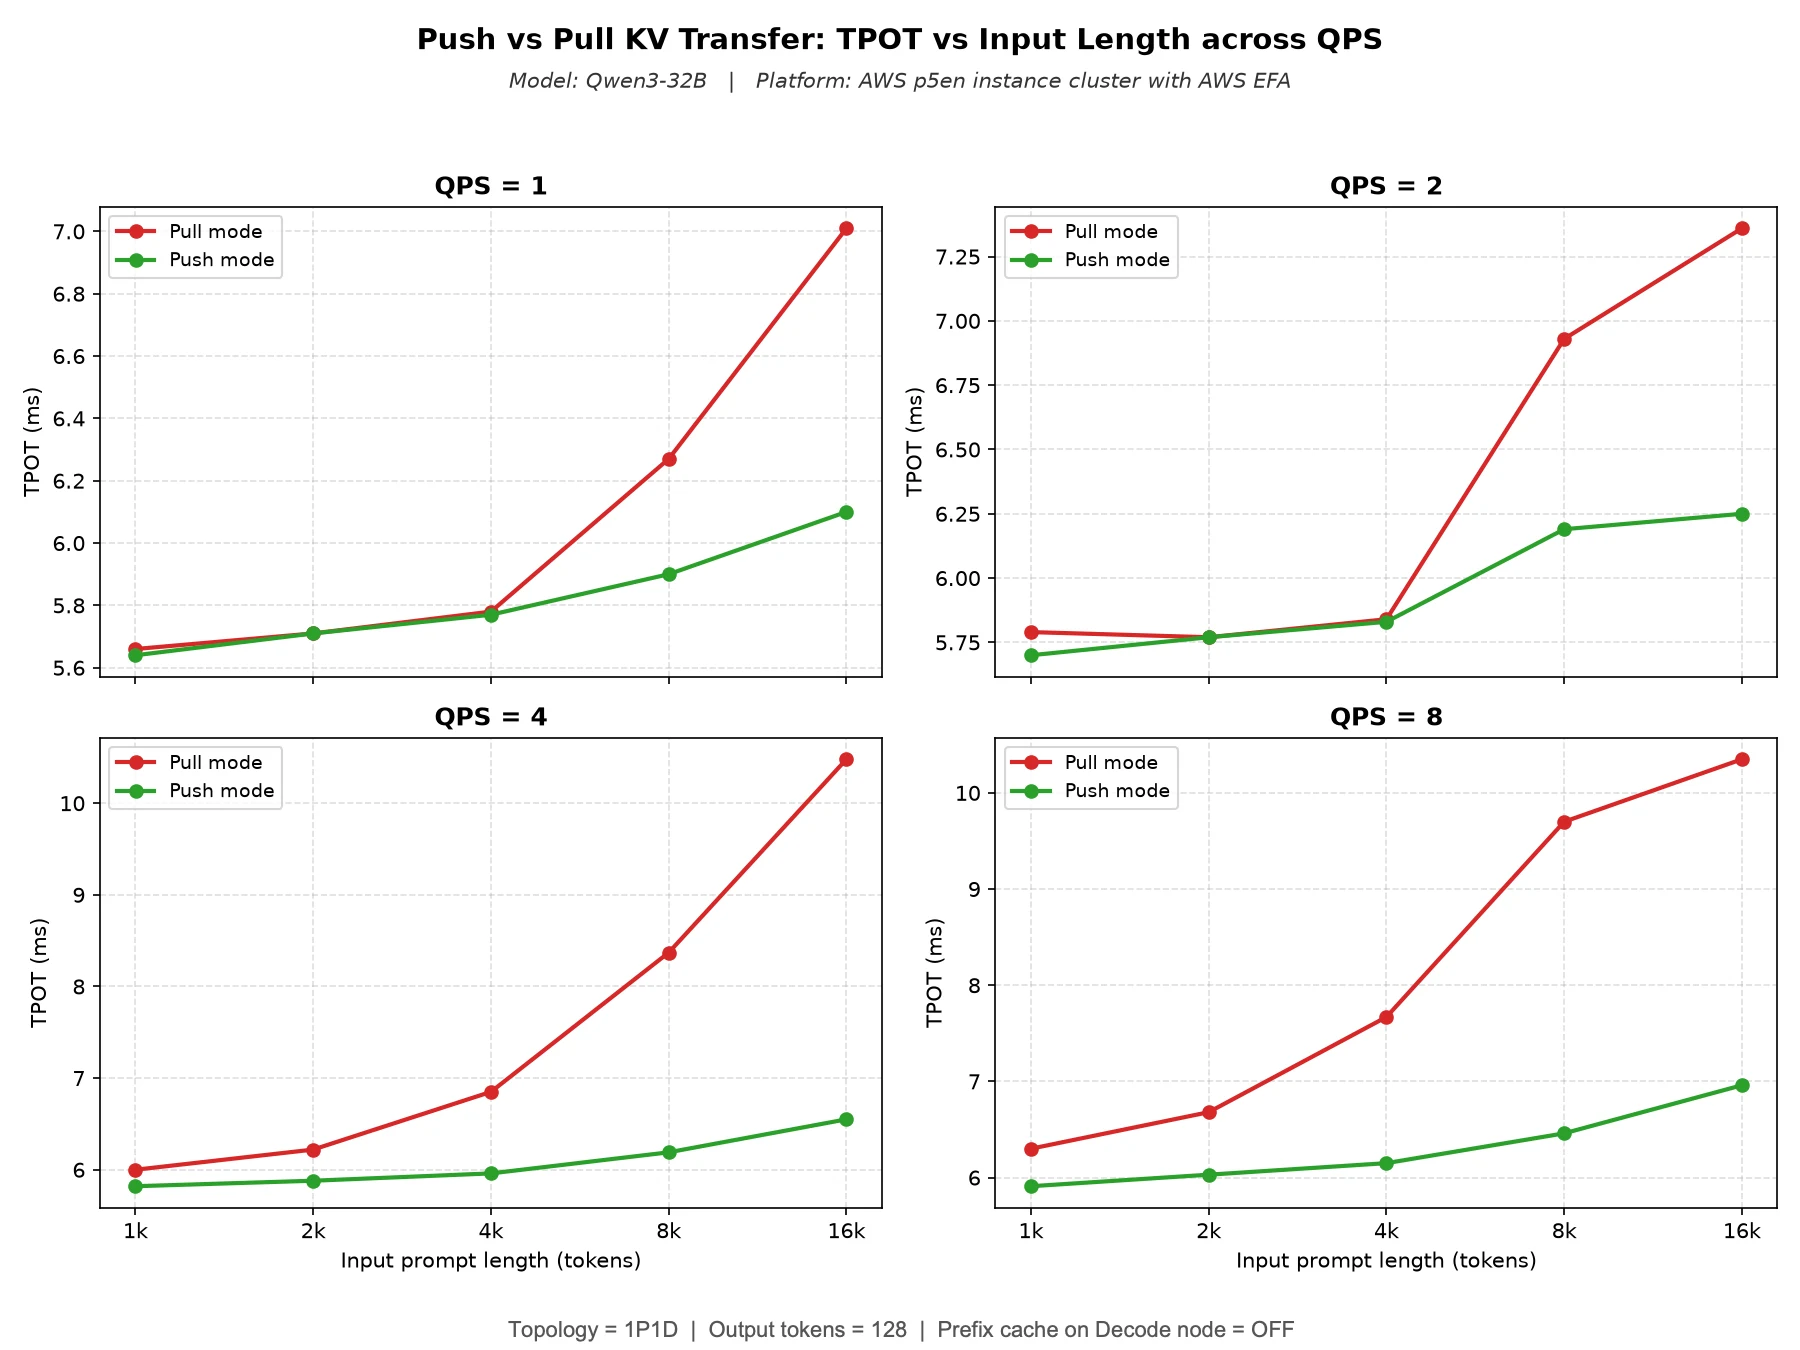
يعرض هذا المخطط قيمة TPOT في الظروف نفسها. النمط يعكس TTFT. عند الحمل الخفيف، يكون الدفع والسحب متقاربين، حوالي 5.6–5.8 ms. مع ارتفاع الحمل وطول المدخلات، يرتفع السحب إلى حوالي 10.4 ms عند 4–8 QPS و16k، بينما يبقى الدفع قريباً من 7 ms. السبب هو أن الدفع ينقل إعداد الواصفات وإرسال النقل خارج عامل فك الترميز. لا يتعرض توليد الرموز أبداً للتجويع، لذا تبقى زمن الاستجابة لكل رمز مستقراً حتى مع التزامن العالي والسياقات الطويلة.
كيفية تشغيل الاختبار المعياري
لإعادة إنتاج إعداد الاختبار المعياري لدينا 1P1D، أي عقدة prefill واحدة وعقدة decode واحدة، باستخدام مثيلات Amazon EC2 P5en المتصلة عبر EFA، راجع التعليمات التفصيلية في دليل Reproducing our results . يغطي الدليل إعداد البيئة، وإطلاق خوادم vLLM لكل من prefill وdecode، وتشغيل الاختبار المعياري، وجمع النتائج. يمكن تشغيل الميزة على إعدادات مدعومة أخرى، لكن ستختلف نتائج الأداء باختلاف العتاد والنموذج وحجم العمل وإعداد الشبكة.
الخاتمة
في هذه التدوينة، عرضنا كيف يتراكب موصل KV المعتمد على الدفع بين حساب prefill وتخصيص الكتل وتسجيلها على جانب decode، مما يزيل ذهاباً وإياب الموجّه بعد prefill وإعداد النقل على جانب decode من المسار الحرج. هذا يقلل TTFT وTPOT، لا سيما عند معدلات طلبات عالية. في الاختبار المعياري لدينا على Qwen3-32B في نشر 1P1D باستخدام مثيلات Amazon EC2 P5en المتصلة عبر EFA، قدّم وضع الدفع تحسناً يصل إلى 3x في TTFT وتحسناً بنسبة 30% في TPOT مقارنة بوضع السحب. تختلف النتائج باختلاف حجم العمل والإعداد. لاستخدام وضع الدفع، قم بتكوين كل من خادمي prefill وdecode لاستخدام NixlPushConnector بدلاً من NixlConnector.
اختر الموصل المعتمد على الدفع عندما يكون اختيار عقدة decode مبكراً مقبولاً وكان خفض TTFT هو الأولوية. يبقى الموصل المعتمد على السحب الخيار الأنسب لأحمال العمل التي تتطلب نقل KV ثنائي الاتجاه أو تؤجل اختيار نسخة decode إلى ما بعد prefill لأغراض التوجيه الواعي بالحمل. يدعم vLLM كلا الموصلين المعتمدين على الدفع والسحب لنقل KV، مما يتيح للمستخدمين اختيار النهج الأنسب لنشرهم.
كتحسين مستقبلي، نستكشف إحضار نموذج الخيوط الخلفية لـ NIXL إلى موصل وضع السحب، ونقل إعداد NIXL خارج المسار الحرج بحيث تستفيد أحمال عمل وضع السحب من التحسينات نفسها؛ وقد فتحنا طلب سحب (#45211) لاستكشاف ذلك.
موارد ذات صلة
شكر وتقدير
نشكر مجتمع vLLM على دعمه في صيانة هذه الميزة.
ملحق: إعادة إنتاج نتائجنا
الطوبولوجيا هي عقدتا GPU من نوع p5en (prefill على :8100وdecode على :8200) مع تمكين EFA، إضافة إلى عقدة ثالثة أصغر تشغّل الوسيط وعميل الاختبار المعياري. ثلاثة نصوص برمجية ترفق بهذه التدوينة: serve_pd.sh تشغّل أي فرع في أي وضع، run_sweep.sh يقود المسح، و cleanup.sh تفكك كل شيء. plot_push_vs_pull.py يعيد رسم الشكلين أعلاه من ملفات JSON الخاصة بالنتائج.
بيئة الاختبار
تم تكوين عقدتي GPU بشكل متطابق:
| نوع المثيل | p5en.48xlarge (8x NVIDIA H200)، واحدة لـ prefill وواحدة لـ decode |
| المنطقة / منطقة التوفر | ap-south-1 (مومباي)، ap-south-1b (معرّف منطقة التوافر AZ ID aps1-az3)، كلتا العقدتين في نفس منطقة التوافر |
| التموضع | لا توجد مجموعة تموضع عنقودية؛ تم تشغيل كلتا الحسابتين في حجز سعة عند الطلب (On-Demand Capacity Reservation) مستهدف، باستئجار افتراضي |
| صورة AMI | الصورة العامة لـ AWS ParallelCluster 3.14.2 لأنظمة Ubuntu 24.04 x86_64، aws-parallelcluster-3.14.2-ubuntu-2404-lts-hvm-x86_64-202602121713 (ami-0133f195033a4baae في ap-south-1؛ تختلف معرّفات AMI حسب المنطقة). تتضمن النواة 6.14.0-1018-aws، وبرنامج تشغيل NVIDIA 570، وCUDA 12.8، لذا يجب ترقية برنامج التشغيل وأدوات CUDA ومثبّت EFA إلى الإصدارات المذكورة أدناه. |
| نظام التشغيل / النواة | Ubuntu 24.04.4 LTS، 6.14.0-1018-aws |
| برنامج تشغيل NVIDIA / CUDA | البرنامج 580.126.16 (واجهة برمجة برامج التشغيل CUDA 13.0 driver API)؛ حزمة أدوات CUDA 13.0 |
| واجهات EFA | 16 لكل حساب، واحدة لكل بطاقة شبكة (البطاقات 0-15، جميع الواجهات من نوع efa)، بمعدل 200 Gb/s لكل منها ليصبح الإجمالي 3.2 Tb/s. يقع 8 واجهات على كل عقدة NUMA، ويشارك كل وحدة معالجة رسومية مفتاح PCIe مع 2 منها. |
| برمجيات EFA | مثبِّت EFA 1.50.0، وحدة نواة EFA 3.3.0g، وlibfabric 2.6.0amzn1.0، وrdma-core 64.0amzn0 |
اختيار أجهزة EFA بواسطة NIXL. تفتح الواجهة الخلفية LIBFABRIC جميع الأجهزة الـ 16 من نوع EFA كمسارات (rails) باستخدام المزوّد efa ثم تسجّل ذاكرة KV cache لكل GPU على المسارَين الـ 2 فقط اللذين يتشاركان مع ذلك GPU مفتاح PCIe نفسه، بحيث تبقى كل عملية نقل محلية على PCIe. لم يتم ضبط أي تجاوزات للأجهزة في NIXL أو libfabric؛ وهذا هو الاختيار الافتراضي. للتأكد من ذلك على عقدك الخاصة، شغّل الخوادم مع NIXL_LOG_LEVEL=DEBUG وتحقّق من أسطر التسجيل:
grep -E "Created rail [0-9]+ \(device=|mapped to rail" server.log1. توفير العقد
ثبّت حزمة مستخدم EFA على كلتا عقدتي GPU وتأكّد من وجود المزوّد. استخدمنا المثبِّت 1.50.0:
curl -O https://efa-installer.amazonaws.com/aws-efa-installer-1.50.0.tar.gz
tar -xf aws-efa-installer-1.50.0.tar.gz && cd aws-efa-installer
sudo ./efa_installer.sh -y
fi_info --version         # libfabric 2.6.0amzn1.0
fi_info -p efa            # verify the EFA provider is present
يجب أن تتمكن عقدتا GPU من الوصول إلى بعضهما عبر 8100/8200 وعبر قناة NIXL الجانبية (5600).
2. تثبيت vLLM وNIXL
على كلتا عقدتي GPU:
python3.12 -m venv ~/vllm_env && source ~/vllm_env/bin/activate
pip install --upgrade pip
pip install vllm==0.29.0      # any build that includes the NIXL push connector
pip install nixl==1.4.1       # NIXL with the libfabric/EFA backend
على عقدة الوكيل (لا حاجة إلى بيئة تشغيل GPU):
pip install vllm aiohttp fastapi uvicorn pandas datasets3. تنزيل النموذج
export HF_HOME=/shared/huggingface     # a large shared volume
hf download Qwen/Qwen3-32B
4. تشغيل زوج P/D
شغّل serve_pd.sh مرة واحدة على كل عقدة GPU. الفرق الوحيد بين الوضعين هو kv_connector: NixlConnector للسحب، و NixlPushConnector للدفع. تبقى المنافذ ومعرّفات المحرك والأدوار والرتب كما هي.
# on the prefill node
PREFILL_IP=<PREFILL_IP> DECODE_IP=<DECODE_IP> ROLE=prefill MODE=pull ./serve_pd.sh
# on the decode node
PREFILL_IP=<PREFILL_IP> DECODE_IP=<DECODE_IP> ROLE=decode  MODE=pull ./serve_pd.sh
والذي يتوسّع، على جانب ما قبل التعبئة (prefill)، إلى:
vllm serve Qwen/Qwen3-32B --served-model-name Qwen --dtype bfloat16 \
  --tensor-parallel-size 8 --max-model-len 32768 --max-num-seqs 8 --port 8100 \
  --kv-transfer-config '{"kv_connector":"NixlConnector","kv_buffer_device":"cuda",
    "kv_role":"kv_producer","engine_id":"prefill-engine-001","kv_rank":0,
    "kv_parallel_size":2,"kv_connector_extra_config":{"backends":["LIBFABRIC"]}}'
يضيف خادم فك الترميز (decode) --no-enable-prefix-caching، مما يجبر كل طلب على جلب كامل KV من prefill — وهو بالضبط ما نقيسه. مع تمكين التخزين المؤقت، يمكن أن تصل المطالبات المتداخلة إلى ذاكرة التخزين المؤقت المحلية في عقدة decode وتتجاوز نقل P->D، مما يعطي أرقامًا مضلّلة. انتظر حتى يعيد كلتا نقطتَي /health النهايتين الشفرة 200 قبل إجراء الاختبار المعياري.
5. تشغيل المسح
يوجد سكربت الاختبار المعياري في #57567؛ فهو يختار الوكيل المطابق للوضع (disagg_proxy_demo.py للسحب، و disagg_proxy_pushconnector_demo.py للدفع) ويشغّله باستخدام vllm bench serve.
git clone https://github.com/vllm-project/vllm.git ~/vllm && cd ~/vllm
git fetch origin pull/57567/head:pd-bench && git checkout pd-bench
export VLLM_SRC=~/vllm

VLLM_SRC=~/vllm PREFILL_IP=<PREFILL_IP> DECODE_IP=<DECODE_IP> \
  MODE=pull ./run_sweep.sh
ثم أوقف كلا الخادمين، وأعد تشغيل الخطوة 4 مع MODE=push على كل عقدة، ثم أعد تشغيل المسح باستخدام MODE=push. يتطلب وضع الدفع (push) أيضًا إحداثيات NIXL الخاصة بمثيل التعبئة المسبقة (PREFILL_ENGINE_ID, PREFILL_KV_HOST, PREFILL_SIDE_CHANNEL_PORT, PREFILL_TP_SIZE, PREFILL_PP_SIZE) حتى يتمكن الوسيط من إخبار عقدة فك الترميز بمكان التسجيل؛ run_sweep.sh يملؤها من القيم الافتراضية المستخدمة أعلاه. حافظ على QPS_LIST, INPUT_LENSو OUTPUT_LENS متماثلة عبر التشغيلين، وتأكد من أن PREFILL_TP_SIZE يطابق حجم التوازي الزمني للموترات الفعلي لخادم التعبئة المسبقة.
results/ يحتفظ بـ <mode>_qps<q>_in<in>_out<out>_iter<i>.json (بالإضافة إلى .log) مع TTFT وITL والإنتاجية وزمن الاستجابة من طرف إلى طرف لكل تشغيل. لإعادة رسم الأشكال:
python plot_push_vs_pull.py --results-dir ./results --metric ttft
python plot_push_vs_pull.py --results-dir ./results --metric tpot
استكشاف الأخطاء وإصلاحها
- انهيار الخادم مباشرة بعد الطلب الأول — لا يتطابق الوضع مع الموصل. السحب (Pull) يتطلب
NixlConnector؛ والدفع (push) يتطلبNixlPushConnector، على كل من P وD. Backend 404: model ... does not exist—SERVED_MODEL_NAMEلا يطابق قيمة الخوادم في--served-model-name(Qwen).- انتهاء مهلة جهوزية الوسيط — تأكد من وجود وسيط للوضع المختار تحت
$VLLM_SRC/examples/disaggregated/disaggregated_serving/، وأن كل من P وD/healthيعيدان 200. - أخطاء مصافحة NIXL أو أخطاء النقل — تحقق من EFA (
fi_info -p efa)، ومن أن منفذ القناة الجانبية (5600) مفتوح بين P وD، وأنPREFILL_TP_SIZEيطابق حجم التوازي الزمني للموترات لخادم التعبئة المسبقة.
التنظيف
./cleanup.sh proxy      # on the proxy / benchmark driver node
./cleanup.sh server     # on each GPU node
ثم اتبع دليل مستخدم AWS EC2 لإنهاء المثيلات.