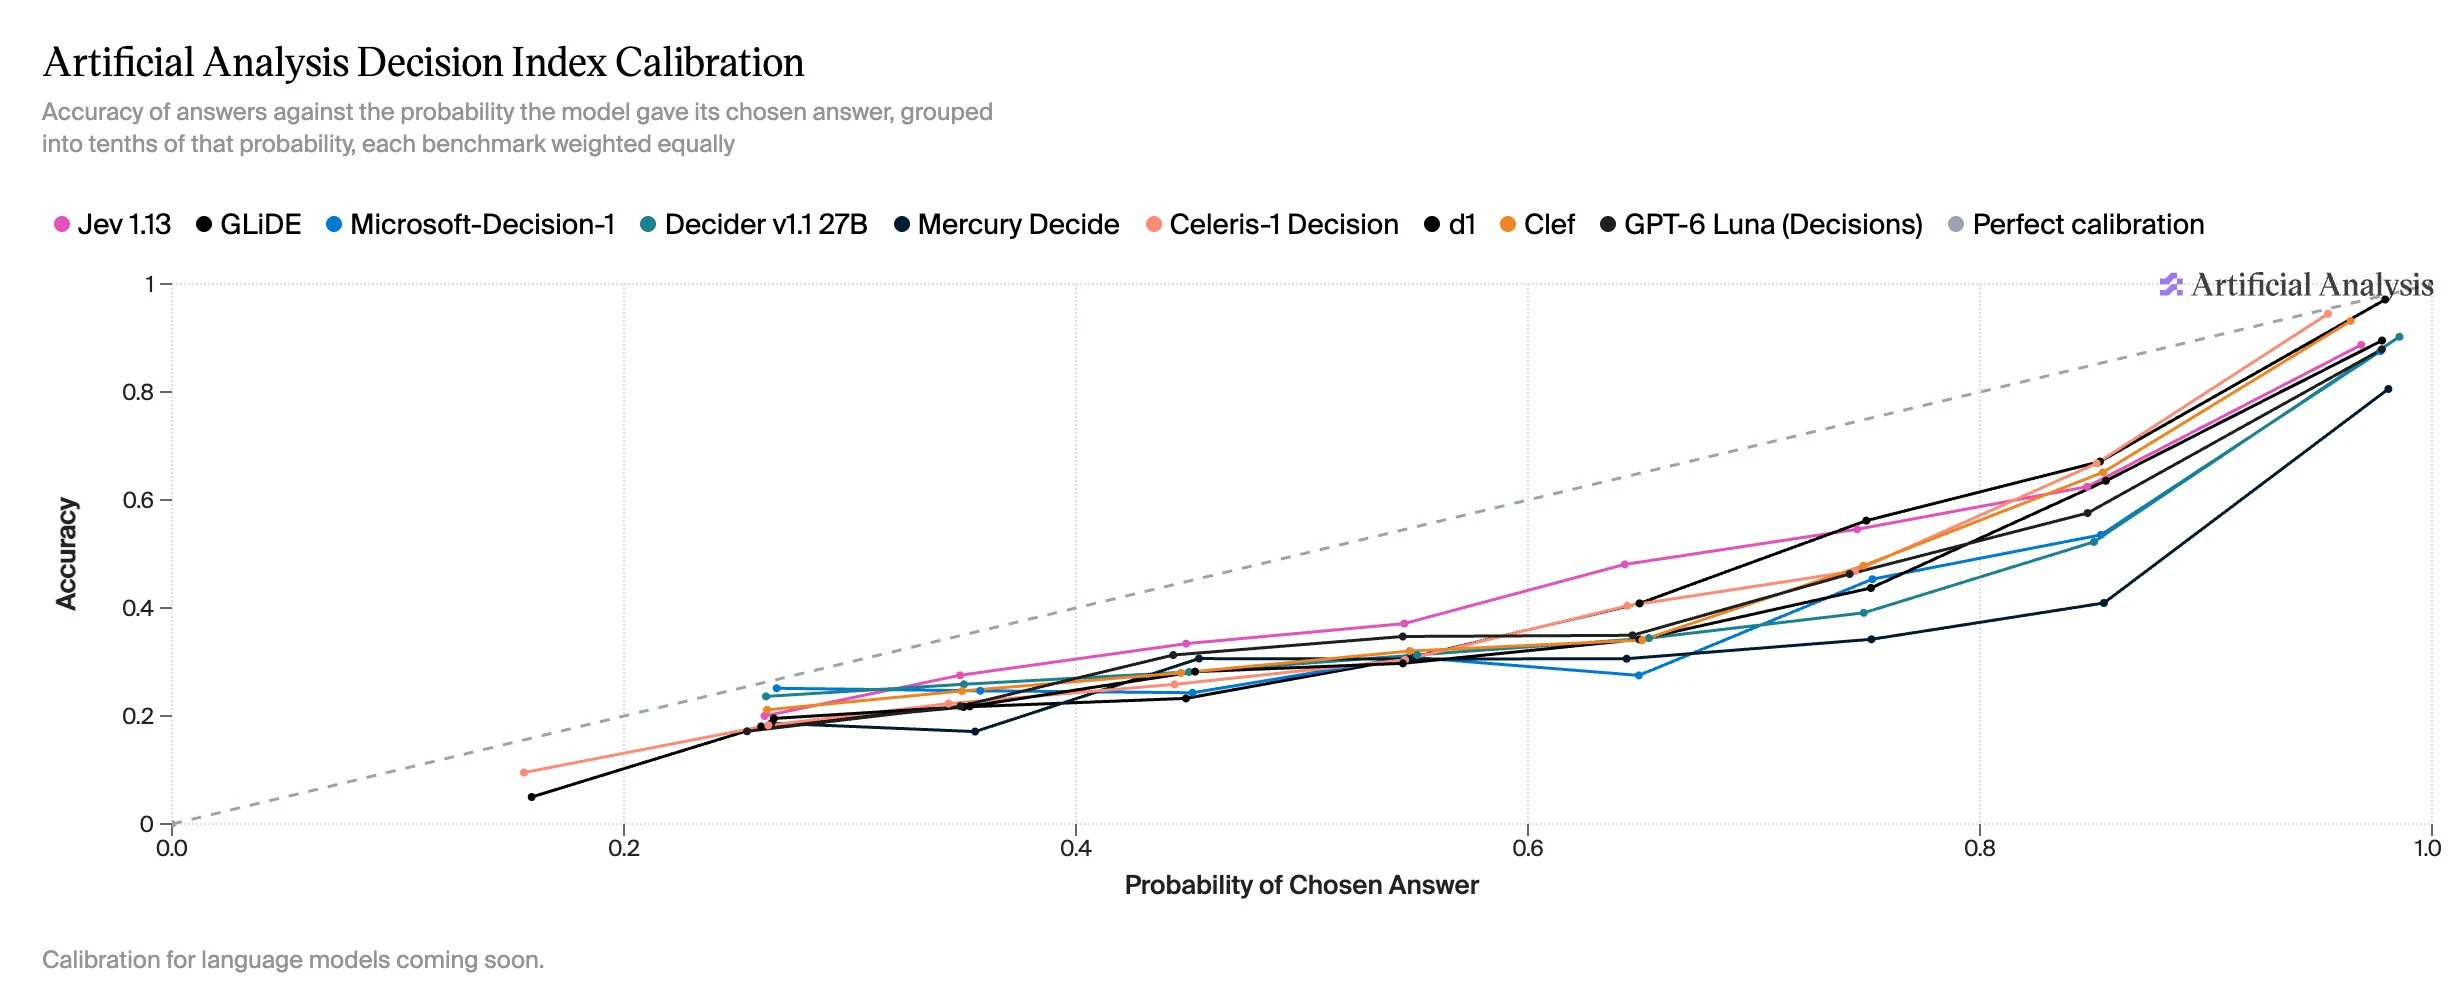
تُعاير نماذج القرار معايرة سيئة في مهام المعرفة والاستدلال. وعبر معظم مستويات الاحتمالية تقريبًا للإجابات المختارة، تكون الدقة أقل من ذلك الاحتمال لجميع نماذج القرار الـ 2. وهذه الفجوة هي الأكبر في AA-Omniscience-Decision و HLE-MultiChoice، بينما تكون معظم النماذج معايرة بشكل جيد نسبيًا في WildGuardTest (التصنيف) و When2Call (استدعاء الأدوات)