
الخلاصة
أصبح تسجيل الثقة مدعومًا الآن لجميع أنواع المُضاربين القائمة على نماذج المسودة. في غياب رأس ثقة، يقوم مُقدِّر يُملاءم عبر الإنترنت باشتقاق ميزة من لوغاريتمات احتمالات المسوّد للتنبؤ باحتمال قبول النموذج الهدف لها، وتُستخدم هذه الميزة مباشرةً كدرجة ثقة للتحقق التكيّفي. وتُملاءم معاملات المُقدِّر باستمرار، بما يتكيف مع حركة البيانات الواردة. وصلت هذه الميزة في طلب السحب رقم PR #52228، وتُفعَّل باستخدام enable_adaptive_verification لنماذج المسودة التي لا تحتوي على رأس ثقة.
الخلفية
تُمكِّن ميزة التحقق التكيّفي (AV) في vLLM من التحقق من مجموعة فرعية من الرموز المسودة أثناء فك التشفير التخميني. تُقتطع رموز المسودة ذات احتمال القبول المنخفض من الدفعة قبل تشغيل التمريرة الأمامية للنموذج الهدف، مما يوفر في الحوسبة. وهذه التحسينات مفيدة بشكل خاص عند التقديم بأحجام دفعات كبيرة، لأنها في تلك الحالة يصبح وحدة معالجة الرسومات محدودة بقدرة الحوسبة. انظر هذه التدوينة على مدونة vLLM لمزيد من التفاصيل.
يتطلب AV تقديرًا لاحتمال القبول على مستوى كل رمز، ولهذا السبب، وحتى الآن، كان يدعم مسوّدي DSpark فقط. غالبًا ما تأتي نماذج DSpark مزودة برأس ثقة: وهي طبقة خطية صغيرة فوق الحالة الخفية للمسوّد لكل موضع، تُدرَّب كمصنِّف ثنائي للسؤال: "هل سيقبل الهدف هذا الرمز؟"
المشكلة
نماذج المسودة التي تفتقر إلى رأس ثقة، مثل EAGLE وMTP وDFlash وبعض نقاط تفتيش DSpark، لا تستفيد من AV إطلاقًا. وبهذه المُضاربات ميزة AV لاستخدامه، تحتاج هذه المُضاربات إلى تقدير قبول لكل رمز، وإضافة رأس ثقة تعني إعادة تدريب المسوّد، وهو أمر غير متاح للعديد من نقاط التفتيش الحالية التي يقدّمها الناس بالفعل.
الأعمال السابقة
استخدام ثقة المسوّد نفسها كوكيل للقبول أمرٌ راسخٌ جيدًا. EAGLE-2 أظهر أن احتمالات مسودة EAGLE تتبع ارتباطًا وثيقًا معدلات القبول، واستخدمها لتوسيع شجرة مسودة ديناميكية وإعادة ترتيبها. Draft & Verify والعديد من الأعمال اللاحقة توقف عن توليد المسودة بمجرد أن تنخفض احتمالية المسوّد دون عتبة ثابتة. SpecDec++ بدلاً من ذلك، يدرِّب رأسًا مخصصًا للتنبؤ بالقبول، على غرار روح رأس الثقة في DSpark. في كل حالة، إما أن يُستخدم التعيين من ثقة المسودة إلى القبول كما هو أو يُتعلَّم دون اتصال بالإنترنت.
يحتاج AV إلى أكثر من مجرد ترتيب جيد. فقراره المتعلق بالميزانية يجمع احتمالات القبول المتوقعة ويزنها مقابل التكاليف المقيسة، لذا يجب أن تكون التنبؤات معايَرة (calibrated) لزوج النماذج المحدد وحِمل العمل الذي يُقدَّم، وهذا ما يوفره المُقدِّر المُملاءَم عبر الإنترنت في القسم التالي.
الحل: مُقدِّر قبول يُملاءم عبر الإنترنت
أضفنا انحدارًا لوجستيًا خفيف الوزن يقدّر احتمال قبول كل رمز مسودة من قيمة عددية واحدة مشتقة من توزيع المسودة، وهي لوغاريتم الأرجحيات (log-odds) للرمز الأكثر احتمالًا لدى المسوّد. له ميل واحد مشترك ومعاعقة واحدة لكل موضع مسودة، لذا فإن مسوّدًا يعتمد على Kرموزًا يحتاج في المجموع إلى ك + 1 parameters. وتتم معايرة هذه المعاملات عبر الإنترنت من قرارات القبول/الرفض التي يُنتجها النموذج المستهدف أصلًا أثناء التحقق الاعتيادي. وأي نقطة تفتيش مسودة موجودة تحصل على AV مجانًا.
تغطي بقية هذا القسم النصفين من التصميم: الكمية التي يقيّمها المُقدِّر، وكيفية ملاءمة معاملات أثناء التقديم.
تقييم التوزيع
يتم تقدير درجة الثقة لرمز المسودة المعطى باستخدام انحدار لوجستي لكل موضع:
حيث ω هو الميل المُقدَّر المشترك بين جميع مراكز المسودة، βi هو التقاطع المُقدَّر لكل موضع، و س هو توزيع المسودة. الشكل البديل بالأرجحية اللوغاريتمية يجعل العلاقة واضحة:
logit(qالحد الأقصى") هي ميزة المُقدِّر، و هي log-odds للرمز الأكثر ترجيحًا في المسودة. وبشكل بديهي، تمثل مدى ثقة نموذج المسودة في تنبؤاته. ويتم تحويلها خطيًا بواسطة المعاملين ω وβأنا للتنبؤ بالأرجحية اللوغاريتمية لقبول المسودة من قبل النموذج الهدف. ودالة السيني لذلك هي p، وهو معدل القبول التقديري الذي يُستخدم كدرجة ثقة لـ AV.
ميزات أخرى تم النظر فيها
تم اقتراح ورفض عدة ميزات بديلة لسبب أو لآخر. المحاور الأربعة الرئيسية التي اهتممنا بها أكثر عند تقييم أي ميزة كانت:
- الخلو من الفقد — ما إذا كانت الخاصية تُحدث انحيازًا في توزيع المخرجات أثناء فك الترميز التخميني.
- المساحة تحت المنحنى (AUC) — احتمال أن تحصل مسودة مقبولة مختارة عشوائيًا على درجة أعلى من مسودة مرفوضة مختارة عشوائيًا. يقيس هذا التمييز بين المسودات التي ينبغي قبولها مقابل تلك التي ينبغي رفضها. وتشير القيمة الأعلى إلى قدرة أفضل على التمييز، بينما 0.5 تعني الصدفة العشوائية.
- خسارة السجل (Log-loss) — متوسط اللوغاريتم السالب للاحتمال المتوقع لقبول المسودة، والذي يعاقب الإجابات الخاطئة الواثقة ويكافئ المعايرة الدقيقة. وتشير القيمة الأقل إلى قدرة أفضل على التنبؤ باحتمال القبول الحقيقي لمسودة معينة.
- خطأ المعايرة المتوقع (ECE) — قسّم كل مسودة إلى صناديق بناءً على احتمال القبول المتوقع لها، ثم قِس الخطأ بين متوسط التنبؤ مقابل متوسط التكرار المرصود داخل كل صندوق، موزنًا بإشغال الصندوق. هذا يقيس المعايرة، وتشير القيمة الأقل إلى قدرة أفضل على إسناد احتمال لمسودة يطابق التكرار الحقيقي بين المسودات التي سُجلت بشكل مماثل.
اللاخسارية هي خاصية غير قابلة للتفاوض يجب أن تمتلكها الميزات. وإلا فإننا نكسر الضمانة الأساسية لفك التشفير التخميني المتمثلة في إخراج التوزيع الدقيق للنموذج الهدف. كلا من AUC و ECE مهمان لقرارة الاقتصاص في AV، ولكن بطرق مختلفة. AUC مهم لـ الترتيب المحلي لاحتمالات البقاء:
survival = confidence_probs[idx_mapping].cumprod(dim=1)
...
winners = flat.topk(draft_budget).indices
يضمن AUC قبول رمز مسودة أكثر احتمالاً للقبول على حساب رمز أقل احتمالاً. من ناحية أخرى، ECE مهم لقرار الميزانية الشاملة :
num_tokens_to_estimated_accepted_tokens = np.concatenate(
    ([num_sampling_requests], num_sampling_requests + np.cumsum(scores))
)
costs = draft_cost_ms[...] + verify_cost_ms[...]
...
draft_budget = int(np.argmax(num_tokens_to_estimated_accepted_tokens / costs))
تُجمع الاحتمالات ثم تُقسم على جدول التكلفة المقاس. يضمن ECE أن العدد المقدر للرموز المقبولة يطابق الواقع.
فيما يلي جدول بالخصائص التجريبية المختلفة، إلى جانب درجاتها في الفئات الأربع. تم قياسها عبر ~4.5M مسودة موسومة جرى جمعها أثناء خدمة DeepSeek-V4-Flash + DSpark (temp=1, top-p=0.95, conc=64)، بدون AV، عبر خمس مجموعات بيانات: SPEED-Bench 2k low/high-entropy، وGSM8K، وHumanEval، وMT-Bench. الصفان الأخيران مرجعان وليسا خصائص مُلائمة: مسوّد qmax للمسودة مباشرةً كاحتمال قبول دون ملاءمة، ودرجات رأس الثقة المدرَّب.
| الميزة | بلا خسارة | AUC | log-loss | ECE |
|---|---|---|---|---|
| log(qmax) | نعم | 0.8069 | 0.4813 | 0.0592 |
| log(qmax) − log(q2nd) (هامش أعلى-2) | نعم | 0.8156 | 0.4437 | 0.0105 |
| H(q) (الإنتروبيا) | نعم | 0.8321 | 0.4577 | 0.0638 |
| −log(−log(qالأقصى)) | نعم | 0.8336 | 0.4289 | 0.0103 |
| logit(qالأقصى) (المشحون) | نعم | 0.8336 | 0.4284 | 0.0100 |
| logit(qالمُعين) | لا | 0.8553 | 0.4040 | 0.0152 |
| −log(−log(qالمُعين)) | لا | 0.8554 | 0.4075 | 0.0193 |
| qالأقصى (بدون ملاءمة، يُستخدم مباشرة كاحتمال) | نعم | 0.8259 | 0.4880 | 0.0736 |
| رأس الثقة المدرَّب | نعم | 0.8191 | 0.4449 | 0.0052 |
logit(qالمُعين) و−log(−log(qsampled)) تتفوق بوضوح على الخصيصة المختارة في الجدول من حيث AUC، لكنها لم تُستخدم لأن التقليم بناءً عليها يؤدي إلى توزيع مخرجات منحاز. وكلاهما يقرأ qsampled، أي احتمال الرمز الذي سحبه المسوّد فعلياً. تقليم المسودة بناءً على دالة من هذه القيمة يجعل قرار التحقق عند الموضع i معتمداً على xi نفسه، وبالتالي لم تعد المسودات التي تنجو من التقليم موزعة وفق q. يقبل أخذ العينات بالرفض القياسي الرمز باحتمال min(1, p/q)، مع افتراض أن q هي التوزيع الذي سُحب منه رمز المسودة. لكن التقليم بناءً على qsampled يُحيّز التوزيع المُصدَّر نحو الرموز ذات الثقة الأعلى لدى المسوّد.1
يُظهر الصف qmax "no fit" سبب قيامنا بالملاءمة أصلاً، بدلاً من استخدام احتمال المسوّد الخاص به مباشرةً، كما تفعل EAGLE-2 عند بناء شجرة المسودات الخاصة بها. عند استخدامه مباشرةً، فإن احتمال الرمز الأعلى للمسوّد يرتّب المسودات فعلياً بشكل أفضل من رأس الثقة المدرَّب (0.8259 مقابل 0.8191 AUC). ومع ذلك، فهو غير معاير بشكل جيد. متوسط تنبؤه على المسودات الموسومة هو 0.784 مقابل معدل القبول الملاحظ البالغ 0.723، وقيمته ECE أسوأ بـ 7 مرات من خاصية logit(qmax) المشحونة (0.0736 مقابل 0.0100). احتمال الرمز الأعلى للمسوّد يعكس فقط مدى ثقة المسوّد في تنبؤه الخاص، لا ما إذا كان النموذج الهدف سيوافق. ويتأثر هذا التوافق أكثر بالإعداد الخاص بأخذ العينات وبحِمل العمل. الملاءمة عبر الإنترنت تتعلم هذا الربط مباشرةً من قرارات القبول/الرفض الخاصة بالهدف، مما يحقق معايرة أفضل، وهي ما يعتمد عليه قرار الميزانية.
واختَرنا في النهاية خاصية logit(qmax)، التي توازن جيداً بين AUC وECE بتكلفة معقولة. كما كانت خياراً طبيعياً، إذ تتقاسم مقياس احتمالات اللوغاريتم (log-odds) ودقة الكمية التي كنا نحاول تقديرها.
مقابل رأس ثقة مدرَّب
كما يظهر في الجدول أعلاه، بالنسبة لـ DeepSeek-V4-Flash + DSpark، يتفوق المُقدِّر على رأس الثقة في كل من AUC وخسارة log-likelihood، لكنه يقل أداءً في ECE. يلخص الجدول أدناه الفرق:
| AUC ↑ | log-loss ↓ | ECE ↓ | |
|---|---|---|---|
| estimator logit(qmax) | 0.8336 | 0.4284 | 0.0100 |
| trained confidence head | 0.8191 | 0.4449 | 0.0052 |
| Δ (estimator − head) | +0.0146 | −0.0166 | +0.0048 |
لكن بمجرد أن نستثني المسودة الأولى من المتوسطات، يتغير المشهد بشكل كبير:
| AUC ↑ | log-loss ↓ | ECE ↓ | |
|---|---|---|---|
| estimator logit(qmax) | 0.8352 | 0.4420 | 0.0103 |
| trained confidence head | 0.8075 | 0.4743 | 0.0090 |
| Δ (estimator − head) | +0.0278 | −0.0323 | +0.0013 |
أصبح رأس الثقة والمُقدِّر الآن متعادلين تقريبًا في المعايرة. يساعد تفصيل AUC لكل موضع في تفسير السبب:
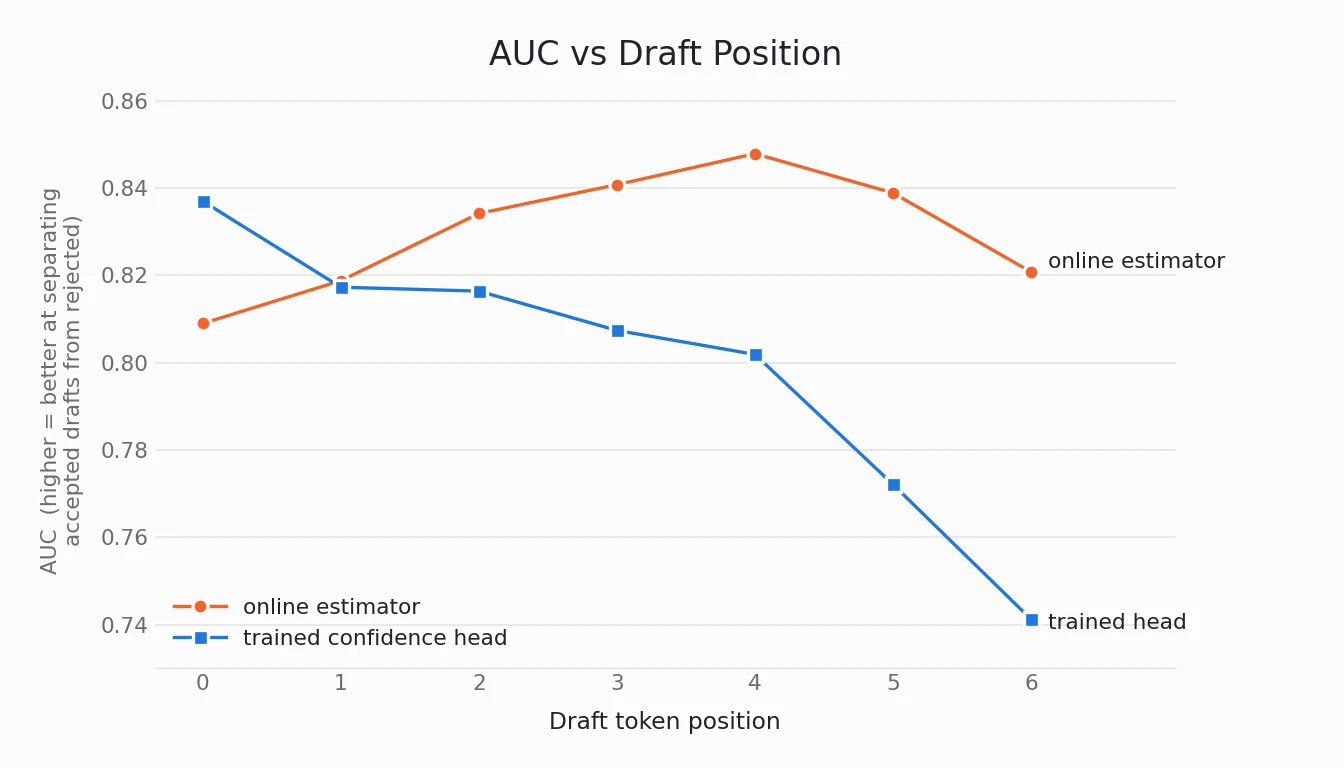
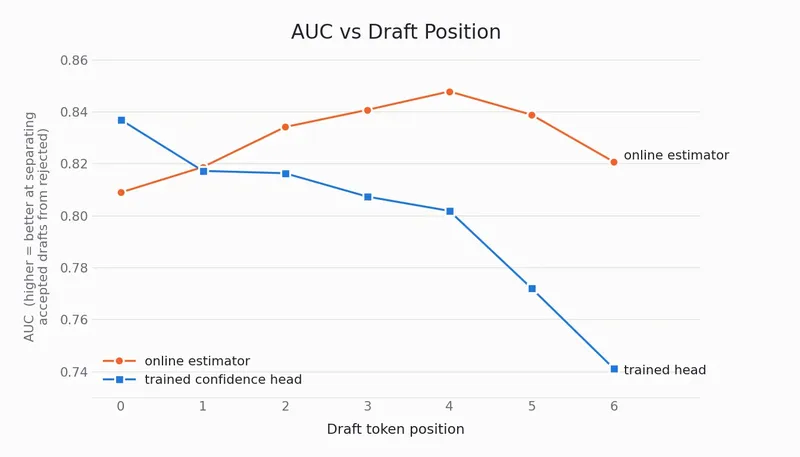
رأس الثقة هو المتنبئ الأفضل في موضع المسودة الأول، لكن المُقدِّر يتقدم من الموضع الثاني فصاعدًا. تتسع الفجوة مع العمق، حيث يتفوق المُقدِّر بـ 0.08 AUC عند الموضع الأخير. يتراجع كلا المتنبئين أيضًا بعد الموضع الخامس. يُرجَّح أن هذا لأن DSpark الخاص بـ DSV4-Flash يعلن حجم كتلة قدره 5 ولم يُدرَّب كاتب المسودات أبدًا بعد ذلك، فتسوء المسودات نفسها هناك.
بما أن البقاء هو حاصل ضرب متجدد، وأن موضع المسودة الأول يحمل دائمًا أعلى درجة للطلب، فهو أقل عرضة لأن يكون الرمز الذي يقتطعه الميزانية. توجد ميزة المُقدِّر تمامًا حيث يحدث الاقتطاع، وهذا يفسر لماذا يستطيع المُقدِّر مجاراة رأس الثقة في الأداء من البداية إلى النهاية.
ملاءمة المعاملات
المعاملات ω و βi يُعاد ملاءمتها بشكل مستمر أثناء الخدمة الفعلية للطلبات. تُتحقق الرموز التخمينية المقترحة خلال خطوة فك التشفير السابقة بواسطة النموذج الهدف في خطوة فك التشفير التالية. الرموز التخمينية المؤهلة للتدريب هي فقط تلك حتى أول رفض (إن وُجد)، لأن النموذج الهدف قد وسمها صراحةً (قبول أو رفض).
نستخدم Iteratively Reweighted Least Squares (IRLS) لتقليل خسارة log-likelihood للتنبؤات مقابل التسميات. يتم إجراء هذا التقليل عبر تقريب تايلور من الدرجة الثانية لخسارة log-likelihood. وتُحصل خطوة التحسين لـ ω و βi عن طريق حل نظام المعادلات
حيث Δθ هو الفارق (delta) للميل المشترك ω ونقاط التقاطع β لكل موضع.i, H هو مصفوفة هيس (Hessian) لدالة الخسارة وذات شكل (K + 1) × (K + 1)، و g هو تدرج دالة الخسارة، بحجم K + 1.
تتم إعادة الملاءمة بعد كل جولة ثابتة من N خطوة فك ترميز. خلال كل خطوة فك ترميز في تلك الفترة، نراكم قيم المصفوفة هيس والتدرج، المشتقة من المعاملات والخصائص والتسميات المجموعة خلال الجولة. يؤدي هذا إلى حصر الذاكرة بحد أعلى قدره O(K²) عبر الجولة، في مقابل O(N × B × K) لو جمعنا التسميات الخام بدلاً من ذلك. في الخطوة الأخيرة من الجولة، تُحلّ منظومة المعادلات، ويتم تحديث المعاملات.
كما هو متوقع، تُقبل المسودات الأعمق بتكرار أقل من المسودات الأكثر سطحية. وبالتالي، قد تُحرم مواضع المسودات الأعمق من التسميات خلال الجولة. اتُّخذ قراران تصميميان للتخفيف من أثر ذلك على عملية إعادة الملاءمة:
- Shared Slope: يُشارَك الميل عبر جميع مواضع المسودات لمنع التحديثات المضوِضة الناتجة عن تناقص البيانات مع العمق. فالتنبؤات أكثر حساسية بكثير لأخطاء الميل منها لأخطاء الحد الثابت، لذا يجعل المشاركة خطوة نيوتن محدَّدة المعالم بشكل جيد. علاوة على ذلك، تُظهر القياسات التجريبية أن مشاركة الميل لا تكاد تكلف شيئًا من حيث الدقة (0.0002 AUC و0.0003 log-loss فقط).
- Step Damping: يتم قياس تحديث كل معامل بحجم الأدلة الداعمة باستخدام الصيغة n / (n + ثابت)، حيث n هو عدد المسودات المُقيَّمة. يضمن هذا أن المواضع الأعمق ذات التسميات الأقل تتحرك بشكل أكثر تحفظًا، مما يمنع التحديثات المستندة إلى الضوضاء.
Slope vs Intercept Roles
تم تتبع المعاملات المُقاوَمة عبر عدة توليفات من نموذج/مجموعة بيانات، وسلوك نوعيّ المعاملات يختلف اختلافًا كبيرًا.
ثبّت زوج النماذج وغيّر عبء العمل: عند ملاءمة DSV4-Flash + DSpark بشكل مستقل على كلٍّ من خمسة أعباء عمل، يتحرك الميل بالكاد (من 0.51 إلى 0.55)، دون أي ارتباط بمدى صعوبة عبء العمل (r = −0.08 مقابل متوسط إنتروبيا المسودة). أما نقاط التقاطع فيفعل العكس: نقطة تقاطع موضع المسودة الأول ترتبط بإنتروبيا المسودة بمعامل r = −0.89، وتمتد من حوالي 0.5–0.6 على أعباء العمل الأكثر قابلية للتنبؤ وصولًا إلى أقل من 0 على الأقل قابلية للتنبؤ.
| مجموعة البيانات | معدل القبول | متوسط إنتروبيا المسودة | الميل ω | التقاطع β0 |
|---|---|---|---|---|
| gsm8k | 0.781 | 0.562 | 0.5365 | +0.478 |
| humaneval | 0.751 | 0.669 | 0.5135 | +0.486 |
| speed-bench 2k low-entropy | 0.755 | 0.703 | 0.5087 | +0.610 |
| mt-bench | 0.714 | 0.800 | 0.5495 | +0.181 |
| speed-bench 2k high-entropy | 0.642 | 1.077 | 0.5197 | −0.089 |
والآن نغيّر زوج النماذج: يترواح الميل بين 0.45 و0.59 عبر الأزواج، مع بقائه ضمن مدى ضيق داخل كل زوج. كما أن التقاطعات تختلف بين الأزواج أيضًا، ولذلك بخلاف الميل فهي ليست خاصية لأحد المحورين وحده.
| النموذج | nspec | الميل ω | الانحراف المعياري لـ ω | التقاطع β0 |
|---|---|---|---|---|
| DeepSeek-V4-Flash + DSpark | 5 | 0.5013 | 0.0250 | +0.279 |
| MiMo-V2.5-Pro-FP4 + DFlash | 8 | 0.5197 | 0.0415 | −1.000 |
| Inkling-NVFP4 + MTP | 8 | 0.5859 | 0.0349 | −0.572 |
| Muse-Glimmer-30B + DFlash2 | 7 | 0.4450 | 0.0323 | +0.167 |
بقراءة الجدولين معًا، يظهر تقسيم للأدوار. يقيس الميل مدى قدرة نموذج المسودة على معرفة متى يكون محقًا. وهذه خاصية لزوج الهدف/المسودة ولطريقة أخذ العينات من المسودة، ولهذا لا يتغير تقريبًا عندما يتغير عبء العمل فقط. أما التقاطعات فتستوعب الباقي: معدل القبول الأساسي في كل موضع من مواضع المسودة، وهو معدل يتناقص مع العمود ويهبط أكثر على المحتوى الأقل قابلية للتنبؤ. ويعتمد معدل القبول الأساسي هذا على زوج النماذج وكذلك على عبء العمل، ولهذا تتحرك التقاطعات على المحورين بينما يتحرك الميل على محور واحد فقط.
المعايير المرجعية
قمنا باختبار ثلاث نقاط تفتيش (MiMo-V2.5-Pro-FP4 + DFlash، وInkling-NVFP4 + MTP، وMuse-Glimmer-30B + DFlash2) لم تكن قادرة سابقًا على استخدام AV إطلاقًا، إلى جانب DSV4-Flash + DSpark + المُقدِّر، وDSV4-Flash + DSpark + رأس الثقة، كمرجع. وقد سُجّلت المكاسب أدناه مع إيقاف AV وتشغيله، ودرجة حرارة 1.0، وtop-p 0.95، وتزامن 64، عبر أربع مجموعات بيانات.
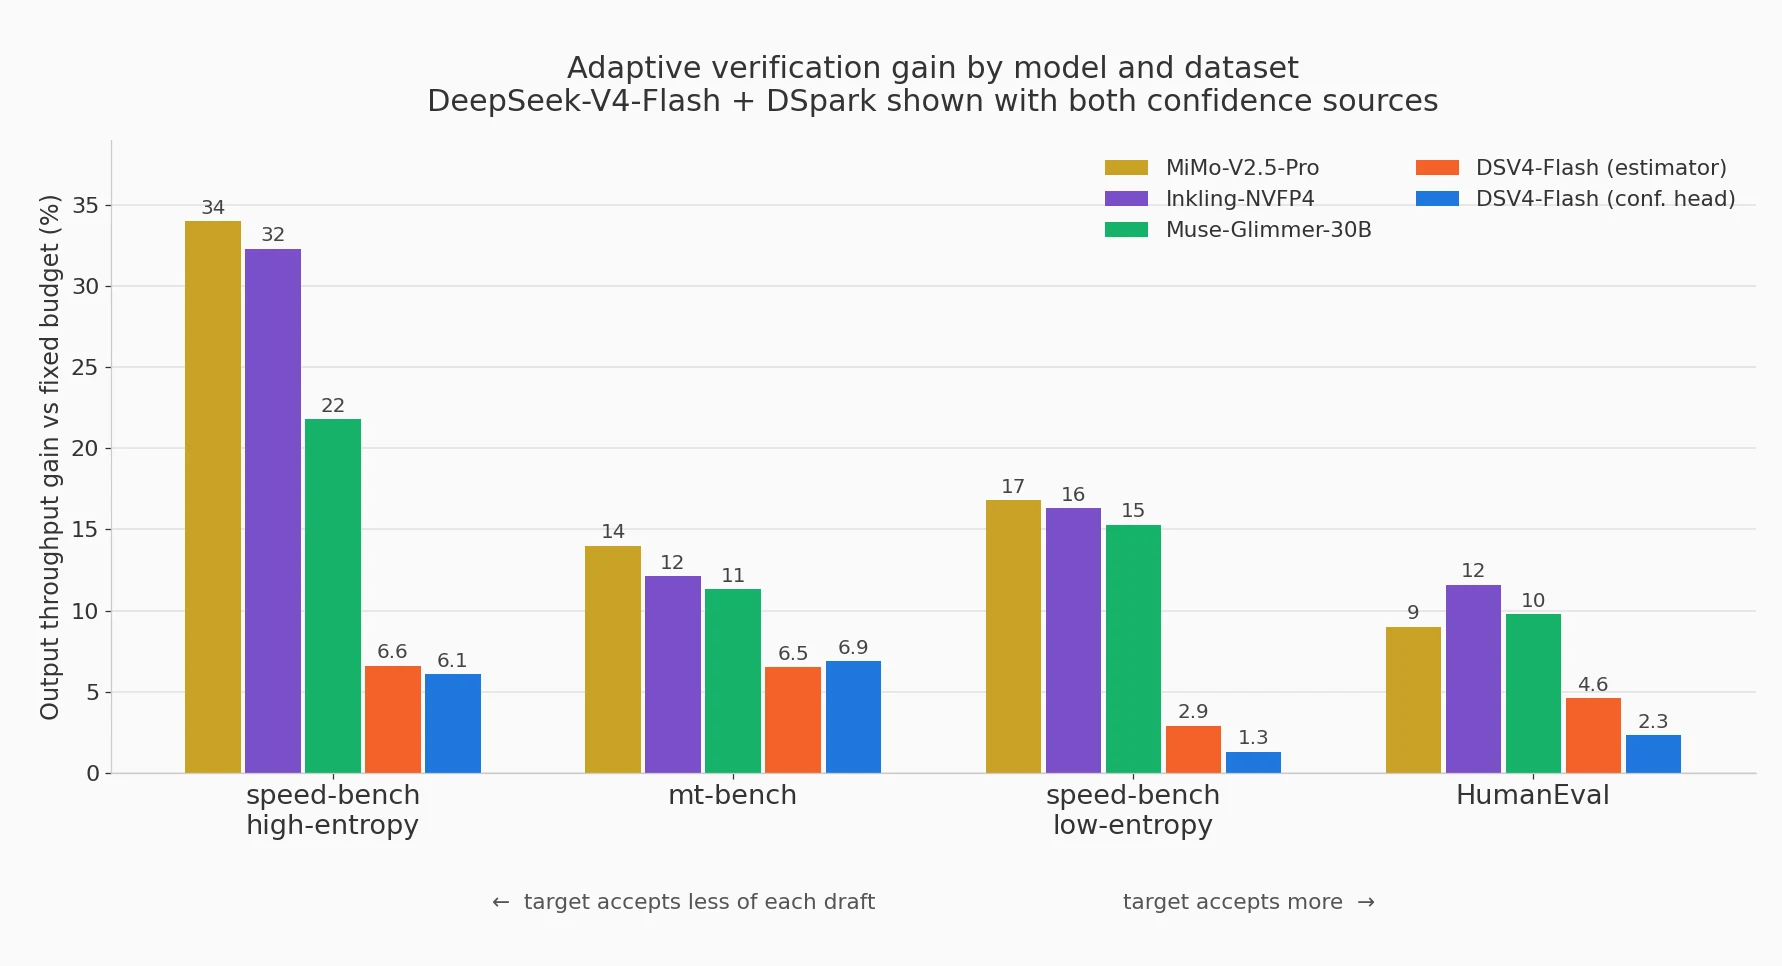
بالمقارنة مع التحقق الثابت، فإن المُقدِّر الإلكتروني عند طول الاستدلال التخميني نفسه يحقق فوزًا عبر جميع مجموعات البيانات المقاسة. ومع ذلك، فإن هذا المكسب وحده لا يحكي القصة كاملة. فغالبًا ما يمكن العثور على طول ثابت أصغر يتفوق على AV عند أقصى طول تخميني عند تزامنات محددة. وقد سُجّلت منحنى باريتو أدناه باستخدام DSV4 + DSpark عبر مسح لأطوال تخمينية ثابتة ولـ AV عند أقصى طول تخميني:
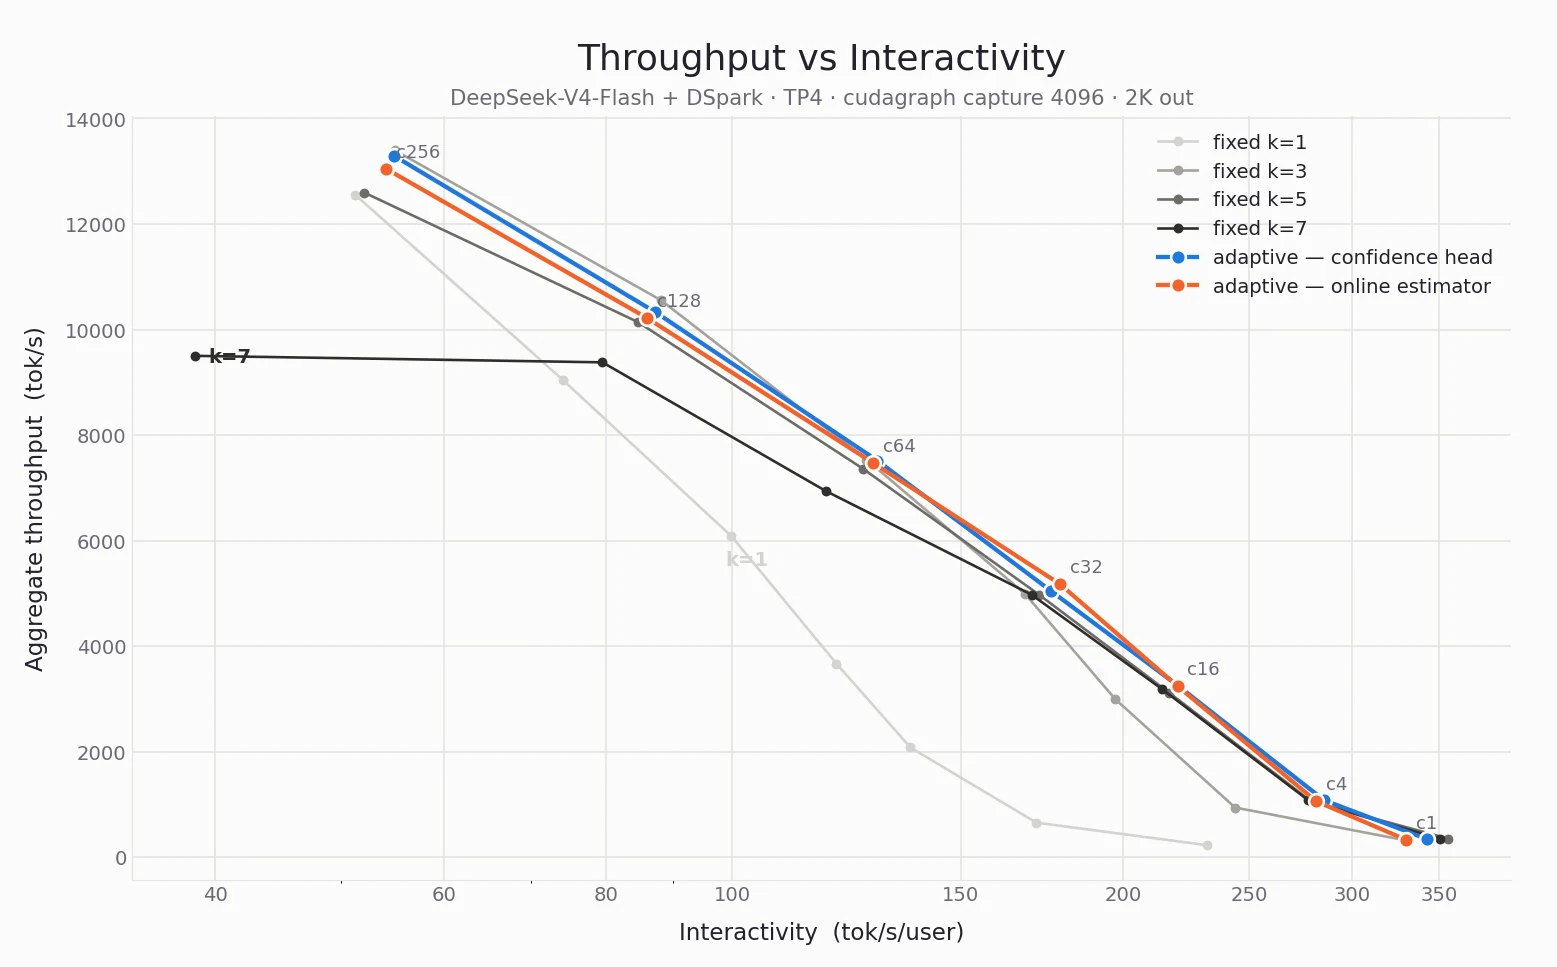
يتساوى المُقدِّر الإلكتروني ورأس الثقة تقريبًا من حيث الأداء، عبر جميع تزامنات القياس. ومع ذلك، لم يُصمَّم المُقدِّر الإلكتروني ليكون بديلًا عن رأس الثقة، بل ليكون خيارًا بديلًا فوريًا عند غيابه. لنرَ كيف يعمل على زوج نماذج يفتقر حاليًا إلى رأس ثقة. فيما يلي منحنى باريتو لـ MiMo-V2.5-Pro-FP4 + DFlash عبر مسح لأطوال تخمينية ثابتة ولـ AV:
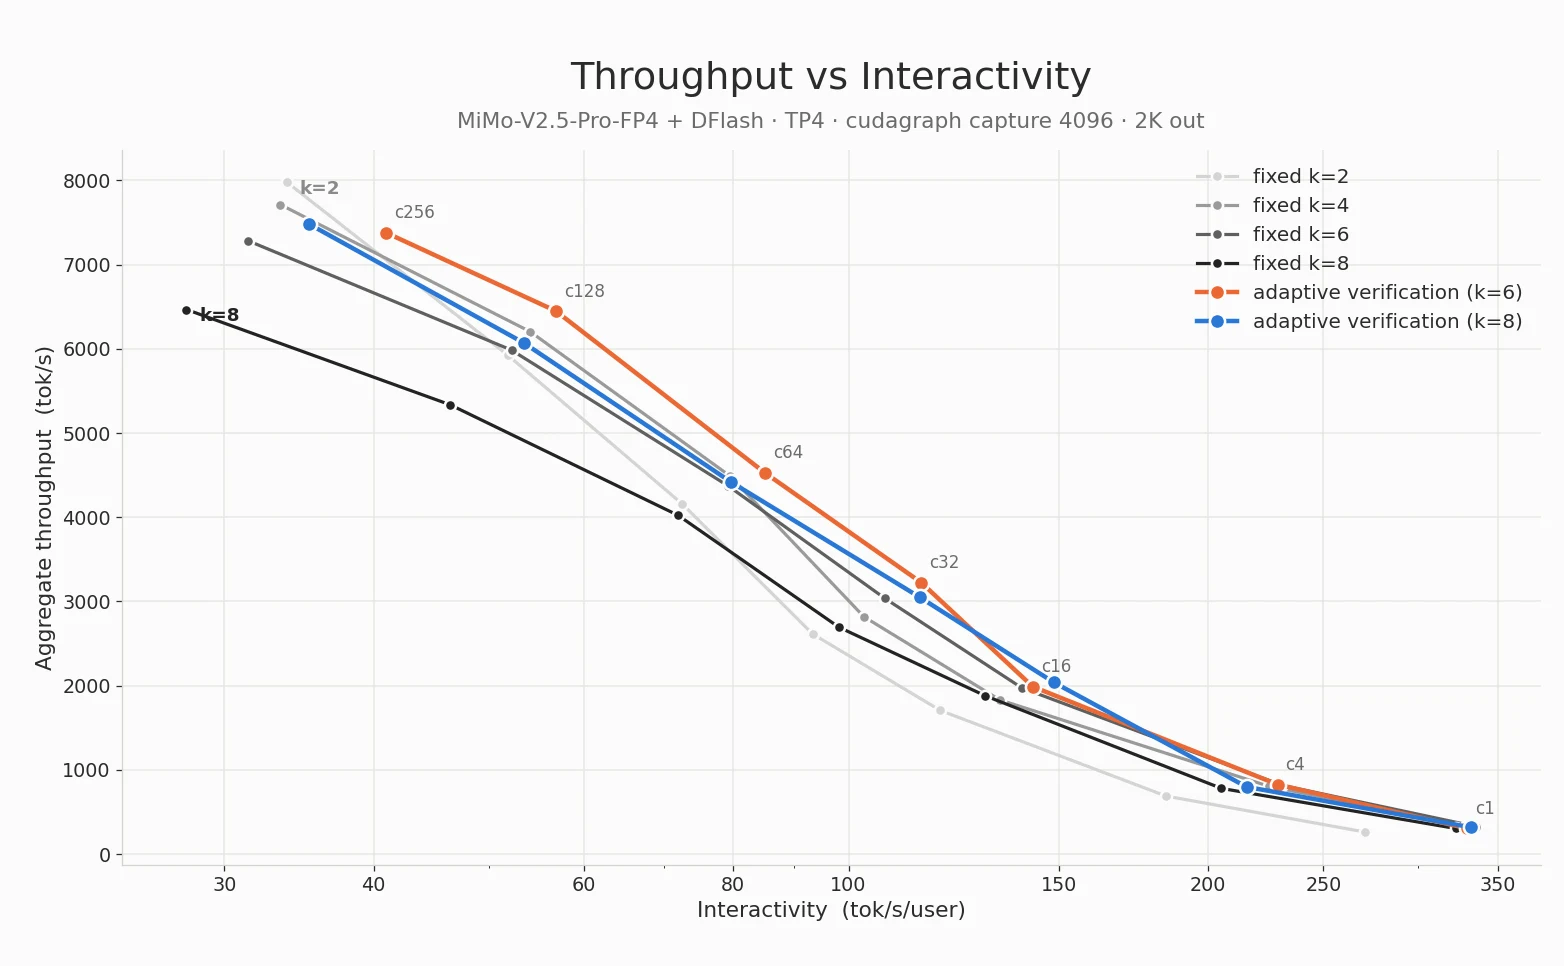
يقع AV على حدود الإنتاجية-التفاعلية عند 5 من أصل 7 تزامنات.
القيود
- يجب أن يدعم الواجهة الخلفية للانتباه في النموذج الهدف التحقق متغير الطول. وهذا هو المتطلب السابق نفسه الذي يمتلكه DSpark AV بالفعل.
- يستفيد MTP وEAGLE من AV بدرجة أقل من DFlash وDSpark. والسبب أن آليات الاستدلال التخميني ذاتية الانحدار تلك تدفع تكلفة أكبر نسبيًا عند صياغة رموز قد تُقتطع قبل التحقق.
الاستخدام في vLLM
يُفعَّل AV من خلال إعدادات الاستدلال التخميني (speculative config). عند استخدام نموذج مسودة (1) لا يحتوي على رأس ثقة و(2) يدعم انتباهًا متغير الطول في جميع واجهاته الخلفية، يُختار المُقدِّر الإلكتروني تلقائيًا:
vllm serve <target_model> \
  ...
  --speculative-config '{
    "model": "<draft_model>",
    "method": "<method>",
    "num_speculative_tokens": <num_speculative_tokens>,
    "draft_sample_method": "probabilistic",
    "enable_adaptive_verification": true
  }'
شكر وتقدير
أُنجز هذا العمل من قِبل Giancarlo Delfin (Inferact)، ويبنى مباشرة على Adaptive Verification من Lucas Wilkinson (Red Hat) وBenjamin Chislett (NVIDIA).
هوامش
-
يمكن استخدام مثال بمفردات بسيطة من رمزين وهما [a, b] لتوضيح هذا التحيز. افترض p = [0.5, 0.5], q = [0.2, 0.8]، وأن الرمز المسودة يُقتطع من التحقق إذا كان q(x) < 0.5. سحب a يؤدي إلى الاقتطاع، والعينة الهدف تسحب رمزًا من توزيعها الخاص، p(x). غير أن سحب b يؤدي إلى التحقق: يُقبل الرمز باحتمال min(1, p(b)/q(b)) = 0.625، وإلا فيُرفض وتُعاد عيّنته من الباقي norm(max(0, p − q)) = [1, 0]، مما ينتج a. أثناء أخذ العينات بالرفض نحصل على pout(a) = q(a)·p(a) + q(b)·(1 − 0.625) = 0.4 و pخارج(b) = q(a)·p(b) + q(b)·0.625 = 0.6. وهذا يختلف عن توزيع الهدف البالغ [0.5, 0.5] وينتهك ضمان الفقدان الصفري لفك التشفير التخميني. ↩