
أهم النقاط
- تمنحك التقييمات درجات لتشغيلات وكيلك حتى تتمكن من التحقق من أنه يتصرف بالطريقة التي تتوقعها. للبدء، اختر سلوكًا واحدًا، وأنشئ مجموعة بيانات صغيرة من الآثار الحقيقية، وشغّل خط أساس. استخدم التقييمات دون الاتصال قبل الإطلاق والتقييمات المتصلة في الإنتاج، وحوّل الإخفاقات الجديدة إلى أمثلة في مجموعة البيانات.
- استخدم المقيمات البرمجية حيث تستطيع، وقضاة نماذج اللغة الكبيرة حيث لا تستطيع، والمراجعة البشرية للتحقق من كليهما. بالنسبة للوكلاء الذين يتخذون خطوات عديدة، قيّم المحادثات الكاملة والمسارات والحالة النهائية.
- المعايير القياسية مثل Terminal-Bench هي تقييمات دون اتصال بمهام أطول وبيئات خاصة بها. Harbor يشغّلها ويسجّل النتائج في تجارب LangSmith.
أثناء بناء وكيلك وإطلاقه، ستحتاج إلى طريقة للتحقق من أنه يتصرف بالطريقة التي تتوقعها، سواء أثناء التطوير أو عندما يبدأ المستخدمون الحقيقيون في الاعتماد عليه.
في البرمجيات التقليدية، تنتج المدخلات نفسها المخرجات نفسها، لذا يمكن لاختبار الوحدة التحقق من نتيجة محددة بدقة. أما الوكلاء فيصعب اختبارهم لعدة أسباب:
- تختلف المخرجات بين التشغيلات، حتى للطلب نفسه
- قد يكون أكثر من إجابة واحدة صحيحة، لذا فإن التحقق من تطابق تام لا يكفي
- الوكيل يختار خطواته بنفسه، لذا قد تنتج المخرجات الصحيحة من مسار "خاطئ". على سبيل المثال، قد يستدعي الوكلاء أداة لا يحتاجها أو يتخذ إجراءً دون إذن المستخدم.
تقييمات الوكلاء هي الحل. فهي تمنح درجات لتشغيلات وكيلك من خلال فحوصات تأخذ هذه الاختلافات في الاعتبار. وعلى غرار الوكلاء الذين تقيّمهم، هذه الاختبارات ليست مقاسًا واحدًا يناسب الجميع، وأفضل مجموعة من التقييمات تعتمد على الفريق ومنتجهم وما يريدون تحسينه.
على مدى السنوات القليلة الماضية أثناء العمل على LangSmith، منصة LangChain لهندسة الوكلاء، واجه فريقنا الكثير من أسئلة التقييم المختلفة. تستعرض هذه المدونة بعض الأسئلة الأكثر شيوعًا حول كيفية البدء بتقييمات الوكلاء والأنواع المختلفة من التقييمات التي يمكنك استخدامها في سير عملك.
من أين يجب أن نبدأ؟
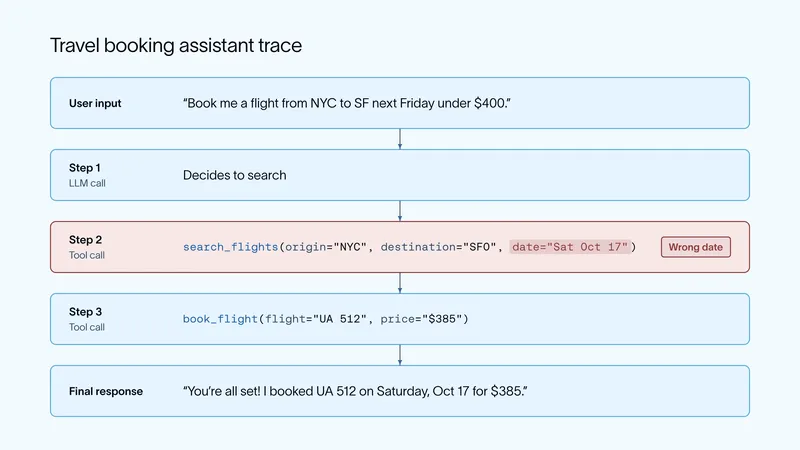
كل تقييم يبدأ بفهم ما يفعله وكيلك فعليًا. الأثر (trace) هو سجل لتشغيل واحد لوكيلك، يتضمن مدخلاته ومخرجاته وكل استدعاء للنموذج أو الأداة بينهما. اقرأ عينة من آثاره لترى كيف يتعامل مع الطلبات وأين يخطئ. ما تجده يخبرك بما يجب اختباره أولًا. ابدأ صغيرًا.
- اختر سلوكًا تهتم به. على سبيل المثال، بالنسبة لمساعد سفر، قد يكون السلوك هو ما إذا كان يحجز التاريخ ونطاق السعر الذي طلبه المستخدم.
- أنشئ مجموعة بيانات صغيرة من الآثار. مجموعة البيانات هي مجموعة من الأمثلة، وكل مثال هو حالة اختبار واحدة تتكون من مدخل وغالبًا مخرج متوقع. عشرة إلى عشرين مثالًا لسلوك ما تكفي للبدء، وفي LangSmith يمكنك إضافة آثار إلى مجموعة بيانات مباشرة من واجهة التتبع. إذا لم يكن وكيلك في الإنتاج بعد، اطلب من فريقك أو مجموعة صغيرة من شركاء التصميم الموثوقين تجريبه (dogfooding) واعمل من تلك الآثار.
- شغّل خط أساس. شغّل وكيلك الحالي على مجموعة البيانات واحفظ النتيجة كتجربة. التجربة تحتوي على نتائج تشغيل نسخة واحدة من وكيلك على مجموعة بيانات، إلى جانب الدرجات من المقيمات لديك. ستقارن أداء النسخ المستقبلية من وكيلك بهذه التجربة.
- أضف الإخفاقات الجديدة كلما وجدتها. كل فشل تراه في الإنتاج أو أثناء الاختبار يصبح مثالًا جديدًا.
استمر في إضافة حالات الفشل إلى مجموعة بياناتك وستحصل على حلقة تحسين. ابحث عن فشل، وأضفه إلى مجموعة البيانات، وحسّن الوكيل، وأعد التشغيل. ومع تحديدك لمزيد من سلوكيات الوكيل المراد تقييمها، ستوسّع مجموعة التقييمات الخاصة بك باتباع النمط نفسه الموضح أعلاه.
ما الفرق بين التقييمات دون الاتصال بالإنترنت والتقييمات المتصلة بالإنترنت؟
يمكن للتقييمات، بل ينبغي لها، أن تعمل قبل طرح التغيير وبعد انطلاق الوكيل مباشرة. قبل الطرح، يمكن للتقييمات أن تخبرك ما إذا كان التغيير قد حسّن أداء الوكيل أم أساءه. وبعد الطرح، يمكن للتقييمات أن تخبرك كيف يؤدي الوكيل مع المستخدمين الحقيقيين.
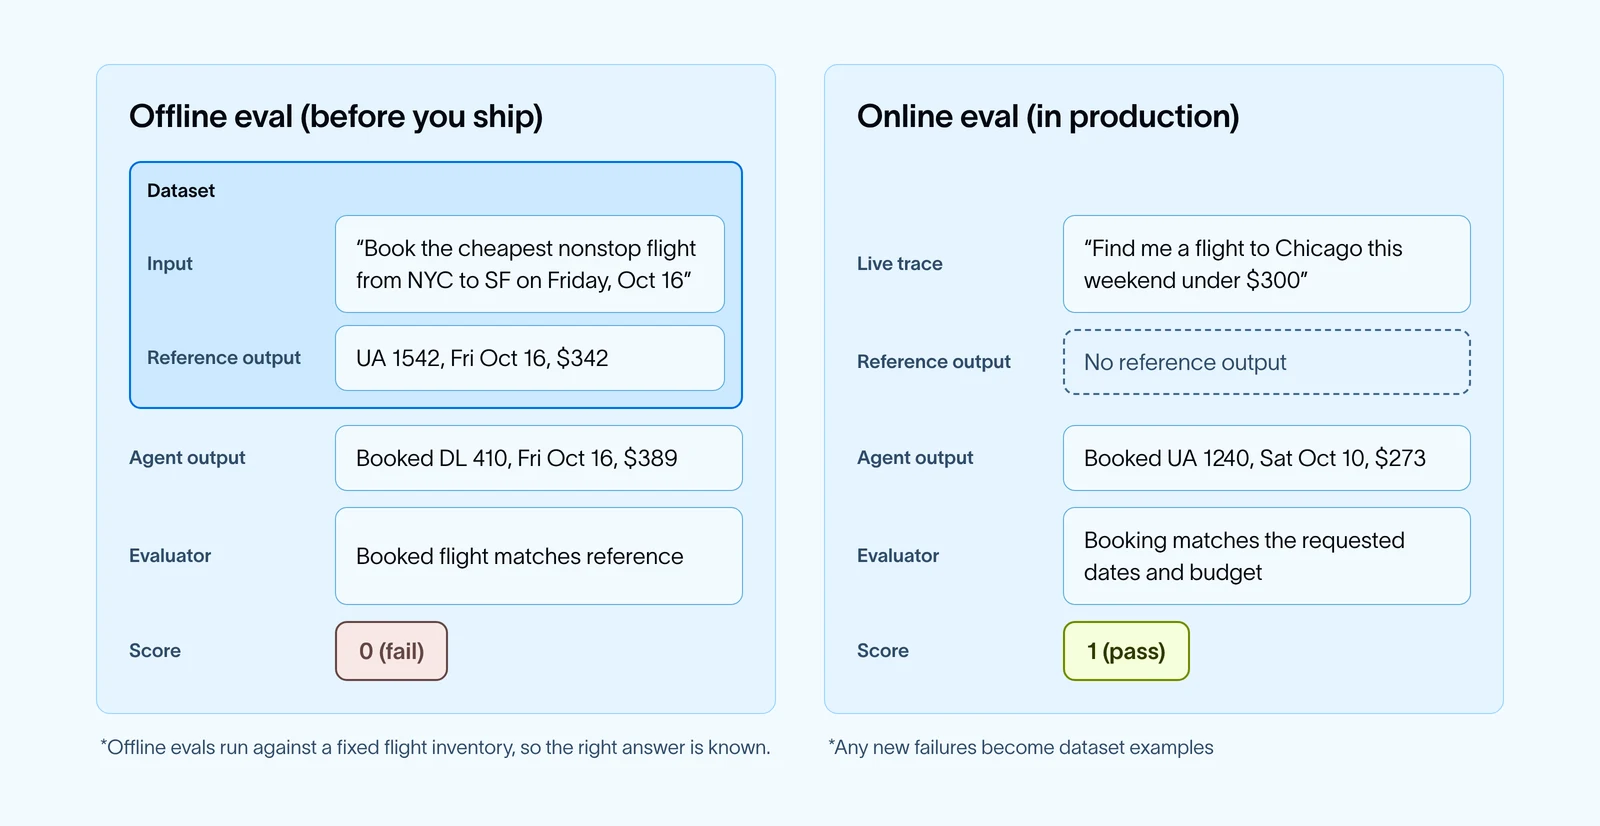
التقييمات دون الاتصال بالإنترنت تشغّل وكيلك على مجموعة بيانات قبل أن تطرح تغييرًا. أنت تختار مدخلات الأمثلة، ويمكنك أيضًا تضمين المخرجات المتوقعة (وتُسمى أيضًا المخرجات المرجعية). باستخدام مجموعة البيانات لديك، يمكنك مقارنة نتائج التجارب عبر إصدارات الوكيل. وهي الأنسب لاختبار موجّه جديد أو نموذج أو أداة جديدة، ولرصد حالات التراجع قبل وصولها إلى المستخدمين.
المعايير القياسية مثل Terminal-Bench هي أيضًا تقييمات دون الاتصال بالإنترنت، مبنية على مجموعة ثابتة من المهام حتى تتمكن من مقارنة الوكلاء أو النماذج أو الإصدارات. يقوم Harbor بتشغيلها وتسجيل النتائج في تجارب LangSmith، وهو ما نتناوله بمزيد من التفصيل أدناه.
التقييمات المتصلة بالإنترنت تمنح درجات لمسارات الإنتاج الحقيقية أثناء ورودها. لا توجد عادةً مخرجات مرجعية للمقارنة معها، لذا فهي تعتمد على فحوصات برمجية وقضاة يعملون بنماذج LLM يمكنهم تقييم تشغيلة من تلقاء نفسها. وهي الأنسب لمراقبة الجودة وإيجاد المشكلات التي فاتت مجموعة بياناتك.
أنت بحاجة إلى النوعين معًا، وكل منهما يغذي الآخر. حالات الفشل التي ترصدها التقييمات المتصلة بالإنترنت تصبح أمثلة جديدة في مجموعة بياناتك دون الاتصال بالإنترنت.
هناك عدة طرق لـ بناء مجموعة بيانات للتقييمات دون الاتصال بالإنترنت في LangSmith. يمكنك كتابة أمثلة من الصفر، أو إضافة تشغيلات من مساراتك الحالية، أو إرسال تشغيلات راجعها فريقك في قائمة انتظار التعليقات التوضيحية (annotation queue), أو تحميل ملف CSV أو JSONL، أو توليد أمثلة اصطناعية من أمثلة قليلة تملكها بالفعل.
مع نمو مجموعة التقييم الخاصة بك، ستحتاج إلى أن تقرر ما إذا كنت ستضيف أمثلة إلى مجموعة بيانات موجودة أو تبدأ مجموعة جديدة. كقاعدة إرشادية:
- احتفظ بالأمثلة في نفس مجموعة البيانات عندما تختبر السلوك نفسه باستخدام المقيّمين نفسه، حتى تظل التجارب قابلة للمقارنة مع مرور الوقت.
- أنشئ مجموعة بيانات جديدة عندما تبدو المدخلات مختلفة (مثل الطلبات المفردة مقابل المحادثات الكاملة)، أو عندما تحتاج إلى مقيّمين مختلفين، أو عندما تخدم مجموعة البيانات غرضًا مختلفًا، مثل مجموعة صغيرة تُشغَّل على كل طلب دمج مقابل مجموعة أكبر تُشغَّلها قبل الإصدار.
داخل مجموعة بيانات واحدة، يمكنك أيضًا استخدام التقسيمات لتشغيل مجموعة فرعية من الأمثلة.
ما هي الأنواع المختلفة لمقيّمي الوكلاء؟
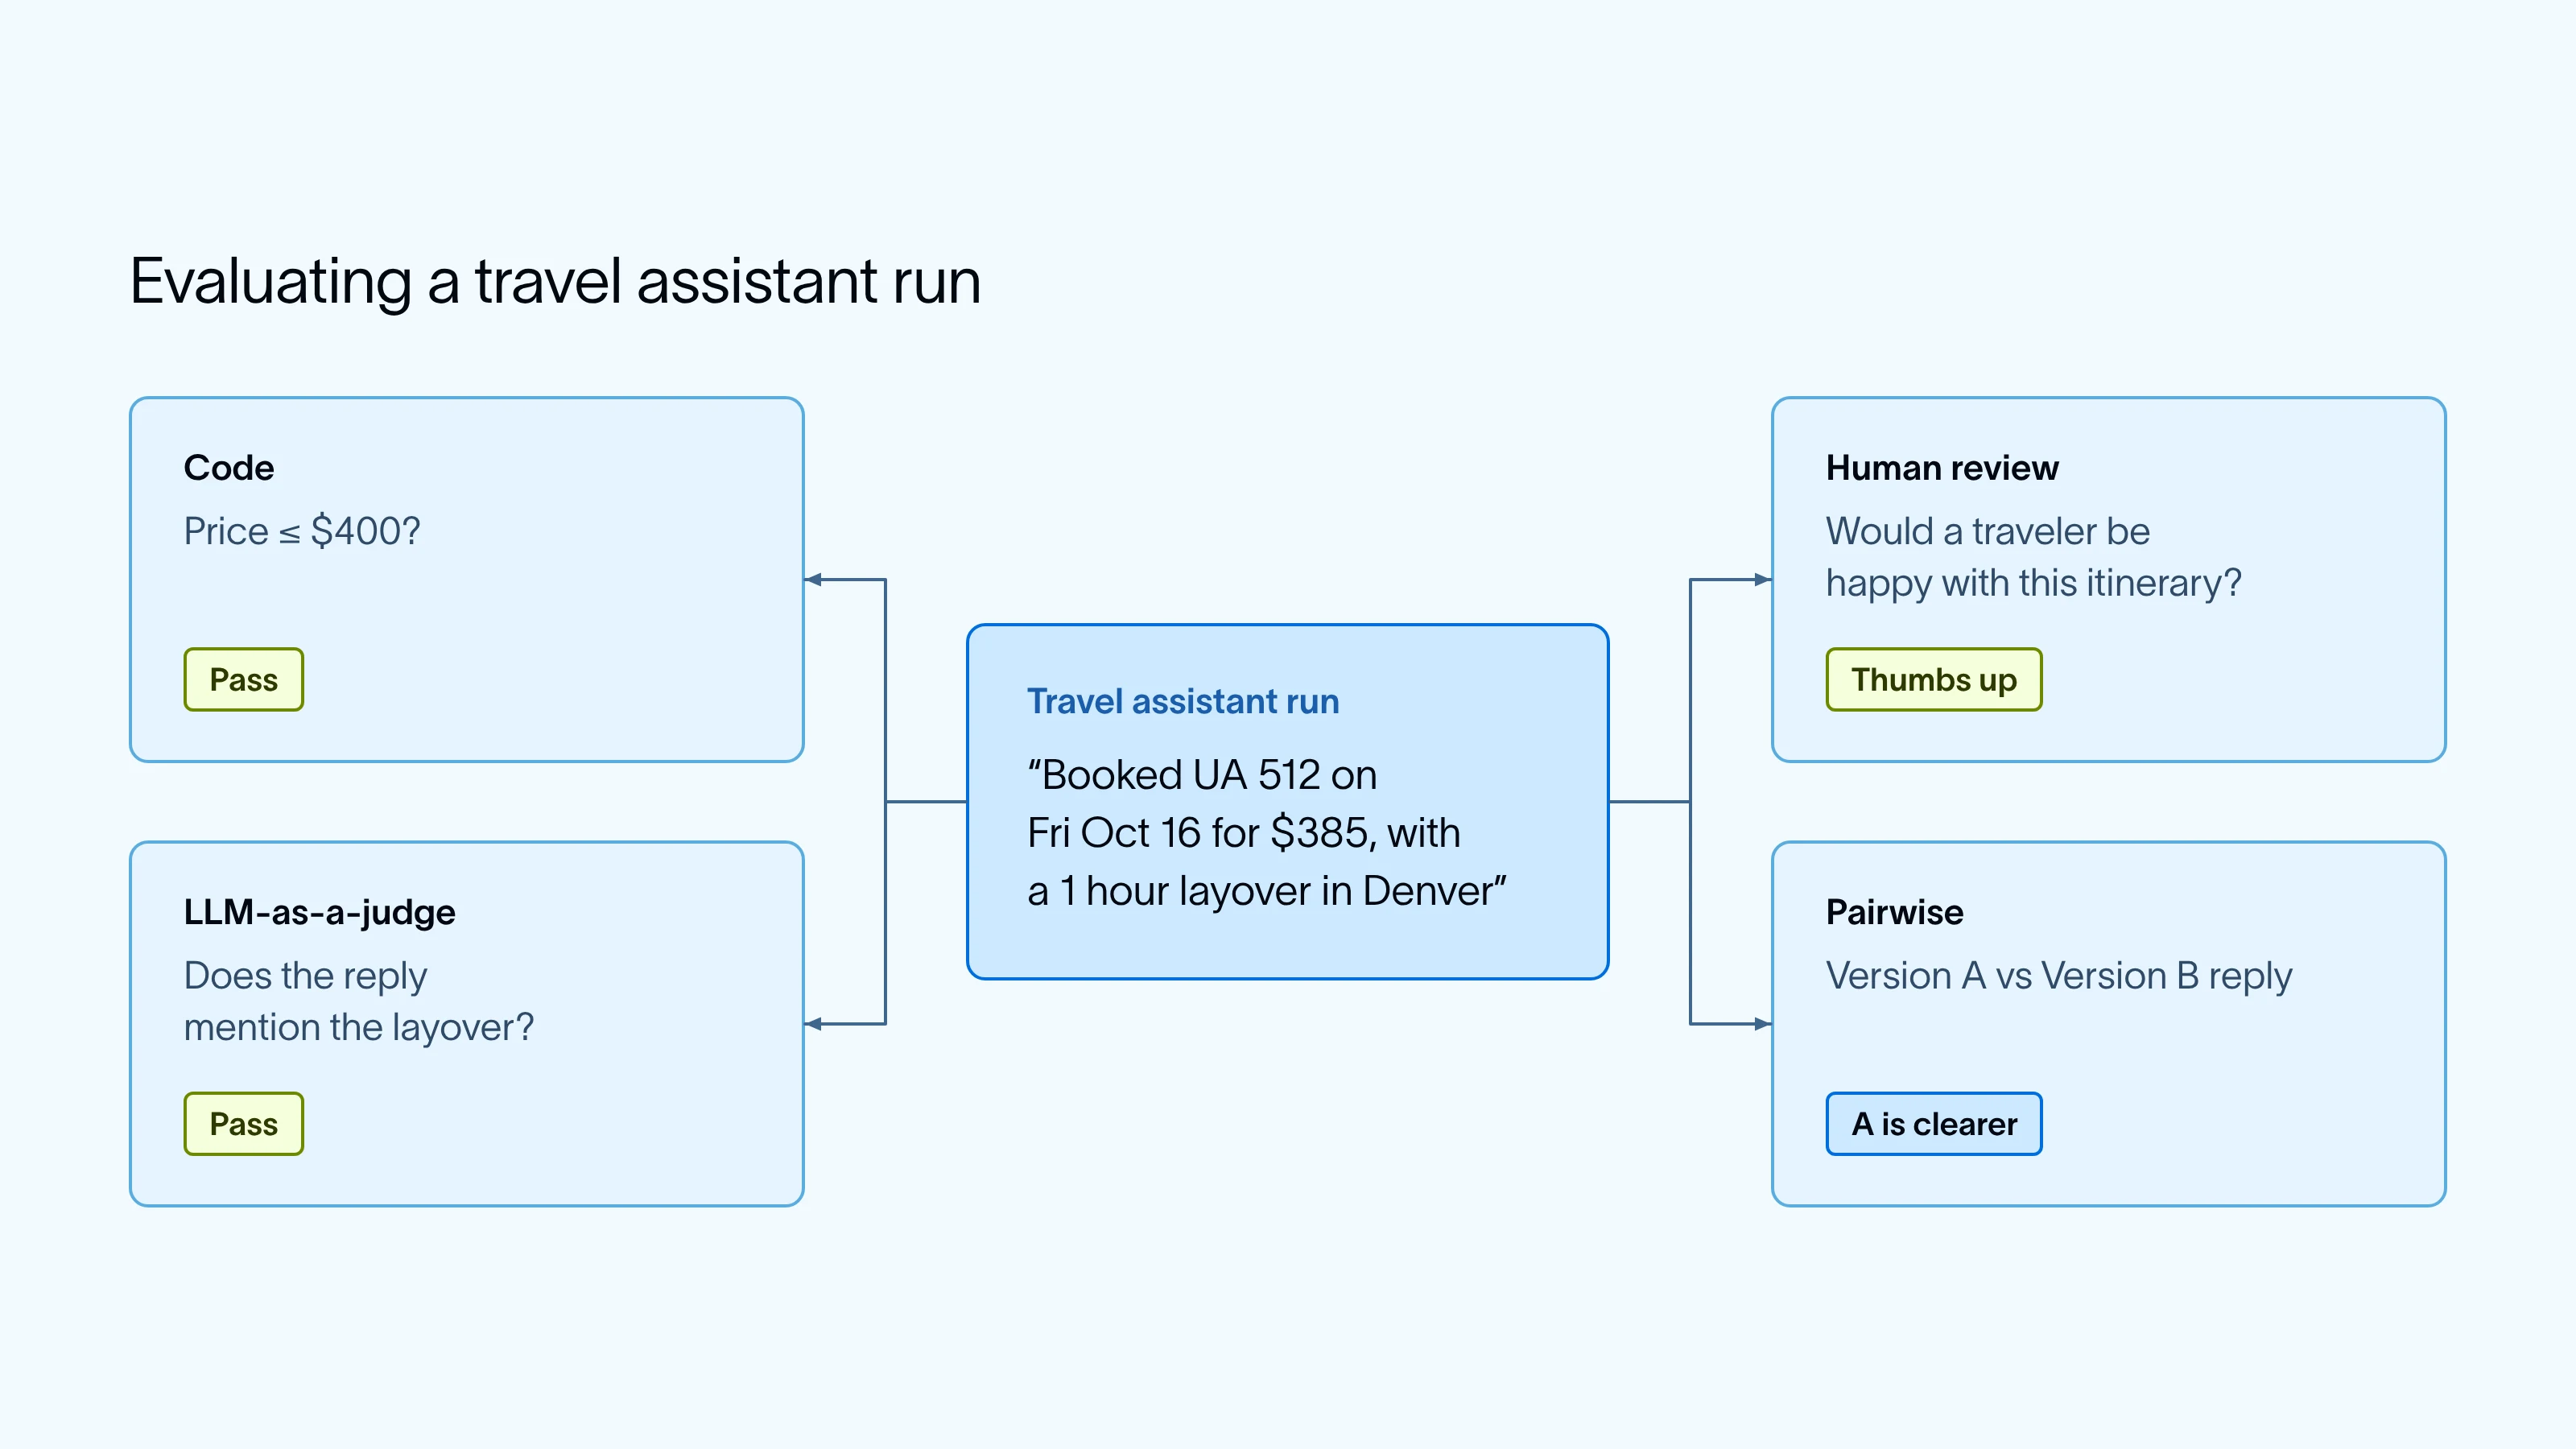
المقيّم هو المنطق الذي يمنح درجة للتشغيل. هناك أربعة أنواع شائعة. تبدأ معظم الفرق بنوع أو نوعين ثم تضيف المزيد مع الوقت.
- مقيّمات الكود تفحص الأمور بشكل حتمي، مثل ما إذا كان السعر المحجوز أقل من ميزانية المستخدم. إنها سريعة ورخيصة ومتسقة، لكن حاجتها إلى مدخلات ومخرجات حتمية تحد من فائدتها.
- النموذج اللغوي كقاضٍ يستخدم نموذجًا لتقييم أمور لا يستطيع الكود تقييمها، مثل ما إذا كانت ردّ المساعد يؤكد بوضوح تفاصيل الرحلة.
- المراجعة البشرية تجعل فريقك أو خبراء المجال يمنحون الدرجات للتشغيلات مباشرة. إنها أبطأ، لكنها أفضل إشارة للجودة الذاتية وللفحص المقيّمين الآخرين. غالبًا ما تُستخدم على عينة أصغر لإفشاء حكم مقيّم النموذج اللغوي لاحقًا.
- المقيّمات الثنائية تقارن مخرجين جنبًا إلى جنب وتختار الأفضل، وهو أمر مفيد عند الاختيار بين طلبين (prompts) أو نموذجين.
يمكن توجيه أي من هذه المقيّمات إلى أجزاء مختلفة من تشغيل الوكيل. قد يمنح التقييم درجة لـ:
- خطوة واحدة. مثال: ما إذا كان
search_flightsقد تم استدعاؤه بالتاريخ الصحيح. - الاستجابة النهائية. مثال: ما إذا كان الرد يؤكد الرحلة التي حجزها الوكيل فعلًا.
- محادثة كاملة. مثال: ما إذا كان الحجز النهائي يعكس كل تغيير طلبه المستخدم عبر عدة أدوار
- الحالة النهائية لبيئة ما. مثال: سجلات الحجز في نظام حجز وهمي بعد تشغيل الوكيل في حاويته الخاصة. غالبًا ما تستخدم المعايير المرجعية هذا الإعداد، وأحيانًا ستسمع تسميتها بالتقييمات المُحوّلة (containerized evals).
هل يمكنك الوثوق بقاضٍ من نموذج لغوي؟
يستخدم قاضي النموذج اللغوي نموذجًا لتقييم المخرجات التي يصعب فحصها بالكود، مثل ما إذا كان الجواب مدعومًا بالمستندات المسترجعة. القضاة مرنون، لكن قد يكونون غير متسقين وينحرفون عن حكم فريقك. بعض العادات تجعلهم موثوقين:
- قارن بين القاضي والدرجات البشرية. اطلب من أحد أعضاء فريقك تقييم عينة من عمليات التشغيل والتحقق من مواضع خلاف الحكم معها. عدّل موجه الحكم أو أمثلته حتى يتطابقوا. طوابير التعليق التوضيحي في LangSmith تجعل هذا الأمر سهلاً. وثائقنا حول LLM كحكم ترشدك خلال هذه العملية.
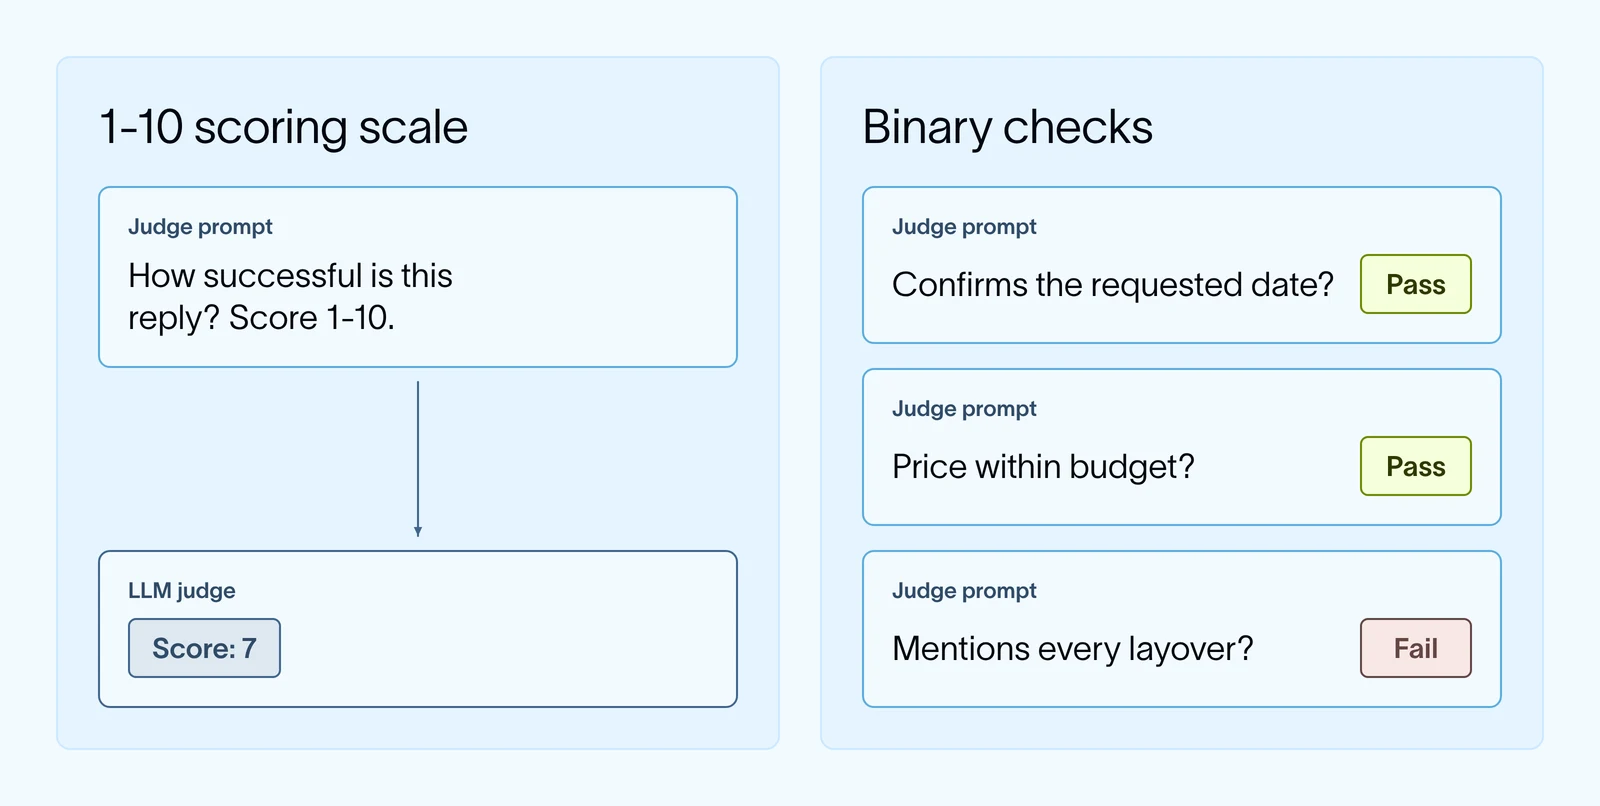
- اطرح أسئلة ضيقة. في مثال وكيل السفر لدينا، سؤال "هل يذكر الرد كل توقف ترانزيت؟" أسهل في الحكم من سؤال "هل هذا رد جيد؟"
- حدد مقياس تقييم دقيقاً. النجاح أو الفشل الثنائي، أو مجموعة صغيرة من الفئات المسمّاة، أكثر قابلية للتكرار بكثير من التقييم على مقياس من 1 إلى 10. قد يجد الحكم صعوبة في التمييز بين درجة 6 مقابل 7.
هل التقييمات هي نفسها المعايير المرجعية (benchmarks)؟
المعيار المرجعي هو نوع من التقييم دون الاتصال بالإنترنت يتكون من مجموعة من المهام. المهمة هي حالة اختبار واحدة في المعيار المرجعي، وتشمل تعليمات، وبيئة داخل حاوية، وسكربت اختبار يقيّم النتيجة. مع ازدياد قدرات الوكلاء، غالباً ما لا يكون حكم LLM بسيط أو تقييم قائم على الكود كافياً. يمكن للوكلاء الآن تنفيذ الكود، وتحرير الملفات، والتفاعل مع الخدمات. لنمذجة هذا السلوك متعدد الخطوات، تُنشئ المعايير المرجعية بنية تحتية معزولة في حاويات. هذا يتيح للمطورين اختبار سلوك الوكيل دون اتصال بنفس الطريقة التي سيعمل بها الوكيل في الإنتاج.
تختلف المعايير المرجعية عن أحكام LLM الأبسط والتقييمات القائمة على الكود في عدة جوانب:
- تتضمن المهام خطوات أكثر. لإكمال مهمة واحدة، قد يقوم الوكيل بتثبيت حزم، وتحرير ملفات، وتشغيل أوامر عبر عشرات من استدعاءات الأدوات.
- كل مهمة تأتي مع بيئة خاصة بها. يمكن للوكلاء الآن اتخاذ إجراءات في بيئات مثل بيئة تجريبية تحتوي على مستودع كود وملفات وأدوات. كل مهمة تُرفق مع بيئتها المعزولة الخاصة ليعمل فيها الوكيل.
- التقييم يفحص ما فعله الوكيل. سكربت اختبار يفحص حالة البيئة بعد التشغيل، مثل ما إذا كانت الاختبارات ناجحة أو أن الملف الصحيح موجود. لا يزال بإمكانك مراجعة المسار، لكن الدرجة تأتي من الإجراءات التي اتخذها الوكيل والحالة التي تركها خلفه.
لمساعد السفر لدينا، قد توفر مهمة المعيار المرجعي للوكيل نظام حجز وهمياً وطلباً مثل "ألغت عاصفة رحلة المسافر إلى دنفر. أعد حجزها وانقل فندقه ليتوافق مع ذلك." بعد انتهاء الوكيل، سيتحقق سكربت الاختبار من سجلات الحجز في قاعدة البيانات.
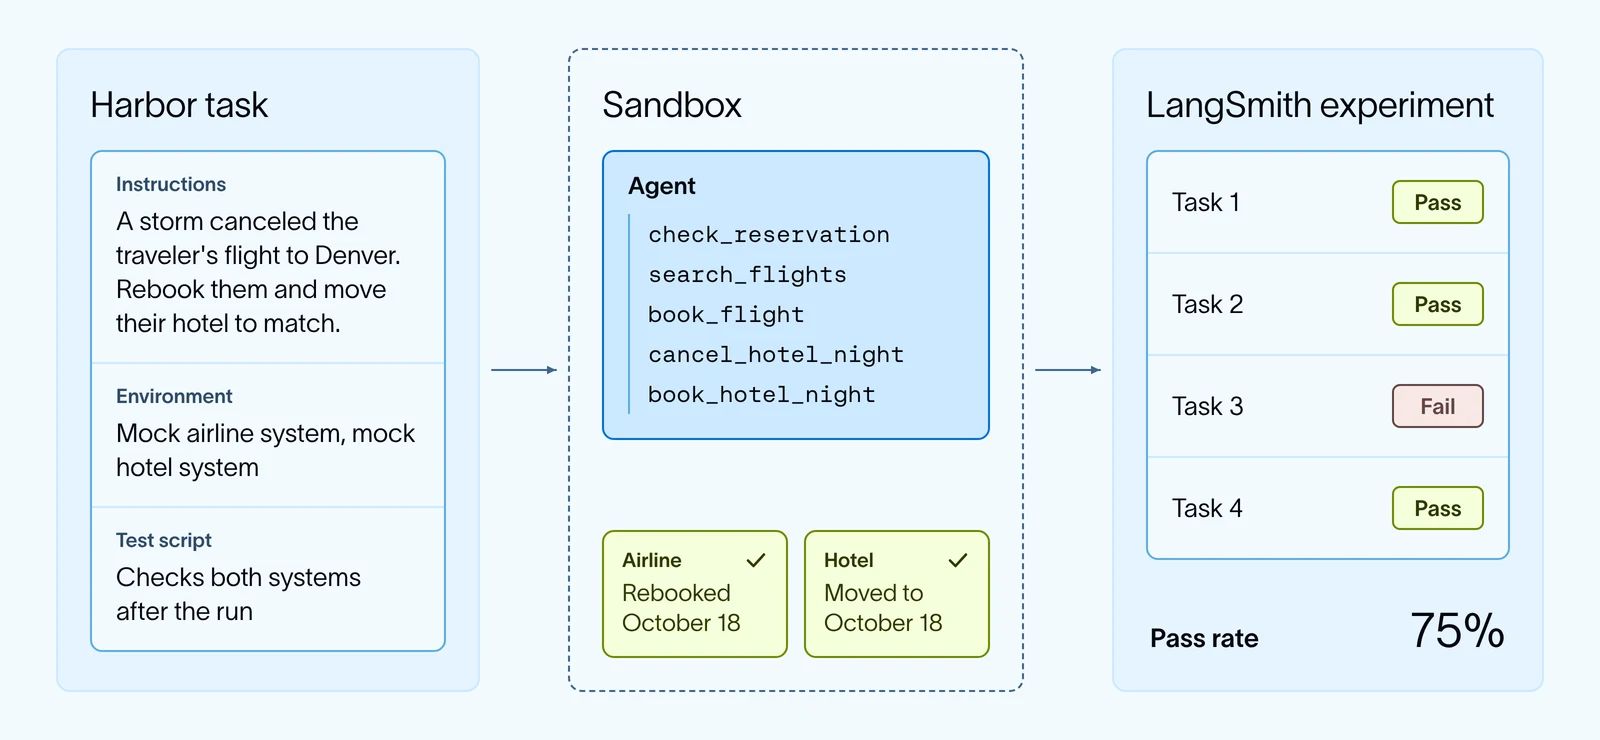
الميناء هو أداة تقييم مفتوحة المصدر توفر البنية الأساسية للاختبار على هذه المهام الأطول. وهو الإطار الذي يشغّل Terminal-Bench، ويمكنك استخدام نفس تنسيق المهام لبناء معيار تقييم لوكيلك الخاص. مع تكامل LangSmith، يُسجَّل كل تشغيل لـ Harbor كتجربة في LangSmith. ينشئ Harbor حاوية لكل مهمة، ويمكنك استخدام تتبعات LangSmith لجعل كل بيئة أقرب إلى ما يراه وكيلك في بيئة الإنتاج. ثم تظهر نتائج المعيار التقييمي إلى جانب بقية تقييماتك، ويمكنك فتح أي تشغيل لمشاهدة التتبع الكامل بجوار درجته.
استخدمنا هذا الإعداد لـ تحسين Deep Agents على Terminal-Bench 2.0 عن طريق مراجعة التتبعات للعثور على أنماط الفشل ثم تعديل أداة الاختبار. واستخدمناه أيضًا لبناء IssueBench, وهو معيار قياسي لـ LangSmith Engine. تمنح كل مهمة من مهام IssueBanch لـ Engine دفعة من السجلات (traces) وتقيّم ما إذا كان يجمّع السجلات الصحيحة في مجموعات المشكلات الصحيحة.
يتطلب بناء معيار مرجعي (benchmark) لوكيلك الخاص اتباع الخطوات نفسها المتبعة في التقييمات أعلاه، مع بعض التغييرات:
- اجمع المهام من الآثار (traces). ابحث عن حالات الفشل في آثار LangSmith، ثم حوّل كل واحدة منها إلى مهمة Harbor مع بيئتها الخاصة، مثل نظام حجز وهمي يحتوي على حجوزات المستخدم.
- حدّد كيف يبدو "الجيد". أنشئ قضاة LLM أو تقييمات قائمة على الشيفرة تُسجّل النقاط وفق معاييرك.
- اصعد التل (hill climb) على الدرجة. شغّل الوكيل واستخدم الدرجات لإجراء اختبارات A/B للتغييرات. يمكنك إعداد حلقة وكيلة تمر ب هذه العملية بالنيابة عنك، حيث تُجري تعديلات على وكيلك، وتعيد تشغيل المعيار المرجعي، وتحتفظ بكل تغيير أو تتراجع عنه، على غرار حلقة autoresearch الخاصة بـ Andrej Karpathy منذ بضعة أشهر.
كيف يمكنك تقييم حركة الإنتاج دون تكاليف مرتفعة؟
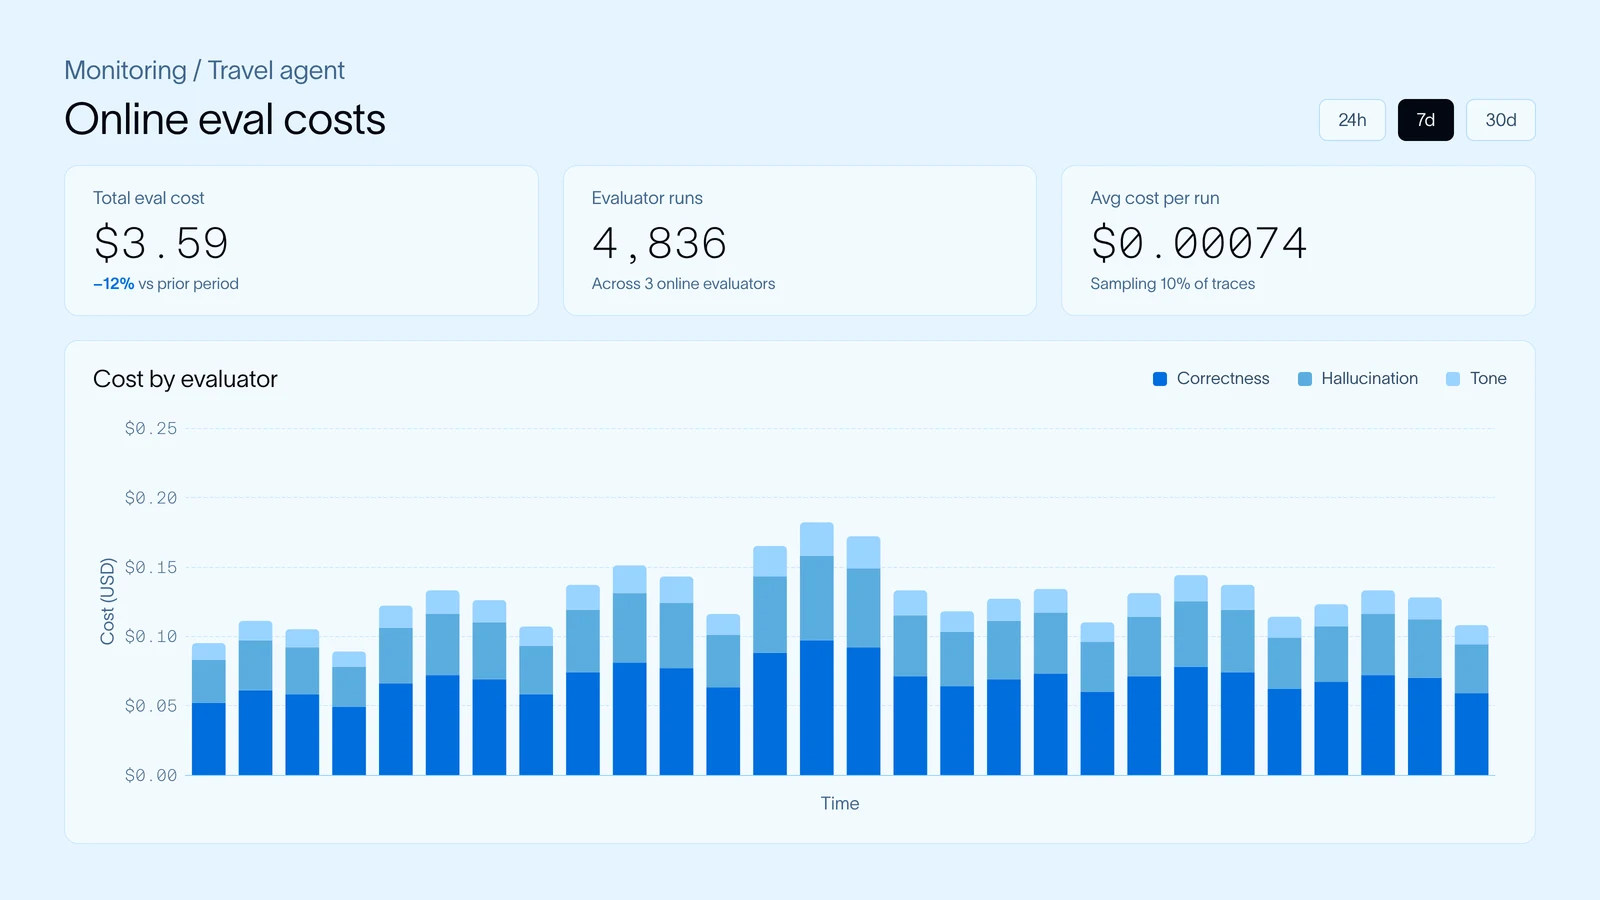
التقييمات دون الاتصال تعمل على مجموعة بيانات ثابتة، لذا فإن تكلفتها قابلة للتنبؤ. أما التقييمات عبر الإنترنت فتعمل على حركة مباشرة، فإذا سجّل قاضٍ LLM النقاط لكل أثر، ترتفع تكاليف التقييم مع كل مستخدم جديد. لإبقائها في المتناول:
- أخذ العينات والترشيح. المقيّمون عبر الإنترنت في LangSmith يمكنهم تسجيل النقاط لنسبة مئوية من حركة المرور، أو للآثار المطابقة لعامل تصفية فقط مثل ملاحظات المستخدمين السلبية.
- استخدم فحوصات الشيفرة حيثما أمكن. التحقق مما إذا كان الحجز مطابقًا للتاريخ المطلوب، أو مما إذا كان الوكيل قد بحث قبل الحجز، لا يكاد يكلف شيئًا.
- استخدم قاضيًا أرخص. في تجربتنا Jev-as-a-Judge طابَق Jev من TypeSafe AI التصنيفات البشرية في كل قرار نجاح/فشل وكلّف 0.34 دولارًا في المجموع، مقارنة بـ 28.17 دولارًا لـ Claude Sonnet 4.6.
تُحفظ تكاليف التقييم عبر الإنترنت بمرور الوقت في LangSmith، حتى تتمكن الفرق من مراقبة إنفاقها.
هل عليك أن تبني تقييمات الوكلاء الخاصة بك؟
لا، خاصة عندما تقوم بالتقييم لمشكلات الوكلاء الشائعة. نقطة بداية جيدة هي قوالب المقيّمات الجاهزة لـ LLM في LangSmith للفحوصات النمطية مثل الهلوسة أو تسريب البيانات الشخصية. أضف واحداً منها إلى مجموعة بيانات أو مشروع تتبّع وعدّل مطالبة ليتوافق مع وكيلك، مثل إخبار المُقيِّم بأن مساعد السفر لدينا لا ينبغي أن يحجز أبداً خارج ميزانية المستخدم.
حزمتنا مفتوحة المصدر agentevals تحتوي أيضاً على مُقيّمات جاهزة لرسائل الوكيل واستدعاءات الأدوات. يمكنها مقارنة الأدوات التي استدعاها وكيلك بقائمة مرجعية، أو مطالبة قاضٍ من نموذج لغوي كبير بالحكم على ما إذا كانت الخطوات منطقية.
يمكنك أيضاً إعادة استخدام مُقيّم غير متصل عبر مجموعات بيانات متعددة وتشغيله كمُقيّم متصل على الآثار الإنتاجية (لا يعمل ذلك إلا إذا كان المُقيّم لا يتطلب مخرجاً مرجعياً).
أما بالنسبة للتقييمات الخاصة بوكيلك، فإن Eval Engineering Skill يعمل في وكلاء البرمجة مثل Claude Code أو Codex، ويقرأ مستودعك وآثرك، ويكتب معك تقييمات قابلة للتشغيل.
LangSmith Engine يمكنه أيضاً كتابة تقييمات لك تلقائياً بالاستناد إلى الآثار الإنتاجية. عندما يحدد مجموعة من المشكلات، فإنه يحوّل الآثار الفاشلة إلى أمثلة في مجموعة البيانات ويكتب مخرجاتها المرجعية على شكل تأكيدات، مثل "يحجز رحلة طيران في التاريخ الذي طلبه المستخدم".
كيف تُقيّم المحادثات متعددة الأدوار؟
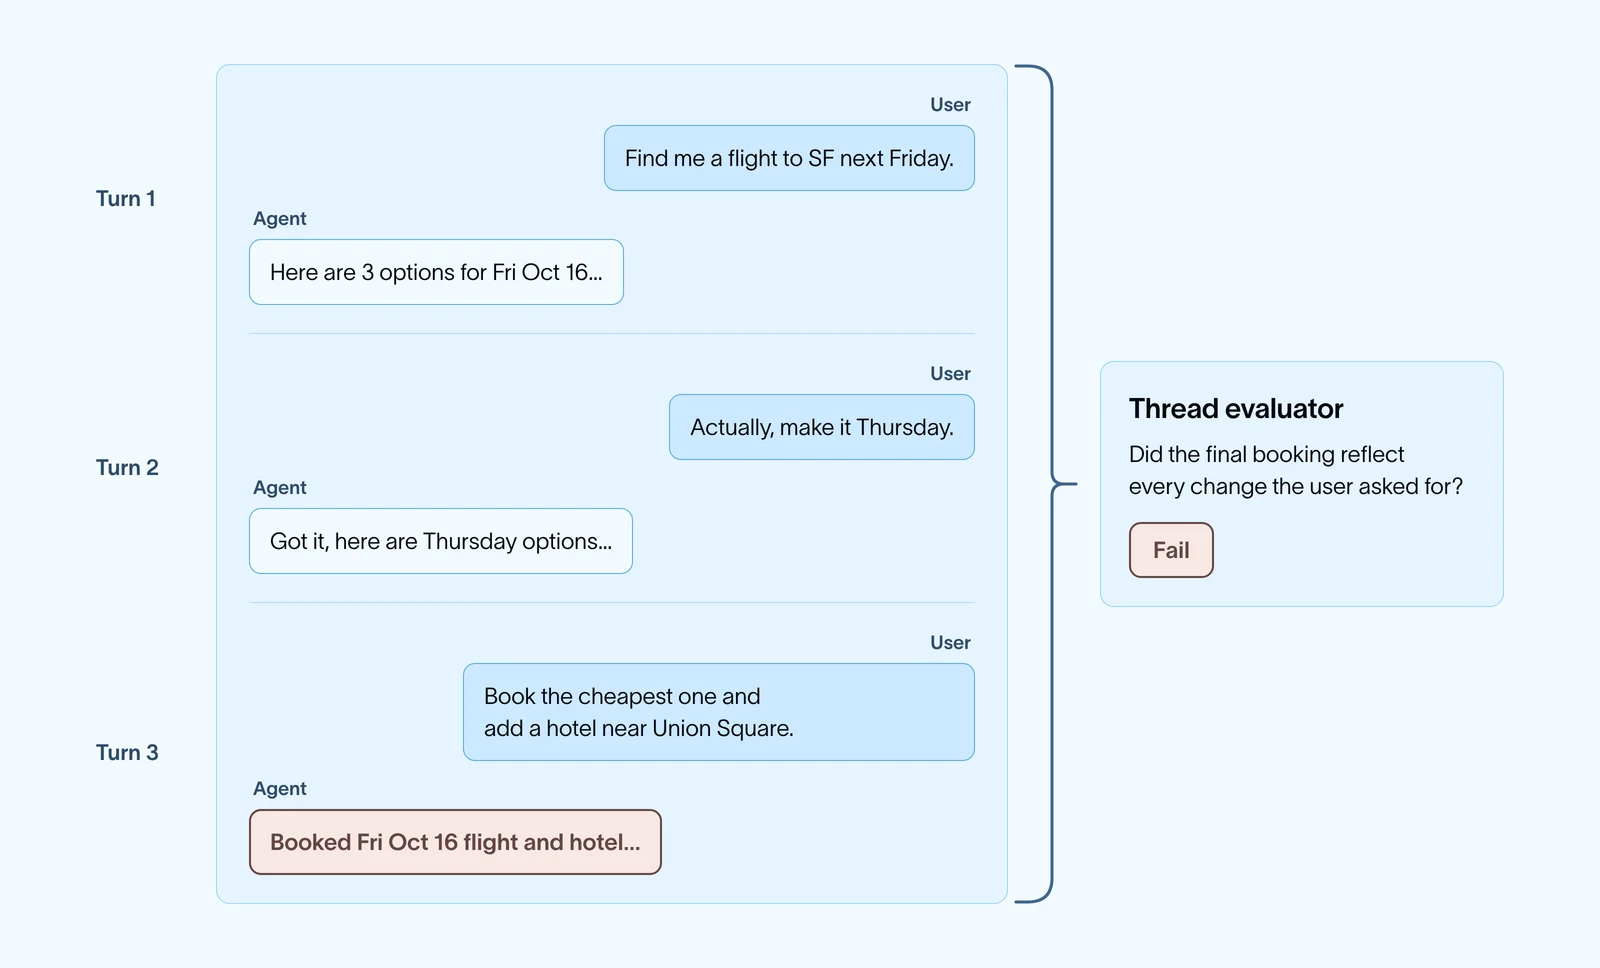
تعمل الكثير من الوكلاء عبر عدة أدوار. على سبيل المثال، قد يطلب المستخدم من مساعد السفر لدينا رحلات طيران، ثم يغيّر التاريخ، ثم يضيف فندقاً. قد يبدو كل دور على حدة سليماً في حين تخرج المحادثة ككل عن مسارها الصحيح.
لتقييم المحادثات في LangSmith، مرِّر معرّف سلسلة (thread ID) في بيانات التتبع الوصفية (trace metadata) حتى تُجمَّع كل دورة في سلسلة. السلسلة هي تسلسل من عمليات التتبع من نفس المحادثة. من هناك يمكنك إرفاق مقيّمين عبر الإنترنت يعطون درجة للسلسلة بأكملها بمجرد انتهاء المحادثة، بأسئلة مثل "هل عكست عملية الحجز النهائية كل التغييرات التي طلبها المستخدم؟" أو "هل اضطر المستخدم إلى تكرار ما يقوله؟" كما يعرض LangSmith كل سلسلة كـ مسار، مع سرد كل رسالة وكل استدعاء أداة مرة واحدة، بالترتيب.
للتقييمات دون الاتصال (offline evals)، يمكنك تخزين المحادثات الكاملة كأمثلة في مجموعة بيانات، أو محاكاة المستخدم بنموذج LLM بحيث تختبر كيفية تعامل الوكيل مع محادثة من البداية إلى النهاية.
كيف تقيّم وكيلًا يتجاوز مخرجاته النهائية؟
تتخذ الوكلاء خطوات كثيرة، لذا لا تُظهر الإجابة النهائية سوى جزء مما حدث. إلى جانب الاستجابة النهائية، قد ترغب في التحقق من:
- المسار، أي تسلسل الرسائل واستدعاءات الأدوات الذي أنتجه الوكيل.
- الحالة النهائية، مثل سجل الحجز الذي أنشأه وكيل السفر لدينا، أو ملف كتبه، أو تغيير أجراه في مستودع برمجي.
مع ازدياد تعقيد وكلاء الإنتاج لديك، قد تحتاج إلى إطار تقييم مخصص. وعلى وجه التحديد، عندما يكون عمل الوكيل هو التغيير الذي يُجرِه في بيئة ما. لنقل إن وكيل برمجي طُلب منه إصلاح خطأ برمجي. يمكن لقاضٍ LLM قراءة رد الوكيل، لكن الفحص الموثوق هو تشغيل اختبارات المستودع بعد انتهاء الوكيل. ولكي يعمل ذلك، يحتاج كل تشغيل اختبارات إلى نسخته النظيفة الخاصة من المستودع حتى لا تؤثر التشغيلات على بعضها. يتيح لك Harbor إعداد ذلك. يمكنك تشغيل وكلاء مُنشأين باستخدام Deep Agents في LangSmith Sandboxes وتسجيل كل تشغيل، مع تتبعه، في تجربة LangSmith. تعرّف على المزيد في Harbor x LangChain.
هل يمكنك تتبع وتقييم وكيل في LangSmith إذا لم يُبنَ باستخدام LangChain أو LangGraph أو Deep Agents؟
نعم! LangSmith محايد تجاه الأطر (framework agnostic)، لذا يمكنك تتبع وتقييم وكيل مُنشأ بأي إطار، أو حتى دون أي إطار على الإطلاق. هناك عدة طرق لإرسال التتبعات:
- تكاملات الأطر. يمتلك LangSmith تكاملات لأطر الوكلاء الشائعة مثل OpenAI Agents SDK, Claude Agent SDKوغيرها.
- غلاف مقدمي النماذج. إذا كنت تستدعي مقدم نموذج مباشرة، فغلف العميل الخاص بـ OpenAI أو Anthropic وكل استدعاء للنموذج يتم تتبّعه.
- الـ
@traceabledecorator. أضِفه إلى دوالّك الخاصة، مثل أداة البحث عن الرحلات في مساعد السفر، من أجل تتبّع أي خطوة من وكيلك.
بمجرد دخول آثار التتبّع إلى LangSmith، تعمل التقييمات بالطريقة نفسها لأي إطار عمل. يمكنك إضافة آثار التتبّع إلى مجموعة بيانات، وإجراء تجارب غير متصلة بالإنترنت عن طريق تمرير وكيلك إلى دالة SDK’s evaluate() ، وإرفاق مقيّمين عبر الإنترنت بحركة الإنتاج.
كيف تنتقل من منظومة تقييم قائمة؟
لست مضطرًا للبدء من الصفر. معظم ما بنيته بالفعل يمكن نقله إلى LangSmith:
- مجموعات البيانات. ارفع حالات الاختبار الحالية كملف CSV أو JSONL، أو أنشئها باستخدام الـ SDK.
- مقيّمات الكود. دالات التقييم الحالية عادةً ما تحتاج فقط إلى تغييرات طفيفة لتعمل كمقيّمات في LangSmith. إذا كانت تقييماتك تعمل بالفعل كاختبارات، فإن تكاملات pytest و Vitest تتيح لك الإبقاء على هذا الإعداد.
- قضاة LLM. الصق مطالبة القاضي الحالية لديك في مقيّم LLM-as-a-judge في الواجهة، أو احتفظ بها في الكود.
- التتبّع. يعمل LangSmith مع أي إطار عمل، لذا يمكنك إرسال آثار التتبّع من وكيلك الحالي دون إعادة كتابته.
كيف تُبلغ عن النتائج؟
تُظهر التجارب غير المتصلة ما إذا كان كل إصدار قد حقق تحسنًا. وتُظهر لوحات معلومات التقييم عبر الإنترنت كيف يستمر الأداء في الإنتاج مع مرور الوقت. في LangSmith، يمكنك مقارنة نتائج التجارب مباشرة وإنشاء لوحات معلومات مخصصة لمقاييس مثل تكلفة التوكنات وزمن الاستجابة ودرجات المقيّمين عبر الزمن. ويمنحك المعيار المرجعي درجة ثابتة لمقارنة النماذج أو إصدارات الوكيل عبر الإصدارات المختلفة.
التالي
إذا أردت التعمق أكثر، اقرأ كيف نبني تقييمات لوكلاء التعلم العميق (How We Build Evals for Deep Agents)، أو جرّب دليل البدء السريع لتقييم LangSmith، أو اطلع على دورتنا في LangChain Academy بعنوان أساسيات LangSmith.
تفضّل مدربًا مباشرًا؟ سأستضيف ورشة عمل افتراضية حول تقييمات الوكلاء في 28 أكتوبر 2026. سجّل هنا!