
باختصار
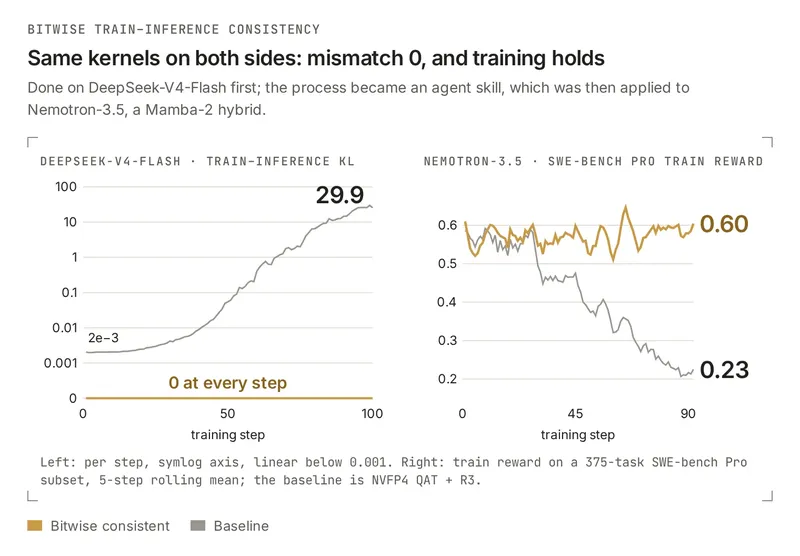
- المشكلة: التحسينات على جانب الاستدلال في التعلم المعزز عالي الأداء تغيّر الحسابات العددية، بحيث يُدرَّب النظام على سياسة غير تلك التي أخذت العينات. على DeepSeek-V4-Flash، ارتفع KL بين التدريب والاستدلال في خط الأساس عالي الأداء من 2e-3 إلى 29.9 بينما تراجعت المكافأة.
- المنهجية: يستدعي التمرير التدريبي (training forward) نوى الاستدلال (inference kernels) الخاصة بـ vLLM مباشرةً، وقد تم تعديل تلك النوى عالية الأداء بحيث ينتج كل من التوليد (rollout) والتدريب قيم logprobs متطابقة بتًا ببت (bitwise-identical) لكل رمز مُعيَّن (diff = 0).
- النتائج: على مدى أكثر من 100 خطوة تدريب لـ DeepSeek-V4-Flash، تكون القيمة diff هي 0 في كل خطوة عند 91.3% من معدل نقل البيانات (rollout throughput) الخاص بخط الأساس. وعند تطبيق ذلك على Nemotron (Mamba hybrid + NVFP4)، تحافظ النسخة المتسقة على نتيجتها في SWE-bench Pro بينما تنخفض نتيجة خط الأساس من 0.56 إلى 0.22.
- مفتوح المصدر: تم تجهيز العملية كمهارة وكيل (agent skill) وإطلاقها مع الوصفات والشيفرة البرمجية، مما يقلل تكلفة القيام بذلك على نموذج جديد.
- قيد التنفيذ: لقد وصل DeepSeek-V4.1 إلى 0 diff؛ يتم الانتهاء من عمل الأداء وسيحصل على مقال خاص به.
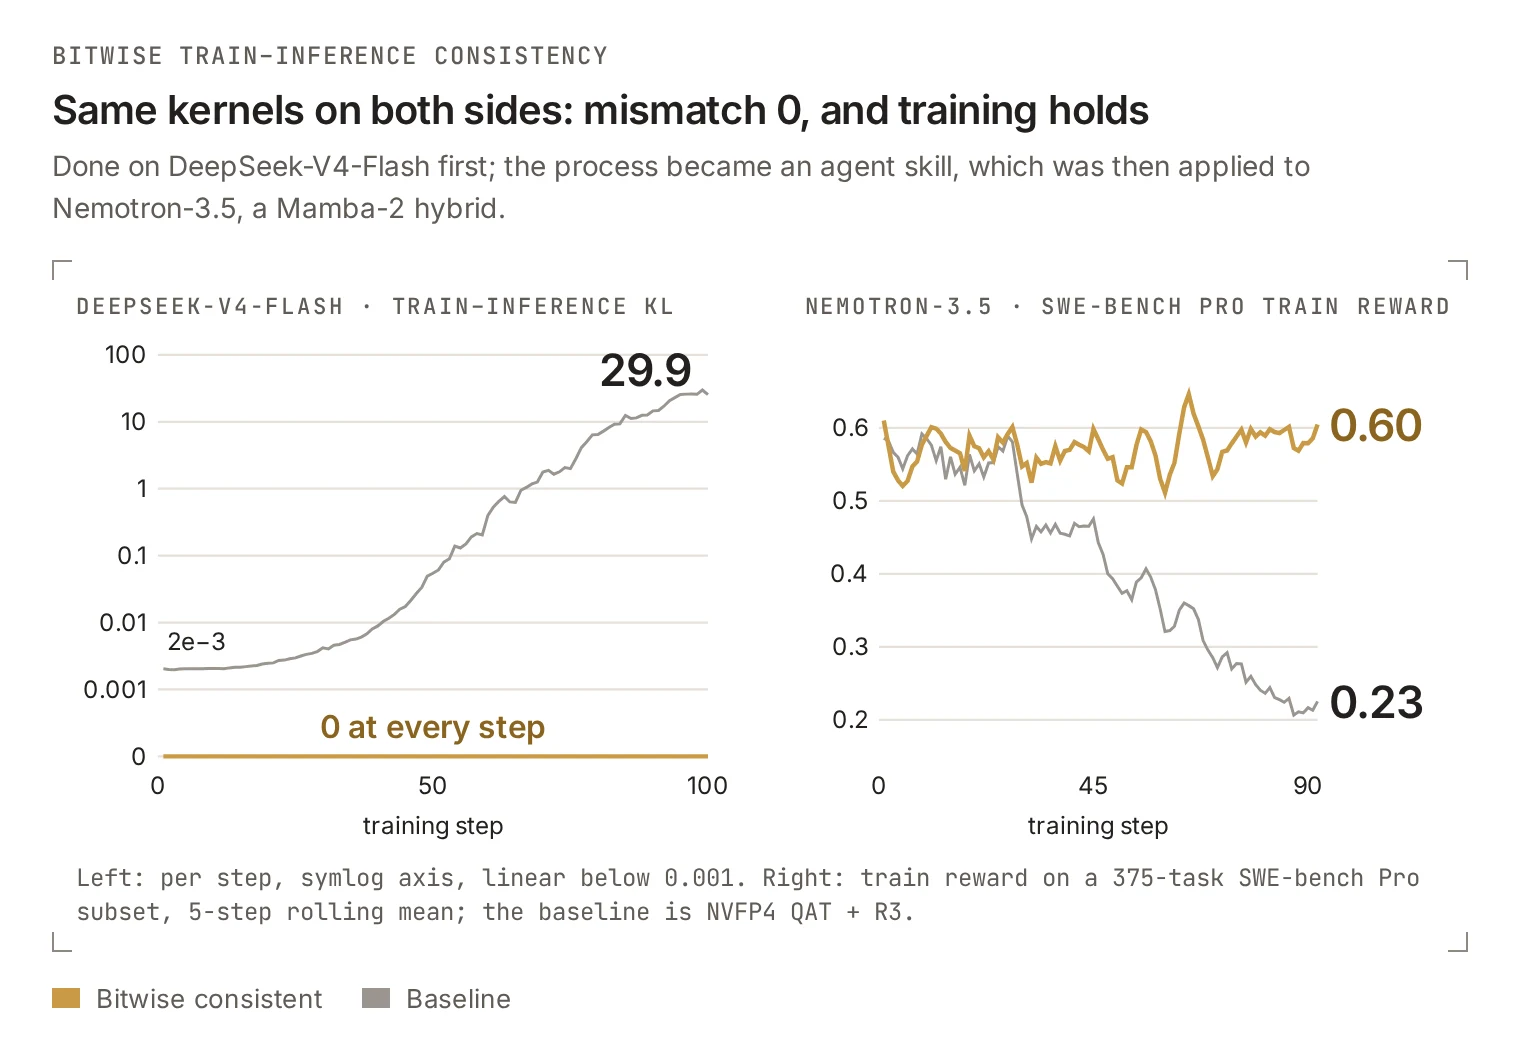
حقّق DeepSeek-V4-Flash قيمة 0 فرق أولاً؛ وأصبحت العملية مهارة وكيل، طُبّقت بعد ذلك على Nemotron-3.5 (نموذج هجين من Mamba-2). على اليسار: KL بين التدريب والاستدلال في DeepSeek-V4-Flash؛ إذ يصعد خط الأساس من 2e-3 إلى 29.9 بينما تظل التجربة المتسقة 0 عند كل خطوة. على اليمين: درجة التدريب لـ Nemotron-3.5 على SWE-bench Pro (متوسط متحرك من 5 خطوات)؛ حيث تظل التجربة المتسقة حول 0.6 بينما يهبط خط الأساس إلى 0.23.
تستغرق عملية Rollout الجزء الأكبر من وقت تدريب RL، لذا تعتمد أنظمة التدريب على الحسابات منخفضة الدقة، وذاكرة KV cache منخفضة الدقة، وتحسينات في الاتصال والنوى البرمجية (kernels). هذه التغييرات تؤثر على الأرقام في جانب الاستدلال (inference). محرك الاستدلال يولّد استجابة، ثم يعيد محرك التدريب حساب احتمالاتها ويحدّث النموذج. وباستخدام أوزان متطابقة، يقوم الجانبان الآن بإسناد احتمالات مختلفة لنفس الرمز (token)، وبالتالي يُحسّن التدريب سياسة غير تلك التي أنشأت العينات. وقد تتسع هذه الفجوة مع التحديثات وتزعزع استقرار التدريب. في تجربتنا على DeepSeek-V4-Flash-Base (دون أي تصحيح خوارزمي مثل TIS)، ارتفع KL بين التدريب والاستدلال في خط الأساس عالي الأداء من 2e-3 إلى 29.9 بينما تراجعت المكافأة.
تعني عملية التدريب غير المستقرة المزيد من الانهيارات والتراجعات وإعادة التشغيل، وحصة أصغر من التدريب الفعال، ووقتًا إجماليًا أطول للوصول إلى النتيجة نفسها. هدفنا هو إنهاء التدريب الفعّال على RL بشكل أسرع: من خلال تقليل الأعطال وإعادة التشغيل، الوصول إلى نتيجة في وقت أقل من البداية إلى النهاية.
نهجنا: على المسار الرقمي عالي الأداء، ينتج التدريب والاستدلال logprob متطابقة bitwise لكل رمز مُعيَّن (diff = 0؛ يعرفها القسم 2 بدقة)، وهو ما يمثل RL على السياسة الحقيقية (true on-policy RL). نصل إلى ذلك عن طريق جعل نداء التمرير الأمامي للتدريب يستدعي نوى الاستدلال في vLLM مباشرةً وتعديل تلك النوى عالية الأداء بحيث لا تتغير النتائج مع تكوين الدفعة، أو مرحلة prefill أو decode، أو التخطيط التوازي (القسمان 3 و4). ثم تقوم مهارة وكيل (agent skill) بخفض تكلفة تطبيق ذلك على نموذج جديد وتجعل العملية قابلة للنقل: فهي تخبر الوكيل كيف يجد أول مُعامل تنحرف عنده الجهتان، ويختصره إلى حالة إعادة إنتاج دنيا، ويصلحه ويعيد تشغيل اختبارات الانحدار. على DeepSeek-V4-Flash نصل إلى diff بقيمة 0 عند 91.3% من معدل نقل rollouts الخاص بالخط الأساس عالي الأداء، ونقلنا المنهجية إلى Nemotron، وهو هجين Mamba مع NVFP4.
تقيس هذه التدوينة الاتساق الرقمي، ومنحنيات التدريب، ومعدل نقل rollouts. المكسب من البداية إلى النهاية يأتي من انخفاض الأعطال وإعادة التشغيل، وهو ما يظهر فقط في الجلسات الطويلة؛ تلك المقارنة بزمن الحائط تُترك لوقت لاحق. أيضًا، لم يكن أيٌّ من الخطّين الأساسيين مضبوطًا أو مستكشفًا بعناية: كلٌّ منهما شغّل تكوينًا واحدًا، مع R3 لكن دون تصحيحات خوارزمية مثل TIS أو MIS. حالات انهيار الخط الأساسي المعروضة هنا تعكس هذه الوصفة فقط؛ مع الضبط، قد لا ينهار الخط الأساسي بهذه السهولة.
1. النهج الحالية: كيف تقايض بين الثلاثة
إنهاء التدريب الفعّال على RL بشكل أسرع يتطلب ثلاث خصائص في آن واحد:
- A، الأداء العالي: rollout وتدريب سريعان، مع إمكانية استخدام الحسابات منخفضة الدقة، وذاكرة KV cache منخفضة الدقة، وتحسينات الاتصال جميعها;
- B، الاتساق العالي: أن يحسب التدريب والاستدلال السياسة نفسها للأوزان نفسها;
- C، التكلفة المنخفضة والعمومية: تحقيق A وB على نموذج جديد أو دقة جديدة أو عتاد جديد في وقت تطوير مقبول.
نادرًا ما تتماسك هذه العوامل معًا. إذا أقصيت B فقد حصلت على حرية التحسين لكن مع خطر عدم استقرار التدريب. وإذا أقصيت A أمكنك استخدام نواة (kernels) متسقة، لكن الاستدلال يصبح أبطأ بكثير (الأرقام في الجدول أدناه). أما الإبقاء على A و B معًا يعني المواءمة نموذجًا بنموذج ومعاملًا بمعامل، وبالتالي يفشل C.
عدم التطابق بين التدريب والاستدلال ليس أمرًا جديدًا؛ فالمناهج الحالية توازن بين A و B و C بطرق مختلفة:
| المنهج | ما يحافظ عليه | ما يتخلى عنه أو يدفع مقابله |
|---|---|---|
| التصحيح الخوارزمي: TIS، MIS، FlashREINFORCE، Score Centering | A و C: يترك محرك الاستدلال دون تغيير، مستقل عن النموذج، وسهل التبني منخفض التكلفة | B: يبقى الفرق العددي قائمًا؛ ولا يُحدّ إلا تأثيره على التحديث. التكاليف: التحيز، والعينات الملغاة، وصعوبة التصحيح المتزايدة كلما اتسعت الفجوة بسبب الدقة المنخفضة |
| R3 (توجيه خبير عبر إعادة تشغيل التمريرات / replay rollout expert routing) | A، إضافة إلى B لتوجيه MoE | يزيل فقط انقلابات التوجيه؛ وتبقى الفروق العددية الأخرى قائمة |
| QAT (يحاكي التمرير الأمامي في التدريب تقريب النشر) | A: النشر (rollout) يمكنه بأمان استخدام دقة منخفضة؛ ويقلص الجزء الناتج عن التكميم من الفرق (يحسّن B) | يجب أن يحاكي التدريب التكميم، وتستخدم المرحلة العكسية مقدّر المرور المباشر (STE: تعامل المرحلة العكسية التكميم كدالة هوية)؛ ومحاكاة الأوزان فقط تترك فروقات من التنشيطات وKV والأنوية (kernels) وعمليات التخفيض |
| محاذاة عددية صارمة (Thinking Machines، slime، IsoExec، هذا المنشور) | B | A أو C: الأنوية العامة الثابتة تجاه الدفعات تكلف A (حِمل عمل Thinking Machines: من 26 ثانية إلى 55 ثانية، و42 ثانية مع نويّة انتباه محسّنة)؛ والمحاذاة على المسار عالي الأداء تحافظ على A وتكلف C (slime، IsoExec، هذا المنشور: محاذاة وتحقق لكل نموذج ولكل مُعامل) |
التصحيح الخوارزمي يغطي عدة آليات:
- TIS (أخذ العينات بالأهمية المقتطع، Yao et al.): يوازن التدرج بنسبة الاحتمال بين التدريب/النشر، مع قطع عند حد أعلى، مقايِضاً قدراً بسيطاً من الانحياز بتباين محدود؛
- MIS (أخذ العينات بالأهمية المقنَّع، When Speed Kills Stability): بلا قطع؛ يُسقِط التسلسلات الكاملة التي تتجاوز نسبة الاحتمال على مستوى التسلسل عتبةً معينة؛
- FlashREINFORCE (Hu, Zhang et al.): للتعلم المعزز الوكيلي غير المتزامن؛ تصفية الانحراف على مستوى المسار (منطقة ثقة التسلسل) تزيل المسارات التي تنحرف بعيداً أكثر من اللازم؛
- Score Centering (Marek & Ryabinin): يُلغي انحراف التدريب-الاستدلال المتراكم مع كل تحديث عبر حد تصحيح جبري؛ ويُركَّب مع أخذ العينات بالأهمية.
تُقلِّل هذه الطرق من أثر عدم التطابق لكنها لا تزيله: عدم التطابق يحوّل التدريب على السياسة (on-policy) إلى تدريب خارج السياسة (off-policy) (Yao et al.)؛ وعندما يكون كبيراً ولديه مصادر متعددة، يصبح أخذ العينات بالأهمية على مستوى الرموز منحازاً ويصبح التدريب أكثر عرضة للانهيار (Li & Liu)؛ وفي P1-VL، لم يؤدِّ أخذ العينات بالأهمية المقتطع إلا إلى تأخير الانهيار. R3 (Rollout Routing Replay، Ma et al.) يسجّل توجيه الخبراء في النشر ويعيد تشغيله في التدريب، مزيلاً جزء انقلاب التوجيه فقط.
في الصف الأخير، يحقق Thinking Machines Lab تعلماً معززاً حقيقياً على السياسة بأنوية ثابتة تجاه الدفعات (Defeating Nondeterminism in LLM Inference) لتكلفة الاستدلال في الجدول، ومعظمها من تكامل FlexAttention الذي لم يُحسَّن جيدًا بعد؛ vLLM وTorchTitan يعيدون استخدام نوى forward الخاصة بـ vLLM في التدريب، ووصلت جولتهم المتسقة على مستوى البت (bitwise-consistent) إلى مكافأة أعلى في خطوات أقل؛ slime يوائم logprobs على معمارية GLM-5 (MLA + DSA، نفس بنية DeepSeek-V3.2)؛ و IsoExec من إعداد Alexander Jiang وفريق SkyRL يغطي الانتباه الخطي (القسم 6).
معظم هذه المقاربات قابلة للتركيب فوق بعضها: بعضها يستهدف الفرق العددي بين المحرّكات على نسخة أوزان واحدة، وبعضها الآخر يستهدف فرق السياسة بين نسخ الأوزان. في التدريب غير المتزامن، ما يخرج عن السياسة (off-policy) بسبب الأوزان القديمة يبقى يُعالج عبر TIS أو MIS أو Score Centering، لكن يمكن مع ذلك مواءمة المحرّكات عدديًا على تلك الأوزان، وتصبح الجولة المتسقة على مستوى البت خط الأساس لقياس هذه التصحيحات. كما ينتمي QAT إلى المواءمة الصارمة: لا تتطابق rollout والتدريب على مستوى البت في الدقة المنخفضة إلا إذا طبّق تمرير التدريب الأمامي نفس الكمّمة؛ ويستخدم backward لدينا طريقة STE.
نختار مسار الصف الأخير الذي يحافظ على A، بهذا المعيار بالنسبة لـ A: إنتاجية rollout لا تقل عن 70% من خط أساس عالي الأداء محسَّن بالمقدار نفسه (فإن rollout هو الجزء الأكثر استهلاكًا للوقت في تدريب RL؛ ولم تُقَس حملات جانب التدريب على حدة، انظر 3.2). أما C فهي نقطة الضعف في هذا المسار؛ ويغطي القسم 5 كيف يعوّض Agent + skill عنها.
2. ما تتطلبه الاتساق بين التدريب والاستدلال
في هذه التدوينة، diff هو الفرق، قبل كل تحديث بنسخة الأوزان نفسها وبادئة الرموز (token prefix) نفسها، بين logprob الذي تحسبه rollout لكل رمز صالح (الرموز المُعيَّنة داخل قناع الاستجابة) وold-logprob المعاد حسابه في جانب التدريب. يتطلب القبول أن يكون الحد الأقصى والمتوسط والانحراف المعياري لفرق كل رمز |p_rollout − p_train|، وKL بقيمة k3، جميعها تساوي 0 تمامًا. هذا تساوٍ تام، وليس عتبة، ويُفحص قبل كل تحديث؛ فتحديث mini-batch يغيّر السياسة على أي حال، وهو ما يستثنيه هذا التعريف. وينطبق ذلك على المهام التي قبولناها (الاستدلال الرياضي، استدعاء الأدوات متعدد الأدوار) وتخطيطات التوازي، بما فيها تخطيطات مختلفة لكل جانب.
«التدريب والاستدلال يحسبان الشيء نفسه» يتفكك إلى أربعة أبعاد مع عقد رقمي مشترك:
train-inference consistency ⇐ kernel determinism + batch independence + phase consistency + cross-GPU consistency + same numerical contract on both sides
حتمية النوى (GPU واحد). النواة نفسها على المدخل نفسه تعطي دائمًا الناتج نفسه. لا تضمن وحدات GPU ذلك افتراضيًا. مثال على ذلك ضرب المصفوفات split-K: ترتيب تجميع مختلف يعطي نتيجة مختلفة لأن جمع الأعداد العائمة ليس تجميعيًا.
استقلالية الدفعات. يجب ألا تعتمد نتيجة الطلب على بقية طلبات دفعته. أثناء الاستدلال، يدمج المحرك الدفعات ويقسمها ديناميكياً لزيادة الإنتاجية. وفي التدريب، فإن حجم الدفعة الصغيرة (micro-batch) والحزم (packing) وأعداد رموز MoE لكل خبير تغيّر المسار أيضاً. وتجعل مختلف التحسينات (اختيار النواة (kernel) حسب حجم الدفعة، وعدد التقسيمات الديناميكي) طلباً معيناً متعلقاً بغيره ضمن دفعته.
اتساق الطور. يجب أن يحصل الرمز (token) على النتيجة نفسها في مرحلة التعبئة المسبقة (prefill، رموز كثيرة دفعة واحدة) وفك التشفير (decode، رمز واحد في كل مرة). تمنح محركات الاستدلال كل طور أسرع نواة لديها؛ وإجبار مسار مشترك هو المصدر الرئيسي لبطء النسخة المتسقة وتركيز التحسين.
الاتساق عبر وحدات معالجة الرسوميات (GPU). يجب أيضاً تثبيت عمليات التقليص عبر وحدات GPU (AllReduce، وreduce-scatter، ودمج مخارج الخبراء بعد الـ all-to-all الخاص بـ MoE) على مستويين.
- مع التخطيط الموازي نفسه على الجانبين، يجب ألا تختلف نتائج الاتصال تبعاً للتوقيت والجدولة (بتثبيت خوارزمية مكتبة الاتصال، وتقسيم التقليص إلى أجزاء، ودقته، وترتيب دمج الخبراء).
- مع تخطيطات موازية مختلفة (مثل درجات TP/EP مختلفة)، يجب أيضاً أن تبقى النتائج نفسها مع تغيّر درجة التوازي، وهو ما يحتاج إلى شجرة تقليص ثابتة ويكلّف أكثر. وبدلاً من ذلك، تنقل وصفة DeepSeek-V4 عملية التقليص عبر وحدات GPU خارج المسار الخاضع للمقارنة (4.5).
يحمي كل بُعد من هذه الأبعاد ضد أحد سببين جذريين: ترتيب مختلف للعمليات (ترتيب الجمع أو التقليص الموازي يتبع الجدولة)، أو مسار حسابي مختلف (حيث يشغّل الجانبان، أو أشكال الدفعات المختلفة، أنوية أو فروعاً مختلفة). تحقيق فرق 0 يعني أولاً إزالة الفروقات الثابتة، ثم تثبيت اختيار المسار الديناميكي بحيث يتجاهل الحمل.
إلى جانب هذه الأبعاد الأربعة، يتطلب تحقيق diff = 0 بضعة أشياء إضافية:
- العقد العددي نفسه على الجانبين: التكميم والتقريب نفسيهما، ودقة الجمع نفسها، والحساب النووي نفسه. يمكن لمحرّكَين أن يستيفيا الأبعاد الأربعة كافة ومع ذلك يختلفا إذا حسبا بطريقة مختلفة.
- الخيارات المتقطعة نفسها: يحوّل Top-K وتوجيه MoE فرقاً صاعداً بمقدار أول واحد (ulp، وحدة واحدة في آخر منزلة لعدد فاصل عشري) إلى مجموعة رموز أو تركيبة خبراء مختلفة. وبمجرد تطابق المنبع، يجب أن تتطابق أيضاً قواعد كسر التعادل وترتيب المخرجات والدمج.
- 1 تحديث لكل خطوة (دفعة الخطوة تساوي الدفعة الصغيرة): عند وجود عدة تحديثات لدفعة صغيرة في كل خطوة، فإن أوزان التدريب تبدأ من التحديث الثاني تختلف عن أوزان أخذ العينات، وهو ما لا يغطيه diff = 0، فيتوقف التدريب عن كونه على السياسة (on-policy) بدقة صارمة (في مهمة رياضيات بعدد 4 تحديثات لكل خطوة، غيّر نحو 7% من الرموز تركيبة الخبراء بعد كل تحديث).
- انتشار عكسي واستعادة صحيحان: الأبعاد الأربعة تمنح انتشاراً أمامياً متسقاً فقط. ولا يزال يجب أن يكون الانتشار العكسي صحيحاً، وأن تظل الخطوة الأولى بعد الاستعادة من نقطة حفظ متسقة.
يستوفي كل عامل رئيسي في القسم 4 واحداً من هذه المتطلبات: تثبيت GEMM الكثيف اختيار النواة لاستقلالية الدفعات (4.1)؛ وتوحّد ذاكرة FP8 KV قراءات prefill وdecode لتحقيق اتساق الطور (4.2)؛ ويصلّح Top-K حالات التعادل والترتيب بحيث تتطابق الخيارات المتقطعة (4.3)؛ ويحافظ GEMM الخاص بالخبراء على عقد عددي واحد عبر تخطيطين (4.4)؛ وينقل التقليص عبر وحدات GPU خارج المسار الخاضع للمقارنة لتحقيق الاتساق عبر وحدات GPU (4.5).
diff = 0 يعني أن الجانبين يحسبان الشيء نفسه، لا أنه يناسب التدريب: عند وجود عدة تحديثات لكل خطوة، يتحقق diff = 0 بينما ينحرف التوجيه بين التحديثات. إن diff = 0 هدفنا الهندسي، وليس شرطاً كافياً لجودة التدريب، التي تحتاج إلى قبول منفصل.
3. الوصفة المرجعية: DeepSeek-V4-Flash
يجمع DeepSeek-V4-Flash بين الحساب منخفض الدقة، والانتباه المتناثر، والتوازي متعدد العقد للخبراء، ما يجعله تهيئة صعبة. من أساس FP8 درّبنا تشغيلَين من 100 خطوة على GB200: خط أساس محسّن عالي الأداء، ونسخة متسقة بفرق diff = 0.
المهمة: استدلال رياضي ببيانات بصيغة DAPO، مع GRPO ومكافأة تتضمن عقوبة تجاوز الطول (بحيث يمكن أن تكون سالبة). تستخدم كل دورة 8 أجهزة (32 وحدة GPU)، و128 موجهاً × 8 استجابات لكل خطوة، و1 تحديث لكل خطوة (دفعة الخطوة = الدفعة الصغيرة). لا تستخدم أي من الدورتين TIS أو MIS أو تصحيحات مشابهة، مما يكشف الفرق بين المحركين مباشرة.
التوازي: DP للبيانات، وEP للخبراء، وCP للسياق (تقسيم التسلسل)، وTP للموتر. تشغيل النسخة المتسقة للتوليد يستخدم 4 محركات vLLM، كل منها DP8/EP8، وTP=1؛ ويستخدم التدريب EP32، وCP4، وTP=1. يستخدم الجانبان تخطيطين موازيين مختلفين (4.5).
البنى ذات الصلة: MLA (آلية الانتباه الكامن متعدد الرؤوس، التي تضغط KV قبل التخزين المؤقت)؛ DSA (انتباه DeepSeek المتناثر: مفهرس خفيف الوزن يمنح درجات لpositions التاريخ، ويحتفظ Top-K بـ 2048 على الأكثر، ويقوم MLA بالانتباه إليها فقط)؛ ضاغط CSA (يضغط KV التاريخي في صفوف أقل)؛ mHC (الخلط عبر تيارات المتfon المتبقي، مع مصفوفة الخلط المُطبَّعة بتكرارات Sinkhorn)؛ و43 طبقة MoE. SM100 هو Blackwell (GB200 المستخدم هنا)؛ وSM90 هو Hopper.
3.1 القرار الجوهري: أنوية الاستدلال تحدد القيم، والتدريب يضيف فقط التمرير الخلفي
تتفق المحرّكتان بسهولة أكبر عبر تشغيل الشيفرة نفسها؛ والسؤال هو أي جهة تتكيّف. يهيمن Rollout على وقت التعلم المعزز (RL)، حيث تضبط كل عملية من أجل معدل النقل؛ ولو اعتُمد التدريب كمرجع لكان ذلك التنازل عن تلك التحسينات. وبالتالي، أنوية الاستدلال هي المرجع العددي: يستدعي التمرير الأمامي للتدريب أنوية vLLM نفسها لقيمه، ولا يضيف التدريب سوى التمرير الخلفي. ولا ينتقل الاستدلال أيضًا إلى أنوية عامة ثابتة الدفعات: بل يحتفظ بأنوية النشر عالية الأداء ويعدّلها لتحقق متطلبات القسم 2. وتتبع كل عملية في القسم 4 هذا المقايضة.
التحدي مع هذا القرار هو أن نوى الاستدلال (inference kernels) ليس لها backward، وكمّ FP8 ليس قابلاً للاشتقاق. لذا تتم معالجة forward وbackward بشكل منفصل، وقيم forward تأتي دائماً من نواة vLLM. كل وحدة (module) تُغلّف النواة في autograd.Function يشتق الـbackward الخاص بها بالنسبة إلى الأوزان الرئيسية BF16، مع اعتبار كمّ FP8 كعملية محايدة (مُقدّر المرور المستقيم، STE). يعيد الـbackward استخدام النوى الموجودة في الغالب: Transformer Engine BF16 GEMMs للطبقات الخطية وGEMMs الخبراء، وcuDNN frontend DSA backward للانتباه المتناثر، وDeepEP's backward للـall-to-all؛ فقط عوامل صغيرة مثل mHC وRMSNorm وSwiGLU لها مشتقات FP32 مكتوبة يدوياً. لبعض النوى المدمجة مخرجات لا يمكن اشتقاقها بهذه الطريقة (attention q/k، وKV المضغوط، وأوزان التوجيه، وlogprob النهائي)؛ لهذه نعيد تشغيل نفس الحساب في PyTorch فقط من أجل التدرّج ونحتفظ بقيم النواة: visible + (graph - graph.detach()). يتحقق كل backward أولاً من أن الأوزان الرئيسية لم تتغير منذ الـforward، حتى لا تخلط إعادة الحساب أو التحديثات غير المتزامنة بين إصدارات الأوزان.
كل التكاليف تنتقل إلى التدريب، من نوعين. الهندسة والتحقق: التدرّج هو بديل تقريبي، وليس مشتقة المشغّل المُكمّم الدقيقة، لذا فإن forward متطابقاً على مستوى البت لا يثبت شيئاً عن التدرجات، وتمارس المهارة (skill) التحقق من الـbackward مقابل مرجع مستقل (القسم 5)؛ الـbackward يجب أن يكون صحيحاً فقط، وليس حتمياً. كل نقطة دخول لتخطيط (مثل masked / contiguous في 4.4) تحتاج أيضاً إلى تحقق خاص بها. الأداء والذاكرة: يجب أن يحفظ forward في التدريب مدخلات ومخرجات نوى الاستدلال من أجل الـbackward؛ ضغط الذاكرة هو سبب تمكين الوصفة لإعادة الحساب الكاملة، التي تشغّل الـforward مرتين.
3.2 النتائج ومن يدفع
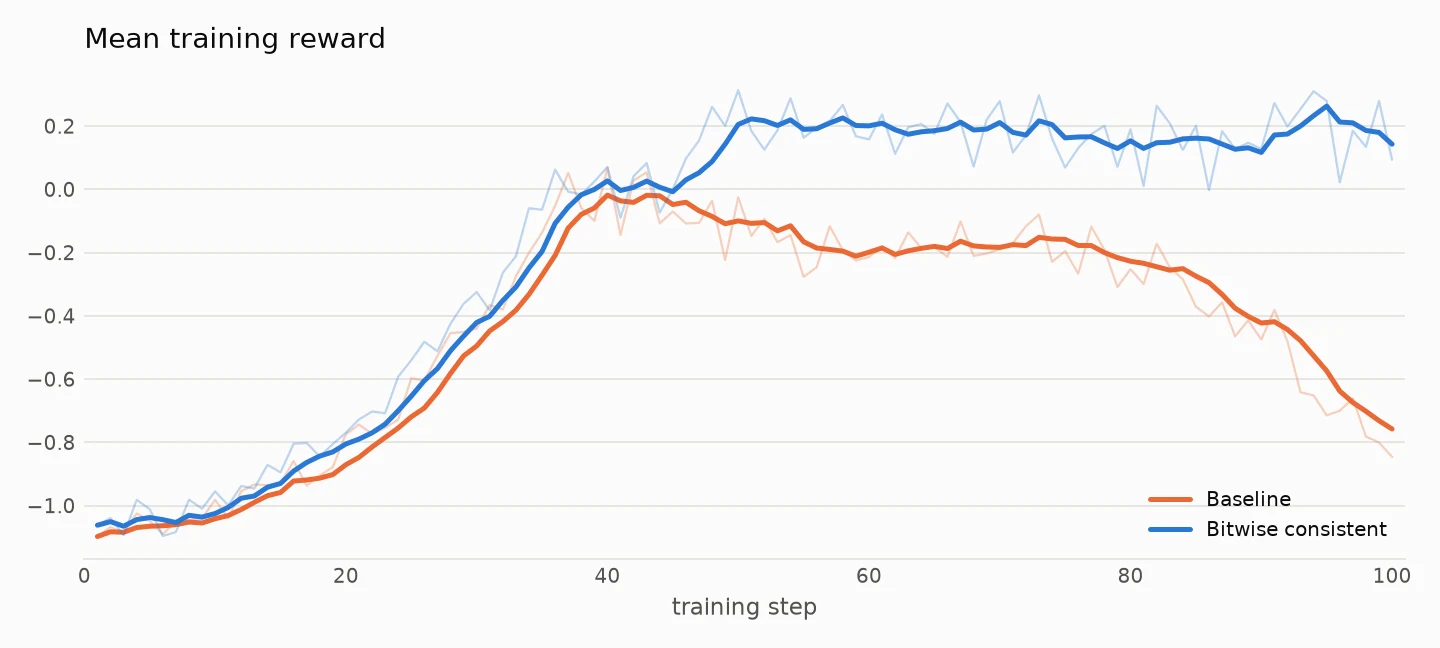
مكافأة التدريب لكل خطوة. البرتقالي: خط الأساس؛ الأزرق: النسخة المتسقة. الخط السميك: المتوسط المتحرك للخطوة الحالية والـ4 خطوات السابقة؛ الخط الرفيع: القيمة الخام.
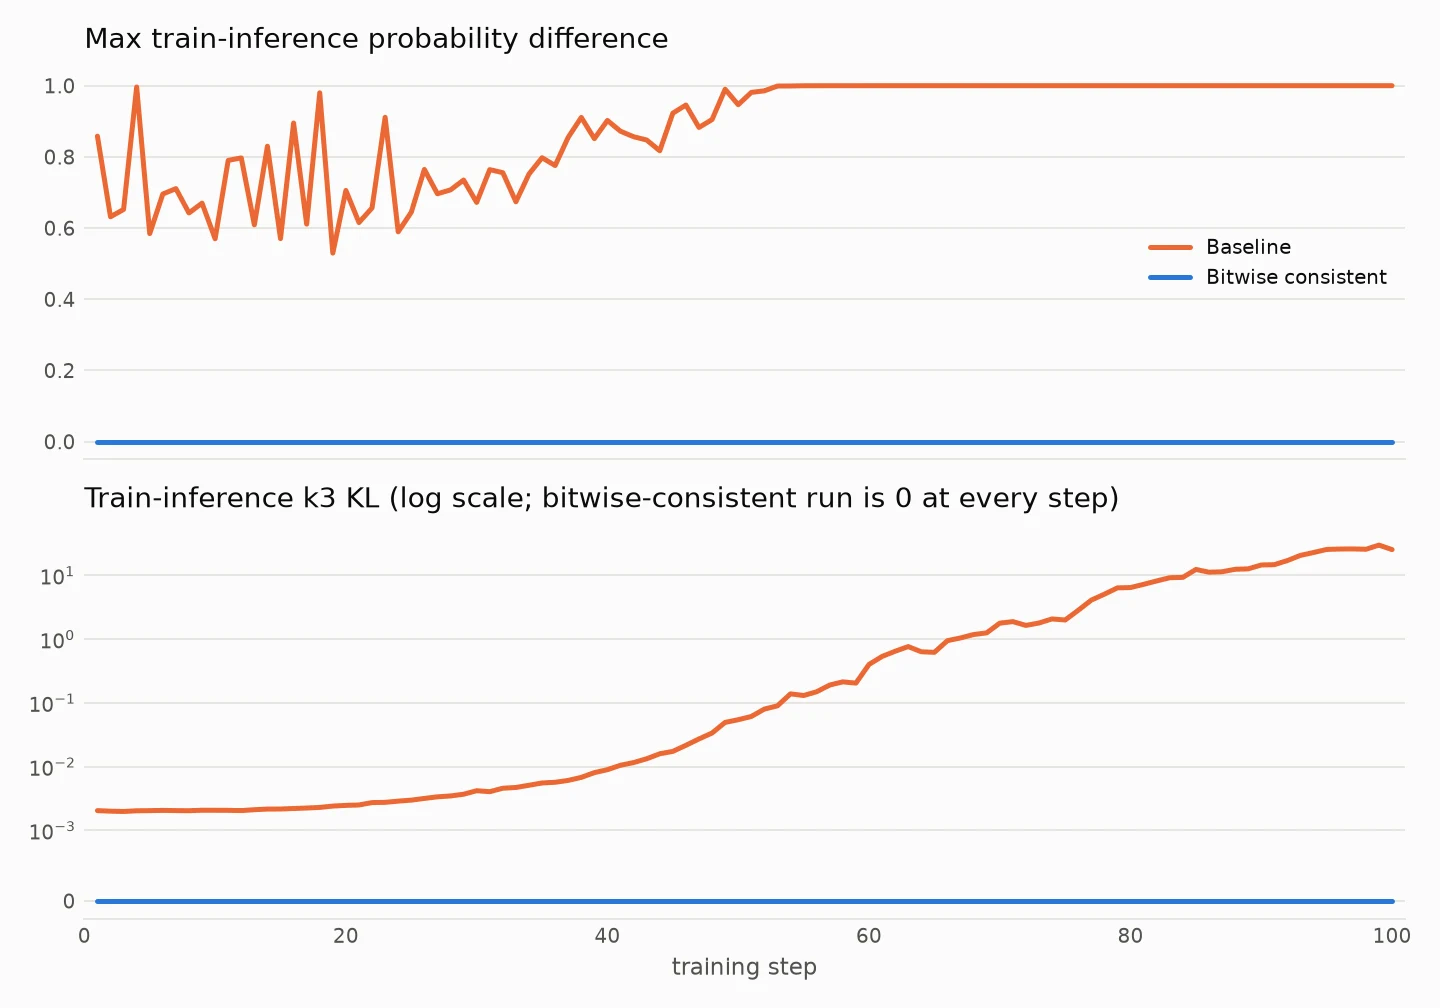
أعلى: أقصى فرق احتمال بين التدريب والاستدلال لكل خطوة؛ أسفل: KL بين التدريب والاستدلال (مُقدّر k3 r − 1 − log r، مستخدم في كل مكان؛ مقياس لوغاريتمي متماثل، خطي قرب الصفر). الفرق الأقصى يتفاعل مع انقلاب توجيه واحد أو تبديل Top-K واحد، لذا فهو كبير منذ خطوة 1 في خط الأساس؛ وKL يظهر المستوى العام. البرتقالي: خط الأساس؛ الأزرق: النسخة المتسقة. كلا مقياسي النسخة المتسقة يساوي 0 في كل خطوة.
على مدى 100 خطوة، يبلغ متوسط rollout للنسخة المتسقة 24.22 token/ms، أي 91.3% من خط الأساس (26.53):
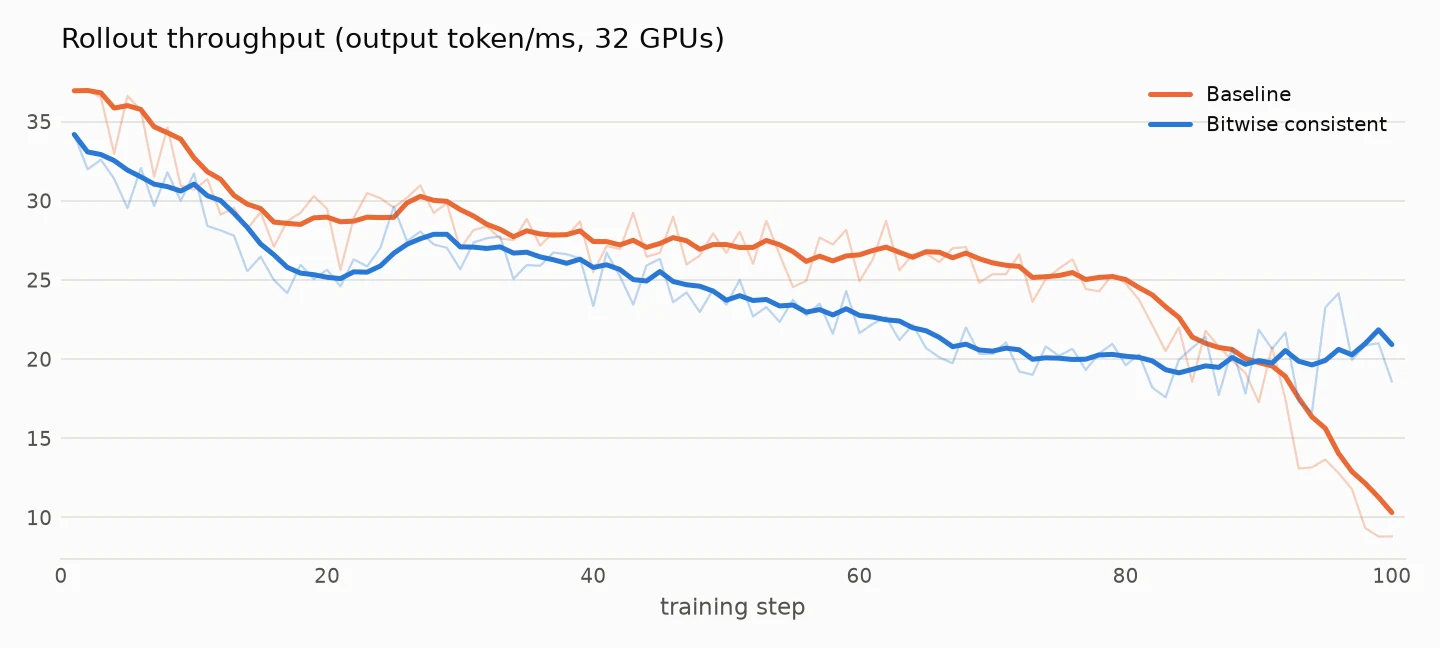
معدل نقل rollout لكل خطوة (token/ms للمخرجات، مجمّع على 32 GPU). البرتقالي: خط الأساس؛ الأزرق: النسخة المتسقة. الخط السميك: المتوسط المتحرك للخطوة الحالية والـ4 خطوات السابقة؛ الخط الرفيع: القيمة الخام.
تنمو KL بين التدريب والاستدلال في خط الأساس (من 2e-3 إلى 29.9) بينما تتراجع مكافأته؛ أما النسخة المتسقة تبقى عند فرق 0 وتبقى مكافأتها ثابتة. مكسب محتمل آخر هو forward واحد أقل: نعيد حساب old-logprob في كل خطوة فقط لقياس الفرق؛ بعد القبول، يمكن للتدريب استخدام logprob الخاص بالـrollout بدلاً منه.
جانب الـrollout، مقاساً في هذا التشغيل: متوسط معدل النقل هو 91.3% من خط الأساس (أقل بنحو 9%)، وهو أعلى من حد الـ70% في القسم 1. بعد الخطوة 90 ينخفض معدل نقل خط الأساس، مما يضخّم النسبة؛ وفي نفس الخطوات ينخفض متوسط طول الاستجابة لديه من نحو 3,000 إلى نحو 1,600 رمز (token). أول 89 خطوة تعطي 88.6%. تختلف أطوال الاستجابة بين التشغيلين طوال التدريب، لذا تعكس النسبة أيضاً أحمال عمل مختلفة، وليس المحرّكات فقط.
هذه الفجوة لم تُنسب بعد إلى مشغّلات؛ يشير القسم 4 إلى اتصال MoE LL والواجهة الخلفية، وجمع الانتباه (attention gather) وإزالة الكمّ (dequantization)، والإطلاق لكل طلب.
جانب التدريب، غير مقاس على حدة: وفق القسم 4، التكلفة هي إعادة كمّ أوزان FP8 في كل forward، والانتباه وTop-K التسلسليين لكل طلب، وإرسال إضافي واحد لبيانات وصف التوجيه، وإعادة الحساب الكاملة (3.1)، التي تشغّل الـforward مرتين.
معاينة PR منفصلة لوصفة verl على 32 GPU من نوع GB200 تُبلّغ عن تكلفة إجمالية تقارب 10%: الـrollout قريب من التكافؤ، والفجوة معظمها في التدريب. تحسين جانب التدريب هو الخطوة التالية.
4. مشغّلاً بمشغّل: الخيارات التقنية في وصفة DeepSeek-V4
كل قسم فرعي يغطي ما هو محفوظ، وما هو مُتخلى عنه، وكيف يُستعاد معدل السرعة، وما التكلفة المتبقية. أما النواة التي يستخدمها كل جانب لكل مشغّل، وكيفية كتابة الـbackward، فهي في المهارة (skill).
الجدول الرئيسي لكل مشغّل
تكمن التكلفة غالباً في اتصال MoE والواجهة الخلفية (4.4، 4.5)، ثم في جمع الانتباه وإزالة الكمّ (4.2، 4.3)؛ أما الكثيف (dense) فهو رخيص.
| الوحدة | المحفوظ | المتخلى عنه | التكلفة |
|---|---|---|---|
| GEMM الكثيف (4.1) | النشر W8A8 و DeepGEMM؛ ترتيب تجميع واحد لكل مخرج | فرع FlashInfer عند M<32، نواة بوابة الدفعات الصغيرة، نواة mHC المدمجة | rollout: لا توجد نواة أسرع للدفعات الصغيرة؛ التدريب: إعادة تكميم الأوزان في كل تمريرة أمامية |
| ذاكرة KV المؤقتة FP8 (4.2) | تخزين FP8 | نواة فك التشفير التي تقرأ FP8 مباشرة | rollout: تجميع إضافي وإلغاء تكميم في فك التشفير؛ التدريب: ذاكرة مؤقتة خاصة واحدة |
| Top-K (4.3) | DSA sparse attention | Default Top-K tie-breaking and output order | فرز إضافي واحد لكل جانب، يُسترد عبر الدمج (fusion)؛ عدة عمليات إطلاق prefill لكل طلب؛ التدريب: الانتباه وTop-K تسلسليان لكل طلب |
| Expert GEMM (4.4) | FP8 grouped GEMM; routing matches by construction, no R3 | FlashInfer TRT-LLM MoE | rollout: a main throughput gap; training: alignment padding |
| Cross-GPU reduction (4.5) | Different parallel layouts for training and rollout | TP>1 | الطرح (rollout): لا يمكن لاتصال LL أن يتداخل مع الحساب؛ التدريب: إرسال إضافي واحد لبيانات التوجيه الوصفية (routing-metadata) |
| CUDA Graph (4.6) | Graphs | Performance-only shortcut branches | Workspaces reserved at their upper bound |
| Others (embedding, RMSNorm, o_proj, lm_head + logprob) | Existing kernels, fixed reduction order | — | Small |
4.1 Dense GEMM: keep FP8, one accumulation order for every M
Kept. يُطرح DeepSeek-V4-Flash-Base بصيغة block-FP8، ومسار النشر هو W8A8 مع DeepGEMM. النسخة المتسقة تستخدمه في الجانبين: كل تمريرة أمامية في التدريب تُكمّم أوزان BF16 الرئيسية إلى block FP8 وفق قاعدة النشر وتستدعي GEMM الخاص بالاستدلال. كان الطرح بـ BF16 سيكلّف قوة حوسبة ونطاق ترددي؛ أمّا مخطط منفصل في جانب التدريب مثل MXFP8 فلا يقترب سوى من القيم العددية المنشورة، وهو قيد صف QAT في القسم 1.
Given up. يختار محرك الاستدلال النوى (kernels) حسب الشكل: الطبقة الخطية FP8 تستخدم FlashInfer عندما M<32 وDeepGEMM في غير ذلك؛ بوابة الموجّه تنتقل إلى نواة دفعات صغيرة عند 16 رمزًا أو أقل؛ وعدد التقسيمات في mHC يزداد مع عدد الرموز. الجمع في الفاصلة العائمة ليس ارتباطيًا، لذا يجعل كلٌّ منها نتيجة الطلب متوقفة على جيرانه. النسخة المتسقة تزيل هذه التفرعات: الطبقة الخطية FP8 تستخدم دائمًا DeepGEMM في وضع الثبات تجاه الدُفعات (batch-invariant)، وبوابة الموجّه تستخدم GEMM واحدًا بمخرجات FP32 عند كل حجم دفعة، وضربات BF16 المصفوفيّة الصغيرة تستخدم نواة Triton بترتيب جمع ثابت، ويُثبَّت تقسيم mHC عند 1. نوحّد على DeepGEMM بدلًا من FlashInfer لأن DeepGEMM يملك وضع batch-invariant، وهو أصلًا نواة النشر، وقيمة M في التدريب كبيرة.
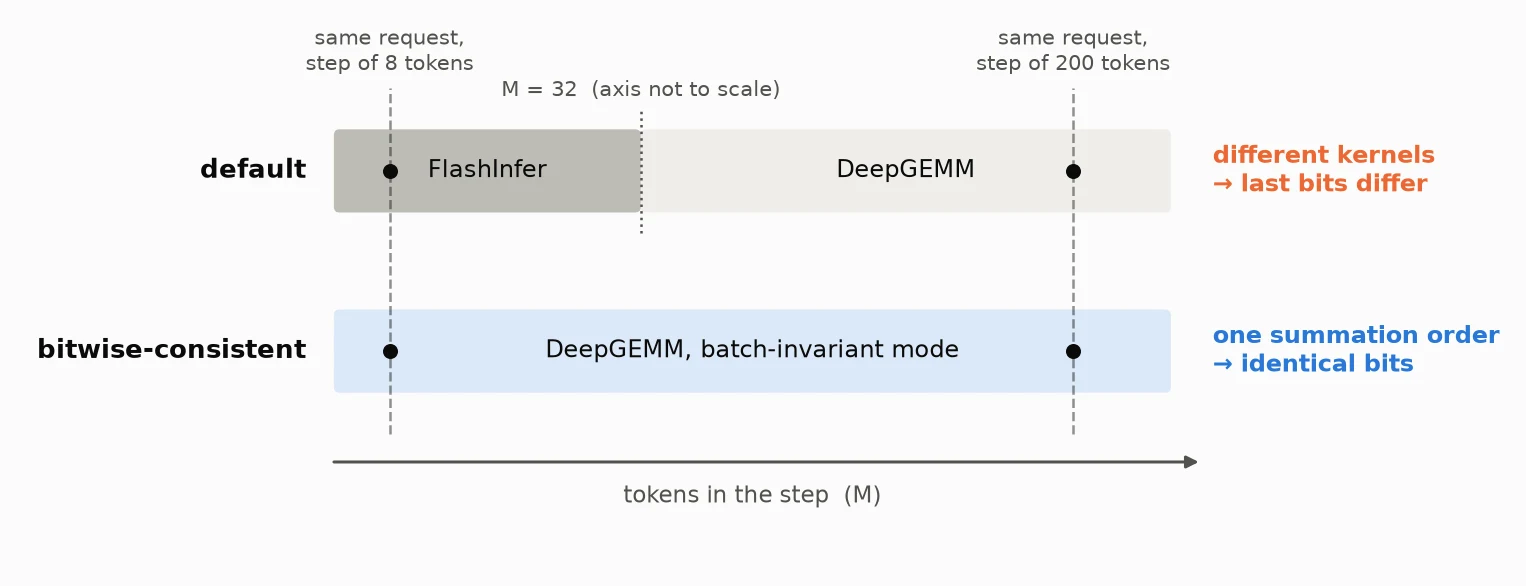
المحور الأفقي: الرموز لكل خطوة (تخطيطي). المسار الافتراضي يبدّل النوى عند 32، لذا الطلب نفسه في خطوة من 8 رموز وخطوة من 200 رموز يمر عبر FlashInfer وDeepGEMM ويختلف في الخانة الأخيرة. وضع batch-invariant له ترتيب جمع واحد.
Cost. يفقد الطرح (rollout) نوى الدفعات الصغيرة الأسرع ودمج mHC واحدًا، لكن Tensor Cores تبقى قيد الاستخدام. التدريب يعيد تكميم الأوزان في كل تمريرة أمامية، بما في ذلك إعادة الحساب؛ وإنشاء ذاكرة مؤقتة لأوزان FP8 يوفر ذلك الوقت مقابل نسخة مقيمة إضافية واحدة.
4.2 FP8 KV cache: keep FP8 storage, unify the read path
Kept. تُخزَّن ذاكرة KV المؤقتة بصيغة FP8، أي نحو 57% من BF16، وهو ما يحدد التزامن مباشرة. وكلا التشغيلين يتشاركان مسار الكتابة.
Given up. فك الترميز الافتراضي يستخدم نواة FlashMLA تقرأ FP8 مباشرة وتقسّم العمل حسب الدفعة؛ أما prefill فيزيل التكميم إلى BF16 ويشغّل الانتباه المتناثر (sparse attention). الطوران يشغّلان خوارزميتين مختلفتين، وتقسيم فك الترميز يعتمد على دفعته. النسخة المتسقة توجّه فك الترميز عبر مسار prefill: إزالة التكميم وجمع عناصر KV المختارة في مساحة عمل BF16، ثم استدعاء نفس flash_mla_sparse_fwd. مساحة العمل تكون لكل طلب ويُحدَّد حجمها فقط بحدود النموذج. يجب اختيار نواة فك الترميز هذه صراحةً؛ فمفتاح الاتساق وحده لا يغيّرها.
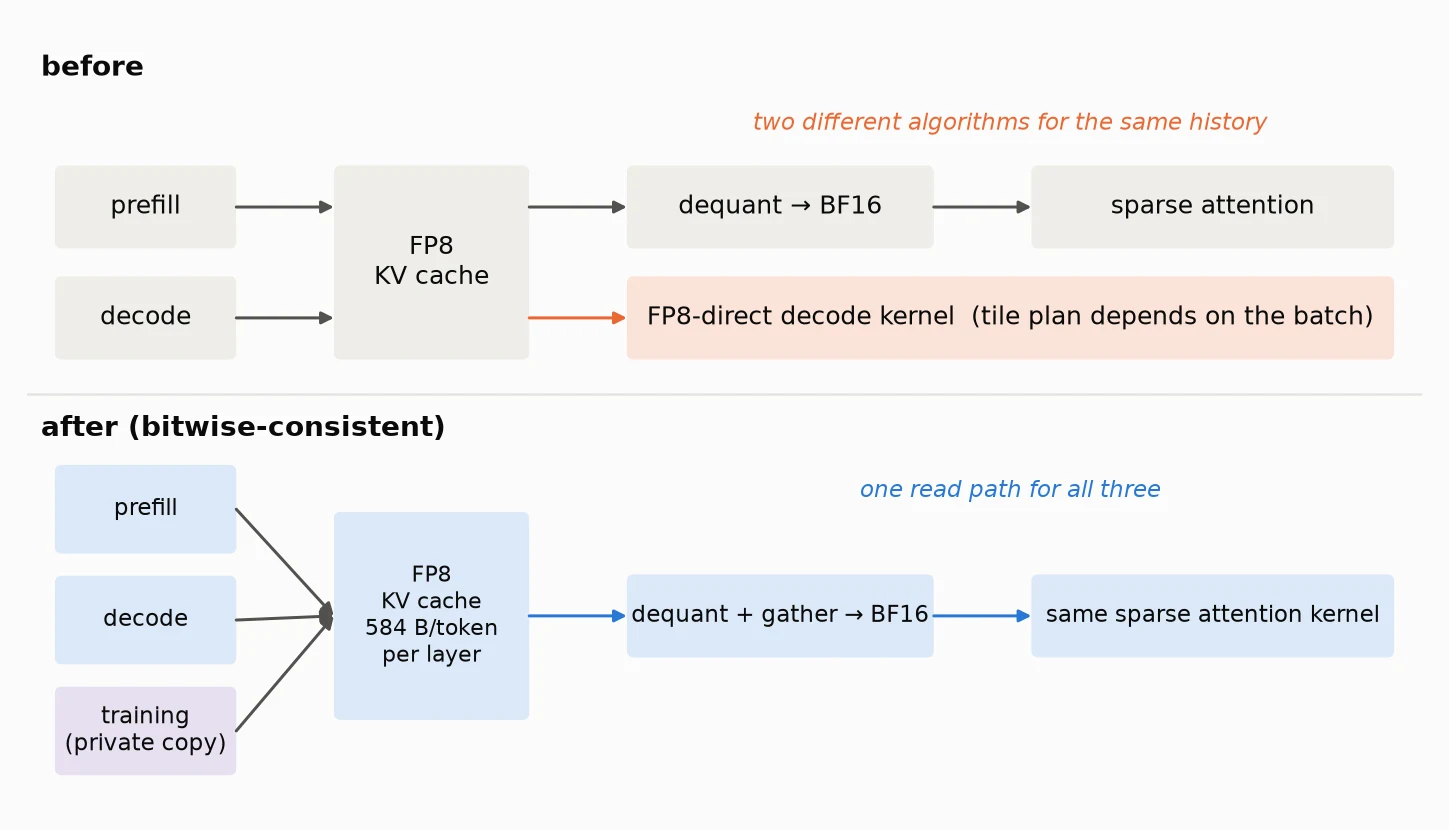
الأعلى: قبل التغيير، كانت التعبئة المسبقة وفك الترميز يقرآن نفس سجل FP8 بخوارزميتين، وكان تقسيم فك الترميز يعتمد على الدفعة. الأسفل: التعبئة المسبقة وفك الترميز والتدريب (مع نسخة خاصة من الذاكرة المؤقتة) يتشاركون مسار قراءة واحداً.
التدريب ليس لديه ذاكرة مؤقتة حقيقية، لكن يجب أن يمرّ K بنفس رحلة تقريب FP8: النواة المدمجة نفسها تكتبه في ذاكرة مؤقتة خاصة بـ FP8، ونفس عملية إزالة التكميم تقرأه مرة أخرى.
التكلفة. يضيف فك الترميز عمليتي التجميع وإزالة التكميم، ويضيف التدريب ذاكرة مؤقتة. هذا هو ثمن اتساق المراحل؛ ودقة التخزين لا تمسّ. يولّد كل طلب حالياً رمزاً واحداً في كل خطوة؛ التنبؤ متعدد الرموز (MTP) وفك الترميز التخميني غير مشمولين.
4.3 Top-K في الانتباه المتناثر: إصلاح حالات التعادل والترتيب
المشكلة. يقيّم مفهرس DSA كل موضع في السجل، ويختار Top-K في الغالب 2048 لآلية الانتباه. هذا الاختيار المنفصم يحوّل فرقًا بسيطًا بمقدار one-ulp في المنبع إلى سياق مختلف. أما تسجيل النقاط فهو متوافق أولًا: يستخدم المفهرس نفس نواة DeepGEMM، ويقرأ prefill الـ KV المتجاورة بينما يقرأ decode الـ KV المُقسّمة إلى صفحات، والقراءتان متطابقتان تمامًا على مستوى البت.
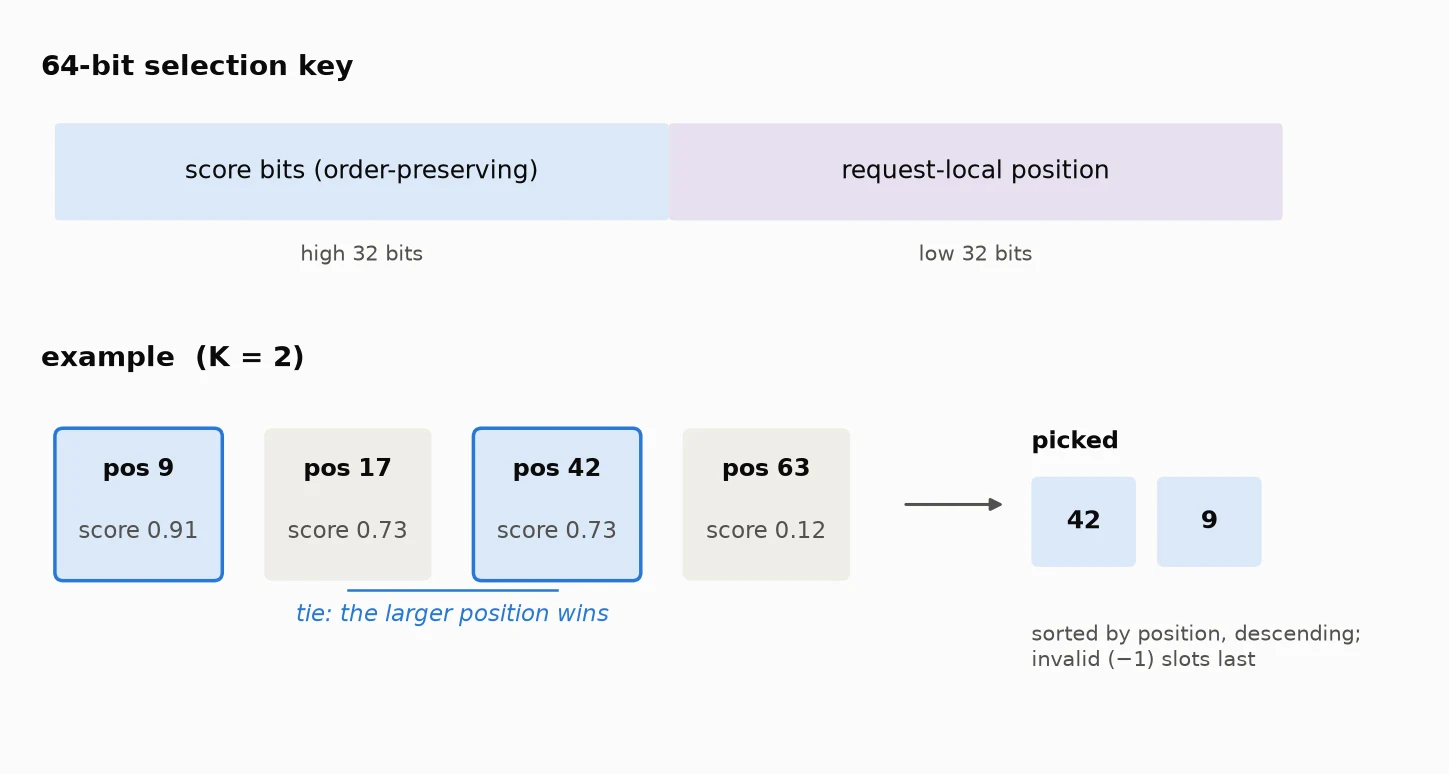
الأعلى: تخطيط مفتاح الاختيار ذي 64 بت. الأسفل: مثال بـ K = 2 حيث يتعادل الموضعان 17 و42 وتختار بتات الموضع في المفتاح الموضع 42؛ ثم يُرتَّب المواضع المختارة تنازليًا حسب الموضع، وتأتي الإدخالات غير الصالحة في النهاية.
تثبيت الاختيار والترتيب. يعالج Top-K الافتراضي حالات التعادل حسب جدولة الخيوط. أما النسخة المتسقة فتجمع الدرجة والموضع داخل الطلب في مفتاح فريد، بحيث تنحسم التعادلات لصالح الموضع الأكبر. وتستخدم الموضع داخل الطلب وليس الموضع العام في الدفعة؛ وإلا فإن تحريك طلب داخل الدفعة سيغيّر نتائج التعادل. مجموعة الاختيار نفسها ليست كافية: ترتيب الفهارس يحدد ترتيب التراكم في الانتباه، لذلك تُرتَّب الفهارس المختارة تنازليًا حسب الموضع، وتأتي الإدخالات غير الصالحة في النهاية.
البديل بنمط R3 يسجّل فهارس الـ rollout ويعيد تشغيلها في التدريب، لكن هذا يصل إلى 2048 فهرسًا لكل رمز لكل طبقة: بمقياس غيغابايت لكل تسلسل في الاستجابات الطويلة.
جانب التدريب. تختار المرور الأمامي للتدريب المواضع نفسها بنفس التسجيل ونفس Top-K، لكن المفهرس غير مُدرَّب، وذلك أساسًا من أجل البساطة. وهذا يتوافق مع الممارسات الحالية: DeepSeek-V3.2 تفصل مُدخل المفهرس عند تدريب DSA، فلا تصل خسارة RL إليه أبدًا، و GLM-5 تجمّد المفهرس افتراضيًا في RL.
التكلفة والاسترداد. يُجري كل جانب فرزًا إضافيًا واحدًا. يستغرق Top-K الحتمي نحو 5.9 ميكروثانية لكل استدعاء؛ ودمجه مع فرز الفهارس يرفع إنتاجية النسخة المتسقة في معيار الاستدلال بنسبة 6.7% (الإعداد في 4.4). التكلفة المتبقية هي إطلاقات متعددة لكل طلب في prefill.
4.4 GEMM الخبراء: تخطيطان، نتيجة صفّ واحدة
ما هو محتفَظ به. تسيطر GEMM المجمّعة بـ FP8 لخبراء التوجيه على طبقة MoE، ويغذّيها الجانبان بتخطيطين مختلفين. يستخدم rollout وضع DeepEP منخفض زمن الاستجابة (LL) (السبب: 4.5)، مما يعطي تخطيطًا مقنّعًا مقسّمًا إلى أجزاء حسب الخبير بسعة ثابتة لكل جزء. يعالج التدريب رموزًا كثيرة بوضع DeepEP العادي، مما يعطي تخطيطًا متجاورًا مُحزَّمًا حسب الخبير.
اختيار الواجهة الخلفية. يستخدم كلا الجانبين المتسقين DeepGEMM في وضع batch-invariant: فهو مفتوح المصدر، ويتوفر فيه وضع batch-invariant، وهو نواة النشر عالية الأداء. أما FlashInfer TRT-LLM MoE في الأساس الأساسي يُشحن كملفات cubins مجمّعة مسبقًا، لذا لا يمكننا تعديله أو التحقق مما إذا كان batch-invariant؛ وcutlass يفتقر إلى block-FP8، وtriton يقع في تنفيذ مُجمَّع لا يعلن ثبات الدفعة. تستغرق GEMM خبير واحد نحو الوقت نفسه في كليهما؛ والأساس الأساسي أسرع لأن TRT-LLM MoE يتراكب الاتصال مع الحساب في خط أنابيب متعدد التدفقات.
نتيجة صفّ واحدة من تخطيطين. يجب أن تنطبق ثلاثة شروط:
- يتلقى الخبراء نفس المُدخل FP8. يكمّي LL عند الإرسال بينما يكمّي الوضع العادي بعده، وكان في الأصل بتقريب مختلف؛ وقد وحّدنا كليهما على التقريب إلى الأقرب لكل عنصر.
- نتيجة كل صف مستقلة عن التخطيط. الكمّية لكل رمز، وDeepGEMM بنمط batch-invariant يراكم كل صف بطريقة ثابتة، لذا فإن نتيجة الصف لا تعتمد على جيرانه. تؤكد اختبارات الموجّه + MoE البتية ذلك.
- يُقرَّب التنشيط مرة واحدة. يُحسب SiLU(gate) × up بين عمليتي GEMM بـ FP32 ويُقرَّب الناتج فقط إلى BF16، ثم يُكمَّى إلى FP8. تقريب SiLU إلى BF16 قبل الضرب قد يختلف بمقدار ulp واحد، وهو ما يضخّمه الكمّ إلى FP8 في انقلاب رمز.
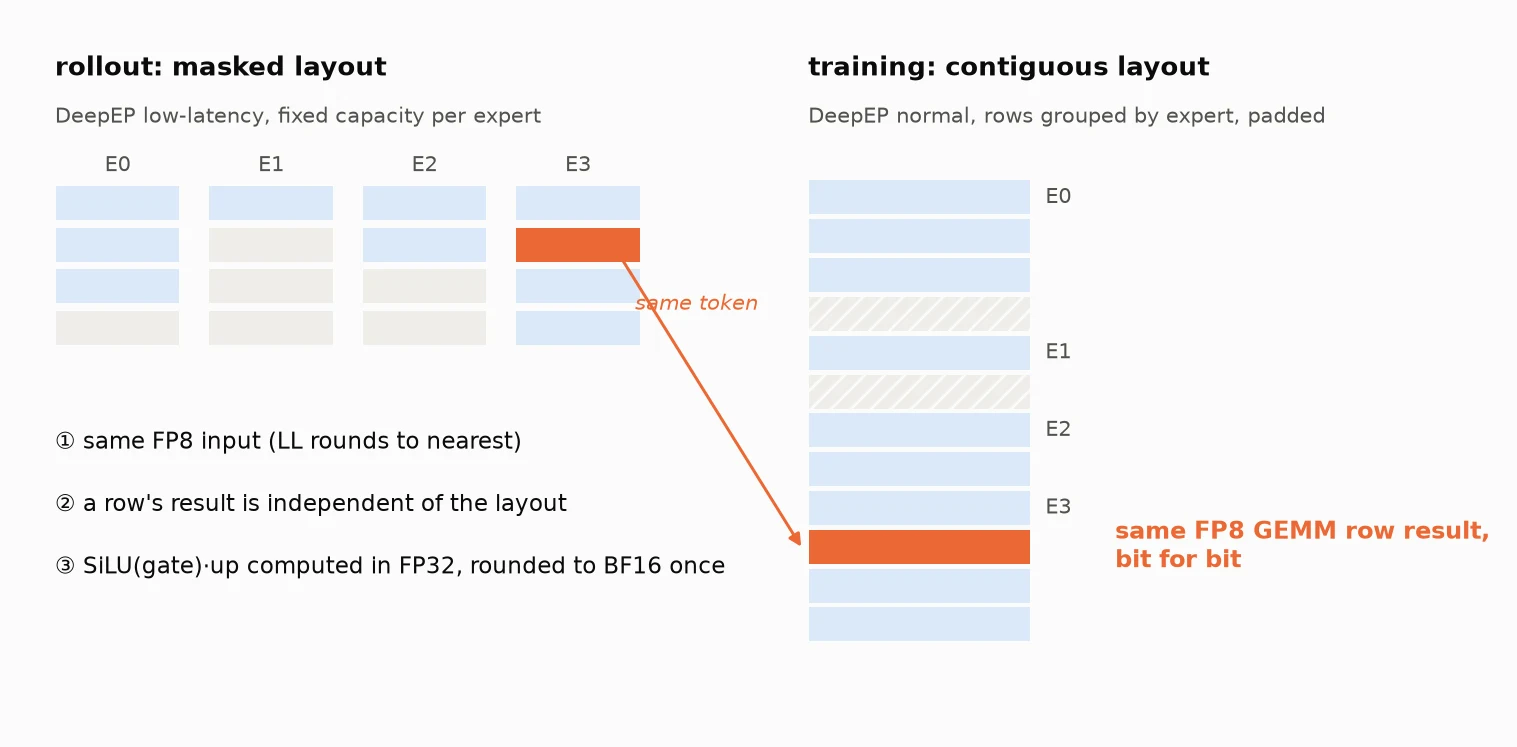
الرمز نفسه (برتقالي) يقع في مواضع مختلفة في التخطيط المقنّع للـ rollout والتخطيط المتجاور للتدريب، ومع ذلك تجعل الشروط الثلاثة نتيجة GEMM الخبير له متطابقة bitwise. الرمادي: خانات فارغة؛ التظليل المشطّب: حشو المحاذاة.
لا حاجة إلى R3. تستخدم GEMM لتسجيل درجات الموجّه نواة واحدة بمخرجات FP32 عند كل حجم دفعة على مُدخلات متطابقة bitwise، لذا فإن التوجيه المُعاد حسابه يطابق الـ rollout. يفترض هذا 1 تحديث لكل خطوة (القسم 2).
التكلفة. يتخلّى مسار Rollout عن TRT-LLM MoE، لكن GEMM ليست الجزء الأكبر من الفجوة. في معيار الأداء للاستدلال (GB200، DP8/EP8، تزامن 256، 150 إدخالًا / 3000 إخراج لكل طلب) كانت النسخة المتسقة تبدأ أبطأ بنسبة 33% من الخط الأساسي، نحو 83% منها يرجع إلى اتصالات LL غير القابلة للتداخل (4.5). يوفّر التدريب القيم الوسيطة للانتشار العكسي ويضيف حشوًا إلى صفوف كل خبير. أرقام معيار الاستدلال أدناه تأتي من مراحل تحسين مختلفة؛ قارنها فقط داخل الجملة نفسها.
قبل مقارنة الأداء، تأكّد أيضًا من أي نواة (kernel) يعمل بها الخط الأساسي: يفعّل vLLM نواة SiLU·mul·quantization الثابتة تجاه الدُفعات كلما كانت مكتبته المشتركة موجودة، متجاهلًا مفتاح الاتساق، لذا فإن أي صورة تتضمن هذه المكتبة تشغّلها في الخط الأساسي أيضًا.
4.5 الاختصار عبر وحدات المعالجة الرسومية: خارج المسار المقارَن
المشكلة. يريد Rollout زمن استجابة منخفضًا فيستخدم DP8/EP8؛ بينما يجب أن يستوعب التدريب تفعيلات التسلسلات الطويلة فيستخدم EP32 مع CP4. كما أشار القسم 2، تحتاج التخطيطات المختلفة إلى نتائج غير متأثرة بدرجة التوازي، وعادةً ذلك عبر شجرة اختصار ثابتة ومكلفة.
الخيار. هذه الوصفة تبقي الاختصار عبر وحدات المعالجة الرسومية خارج المسار العددي المقارَن، فيما ينقل الاتصال المتبقي البيانات دون تغيير القيم:
- TP=1. الطبقات الخطية لا تضمّ أي all-reduce. إذ يختار all-reduce في vLLM الخوارزميات بحسب حجم الرسالة، لذا فإن TP ستعيد هذه التبعية؛ لذا ترفض الوصفة TP>1 عند بدء التشغيل.
- دمج EP محلي. الـ all-to-all ينقل البيانات فقط. تعود مخرجات الخبراء إلى الرتبة المالكة للرمز وتُجمع بترتيب خانات top-k بـ FP32، بمعزل عن EP=8 مقابل 32 أو أي رتبة تجيب أولًا.
- CP لا يجري أي اختزال. تتبادل الرتب المتجاورة حالات الحدود المخفية فقط، وتُجمع KV المضغوطة بـ all-gather في مجموعة CP: دمج وليس جمعًا.
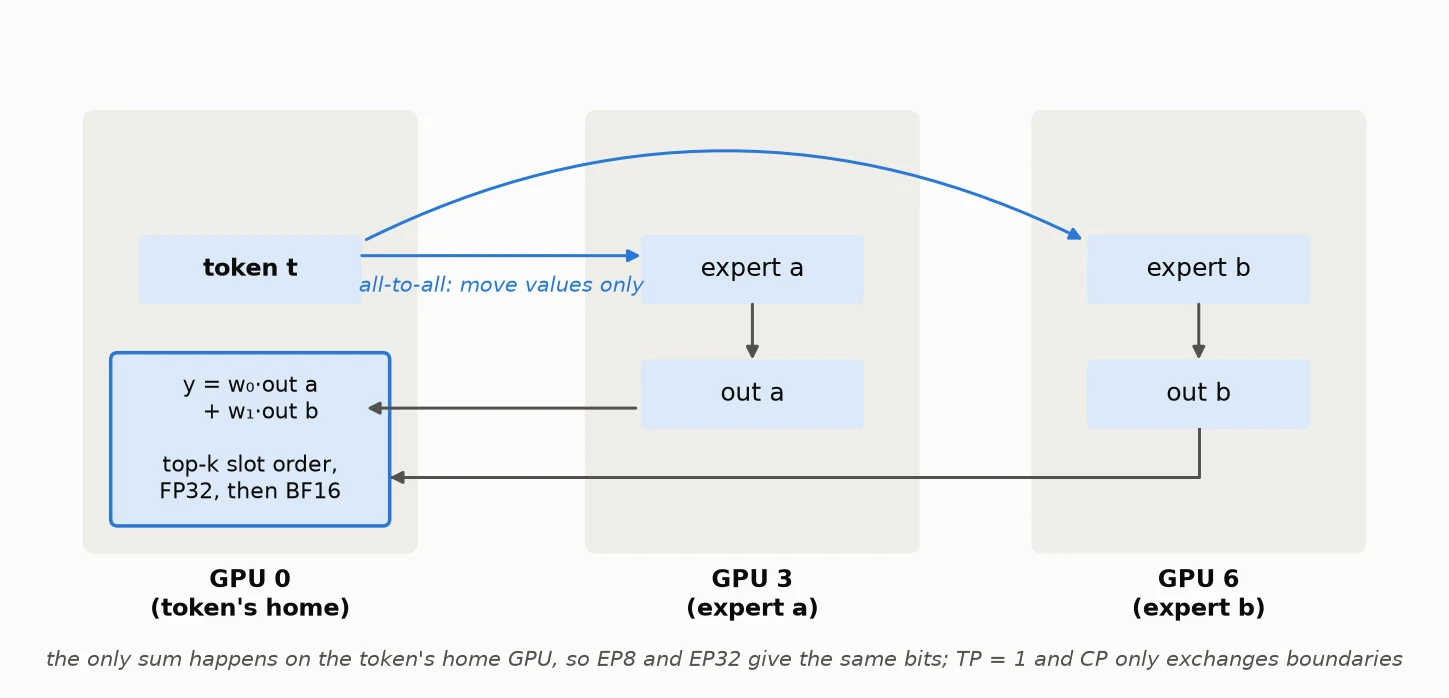
مسار رمز واحد: الـ all-to-all ينقل البيانات فقط، والجمع الوحيد يحدث على GPU المالك للرمز، بـ FP32 وبترتيب خانات top-k، لذا يعطي EP8 وEP32 النتيجة نفسها.
جعل حركة البيانات حتمية. في الـ rollout، ترسل كل رتبة على الأكثر عددًا ثابتًا من الرموز لكل استدعاء وجميع الرتب تُقسّم في خطوة موحدة، فيكون شكل الاتصال ثابتًا. الوضع LL فقط يطبّق هذا، والوضع العادي في DeepEP يعطّل CUDA Graph عندما DP>1، لذا يجب أن يستخدم الـ rollout الـ LL. في التدريب، لا يوجد للوضع العادي ترتيب وصول ثابت، لذا تُرسل بيانات التوجيه الوصفية مرة أخرى وتطابق بصمة bitwise كل مخرج خبير مع رمزه وخانته.
التكلفة والاستعادة. يعمل وضع LL بـ 43 طبقة × 2 = 86 عملية all-to-all تسلسلية في كل خطوة لا يمكن أن تتداخل مع الحساب. مخططات التداخل عبر الطبقات التي جربناها تحسب قبل جهوزية المدخلات وتكسر استقلالية الدفعات. التداخل بين دفعتين مصغرتين (DBO) كان أبطأ بنسبة 39%: تُقرأ أوزان الخبراء لكل طبقة مرتين، وقراءات الأوزان تستهلك أصلًا 84% من عرض نطاق HBM.
أغلقنا في النهاية فجوة الاتصال في معيار الاستدلال. تأكد أولًا أن كلا التشغيلين يستخدمان نفس الناقل: خسرنا يومين لأن سكربتًا ثبّت DeepEP للنسخة المتسقة على RDMA عبر إيثرنت (RoCE) بينما استخدم الأساس MNNVL الأسرع بكثير. مع تطابق الناقل والخبير المشترك على مسار مساعد، كانت النسخة المتسقة أسرع بنسبة 3.2% من الأساس (16834 مقابل 16313 tok/s).
الوضع TP>1 وdecode context parallel سيعيدان الاختزال عبر GPU إلى المسار المقارن وغير مدعومين بعد.
4.6 CUDA Graph: الاحتفاظ بالرسوم البيانية وجعلها تتعايش مع الاتساق
لماذا نحتفظ بها. يعمل الـ decode بعشرات النوى الصغيرة لكل طبقة في كل خطوة عند رمز واحد لكل طلب، لذا كان عبء الإطلاق سيهيمن؛ نحتفظ بـ CUDA Graph لبلوغ هدف الأداء. تتعارض الرسوم البيانية مع الاتساق bitwise في ثلاثة مواضع.
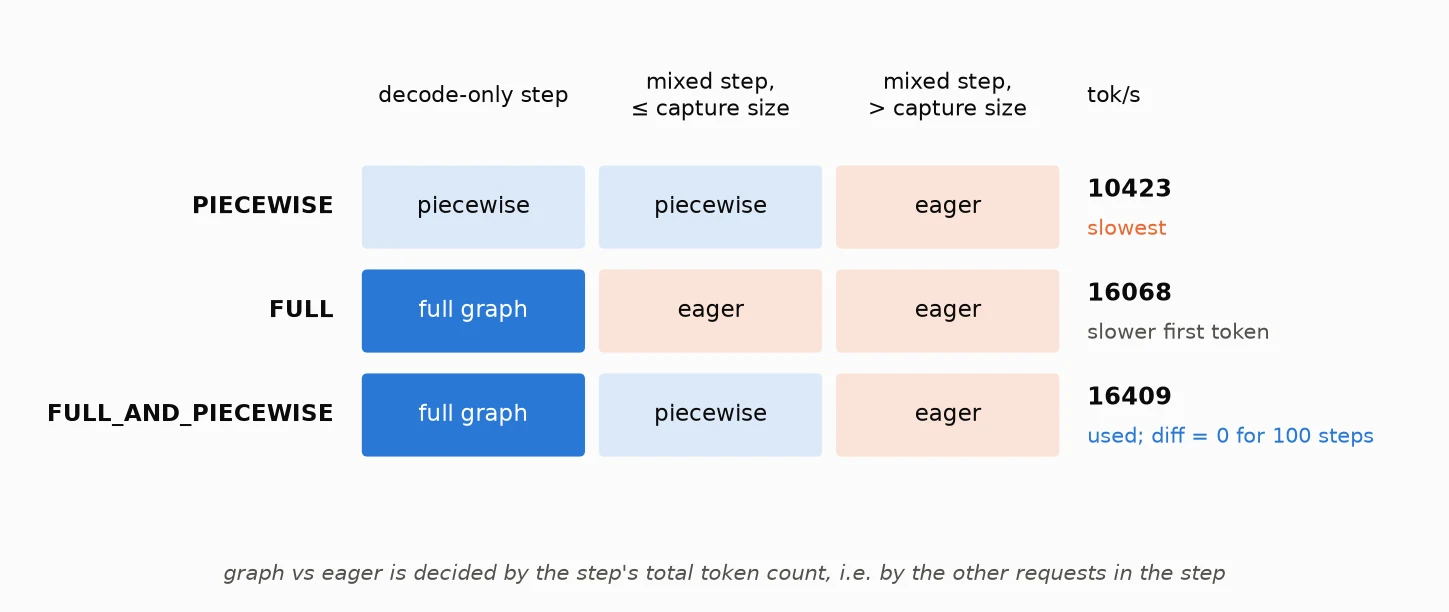
المسار الذي يسلكه كل وضع لثلاثة أنواع من الخطوات، مع إنتاجية معيار الاستدلال على اليمين. ينتقل الطلب بين الرسم البياني والـ eager حسب دفعته، فيجب أن يكون المساران متطابقين bitwise.
التعارض 1: رسم بياني أم eager. تعمل الخطوة داخل الرسم البياني إذا كان إجمالي عدد رموزها ضمن حجم الالتقاط الأقصى وفي الـ eager خلاف ذلك، وهذا يعتمد على الرموز الأخرى في الخطوة، فيجب أن يكون المساران متطابقين bitwise. كان هذا أول عدم تطابق لدينا: اختصار مسار سياق قصير في المفهرس كان مدمجًا في الرسم البياني عند الالتقاط بناءً على طول المدخل الوهمي. جعل الفحص يعتمد فقط على حد أعلى ثابت حلّ المشكلة.
الوضع مهم أيضًا. الوضع PIECEWISE لا يلتقط الانتباه، والوضع FULL على DeepSeek-V4 يلتقط خطوات decode الخالصة فقط. في معيار الاستدلال يعطي FULL_AND_PIECEWISE 16409 tok/s، وFULL 16068 وPIECEWISE 10423؛ الوضع FULL يشغّل كل خطوة مختلطة مع prefill في الـ eager، ما يرفع زمن أول رمز من 764 ms إلى 1792 ms. نستخدم FULL_AND_PIECEWISE: رسوم بيانية كاملة لخطوات decode الخالصة، والتقاط مجزأ للخطوات المختلطة؛ يبقى الفرق 0 عبر تشغيل 100 خطوة.
التعارض 2: لا مزامنة مع المضيف ولا أشكال تعتمد على الدفعة داخل الرسم البياني. هذا يتوافق مع الاتساق، وتصاميم كثيرة تخدم الاثنين: تلميح جدولة MoE يستخدم سعة ثابتة بدلًا من قراءة أعداد الرموز لكل خبير وإعادتها إلى المضيف (4.4)؛ الـ LL يثبّت شكل الاتصال (4.5)؛ مساحات العمل تُحجّم فقط بحدود النموذج، وتُخصص قبل الالتقاط ثم تُقفل؛ فروع الاختصار الخاصة بالأداء فقط تُعطَّل وقت الالتقاط.
التعارض 3: الرسوم البيانية تلتقط العناوين، والأوزان تتغير كل خطوة. يجب على الـ rollout نسخ الأوزان الجديدة إلى مخازنها الأصلية وإعادة حساب المعاملات المشتقة من الأوزان في مكانها، بدلًا من تخصيص ذاكرة جديدة تترك الرسم البياني على العناوين القديمة. التطابق في الخطوة الأولى لا يكفي، لذا تعيد المهارة المقارنة بعد التحديث والتصدير وإعادة التحميل.
التكلفة. مساحات العمل المحجوزة عند حدّها الأعلى تستهلك بعض الذاكرة. استعادة السرعة الأخرى (إزالة الحشو التصحيحي غير الضروري والبداية الباردة من الـ rollout، وتصفير أسرع لذاكرة KV) تنطبق على كلا التشغيلين؛ يجب أن يحصل الأساس عليها أيضًا، وإلا كان رقم خسارة الأداء بلا معنى.
5. خفض التكلفة الهندسية بـ Agent + skill
يمكن لـ A وB أن يتعايشا، لكن الجدول الرئيسي في القسم 4 والخيارات الأساسية فيه تتطلب حكمًا خبيرًا: أي نواة تكون batch-invariant، وأن الاختيارات المنفصلة تحتاج تعادلًا متوائمًا وترتيبًا، وكيفية مواءمة الكمّمة وترتيب الدمج عبر أوضاع اتصال مختلفة، وأن فجوة الاتصال تتطلب أولًا استبعاد اختلاف في الناقل. نموذج جديد أو دقة أو عتاد جديد يعني البدء من جديد، لذا لا ينطبق C.
بعد DeepSeek-V4-Flash، لاحظنا أن معظم هذا العمل يندرج في فئتين، لكل منهما هدف قابل للقياس:
- إيصال الفرق إلى 0. تثبيت الأوزان والمدخلات، إيجاد أول عملية تتفرق فيها الطرفان، تقليصها إلى مثال إعادة تشغيل أدنى، إصلاحها، ثم التحقق في تدريب حقيقي. تُقارن المخرجات مباشرة.
- تحسين الأداء مع إبقاء الفرق عند 0. حدّد النقاط الساخنة في الأداء، وقارن بين المشغّلَين A وB على حدة، وأعد التحقق من الاتساق بعد كل تغيير. لا تُحتسب التسريعات التي تغيّر النتائج أو التي تظهر فقط في الاختبارات المرجعية الدقيقة دون طرح فعلي، كما لا يُسمح بإبطاء خط الأساس لتقليص الفارق.
قراءة الشيفرة، وتتبّع سلاسل الاستدعاء، وتحديد مواضع التباين، وكتابة أمثلة إعادة الإنتاج، وتعديل النوى وإعادة تشغيل اختبارات الانحدار هي أعمال طويلة الأمد تناسب الوكيل الذكي، ويُحسم نجاحها من خلال مقارنة الاتساق وقياس الأداء.
قمنا بتغليف هذا كـ مهارة اتساق التدريب والاستدلال: فهي تخبر الوكيل ماذا يفعل وبأي ترتيب وما الذي يجب أن يصل إليه كل خطوة لكي يجتازها، حتى تنتقل العملية إلى نماذج أخرى.
تتضمن المهارة 11 بوابة (C0–C10) بشروط نجاح صريحة. وللتسريع من بدء التشغيل البارد، قمنا أولاً بقطع بعض الطبقات من النموذج الكامل إلى نموذج صغير، وحل معظم المشكلات هناك، ثم الانتقال إلى النموذج الكامل. خمس خطوات:
- حدد الهدف وخط الأساس (C0–C1). اسرد وحدات النموذج مع دقتها وتوازيها. اضبط النسخة العادية غير المتسقة (خط الأساس) على أداء عالٍ طبيعي للمراجعة البشرية. فهي المقام لعبارة "كم تكون النسخة المتسقة أبطأ".
- اجعل الاستدلال متسقاً ذاتياً على نموذج صغير (C2–C4). يجب أن يحتوي النموذج الصغير (عادةً 4–6 طبقات مختارة من النموذج الكامل) على كل فئة من العمليات (operators)، وأن يحافظ على التفاعل بين الطبقات المتجاورة، وأن يطابق حجم كل طبقة والتكميم، بحيث يعيد إنتاج معظم المشكلات العددية المحلية. يجب أن يظل العمق الكامل والسياق الطويل والتوزيع متعدد وحدات المعالجة الرسومية وضغط الذاكرة مقبولاً على النموذج الكامل. أولاً، اجعل محرك الاستدلال متسقاً داخلياً: الطلب الواحد يعطي النتيجة نفسها منفرداً وفي دفعة، وتطابق المدخلات الكاملة مع المعالجة رمزاً برمزاً (token by token). في الوقت نفسه، ابحث عن مشكلات هيكلية قد تبطئ النسخة المتسقة.
- اربط التدريب (C5–C7). يستدعي التدريب نفس العمليات التي يستدعيها الاستدلال، ويعيد حساب البيانات المولدة من الاستدلال، ويقارن رمزاً برمزاً؛ وعند وجود عدم تطابق، قارن طبقة بطبقة للعثور على أول طبقة متباعدة. ثم أضف التمرير العكسي وتحقق من التدرجات مقابل تنفيذ مرجعي مستقل عن الكود قيد الاختبار: التمرير الأمامي المتسق لا يعني تدرجات صحيحة.
- شغّل التعلم المعزز (RL)، ثم انتقل إلى النموذج الكامل (C8–C9). على النموذج الصغير، شغّل تحديثين متتاليين في إطار التدريب الحقيقي، وقارن تحت نسخة الأوزان نفسها قبل كل تحديث وبعده. بعد المراجعة البشرية، انتقل إلى النموذج الكامل ووسّع النطاق تدريجياً، بما في ذلك التحقق من الخطوة الأولى بعد استعادة نقطة التفتيش.
- استعد الأداء (C10). حسّن العمليات الأكثر تكلفة واحدة تلو الأخرى، مع إعادة التحقق من الاتساق في كل مرة، ثم قم بإجراء مقارنة مقترنة مقابل خط الأساس على صورة التسليم.
تصميمان يهمّان أكثر من غيرهما. أولاً، وكيلان يدفعان خط الأساس والاتساق بالتوازي: أحدهما يجعل خط الأساس سريعاً، والآخر يبني النسخة المتسقة. يتم تجميد خط الأساس المضبوط للمراجعة البشرية، حتى لا يتمكن الوكيل من إبطائه لتضييق الفجوة. ثانياً، مزالقنا مكتوبة في العملية نفسها: يجب أن يطابق البرنامج الجاري التشغيل المصدر الجاري قراءته؛ وتحتاج نقاط التفتيش إلى التحقق من الخطوة الأولى بعد الاستعادة، وليس مجرد الحفظ؛ وكل استنتاج حول الأداء يحتاج إلى خط أساس عادل وبيانات خام قابلة للتتبع؛ وقبل مقارنة اختناقات الاتصال، تأكد أن كلا التشغيلين يستخدمان النقل نفسه (الدرس المستفاد من 4.5).
تخفض المهارة تكلفة تحديد المواقع والانحدار (التوفير لم يتم قياسه كمياً هنا)؛ وهي لا تحل محل الحكم البشري: لا يزال البشر يراجعون خط الأساس، ومقايضات الدقة، والوصفة (recipe). مثال على ذلك انحراف التوجيه (routing drift) مع عدة تحديثات لكل خطوة: بنى الوكيل نموذج إعادة إنتاج صغير النطاق من الأعراض، وأجرى تجارب مميِّزة واستبعد الفرضيات، وقرر أحد البشر الانتقال إلى 1 تحديث لكل خطوة.
6. النقل: Nemotron، بنية هجينة من Mamba + NVFP4
ثم اختبرنا الوصفة المرجعية والمهارة على نموذج مختلف هيكلياً جداً.
Nemotron-3.5-Lightning-30B-A3B (NVFP4) هو نموذج هجين من Mamba-2 / الاهتمام / MoE (خبراء موجهون بـ NVFP4 W4A16، إسقاطات Mamba بدقة FP8، ذاكرة KV cache بدقة FP8 للاهتمام) على GB200. يستخدم خط الأساس تدريب NVFP4 QAT (قاعدة التكميم والتصدير من NVIDIA ModelOpt) + إعادة تشغيل المسار R3؛ أما النسخة المتسقة فتشارك التمرير الأمامي لـ vLLM، دون إعادة تشغيل المسار. كلا التشغيلين يستخدم أوزاناً رئيسية بدقة BF16 و1 تحديث لكل خطوة.
للهياكل المتكررة سوابق. في مجتمع vLLM، صمم Alexander Jiang وفريق SkyRL الشكل المتكرر المتوازي على شكل أجزاء (CPR) في IsoExec لشبكة Gated DeltaNet (GDN) في Qwen3.5-35B-A3B: فهو يحافظ على الشكل المتكرر لكنه يحسب على شكل أجزاء متوازية، بحيث تتشارك عملية التدريب والتمهيد (prefill) وفك الترميز (decode) ترتيب تقريب واحداً، وتوفر النموذج الموحد تعريف نموذج واحد ومجموعة واحدة من النوى المتوافقة للتدريب والاستدلال. ويظل مبدأ "عدم وجود عدم تطابق" في IsoExec صادقاً ضمن عقد التنفيذ الخاص به؛ وعلى مستوى النظام الكامل لا يزال يُبلّغ عن فرق logprob غير صفري صغير (متوسط الفرق المطلق حوالي 1e-7)، على عكس "التطابق البتّي الكامل" في هذه التدوينة. Mamba-2 من نفس نوع التكرار الخطي. نحن نجعل فك الترميز يعيد تنفيذ حسابات التمهيد المجزأة بدقة بدلاً من تكراره الخطوي الفردي الخاص، ويستورد التدريب نفس العمليات التي يستخدمها الاستدلال، كما في النموذج الموحد. قام الوكيل + المهارة بهذا التوافق.
في vLLM، تحصل كل عملية قد تعتمد على تكوين الدفعة على تنفيذ مستقل عن الدفعة (batch-invariant)، ويستوردها التدريب (نسخة خفيفة من Megatron-LM):
| المُشغّل | إصدار ثابت |
|---|---|
| مسح Mamba-2 SSD | فك الترميز يعيد تمامًا الحساب المجزأ الخاص بمرحلة prefill، إعدادات autotune ثابتة، حالة بدقة fp32 |
| Attention | FlashAttention مع split-KV ثابت، وعدد التقسيمات مستقل عن حجم الدفعة |
| الخبراء الموجّهون (NVFP4 W4A16: أوزان 4-بت، تفعيلات 16-بت) | CuTe-DSL grouped GEMM، تكتيك واحد، بدون split-K، دمج fp32 بترتيب الخانات |
| MoE all-to-all | اتصال أحادي الاتجاه، ترتيب دمج ثابت |
| Router GEMM | matmul persistent ثابت على مستوى الدفعة، مخرجات fp32 |
| التطبيع / تكميم FP8 | أنوية موحّدة ثابتة على مستوى الدفعة؛ يُمنع أي دمج يغيّر القيم |
النتائج: التدريب على SWE-bench Pro
نُشغّل التعلم المعزز الوكيلي (agentic RL) على SWE-bench Pro في بيئات معزولة بعيدة: 32 مهمة × 8 مسارات في كل خطوة، بنحو 57K رمز (token) لكل مسار في المتوسط، مع GRPO و8 عقد GB200 لكل تشغيل. مجموعة التدريب هي 375 مهمة من مهام SWE-bench Pro التي لم تكن فيها المحاولات الـ 4 المُعيارنة للنموذج الأساسي كلها صحيحة ولا كلها خاطئة، وكانت ترقية الإصلاح المعيارية (gold patch) تنجح في بيئتنا المعزولة، لذا فإن الدرجات أدناه هي مكافآت تدريب على هذه المجموعة الفرعية. كلا التشغيلين يستخدمان الصورة نفسها والوصفة نفسها، دون تصحيحات مثل TIS أو MIS. مع تحديث 1 في كل خطوة، يكون تباعد KL بين لوغاريتمات الاحتمالات لعمليات التوليد قبل التحديث وإعادة الحساب على جانب التدريب هو معامل KL بين التدريب والاستدلال لتلك الخطوة.
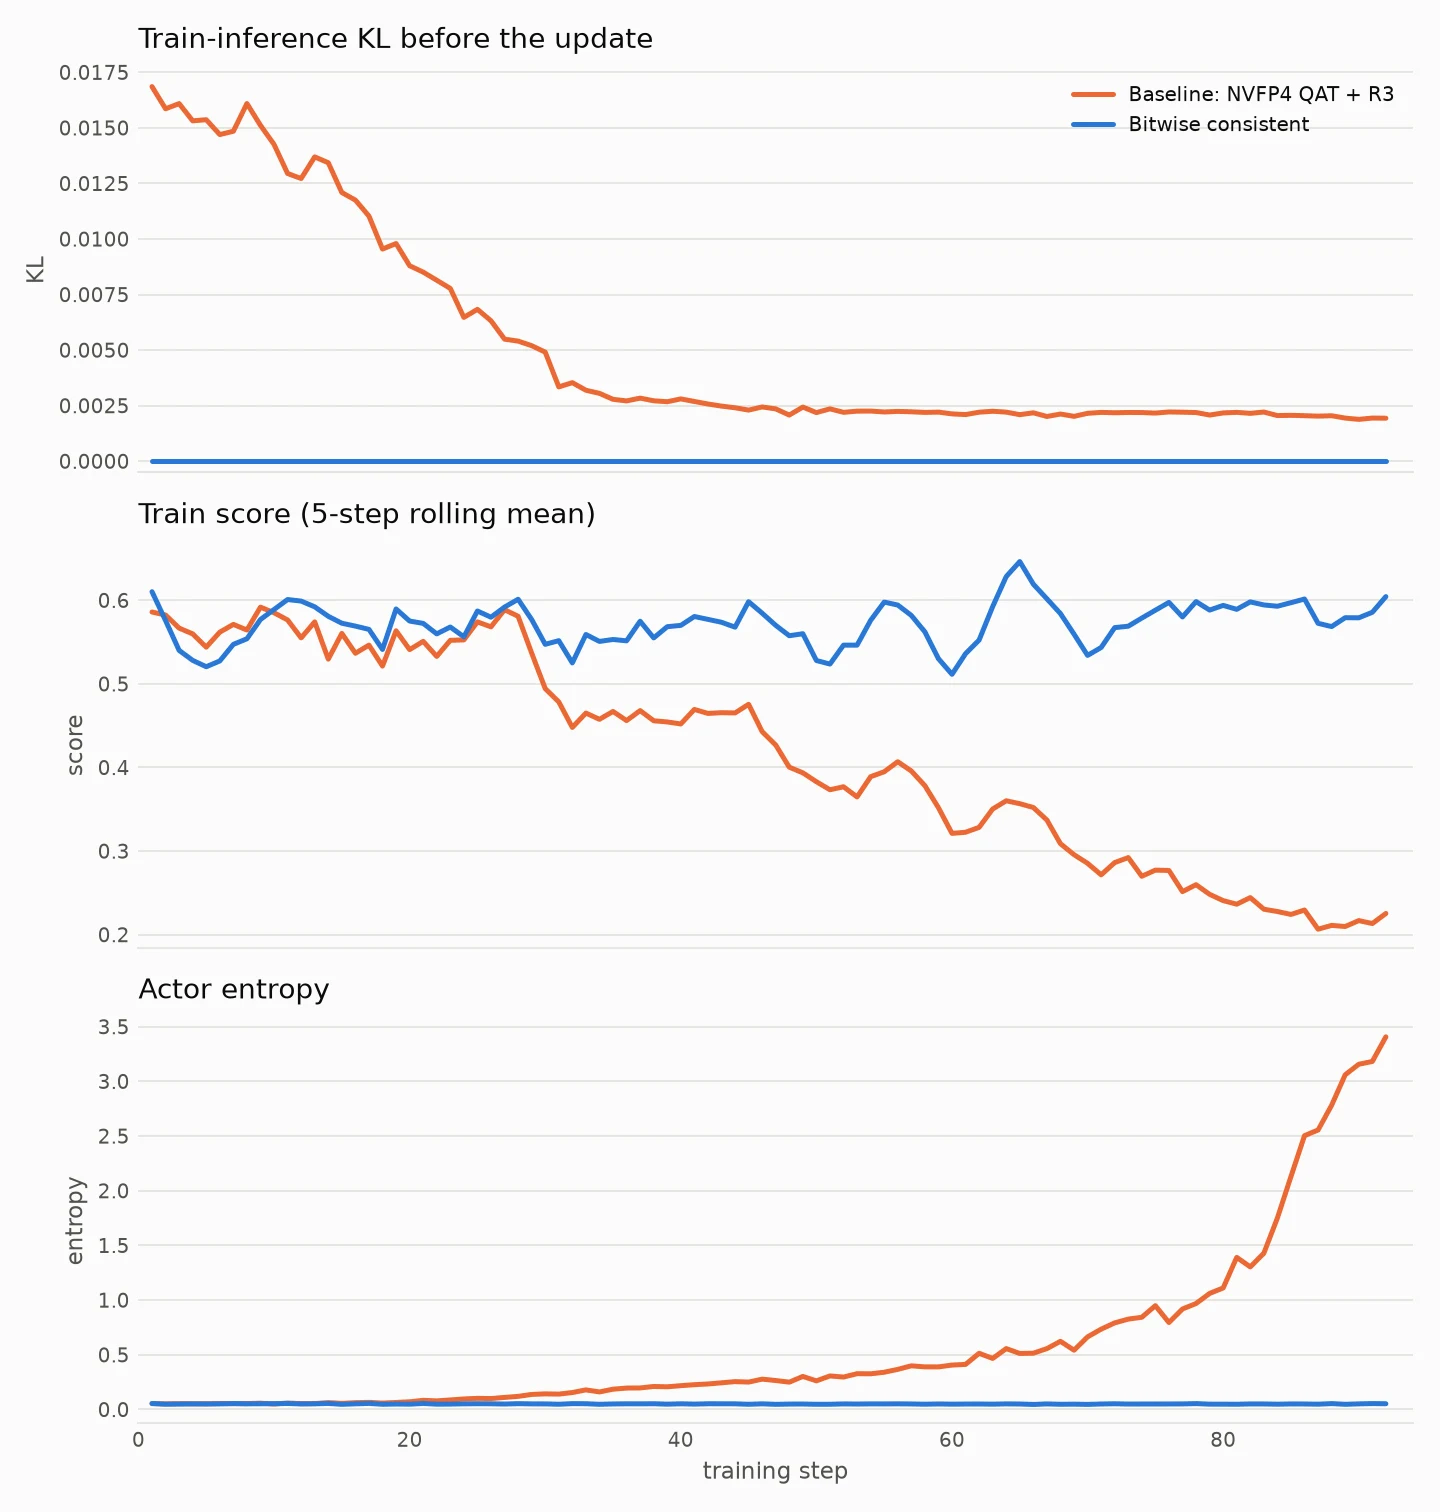
الأعلى: KL التدريب-الاستدلال لكل خطوة؛ الوسط: درجة التدريب (متوسط متحرك على الخطوة الحالية والـ 4 خطوات السابقة)؛ الأسفل: إنتروبيا الممثل. البرتقالي: خط الأساس؛ الأزرق: النسخة المتسقة. عند الخطوة 10 من النسخة المتسقة لم تُعد سوى بضعة مسارات من صندوق الحصر، لذا تُستثنى درجتها.
- النسخة المتسقة: KL التدريب-الاستدلال يساوي 0 تمامًا في كل خطوة، وتبقى الإنتروبيا حول 0.05، وتنتقل الدرجة من 0.56 (أول 10 خطوات) إلى 0.59 (آخر 10)، دون أي انخفاض.
- خط الأساس: يهبط KL التدريب-الاستدلال من ~0.015 إلى ~0.002، لكن الإنتروبيا ترتفع من 0.05 إلى 2.6 وتنخفض الدرجة من 0.56 إلى 0.22 (أول 10 خطوات مقابل آخر 10).
- سرعة التنفيذ: على مدى أول 30 خطوة، بينما كان التشغيلان سليمين، بلغ معدل نقل التنفيذ للنسخة المتسقة 87.5% من معدل خط الأساس، أي أبطأ بـ 12.5% فقط.
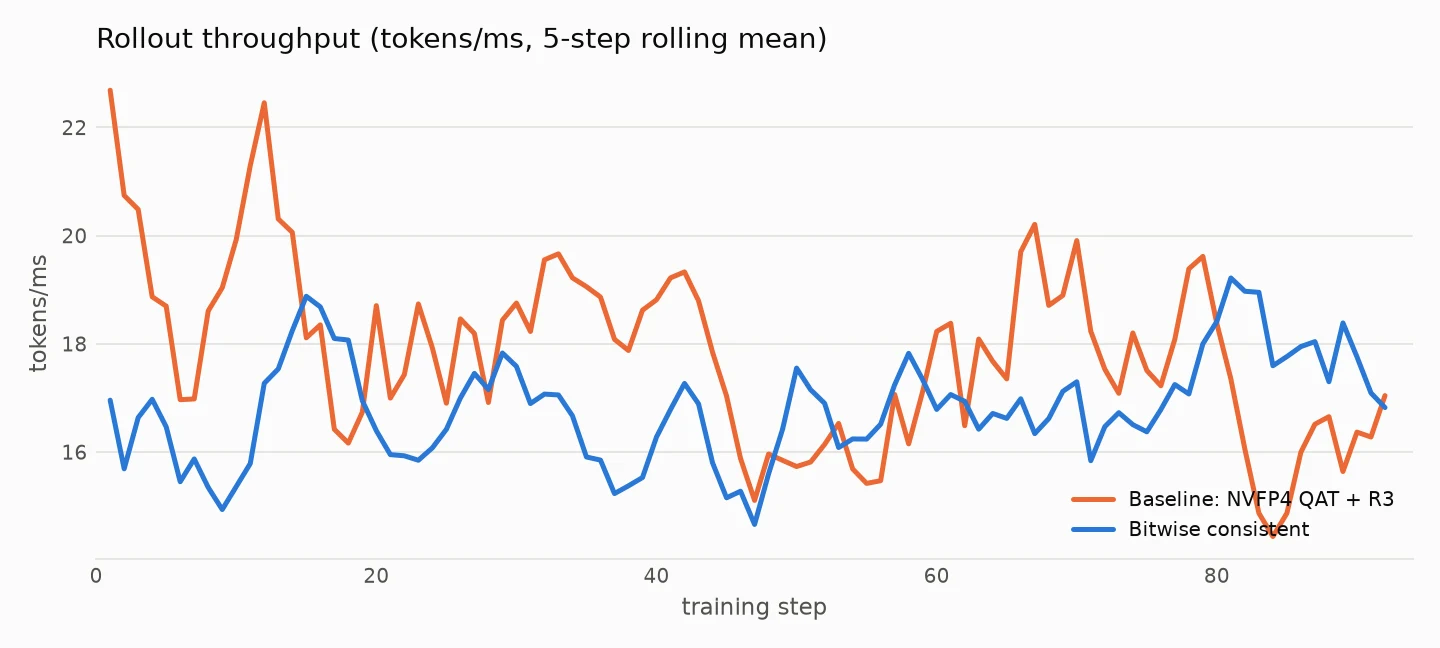
معدل نقل التنفيذ لكل خطوة (token/ms، متوسط متحرك على الخطوة الحالية والـ 4 خطوات السابقة). البرتقالي: خط الأساس؛ الأزرق: النسخة المتسقة.
7. المصدر المفتوح
نفتح مصدر هذا كي يتمكن الآخرون من تحقيق اتساق التدريب-الاستدلال باعتماد أقل على مهندسين كبار يفحصون المشغلًا تلو الآخر، باستخدام المهارة والكود الجاهز ووكيل على نموذجهم الخاص. الإصدار يشمل:
- مهارة train-inference-consistency: سير العمل الكامل (C0–C10)، وعشرة أدلة، وممارسات رئيسية مثل مقارنة logprob والتحقق المتقاطع بالتدرجات؛
- DeepSeek-V4: وصفة RL حقيقية على السياسة تصل إلى 0 اختلاف على Megatron وvLLM، verl-project/verl#7688;
- Nemotron-3.5-Lightning-30B-A3B (أوزان رئيسية BF16، مُكمَّمة إلى NVFP4 الخاص بالنشر في المرور الأمامي للتدريب وعند مزامنة الأوزان):
- استدلال vLLM متطابق على مستوى البِت مع التدريب: aoshen02/vllm#85;
- ممثل تدريب متوافق مع vLLM: aoshen02/Megatron-LM#7;
- تغييران في verl: aoshen02/verl#11;
- وصفة اتساق التدريب-الاستدلال وDockerfile للصورة الموحدة: aoshen02/verl#12.
نرحب بالمشكلات وطلبات السحب والملاحظات الناتجة عن استخدام المهارة على نموذجك الخاص.
التالي: اتساق التدريب-الاستدلال لـ DeepSeek-V4.1 قد وصل إلى 0 اختلاف؛ تحسين الأداء قيد التنفيذ وسيحصل على مقال خاص به.
شكر وتقدير
الشكر إلى (المنظمات بترتيب أبجدي):
- إنفيديا: جيان هو من أبحاث NVIDIA، Nolen Liang و تومر من فريق Nemotron
- السلايم: ال مادة لزجة (سلايم) المجتمع
- TikTok: مينغروي
- Verda: دعم بيئة الاختبار المعزولة (sandbox)
- verl: ال verl فريق