
يوسّع إصدارنا الأخير، Apertus 1.5، نموذجي Apertus 1.0 بحجمي 8B و70B من خلال إضافة فهم الصور/الصوت، ووضع تفكير اختياري، ونافذة سياق أطول بأربعة أضعاف، وتحسين التزام الإرشادات، واستخدام أفضل للأدوات. أما أوزار النموذجين 8B و70B تم إصدارها على Hugging Face في 24 يوليو 2026 بموجب ترخيص Apache 2.0. التفاصيل الإضافية متاحة الآن من المشروع تقرير تقنيوتم تلخيصها هنا.
Apertus 1.5 هو تدريب مسبق ممتد للنموذج من الجيل الأول: حيث أُضيفت 4 تريليون من الرموز النصية وبيانات التدريب متعددة الوسائط إلى نموذج 8B و2 تريليون من الرموز إلى نموذج 70B، ليصل الإجمالي إلى 19T و17T على التوالي. وكما هو الحال مع كل إصدار من Apertus، فإن النماذج مفتوحة بالكامل: مفتوحة الأوزان، افتح البيانات، افتح القيم، والتدريب الكامل التفاصيل.
التحسينات الرئيسية
- فهم محلي متعدد الوسائط: يستقبل Apertus 1.5 الصور والصوت إلى جانب النص، مما يُدخل المستندات والمخططات والصور إلى المحادثة. كما يمكن للنماذج معالجة اللغة المنطوقة، وإن كان ذلك لا يزال تجريبيًا.
- وضع التفكير: يمكن تحويل النماذج إلى وضع التفكير للتأمل في المُدخل قبل الإجابة، مما يحسّن الأداء في مسائل الاستدلال.
- السياق الطويل: تتوسع نافذة السياق إلى 262,144 رمزًا، بزيادة قدرها 4 أضعاف مقارنة بـ Apertus 1.0.
- تحسّن في اتباع التعليمات: الالتزام بالتعليمات أفضل من Apertus 1.0 يمنح إجابات أكثر قابلية للتنبؤ والدقة.
- تحسين استخدام الأدوات: تم تدريب النماذج لتحقيق تكامل أفضل مع الأدوات، مما يتيح استخداماً أكثر فعالية للأدوات الخارجية وواجهات برمجة التطبيقات (APIs).
- القيم المفتوحة: التزام أقوى بميثاق Apertus، الذي يضفي الشفافية على قيم النموذج ومبادئه.
عملية التدريب
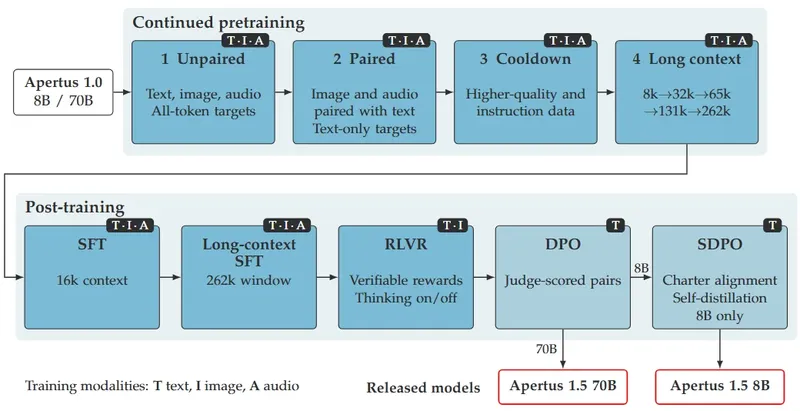
 مسار تدريب Apertus 1.5 الكامل
التعددية الوسائطية من خلال المُرمِّز
نقدّم تعدد الوسائط في نماذج v1.5 بأسلوب الاندماج المبكر، حيث تدخل الصور والصوت إلى Apertus كرموز منفصلة في التسلسل نفسه مع رموز النص، بدلاً من استخدام مُشفِّر رؤية منفصل. تُحوَّل الصور إلى رموز باستخدام Emu3.5 المُجزِّئ (tokenizer) (حيث تصبح صورة بحجم 512×512 إلى 1,024 رمزاً) والصوت باستخدام WavTokenizer (40 رمزاً في الثانية). نحن نوسّع المفردات فقط، لذا تبقى البنية المعمارية دون تغيير ويسير التدريب بسرعة النص الخالص. النماذج تفهم الصور والصوت لكنها تولّد النص فقط.

التدريب المسبق
انطلاقاً من Apertus 1.0، نتابع التدريب المسبق على أربع مراحل:
- غير مُقترن: نص مع صور وأصوات مستقلة، بحيث يتعلم النموذج الوسائط الجديدة.
- مُقترن: أزواج صورة–تعليق وصوت–نص مكتوب، بحيث يوائمها مع اللغة.
- التبريد: بيانات أعلى جودة مع المزيد من الرياضيات والبرمجة.
- السياق الطويل: تنمو النافذة خطوة بخطوة من 8k إلى 262k رمزاً.
بشكل إجمالي، أكثر من نصف رموز التدريب هي نص خالص، وهو ما يحافظ على القدرات اللغوية لـ Apertus 1.0. تُحدَّث البيانات النصية بمصادر مثل FineWeb2-HQ+وFinePDFs وNemotron-CC. جميع البيانات الجديدة، متعددة الوسائط بما فيها، تلبي المعيار نفسه كما سابقاً: متاحة للعموم، مرخّصة بتراخيص متساهلة، واحترام انسحابات robots.txt بأثر رجعي. كل مصدر مدرج في apertus-data-transparency.
التدريب اللاحق
يجري التدريب اللاحق على خمس مراحل: SFT ← SFT للسياق الطويل ← RL ← DPO ← المواءمة مع الميثاق (SDPO).
- SFT على 3.7M عينة نصية بالإضافة إلى بيانات الصور والكلام. تُضاف مسارات الاستدلال فقط إلى المطالبات التي لا يستطيع النموذج حلّها من دونها بالفعل. وتقتصر بيانات استخدام الأدوات على المسارات المتحقق منها عبر التنفيذ. ونُطلق SFT النصي الذي استخدمناه على Hugging Face.
- SFT للسياق الطويل عند النافذة الكاملة البالغة 262k يستعيد قدرة السياق الطويل التي يُضعفها SFT قصير السياق.
- RL بمكافآت قابلة للتحقق (RLVR) على حوالي 350k مطالبة في الرياضيات والبرمجة واتباع التعليمات وتعدد اللغات والرؤية، مع مزج التفكير بين التشغيل والإيقاف.
- DPO مع أزواج التفضيلات التي يقيّمها حكم يُحسّن جودة المحادثة واستخدام الأدوات والسلامة. نُطلق مجموعة التفضيلات و أزواج التدريب.
- SDPO يوائم النموذج مع ميثاق Apertus من خلال ملاحظات الحكم والتقطير الذاتي.
نتائج التقييم
إلى جانب توسيع قدرات النموذج، وسّعنا أيضًا بشكل كبير نطاق التقييمات. وإضافة إلى التقييمات النصية الحالية المستخدمة في Apertus 1.0، أضفنا تقييمات متعددة الوسائط (الصورة والصوت) وتقييمات وضع التفكير.
تُجرى التقييمات متعددة الوسائط عبر خط أنابيب MLLM-eval-suite الذي يدمج إطارين رئيسيين للتقييم متعدد الوسائط هما lmms-eval و VLMEvalKit. أضفنا أيضًا سلسلة من المعايير النصية، بالإضافة إلى توسيع القياس المعياري للترجمة والقدرات متعددة اللغات والسلامة واستخدام الأدوات. ويمكن العثور عليها في مستودع التقييم الخاص بنا لما بعد التدريب مستودع التقييمالمبني على نسخة lm-evaluation-harness المشتقة.
ورغم أنه لا يزال متأخرًا عن نماذج مفتوحة الأوزان الرائدة، فقد حسّن الإصدار الجديد أيضًا بشكل كبير الأداء في البرمجة واتباع التعليمات، حيث تفوّق Apertus 1.5 8B على نماذج مفتوحة الأوزان ذات الحجم المماثل في مهام IF والمهام متعددة اللغات. كما أن وضع التفكير يحسّن الأداء أكثر في المعايير الصعبة كثيفة الاستدلال مثل AIME. أما الأداء متعدد الوسائط للنموذج فأقرب إلى Gemma 4 12B ونماذج مفتوحة الأوزان الحالية الأخرى. ويُظهر الأداء متعدد الوسائط لـ Apertus 1.5 قدرة تنافسية في الفهم المكاني بين النماذج مفتوحة الأوزان وفي فهم المستندات والمخططات بين النماذج مفتوحة المصدر.
نشكر أيضًا متعاونينا والمقيّمين الخارجيين على مساعدتهم في القياس المعياري الفعال لقدرات Apertus. وعلى وجه الخصوص، يُظهر Apertus 1.5 أداءً قويًا في مهام القانون السويسري، إذ يضاهي النماذج مفتوحة الأوزان الرائدة (المدونة, الشيفرة). بالإضافة إلى ذلك، في معيار Last Translation Benchmark، يقدّم Apertus 1.5 8B قدرات ترجمة آلية تضاهي GPT-OSS-20B وتتفوق على نماذج مثل Claude Haiku 4.5 أو ترجمة جوجل (لوحة الصدارة, ورقة بحثية).
بطاقات التقييم: Apertus ❤️ EvalEval
يتعاون Apertus مع تحالف EvalEval لضمان قياس مرجعي شفاف بالكامل وقابل لإعادة الإنتاج. ننشر نتائج Apertus 1.5 في مخطط Every Eval Ever (EEE) وهو صيغة مشتركة تسجّل ليس فقط الدرجات، بل أيضاً من أجرى التقييم، وكيف تم الوصول إلى النموذج، وإعدادات التوليد، وكيف ينبغي تفسير كل مقياس: وهي تفاصيل تنقص عادةً من لوحات الصدارة وكثيراً ما تفسّر لماذا تختلف درجات تبدو متشابهة.
تُعرض النتائج في بطاقة التقييم أدناه، التي تجمع بيانات التشغيل مع البيانات الوصفية للمعيار المرجعي والنموذج في سجل واحد قابل للتفسير، وتتاح أيضاً عبر تقييمات مجتمع Hugging Face. وهي نفس البنية التحتية التي يستخدمها معهد أمن الذكاء الاصطناعي البريطاني لنشر تقييماته بشكل مفتوح. وبما أن تقييمات النصوص لدينا تُجرى على نسختنا العامة المتفرعة من lm-evaluation-harness، والتي يدعمها EEE بمحوّل مخصص، يمكن لأي شخص إعادة تشغيلها ومقارنة أرقامه بأرقامنا في ظل إعدادات متطابقة.
تُعدّ التقارير التقييمية المنظمة أمرًا مهمًا أيضًا خارج نطاق البحث. EvalEval ربط بطاقات التقييم بمتطلبات حوكمة الذكاء الاصطناعي, بما في ذلك المادة 55 من قانون الاتحاد الأوروبي للذكاء الاصطناعي ومدونة ممارسات النماذج ذات الأغراض العامة للذكاء الاصطناعي (GPAI Code of Practice)، وجدنا أن مخطط EEE يمكنه تمثيل 56 من أصل 60 عنصرًا للإبلاغ عن التقييم تدعو إليها هذه الأطر. وهذا يتوافق مع الطريقة التي نطلق بها Apertus بالفعل: فإلى جانب النماذج، ننشر ملخص عام من محتوى التدريب، وطوعاً، مدونة قواعد السلوك المستند. السجلات التقييمية القابلة للقراءة آلياً هي الخطوة الطبيعية التالية: تسهيل الأمر على الجهات التنظيمية والناشرين والباحثين للعثور على الأدلة الكامنة وراء النموذج وتفسيرها ومقارنتها.
نحن ملتزمون بتعزيز التقييم القابل للتكرار والشفاف من خلال بطاقات Eval Cards ومخطط EEE، ونشجع مطوري النماذج الآخرين على الإبلاغ عن نتائجهم بالطريقة نفسها، حتى يمكن مقارنة النتائج عبر النماذج والمؤسسات.
قابلية إعادة إنتاج Apertus 1.5
جميع الوصفات والتجارب الاستبعادية وخلطات البيانات موثقة في تقرير تقني. نهدف إلى تعميم تطوير النماذج المفتوحة من خلال جعل عملية تدريب v1.5 عامة ومتاحة. يتم استضافة نقاط التحقق الوسيطة في مجموعة Apertus 1.5 على Hugging Face, بما في ذلك الأوزان الأساسية، وSFT، وRLVR وDPO، بالإضافة إلى مزيج بيانات التدريب المنسقة لدينا/مجموعات البيانات المخصصة في مجموعة بيانات Apertus 1.5. يتيح مشاركتها للباحثين دراسة كيف تغيّر كل مرحلة سلوك النموذج.
يغطي التقرير العديد من تجارب الاستئصال (ablations) حول تأثير بيانات ما بعد التدريب في المراحل المختلفة، حيث لاحظنا أن البيانات متعددة الوسائط المدمجة معًا مع البيانات النصية أثناء SFT تساعد في تحسين الأداء عبر جميع الوسائط. نجد أيضًا أن فوائد مسارات الاستدلال متعددة الوسائط تظل قائمة بعد التعلم المعزز اللاحق النصي الخالص: فبدءًا من نقطة تفتيش SFT مدرَّبة بمسارات متعددة الوسائط، يحسّن التعلم المعزز (RL) الرياضيات أكثر مما عند البدء من نقطة تفتيش نصية خالصة، وتستمر الميزة في مهام الاستدلال طوال التدريب.
| نماذج | 8B | 70B |
|---|---|---|
| التدريب المسبق (نموذج أساسي بسياق طويل) | Apertus-v1.5-8B-base | Apertus-v1.5-70B-base |
| الضبط الدقيق الموجّه بالإشراف (SFT) | Apertus-v1.5-8B-SFT | Apertus-v1.5-70B-SFT |
| التعلم المعزز (RLVR) | Apertus-v1.5-8B-RLVR | Apertus-v1.5-70B-RLVR |
| مواءمة التفضيلات (DPO) | Apertus-v1.5-8B-DPO | Apertus-v1.5-70B (نهائي) |
| مواءمة الميثاق (SDPO) | Apertus-v1.5-8B (نهائي) | – |
| المرحلة | البيانات | الكود / الوصفة |
|---|---|---|
| التدريب المسبق: المرحلتان 1–2 (غير مزدوج، مزدوج) | جميع المصادر مع الإصدارات والتراخيص في apertus-data-transparency؛ ووصفات معالجة الرؤية والصوت في multimodal-data | Megatron-LM، وسكربتات الإطلاق في pretrain-code, apertus-omni-tokenizer, benchmark-image-tokenizer, benchmark-audio-tokenizer (بما في ذلك أداة بناء الكلام–النص المتشابك) |
| التدريب المسبق: المرحلة 3 (مرحلة التهدئة) | apertus-data-transparency; مجموعات بيانات الصور المنسّقة NASA, Our World in Data, Smithsonian, swisstopo | Megatron-LM، وسكربتات الإطلاق في pretrain-code |
| امتداد السياق الطويل | apertus-data-transparency; مهام السياق الطويل الاصطناعية في LongContextQA | Megatron-LM، وسكربتات الإطلاق في pretrain-code |
| SFT | Apertus-v1.5-SFT-mix (مزيج SFT متعدد الوسائط مذكور في التقرير) | posttraining-data, Megatron-LM (سكربتات إطلاق SFT) |
| SFT للسياق الطويل | مجموعات فرعية من مزيج SFT (مذكورة في التقرير)، بالإضافة إلى LongContextQA مهام | Megatron-LM |
| RL (RLVR) | مزيج مذكور في التقرير | verl, verl-recipe |
| DPO | Apertus-v1.5-Preference-Pool (الإكمالات المشروحة)، Apertus-v1.5-Preference-Data (أزواج) | ما بعد التدريب, verl |
| SDPO (توافق مع الميثاق، طراز 8B فقط) | gretelai/gretel-safety-alignment-en-v1 | التقطير الذاتي |
توفر النموذج
Proton Lumo و Infomaniak Euria هما تطبيقان واسعا الاستخدام قاما مؤخرًا بدمج Apertus 1.5. وهذه النشرات مرتبطة في عرض من المجتمع من بين آخرين - انظر هذا سلسلة النقاش لمشاهدة معاينة.
أُعلن عن إتاحة الوصول إلى Apertus 1.5 في شكل واجهة برمجة تطبيقات (API) للمطورين من قبل مجموعة من مزودي الخدمة، ومن بينهم Swisscom, Infomaniak, Phoeniqs، وشركات أخرى مذكورة في دليل التوفر العام. يقدم التقرير أيضًا تفاصيل حول كيفية عملنا مع مقيّمين خارجيين لاختبار النماذج وإعدادها.
التعليمات التقنية لتشغيل النماذج موجودة في بطاقات النماذج لإصدارات Apertus على Hugging Face وفي دليل البدء السريع.
كيفية المشاركة
شكرًا لقراءتك هذا المنشور على المدونة ولكونك جزءًا من مجتمعنا! احتفلنا للتو بخمسة ملايين تنزيل في تحليلات Hugging Face الخاصة بنا 🤗 ولا نتباطأ. في الآونة الأخيرة قمة الذكاء الاصطناعي + X (AI+X Summit) في زيورخ، أعلن فريقنا خارطة الطريق لـ أبيرتوس 2.0: بنية sparse/MoE، بإجمالي معاملات يبلغ نحو 600B، وجدول تدريب ممتد، مع تركيز الأولويات على الوكلاء والرياضيات والبرمجة.
خلاصة القول: ندعوكم لقراءة تقريرنا، وتنزيل النماذج، واستكشاف نقاط التحقق الوسيطة، وضبط الأوزان بدقة، وإعادة إنتاج تقييماتنا. الأسئلة التي لم تُغطَّ بعد في منشوراتنا أو الأسئلة الشائعة على الموقع مرحَّب بها دائمًا، كما يسعدنا أن نعرف أي المواضيع ستكون الأكثر فائدة للمجتمع في تعمقات مستقبلية.
إذا كنت تبني باستخدام Apertus أو تستخدمه، فيرجى ملء نموذج الاستعراضوالتواصل عبر الخيارات المتاحة في صفحة الاتصاللدينا. نتطلع إلى إبراز المزيد من الأعمال، ومعرفة ما تبنيونه، وسماع آرائكم حول كيفية تحسين Apertus!
الاستشهاد
مشروع Apertus وآخرون. "Apertus 1.5: من النماذج النصية المفتوحة إلى المستدلات متعددة الوسائط المفتوحة." arXiv:2610.15542. مسودة علمية أولية، arXiv، 11 أكتوبر 2026. https://doi.org/10.48550/arXiv.2610.15542.
@misc{apertus2026apertus15opentext,
      title={Apertus 1.5: From Open Text Models to Open Multimodal Reasoners},
      author={Project Apertus and Yixuan Xu and Yassine Turki and Vinko Sabolčec and Valentina Pyatkin and Tommy Chu and Sven Najem-Meyer and Sean F. Carroll and Robert Smith and Raphael Kreft and Oscar Alessandro Tazza and Oleg Lavrovsky and Nicola Irmiger and Matteo Santelmo and Marian Schneider and Juan García Giraldo and Hanna Yukhymenko and Eduard Ďurech and Davit Melikidze and Dani Tamayo and Bettina Messmer and Aryan Ahadinia and Anunay Yadav and Allen Huang and Ahmad Fraij and Alessandro Bombarda and Alex Padula and Alexander Hägele and Alexander Sternfeld and Anna Hedström and Anna Kosovskaia and Arthur Wuhrmann and Arundhati Balasubramaniam and Badr Al Mahouri and Barna Pasztor and Bartosz Szostakiewicz and Bich Ngoc Doan and Bryan Schmid and Burak Sezen and Camille Challier and Clément Charmillot and Dana Shayakhmetova and Daniel Perruchoud and David Brüggemann and David Isztl and Elia Palme and Emma Anastassova and Fabian Bösch and Faruk Zahiragić and Fawzi Roberto Mohamed and Fiona Panicali and Florian Kolly and Flynn Guerra and Francesco Monti and Frederike Lübeck and Gennaro Oliva and Haofeng Yang and Haoliang Shang and Helen El Khoury and Henrique Mendonça and Jannis Vamvas and Jérome Landolt and Jessica Lam and Jingchun Xiao and Jonathan Coles and Joshua Oyebanji and Khanh Nguyen and Konstantinos Pitas and Lasse B. Strand and Li Mi and Loïc Deslarzes and Lorenzo Baggi and Lorenzo Noci and Luca Baumann and Luca Sartori and Lukas Drescher and Marco De Negri and Marco Passerini and Mark Klein and Marko Stojanovic and Martin Majsec and Matin Ansaripour and Mattea Busato and Mauro Pellonara and Max Neuwinger and Michael Graber and Michal Tešnar and Michelle Wastl and Miguel Gila and Mikolaj Boronski and Morgane Magnin and Moritz Reihs and Mukhammadali Sayfiddinov and Nathan Ranchin and Nicolas Cuveillier and Oscar Wohlfahrt and Qianqian Zou and Rada Kamysheva and Rita Sevastjanova and Roman Machacek and Sebastian Keller and Simon Matrenok and Simon Pierre and Stefano Schuppli and Suei-Wen Chen and Szabina Horváth-Mikulas and Taliesin Perez and Thilo Spinner and Thomas Kleine Buening and Tim Robinson and Tymoteusz Kwiecinski and Vilém Zouhar and Vinzenz Thoma and Xiaozhe Yao and Yannick Metz and Yuhei Fukuhara and Yusif Askari and Zixuan Chen and Alexander Ilic and Ana Klimovic and Andreas Krause and Andrei Kucharavy and Elliott Ash and Joost VandeVondele and Martin Rajman and Mennatallah El-Assady and Thomas Schulthess and Timo Kehrer and Torsten Hoefler and Antoine Bosselut and Martin Jaggi and Imanol Schlag},
      year={2026},
      eprint={2610.15542},
      archivePrefix={arXiv},
      primaryClass={cs.CL},
      url={https://arxiv.org/abs/2610.15542},
}