
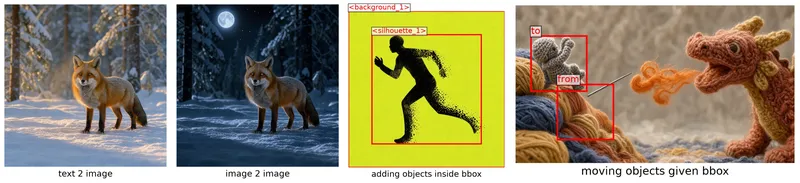
Black Forest Labs وصل FLUX.3 Image Klein، وهو يعمل في Diffusers منذ اليوم الأول. نموذج واحد يقوم بتوليد الصور من النص وتحويل الصور من صور مرجعية متعددة، ويضيف شيئاً جديداً وهو التحكم في التخطيط. تكتب صناديق الإحاطة (bounding boxes) في المطالبة لتحديد أين يجب أن يذهب كل جزء من الصورة، أو أي أجزاء من صورة مرجعية يجب تحريكها.
نقاط التحقق المفتوحة كلاهما متاحان في مجموعة FLUX.3 Image Klein:
| نقطة التحقق | ما هي | الإعدادات الافتراضية |
|---|---|---|
black-forest-labs/flux-3-image-klein |
مقطّرة زمنياً للاستدلال السريع | 16 خطوة، بدون CFG |
black-forest-labs/flux-3-image-klein-base |
النموذج الأساسي | 50 خطوة، مع CFG |

يمكنك التوجه إلى مساحة Hugging Face وتوليد بعض الصور الآن!
الخلاصة السريعة
- نموذج واحد لتوليد الصور من النص، وتحويل الصور من صور مرجعية متعددة، والتحكم في التخطيط عبر صناديق الإحاطة.
- نقطة التحقق المقطّرة تنشئ صورة 1024 × 1024 في حوالي 2 ثانية على H100.
- أوزان NVFP4 و FP8 تُحمَّل مع
from_single_fileللأجهزة ذات الذاكرة الأصغر. - سكربتات تدريب LoRA لكل من توليد الصور من النص وتحرير الصور.
- يأتي كخط أنابيب من نوع Modular Diffusers حتى تتمكن من إزالة الكتل أو إضافة كتل خاصة بك.
المحتويات
- البدء
- ماذا يمكن أن يفعل FLUX.3
- النموذج الأساسي والمتغيرات المكممة
- الضبط الدقيق بـ LoRA
- تكلفة تشغيله
- البنية المعمارية
- Modular Diffusers
- جرّبه
البدء
ثبّت الإصدار الأحدث diffusers و transformers (ل沐مُشفِّر نص Qwen3-VL):
pip install -U diffusers transformers
حمّل نقطة التحقق المقطَّرة وأنشئ صورة:
import torch
from diffusers import ModularPipeline

pipe = ModularPipeline.from_pretrained("black-forest-labs/flux-3-image-klein")
pipe.load_components(dtype=torch.bfloat16)
pipe.to("cuda")

pipe(prompt="a red fox", output="images")[0].save("fox.png")
ما يمكن أن يفعله FLUX.3
تحويل النص إلى صورة
يستجيب FLUX.3 بشكل أفضل لوصف كامل للمشهد يتضمن الموضوع، والمكان، والإضاءة، والتكوين، والأسلوب. إن دليل كتابة الأوامر الرسمي من Black Forest Labs يحتوي على مزيد من النصائح. يولّد نقاط التحقق المقطّرة صورة 1024 × 1024 في 16 خطوة افتراضيًا. مرِّر height, widthأو num_inference_steps لتغييرها.
prompt = (
    "A wide-angle wildlife photograph of a red fox standing alert in a snow-covered forest clearing at golden hour. "
    "The fox is centered in the frame, its thick orange winter coat contrasting with the fresh white snow, breath "
    "visible in the cold air. Snow-laden pine trees fill the softly blurred background, and low warm sunlight rakes "
    "across the scene from the left, casting long blue shadows."
)

fox = pipe(
    prompt=prompt,
    generator=torch.Generator().manual_seed(0),
    output="images"
)[0]
fox.save("fox.png")
 |
|---|
| نص إلى صورة |
صورة إلى صورة
مرِّر صورة مرجعية (أو أكثر) باستخدام الوسيطة image اكتب الأمر في صورة تعليق توضيحي للصورة التي تريدهامع تضمين التغيير.
prompt = (
    "The same red fox in the same snow-covered forest clearing, now at night under a full moon: cool blue "
    "moonlight, deep shadows, stars visible through the pine branches, the fox's eyes catching the light."
)
night = pipe(
    prompt=prompt,
    image=fox, # from the previous text to image example
    generator=torch.Generator().manual_seed(0),
    output="images",
)[0]
night.save("night.png")
 |
|---|
| صورة إلى صورة |
مع وجود عدة مراجع، أشر إليها في الأمر على أنها <ref_image_0>, <ref_image_1>... بالترتيب الذي تُمرَّر به إلى image:
red_fox = pipe(prompt="a red fox", generator=torch.Generator().manual_seed(0), output="images")[0]
bench = pipe(prompt="a wooden bench", generator=torch.Generator().manual_seed(0), output="images")[0]

combined = pipe(
    prompt="The fox from <ref_image_0> sitting on the wooden bench from <ref_image_1> in a snowy setting.",
    image=[red_fox, bench],
    output="images",
)[0]

combined.save("combined.png")
 |
 |
 |
|---|---|---|
<ref_image_0>: ثعلب أحمر |
<ref_image_1>: مقعد خشبي |
الثعلب على المقعد |
التحكم في التخطيط
أضف قائمة JSON من المناطق بعد التعليق التوضيحي. كل منطقة لها idو bboxو descويُشار إليها في التعليق التوضيحي على أنها <id>.
تُكتب المربعات على شكل
[y_min, x_min, y_max, x_max], y أولًاعلى مقياس من 0 إلى 1000. ولأن المقياس مُطبَّع، يعمل المربع نفسه بأي حجم للصورة.
وضع المناطق في صورة جديدة
layout_prompt = (
    "Minimalist graphic illustration featuring a black silhouette of a person <silhouette_1> centered against a "
    "solid, vibrant chartreuse background <background_1>. The figure is captured in a dynamic, mid-stride running "
    "pose, facing toward the left side of the frame. "
    '[{"id": "background_1", "bbox": [0, 0, 1000, 1000], "desc": "A flat field of neon yellow-green with a subtle '
    'paper texture and fine, organic grain."}, {"id": "silhouette_1", "bbox": [150, 150, 850, 850], "desc": "A '
    "black silhouette of a person in motion, made of dense stippled ink. The leading edges are solid; the trailing "
    'arm and leg dissolve into coarse square pixels and scattered dots."}]'
)

runner = pipe(prompt=layout_prompt, generator=torch.Generator().manual_seed(0), output="images")[0]
 |
|---|
يُرسم desc الخاصة بكل منطقة داخل bbox |
نقل المناطق داخل صورة مرجعية
بالنسبة للتعديلات، تحدد كل منطقة من أين يأتي محتواها من (src_bbox في الصورة المرجعية) وإلى أين يذهب (tgt_bbox في المخرجات). المنطقة التي تحمل المربعين نفسهين تبقى في مكانها.
ينقل هذا المثال الفارس المحبوك إلى الأعلى وإلى اليسار، ويثبّت الخلفية والجرف والإبرة والتنين والنار:
from diffusers.utils import load_image

knight_image = load_image("knight_orig.png")
edit_prompt = (
    "In <ref_image_0>, move the miniature grey amigurumi knight figure <knight_1> upwards and to the left along the "
    "yarn cliff <cliff_1>. Keep the rest of the image completely unchanged, preserving the blurred yarn backdrop "
    "<backdrop_1>, the large knitted dragon <dragon_1>, and the fiery orange thread <fire_1>. "
    '[{"id": "knight_1", "from": "ref_image_0", "src_bbox": [500, 150, 850, 350], "tgt_bbox": [194, 55, 544, 255], '
    '"desc": "A miniature amigurumi knight crocheted from thick grey woolen yarn."}, '
    '{"id": "backdrop_1", "from": "ref_image_0", "src_bbox": [0, 0, 1000, 1000], "tgt_bbox": [0, 0, 1000, 1000], '
    '"desc": "A soft, out-of-focus backdrop of cream and indigo knitted yarn."}, '
    '{"id": "cliff_1", "from": "ref_image_0", "src_bbox": [300, 0, 1000, 450], "tgt_bbox": [300, 0, 1000, 450], '
    '"desc": "A steep cliff of stacked yarn skeins in mustard, terracotta, and indigo."}, '
    '{"id": "needle_1", "from": "ref_image_0", "src_bbox": [420, 250, 550, 450], "tgt_bbox": [420, 250, 550, 450], '
    '"desc": "An oversized polished steel tapestry needle."}, '
    '{"id": "dragon_1", "from": "ref_image_0", "src_bbox": [100, 600, 950, 1000], "tgt_bbox": [100, 600, 950, 1000], '
    '"desc": "A large, fluffy knitted dragon in terracotta and mustard yarn."}, '
    '{"id": "fire_1", "from": "ref_image_0", "src_bbox": [350, 400, 650, 650], "tgt_bbox": [350, 400, 650, 650], '
    '"desc": "Curled puffs of fiery orange angora thread suspended in mid-air."}]'
)

moved = pipe(prompt=edit_prompt, image=knight_image, generator=torch.Generator().manual_seed(0), output="images")[0]
 |
|---|
يتحرك الفارس من src_bbox الخاص به إلى tgt_bboxالخاص به، وتبقى بقية المشهد في مكانها |
النموذج الأساسي والمتغيرات المُكمَّمة
النموذج الأساسي
كل ما سبق يستخدم نقطة التحقق المقطَّرة. نقطة التحقق الأساسية تشغّل 50 خطوة مع classifier-free guidance، وهي المعنيّة بالضبط الدقيق (انظر ضبط LoRA الدقيق).
pipe = ModularPipeline.from_pretrained("black-forest-labs/flux-3-image-klein-base")
pipe.load_components(dtype={"vae": torch.float32, "default": torch.bfloat16})
pipe.to("cuda")

pipe.guider = pipe.guider.new(guidance_scale=5.0)  # optional
image = pipe(prompt=prompt, output="images")[0]
نقاط تحقق بتنسيق الملف الواحد
كما توفّر Black Forest Labs المحوّل (transformer) كملف واحد، بصيغة bf16 وبصيغتين مُكمَّمتين: fp8r (rowwise FP8) و nvfp4. حمّل أيًّا منها باستخدام from_single_file، ثم حمّل المكونات الأخرى بالاسم حتى لا يُنزَّل محوّل bf16 أيضًا.
from diffusers import BFLQuantizationConfig, Flux3Transformer2DModel, ModularPipeline

model_id = "black-forest-labs/flux-3-image-klein-base"
variant = "fp8r"  # or "nvfp4"

transformer = Flux3Transformer2DModel.from_single_file(
    f"https://huggingface.co/{model_id}/blob/main/variants/{variant}/model.safetensors",
    config=model_id,
    subfolder="transformer",
    quantization_config=BFLQuantizationConfig(compute_dtype=torch.bfloat16),
    dtype=torch.bfloat16,
)

pipe = ModularPipeline.from_pretrained(model_id)
pipe.load_components(dtype=torch.bfloat16)
pipe.update_components(transformer=transformer)
pipe.to("cuda")
بالنسبة للملف الواحد غير المُكمَّم، استخدم https://huggingface.co/{model_id}/blob/main/model.safetensors واحذف quantization_config.
| المتغير | الأنوية السريعة على | وحدات GPU الأخرى |
|---|---|---|
fp8r |
قدرة حسابية 8.9+ (Ada وHopper وBlackwell) | تُلغى تكميم الأوزان في كل خطوة: ذاكرة أقل، دون تسريع |
nvfp4 |
Blackwell، مع flashinfer-python و flashinfer-cubin بنفس الإصدار |
كما سبق |
ضبط دقيق LoRA
يعمل FLUX.3 لكل من التحويل من نص إلى صورة والتحويل من صورة إلى صورة، مما يجعله قاعدة ممتازة لإنشاء LoRAs مخصصة. diffusers يتضمن سكربتات تدريب DreamBooth LoRA لكلا المهمتين (يمكنك أيضًا التدريب باستخدام أداة Ostris للذكاء الاصطناعي).
فيما يلي مثال للتحويل من نص إلى صورة يتعلم أسلوب بطاقات التاروت من مجموعة بيانات multimodalart/1920-raider-waite-tarot-public-domain ويُستدعى باستخدام trtcrd:
accelerate launch train_dreambooth_lora_flux3_klein.py \
  --pretrained_model_name_or_path="black-forest-labs/flux-3-image-klein-base" \
  --dataset_name="multimodalart/1920-raider-waite-tarot-public-domain" \
  --caption_column="caption" \
  --instance_prompt="trtcrd" \
  --output_dir="trained-flux3-tarot-lora" \
  --mixed_precision="bf16" \
  --resolution=1024 \
  --use_aspect_ratio_buckets \
  --train_batch_size=1 \
  --rank=16 \
  --lora_alpha=16 \
  --learning_rate=1e-4 \
  --lr_scheduler="constant" \
  --max_train_steps=1500 \
  --validation_prompt="a trtcrd of a cat, tarot style" \
  --validation_epochs=25 \
  --seed=0 \
  --push_to_hub
لتقليل استهلاك الذاكرة، أضف بعض أعلام التحسين:
  --gradient_checkpointing \
  --cache_latents \
  --use_8bit_adam
--gradient_checkpointingيعيد حساب التنشيطات في التمرير العكسي (استهلاك أقل لذاكرة VRAM مع تباطؤ طفيف)،--cache_latentsيقوم بترميز الصور مسبقًا ويحرر VAE، و--use_8bit_adamيحتفظ بحالات المُحسِّن بدقة 8 بت.
هناك بعض الإعدادات التي يستحق التجريب. الشبكة أدناه تدرب نفس أسلوب التاروت بتصنيفات LoRA ومُحسِّنات مختلفة؛ والمُهايئات متاحة على Hub على الرابط diffusers-modular/flux3-tarot-lora. يتم توثيق المزيد من ميزات التدريب والتكوينات في DreamBooth FLUX.3 README.

للتعديل المبني على التعليمات، يقوم سكربت التحويل من صورة إلى صورة (train_dreambooth_lora_flux3_klein_img2img.pyبالتدريب على ثلاثيات (صورة مرجعية، صورة هدف، تعليمة)، حيث تتم الإشارة إلى الصورة المرجعية في الطلب بصيغة <ref_image_0>.
انظر DreamBooth FLUX.3 README لجميع الخيارات والمثال الكامل للتحويل من صورة إلى صورة.
تكلفة تشغيله
في هذا القسم، سنتحدث عن استهلاك الذاكرة وسرعة توليد النماذج.
الذاكرة
| الاسم | الذروة المخصصة (بعد التحميل) جيبي بايت | الذروة المخصصة (بعد الاستدلال) جيبي بايت |
|---|---|---|
| nvfp4 (RTX6000) | 13.4 | 15.3 |
| fp8r (H100) | 14.35 | 16.27 |
| bf16 (H100) | 18.80 | 20.72 |
إذا كانت ذاكرتك أقل:
- حمّل محوّلًا كمّيًا (quantized transformer).
- شغّل مرمّز النص بشكل منفصل ثم حرّره. إذ يعمل مرة واحدة فقط لكل صورة، قبل عملية إزالة التشويش (انظر الترميز مرة واحدة والتوليد عدة مرات).
- فعّل التفريغ التلقائي إلى وحدة المعالجة المركزية (CPU offloading)، الذي ينقل كل مكوّن إلى وحدة معالجة الرسومات فقط أثناء تشغيله (لم نقم بقياس أداء هذا)
from diffusers import ComponentsManager, ModularPipeline

manager = ComponentsManager()
manager.enable_auto_cpu_offload(device="cuda")

pipe = ModularPipeline.from_pretrained("black-forest-labs/flux-3-image-klein", components_manager=manager)
pipe.load_components(dtype={"vae": torch.float32, "default": torch.bfloat16})
# no pipe.to("cuda"): the manager handles device placement
السرعة
أزمنة التنفيذ من البداية إلى النهاية لنموذج التقطير (16 خطوة)، وهي متوسطات على ثلاث تشغيلات بعد التسخين:
| سير العمل | حجم المخرجات | الوقت | الذاكرة القصوى |
|---|---|---|---|
| من النص إلى صورة | 1024 × 1024 | 1.93 ثانية | 23.8 GiB |
| من صورة إلى صورة، مرجع واحد بحجم 1024 × 1024 | 1024 × 1024 | 3.87 ثانية | 23.8 GiB |
| تحرير التخطيط (الفارس)، مرجع واحد بحجم 1360 × 768 | 1360 × 768 | 4.10 ثانية | 23.8 GiB |
كرت NVIDIA H100 80GB واحد، بدون تفريغ، مع خلفية الانتباه الافتراضية.
تضاعف الصورة المرجعية الوقت تقريبًا. فالرموز المرجعية تنضم إلى نفس التسلسل مع النص والصورة التي يتم توليدها، وبالتالي فإن المرجع بحجم 1024 × 1024 يضيف 4,096 رمزًا إلى كل استدعاء للمحوّل
 |
|---|
| أعمدة متراكمة للرموز لكل استدعاء للمحوّل: من نص إلى صورة 4,256 رمزًا؛ من صورة إلى صورة 8,272؛ من نص إلى صورة مع تخطيط 4,336؛ من صورة إلى صورة مع تخطيط 8,800 |
البنية المعمارية
لنفتح النموذج، قطعةً قطعة. يأخذ النموذج ثلاثة أنواع من الرموز:
- النص
- و الصورة المشوّشة التي يتم توليدها
- وكذلك الصور المرجعية
من البكسلات إلى الرموز
FLUX.3 هو نموذج تدفق في الفضاء الكامن لتوليد الصور. وهذا يعني أن مزيل التشويش يأخذ الكمونات كمدخلات وينتج كمونات كمخرجات. نستخدم VAE لفك ترميز الكمونات عائدين إياها إلى بكسلات. يستخدم FLUX.3 نفس بنية VAE الخاصة بـ Flux.2.
يضغط VAE الخاص بـ FLUX.2 الصورة بمقدار 8× في كل اتجاه إلى 32 قناة، ثم تُحزم كل رقعة 2 × 2 من ذلك الكامن في رمز واحد يحتوي على 128 قناة.
إذن رمز واحد يغطي رقعة من 16 × 16 بكسل، وتصبح الصورة بحجم 1024 × 1024 شبكة 64 × 64 مكوّنة من 4,096 رمزًا. تبدأ الصورة المشوّشة كضجيج عشوائي بهذا الشكل تمامًا. أما الصورة المرجعية فتمر عبر نفس مرمّز VAE ونفس التعبئة، وتحافظ على حجمها الخاص.
من التوجيه إلى الرموز
مرمّز النص هو Qwen3-VL، وهو نموذج رؤية-لغة. لا يقتصر FLUX.3 على أخذ طبقته الأخيرة، بل يقرأ الحالات المخفية لثماني طبقات من أصل 36 طبقة (الطبقات 4، 8، …، 32) ويكوّنها فوق بعضها، بحيث يصبح كل رمز نصي متجهًا بأبعاد 8 × 2560 = 20,480 قبل أن تعيده طبقة خطية إلى عرض المحوّل البالغ 3072.
هذا يمنح المحوّل خصائص من عدة أعماق لنموذج اللغة، وليس من طبقته النهائية فقط. تُحشى المطالبة إلى مضاعف من 80 رمزًا، وينتبه المحوّل إلى الحشوة أيضًا، ولهذا تأخذ الخطوة مطالبة واحدة لكل استدعاء.
مرحلتان
يعالج المحوّل الرموز على مرحلتين:
- المرحلة 1: كتل لكل نمط. يمر كل تيار عبر 5 كتل لها أوزانها الخاصة. النص له كتله الخاصة، والصورة المشوشة لها كتلها الخاصة، والصور المرجعية لها كتلها الخاصة.
- المرحلة 2: الكتل المشتركة. تُدمج التيارات في تسلسل واحد،
[text | image | reference]والذي يمر عبر 28 كتلة تتشارك مجموعة واحدة من الأوزان.
تختلف المرحلتان في من يستطيع الانتباه إلى من.
في المرحلة 1، ينتبه كل تيار إلى نفسه فقط، لذا يُحسَّن كل نوع من الرموز أولاً وفق شروطه الخاصة. في المرحلة 2، ينتبه كل شيء إلى كل شيء، حيث تتعلم الصورة من النص ومن المراجع. للمقارنة، فإن كتل التيار المزدوج في FLUX.2 تمنح أيضاً النص والصورة أوزاناً منفصلة، لكنها تتيح لهما الانتباه إلى بعضهما منذ البداية. أما FLUX.3 فيُبقي التيارات منفصلة تماماً أولاً، ثم يدمجها.
في النهاية، تُهمَل رموز النص والمراجع ببساطة. فقط رموز الصورة تمر عبر طبقات الإخراج، التي تتنبأ بكيفية تحريكها خطوة واحدة نحو صورة نظيفة.
داخل كتلة واحدة
كل كتلة، في أي من المرحلتين، لها الشكل نفسه. يعمل الانتباه وشبكة MLP بالتوازي على المدخلات المُطبَّعة نفسها، ويُضاف مجموعهما مرة أخرى إلى مجرى البواقي (residual stream).
تبدأ كل كتلة بـ LayerNorm لا يملك مقياساً أو إزاحة مُتعلمة من تلقاء نفسه. بل يأتي المقياس والإزاحة والبوابة من تضمين خطوة زمنية بدلاً من ذلك (وهذا يُسمى التعديل). داخل الانتباه، تُطبَّق التسوية RMS على الاستعلامات والمفاتيح وتحصل على تضمينات المواقع الدوّارة (RoPE)، التي سنلقي نظرة عليها أدناه.
في الكتلة الموحدة، تشترك جميع الرموز في نفس الأوزان، لكن رموز النص والصورة والمرجع يحصل كل منها على مقياسه وإزاحته وبوّابته الخاصة.
def block(x, shift, scale, gate):      # shift, scale, gate come from the token's timestep embedding
    h = layer_norm(x)                  # no learned scale or shift
    h = (1 + scale) * h + shift
    q, k, v = to_q(h), to_k(h), to_v(h)
    q, k = rope(rms_norm(q)), rope(rms_norm(k))
    out = attention(q, k, v) + mlp(h)  # parallel, MLP is SwiGLU
    return x + gate * out
كل رمز يحصل على خطوة زمنية خاصة به
في FLUX.1 وFLUX.2، يقوم تضمين خطوة زمنية واحدة بتعديل كل رمز. أما في FLUX.3، فيعتمد التعديل على نوع الرمز.
يتم تعديل رموز الصورة المشوّشة بواسطة الخطوة الزمنية الحالية t. أما رموز النص والمرجع فيتم تعديلها دائماً بواسطة الخطوة الزمنية 0، ما يعني "نظيف، لا شيء يُزال تشويشه هنا". لذا حتى مرجع يبدو مطابقاً تقريباً للناتج يُوسَم كسياق معطى، وليس كشيء يجب توليده.
نقطة التحقق المقطّرة هي خريطة تدفق. كما يُخبَر أيضاً بالخطوة الزمنية التي تقفز إليها كل خطوة. تحصل تلك الخطوة الزمنية الثانية على تضمين خاص بها يُضاف إلى تعديل كل رمز، بحيث يمكن لكل من خطواتها الـ 16 أن تقفز قفزة أكبر.
المواقع في أربعة أبعاد
الانتباه بمفرده لا يعرف موقع الرمز (تُسمّى هذه الظاهرة تعادلية التبديل). يحل RoPE ذلك بتدوير كل استعلام ومفتاح بمقدار يعتمد على موقع الرمز. يستخدم FLUX.3 أربعة محاور للموقع، (t, h, w, l) (الخطوة الزمنية، الارتفاع، العرض، طول المتتالية)، ويمنح كل محور منها ربع (32 بُعداً) من كل رأس انتباه 128-الأبعاد:
| الرموز | t: الخطوة الزمنية | h: الارتفاع | w: العرض | l: طول المتتالية |
|---|---|---|---|---|
| رمز نصي i | 0 | 0 | 0 | i |
| رمز صورة عند (صف، عمود) | 0 | الصف / 2 | العمود / 2 | 0 |
| مرجع k عند (صف، عمود) | 0 | الصف / 2 | العمود / 2 | −(k + 1) |
تتمازج الرموز النصية على طول l، مثل الكلمات في جملة. الصورة والمراجع شبكات 2D في (h, w)، مفصولة بعضها عن بعض على طول l. ولأن المرجع يستخدم نفس (h, w) الإحداثيات مثل المخرجات، فإن "نفس الموقع في المرجع" له معنى دقيق بالنسبة للنموذج، وهو ما يعتمد عليه src_bbox / tgt_bbox التعديل.
حلقة إزالة التشويش
FLUX.3 هو نموذج flow-matching. تبدأ التوليد من تشويش خالص، وفي كل خطوة من الخطوات الـ 50 يتنبأ المحول (transformer) بـ السرعة (velocity). وهي الاتجاه من التشويش نحو صورة نظيفة. يأخذ المجدول خطوة واحدة على طول هذا الاتجاه.
في كل خطوة يمكنك أيضًا قراءة التخمين الحالي للنموذج عن الصورة النهائية. فك ترميز هذا التخمين عند بضع خطوات يُظهر كيف تتشكل الصورة:
 |
 |
||||
|---|---|---|---|---|---|
| الخطوة 1 | الخطوة 5 | الخطوة 10 | الخطوة 15 | الخطوة 25 | الخطوة 50 |
الثعلب ووضعيته والإضاءة تكون قد استقرت بالفعل بحلول الخطوة 10، بينما لا يزال مستوى التشويش 0.97. أما الفروع المثقلة بالثلج وملمس الفرو فلا يظهران إلا في الخطوات القليلة الأخيرة. يستخدم مجدول FLUX.3 إزاحة زمنية كبيرة (6.93)، وهي ما يحافظ على مستوى التشويش مرتفعًا خلال معظم مسار التشغيل: 44 من أصل 50 خطوة تحدث فوق σ = 0.5. لقد أنشأنا هذا الشكل بإضافة كتلة صغيرة واحدة إلى الـ pipeline، وهو ما يقودنا إلى Modular Diffusers.
إذا كنت مبتدئًا في flow matching، لدينا برنامج تعليمي سهل للمبتدئين و فيديو ل帮助你—نلت به لك فهم كيفية عمله.
Modular Diffusers
يأتي FLUX.3 كخط أنابيب Modular Diffusers .
شاهد سير العمل
يمكنك عرض سير العمل وطباعة الكتل الدقيقة لكل منها، دون تحميل أي أوزان.
from diffusers import Flux3AutoBlocks

blocks = Flux3AutoBlocks()
print(blocks.available_workflows)
# ['text2image', 'image_conditioned']

print(list(blocks.get_workflow("text2image").sub_blocks))
# ['text_encoder', 'denoise.input', 'denoise.prepare_latents', 'denoise.set_timesteps',
#  'denoise.prepare_rope_inputs', 'denoise.denoise', 'denoise.after_denoise', 'decode']
get_workflow() يحل الفروع التلقائية ويعطيك تسلسل الخطوات البسيط الذي سيتم تشغيله. print(blocks.get_workflow("image_conditioned").doc) يطبع المكونات والمدخلات والإعدادات الافتراضية والمخرجات لسير العمل هذا.
الترميز مرة واحدة، والتوليد مرات عديدة
أخرج مشفّر النص، وشغّل ترميز الوصف مرة واحدة، وحرّره، ثم ولّد من التضمينات المخزنة مؤقتًا.
import torch
from diffusers import ModularPipeline

model_id = "black-forest-labs/flux-3-image-klein-base"

blocks = ModularPipeline.from_pretrained(model_id).blocks
text_blocks = blocks.sub_blocks.pop("text_encoder")  # `blocks` now starts at the VAE encoder

text_pipe = text_blocks.init_pipeline(model_id)
text_pipe.load_components(dtype=torch.bfloat16)
text_pipe.to("cuda")

state = text_pipe(prompt=prompt, negative_prompt="")  # no guider here, so ask for the negative embeddings

prompt_embeds = state.get("prompt_embeds")
negative_prompt_embeds = state.get("negative_prompt_embeds")

del text_pipe
torch.cuda.empty_cache()

image_pipe = blocks.init_pipeline(model_id)  # no text encoder to load
image_pipe.load_components(dtype={"vae": torch.float32, "default": torch.bfloat16})
image_pipe.to("cuda")

for seed in range(3):
    image = image_pipe(
        prompt_embeds=prompt_embeds,
        negative_prompt_embeds=negative_prompt_embeds,
        generator=torch.Generator().manual_seed(seed),
        output="images",
    )[0]
    image.save(f"{seed}.png")
أضف خطوة داخل الحلقة
الشكل الخاص بإزالة الضوضاء أعلاه جاء من كتلة إضافية واحدة تسجل تخمين النموذج للصورة النظيفة عند كل خطوة:
from diffusers.modular_pipelines import Flux3AutoBlocks, InputParam, ModularPipelineBlocks, OutputParam


class Flux3PreviewStep(ModularPipelineBlocks):
    model_name = "flux3"

    @property
    def inputs(self):
        return [InputParam("latents"), InputParam("noise_pred")]

    @property
    def intermediate_outputs(self):
        return [OutputParam("x0_previews", type_hint=list)]

    @torch.no_grad()
    def __call__(self, components, block_state, i, t):
        if i == 0:
            block_state.x0_previews = []
        sigma = t / 1000  # timesteps are sigmas scaled to [0, 1000]
        block_state.x0_previews.append(block_state.latents - sigma * block_state.noise_pred)  # x0 = x_t - sigma * v
        return components, block_state


blocks = Flux3AutoBlocks()
denoise_loop = blocks.sub_blocks["denoise"].sub_blocks["text2image"].sub_blocks["denoise"]
denoise_loop.sub_blocks.insert("preview", Flux3PreviewStep(), 1)  # between "denoiser" and "after_denoiser"

pipe = blocks.init_pipeline(model_id)
pipe.load_components(dtype={"vae": torch.float32, "default": torch.bfloat16})
pipe.to("cuda")

out = pipe(prompt=prompt, generator=torch.Generator().manual_seed(0), output=["x0_previews", "images"])
جرّبها
- النماذج: مجموعة FLUX.3 Image Klein
- الوثائق: FLUX.3 في Diffusers
- الضبط الدقيق: سكربتات DreamBooth LoRA
- كتابة الأوصاف: دليل كتابة الأوصاف من Black Forest Labs
هل بنت شيئًا باستخدام FLUX.3؟ شارك نماذج LoRA الخاصة بك وخطوط الأنابيب على الـHub. يسعدنا رؤيتها! 😎