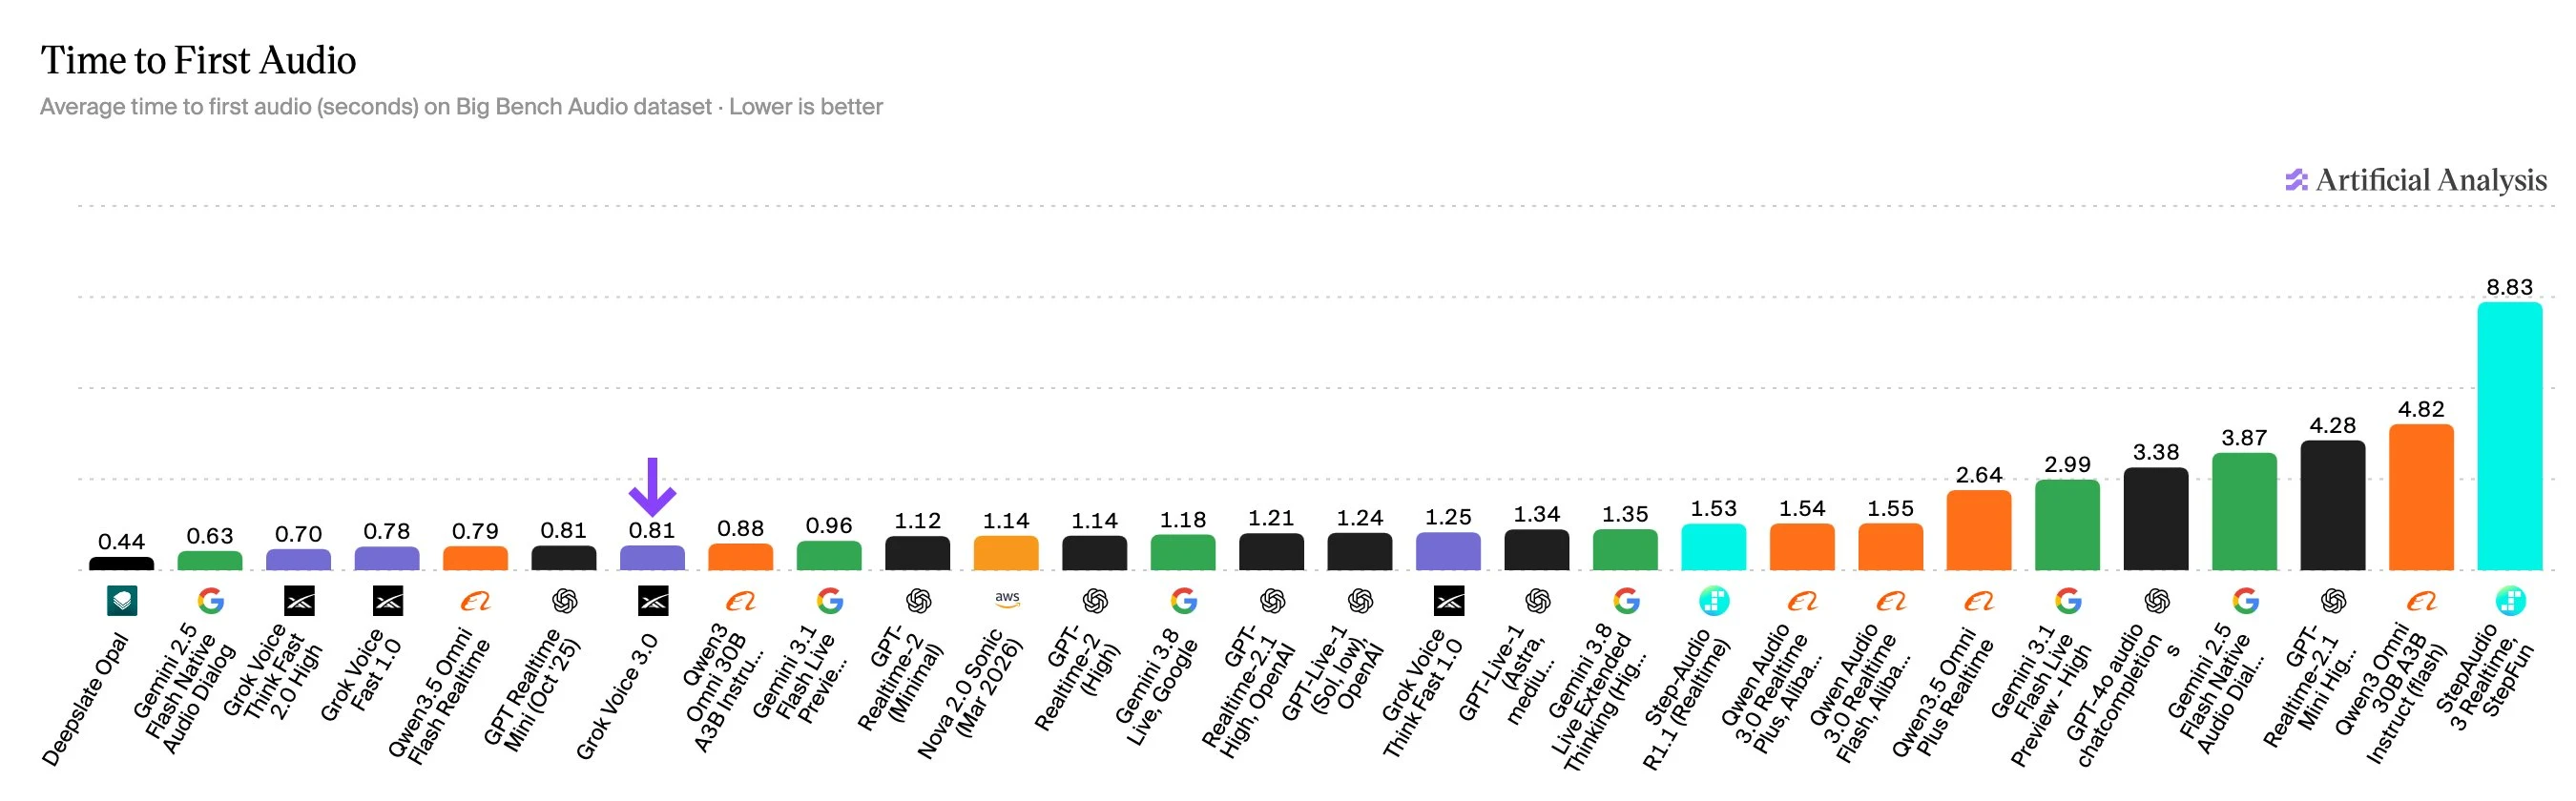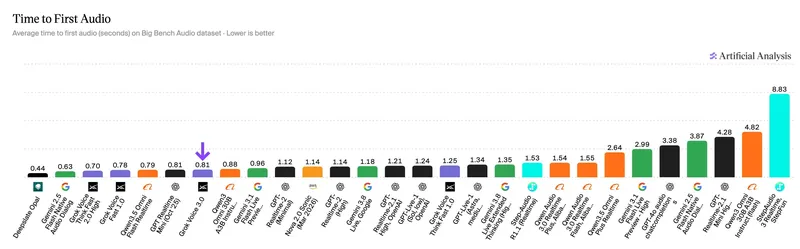
يبلغ متوسط زمن الوصول لأول صوت (Time to First Audio) لنموذج Grok Voice 3.0 في معيار Big Bench Audio حوالي 0.81 ثانية، أي أسرع بنحو 40% من GPT-Live-1 (Astra, medium) (1.34s) وGemini 3.8 Live Extended Thinking (High) (1.35s)، وهما النموذجان التاليان في مؤشرنا Speech to Speech Index، ويأتي خلف Grok Voice 2.0 مباشرة عند 0.70 ثانية. هذا يجعله متقدمًا بكثير على GPT-Live-1 (Sol, low) (1.24s)، حيث يُعد Grok Voice 3.0 وGrok Voice 2.0 النموذجين الوحيدين ضمن أعلى 5 في مؤشرنا Speech to Speech Index اللذين يقل زمنهما عن 1 ثانية.