

تريد Google أن يكون Gemini 4 Argon نموذج الذكاء الاصطناعي الوحيد الذي تحتاجه الروبوتات
 جوناثان كيمبر
عرض ملف Jonathan Kemper على LinkedIn
15 أكتوبر 2026
 Google Deepmind
النقاط الرئيسية
- Gemini 4 Argon هو محاولة Google لإنشاء نموذج ذكاء اصطناعي واحد يتحكم في الروبوتات، ويولّد بيئات تدريب 3D تفاعلية، ويقيّم بيانات التدريب.
- من مدخلات بسيطة مثل الصور أو الرسومات التخطيطية، يبني النظام محاكيات يمكن للروبوتات التدرب على الحركات فيها قبل النشر في العالم الحقيقي.
- لا تزال العروض التوضيحية تتطلب موجّهات وتوجيهاً بشرياً مفصلاً. Argon متاح من خلال برامج الوصول المدفوعة للمطورين لدى Google.
من خلال Gemini 4 Argon، تقدم Google نموذجاً واحداً لخط أنابيب الروبوتات بأكمله. فهو يتحكم في الروبوتات، ويبني عوالم تدريب افتراضية، ويقيّم فيديوهات التدريب. لكن أمثلة الموجّهات تكشف مدى الحاجة الكبيرة لا يزال النموذج يضظرها لمساعدة بشرية.
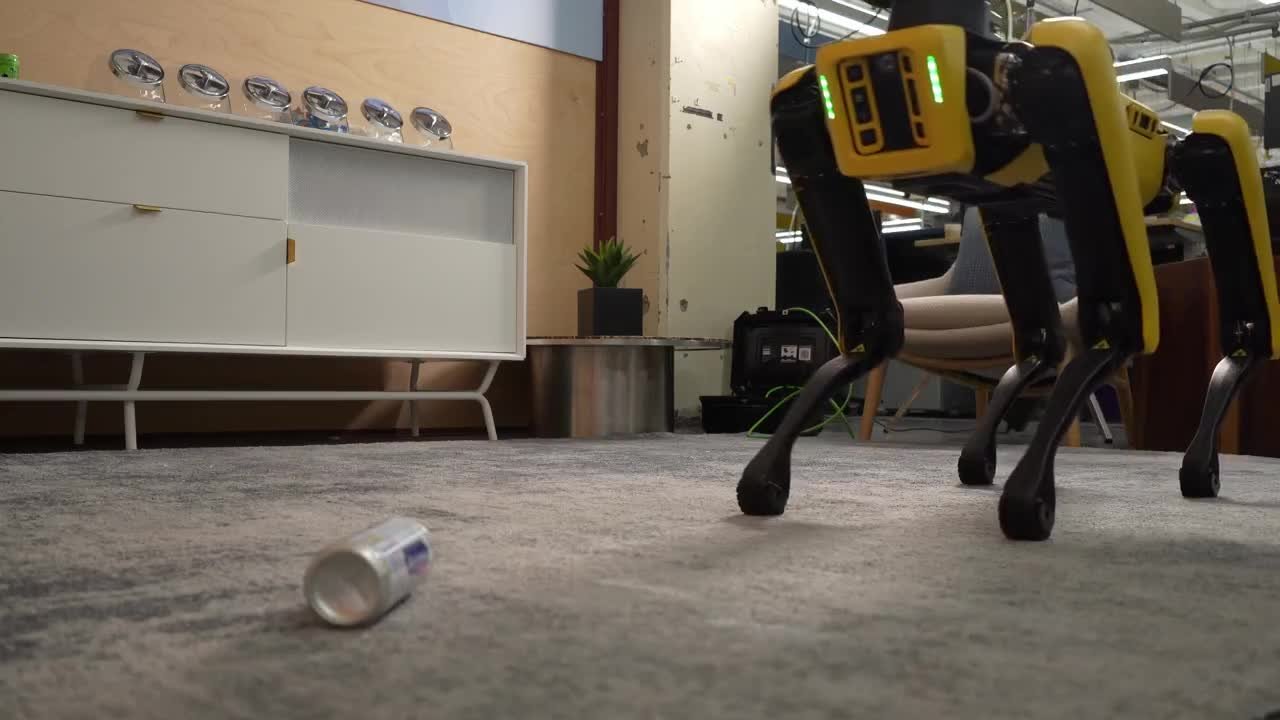
من المفترض أن يقوم روبوت Spot من Boston Dynamics برمي علب المشروبات الغازية في سلة مهملات تعمل بالدوس. وقبل أن يضغط الدواسة الحقيقية، يبني Gemini 4 Argon نسخة افتراضية من السلة، ويتدرب الروبوت على التوازن على ثلاث أرجل داخل تلك المحاكاة. عندها فقط يحاول أداء المهمة على العتاد الحقيقي. وقبل أن يُسقط العلبة، يتحقق وكيلان إضافيان من الذكاء الاصطناعي من أن القدم والقبضة في الموضع الصحيح.
هكذا تعرض Google قدرات أحدث نماذجها لمهام الروبوتات. صُمم Argon لفهم العلاقات المكانية بشكل أفضل، وكتابة أكواد التحكم، وتفسير الفيديوهات من حيث الفيزياء. وترى Google أن النموذج أداة متعددة الأغراض تغطي كل شيء من التحكم في روبوتات فردية إلى إعادة إنتاج أبحاث منشورة، وتصفه بأنه خطوة أخرى نحو "الذكاء الاصطناعي العام المادي"، وهو هدف سعت إليه هي وشركتها الفرعية للذكاء الاصطناعي DeepMind منذ سنوات.

صورة واحدة تتحول إلى آلاف جولات التدريب
يتبع عرض Spot نمطاً يتكرر في كثير من أمثلة Google: يستخدم Argon المحاكيات لإعداد المهام أو التحقق منها أو توليد بيانات التدريب. فمن صورة واحدة لطاولة عليها أدوات حفلة، بنى النموذج نسخة افتراضية، بما في ذلك قبعة قطيفة ناعمة. وقد توصل إلى 77 مهمة، من إعادة الوقوف للأشياء المقلوبة إلى تنظيف الطاولة، وولّد أكثر من 4,500 حلقة تدريب لنموذج تحكم. وعند الاختبار على الروبوت الحقيقي، ارتفع معدل النجاح من 56 إلى 75 بالمئة وانخفض زمن التنفيذ من 35 إلى 24 ثانية.إعلان

يمكن لـ Argon العمل من مصادر أخرى أيضاً. فمن تسجيل لروبوت يعمل بالتحكم عن بُعد، يبني محاكاة مصممة لتبدو مطابقة وتعيد إنتاج نفس قراءات القوة عند أطراف الأصابع. ومن فيديو من منظور الشخص الأول لإنسان يؤدي مهمة إمساك، يربط النموذج حركات اليد والأصابع بإنسان آلي افتراضي بأيادٍ ذات خمسة أصابع.
حتى رسمة بقلم حبر جاف تعمل. فإحدى الرسومات تُظهر روبوتاً إنسانياً أسقط هرماً من الصناديق بكرة، ويحوّل Argon الرسمة إلى محاكاة تحسب حركة رمي لإسقاط الصناديق الستة كلها دون أن يسقط الروبوت.

يوجّه Argon نموذج فيديو ذكاء اصطناعي لتخطيط تصرفات الروبوت
يتكشف أحد العروض التوضيحية بالكامل داخل فيديو مولّد بالذكاء الاصطناعي. Gemini Omni هو نموذج عالم فيديو يولّد مقاطع تُظهر كيف يتغير المشهد عند حدوث شيء فيه، ويعمل Argon كمخرج. فهو يكتب تعليمات موقوتة زمنياً تصف ما يجب أن تفعله الأيدي، مثل تحريك بلاطة سكرابل إلى منتصف الطاولة. يولّد Gemini Omni فيديو من تلك التعليمات، ثم يفحص Argon الإطارات الفردية ويعدّل الأمر التالي. الهدف هو ترتيب خمس بلاطات حروف متناثرة لهجاء "ARGON"، وبعد 33 خطوة، تكون في الترتيب الصحيح.

في عرض توضيحي منفصل باستخدام ذراع روبوتية بسيطة، كان على Argon أن يضع قطعة ليغو داخل صندوق خشبي وأن يحسّن أدائه مع مرور الوقت. عندما فشلت المحاولات، كانت التعليمات توجّه Argon إلى مراجعة سجلاته وصور الكاميرا، وإيجاد السبب، وإعادة المحاولة بعد تطبيق إصلاح مُتحقق منه. استغرقت المحاولة الأولى أقل من دقيقة بقليل، وكانت الثانية أسرع بكثير عند 23 ثانية، رغم أن القطعة اصطدمت بحافة الصندوق. وفي المحاولة الثالثة، هبطت في المنتصف تمامًا بعد حوالي 17 ثانية. Ad

تريد Google أيضًا أن يخدم Argon الأبحاث. عند إعطائه تعليمة واحدة لكل ورقة علمية، يعيد إنشاء تجارب الروبوتات المنشورة كمحاكاة تفاعلية تعمل في المتصفح. تقول Google إنه حتى الآن تم بناء 68 من هذه البيئات التجريبية، منها كرة القدم الروبوتية وروبوت بشري على لوح تزلج.
إن معيار ERQA (Embodied Reasoning Question Answering) يختبر مدى قدرة نماذج الذكاء الاصطناعي على فهم وحل المشكلات الفيزيائية والمكانية في بيئات 3D. استخدم الاختبار 400 سؤال دون أدوات مساعدة، فكان على النماذج حل كل شيء بالاستدلال وحده. سجّل Argon وفقًا لـ Google نسبة 87 بالمئة، متقدمًا على جميع النماذج الحدودية الأخرى. وجاء في المركز الثاني Claude Opus 5.5 بنسبة 82.3 بالمئة، أي أقل بنحو 5 نقاط مئوية. تبعه GPT-6 Astra بنسبة 81 بالمئة، وتأخر Claude Fable 5.1 عند 74 بالمئة، أي بفارق 13 نقطة.

إن معيار AA-Robotics من Artificial Analysis، الذي نُشر بعد يوم، يحكي قصة مختلفة. في هذا الاختبار، تتحكم النماذج اللغوية مباشرة في ذراع روبوتية حقيقية عبر ثماني مهام، وقد حلّ Argon ثالثًا بـ 55 نقطة من أصل 100، خلف GPT-6 Astra عند 69 وGPT-6.1 Sol عند 65.
يراجع Argon أيضًا جودة بيانات التدريب
إلى جانب التحكم في الروبوتات وبناء المحاكاة، يُقصد بـ Argon تقييم بيانات التدريب. في فيديو مدته يزيد قليلًا عن دقيقتين يُظهر روبوتًا بذراعين يطوي ثعلبًا من الأوريغامي، يقسّم النموذج التسلسل إلى خطوات فرعية ويحدد حالات التوقف والقبضات الفاشلة. ثم تُوزن تلك المقاطع بدرجة أقل أثناء التدريب. وفي فيديو آخر لإنسان يفرز حلقات، تتبّع Argon أين تتقدم المهمة أو تتوقف أو تتراجع.
عرضت Google أيضًا حالة استخدام أكثر مرحًا مبنية حول لغز الوزن الكلاسيكي. بين اثنتي عشرة كرة متطابقة المظهر، هناك كرة أثقل أو أخف من الباقي. بنى Argon محاكاة بذراعين روبوتيتين وميزان، ويقرأ ميل الميزان من صور الكاميرا وحدها. وهو يجد الكرة الشاذة في ثلاثة وزنات أو أقل.
الهيكل الحقيقي يكمن في التعليمات
نشرت Google تعليمات نموذجية تفصيلية للعروض التوضيحية، وهي تضع بعض الادعاءات الأكبر في منظورها الصحيح. ففي مهمة إعادة الكوب المقلوب إلى وضعه، الموصوفة بأنها "zero-shot"، يتلقى Argon صورة كاميرا مع تراكب شبكة بالسنتيمترات وأوامر جاهزة مثل "grasp" أو "lower until contact". وفي المحاكاة، توجد قوائم طويلة من المحظورات لمنع النموذج من اتخاذ طرق مختصرة، مثل مجرد نسخ قيم المستشعرات المقاسة. لا تشارك Google معدلات الفشل للعروض الفردية في التدوينة، ونسبة النجاح البالغة 75 بالمئة ترد دون أي ذكر لعدد المحاولات الكلي التي استندت إليها.

يتوفر Argon الآن في Google AI Studio وبيئة التطوير Antigravity، ولكن لمشتركي Google AI Ultra فقط. ويمكن للمطورين أيضًا الوصول إلى النموذج عبر الفئة المدفوعة من Gemini API.
وقد أطلقت Google Gemini 4 Argon عالميًا قبل أيام فقط. وفي مجال الروبوتات، كانت الشركة قد قدّمت بالفعل Gemini Robotics-ER 1.6، وهو نموذج للإدراك المكاني وتخطيط المهام. والتدريب في البيئات الافتراضية ليس جديدًا أيضًا: فالشركة الناشئة World Labs أظهرت كيف يمكن تحويل مشاهد واقعية إلى عوالم تدريب افتراضية، بينما محاكي DreamDojo من Nvidia يحاكي أفعال الروبوتات على شكل مقاطع فيديو. ما يميز نهج Google هو الطموح إلى التعامل مع المحاكاة والتحكم والتقييم كلها بالنموذج نفسه.
أخبار الذكاء الاصطناعي بلا ضجيج – بانتقاء بشري
اشترك في THE DECODER للحصول على قراءة خالية من الإعلانات، ونشرة أسبوعية عن الذكاء الاصطناعي، وتقريرنا الحصري "AI Radar" عن الموجة المتقدمة ست مرات في السنة، ووصول كامل إلى الأرشيف، وإلى قسم التعليقات.
المصدر: جوجل