
أبرز النقاط
- المعمارية: 816B معامل إجمالية، مع 42B نشطة لكل رمز (token) ونافذة سياق بطول 1M.
- التكميم: أصدرت Meta النموذج بصيغتي BF16 وNVFP4. وأصدرت AMD أوزان MXFP4.
- تعدد الوسائط: إدراك أصلي للصور والفيديو عبر نفس Perception Encoder المستخدم في Muse Glimmer، مع دعم إضافي للصوت.
- التوازي: توازي الموترات (Tensor Parallelism) وتوازي الأنابيب (Pipeline Parallelism) على كل من Nvidia وAMD. وEP وTEP وDEP وفصل PD على Nvidia. كما يتوفر دعم أولي على TPU.
- فك الترميز التخميني: قمنا بتدريب نموذج مسودة DSpark، مدعوم على كل من CUDA وROCm، يسرّع أداء النموذج، وتم اختباره على معيار SPEED.
الاستخدام
تتوفر صور جاهزة (prebuilt) للشركتين:
- Nvidia: vllm/vllm-openai:muse-spark-open
- AMD: vllm/vllm-openai-rocm:muse-spark-open
لاحظ أن النموذج لن يكون متاحًا عبر حزمة PyPI الليلية (nightly wheel) إلا بعد مراجعة الكود (PR #61879) ودمجه، وهو ما يستغرق عادةً حوالي أسبوع.
# Rust frontend is recommended
export VLLM_USE_RUST_FRONTEND=1

vllm serve meta-models/Muse-Spark-Open-816B-A42B-NVFP4 \
    --tensor-parallel-size 8 \
    --enable-expert-parallel \
    --max-model-len 1048576 \
    --reasoning-parser muse \
    --tool-call-parser muse \
    --enable-auto-tool-choice \
    --speculative-config '{"method":"dspark","model": "Inferact/Muse-Spark-Open-DSpark","num_speculative_tokens":7,"draft_sample_method":"probabilistic","rejection_sample_method":"block","enable_adaptive_verification":true}'
لاستخدام هذا النموذج مع نص عادي:
  curl http://localhost:8000/v1/chat/completions \
    -H 'Content-Type: application/json' \
    -d '{
      "model": "meta-models/Muse-Spark-Open-816B-A42B-NVFP4",
      "messages": [{"role": "user", "content": "Refactor this module."}],
      "reasoning_effort": "xhigh"
    }'
للإدراك متعدد الوسائط:
 curl http://localhost:8000/v1/chat/completions \
   -H 'Content-Type: application/json' \
   -d '{
     "model": "meta-models/Muse-Spark-Open-816B-A42B",
     "messages": [{"role": "user", "content": [
       {"type": "image_url", "image_url": {"url": "https://example.com/screenshot.png"}},
       {"type": "video_url", "video_url": {"url": "https://example.com/demo.mp4"}},
       {"type": "audio_url", "audio_url": {"url": "https://example.com/clip.wav"}},
       {"type": "text",      "text": "What is happening here, and when?"}
     ]}]
   }'
تفاصيل التنفيذ
معمارية النموذج
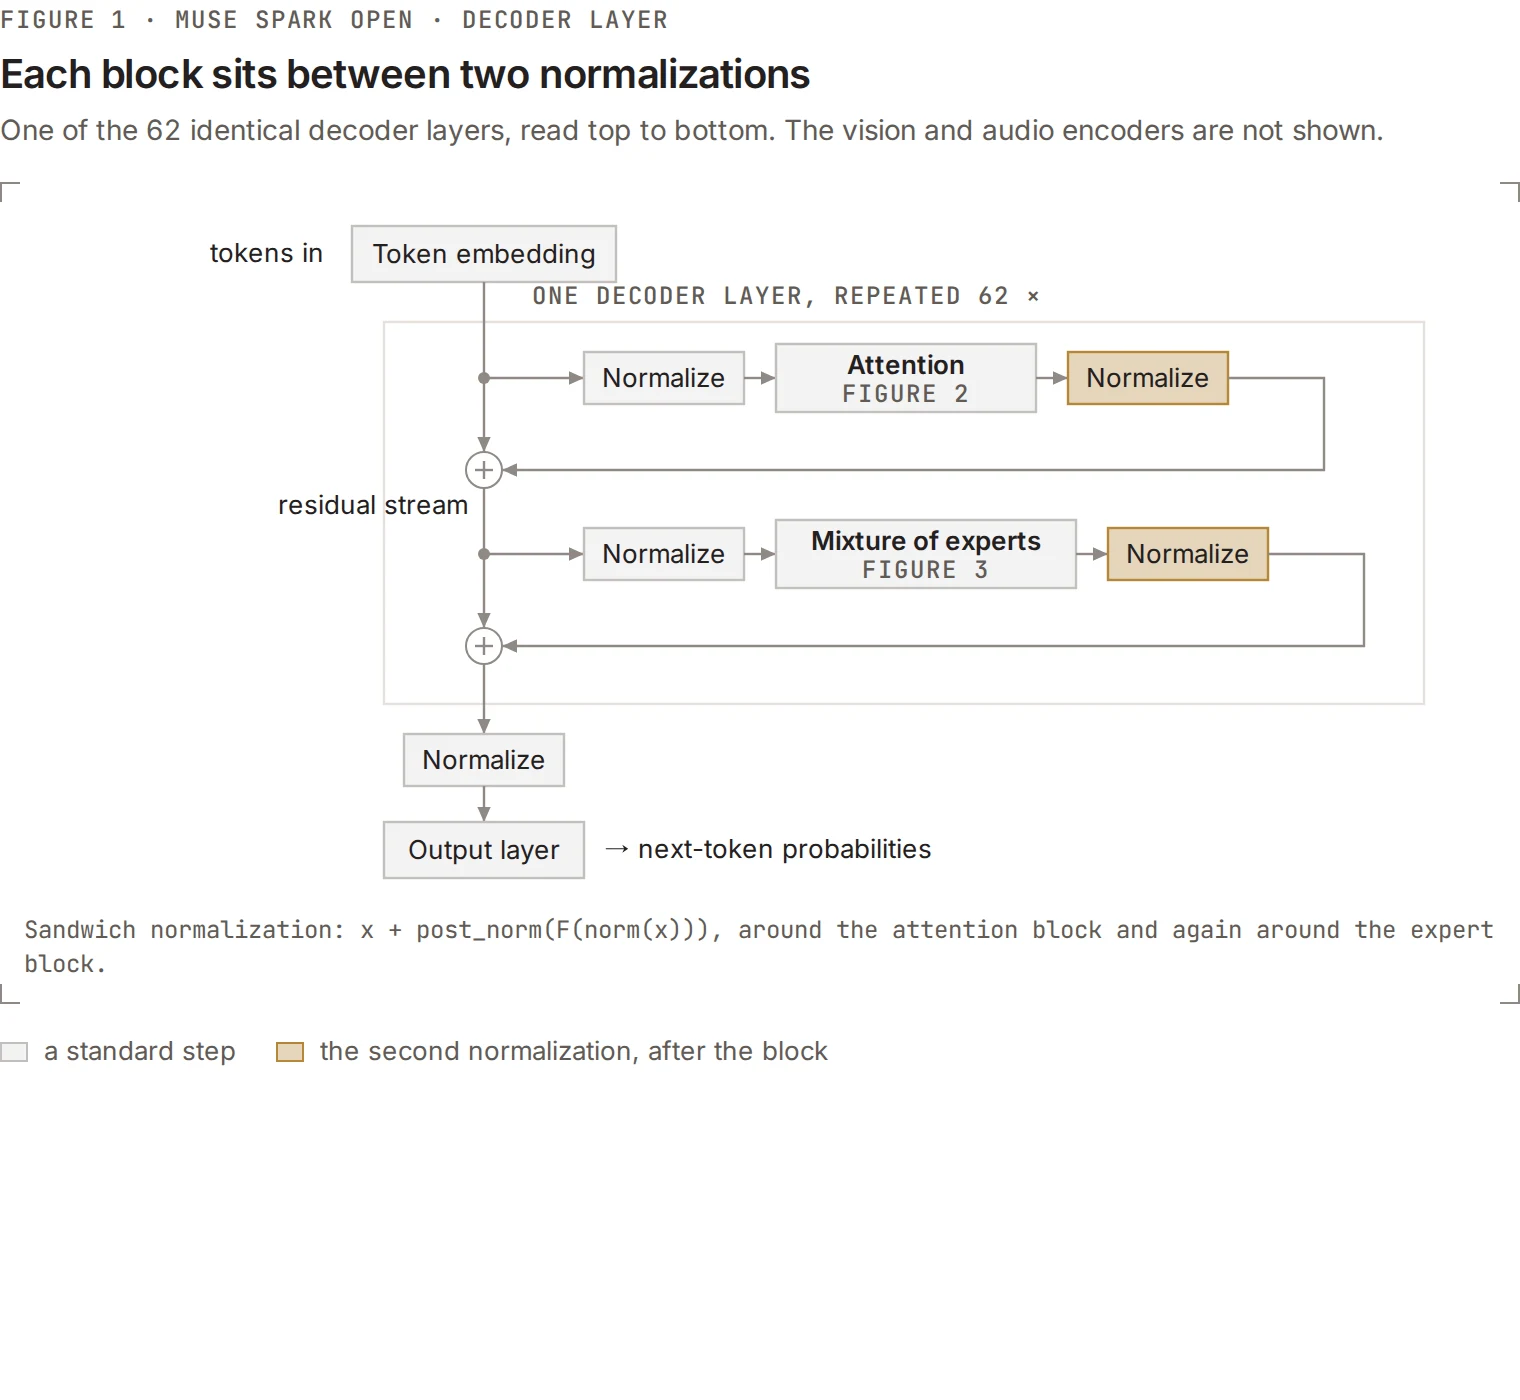
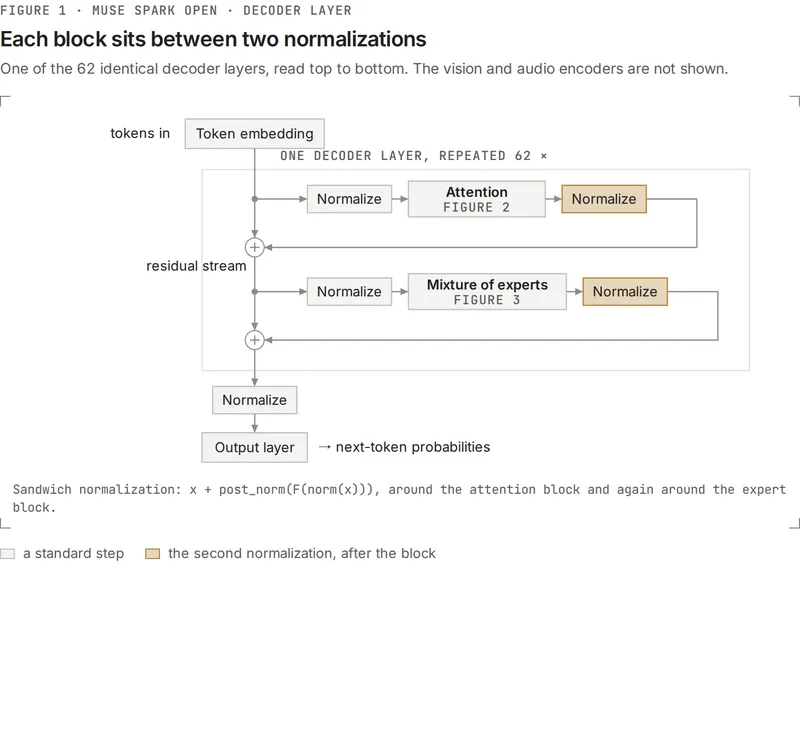
Muse Spark Open هو نموذج خليط الخبراء (mixture-of-experts) بـ 816B معامل إجمالية تشمل فك ترميز النص، بالإضافة إلى مشفر رؤية بحجم 2B ومشفر صوتي صغير بجانبه. يضم فك الترميز 62 طبقة، وكل واحدة منها طبقة خليط خبراء. وهنا توجد الأوزان:
| الجزء | الحجم |
|---|---|
| 256 خبيرًا لكل طبقة | 799 B |
| الانتباه (attention) | 13.5 B |
| إسقاطات MoE الكامنة | 4.2 B |
| طبقة التضمين وطبقة الإخراج | 3.3 B |
| برج الرؤية (منفصل) | 1.9 B |
بنية النموذج مشابهة لـ Muse Glimmer. لمن لم يستخدموا Muse Glimmer، هناك بعض الأمور في بنية هذا النموذج تستحق نظرة فاحصة.
تطبيع الساندويتش. معظم أجهزة فك الترميز تضع طبقة تطبيع واحدة قبل كل كتلة، بما يعطي x + F(norm(x)) بينما Muse Spark Open، مثل Muse Glimmer، يضع واحدة قبل وأخرى بعد، كشريحتي ساندويتش مع الكتلة في المنتصف، بما يعطي x + post_norm(F(norm(x)))
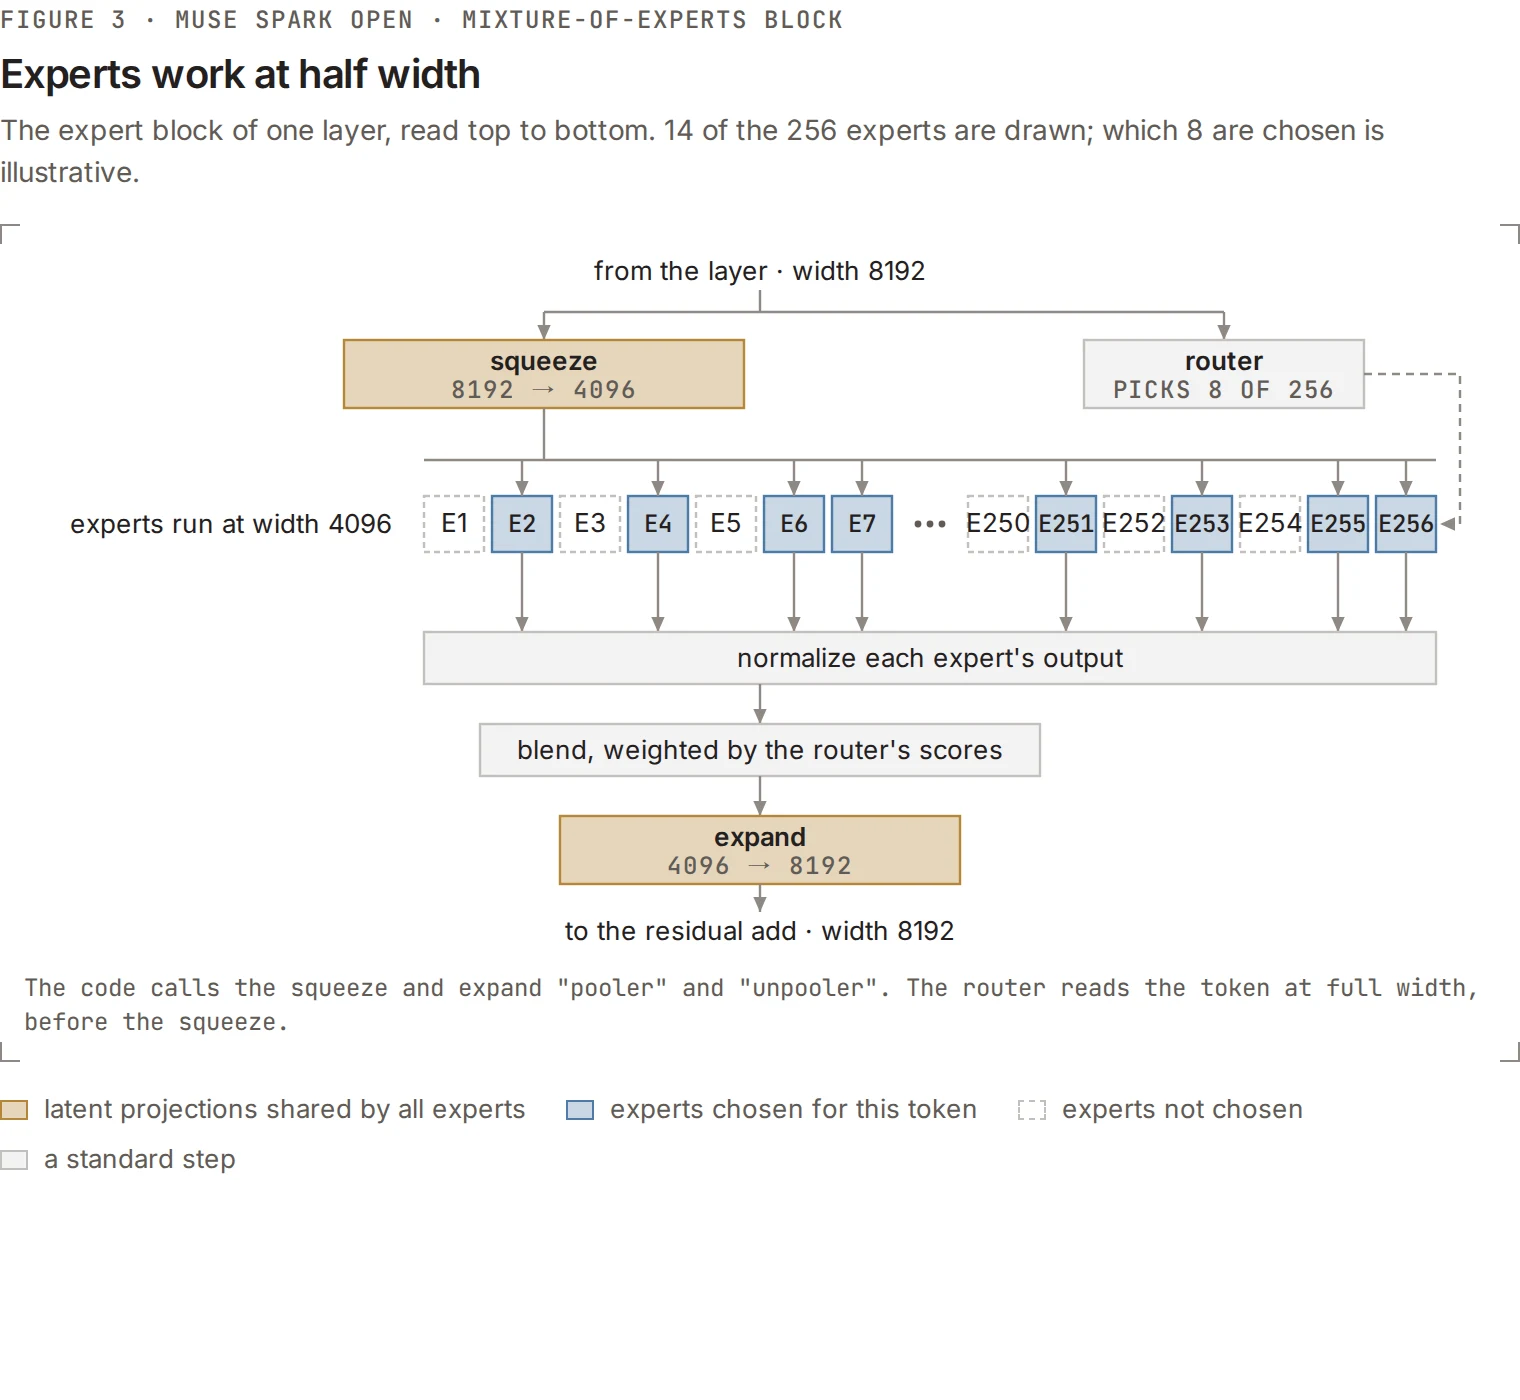
MoE الكامن. تحمل كل طبقة مزيج الخبراء (MoE) مصفوفتين إضافيتين مشتركتين بين جميع الخبراء الـ 256 في تلك الطبقة. يسمي الكود هاتين المصفوفتين pooler وunpooler، على الرغم من أن أيًّا منهما لا يجمع بيانات بالمعنى المعتاد؛ بل كلاهما إسقاطان متعلَّمان لضغط الأبعاد وتوسيعها. الـ pooler مصفوفة 8192 × 4096 تُنصِّف عرض كل رمز قبل وصوله إلى الخبراء؛ بينما يعيد الـ unpooler العرض الكامل بعدها. وبالتالي يعمل الخبراء تمامًا عند 4096 بدلًا من 8192، مما خفّض فعليًا إلى النصف عدد المعاملات المطلوبة في طبقتي إسقاط الخبراء.
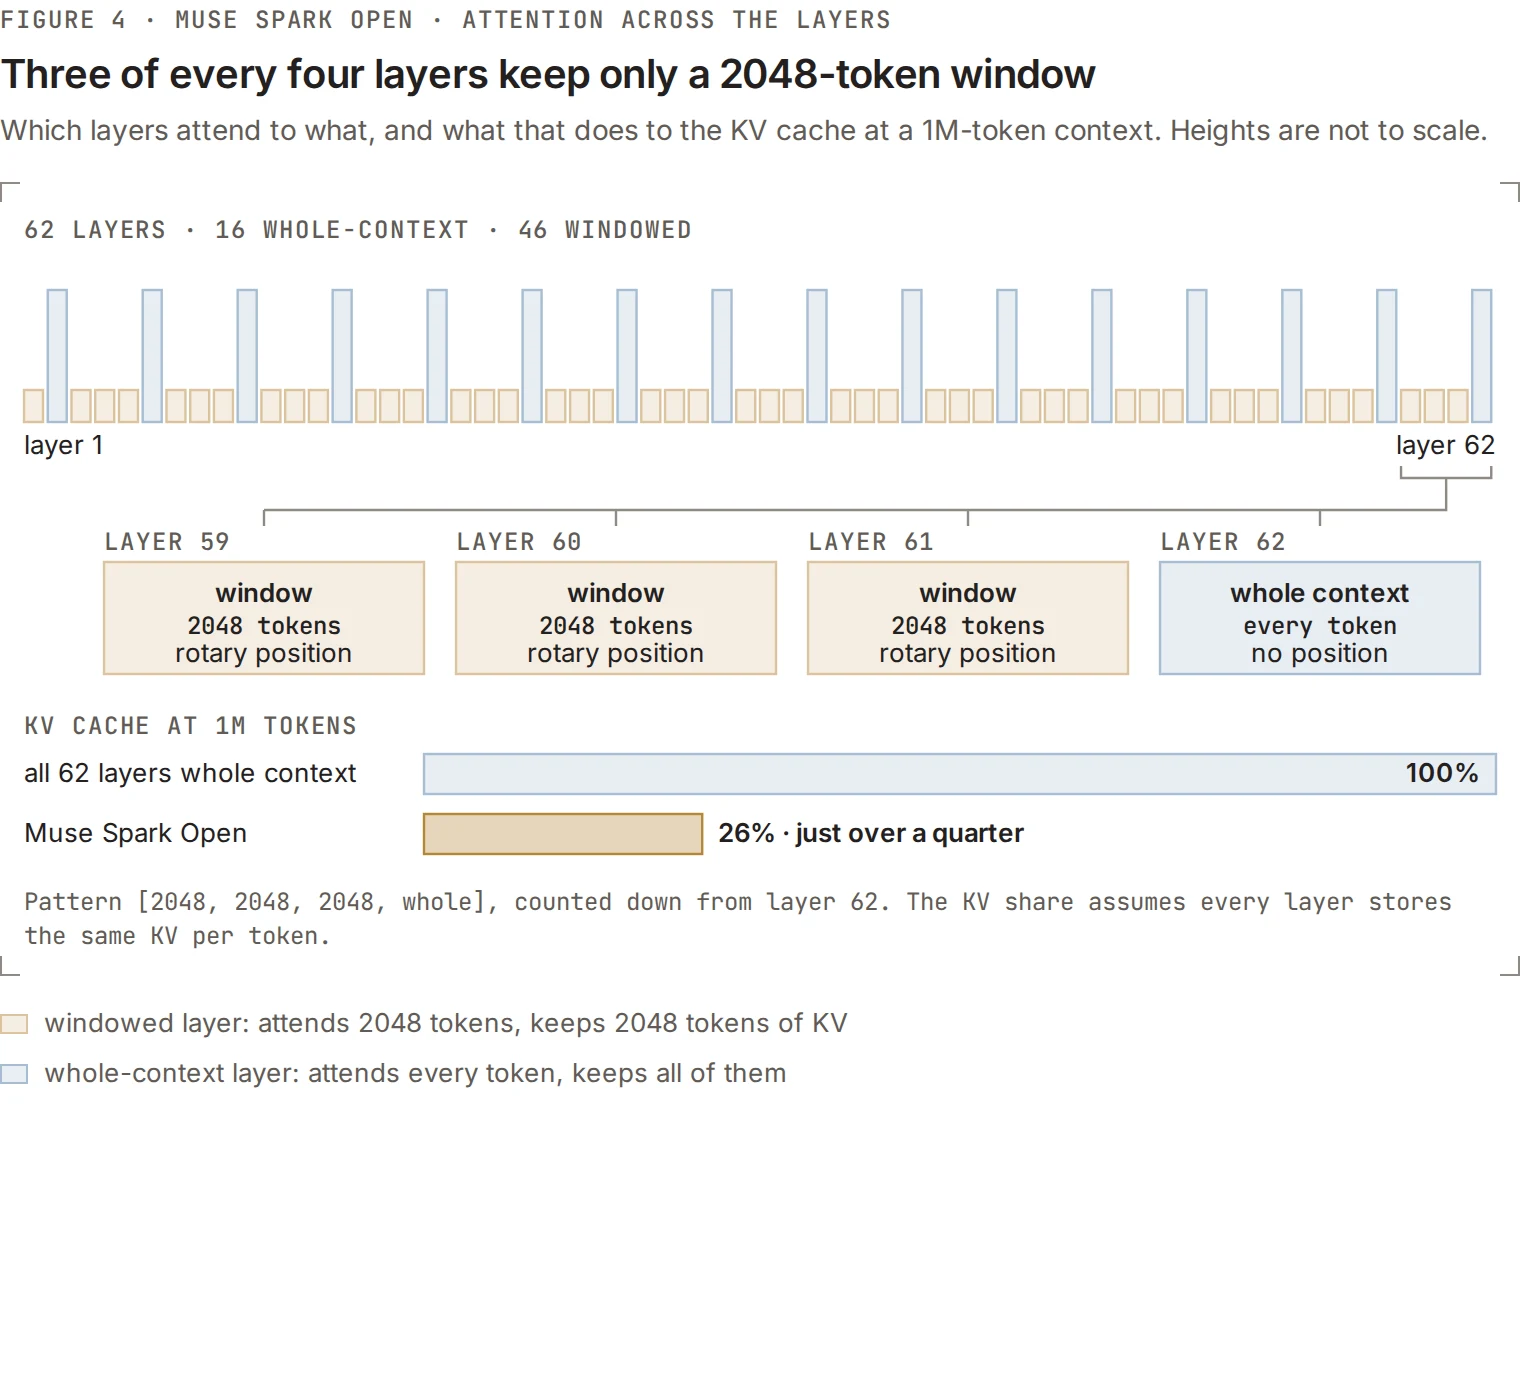
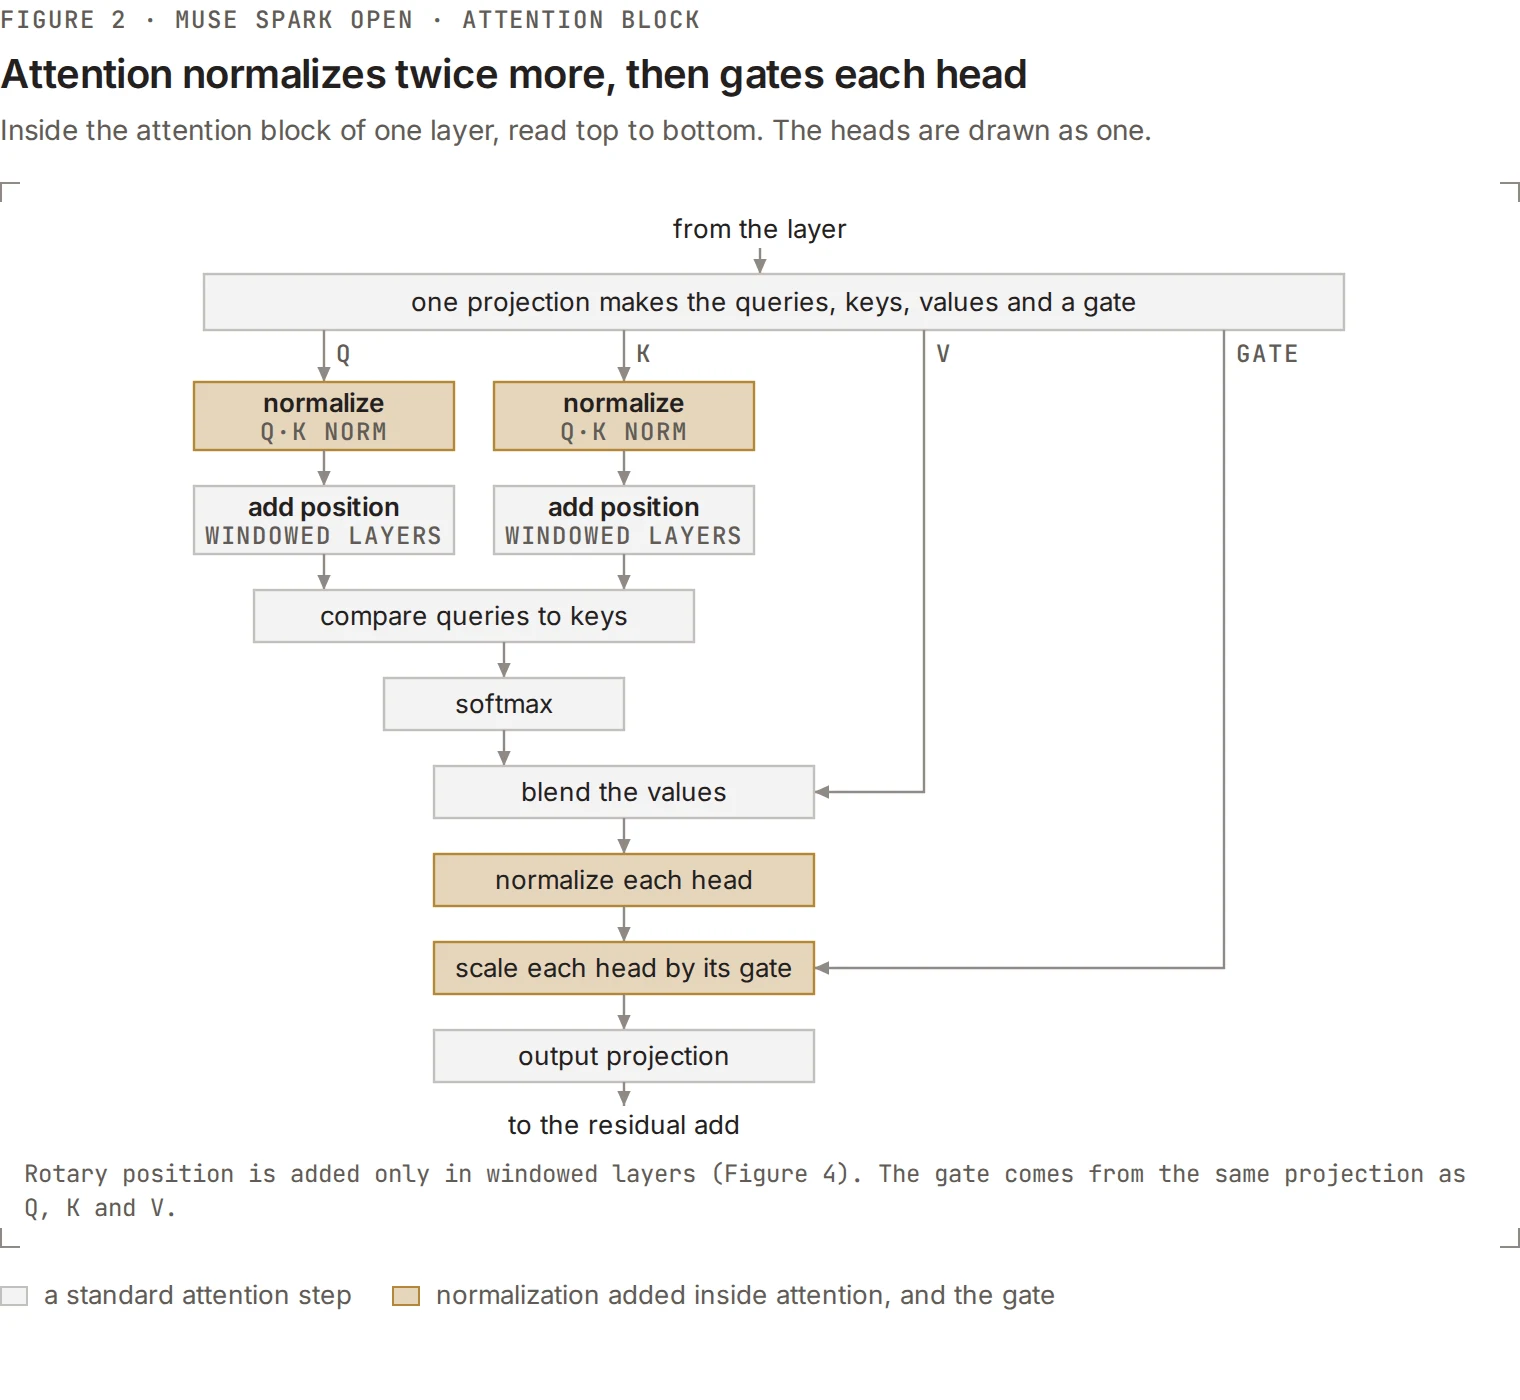
انتباه هجين. تتناوب الطبقات بين الانتباه الكامل والانتباه ذي النافذة المنزلقة (SWA) في دورة متكررة من 4 حيث تحضر ثلاث طبقات إلى نافذة من 2048 رمزًا وتنظر الرابعة إلى السياق بأكمله. ترتبط الدورة بنهاية المكدس بحيث تكون الطبقة الأخيرة دائمًا طبقة انتباه كامل. عبر 62 طبقة، يعطي ذلك 46 طبقة ضيقة و16 واسعة، حيث تحفظ الطبقات الضيقة فقط KV الحديثة. عند 1M من الرموز، يُجلب هذا ذاكرة التخزين المؤقت إلى ما يزيد قليلًا عن ¼ مما يحتاجه الانتباه الكامل بالكامل. هذا ما يجعل طول سياق 1M رمز في المتناول.
مُرمِّز الرؤية. يستخدم Muse Spark Open نفس Perception Encoder المستخدم في Muse Glimmer، وهو برج بمعاملات 2B يقرأ الصور بدقتها الأصلية بدلًا من تغيير حجمها إلى مربع. وتُمرَّر الفيديوهات عبر نفس المُرمِّز: تُؤخذ الإطارات في وقت التحميل كسلسلة إطارات فيديو مُعيَّنة مع ترميز الطابع الزمني في الموجّه.
مُرمِّز الصوت. يُقرأ الصوت كموجة خام بمعدل 24 كيلوهرتز، وكل 1920 عينة، أي 80 مللي ثانية، تصبح رمزًا واحدًا عبر سلسلة من التحويلات. مُرمِّز الصوت بأكمله يبلغ 118M معامل فقط. لاحظ أن المسار الصوتي للفيديو لا تتم معالجته. لإعطاء النموذج صور المقطع وصوته معًا، أرسل الفيديو والصوت المستخرج كجزأين محتويين منفصلين في الطلب نفسه.
DSpark
لتسريع استدلال Muse Spark Open على vLLM، درّبنا مُوَلِّد افتراضات باستخدام DSpark، وهي خوارزمية فك ترميز تخميني تستخدم الانتشار الكتلي لاقتراح ما يصل إلى سبعة رموز مسودة في تمريرة واحدة. ويساعد الجدولة القائمة على الثقة في الحفاظ على تسريعات كبيرة حتى بأحجام الدفعات الكبيرة، حيث تقدم عادةً طريقة فك الترميز التخميني عوائد متناقصة، كما هو موضح في النتائج أدناه.
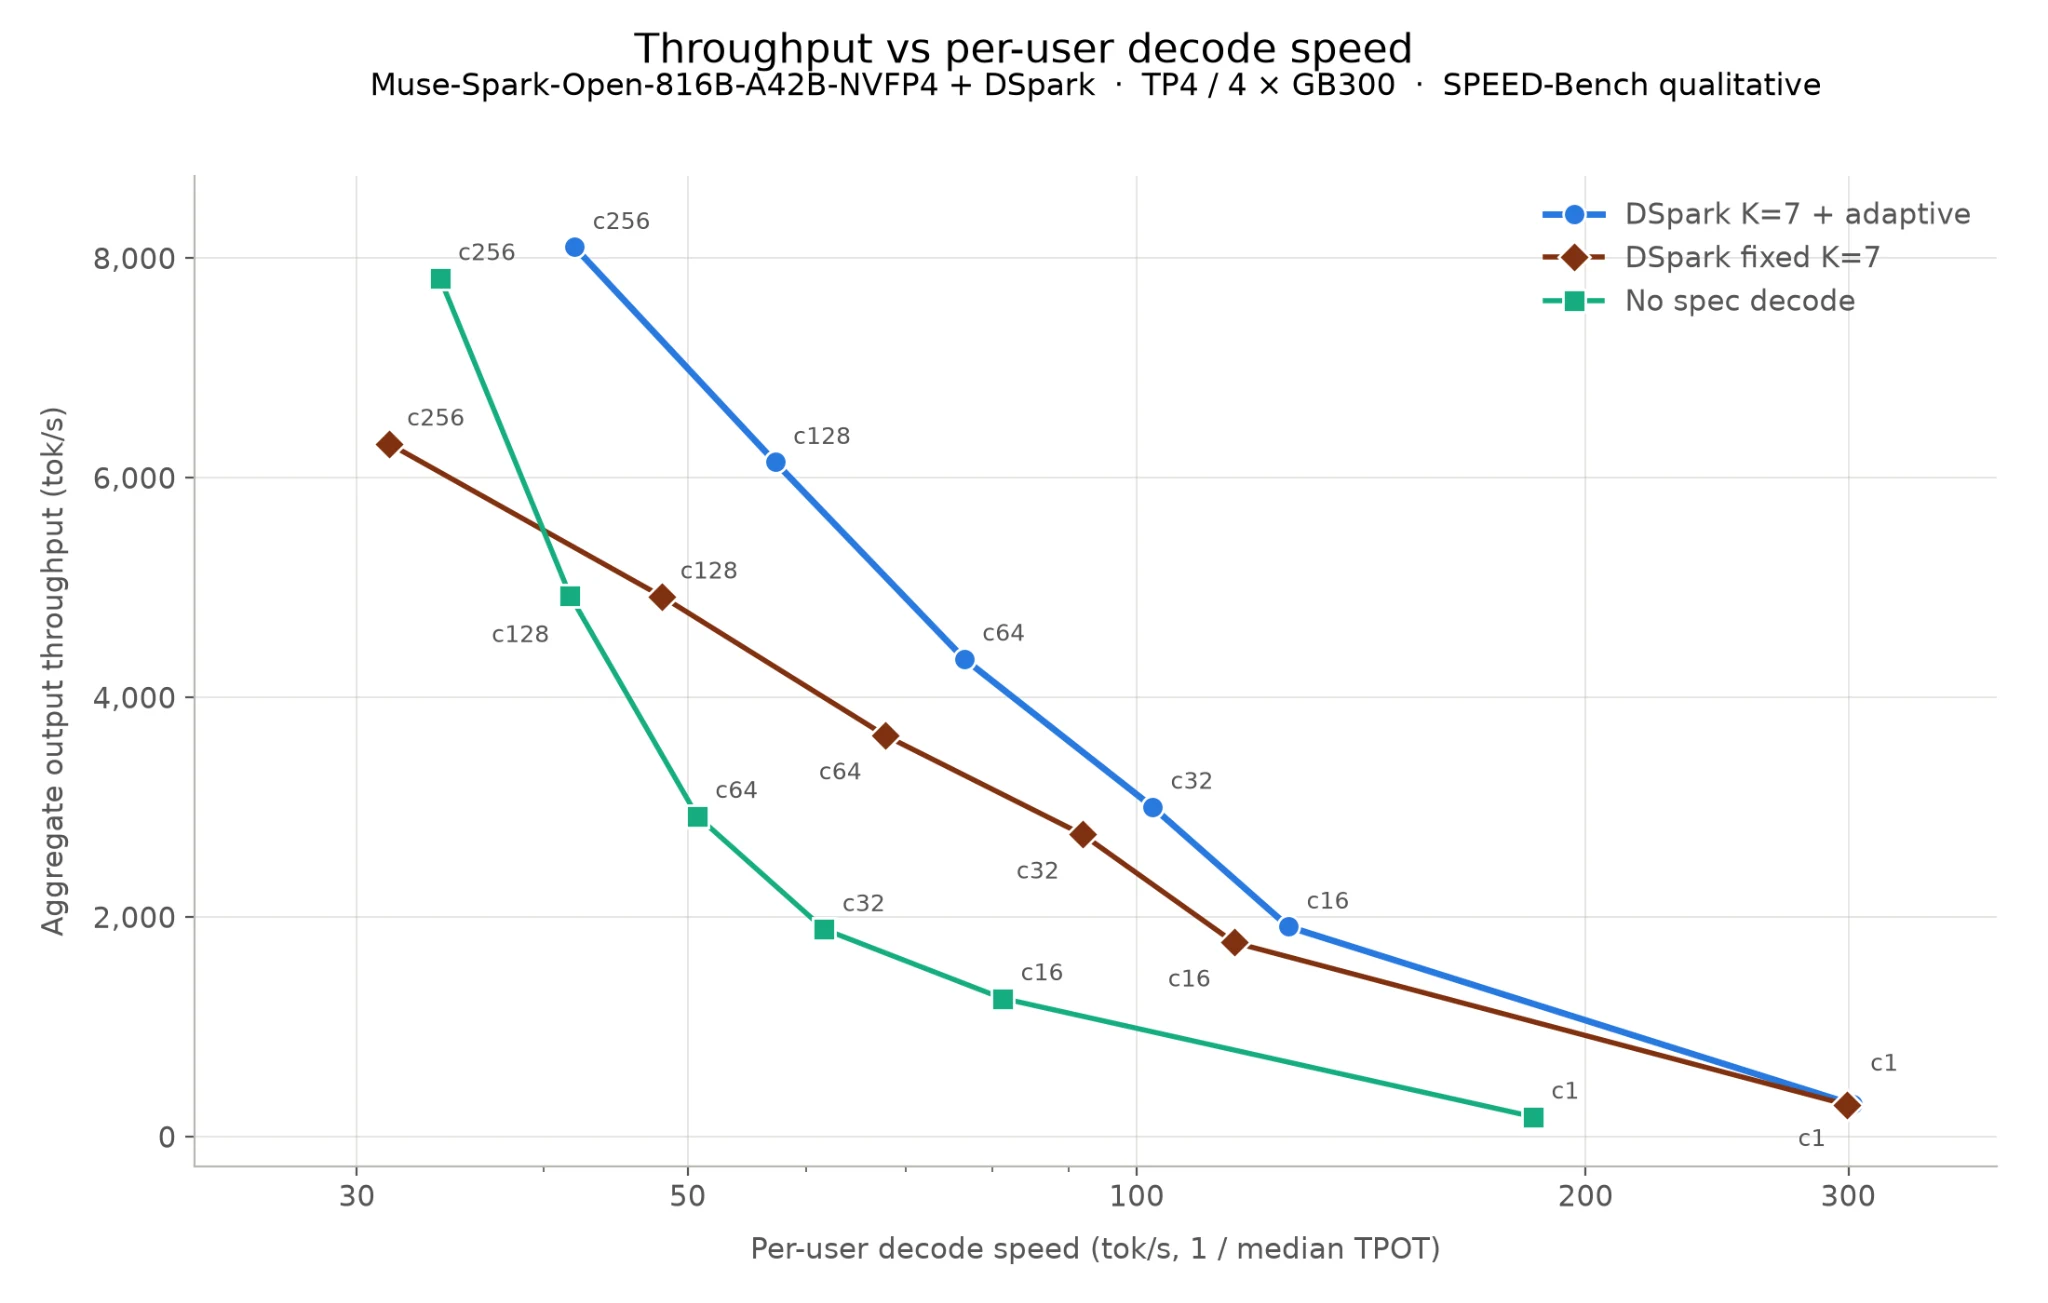
يستخدم المُوَلِّد التخميني أيضًا انتباه النافذة المنزلقة الخاص بـ Muse Spark Open لإبقاء عملية الصياغة خفيفة، حتى مع سياق بحجم 1M رمز. ونتيجةً لهذه الخيارات مجتمعةً، فهو مناسب تمامًا لأحمال الإنتاج التي تمتد عبر مجموعة واسعة من أحجام الدفعات وأطوال السياق.
لتفعيله، أضف هذا عند بدء تشغيل الخادم:
--speculative-config '{"method":"dspark","model": "Inferact/Muse-Spark-Open-DSpark","num_speculative_tokens":7,"draft_sample_method":"probabilistic","rejection_sample_method":"block","enable_adaptive_verification":true}'Nvidia
حسّن فريق Nvidia استدلال Muse Spark Open عبر FlashInfer وvLLM من خلال نوى مدمجة للتطبيع والتوجيه والبواقي؛ ودمج نهائي MoE مع اتصال التوازي الموتري وRMSNorm؛ وتنفيذ جديد لـ BF16 GEMM منخفض الكمون وتقليل عبء التجميع؛ وتقسيم pooler/unpooler لـ TEP مع جمعيات MNNVL مدمجة؛ ومُوجِّه TF32 GEMM يُغذَّى بمخرج التطبيع FP32؛ وتحسينات في حركة البيانات ودعم العتاد وموثوقية وقت التشغيل.
AMD
بفضل فريق AMD، دعمنا أيضًا النموذج على وحدات معالجة الرسومات AMD Instinct™ MI355X، بكلٍّ من التنسيقين الكمّيين FP8 وMXFP4، موفّرين أداء استدلال محسّنًا وكفاءة نشر أفضل. يُرجى ملاحظة أن ROCm يدعم حاليًا كلاً من التوازي الموتري والتوازي الأنابيبي.
TPU
أضفنا دعم Muse Spark Open على TPU فوق TorchTPU. يرجى التواصل معنا أو مع Google للحصول على الوصول إلى الكود. كما بنينا megakernels لـ Muse Spark Open. مع فك الترميز التخميني DSpark (طول القبول = 6)، تصل هذه النوى إلى أكثر من 650 رمزًا/ثانية على 4 شرائح TPU v7 وأكثر من 960 رمزًا/ثانية على 8 شرائح. بدون فك الترميز التخميني، لا تزال توفر أكثر من 270 و350 رمزًا/ثانية على التوالي.
التعلم المعزز في vLLM
يدعم vLLM أيضًا LoRA RL على Muse Spark Open منذ اليوم 0، إذ يعمل كمحرك التنفيذ (rollout) مع Verl FSDP2 كمدرب. يقدّم vLLM نقطة فحص NVFP4 الأصلية مع تطبيق مُهايئ LoRA فوقها. يعمل المدرب على إلغاء تكميم BF16 لنفس الأوزان ويحدّث المُهايئ فقط (رتبة 32، ألفا 64)، الذي يغطي الانتباه وإسقاطات MoE الكامنة وجميع الخبراء الموجَّهين. كما يعيد تشغيل توجيه MoE الخاص بالتنفيذ (R3)، ولا يُزامَن سوى المُهايئ مع vLLM بعد كل خطوة.
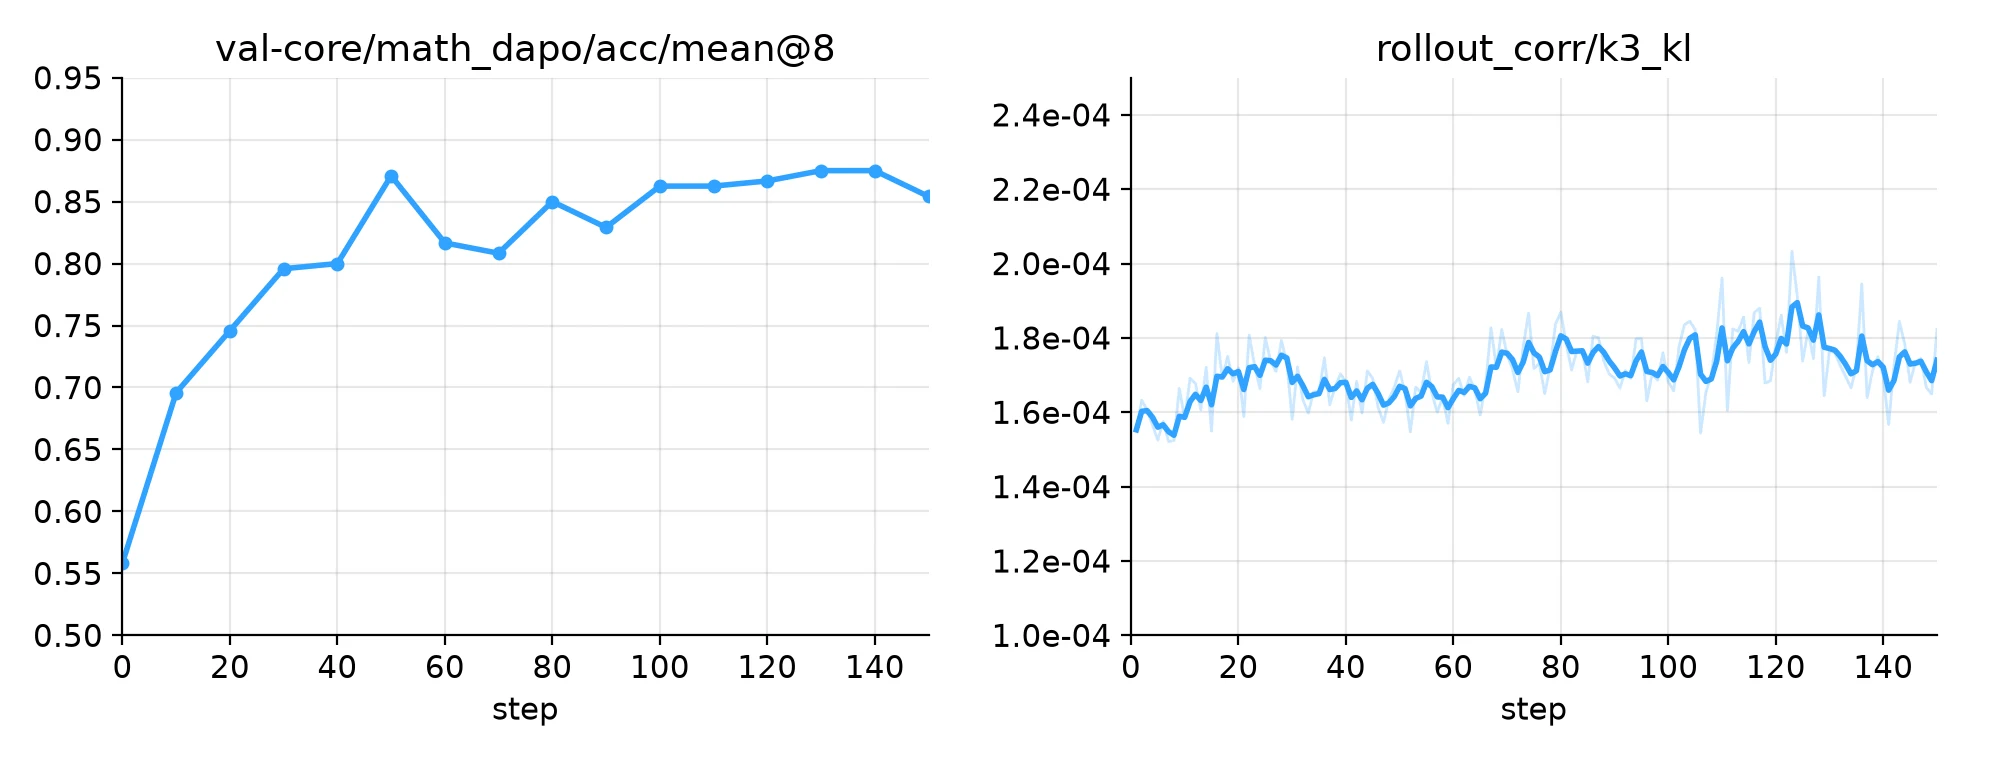
درّبنا باستخدام GRPO على DAPO-Math-17K لمدة 150 خطوة على 16 وحدة GPU من نوع GB300، بأخذ 8 استجابات لكل من 32 موجّهًا في كل خطوة وبما يصل إلى 4K رمز لكل استجابة. انتقلت الدقة على AIME-2024 (mean@8) من 0.56 قبل التدريب إلى 0.85 بحلول نهاية التجربة. على مدار التدريب، بقي الـ k3 KL بين لوغاريتمات الاحتمال لدى المدرب وvLLM قريبًا من 2×10⁻⁴. المزيد من التفاصيل متاحة في https://github.com/verl-project/verl/pull/8257. في منظومة vLLM، يستخدم Titan RL أيضًا vLLM كمحرك rollout لتوفير دعم RL في اليوم 0.
شكر وتقدير
نتوجه بخالص الشكر لفرق Meta Superintelligence Labs ومجتمع vLLM على تعاونهما الوثيق في توفير دعم Day 0 لنموذج Muse Spark Open على vLLM. كما نشكر Inferact على تدريب DSpark speculator وتكامل TPU، إلى جانب NVIDIA وAMD على تحسيناتهما الحيوية للعتاد.
المساهمون:
- Inferact: Jie Li, Zifeng Mo, Zixi Qi, Jeff Ma, Ziqi Zhao, Dakai An, Ao Shen
- Meta: Beto de Paola, Sidhartha Reddy Potu
- Nvidia: Cyrus Chang, Duncan Moss, Marek Pikulski, Seong Hee Lee
- AMD: Andy Luo, Hongxia Yang, Haichen Zhang