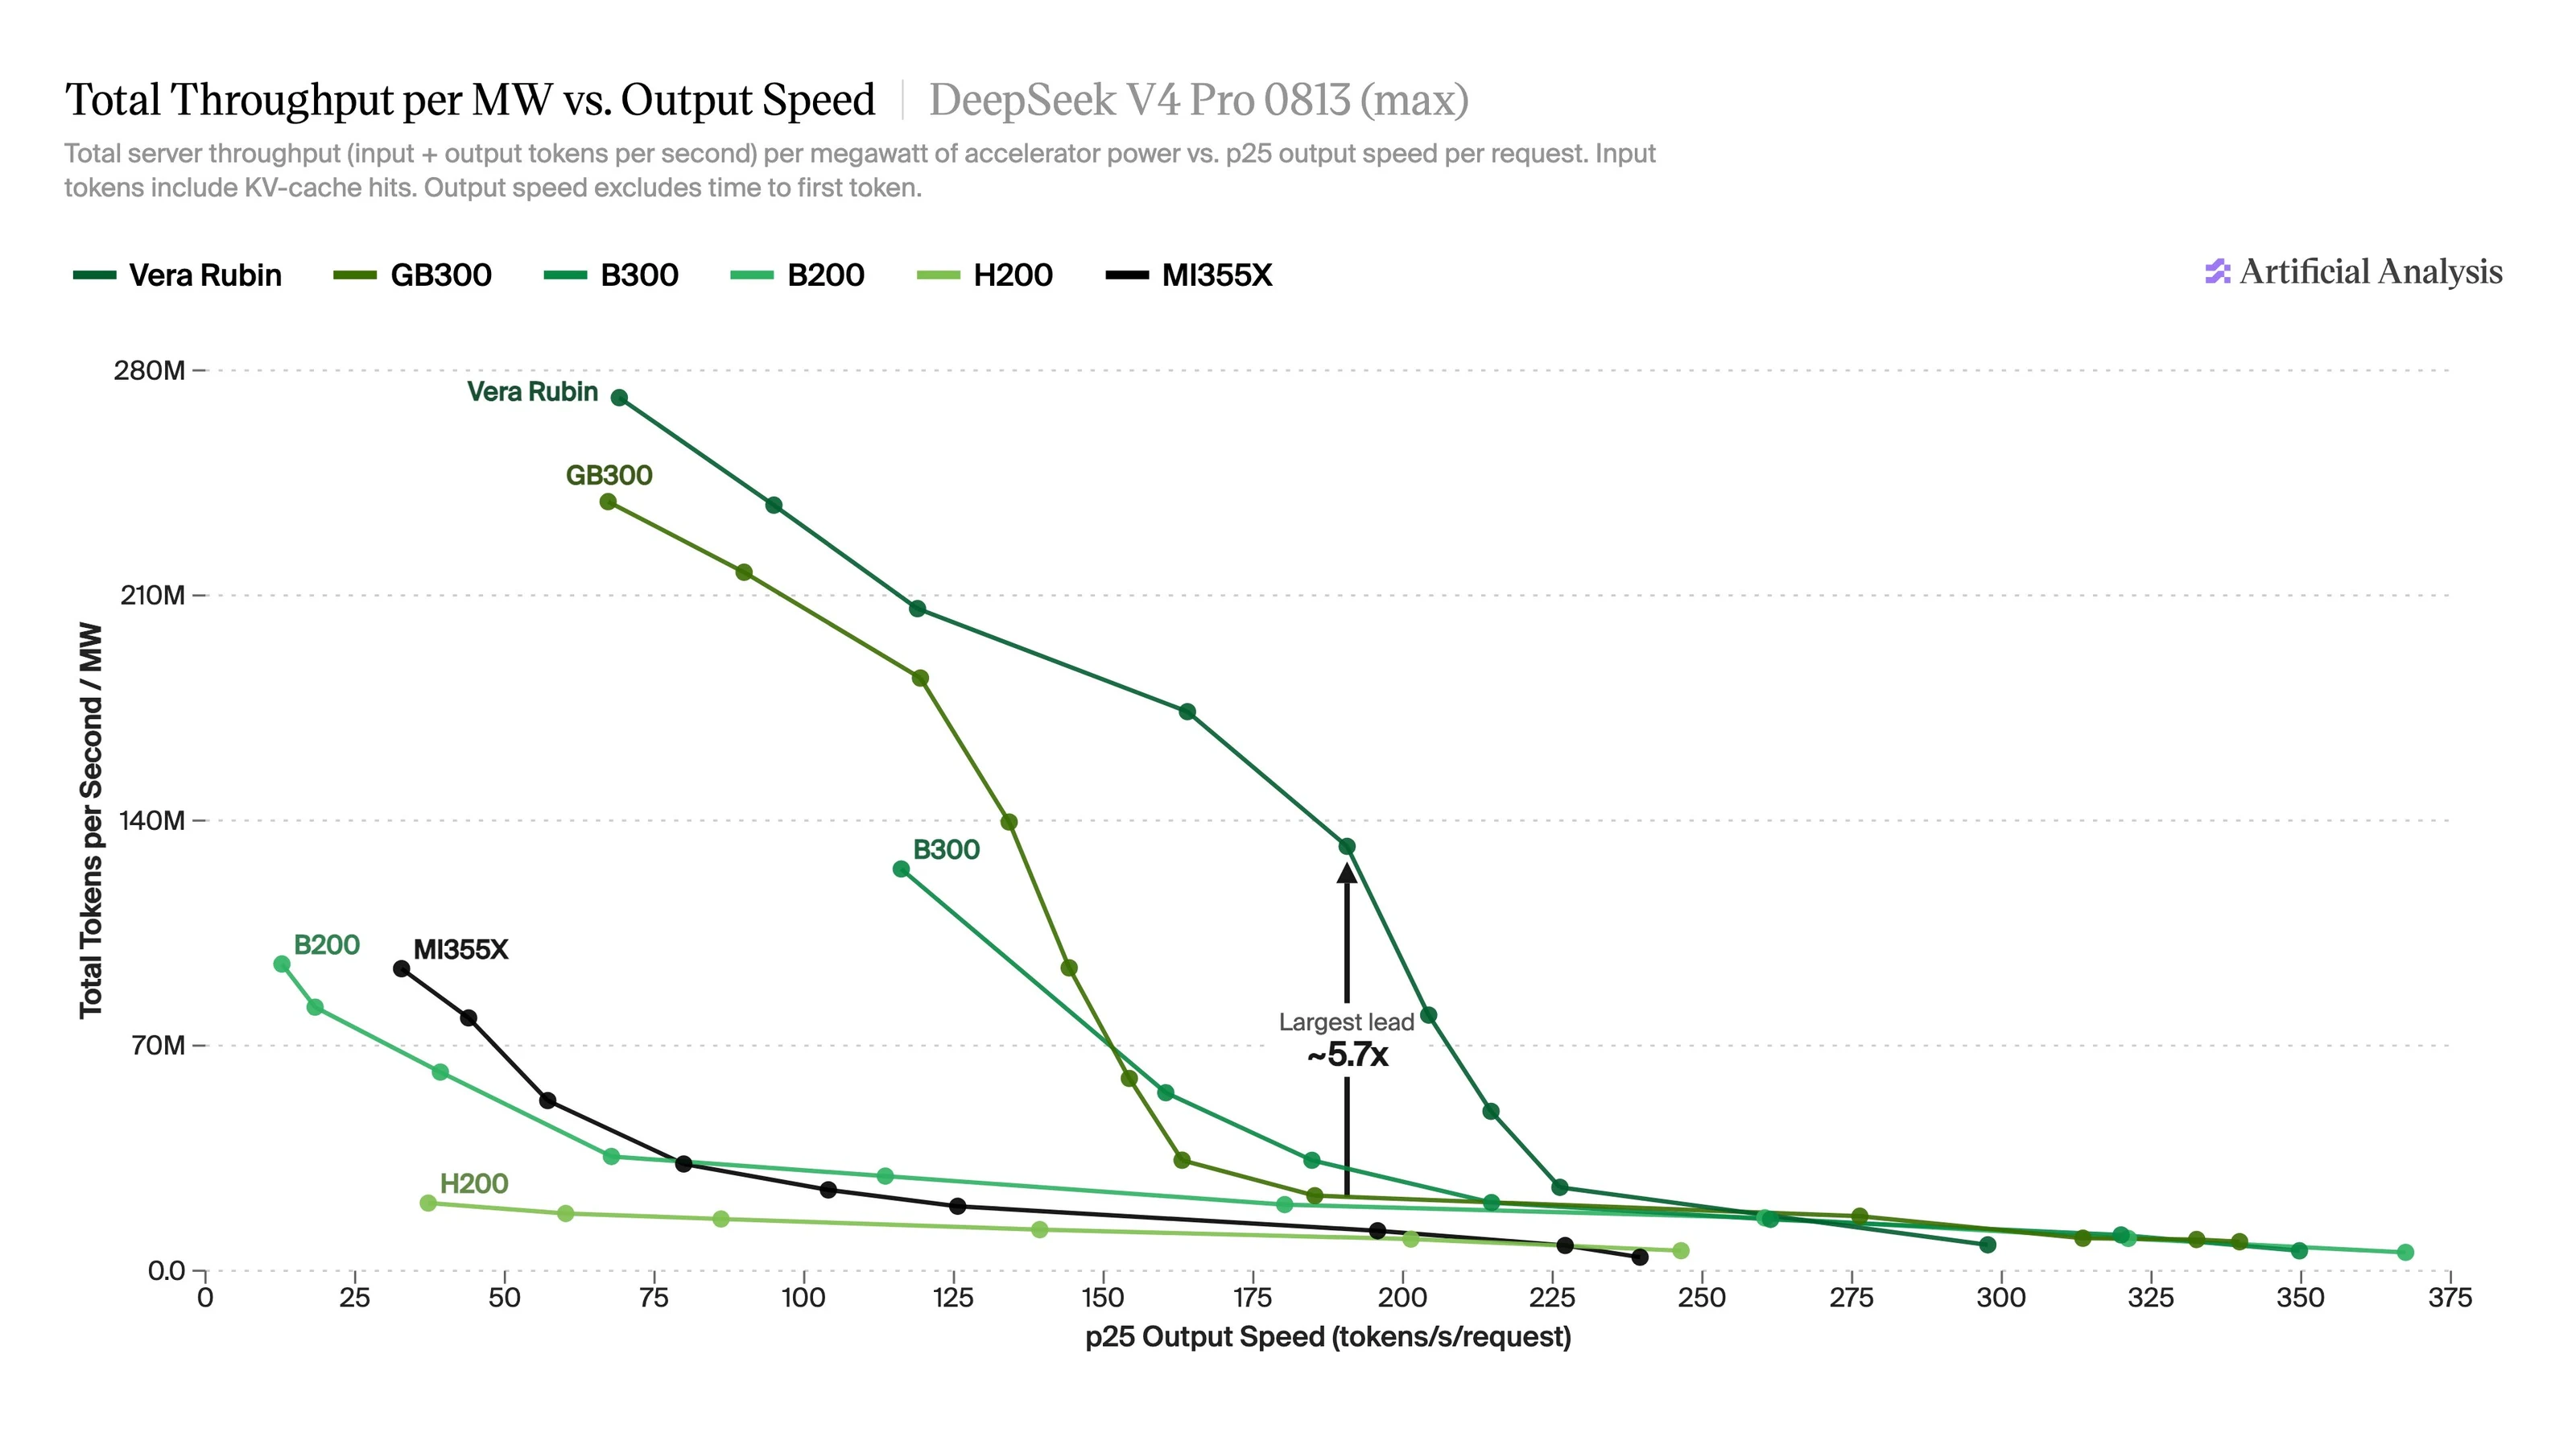
النتائج الأولية لنظام NVIDIA's Vera Rubin NVL72 متاحة الآن على AA-AgentPerf، بإجمالي إنتاجية يصل إلى ~5.7 أضعاف لكل ميغاواط مقارنة بسابقه GB300 NVL72 على DeepSeek V4 Pro، و~5.4 أضعاف على DeepSeek V4.1 Flash، و~3.0 أضعاف على GLM-5.2 و~2.8 أضعاف على Kimi K3
Vera Rubin هي خليفة Blackwell من NVIDIA، وVera Rubin NVL72 هو نظامها بمقياس الرف، بـ72 وحدة معالجة رسوميات Rubin و36 وحدة معالجة مركزية Vera. تحتوي كل وحدة Rubin GPU على نفس سعة الذاكرة البالغة 288 GB الموجودة في Blackwell Ultra، لكن بعرض نطاق ذاكرة أكبر بـ2.4 مرة، وعرض نطاق NVLink أكبر بـ1.7 مرة، وقدرة حسابية NVFP4 مكثفة أكبر بـ2.3 مرة. قدمت NVIDIA جميع نتائج Vera Rubin، باستخدام TensorRT-LLM وvLLM مع NVIDIA Dynamo
AA-AgentPerf هو معيار الأداء الخاص بنا للاستدلال الوكيلي. يعيد تشغيل جلسات برمجة وكيلية حقيقية، بما في ذلك السياقات المخزنة الطويلة وتأخيرات استدعاء الأدوات، لتقديم مقياس واقعي لأداء الاستدلال في أحمال العمل الوكيلية اليومية. نقيس إجمالي إنتاجية النظام لكل ميغاواط من قدرة GPU المقاسة، وسرعة الإخراج لكل وكيل (p25 عبر الطلبات) عند مستويات تزامن متفاوتة، لإظهار المقايضة بين استغلال النظام وتجربة المستخدم الفردية
النتائج الأولية:
➤ تفاوق Vera Rubin هو الأكبر عند سرعات أسرع لكل مستخدم، حيث تتدنى إنتاجية GB300. على DeepSeek V4 Pro، الانتقال من ~120 إلى ~165 رمز/ث لكل مستخدم يكلف GB300 ما نسبته 81% من إنتاجيته لكل ميغاواط، مقارنة بـ16% لـVera Rubin
➤ عند أقصى إنتاجية يقترب الأداء بين النظامين، حيث تبلغ Vera Rubin 272M رمز/ثانية لكل ميغاواط على DeepSeek V4 Pro مقابل 239M لـ GB300 (1.14x)، و571M مقابل 395M على DeepSeek V4.1 Flash (1.45x)، و272M مقابل 201M على GLM-5.2 (1.35x)، و70M مقابل 56M على Kimi K3 (1.26x). نتوقع أن تتسع الفجوة بين النظامين مع تحسين نوى Vera Rubin وبرمجيات الخدمة الأخرى
➤ سجلت Vera Rubin أسرع سرعات لكل مستخدم في لوحة الصدارة لدينا على DeepSeek V4.1 Flash (906 رمز/ث، أسرع نتيجة لأي نموذج)، وGLM-5.2 (408 رمز/ث) وKimi K3 (255 رمز/ث)
تهانينا @nvidia على هذه النتائج القوية!
اقرأ التحليل الكامل: https://artificialanalysis.ai/articles/vera-rubin-nvl72-agentperf