
داخل جهود تحسين كيمي ك3: فهم العقبات والقرارات التي ساعدت على تسريع الاستدلال
في هذه المقالة- AgentX: العبء العمل والنتائج
- داخل كيمي ك3: الخبراء، الانتباه والحالة المتكررة
- 1. السحابة: الحفاظ على حالة المحادثة متاحة للاستخدام مرة أخرى
- 2. MoE: إزالة العمل التكراري المكرر عبر GPU
- 3. حركة التخزين: عمليات الدمج وإزالة النسخ غير الضرورية
- 4. MLA: فك التشفير للسياق الطويل بشكل أسرع باستخدام تجميع AMD AITER
- 5. KDA: تقسيم عملية الملء المسبق والتحقق التجريبي على مستوى متوازي
- 6. التفكير التجريبي في التحويل: اختر عدد المفاتيح التي تريد صياغتها
- ما يجب تحسينه بعد ذلك
- المساهمات والشكرات
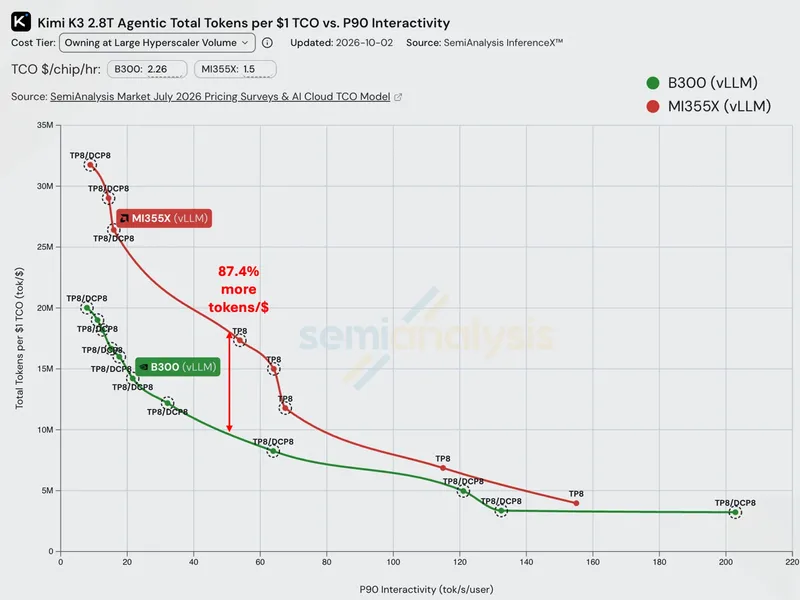
على نظام AgentX المكون من ثمانية وحدات معالجة الرسومات AMD Instinct MI355X الذي يخدم Kimi K3 باستخدام vLLM، يتم توفير 24.4% أكثر من الرموز الإجمالية لكل جهاز معالجة في الثانية مقارنة بنظام NVIDIA HGX B300 عند 50 رمزًا/ثانية/مستخدم مع التفاعل P90. تحت نموذج تكلفة الملكية الخاص بالمقاييس، يتم توفير 87.4% أكثر من الرموز لكل دولار.
في هذا المقال، سنفكك الهندسة الكامنة وراء Kimi K3 على AMD Instinct MI355X، وسنربط قرارات تقديم vLLM بالحوافز الخاصة بذواكر الرسومات الثنائية والهيكل الصلب منخفض التردد. وسنوضح سبب نجاح التحسينات، ونتعلم كيفية اكتشاف الأعمال المفقودة، تحديد النواقص، وإيجاد التحسينات التالية في مجموعة الاستدلال الخاصة بك.
التفاعلية تكون متبادلة، وتشمل زمن الانتظار بين الكلمات P90، ولا تشمل الوقت حتى الوصول إلى الكلمة الأولى. تشمل الكلمات الإجمالية المدخلات المستخدمة مرة أخرى والناتج المُولد.
المصدر: SemiAnalysis InferenceX، لقطة عرضية بتاريخ 9 أكتوبر 2026. إعدادات المقارنة.
تم نشر قمم مصفوفات كثيفة بمعدل 10.1 PFLOP/s MXFP4 لجهاز AMD Instinct MI355X، و13.5 PFLOP/s FP4 لجهاز NVIDIA B300. كلا الجهازين يمتلكان ذاكرة HBM3E بسعة 288 جيجابايت، ومتوسط عرض النطاق الترددي للذاكرة عند الذروة 8 تيرابايت/ثانية. الوصول إلى هذا الأداء في الخدمة يعكس بناءً مستمرًا في هندسة البرمجيات من قبل شركة AMD والمشاركين في مجتمع vLLM.
آجنت إكس: حجم العمل والنتائج
الاختبار العام AgentX يعيد عرض سجلات جلسات البرمجة للعاملين الحقيقيين باستخدام رموز توليدية، مع الحفاظ على طول الطلبات ووقت التنفيذ وأنماط مشاركة البادئات. يوفر الحملة العملية أكثر من 96% من إعادة استخدام البادئات النظرية مع سعة لا حدود لها للسحابة. تستخدم التشغيلات الافتراضية مرجع قبول توليدي ثابت.
عند 50 توكينات/ساعة/مستخدم P90 تفاعلية,يقدّم AMD Instinct MI355X حوالي 7,567 توكينًا إجماليًا/ساعة/GPU، مقارنة بـ 6,083 توكينًا لـ NVIDIA HGX B300، أي ميزة في الإنتاجية تبلغ 24.4%. باستخدام تكلفة الاستثمار المتوقعة لشركة SemiAnalysis والتي تبلغ 1.50 دولار مقابل 2.26 دولار لكل ساعة GPU، يترجم ذلك إلى 18.16 مليون توكين إجمالي مقابل 9.69 مليون توكين لكل دولار من تكلفة الاستثمار: 87.4% أكثر توكيناتًا لكل دولار.
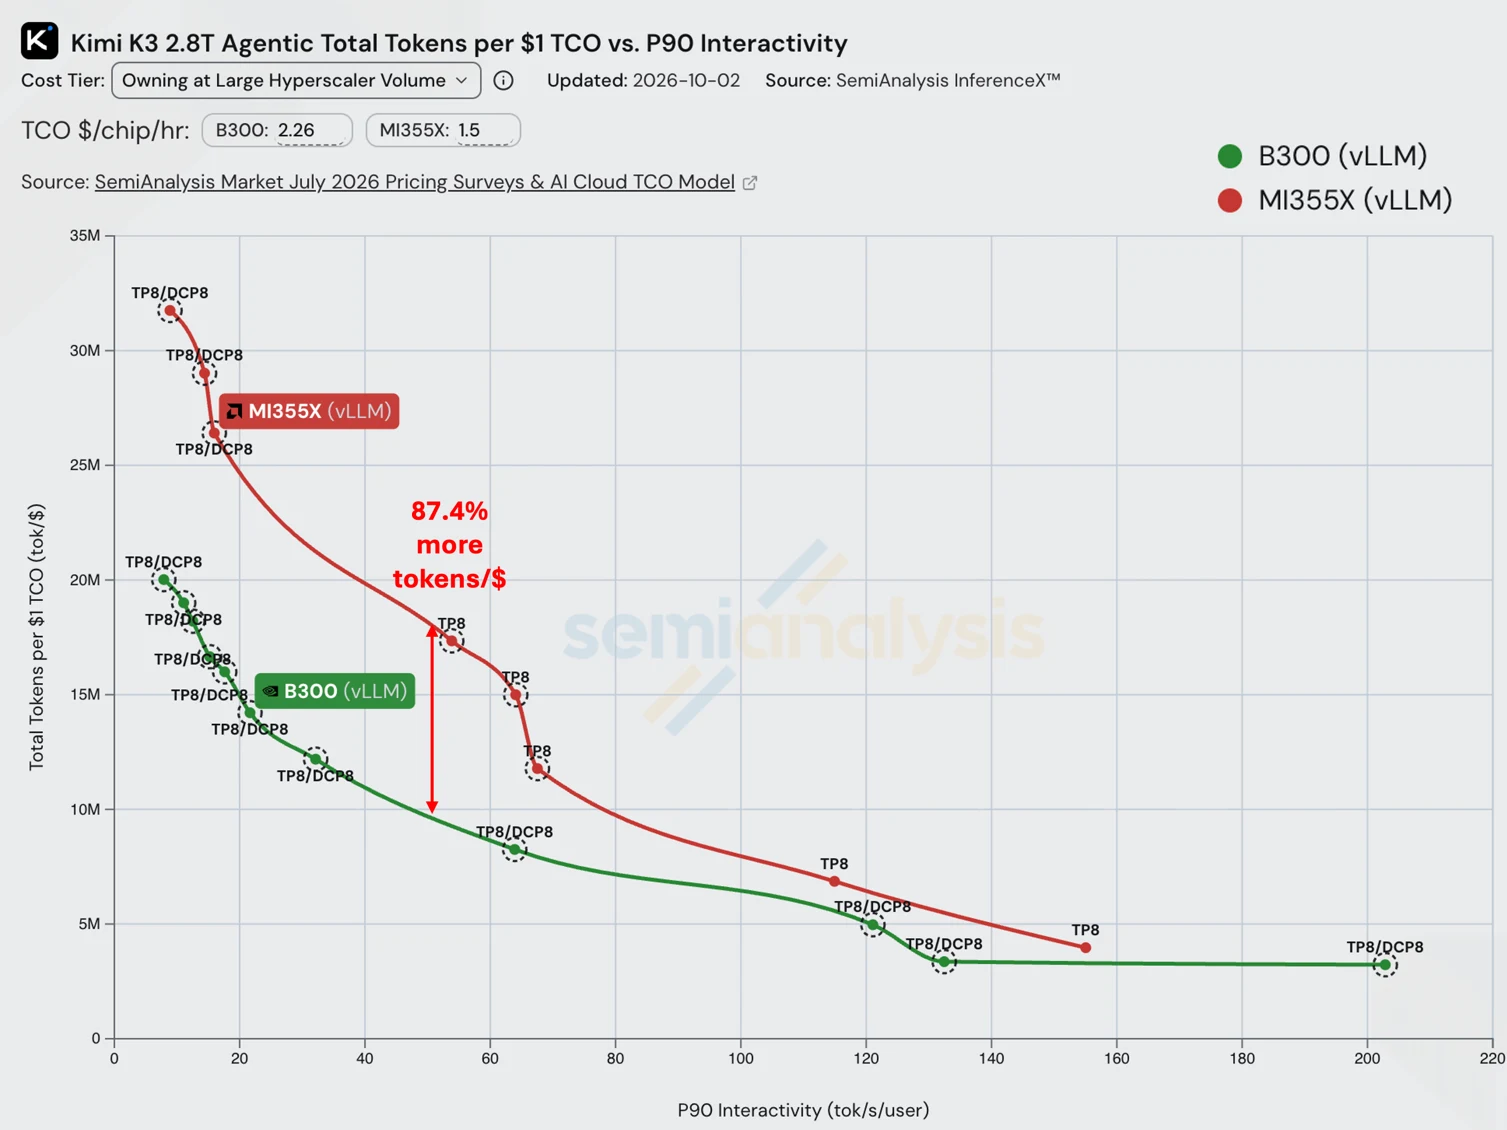
SemiAnalysis InferenceX المنحنيات العامة، مع توضيح هدف 50 تكرارًا/مستخدم. ملاحظات الاختبارات المعيارية.
تقارن المنحنيات العامة مجموعات الخدمة الكاملة. تأتي القياسات بجانب كل تحسين من اختبارات منفصلة، وتوضح الآليات الفردية تحت التكوينات المذكورة.
داخل كيمي ك3: خبراء، انتباه، وحالة متكررة
يمكن لدور الشخصية العائدة استخدام معظم البادئات الخاصة بها مرة أخرى، لكن مع معالجة النص القصير، يتم التفاعل مع ثلاثة أنواع من البيانات.
Kimi K3 يستخدم نوعين من الانتباه. تُحتفظ 24 طبقة MLA بسجل KV المضغوط الذي ينمو مع المحادثة. يتم استدعاء السجل القديم عند طلب جديد. بدلاً من ذلك، تحمل 69 طبقة KDA مصفوفات الحالة ذات الأبعاد الثابتة، وتُحدَّث هذه المصفوفات مع وصول عبارات جديدة. تكوين النموذج.
في طبقات MoE، يختار المحول شبكات الخبراء لتحويل كل توكين. وتُشارك أوزانها بين الطلبات.
تحتفظ MLA بمزيد من التاريخ مع تطور المحادثة. يقوم KDA بتحديث حالة بأبعاد ثابتة؛ وبالاحتفاظ بالنقاط المراجعة السابقة، يعني ذلك الحفاظ على نسخ إضافية من تلك الحالة.
عبر الدورات: إعادة استخدام الذاكرة والتخلي عن المسؤولية (القسم 1).
داخل خطوة النموذج: تنبؤات الخبراء، نقل المسؤوليات بين الوحدات الأساسية، وترتيب تنفيذ MLA/KDA (الأقسام 2–5).
اختيار عمق النسخة التجريبية: الإخراج الملزم مقابل تكلفة الدورة الكاملة (القسم 6).
1. السحابة: احفظ حالة المحادثة متاحة لإعادة الاستخدام
تقلل صيغة DCP من التكرار في التاريخ في ذاكرة الجهاز الرسومي؛ ويحافظ نقل العمل على وحدة المعالجة المركزية على الحالة القابلة لإعادة الاستخدام خارجها.
DCP: مشاركة التاريخ بين الشرائح الرسومية
تحت TP8، يتعامل كل GPU مع 12 من رؤوس الاستعلام الخاصة بـ 96 MLA في Kimi K3، لكنه يحتفظ بسجل KV المضغوط الكامل. التوازي على تنسورات البارامترات ينقسم رؤوس الاستعلام دون تقسيم الذاكرة المؤقتة.
مع توازي السياق التشفير بطريقة الثمانية طرق (DCP8)، يخزن كل جهاز كرت عرضي ثُمينًا واحدًا من الثمن من المواقع المخزنة. أثناء عملية التشفير، تتبادل الأجهزة الكرتية الاستعلامات، وتحسب النتائج استنادًا إلى تاريخها المحلي، ثم تجمع الإجابات الجزئية.
توضح جهازا GPU اثنان نفس القسم المستخدم من قبل TP8/DCP8. ينطبق هذا التقسيم الإضافي على تاريخ MLA؛ ويحافظ حالة KDA على قسمه القائم بين الرؤوس.
كل إجابة جزئية تحتوي على معلومات التوحيد، بحيث يمكن لعملية الدمج أن توزن الأجزاء بشكل صحيح. #51705 يوسع مسار ROCm AITER DCP لتحقق المفاتيح المتعددة.
للحوار الذي يتضمن 142,000 كلمة، يُقدر حجم البيانات المستخدمة في الـ MLA بحوالي 24 طبقة × 142,000 موقع × 576 بايت من نوع FP8 ≈ 1.96 جيجابايت لكل GPU. أما DCP8 فيقلل هذا الرقم إلى حوالي 245 ميجابايت، قبل احتساب تكاليف التخصيص. كل GPU يقوم بمعالجة ثمانية أضعاف عدد الكلمات مقابل ثُمن من التاريخ المحفوظ، مما يترك العمليات الحسابية للانتباه دون تغيير تقريبًا.
تخلص من عبء المعالج: حفظ الحالة التي لم تعد تتناسب مع HBM
عندما لا يتسع الذاكرة الخاصة بالواجهة الحاسوبية للحالة، فإن نقل العملية إلى المعالج الدقيق vLLM عبر وصفة AMD يحافظ على تاريخ MLA ونقاط التحقق KDA في الذاكرة DRAM للمضيف.
يتطلب استرجاع الذاكرة الحصول على نقاط استئناف متطابقة. إذا وصل تاريخ MLA إلى الرمز 3,072، لكن نقطة التحقق الأخيرة المتوافقة مع KDA هي 2,048، فيجب أن تبدأ الطلب من 2,048 وإعادة حساب الباقي.
يجب أن يكون النقطة الوظيفية قابلة للاستخدام في حالة متوافقة على جميع الطبقات المطلوبة. التصنيفات هي مجرد أمثلة توضيحية.
يُحافظ على مواقع البحث جنبًا إلى جنب مع نقطة التسجيل KDA، من خلال حفظ ذيل كتلة الانتباه (#54736). ويعوض استعادة ذلك الحالة إعادة نقل البيانات إلى GPU لتجنب إعادة حساب البادئة. عندما يعود الطلب، يمكن للتواقيع الجديدة أن تجعل عدة GPU تكرر نفس الحساب.
2. MoE: إزالة الأعمال المكررة بين الراقات الجرافية
على جهاز الرسوميات الواحد، يعيد إنتاج الخرج الخاص بخبير التوجيه الناتج المتجه الكامل الذي يتوقعه المستخدم. في المسار الأصلي لـ ROCm، أدى التقليل والتطبيع المسبق إلى توفير مدخل مخفي متساوي لجميع الأجهزة الثمانية، وكل منها يحتفظ بأوزان كاملة. وبالتالي، تم تنفيذ نفس العملية ثماني مرات.
يمكن تقسيم إحداثيات الإخراج بين وحدات الرسومات المتعددة، لكن كل رتبة لا تزال بحاجة إلى النتيجة الكاملة. تمتلك كيمي K3 بالفعل خاصية التخفيض الشامل لجزئيات الخبراء المشترك.
يضيف كل وحدة معالجة جرافيكية فقط الإخراجات الموجودة على خوادمها إلى الجزء المشترك الخاص بالخبراء. يتم تجميع النتائج الكاملة باستخدام طريقة all-reduce القائمة، دون أي نتائج جماعية جديدة (#51253). تنفيذ ROCm يعتمد على استراتيجية CUDA المقابلة.
توضح جهازا راديويان GPU ملكية координات الإخراج. كلا المسارين يستخدمان خاصية "all-reduce" موجودة، ويُرجع كل منهما نفس النتيجة الكاملة لكل GPU.
تتلقى كل إحداثية مخرجية مساهمة مُوجّهة واحدة بالضبط. تظل أوزان الإسقاط الكاملة متكررة.
ارتفع معدل الإنتاجية إلى 3.05–4.91% في اختبار PR على ثمانية وحدات معالجة AMD Instinct MI355X باستخدام TP8، مع تعدد التوافقيات من 8 إلى 128، وطلبات صدرت بشكل عشوائي بصيغة 8K-مدخل/1K-مخرج، مع إيقاف التخزين المؤقت للمؤشرات.
تحرير ذاكرة GPU للحفاظ على المزيد من الحالة المخزنة في الكاشطة
يحسب كل رتبة الآن فقط إحداثيات الإسقاط المخصصة لها، مع الحفاظ على الأوزان الكاملة.
تحرير الصفوف فقط التي يستخدمها كل تصنيف يوفر حوالي 3.85 جيجابايت في كل جهاز كرت جيمي عبر 92 طبقة MoE عند TP8 (#59591). يظل حساب المسار المتراكم كما هو؛ ويمكن للفضاء الإضافي استيعاب تاريخ MLA ونقاط التحقق KDA.
تم إجراء هذا التغيير بعد استخدام الصورة المستخدمة للنتيجة العامة للعنوان. ووجدت تجربة AgentX المنفصلة أن المعدل الإحصائي أقل من 1% أعلى عند التزامن 32 و48، بينما ارتفع بنسبة 28.9% عند 70، حيث ارتفع معدل الضغط في الذاكرة المؤقت من 74.8% إلى 80.1%.
فصل #59591 القياسات: ثمانية وحدات معالجة رسومية AMD Instinct MI355X، TP8/DCP8، FP8 KV، تشغيل لمدة 30 دقيقة، بدون تشغيل للوحدة المعالجة الرئيسية أو تفكيك متوقع. العلامات تشير إلى التجارب المُبلغ عنها؛ لم يتم الإبلاغ عن عدم اليقين المتعلق بالتجارب المتكررة.
الفائدة الأكبر عند التوافر العالي للتنفيذ تتوافق مع ضغط الذاكرة المخزنة. سيُساعد مقارنة كلا التنفيذين عند قدرة ذاكرة متساوية في تحديد ذلك التأثير بشكل واضح.
مزيد من المعلومات حول التوجيه المتخصص والتفعيل بأربعة بتات.
3. حركة الذاكرة: دمج العمليات وإزالة النسخ غير الضرورية
داخل كل وحدة معالجة رسومية، المكان التالي الذي يجب البحث فيه هو البيانات التي تمر بين الخلايا.
مسار KDA بوحدة واحدة لـ Kimi K3 تم تنفيذه عبر ثلاث كروسات حاسوبية ونسختين من الإخراج. تم تنفيذ عملية التمفغنشن قبل كروسة تجمعت بالفعل بين تطبيع Q/K وتدهور وبيتا بوابات، والتحديث المتكرر؛ بينما تم تنفيذ عملية تطبيع الإخراج بعد ذلك. يؤدي مسار HIP المجمع هذه العمليات في تحديث واحد ويسجل مباشرة إلى الذاكرة الهدف (#50654).
تظل التحويلات المتوسطة موجودة على الشريحة. تذهب تاريخ التشويه والحالة المتكررة إلى ذاكرة GPU لعملية الترميز التالية.
تحليل KDA الأحادي الكلمة، غير المتوقع، في #50654. قبل ذلك، يستخدم مسار التسوية المركب Triton. تتبع الأعداد الكود المصدر؛ أما الإسقاطات فهي خارج النافذة. تظل قراءة وكتابة الحالة المحفوظة ساريتين.
يتخلط AttnRes بين إخراجات طبقات الطبقة السابقة والناتج المتبقي الجاري. عند دمج هذا الخليط مع RMSNorm، يظل الخليط المؤقت في المخازن الإشارية (#50593). يحتفظ الناتج المتبقي الجاري المحفوظ للطبقات اللاحقة بضبط التقريب BF16؛ ويبقى الخليط في FP32 من خلال التطبيع. تتطلب الاختبارات تحديثات مستمرة دقيقة وتسمح بتسامد رقمي للإخراج المطبع.
مع دمج AttnRes، ارتفع معدل الإنتاجية بنسبة 14.2% على ثمانية وحدات GPU AMD Instinct MI355X عند مستوى TP8، مع طلبات بصورة 100K-إدخال/1K-إخراج وتم تعطيل التخزين المؤقت للمؤشرات. ولم يتغير التأخير الناتج عن ملء المعلومات لفترة طويلة بشكل فعلي.
قم بنسخ المدخلات فقط للحوافز التي تستخدمها
موزع ضرب المصفوفة في ROCm حشّى المدخلات قبل اختيار النواة. عندما اختار النواة البديلة، قرأ المدخل الأصلي وترك النسخة غير مستخدمة. قيام بتحويل عملية الحشو إلى الفروع المتخصصة أزال هذه النسخ (#58566).
جعل الملف الشخصي النفايات واضحة: 69 نسخة غير ضرورية لكل خطوة تفكيك، واحدة لكل طبقة KDA. تحرك كل منها 1,792 بايت فقط، لكن ذلك استغرق حوالي 4.8 ميكروثانية. التحرك أسرع لهذه البايتات لن يساعد كثيرًا؛ فالتكلفة الإطلاقية هي التي تهيمن.
في PR’s TP8، مع التزامن واحد، ستة مقالات، محتوى 384K-context، تشكل النسخ المُحذفة 0.339 مللي ثانية من وقت نواة النسخ لكل خطوة.
4. MLA: تفكيك بطيء للسياق الطويل باستخدام ترحيل AMD AITER
للجهاز كيمي K3، يوجد اثنا عشر رأس استعلام لكل وحدة معالجة جرافيك (GPU) في TP8. وبإضافة ستة عشر، أصبحت مسار تفكيك التجميع الخاص بـ AMD AITER متاحًا. في الاختبار الذي تم الإبلاغ عنه للسياق الطويل، انخفض الوقت لكل كلمة مخرج من 43.8 إلى 23.6 مللي ثانية.
تمت المقارنة باستخدام TP8 دون DCP، عند التزامن واحد. يقوم المحول في #50578 بنسخ أربعة رؤوس استعلام، وضمها في تخطيط يحتوي على ستة عشر رأسًا، ثم يتخلص من نتائجها. يقدم DCP8 شكلًا مختلفًا، يحتوي على 96 رأسًا.
تحافظ هذه الطريقة على عمل النموذج، لأن كل رأس استعلام يتعامل بشكل مستقل مع المواقع المخزنة في الذاكرة. إضافة رأس استعلام آخر لا يغير من نتائج softmax للرأس الأصلي. في هذا المسار التفكيك، يتم ملء الاستعلام فقط؛ ويظل حجم التاريخ المضغوط KV المخزن كما هو.
محادثة طويلة توفر الكثير من الاهتمام، لكن هذه المهمة يجب توزيعها على الشريحة GPU. في الكود التاريخي الذي فحصناه، كان التخطيط محافظًا تلميحات لترتيب الجلسات حظر مسار Gluon مجموعة عمل واحدة لكل طلبلقد استمرت المجموعة العمل هذه في معالجة المحادثة بأكملها. جعلت الزيادة المحتدة مسار التجميع لـ AMD AITER متاحًا، مع سياسة مختلفة لتقسيم التاريخ إلى أجزاء متوازية ودمج النتائج.
تقسم تقسيمات التاريخ إلى أعمال مخصصة لمجموعات العمل داخل جهاز الرسومات الطبيعية (GPU) واحد. تم عرض أربعة أمثلة لأغراض العرض؛ تم اختيار ستة عشر سياسة تجميعًا للفحص. لا تغير تخزين KV.
| تكرارات الإدخال / الإخراج | المسار الأصلي لجلون | مسار التجميع المزود بالضغط |
|---|---|---|
| 1كيلو/1كيلو | 22.9 مللي ثانية/توكين | 22.8 مللي ثانية/توكين |
| 32كيلو/1كيلو | 43.8 مللي ثانية/توكين | 23.6 مللي ثانية/توكين |
الوقت المتوسط الذي يُبلغ عنه PR لكل توكين الخارجي: ثمانية وحدات معالجة AMD Instinct MI355X، TP8، تزامن واحد، أوزان نموذج MXFP4، تفكير BF16، وتشفير التوكين الفردي العادي.
حالة المدخلات القصيرة لا تختلف كثيرًا؛ أما حالة المدخلات الطويلة، فإن الوقت لكل كلمة ناتجة تقريبًا ينقص النصف. تشمل هذه القياسات الخاصة بالتقديم عملية إعداد الاستعلام ومعالجة الناتج.
5. KDA: تقسيم عملية ملء البيانات الأولية والتحقق التجريبي
يمكن لـ MLA تقسيم التاريخ المحفوظ بين مجموعات العمل. يطرح KDA مشكلة ترتيب أكثر صعوبة: كل كلمة تعتمد على الحالة السابقة. يتم إعداد عملية ملء مسبق مدمج في #54038 لكل مجموعة كلمات، قبل أن تُعرف الحالة القادمة لها.
على سبيل المثال، “تقسيم الحالة إلى نصفها وأضافة اثنين”، ثم “تقسيمها إلى نصفها وأضافة واحد”، يتم دمجهما في “أخذ ربع الحالة الابتدائية وأضافة اثنين”. يمكن حساب هذه القاعدة قبل وصول الحالة الابتدائية.
يقوم KDA بذلك من خلال تحويلات المصفوفة. يتم فحص مجموعات التلخيصات بشكل منظم لتحديد الحالة الابتدائية لكل مجموعة؛ ثم تكرار العلامات الخاصة بكل مجموعة بشكل متوازي. يظل ترتيب العلامات كما كان، لكن كل مجموعة لا تنتظر تكرار الحالة الخاصة بالمجموعة السابقة.
تضيف التجميع جولة ثانية وتوسع مسار الكتلة المشتركة من مرتين إلى أربع مرات. يساعد ذلك عندما تكون العديد من التسلسلات أو الرؤوس تكشف عن عمل متوازي قليل؛ وإلا، قد تكلف المراحل الإضافية أكثر مما تحققه.
داخل كل مجموعة، يحتفظ المشي المتكرر بالحالة في سجلات محفز الوسيط بين الأجزاء، مما يمنع كتابة البيانات إلى الذاكرة العالمية وإعادة تحميلها. رسم بياني لتخزين الحالة.
قدمت KDA المدمجة عائد تدفق إدخال يتراوح بين 5.3 إلى 5.6% أكثر من Triton عند أطوال إدخال 4K و16K في مقارنة منفصلة ثلاثة خوادم: ثمانية GPU من AMD Instinct MI355X، TP8، تزامن 32، إيقاف التخزين المؤقت المسبق، ومخرجات بنقاط واحدة. هذا يقيس الخادم الخلفي الكامل. نتائج الاختبار.
استخدم بلاطات أصغر للتحقق التجريبي
تحتاج دفعات التحقق القصيرة إلى تقسيم مختلف. في TP8، يحتوي كل جهاز GPU على 12 رأس KDA مع 128 عمودًا للقيمة. عند تقسيم كل رأس إلى أربعة قطع بأربعة 32 عمودًا، يتم تشغيل 48 مجموعة عمل فقط على 256 وحدة حسابية. #58045 يغير إلى قطع بأربعة أعمدة، مما يزيد العدد إلى 384.
كل قطعة أرضية تحتوي على أعمدة قيم مختلفة، وتتبع نفس تسلسل الكلمات بالترتيب نفسه. القطع الأصغر تزيد من عدد مجموعات العمل المستقلة من 48 إلى 384.
في اختبار نواة إعادة تشغيل الرسومات المنفصلة على وحدة GPU AMD Instinct MI355X (أبعاد TP8، تسلسل واحد، أربعة مواقع تحقق)، انخفض الوقت من 16.20 إلى 5.61 ميكروثانية لكل طبقة (2.89×). يشمل ذلك البلاطات الضيقة، مجموعات العمل ذات الموجة الواحدة، التخصص بطول متساوي، والعمل الذي لا يتغير مع الرموز. تحتفظ الدفعات المتقطعة بمسار ديناميكي؛ حيث يقارن الاختبارات النتائج والحالة المتكررة.
6. التشفير التجريبي: اختر عدد المفاتيح التي تريد صياغتها.
يمكن أن يغير التحقق الأسرع عدد العلامات المقترحة التي يجب التحقق منها. النسبة المفيدة تكون هي الإخراج المتعهد مقسومًا على وقت دورة الإعداد الكامل والتحقق والإخراج.
على سبيل المثال، يوفر مرجع القبول الثابت لـ AgentX متوقعًا 3.00 توكينات ملزمة لكل دورة مع ثلاثة مسودات، و3.36 مع أربعة مسودات، بما في ذلك توكينات الاسترداد أو المكافأة. وهذا يعني زيادة بنسبة 12% في الإخراج الملزم لكل دورة. تحسن التدفق الأربع مسودات فقط إذا استغرقت الدورة الكاملة أقل من 12% من الوقت مقارنة بالثلاث مسودات.
مقارنة توضيحية تحت مرجع القبول المُسيطر. الحد الأدنى بنسبة 12% هو ميزانية التكلفة؛ ولم يتم قياس النمو الكامل للدورة هنا.
الوصفة العامة لـ AMD العامة تستخدم من ثلاثة إلى سبعة مسودات مع DCP1 وتعطل التخمين عند إعدادات التزامن الكبيرة DCP8.
ما يجب تحسينه بعد ذلك
تزيد أعمال التعبئة/التفكيك المستمرة من عدد الأماكن التي يجب البحث فيها: توازن العمال وما إذا كانت عمليات النقل تنتهي قبل الحاجة إلى بياناتهم.
لنموذج أو عبء آخر، ابدأ بأشكال الطلب الموزع واجري ثلاثة تحققات:
قارنوا الترتيبات. هل تقوم عدة وحدات معالجة الرسومات ثلاثية الأبعاد بحساب نفس النتائج قبل أن يتم تجميعها من قبل مجموعة واحدة؟
اتبع المخازن المؤقتة. هل لكل تنسور مؤقت مستهلك على المسار المختار؟ هل يمكن أن تظل البيانات داخل الشريحة؟
عد عدد الأعمال المستقلة. هل تنتج الرؤوس الفعلية، والكلمات، والألواح ما يكفي من مجموعات العمل لتوزيع الأحمال؟
قم بقياس الطلب الكامل بسرعة الاستجابة التي تحتاجها، وتحقق من النتائج ووضع الحالة المحفوظة. يعتبر النواة الأسرع أمرًا مهمًا عندما يقلل من الوقت المستغرق في تخزين الكلمة التالية.
إسهامات والتقديرات
تشمل جهود كيمي ك3 عمليات أكثر من 50 طلبات تصحيحات PR متعلقة بـ AMD/ROCm في نظام vLLM مدمج من شركة AMD، وخوارزميات LLM المدمجة، والمجتمع الأوسع، بالإضافة إلى تطوير AITER وتكامله ومراجعته ومقارناته. تشمل المساهمات الاهتمام، التكرار، MoE، التجريد، تنفيذ الرسوم البيانية، دعم الذاكرة المؤقت والتكامل مع المنصة.
شكر خاص ل: بين سيانغ تان، جون كانغ تشاو، يي هور تشونغ، هونغشيا يانغ، سيونغروك جونغ، بيل هي، ييتشاو زو، هيوكجون لي، آندي لو، مرينال كارفير، ريتشارد لي، سون بينغ
آندي فريدريش, إيثان يانغ, تانغ روي, أندرياس كاراتزاس, أنكور سينغ, ييهوا تشنغ, بادر با سويد, بنجامين تشيسليت, تاو يو تشو, بيل هي, بين دينغ, بوين باو, براندون زهانغ, تشايمين ليم, تشارلز وو, تشوان (ريتشارد) لي, فليكس لي, كاميرون كويليسي, ويشو دينغ, دويو وانغ, ديفاكار فيرما, دوغلاس لير, إدوين ليم, يودونغ بان, إلفير كرنتشيفيتش, فانغ تشي, فانغتشو آي, شينغران فان, فولو لي, فليكس مارتي, كانلين غوو, سامر يانغ, هاي تشن زانغ, يوفينغ هيه, هي لو, هونغشيا يانغ, هيوكجون لي, ييفان تشياو, جيمس إي تي سميث, جياهوي كاو, يانيوان تشين, جوناثان تشن, جونتيان ليو, شاو-تشون لي, كيدار بوتدار, كيفن هـ. لو, كوان-فو ليو, كونتاي دو, كايل سايرز, @lalala-sh, @linnea-lin-00638949, يينفينغ ليو, لوكاس ويلكينسون, جابرييل وو, ماركوس هارتيكاينن, مايثيلي جوشي, جيف (جونز) ما, ماثيو وونغ, ميشا يذهب, ميكا ويليامسون, @minmengdie, ماتفاي باشكوفسكي, ماثيوز نيها, نيكولو لوتشيسي, نيك هيل, نيكولاس سوسانتو, أوكانا كورج, بي زانغ, @ppalanga, بييران تشين, تشيويانغ يو, ريتا بروغارولاس, ريبيكا لي, رايان روك, روهان بوتدار, @Saddss, سامويل شين, شون فيليمون, سونغروك جونج, شانتيبريا باريدا, شانشان شين, شينغنان شو, سيمون دانيالسون, سيراج شيخ, ستايزي روبرتس, ستيفان كونكاريفيتش, أسان ستيفانسكي, مينغهوي جيانغ, تارık ساراج, تون جيان تان, لينغبينج جين, فانش باتيا, ماكسيم فيدينيف, ييه هور تشونغ, @wenwzhan, وي تشاو, خافيير أغويلار, شياوبينغ زانغ, شياوهو جو, شين لي, شو دونغ ليو, يانشو رين, وينتاو ييه, يونغتشين وانغ, ريجينز تشن, تشاو هونغ, يوتشن شين, مات تشين, ييتشاو زو, روجر وانغ, زهينغ غونغ, جيانغيون زو, زفي جرينبرغ, يونغي زو.
ملاحظات مقارنة المعايير
توفير التكوينات في أهداف المقارنة
| التفاعلية P90 (تذكيرات/مستخدم/يوم) | AMD Instinct MI355X | NVIDIA HGX B300 |
|---|---|---|
| 30 و50 | تخفيف سيمبلكيوب؛ DCP8 / لا مخطوطات إلى DCP1 / ثلاث مخطوطات | تخليص مانوكيك؛ DCP8 |
| 150 | متاح فقط بواسطة GPU؛ DCP1؛ خمسة إلى سبعة مسودات | تخليص مانوكيك؛ DCP8 |
يستخدم كلا النظامين ثمانية وحدات معالجة الرسومات ثلاثية الأبعاد، ووزنات TP8، FP4، وFP8 KV. تُقاس القيم بشكل متوسط في كل سلسلة من السلاسل التي تم نشرها والتي تعتمد على استخدام GPU فقط، وذلك وفقًا للتفاعلية المتطابقة؛ يمكن أن يختلف التزامن، DCP، وعمق الصياغة بين جولات التجربة. توفر وصفة AMD (YAML) وبرنامج التشغيل الخاص بNVIDIA العلامات الصورية للصورة والإعدادات الكاملة.
يستخدم Replay مجموعة البيانات cc-traces-weka-062126، وجهاز AIPerf المحفور، مع استبعاد عملية التسخين ووقت ساعة واحدة من التحليل تحت منحنيات القبول الاصطناعية الثابتة. توفر الوصفات إعدادات البذرة، بدء الجلسة، والتسخين. لم يتم تسجيل تعديل مجموعة البيانات المُحفورة. يمكن لالتقاطع الدائري المغلق أن يولد مزيجًا مختلفًا من الطلبات المنجزة.
البرمجيات والتخزين المؤجل. تستخدم المشاريع vLLM 36768d1bf (AMD) و5894fdf98 (NVIDIA). ميزانيات الذاكرة للسحابة المُعدة هي 224.875 و281 غيغابايت لكل GPU على التوالي؛ إعدادات الوصل والتصميمات الصورية موجودة في الوصفات المرتبطة.
التكاليف. نموذج ملكية شركة SemiAnalysis المتعددة الخوادم الكبيرة ، والثوابت الخاصة بتكاليف GPU المنشورة ، تعتمد على 1.50 دولار لكل ساعة GPU لجهاز AMD Instinct MI355X، و2.26 دولار لجهاز NVIDIA HGX B300. القيمة الإجمالية للعملات ÷ الساعة GPU = الإجمالي للعملات/ساعة GPU × 3600 ÷ الثمن المحسوب لكل ساعة GPU. بعض الافتراضات المتعلقة بالرأس المال والاستخدام لا تزال غير منشورة. عند هدف التفاعل بـ 50 عملة، يُظهر المقارنة تكلفة أقل بنسبة 46.6% لكل عملة.
صورة سريعة. تم استرجاع بيانات SemiAnalysis InferenceX في 9 أكتوبر 2026؛ التقديمات تاريخها 30 سبتمبر 2026 (AMD) و16 أغسطس 2026 (NVIDIA). تستخدم اختبارات PR عبء العمل المذكور؛ #59591 هو تجربة منفصلة بعد الصورة الرئيسية.
| المواصفات المنشورة حسب الرسومات الخاصة بالذاكرة العصبية | AMD Instinct MI355X | رسمي NVIDIA B300 GPU |
|---|---|---|
| مصفوفة كثيفة بدقة منخفضة قمة | 10.1 بفلوب/ثانية MXFP4 | 13.5 بفلوب/ثانية FP4 |
| ذاكرة GPU | 288 جيجابايت HBM3E | 288 جيجابايت HBM3E |
| أقصى عرض نطاق الذاكرة | 8 تيرابايت/ثانية | 8 تيرابايت/ثانية |
المصادر: AMD Instinct MI355X، NVIDIA HGX B300، مواصفات الذاكرة الخاصة بـ NVIDIA. تفاصيل الاختبارات: منهجية AgentX.
ملحوظة تقنية: توجيه متقدم دقة عالية
يقوم كيمي K3 باختيار 16 من كل 896 خبيرًا لكل توكين، لذا قد تظل بعض الصفوف قليلة لكل خبير في مجموعة الخادم الكبيرة. وقد تحتوي قطع الخبراء الناتجة على زيادة في الحواف.
يقلل A4W4 جزءًا مختلفًا من حركة البيانات: التكامل في #53940 يغير تفعيلات البيانات من ثمانية بتات إلى أربعة بتات، بينما تظل الأوزان أربعة بتات. ويشمل حجم حركة البيانات الكلية أيضًا الإخراجات الوسيطة BF16 والدعامات المستخدمة من قبل الخبراء.
ملحوظة تقنية: دقة KDA والذاكرة داخل الشريحة
يجب على كل قطعة أن تحل التبعيات بين علاماتها. يقوم النواة بتجميعها في تحويل يمكن لمنتجات المصفوفة لاحقًا تطبيقها. وهذا يخلق سؤالين عمليين: أي دقة تحافظ على الإجابة، وكم من البيانات المؤقتة يمكن أن تدخل في الشريحة؟
يوضح مثال صغير الفكرة. قم باستبدال التصحيحات السابقة بالتصحيحات اللاحقة، ويمكن التعبير عن كل إجابة مباشرة من حيث المدخلات المعروفة. جدول العوامل الناتج عن ذلك يحتوي بالفعل على سلسلة الارتباطات:
في هذا المثال الخطي، يتخذ تأثير الموضع الأول على الموضع الثالث طريقين: مباشرة، −1/8؛ من خلال الموضع الثاني، (−1/4) × (−1/4) = 1/16. معًا، يصبح المجموع −1/16، وهو العنصر الموجود في الزاوية السفلية اليسرى للجدول. الأصفار فوق الخط المائل تعكس أن المواضع اللاحقة لا يمكنها التأثير على المواضع السابقة.
يحسب المقدمة الحقيقية العكس للمصفوفة التابعة للقطعة داخل القطعة التي تبلغ 64×64. وتستخدم منتجات المصفوفة اللاحقة هذه التحويل لتعويض تلك الارتباطات.
يمكن أن تزداد قيم الوسيطات للمعكوسة وتلغي بعضها. إذا تم تجميعها مبكرًا جدًا، فإن ذلك يؤدي إلى فقدان المعلومات التي يحتاجها النتيجة النهائية. يتم استخدام تعليمات مصفوفة FP32 matrix instructions الخاصة بـ AMD، مع الحفاظ على مدخلات FP32 وتراكمها للحسابات الحساسة للمعكوسة. يتم تجميع المعكوسة النهائية فقط إلى BF16 لمنتجات لاحقة. تنفيذ النواة.
لماذا لا يمكن لتراكم FP32 استعادة المدخلات المقربة
فكر في طرح 256 من 256.5. كلا المدخلين دقيقان بالنسبة لـ FP32. عند هذه الحجم، عند تحويل 256.5 إلى BF16، يتم تقريبها إلى 256:
| دقة الإدخال | الطرح يتم في FP32 | النتيجة |
|---|---|---|
| احفظ المدخلات الأصلية من نوع FP32 | 256.5 − 256 | 0.5 |
| قم بتقريب المدخلات إلى BF16 أولاً | 256 − 256 | 0 |
لا يمكن لعمليات الطرح من FP32 استرداد المعلومات التي فُقدت قبل بدء العملية. توضح هذه القيم التجريبية سبب استخدام تعليمات مصفوفة FP32 الأصلية بأبعاد 16×16×4، مما يحافظ على دقة المدخلات والتراكم.
يتولى نموذج FP4 أيضًا الاعتماد على عمليات بمعيار دقيق أكبر. يعتمد أداؤه على جعل تلك المسارات العددية فعالة.
يحتوي المقدمة أيضًا على ميزانية للذاكرة المحلية. تسمي AMD لوحة LDS المشتركة داخل الشريحة بـ LDS. تستخدم رقائق Q وK التخزين المتكرر لأنها مطلوبة في أوقات مختلفة؛ حيث يخزن المدخل المثلثي فقط عشر كتل 16×16 مشغولة. يطلب المجموعة العمل 79.5 KiB، والذي يُعادل 80 KiB، وهو نصف ميزانية LDS لوحدة حاسوب AMD CDNA 4 160 KiB.
توزيع الدوال إلى وحدات بأحجام 1280 بايت. الحد الإضافي للبيجرات الموضحة يتجاوز عتبة الإقامة: لا تكفي توزيعين. هذه حسابات السعة؛ يمكن أن تفرض السجلات والموارد الأخرى قيودًا إضافية.
اختبر هذا العتبة بإعداد كمية كافية من ملفات LDS غير المستخدمة لتجاوزه، مع الحفاظ على نسخة الملف الثنائي الثابتة للنواة. إذا لم يتغير الوقت التشغيلي كثيرًا، فإن مجموعة العمل الإضافية المقيمة قدمت مساهمة صغيرة لهذا الشكل.
الدولة بين الكتل
تتجاوز ملخصات المجموعات والحالات الابتدائية حدود النواة؛ يتم حفظ نقاط التحقق المطلوبة والحالة النهائية.
إعلانات التوضيح
المعلومات المقدمة في هذا الوثيقة تُستخدم لأغراض إعلامية فقط، وقد تحتوي على أخطاء تقنية أو إغفالات أو أخطاء إملائية. المعلومات الواردة هنا قد تتغير، وقد تكون غير دقيقة لأسباب متعددة، بما في ذلك التغييرات في المنتجات والخطة التسويقية، والتغييرات في إصدارات المكونات والذاكرة الرئيسية، والإصدارات الجديدة للمنتجات أو الأجهزة، الاختلافات في المنتجات بين الشركات المختلفة، التغييرات في البرمجيات، تحديثات BIOS، ترقيات البرمجيات، أو أمور من هذا القبيل. كل نظام كمبيوتر يحمل مخاطر أمنية لا يمكن منعها أو تخفيفها بالكامل. تتخذ شركة AMD عدم التزام بتحديث أو تصحيح أو تعديل هذه المعلومات بأي طريقة. ومع ذلك، تحتفظ شركة AMD بالحق في تعديل هذه المعلومات وإجراء تغييرات من وقت لآخر على محتواها دون أن يكون على شركة AMD أي التزام بإبلاغ أي شخص عن هذه التعديلات أو التغييرات. تُقدَّم هذه المعلومات "كما هي". لا تقدم شركة AMD أي التزامات أو ضمانات بخصوص محتواها، ولا تتحمل أي مسؤولية عن أي أخطاء أو إغفالات قد تظهر في هذه المعلومات. وتنفي شركة AMD بشكل خاص أي ضمانات ضمنية بشأن عدم التعدي على حقوق أخرى، أو قابلية البيع، أو ملاءمتها لأي غرض معين. في أي حالة، لن يكون AMD مسؤولاً تجاه أي شخص عن أي أضرار مباشرة أو غير مباشرة، خاصة أو أخرى ناتجة عن استخدام أي معلومات موجودة في هذا النص، حتى لو تم إخطار AMD صراحةً بإمكانية حدوث مثل الأضرار. AMD وشعار AMD Arrow وما إلى ذلك من علامات التجارية تخص شركة Advanced Micro Devices, Inc. أسماء المنتجات الأخرى المستخدمة في هذا النشر تُستخدم لأغراض التعريف فقط وقد تكون علامات تجارية لشركاتها المختلفة. © 2026 شركة Advanced Micro Devices, Inc. جميع الحقوق محفوظة.