
بيانات بنصها الأصلي لـ 22 لغة، وبيانات مكتوبة بالأحرف اللاتينية لاثنتي عشرة لغة، وخط أنابيب قابل لإعادة الاستخدام ومعزّز بوحدات المعالجة الرسومية للترجمة وتقييم الجودة والإصلاح.
المؤلفون: AI4Bharat — Mohammed Safi Ur Rahman Khan، Mitesh Khapra، Anoop Kunchukuttan. NVIDIA — Niket Agarwal، Raviraj Joshi، Anusha Kamath، Markus Kliegl، Yev Meyer، Sriharsha Niverty، Kiran Praveen، Utkarsh Vaidya.
يسرّنا أن نقدّم Nemotron-pretraining-Indic-v1 حوالي 2.8 تريليون رمز عبر 22 لغة هندية، والتي سيتم إطلاقها قريبًا إلى جانب خط أنابيب توليد البيانات المفتوح المعزّز بوحدات المعالجة الرسومية المستخدَم لإنشائها. هذه هي اللغات الـ 22 المدرجة في دستور الهند: اللغات الأولى لـ 97% من الهنود، أو ما يقرب من 1.2 مليار مواطن وفق تعداد عام 2011. طوّرت NVIDIA هذا الإصدار بالتعاون مع IIT Madras، أبرز مؤسسة هندسية في الهند، ومختبر AI4Bharat التابع لها، ويمنح هذا الإصدار بناة النماذج موردًا جديدًا وهامًا للتدريب المسبق للغات الهندية. يلتقط خط الأنابيب وصفة التوليد الكاملة، بما في ذلك المطالبات وسير عمل النماذج اللغوية الكبيرة وفحوصات الجودة، بحيث يمكن للمطورين تكييفه مع مصادرهم الخاصة وتوليد المزيد من البيانات وفق احتياجاتهم.
AI4Bharat، مختبر أبحاث اللغات الهندية في IIT Madras، يطوّر مجموعات بيانات ونماذج مفتوحة المصدر للغات الهندية. وقد ساعدت موارده، مثل Sangraha، وهو مدخل تدريب مسبق مفتوح لـ 22 لغة هندية، في وضع الأساس لأبحاث نماذج اللغات الهندية مفتوحة المصدر. ويمثّل إصدارنا المشترك مفتوح المصدر توسعًا كبيرًا في بيانات التدريب الهندية الاصطناعية المفتوحة التي ستكون متاحة للمجتمع. فهو يقدّم مزيجًا واسعًا من المحتوى الإنجليزي المنسّق، بما يشمل الرياضيات والشيفرة ومحتوى الأسئلة والأجوبة، إلى اللغات الهندية، مما يمنح الفرق مادة تدريبية إضافية لبناء نماذج قادرة على شرح المفاهيم التقنية وحل المشكلات والإجابة عن الأسئلة بتلك اللغات. كل سجل يعود إلى مستند مصدر منسّق، ويتم فحص كل مخرجات مقابل مدخلاتها، بحيث يبقى النص الاصطناعي مرتكزًا على معلومات حقيقية.
Mitesh Khapra، الذي يرأس AI4Bharat وأُدرج في قائمة TIME100 AI لعام 2025، قدّم المشكلة الجوهرية: تقنيات اللغات الهندية متأخرة عن الإنجليزية لأن "ليس لدينا بيانات كافية للغات الهندية". ونحن نستجيب لهذه الدعوة بمزيد من البيانات، إضافة إلى وصفة مفتوحة لتوليد المزيد منها.
يراعي المدخل أيضًا كيفية كتابة الناس. فهو يتضمن بيانات بنصها الأصلي لجميع اللغات الـ 22 ونصوصًا مكتوبة بالأحرف اللاتينية لاثنتي عشرة لغة، بواقع 34 تكوينًا من اللغة والنص. تجمع سير عملنا بين الترجمة على مستوى المستند وتقييم الجودة والإصلاح الموجّه، مع فحوصات للحفاظ على المحتوى مثل المعادلات والجداول والشيفرة. وتكمّل هذه البيانات النصوص الهندية المكتوبة طبيعيًا، والتي تظل أساسية للمعرفة المحلية والسياق الثقافي.
نحن نشارك وصفة التوليد المفتوحة حتى لا يقتصر دور المجتمع على إعادة إنتاج البيانات، بل يأخذ هذا العمل خطوة أبعد. يمكن للفرق استخدام المدخل مباشرةً، أو تكييف المطالبات وفحوصات الجودة، أو إحضار مستندات المصدر الخاصة بها إلى سير العمل. ومن خلال فتح البيانات والعملية معًا، نهدف إلى جعل توليد البيانات الهندية على نطاق واسع أكثر سهولة، وتمكين المزيد من المطورين من المساهمة في نماذج أقوى عبر اللغات الهندية.
أضاف التدريب المسبق المستمر لـ Nemotron 3.5 Super VL 10 مليارات رمز هندي، مأخوذة من مجموعة فرعية مكونة من اثنتي عشرة لغة من هذا المدخل ومن نصوص هندية طبيعية. ويغطي تقريرنا التقني حول النموذج القصة كاملة. نخطط للبناء على هذا المدخل في نماذج Nemotron المستقبلية.
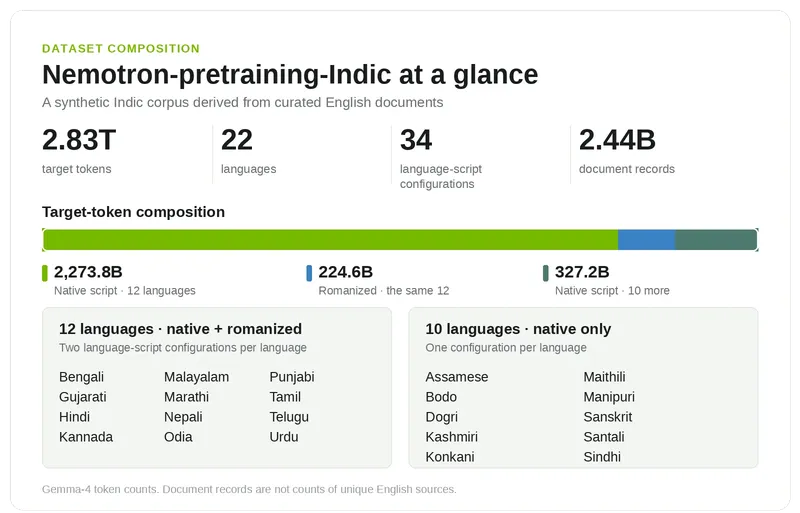
ماذا يحتوي المدخل؟
 الشكل 1. يحتوي المدخل على 2,601.0 مليار رمز بنص أصلي و224.6 مليار رمز مكتوب بالأحرف اللاتينية. تستخدم العدّادات مُرمِّز Gemma-4. سجلات المستندات تشمل ترجمات ومتغيرات نصية لمصادر مشتركة؛ وهي ليست عدّادات المستندات الإنجليزية الفريدة.
يتكون المدخل من مجموعتين من تكوينات اللغات:
- بيانات بالخط الأصلي وبيانات منقولة بالحروف اللاتينية: البنغالية، والغوجاراتية، والهندية، والكانادية، والماليالامية، والماراثية، والنيبالية، والأوريا، والبنجابية، والتاميلية، والتيلوغوية، والأردية.
- بيانات بالخط الأصلي: الأسامية، والبودو، والدوغرية، والكشميرية، والكونكانية، والمايثيلية، والمانيبورية، والسنسكريتية، والسانتالية، والسندية.
هنا، بالخط الأصلي تصف نظام الكتابة: لا يزال النص مترجمًا من الإنجليزية. منقول بالحروف اللاتينية يعني نصًا بلغة هندية مكتوبًا بالحروف اللاتينية، وليس ترجمة إنجليزية. ولكل لغة من اللغات الاثنتي عشرة ذات النصين، يشمل النقل بالحروف اللاتينية مجموعة فرعية من الترجمات المقبولة بالخط الأصلي.
هذا التمييز مهم عند بناء خليط تدريبي. السجلات الأصلية والمعرَّبة بالحروف اللاتينية توفر تعرضًا مختلفًا لنظام الكتابة، لكن يمكنها التعبير عن المحتوى الأساسي نفسه. أعداد الرموز تصف المحفوظات المحتفَى بها، بما في ذلك إعادة الكتابة المقبولة، وليس ميزانية رموز تشغيل تدريبي. كما أن الأعداد تعتمد على المُرمِّز المستخدم، لذا يجب قراءة جرد المحفوظات وأعداد رموز التدريب بشكل منفصل.
من مستندات المصدر الإنجليزية إلى بيانات تدريب هندية
لبناء هذه المحفوظات، نبدأ بمستندات من 15 Nemotron-CC-v2 مجموعة فرعية، تغطي نصوص الويب والمواد السؤال-الجواب والرياضيات والبرمجة ومحتوى متخصصًا آخر. نستخدم NeMo Data Designer، إطار NVIDIA مفتوح المصدر لتوليد البيانات الاصطناعية، لإجراء الترجمة وفحوصات الجودة والإصلاح الموجّه. في جميع مراحل سير العمل، نحتفظ بمعرّف كل مصدر حتى يتمكن المطوّرون من تتبّع أي مخرجات وصولاً إلى المستند الأصلي. هذا الوضوح في المصدر هو جزء مما يجعل البيانات المفتوحة قابلة للتدقيق والبناء عليها عمليًا. يوضح الشكل 2 سير العمل لاثنتي عشرة لغة.
 الشكل 2. خط أنابيب هندي اصطناعي من أربع مراحل لاثنتي عشرة لغة، منفّذ باستخدام NeMo Data Designer وGemma-4-31B-it. نترجم المستندات الإنجليزية، ونقيّم جودة الترجمة، ونصلح المخرجات منخفضة الدرجات، ونحوّل مجموعة فرعية من الترجمات المقبولة إلى الحرف اللاتيني. اللغات العشر الأخرى تستخدم سير عمل Indic Translate المنفصل الموصوف أدناه.
سير العمل ذو الاثنتي عشرة لغة
بالنسبة لهذه اللغات الاثنتي عشرة، نترجم المستندات كاملة حتى يتمكن النموذج من استخدام السياق عبر الفقرات والجداول والمعادلات. اخترنا Gemma-4-31B-it بمقارنة النماذج على مستندات كاملة، مع فحص جودة الترجمة والحفاظ على المحتوى التقني. تُميّز مطالباتنا بين النصوص المطلوب ترجمتها والمحتوى الواجب الحفاظ عليه، بما في ذلك الشيفرة والمعادلات وعناوين URL والتنسيق.
بعد الترجمة، نستخدم النموذج نفسه لتقييم كل مخرجات مقابل مصدرها الإنجليزي. يغطي مقياس تقييم مستوحى من Multidimensional Quality Metrics (MQM)، وهو إطار مفتوح لتصنيف أخطاء الترجمة حسب النوع والشدة، المعنى والطلاقة والمصطلحات والأسلوب والتنسيق. نحتفظ فقط بالمخرجات التي تحصل على 75 من 100 على الأقل (درجة مقياس تقييم، وليست نسبة مئوية من الدقة). أما المخرجات الأقل درجة، فنستخدم ملاحظات التقييم لتوجيه الإصلاحات، ثم نعيد تقييمها مقابل العتبة نفسها. استعادت هذه العملية 438.4 مليار رمز عبر بيانات الحرف الأصلي والبيانات المعرّبة لاتينيًا، وهي مشمولة أصلًا في إجمالي المحفوظات. ساعدت المراجعات البشرية المُعيَّنة والاختبارات بأخطاء مُدخلة عمدًا في تحديد الإغفالات والإنجليزية المتبقية، مما أدى إلى تحسين مطالباتنا وفحوصاتنا.
توفر الترجمات المقبولة بالحرف الأصلي أيضًا نقطة البداية للبيانات المعرَّبة لاتينيًا. نحوّل مجموعة فرعية منها إلى الحرف اللاتيني ونتحقق من كل نتيجة مقابل مدخلها بالحرف الأصلي. هذا يفصل الترجمة عن تحويل نظام الكتابة. في مقارنتنا البشرية الأولية، أنتجت هذه الطريقة ذات الخطوتين إضافات وهمية أقل وإنجليزية متبقية أقل من توليد نص معرَّب لاتينيًا مباشرة من الإنجليزية.
سير العمل ذو العشر لغات
بالنسبة للغات العشر الأخرى، نكيّف سير العمل لمعالجة مشكلات جودة المستندات الطويلة واستقرار نظام الكتابة التي لوحظت في مقارناتنا. نترجم باستخدام Indic Translate، وهو نموذج ترجمة على مستوى المستند للإنجليزية و22 لغة هندية من Bodhan AI، وهو مركز غير ربحي للذكاء الاصطناعي في التعليم مستحدث في معهد IIT Madras. ثم يقيّم Gemma-4-31B-it كل ترجمة مقابل مصدرها الإنجليزي. ولثمان لغات، نحتفظ بأسلوب المستند الكامل. أما مستندات Santali الأطول، فنترجم نوافذ متداخلة ونعيد بناء المستند؛ ولغة Manipuri، نترجم إلى الحرف البنغالي قبل التحويل إلى Meitei Mayek، حرفها الأصلي. تحتفظ سير العمل هذه بالمخرجات التي تحصل على 75 من 100 على الأقل، وتنتج بيانات بالحرف الأصلي فقط، دون إعادة كتابة قائمة على الملاحظات.
ما الذي تغيّر بعد التدريب المسبق المستمر الهندي؟
تقارن التقرير التقني لـ Nemotron 3.5 Super VL نقطة التفتيش التي تسبق مباشرة التدريب المسبق المستمر الهندي (CPT) بنقطة التفتيش التي تلي تلك المرحلة. كانت الميزانية المُهيَّأة 100 مليار رمز تدريبي، مع تخصيص 10% (10 مليارات رمز) لخليط من النص الهندي الاصطناعي والطبيعي. وحافظ الـ90% المتبقية على النسب النسبية لخليط التدريب السابق.
ارتفعت الدرجات على جميع معايير المعرفة والاستدلال الهندية الخمسة المُبلَّغ عنها: MILU وIndic MMLU-Pro وIndic ARC-Challenge وIndic ARC-Easy وIndic GSM8K.
 الشكل 3. Nemotron 3.5 Super VL قبل وبعد مرحلة Indic CPT. تتراوح المكاسب بين 4.98 و9.82 نقطة مئوية. تعرض المقارنة التغير عبر مرحلة تدريب تجمع بين بيانات هندية (Indic) اصطناعية وطبيعية، بدلاً من عزل مساهمة المدون الاصطناعي. يختلف تغطية اللغات باختلاف المعيار؛ وهذه نقاط تفتيش على مستوى المرحلة، وليست مقارنة بين إصدارات نهائية للنموذج.
المصدر: التقرير التقني لـ Nemotron 3.5 Super VL، الجدول 2. يستثني GSM8K اللغة الأودية (Odia) لأن التقييم تجاوز حد سياق الخدمة.
تدعم هذه المكاسب وصفة Indic CPT المدمجة بين الاصطناعي والطبيعي، مع ترك اختيار المزيج للنماذج واللغات الأخرى لدراسات لاحقة.
يتناول تقرير Indic المرافق مخاليط المصادر وحجم مجمع البيانات الاصطناعية وتغطية أنظمة الكتابة باستخدام البيانات المقبولة من التمريرة الأولى لمجموعة اللغات الاثنتي عشرة. ويبقى تقييم المدون الكامل، بما في ذلك إعادة الكتابة المستعادة واللغات العشر الأخرى، خطوة تالية لتلك الدراسات المضبوطة.
قدرات هندية أوسع في Nemotron 3.5 Super VL
وإلى جانب نتائج مرحلة CPT، كيف يقارن النموذج المُصدَر مع الجيل السابق؟ يقارن الشكل 4 بين Nemotron 3.5 Super VL و Nemotron 3 Super عبر أداء المهام الهندية وجودة اللغة. تعكس هذه النتائج خط التدريب الكامل للنموذج المُصدَر، بما في ذلك Indic CPT والتدريب اللاحق.
يحقق Nemotron 3.5 Super VL درجات أعلى في خمسة من معايير المهام الستة المعروضة، والتي تشمل المعرفة والاستدلال والرياضيات والبرمجة والترجمة. بينما تراجع اتباع التعليمات على IFEval 1.5 بمقدار 2.04 نقطة. كما يتحسن عبر جميع أبعاد IndiVibe الأربعة: الفائدة، والسلاسة، وأمانة اللغة ونظام الكتابة، والإسهاب المناسب. IndiVibe هو معيار مفتوح من Sarvam AI يضم مطالبات بأسلوب المساعد باللغات الهندية. معًا، تفحص هذه التقييمات كلًا مما يستطيع النموذج فعله ومدى جودة تواصله باللغات الهندية.
 الشكل 4. أداء المهام الهندية وجودة اللغة عبر أجيال Nemotron Super. يسار: ستة معايير مهام. يمين: درجات تفضيل شرطية أولية من IndiVibe، وليست معدلات فوز مباشرة وجهًا لوجه. تُظهر التسميات التغيرات بالنقاط المئوية، باستثناء WMT24++ الذي يستخدم نقاط chrF. راجع تقرير Indic التقني المرافق لتفاصيل المعايير والتقييم.
ابدأ البناء
حمّل المدون
ابدأ باللغات وأنظمة الكتابة التي يحتاجها نموذجك، وافحص عينة، وراجع بطاقة مجموعة البيانات والترخيص قبل التدريب. تستخدم التكوينات وسوم اللغة ونظام الكتابة والمنطقة: على سبيل المثال، hi-Deva-IN يدل على Hindi بنظام الديفاناغاري، بينما hi-Latn-IN يدل على Hindi بالحروف الرومانية.
يطلب المثال أدناه معرّف المستودع من بطاقة مجموعة البيانات، ثم يكتشف التقسيمات المتاحة ويبث عينة.
from datasets import get_dataset_split_names, load_dataset

dataset_id = input("Repository ID from the dataset card: ").strip()
config = "hi-Deva-IN"

splits = get_dataset_split_names(dataset_id, config_name=config)
print("Available splits:", splits)

data = load_dataset(
    dataset_id, name=config, split=splits[0], streaming=True
)
print(next(iter(data)))
يدعم Hugging Face Datasets البث ليتمكن القراء من فحص السجلات دون تنزيل المدون بالكامل. بمجرد توفر الإصدار، ثبّت مراجعة مجموعة البيانات لتجارب قابلة للتكرار.
لأول دراسة تدريب، قارن بين المخاليط عند ميزانية رموز ثابتة وسجّل حصص الطبيعي/الاصطناعي والأصلي/الروماني. تتبّع النتائج لكل لغة جنبًا إلى جنب مع الاحتفاظ بقدرات الإنجليزية وجودة اللغة/نظام الكتابة. عند إنشاء تقسيمات محجوزة للاختبار، ضع في الاعتبار السجلات المشتقة من المصدر نفسه عبر اللغات وأنظمة الكتابة.
لبناء وصفة أكمل، اقرن المدون مع بيانات التدريب اللاحق من Nemotron، مثل مجموعتي Chat & Instruction أو Post-Training Blends . ولبيانات اصطناعية خاصة بالهند، زوّد NeMo Data Designer بـ Nemotron-Personas-India، وهي شخصيات اصطناعية بالإنجليزية والهندية مستندة إلى توزيعات واقعية للهند.
كيّف وصفة التوليد
المصدر المفتوح الإضافة البرمجية للترجمة Nemotron Bharat لأداة NeMo Data Designer توفر مطالبات للترجمة والتقييم، وإعادة كتابة اختيارية قائمة على الملاحظات، وتقسيم المستندات إلى نوافذ، ودعمًا لإعادة التعيين بين أنظمة الكتابة. استخدم مرجع الإعدادات الخاص بها لاختيار النماذج واللغات، وتكييف المطالبات مع مجالك، وضبط معلمات إعادة الكتابة. أما الملاحظة التقنية المرافقة فتشرح سير العمل والخيارات الهندسية.
ابدأ بعينة صغيرة من مستنداتك المصدرية الخاصة. افحص جودة الترجمة والحفاظ على الشيفرة والرياضيات والتنسيق، ثم حسّن المطالبات والفحوصات بالاستعانة بمراجعين بلغتهم الأم قبل التوسع. تعامل مع التوليد وقبول المدونة كخطوتين منفصلتين: تُعيد الإضافة البرمجية المرشحات والدرجات، بينما تحدد سياسة الترشيح لديك أي السجلات تدخل مدونة التدريب.
النطاق والقيود
توسّع الترجمة الوصول إلى المادة المصدرية، لكنها لا تحل محل النصوص المكتوبة أصلًا باللغات الهندية ولا تضمن تغطية المعرفة والثقافة المحلية. نوصي بالجمع بين هذه المدونة ونصوص هندية طبيعية من مصادر مناسبة، وتقييم المزيج الناتج للاستخدام المقصود.
يُقدَّم تقييم الجودة بشكل آلي أساسًا، مع مراجعة بشرية بالعيّنة تغطيتها تتفاوت بين اللغات. في سير العمل ذي اللغات الاثنتي عشرة (الشكل 2)، يعمل المترجم أيضًا كحكم. قد يظل النص المحتفى به يحتوي على أخطاء، وسير العمل ذو اللغات العشر يحتاج إلى تحقق أوسع من الناطقين باللغة الأم. تزيل فحوصات المعرّف المصدر الازدواجيات الناتجة عن المعالجة؛ وهي ليست إزالة ازدواجية دلالية للمحتوى المتشابه.
إلى جانب المدونة، تعمل منظمة AI4Bharat في معهد IIT Madras، بدعم من NVIDIA، على بناء Indic-LLM-Eval-Suite، وهي مجموعة مفتوحة ومتطورة من مقاييس الأداء لقدرات النماذج الهندية. تساعد هذه المجموعة بناة النماذج على تقييم أداء المهام وجودة اللغة معًا. انظر المدونة المرافقة: النماذج الأفضل تحتاج إلى معايير تقييم أفضل: تقديم Indic-LLM-Eval-Suite.
استكشف إعدادات اللغات، أو جرّب مزيجًا تدريبيًا، أو كيّف الوصفة المفتوحة لمجال جديد. يمكن لمشاركة النتائج لكل لغة والتحسينات على سير عمل التوليد أن تساعد المجتمع على البناء على هذا العمل.
قراءات إضافية وشكر وتقدير
التقريران المرافقان، Scaling Synthetic Pre-training Data and Evaluation for Indic LLMs و الإصدار التقني Nemotron 3.5 Super VL وLightning، يقدمان محاسبة المدونة وأساليب التوليد والتجارب وتفاصيل التقييم. التقييم هو النصف الآخر من هذا العمل. وفي ما يتعلق بمقاييس الأداء، انظر المدونة المرافقة من AI4Bharat وNVIDIA بعنوان النماذج الأفضل تحتاج إلى معايير تقييم أفضل: تقديم Indic-LLM-Eval-Suite.
يجمع هذا العمل بين NVIDIA وIIT Madras وAI4Bharat وBodhan AI. كما نعترف بمساهمات النماذج والأدوات المستخدمة في خط المعالجة: Gemma من Google، وIndic Translate من Bodhan AI، وNeMo Data Designer. ويتوفر المزيد من موارد بيانات NVIDIA في مجموعة بيانات ما قبل التدريب Nemotron Pre-Training Datasets.