
باختصار: نموذج Beam من Reflection هو نموذج MoE بـ 501B معلمة مع 23B معلمة نشطة لكل رمز. يدعمه vLLM من اليوم 0 ويحسّنه على NVIDIA Blackwell:
- دعم كامل للميزات. الاستدلال المنطقي، واستدعاء الأدوات، والمخرجات المهيكلة تعمل مباشرة من الصندوق، ويمكنك تشغيل النموذج بتوازن الموترات أو البيانات أو الخبراء.
- تحسين موجّه بالوكلاء. قام وكلاء برمجة بتحسين النموذج ذاتيًا، مما جعل فك ترميز الدفعة-1 أسرع بمقدار 2.71× والتهيئة المسبقة أسرع بمقدار 1.87× مقارنة بأول تنفيذ لدينا.
- DFlash2 مع تحقق تكيفي. مع مسوّد DFlash2 الخاص بـ Beam، يصل طلب واحد إلى 708 رمزًا/ثانية على TP8، بطول قبول يبلغ 3.7. التحقق التكيفي، الذي يقرر في كل خطوة عدد رموز المسودة التي يستحق التحقق منها، يضيف 10% زيادة إضافية في الإنتاجية عند التزامن العالي.
لتجربته، استخدم صورة Docker الخاصة بنا vllm/vllm-openai:reflection-beam:
docker run --gpus all --ipc=host -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  vllm/vllm-openai:reflection-beam \
  reflection/Beam-1.0-501B-A23B-NVFP4 \
  -tp 4 \
  --max-num-seqs 128 \
  --reasoning-parser beam \
  --tool-call-parser beam --enable-auto-tool-choice \
  --kv-cache-dtype fp8 \
  --attention-config '{"backend":"FLASHINFER"}' \
  --kernel-config '{"enable_flashinfer_autotune":false}' \
  --speculative-config '{
    "method": "dflash",
    "model": "reflection/Beam-1.0-501B-A23B-DFlash2",
    "num_speculative_tokens": 7,
    "attention_backend": "FLASH_ATTN"
  }'
بنية النموذج
Beam هو مُفكِّك MoE من 52 طبقة بحجم مخفي 5120. يتبع توجيه MoE نمط DeepSeek-V3. الاختلافات الرئيسية تكمن في طبقات الانتباه وفي كيفية تطبيع تدفق البواقي.
الشكل 1: كومة طبقات Beam وطبقة مُفكِّك واحدة متفرقة. اللون الذهبي يحدد الأجزاء التي تختلف عن MoE القياسي ذي التطبيع المسبق. افتحه في وضع ملء الشاشة.
الانتباه
- طبقات هجينة بنافذة منزلقة وطبقات NoPE. 43 طبقة تستخدم انتباه النافذة المنزلقة على آخر 512 رمزًا، مع RoPE. أما الطبقات الـ 9 الأخرى (كل سادس طبقة، بالإضافة إلى الأخيرة) فتنتبه للسياق الكامل مع ترميز موضعي (NoPE).
- SSMax على طبقات NoPE. بدون RoPE، يتسطح الانتباه مع زيادة عدد المفاتيح. يقوم SSMax بتوسيع كل استعلام بـ
(1 + p/2048)^0.1، حيثpهو الموضع بدءًا من 1، بحيث يزداد حدة softmax مع نمو السياق. - GQA مع تطبيع Q/K لكل رأس. 48 رأس استعلام، 8 رؤوس KV، بُعد الرأس 128. يتم تطبيع Q وK بواسطة RMS لكل رأس قبل RoPE أو SSMax.
- بوابة مخرجات sigmoid. قبل
o_proj، إذ يُضرب ناتج كل رأس في σ(gate + bias)، حيث يأتي البوابة من إسقاطه الكامل العرض مع انحياز مُتعلَّم لكل رأس. يمكن خفض أو إطفاء الرأس رمزًا برمز. - ذاكرة KV صغيرة. تحتفظ فقط طبقات الانتباه الكامل الـ 9 بـ KV للتسلسل بأكمله:
- 9 × 2 × 8 × 128 قيمة لكل رمز، أي 36 KiB بصيغة BF16 و18 KiB بصيغة FP8.
- نحو 18 GiB من FP8 KV لسياق كامل من 1M رمز، قبل التجزئة.
MoE والتيار المتبقي
- MoE على نمط DeepSeek-V3. 256 خبيرًا موجَّهًا (d_ff 2,560، NVFP4)، موجهون بالطريقة نفسها كما في DeepSeek-V3: درجات sigmoid مع انحياز تصحيحي تختار أفضل 4 من أصل 8 مجموعات خبراء، ثم أفضل 8 خبراء، وتُضرب الأوزان المعاد تطبيعها في 2.5. وعلى عكس DeepSeek-V3، لا يوجد خبير مشترك. الطبقات 0–2 تستخدم MLP كثيفة SwiGLU (d_ff 20,480) بدلًا من ذلك.
- موجِّه FP32. أوزان الموجِّه 5120 × 256 والتراكم والقيم اللوجيتية كلها FP32.
- تطبيع ساندويتش. كل طبقة فرعية لها RMSNorm قبلها وأخرى بعدها.
- متبقيات مقيَّسة بالعمق. الجمع المتبقي n-th يحسب
h ← √((n−1)/n)·h + x/√nبدلًا منh + x. مع مخرجات طبقات فرعية ذات تباين وحيد، يحافظ التيار المتبقي على تباين وحيد عند كل عمق بدلًا من أن ينمو معه.
التحسين الموجَّه بالوكلاء
كانت نسختنا الأولى من التنفيذ نسخة غير محسَّنة، تكاد تكون PyTorch خالصة، من النموذج. ثم حسَّنّاها بشكل مستقل بواسطة وكلاء برمجة: قاموا بقياس أداء النموذج، وكتبوا النوى، وقيسوا كل تغيير. على TP8، أدخلت التغييرات السبعة أدناه فك الترميز بدفعة 1 من 8.95 ms إلى 3.30 ms لكل خطوة، وprefill بدفعة 8 × 2K من 328 ms إلى 176 ms.
الشكل 2: زمن استجابة التمرير الأمامي للنموذج على TP8 على GB200 بعد كل تغيير، لفك الترميز بدفعة 1 وprefill بدفعة 8 × 2,048 رمزًا عند سياق ~100K. تستخدم اللوحتان مقياسين مختلفين. اعرض الجدول للقيم الدقيقة، أو افتحه بالشاشة الكاملة.
- دمج التطبيع ← المتبقي ← التطبيع (−40% في فك الترميز). تعمل الآن عملية ما بعد التطبيع، والجمع المتبقي المقيَّس، والتطبيع السابق التالي عند كل من حدود الطبقات الفرعية الـ 104 كنواة Triton واحدة، بعمليات FP32 ونقاط التقريب BF16 المرجعية نفسها.
- دمج Q/K norm وRoPE/SSMax وبوابة المخرجات. يعمل Q/K RMSNorm وRoPE لكل رأس (أو SSMax) كنواة واحدة، وبوابة sigmoid كنواة أخرى.
- دمج all-reduce داخل نوى التطبيع. كلا عمليتي TP all-reduce في كل طبقة تعملان داخل نواة التطبيع، المبنية على multicast all-reduce من FlashInfer. بعد MoE، تجمع النواة نفسها أيضًا مخرجات أفضل 8 خبراء.
- نواة GEMM مخصصة للموجِّه FP32. كان الموجِّه يعود إلى مسار عام. نواة الموجِّه FP32 للدفعات الصغيرة في vLLM تدعم الآن شكل Beam ذا 5120 × 256، مع الحفاظ على أوزان وتراكم وقيم لوجيتية FP32.
- دمج إسقاط QKV + البوابة مع GEMM منخفض زمن الاستجابة. تُحزم أوزان Q وK وV والبوابة في مصفوفة واحدة وقت التحميل، فتعمل الإسقاطات الأربعة كـ GEMM واحد. وللدفعات الصغيرة يستخدم CuTe DSL GEMM منخفض زمن الاستجابة أو TinyGEMM من FlashInfer.
- تحديث مدمج لذاكرة KV المؤقتة. نواة Q/K norm وRoPE تكتب الآن أيضًا K وV في ذاكرة KV المؤقتة، بحيث لا توجد نواة منفصلة للكتابة في الذاكرة المؤقتة.
- تفعيل Dense-MLP في نواة واحدة للطبقات الكثيفة الثلاث.
المخطط المدمج
بعد هذه التغييرات، تعمل طبقة MoE واحدة كـ 13 نواة في فك التشفير batch-1 على TP8.
الشكل 3: النوى بترتيب الإطلاق لطبقة MoE واحدة، من تتبع rank-0 لفك التشفير batch-1 TP8. النوى الذهبية كُتبت أو دُمجت أو مُددت لـ Beam. تُدرج كل نواة العمليات التي تحسبها. افتحه بملء الشاشة.
- تمت كتابة 6 نوايا أو دمجها أو توسيعها لـ Beam. كل عملية صغيرة خاصة بـ Beam مدمجة مع جار لها، وكلا عمليتي all-reduce تقعان داخل نوى norm.
- 7 نوايا تأتي من المكتبات: TRTLLM-gen attention، وإسقاط المخرجات cuBLAS، ومسار TRTLLM NVFP4 MoE (الكمّنة، واثنتان من نوى التوجيه، واثنتان من GEMM المجمعة). معظم الوقت المتبقي موجود هنا، لذا فهي التالية على القائمة.
Attention DP + MegaMoE
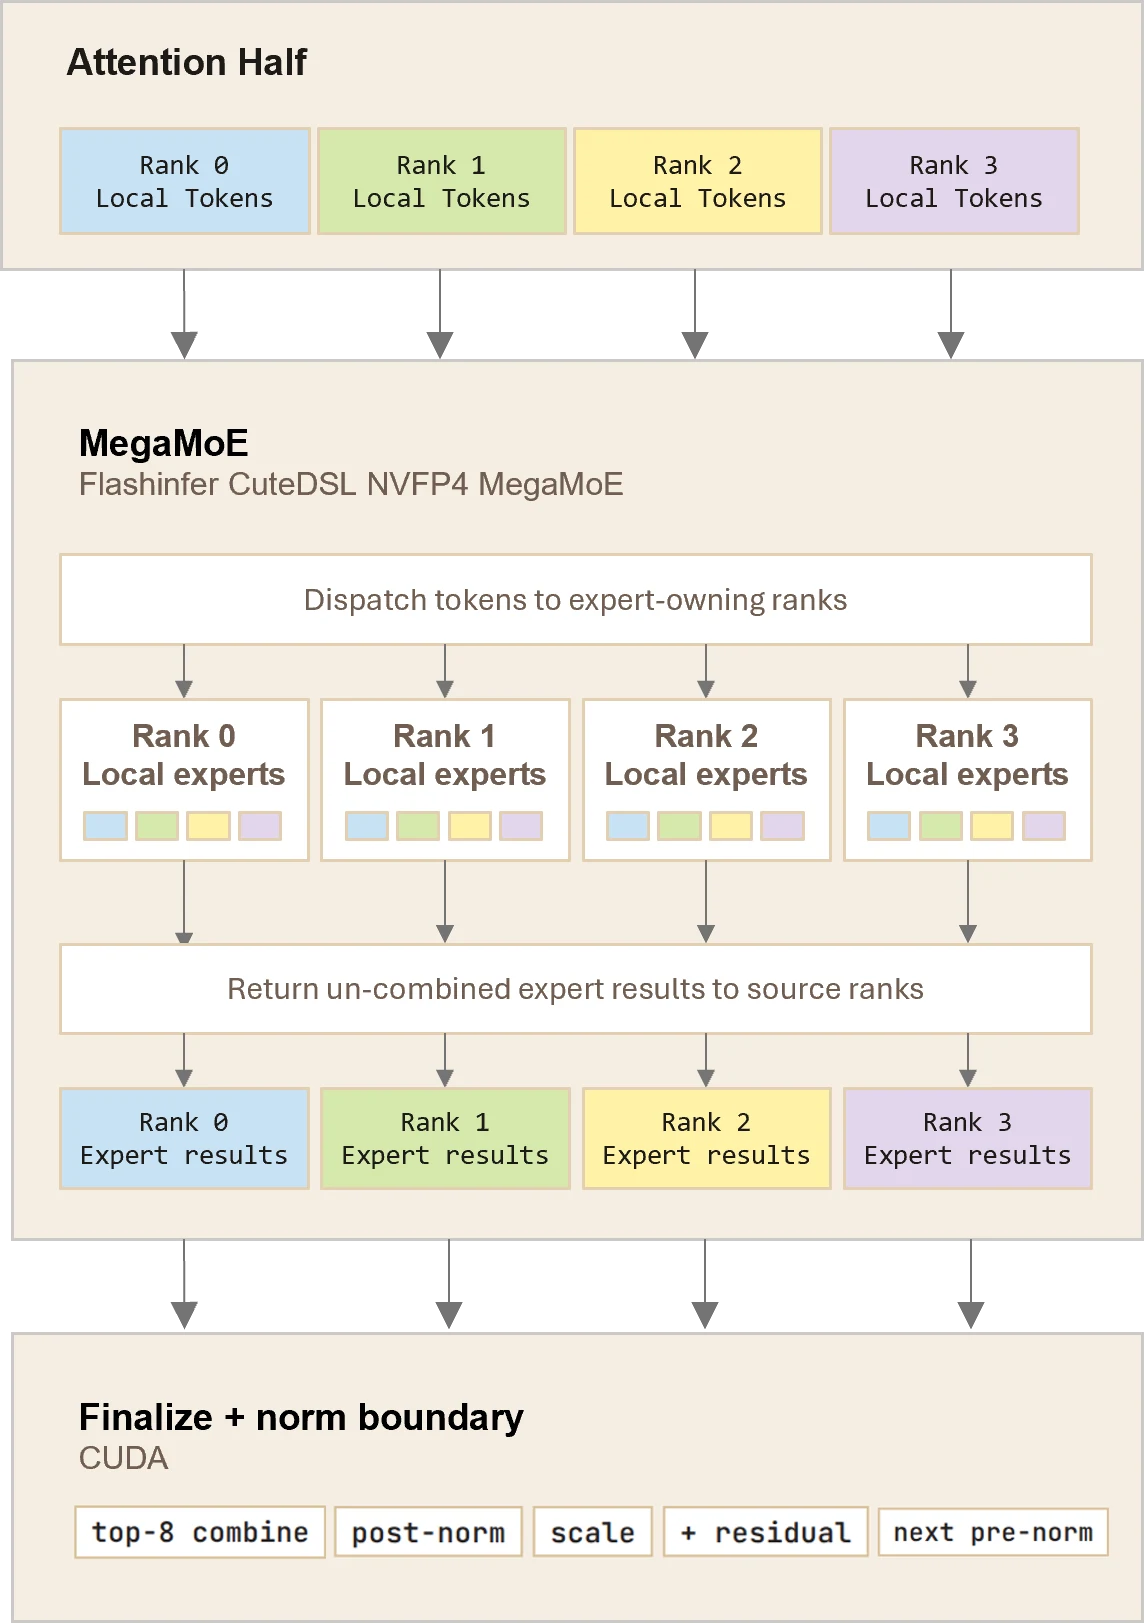
الشكل 4: يمكن لـ FlashInfer CuteDSL NVFP4 MegaMoE دمج الاتصالات مع حساب الخبراء.
في منطقة التزامن العالي، يمكن تحسين أداء Beam بشكل أكبر من خلال الجمع بين Attention DP وMegaMoE، المدعومة بنواة FlashInfer CuTe DSL NVFP4 MegaMoE. يظل دمج الحدود بين Finalize + norm قابلاً للتطبيق.
| التكوين | إنتاجية ذروة رموز الإدخال |
|---|---|
| Attention DP + MegaMoE | 168.8K رمز / ثانية |
TP (flashinfer_trtllm, flashinfer_nvlink_one_sided) | 98.7K رمز / ثانية |
قدّم Attention DP مع MegaMoE إنتاجية prefill ذروة أعلى بمقدار 1.71× من TP4. إعداد المعيار: 4×GB300، مع طول تسلسل إدخال يبلغ 32K من الرموز وطول تسلسل إخراج يبلغ 1 رمز لعزل أداء prefill.
لتمكين Attention DP + MegaMoE، استبدل إعدادات MoE والتوازي بـ:
  --moe-backend flashinfer_moe_ep_cutedsl \
  --data-parallel-size 4 \
  --enable-expert-parallel
فك التشفير التخميني DFlash2
يأتي Beam مزودًا برأس مسودة DFlash2 draft head، الذي تدعمه vLLM من اليوم 0. بدلاً من صياغة رمز واحد في كل مرة، فإنه يتنبأ بكتلة كاملة من الرموز في تمريرة أمامية واحدة من الحالات الخفية للنموذج الهدف.
- الصائغ (Drafter). 5 طبقات نافذة منزلقة تقرأ الحالات الخفية من 5 طبقات هدف وتشارك تضمين الهدف ورأس LM. تعمل الالتفاف المجمّع ومنتقي المرشحين الصغير على استعادة جزء من التبعية من اليسار إلى اليمين التي يفقدها الصائغ المتوازي.
- التحقق التكيفي. مع
"enable_adaptive_verification": true، يتنبأ vLLM بمدى احتمال قبول كل رمز مسودة (draft token) ويُتحقق فقط من الرموز التي تستحق تكلفتها، بدلاً من عدد ثابت في كل خطوة. لا يملك DFlash2 رأس ثقة (confidence head)، لذا يأتي تقدير القبول من logits المسوّد نفسه (انظر منشورنا الأخير حول التحقق التكيفي). - Kernels. إن الالتفاف (convolution) المسوّد وعمليات التطبيع وكتابات KV مدمجة، وتعمل خطوة المسودة كاملة ضمن CUDA graph. كما تعمل ذاكرة KV cache بنمط FP8 مع المسوّد دون أي تغيير في معدل القبول.
نتائج الخدمة على TP8، مع التحقق التكيفي وبدونه، على فئة الإنتروبيا المنخفضة من SPEED-Benchالخاصة بـ throughput_1k split: مطالبات بحجم ~1K رمز، معظمها إكمال برمجي وترتيب نصوص، مع فك ترميز جشع (greedy) وما يصل إلى 4K رمز إخراج. النصوص منخفضة الإنتروبيا أسهل في التنبؤ، لذا توقّع قبولاً أقل في المحادثات المفتوحة.
| التزامن | مسودة ثابتة (رمز/ث) | تكيفي (رمز/ث) | التغيير | طول القبول |
|---|---|---|---|---|
| 1 | 708 | 707 | −0.1% | 3.71 → 3.61 |
| 8 | 3,232 | 3,221 | −0.3% | 3.67 → 3.57 |
| 32 | 7,744 | 8,275 | +6.9% | 3.68 → 3.29 |
| 128 | 15,012 | 16,632 | +10.8% | 3.68 → 3.23 |
يثبت التحقق التكيفي جدواه تحت الحمل. عند تزامن 128 يرفع إنتاجية الإخراج بنسبة 10.8% ويخفض p99 TPOT بنسبة 9%، مع التحقق من رموز مسودة أقل في كل خطوة، مما يخفض طول القبول قليلاً لكنه يوفر حوسبة أكثر مما يخسره. عند التزامن المنخفض، حيث تكون رموز المسودة الإضافية شبه مجانية، يكون التأثير محايداً.
البداية
الأمر في أعلى هذا المنشور هو خيار افتراضي جيد: TP4 على عقدة GB300 واحدة، مع DFlash2 وذاكرة FP8 KV cache. لتمكين التحقق التكيفي، أضف "enable_adaptive_verification": true إلى --speculative-config. أما التحسينات الأخرى المذكورة أعلاه فهي مفعّلة افتراضياً.
- اختيار إعداد التوازي.
- لأقل زمن استجابة، استخدم TP4 أو TP8.
- للحصول على إنتاجية أعلى، استخدم الانتباه المتوازي بالبيانات مع توازي الخبراء، على سبيل المثال.
-dp 4 --enable-expert-parallel.
- الاستدلال واستدعاء الأدوات. يقوم
beamبقراءة قالب الاستجابة المرفق مع نقطة التفتيش. افتراضيًا، يقيد vLLM أيضًا كل استجابة وفقًا لذلك القالب، بحيث تُحلَّل استدعاءات الأدوات دائمًا وتتطابق مع مخطط JSON الخاص بكل أداة.response_formatوthinking_token_budgetيعملان كالمعتاد. لإيقاف القيد الافتراضي، اضبطVLLM_BEAM_ALWAYS_CONSTRAIN_OUTPUT=0.
دعم RL من اليوم 0 مع SkyRL
تعاونّا أيضًا مع فريق SkyRL لتمكين دعم RL من اليوم 0 على Beam. يُدعم LoRA والضبط الكامل بـ BF16 وRL بـ MXFP8 من الصندوق، مع حزمة RL مطورة لمقياس 500B.
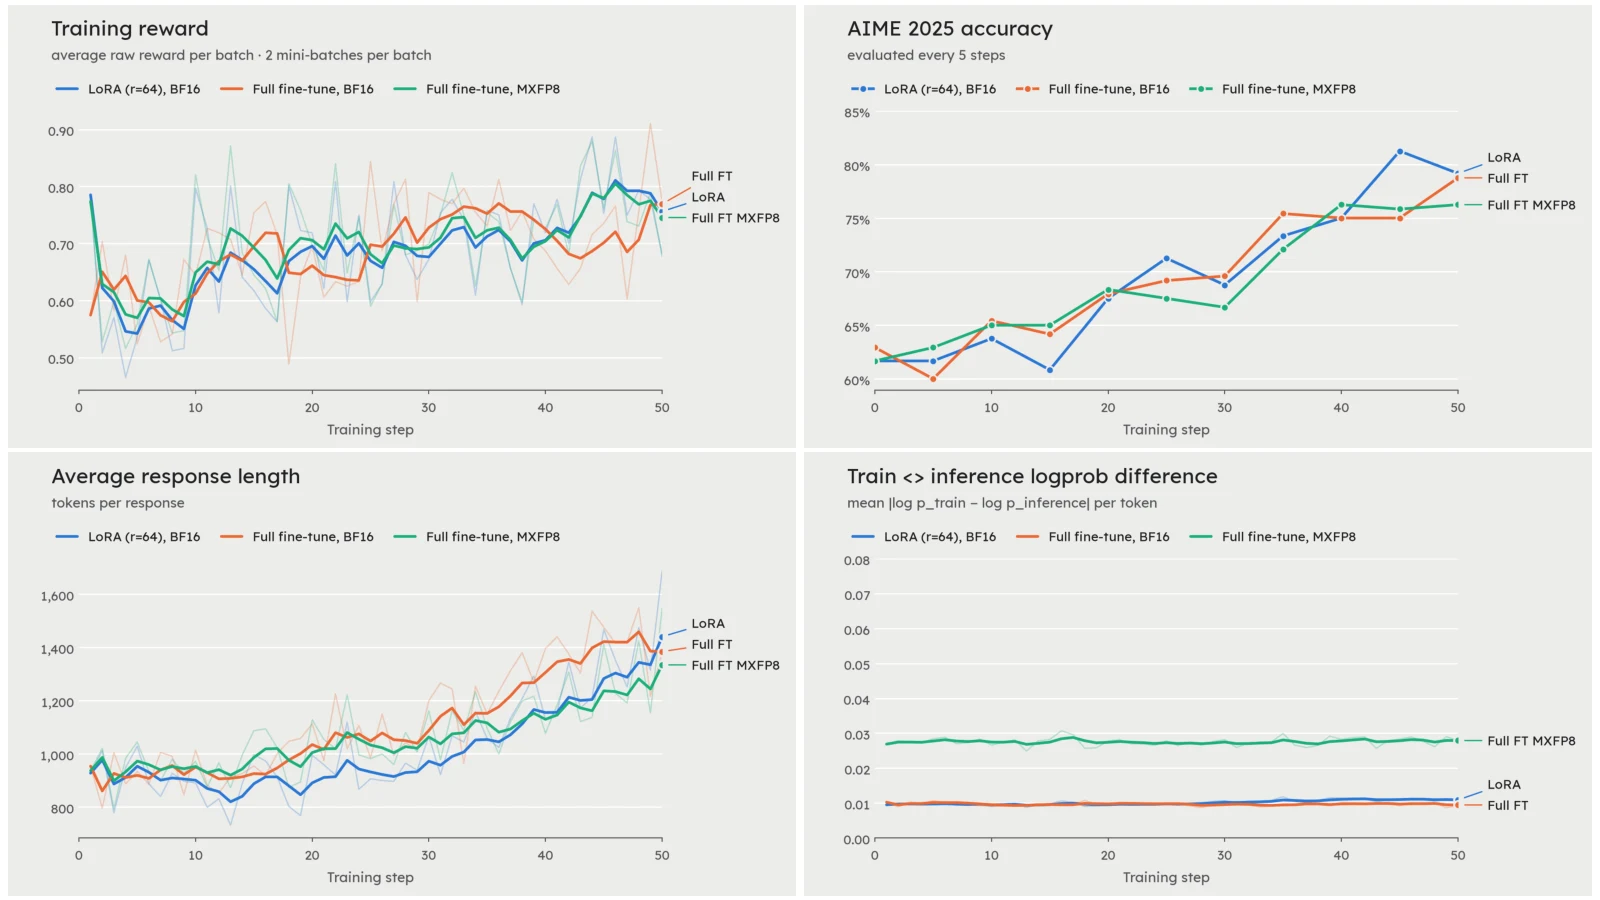
درّب فريق SkyRL نموذج Beam مسبقًا وفق وصفة DAPO باستخدام vLLM للاستدلال وMegatron للتدريب. حقق LoRA والضبط الكامل وRL بـ MXFP8 مكاسب مشابهة في الأداء خلال 50 خطوة تدريب، أي 100 تحديث للمحسِّن (الاستدلال minimal)، مع قفز في متوسط الدقة (avg@8) من حوالي 61% إلى حوالي 79% على AIME25. يبقى متوسط الفرق المطلق في log-probability بين Megatron وvLLM أقل من 0.01 مع تمكين Rollout Routing Replay (R3) لـ LoRA والضبط الكامل بـ BF16، وأقل من 0.03 لـ RL بـ MXFP8.
اطلع على مدونة فريق SkyRL لمزيد من التفاصيل!
شكر وتقدير
كان هذا العمل تعاونًا وثيقًا بين فرق Inferact وReflection وNvidia:
- Inferact: Woosuk Kwon وZiqi Zhao وAo Shen وTiezhen Wang
- Reflection: Kaixing Wu وYoni Gozlan وNeil Gollapudi وThibaut Barroyer وAymen Kallala وMatthias Reso وFlorent Gbelidji
- Nvidia: Siyuan Fu