
هل قرب قابلية تفسير الذكاء الاصطناعي للتحليل إلى اختراق؟ كتب مقالة جديدة جعل الباحثين متفرقين
 ماكسيميليان شريينر
عرض ملف لمسيميليان شريينر على لينكدإن
Oct 16, 2026
 نانو بانانا برو، الذي تم طلبه من THE DECODER
وفقًا لنيك كاماراتا، أحد الأشخاص الذين يقفون وراء فرضية التداخل، فإن الشبكات العصبية ليست معقدة كما افترض الباحثون. ويعتبر Roon التابع لشركة OpenAI هذا لحظة تاريخية. ويحذر الباحث في Google DeepMind نيل ناندا من التبجح المفرط به.
في طويل مقال عنوان المقال: “الشبكات العصبية نظيفة بالفعل”، يقول نيك كاماراتا إن الآليات الداخلية لأنظمة الذكاء الاصطناعي الكبيرة أسهل في الفهم من ما كان يُعتقد سابقًا. كاماراتا هو باحث في مختبر التفسيرية Goodfire. من خلال هذه المقالة، ينكر تفسيرًا شكله هو قبل سنوات.
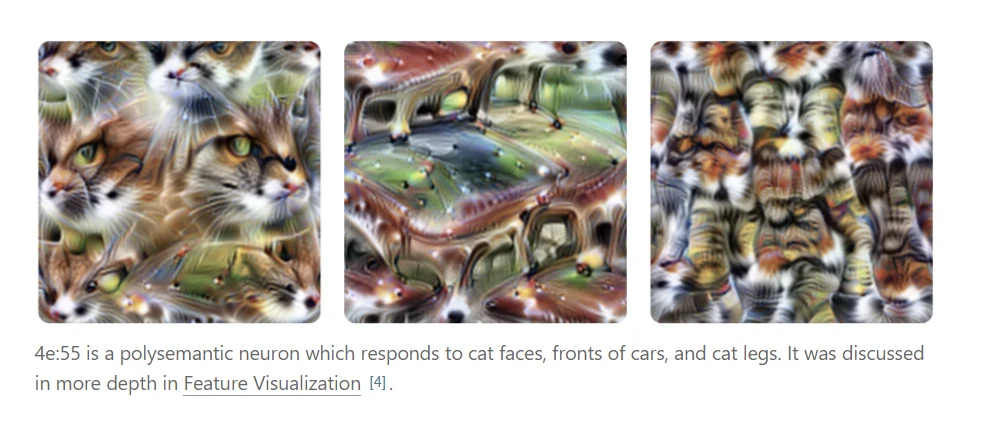
تسعى القابلية للفهم الميكانيكي إلى فعل أكثر من مجرد مراقبة ما ينتجه نموذج الذكاء الاصطناعي. وهدفها تتبع كيفية وصول النموذج إلى إجاباته من الداخل. في الصورة المثالية، يجب أن يمثل كل من ملايين الخلايا الاصطناعية مفهومًا قابلًا للتعرف. لكن في الواقع، يبدو أن العديد من الخلايا تُطلق إشاراتها حول أشياء غير مرتبطة ببعضها البعض، وهو ما يسميه الباحثون "التعددية الدلالية". ومن الأمثلة المشهورة في هذا الصدد خلية في نموذج الصورة InceptionV1 التي استجابت لوجوه القطط وكذلك لوجوه السيارات. استخدم كاماراتا ذلك كمثال في أبحاثه المبكرة.
التفسير القياسي كان عبارة عن التداخل. تقول النظرية إن عندما ينتهي شبكة الخلايا العصبية من الخلايا، فإنها تجمع المفاهيم غير المرتبطة معًا في نفس الخلايا العصبية، لأنها نادرًا تتعارض مع بعضها. والنتيجة تبدو كعقدة. لذلك، تقوم العديد من المختبرات بتدريب نموذج ثانوي، مثل محلل الذاكرة التلقائي النادر، لفصل هذه المفاهيم عن بعضها. ثم يدرسون ذلك النموذج بدلاً من النموذج الأصلي.
لعب كاماراتا دورًا رئيسيًا في تشكيل هذا الرأي. مع كريس أولاه، كتبا معًا الورقة البحثية "Zoom In"، والتي قدمت الدائرة الكهرومغناطيسية الأولى للتداخل. في عام 2023، بدأ مشروعًا لتفسير الآليات بشكل آلي في OpenAI. في ذلك الوقت، كان حوالي 1.7 بالمئة من الخلايا العصبية فقط قابلة للفهم، حتى بالمعيار الأكبر من الإنصاف.
قد يكون الدليل قد تم فهمه خطأ
يعتقد كاماراتا الآن أن الأمثلة الأكثر شهرة قد تم فهمها بشكل خاطئ. ويقول إن الخلية العصبية للقطة والسيارة هي في الحقيقة جهاز للكشف عن الأشكال على شكل V. الأشكال المدببة مثل منقار الثعلب أو اللهب تُفعّلها، بينما الأشكال الدائرية مثل حرف O تُبطل فعاليتها. لذلك، لا تمثل هذه الخلية مفهومين غير مرتبطين تمامًا مثل وجوه القطط والسيارات، وهذا يعني أنها ليست مثالًا على التداخل.
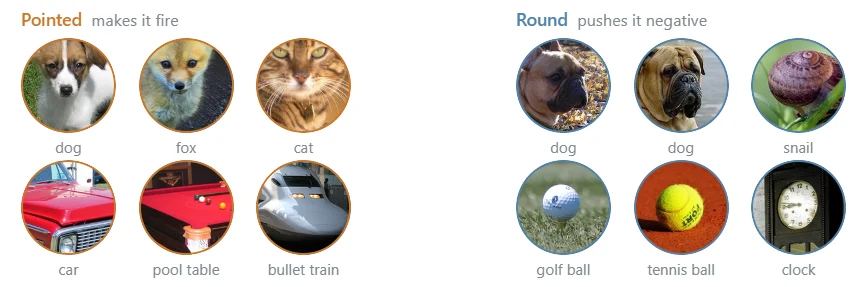
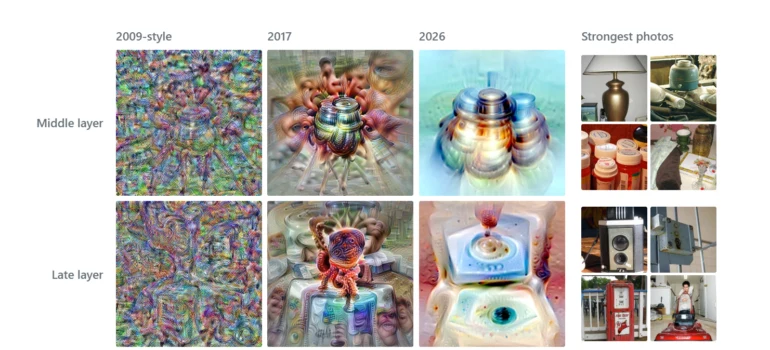
كما يعيد تفسير دائرة التداخل من فيلم “Zoom In”، حيث يبدو أن السيارات تختبئ بين خلايا الكلاب. في رأيه، هذا مجرد تعميم عادي، والدائرة تجمع ببساطة السيارات والكلاب حسب الاتجاه الذي تواجههما الكاميرا. يلوم تصميم الطبقات المتأخرة في InceptionV1 على الهيكل القديم والأدوات التحليلية الضعيفة.
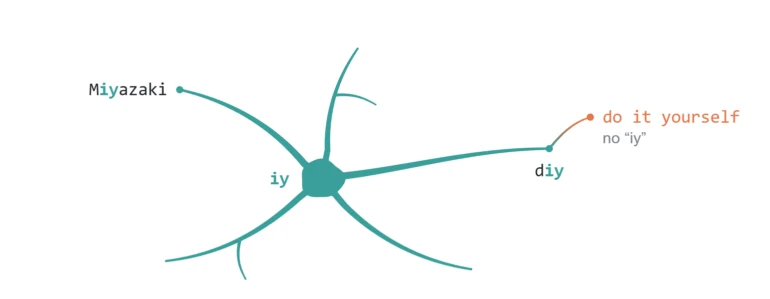
يشرح كاماراتا الغموض المتبقي باستخدام نمط يسميه “التعميم التكراري”. يقول إن الخلايا العصبية تنمو مثل فروع تنمو من جانبها. خلية عصبية واحدة التي تعرف تسلسل الحروف “iy”، تستجيب لاحقًا لـ “diy”، ثم في النهاية لـ “افعلها بنفسك”, والتي لا تحتوي على “iy” على الإطلاق. على عكس التداخل، يمكن لهذه التجميعات أن تعلمك شيئًا عن الشبكة.
بالنسبة للنماذج اللغوية، يقدم أرقام أولية. في Qwen3-32B، حوالي 90 بالمائة من قطبيات الخلايا العصبية لديها مهمة رئيسية واحدة، بينما لدى حوالي 7 بالمائة مهمتان مرتبطتان. يبقى نسبة 2 إلى 4 بالمائة غير مفسرة. تقول Goodfire إنها ترى نتائج مماثلة في النماذج التي تحتوي على تريليونات من المعلمات. العملاء الذكيون الذي يحلل الخلايا العصبية بشكل جماعي قاموا بأغلب العمل. يستعين كاماراتا بـ "الدرس المرير" الذي كتبه ريتش ساتون، ويخلص إلى أنه فيما يتعلق بالقابلية للتفسير، فإن التحقيق البسيط على نطاق واسع أفضل من طرق التفكيك الذكية.
لا يقدم كاماراتا طريقة جديدة من الأساس. فهو يعود إلى النهج الأصلي للمجال، وهو دراسة الخلايا العصبية مباشرة، مع استخدام أدوات أفضل ونماذج أكبر وعناصر آلية.
الشبكات القابلة للقراءة ستكون نجاحًا كبيرًا لسلامة الذكاء الاصطناعي
إذا كان كاماراتا على حق، فهذا سيكون خبرًا جيدًا، خاصة بالنسبة لسلامة الذكاء الاصطناعي. حاليًا، باستثناء المراقبة سلاسل التفكير التي تزداد عدم الموثوقيةهناك طرق قليلة لتحديد ما إذا كان النموذج يخدع الناس أو يتصرف بطريقة خطيرة. يعتقد كاماراتا أن التوجيه، وهو عمل توجيه الذكاء الاصطناعي نحو أهداف البشر، لا يمكن حله دون القدرة على التفسير، لأنه بدون ذلك لا نعرف ما نبنيه. يقول إن الخداع لا يحتاج إلى الاختباء داخل دوائر النموذج نفسه. إذا أصبح البشر مجرد “قارئ” آخر للشبكة، فإنهم يمكنهم أيضًا رؤية الخداع، ويمكن تصحيح الأخطاء بطريقة مستهدفة.
رون، موظف في OpenAI يكتب تحت هذا الاسم المستعار على X وهو صوت مؤثر في دوائر الذكاء الاصطناعي، كان سعيدًا للغاية. يقول إنه صديق مقرب من كاماراتا، ولن يكون قد انضم إلى OpenAI بدونه. قد يُذكر هذا العمل “كلاسيكي في تاريخ العلم”. كتب رونأضاف أن الأخبار جيدة للغاية، حتى أن إليزر يودكوفسكي، أحد أكثر الأصوات شهرة تحذر من كارثة الذكاء الاصطناعي، سيضطر إلى خفض تقديراته لاحتمالات الكارثة. في رأي رون، قد تصبح التوافق بين الأفراد علمًا "طبيعيًا".
حتى رون لديه بعض التحفظات. ولا يزال الآخرون في المجال بحاجة إلى تأكيد النتائج، كما يعتقد أن الاختراقات في قابلية التفسير ستدفع قدرات الذكاء الاصطناعي إلى الأمام. حقيقة أن هذه النتائج تأتي من خارج الشركة لا تبشر بالخير للمختبرات الكبيرة، بما في ذلك OpenAI.
رأى ناندا أداة مفيدة، وليس اختراقًا جديدًا
نيل ناندا أكثر حذرًا. يُعتبر أحد الشخصيات المؤسسة لفكرة القابلية للتفسير الميكانيكي، ويدير فريق القابلية للتفسير في جوجل ديب مايند. قبل ذلك، عمل في شركة أنثروبيك كباحث مستقل. وفقًا له، تغيرت آراؤه: منذ منتصف عام 2024، أصبح أكثر تشاؤمًا بشأن فكرة التفسير المفترض، وسلك نهجًا عمليًا. قام فريقه بتخفيض الأولوية للأبحاث المتعلقة ببرامرات التشفير الذاتي النادر. لم يعتقدوا أن التقنية عديمة الفائدة، لكن لم يبدُ أن الجهد المبذول فيها يستحق العناء.
عمل كاماراتا مثير للاهتمام لكنه لا يغير الصورة الكبيرة حقًا، ناندا يكتب. التحليل القائم على الخلايا العصبية يمكن أن يساعد في الإجابة على أسئلة عملية، مثل سبب قيام النموذج بأفعال مشكوك فيها، كما أن تطبيقه أصعب على النماذج الحديثة. لكنه لا يؤمن بالفكرة القائلة بأن القابلية للتفسير قد تم كشفها بالكامل. يتوقع أن يكون للتحليل القائم على الخلايا العصبية عيوب خطيرة ويفوت الكثير أيضًا.
يعتقد ناندا أن التكبير موجود فعلاً. يقول إن نماذج اللغة تخزن الكثير من الحقائق مقارنة بالخلايا العصبية التي لديها، ومن المحتمل أن التفعيلات الضعيفة تحتفظ بمعظم تلك المعلومات. يشك في أن النتائج المستخلصة من نماذج الصور الصغيرة يمكن أن تنطبق على الأمور الأخرى. كما يعتقد أن المقال يحدد مفهوم التوحيد اللغوي بشكل مفرط، لكنه يقدّر كاماراتا لأنه تحقق من أعماله القديمة باستخدام أدوات حديثة.
جزء من الخلاف يرجع إلى التعريفات: لا يواجه كاماراتا أي مشكلة في النماذج التي تمثل مفاهيم أكثر من أبعادها، ويرى ناندا أنه يتفق مع هذا الرأي. ما يختلف عليه كاماراتا هو أن الشبكات تجمع أشياء غير مرتبطة ببعض بشكل تعسفي.
لم يتم نشر الورقة العلمية المرافقة التقنية بعد. وكشركة متخصصة في التفسير، لدى Goodfire أيضًا مصلحة واضحة في هذه الأطروحة. إذا كانت قراءة كاماراتا صحيحة، فهو يعتقد أن الباحثين الآليين يمكنهم إنجاز ما استغرقه البشر حوالي عقد من الزمن في نماذج الصور خلال أشهر. ويكتب أنه قد لا يتبقى الكثير من الوقت لذلك.
أخبار الذكاء الاصطناعي بدون الضجيج – من تجميع البشر
اشترك في THE DECODER للقراءة بدون إعلانات، برنامج نشر إخباري أسبوعي عن الذكاء الاصطناعي، تقرير حديث حصري "AI Radar" ست مرات في السنة، الوصول الكامل إلى الأرشيف، والوصول إلى قسم التعليقات.
اقرأ للحصول على الصورة الكاملة.
اشترك لتتابع التغطية الخالية من الإثارة.
- الوصول الكامل لكل المقالات على THE DECODER
- بدون إعلانات
- انضم إلى التعليقات والمناقشات المجتمعية
- تلخيص أخبار الذكاء الاصطناعي الأسبوعي عبر البريد
- 6 مرات في السنة: “رادار الذكاء الاصطناعي” — تجارب عميقة في المواضيع المتعلقة بالذكاء الاصطناعي التي تهمنا أكثر
- أخبار الذكاء الاصطناعي اليوم، دائمًا محدثة
- أرشيفنا الكامل لمدة عشر سنوات
- محاط بفريق يعمل في مجال الذكاء الاصطناعي لأكثر من 10 سنوات