
Reflection AI أطلقت Beam، وهو نموذج بأوزان مفتوحة للبرمجة الوكيلة والمهام طويلة المدى مثل صيانة الشيفرة البرمجية، واستخدام الأدوات، وتفسير النتائج، وإنجاز سير العمل متعدد الخطوات. يمنح إطلاق الأوزان المفتوحة المطورين والباحثين تحكماً في بيئة التشغيل، وبيئة النشر، وعملية التخصيص.
في هذه المقالة، نشرح رؤية Reflection ونوضح كيف يمكنك نشر Beam على AWS. ابدأ بنقطة نهاية في الوقت الفعلي من Amazon SageMaker JumpStart للحصول على مسار مُدار بالكامل. وعندما تحتاج إلى تحكم أصلي من Kubernetes في البنية التحتية الموزعة لوحدات معالجة الرسومات، استخدم Amazon SageMaker HyperPod Inference مع JumpStart أو SGLang أو vLLM. نشرح أيضاً كيف تؤثر 501 مليار معلمة إجمالية في Beam على تخزين نقاط التحقق وذاكرة الأوزان والتقسيم والتوازي، بينما تؤثر 23 مليار معلمة نشطة في الحساب لكل رمز.
عند الإطلاق، يتوفر Beam في Amazon SageMaker JumpStart في US East (N. Virginia) وUS East (Ohio).
رؤية Reflection للذكاء المفتوح
مهمة Reflection هي جعل الذكاء مفتوحاً ومتاحاً للجميع من خلال أوزان النماذج المفتوحة، والأبحاث المنشورة، والبرمجيات مفتوحة المصدر. وتشمل منظومة الذكاء الاصطناعي الكاملة النماذج والبرمجيات الأساسية والبنية التحتية الإنتاجية والتطبيقات. ويُقدّم Beam هذا النهج للمطورين الذين يبنون أنظمة هندسة البرمجيات والأنظمة الوكيلة.
نبذة عن Reflection Beam
Beam هو نموذج مختلط نادر الخبراء (sparse mixture-of-experts) لحل مشكلات البرمجيات، وتعديل الشيفرة البرمجية، واستدعاء الأدوات، والتصرف بناءً على النتائج الوسيطة. يحتوي على 501 مليار معلمة إجمالية و23 مليار معلمة نشطة، وتشير Reflection إلى طول سياق فعلي يبلغ 1 مليون رمز.
تُصدر Reflection أوزان Beam عبر Hugging Face بموجب ترخيص Apache 2.0. يتوفر Beam 1.0 بصيغ نقاط تحقق BF16 وFP8 وNVFP4. توفر هذه الصيغ أحجام ذاكرة مختلفة وتوافقاً مختلفاً مع العتاد. يمكنك نشر النموذج باستخدام إعدادات الحاوية المُدارة من AWS عبر JumpStart، أو فحص النموذج وتخصيصه باستخدام SGLang أو vLLM في بيئة AWS الخاصة بك.
فهم معمارية النشر
اختر مسار التقديم الذي يلبي متطلباتك في التحكم والتوسع.
- ابدأ بـ نقطة نهاية في الوقت الفعلي من SageMaker JumpStart عندما ترغب في حزمة نموذج ونقطة نهاية وواجهة برمجة استدعاء مُدارة من AWS دون تشغيل Kubernetes.
- استخدم JumpStart على HyperPod Inference عندما ترغب في الحاوية وإعدادات النموذج المُدارة من AWS على عنقود HyperPod منسّق بواسطة Amazon Elastic Kubernetes Service (Amazon EKS).
- استخدم SGLang أو vLLM على HyperPod Inference عندما تحتاج إلى التحكم في صورة التقديم، أو وسائط التشغيل، أو التكميم، أو التنفيذ الموزع.
- احسب حجم النشر بما يتناسب مع تخزين نقاط التحقق، وذاكرة الأوزان، وذاكرة KV المؤقتة، وطول السياق، والتجميع (batching)، والحمل التشغيلي الإضافي، والتوازي المدعوم.
- حدد أهداف التزامن وزمن الاستجابة المتوقعة، ثم قم بإعداد النسخ المتماثلة والتخزين المؤقت والتوجيه والتوسع التلقائي بناءً على السلوك المقاس لحِمل العمل.
يغلّف مسار JumpStart في الوقت الفعلي النموذج والحاوية ونقطة النهاية خلف سير عمل نشر مُدار. أما مسار HyperPod فيكشف العنقود وبيئة التقديم حتى تتمكن من التحكم في التنفيذ الموزع والتخزين المؤقت والتوجيه والتوسع.
يوضح المخطط التالي المكونات المستخدمة في مسار HyperPod. يمكن الحصول على Beam من خلال SageMaker JumpStart أو Hugging Face Hub أو نسخة احتياطية اختيارية من Amazon Simple Storage Service (Amazon S3). يستخدم العمال الموزعون حاوية JumpStart المُدارة من AWS أو بيئة تشغيل مخصصة من SGLang أو vLLM.
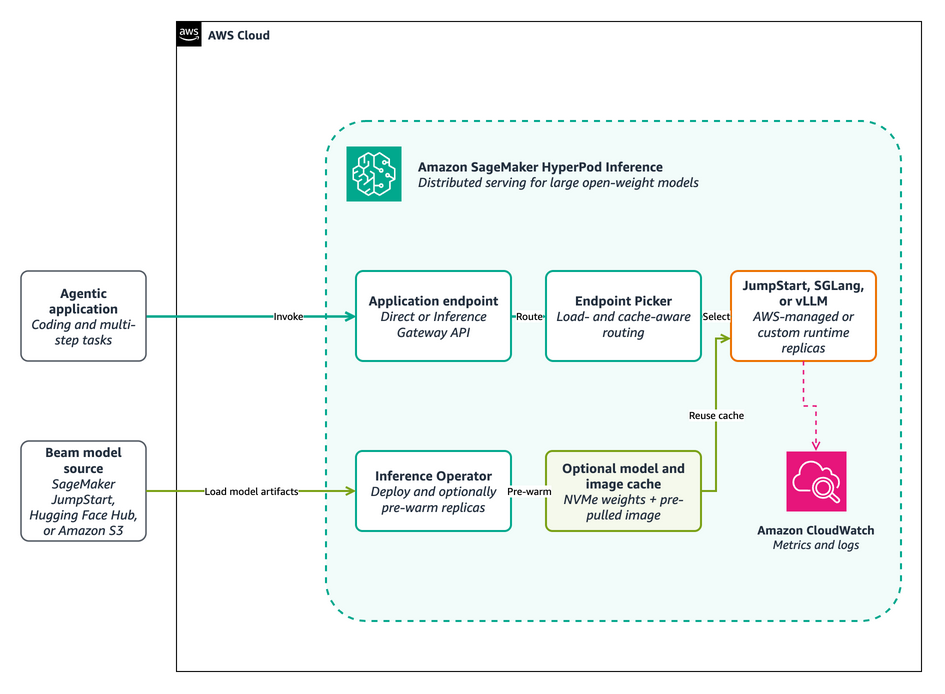
الشكل 1: نشر Beam الموزع مع Amazon SageMaker HyperPod Inference
المتطلبات الأساسية
تحتاج إلى:
- حساب AWS لديه الأذونات لمسار نشر SageMaker المحدد وموارده الداعمة من AWS Identity and Access Management (IAM) والشبكات والتخزين.
- الوصول إلى Beam من خلال SageMaker JumpStart أو أحد مستودعات نقاط فحص Beam 1.0 على Hugging Face.
- قبول شروط النموذج، وواجهة سطر أوامر AWS (AWS CLI)، وPython 3.11 أو أحدث.
- حصة وسعة GPU لتكوين Beam مدعوم.
خطط واحصل على سعة GPU
تتطلب معاملات Beam البالغة 501 مليار معامل نشراً متعدد وحدات GPU. يحقق BF16 أكبر متطلبات ذاكرة للأوزان، لذا خطط لتكوين متعدد العقد بذاكرة GPU إجمالية كافية للأوزان وعبء التشغيل. بالنسبة لـ FP8، استخدم ml.p5.48xlarge مع وحدات NVIDIA H100 GPU أو ml.p5e.48xlarge و ml.p5en.48xlarge مع وحدات H200 GPU. بالنسبة لـ NVFP4، استخدم ml.p6-b200.48xlarge مع وحدات NVIDIA B200 GPU. تأكد من أن نقطة الفحص الصادرة وبيئة التشغيل والتخطيط المتوازي تدعم نوع المثيل المحدد.
- احسب الذاكرة للأوزان وذاكرة KV cache وعبء التشغيل لنسخة متماثلة واحدة، ثم أكّد التقدير باختبار تحميل.
- اختر منطقة AWS تدعم المثيل المُسرَّع المطلوب.
- تحقق من حصة الخدمة والسعة المتاحة لنوع المثيل المحدد. استخدم السعة حسب الطلب عند توفرها، أو استخدم خطة تدريب SageMaker كحجز قصير الأجل للعمل المجدول.
- اسمح بوقت كافٍ لنقل الصورة وتنزيل الأوزان وتحميل الأجزاء (shards) وتهيئة بيئة التشغيل.
المسار 1: ابدأ باستخدام نقطة نهاية SageMaker JumpStart في الوقت الفعلي
استخدم أولاً نقطة نهاية في الوقت الفعلي من JumpStart عندما تريد أقصر مسار من كتالوج النماذج إلى نقطة نهاية HTTPS مُدارة. يدعم النموذج التوضيحي معرّفات النماذج BF16 وFP8 وNVFP4 من خلال أمر واحد متوافق مع المتغيرات. ملف README وملف Python هما المرجع الأساسي لأنواع المثيلات المدعومة ومخطط الطلب وأمر النشر وأمر التنظيف.
- استنسخ المستودع النموذجي.
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git - ادخل إلى مجلد عيّنة نشر SageMaker JumpStart.
cd sagemaker-genai-hosting-examples/01-models/ReflectionAI/Beam-1.0-501B-A23B-NVFP4/ - أنشئ بيئة افتراضية لبايثون وقم بتنشيطها.
python3 -m venv .venv source .venv/bin/activate - تثبيت تبعية العينة.
python -m pip install -r requirements.txt - قم بتشغيل دورة حياة النشر والاستدعاء والتنظيف المحدودة لـ FP8.
python jumpstart_real_time.py \
--variant fp8 \
--endpoint-name reflection-beam-fp8-smoke
يقوم الأمر بنشر نقطة النهاية FP8، وإرسال طلب قصير، وطباعة الاستجابة، ثم تنظيف نقطة النهاية. استخدم
bf16أوnvfp4لتحديد نسخة نقطة فحص أخرى؛ NVFP4 هي الخيار الافتراضي عند الإغفال--variant. استخدم دوال بايثون (Python) الموجودة في ملف README عندما تحتاج إلى إبقاء نقطة النهاية (endpoint) تعمل.
المسار 2: النشر باستخدام SageMaker HyperPod Inference
استخدم HyperPod Inference عندما تحتاج إلى تحكم أصلي في Kubernetes فوق البنية التحتية الموزعة لوحدات معالجة الرسومات GPU. يمكنك استخدام إعداد الحاويات المُدار من AWS عبر JumpStart أو نشر Beam باستخدام SGLang أو vLLM. نموذج README لنشر HyperPod Inference وملفات التكوين الخاصة به هي المصدر المرجعي للبيانات الصادرة (manifests) ومعرّفات النموذج والصورة وإصدارات بيئة التشغيل المدعومة والأوامر.
قبل أن تبدأ، قم بتكوين kubectl الوصول إلى عنقود HyperPod منسَّق عبر EKS مع HyperPod Inference Operator والوظائف الإضافية المطلوبة. تحتاج أيضًا إلى السحابة الخاصة الافتراضية (VPC) للعنقود والشبكات الفرعية ومجموعات الأمان، والوصول إلى كائنات Beam ووقت التشغيل المحددة، وسعة NVMe المحلية إذا قمت بتمكين تخزين النماذج مؤقتًا. استخدم رمز وصول معزول من Hugging Face إذا كان المستودع المحدد يتطلب المصادقة.
انشر نسخة مثبّتة من Beam من Hugging Face Hub للتطوير والتجريب. ولأغراض النشر الإنتاجي والتخزين المؤقت للنماذج، انسخ نقطة الحفظ (checkpoint) إلى Amazon S3 أو Amazon FSx. تخزين مؤقت للنماذج والصور في HyperPod يمكنه تحميل الأوزان مسبقًا على تخزين NVMe المحلي للعقدة وسحب صورة الخدمة مسبقًا.
يوفر بوابة HyperPod Inference Gateway واجهة متوافقة مع OpenAI ويوجه الطلبات عبر النسخ المتماثلة. كما يدعم HyperPod Inference أيضًا التخزين المؤقت المتدرج المُدار لـ KV والتوجيه الذكي. وهذه من بين قدرات Amazon SageMaker Inference المقدمة في 2026.
يوسع المخطط التالي تدفق تحضير النموذج وتدفق طلبات وقت التشغيل. عند تمكين التخزين المؤقت للنموذج، يقوم Inference Operator بتسخين العقد المؤهلة بالأوزان وصورة الخدمة المحددة. في وقت التشغيل، يمكن لبوابة Inference Gateway ومنتقي النقاط (Endpoint Picker) توجيه كل طلب إلى نسخة متماثلة مناسبة مُدارة بواسطة JumpStart أو SGLang أو vLLM.
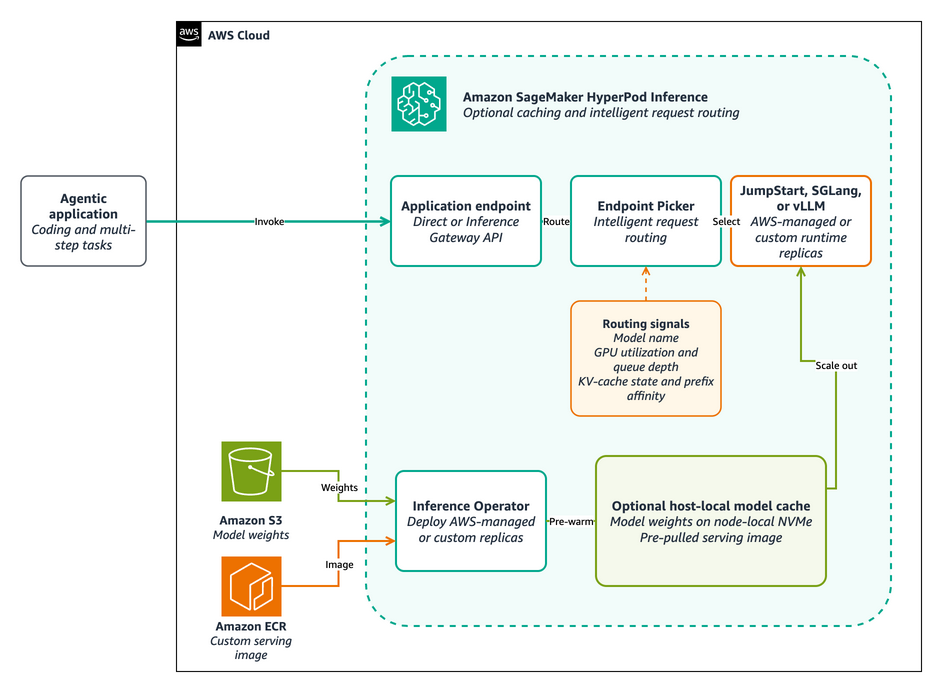
الشكل 2: التخزين المؤقت للنماذج وتوجيه الطلبات في HyperPod
تحضير عناصر النشر
استخدم مدخلات غير قابلة للتغيير حتى تتمكن من إعادة إنتاج نتائج النشر والأداء.
- استخدم إصدار نموذج JumpStart المسجل في عينة النشر.
- اختر نسخة الأوزان (checkpoint) بصيغة BF16 أو FP8 أو NVFP4 لبيئة تشغيل مخصصة.
- بالنسبة لبيئة تشغيل مخصصة، احتفظ بمعرّف الالتزام (commit SHA) العام لـ Beam وبصورة الصورة (image digest) في إعداد الإصدار النموذجي.
- اعكس الصورة المنشورة (Mirror) إلى مستودع خاص في Amazon Elastic Container Registry (Amazon ECR) فقط عندما لا يستطيع عنقودك سحب الصورة الأصلية أو عندما تتطلب مؤسستك سجلًا معتمدًا.
- احتفظ بالرموز (tokens) والأسرار المُنشأة ومعرّفات النماذج الخاصة وبيانات اعتماد السجلات والنتائج غير المنشورة خارج المستودع.
اختر مسار التقديم للخدمة
ابدأ بـ SageMaker JumpStart ما لم تتطلب حِمل العمل بيئة استدلال أو إعدادًا محددًا.
| مسار التقديم للخدمة | استخدمه عندما | ما تديره |
| SageMaker JumpStart | تريد حاوية وإعداد نموذج تديره AWS مع صيانة أقل لبيئة التشغيل. | حدد إصدار نموذج Beam، ونوع المثيل المدعوم، وإعداد نقطة النهاية، وسياسة التوسع. |
| SGLang أو vLLM | تحتاج إلى بيئة تشغيل استدلال أو تكوين محددين، مثل وسائط تشغيل مخصصة أو محللات أو تكميم أو توازٍ. | ثبّت صورة بيئة التشغيل المدعومة ومراجعة النموذج وتكوين المحلل وإعدادات التنفيذ الموزع بتحديد إصدار. |
النشر باستخدام SageMaker JumpStart
يقلّل SageMaker JumpStart من عمل تكامل الحاويات بينما يحتفظ HyperPod بالتحكم في سعة المجموعة والتوسيع وقابلية المراقبة.
- في SageMaker Studio، افتح كتالوج نماذج JumpStart.
- ضمن All public models، اختر Beam.
- اختر SageMaker HyperPod كنشر الوجهة.
- حدّد المجموعة واسم نطاق Kubernetes.
- أدخل اسم نقطة النهاية، واختر Deploy.
- أكّد حالة النشر قبل استدعاء نقطة النهاية باستخدام مخطط طلب JumpStart المُصدَر.
بالنسبة لسير عمل البنية التحتية كتعليمات برمجية، استخدم تكوين JumpStart المُصدَر في نموذج HyperPod. يمكنك الاطلاع على قالب بيان reflection-beam-jumpstart.yaml قبل تكوين النشر.
- استنسخ مستودع النموذج، وادخل إلى دليل HyperPod Beam.
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git cd sagemaker-genai-hosting-examples/SageMakerHyperpod/reflection-beam/ - أنشئ ملفات التكوين المحلية الموضحة في ملف README.
cp config/deployment.env.example config/deployment.env cp config/release.env.example config/release.env - تحقق من صحة تكوين JumpStart قبل تعديل المجموعة.
python hyperpod_tool.py \ --config config/deployment.env \ --config config/release.env \ validate jumpstart - انشر تكوين JumpStart.
python hyperpod_tool.py \
  --config config/deployment.env \
  --config config/release.env \
  deploy jumpstart \
  --timeout-seconds 1800
تقوم الأداة المساعدة بعرض وتطبيق JumpStartModel المُصدَر دون كتابة قيم الإصدار المعبّأة على القرص.
النشر باستخدام SGLang أو vLLM
اختر SGLang أو vLLM عندما تحتاج إلى تحكم مباشر في بيئة تشغيل الخدمة. قبل تكوين النشر، افحص قالب بيان reflection-beam-sglang.yaml أو قالب بيان reflection-beam-vllm.yaml. يظل ملف README الخاص بالنموذج هو المرجع الأساسي لقيم وأوامر الإصدار.
- استنسخ مستودع العينة.
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git - ادخل إلى دليل HyperPod Beam.
cd sagemaker-genai-hosting-examples/SageMakerHyperpod/reflection-beam/ - أنشئ ملفات التكوين المحلية الموضحة في ملف README.
cp config/deployment.env.example config/deployment.env cp config/release.env.example config/release.env - تحقق من صحة التكوين المحدد قبل تغيير المجموعة.
python hyperpod_tool.py \ --config config/deployment.env \ --config config/release.env \ validate sglang - انشر Beam، وانتظر حالة نشر نهائية (terminal).
python hyperpod_tool.py \
  --config config/deployment.env \
  --config config/release.env \
  deploy sglang \
  --timeout-seconds 1800
استبدل
sglangبـvllmلاستخدام vLLM. تقوم الأداة المساعدة بالتحقق من صحة الإعدادات المحددة، وتطبّق ملف manifest المُصيَّر دون كتابة قيم الإصدار على القرص، وتنتظر بمهلة زمنية ثابتة، وتطبع تشخيصات إذا فشل النشر.
استدعِ Beam
استدعِ نقاط نهاية JumpStart بمخطط طلب النموذج المُصدَر. بالنسبة إلى SGLang أو vLLM، استخدم اختبار الدخان (smoke test) المحدود المضمَّن في عينة HyperPod.
استدعِ نقطة النهاية المنشورة
- ثبّت اعتماديات عميل العينة.
python3 -m venv .venv source .venv/bin/activate python -m pip install -r requirements.txt - شغّل فحص صحة خاصًا وطلبًا قصيرًا باستخدام إعدادات أخذ العينات الابتدائية الموصى بها.
python hyperpod_tool.py \
--config config/deployment.env \
smoke sglang \
--prompt "List three checks for a healthy model deployment." \
--temperature 1.0 \
--top-p 0.7
استبدل
sglangبـvllmلنشر vLLM. تختار الأداة المساعدة عاملًا جاهزًا، وتفتح port-forward مؤقتًا، وتتحقق من صحة نقطة النهاية، وترسل الطلب، ثم تغلق port-forward.
يبدو الرد كالتالي:
1. Confirm that the endpoint reports ready.
2. Send a short inference request.
3. Review the service logs for startup errors.
بالنسبة إلى بوابة الاستدلال (Inference Gateway) المصرَّح بها، استخدم إجراء رمز الحامل (bearer-token) في ملف README لعينة HyperPod. حافظ على بيانات الاعتماد بعيدًا عن التعليمات البرمجية المصدرية وملفات manifest وسجل الأوامر.
قياس الأداء وضبطه
- اختبر كل مسار من مسارات التقديم باستخدام طلبات برمجة واستخدام أدوات متكررة ومعبرة عند التزامن المتوقع.
- سجّل إصدار نموذج Beam، وبصورة الصورة (image digest)، ونوع المثيل، والدقة، وطول السياق، ومستوى التوازي، ووسائط التقديم، وحالة ذاكرة التخزين المؤقت، وعدد تكرارات الاختبار.
- قِس معدل نجاح الطلبات، والزمن عند المئين p50 وp95 لأول رمز (token)، والزمن لكل رمز مخرج، وزمن الاستجابة من البداية إلى النهاية، وإجمالي رموز المخرجات في الثانية.
- اضبط حجم الدُفعة، وتخصيص ذاكرة KV cache، وعدد النسخ المتماثلة، والتوسع التلقائي، والتخزين المؤقت للنموذج والصورة بناءً على تلك النتائج.
- أعد التحقق من جودة المخرجات بعد تغيير الدقة أو التكميم (quantization).
التنظيف
احذف الموارد عند انتهائك من الاختبار لتجنب الرسوم المستمرة.
- بالنسبة لنقطة نهاية SageMaker JumpStart للوقت الفعلي، اتبع تعليمات التنظيف في ملف README الخاص بنموذج نشر SageMaker JumpStart.
- بالنسبة إلى JumpStart أو SGLang أو vLLM على Amazon SageMaker HyperPod Inference، اتبع تعليمات التنظيف في ملف README الخاص بنموذج نشر HyperPod Inference.
- احذف عنقود HyperPod أو Amazon EKS المخصص الذي تم إنشاؤه للتجربة التوضيحية.
- احذف الأوزان المخزنة مؤقتًا غير المستخدمة، وال artifacts المعكوسة، وموازنات الأحمال، ومجموعات السجلات، وأدوار IAM المؤقتة، وبيانات الاستدلال الملتقطة.
الخلاصة
يمنح Reflection Beam المطورين نموذجًا مفتوح الأوزان مصممًا للبرمجة الوكيلية (agentic coding) والمهام متعددة الخطوات. ابدأ بنقطة نهاية SageMaker JumpStart للوقت الفعلي للحصول على نشر مُدار بالكامل. استخدم SageMaker HyperPod Inference مع JumpStart عندما تحتاج إلى تحكم أصيل في البنية التحتية لـ Kubernetes دون إدارة حاوية التقديم، أو اختر SGLang أو vLLM عندما تحتاج إلى بيئة تشغيل مخصصة.
استخدم نموذج نشر SageMaker JumpStart أو نموذج نشر HyperPod Inferenceثم اتبع التعليمات.
لمعرفة المزيد عن Reflection AI ورؤيتها للذكاء المفتوح، تفضل بزيارة Reflection AI واقرأ Introducing Beam.
الموارد
- نُسَخ نقاط فحص Reflection Beam: BF16, FP8و NVFP4
- نموذج نشر SageMaker JumpStart
- نماذج نشر HyperPod Inference مع JumpStart وvLLM وSGLang
- نشر النماذج الأساسية من SageMaker JumpStart إلى HyperPod Inference
- مراجعة إطلاقات Amazon SageMaker Inference منذ بداية عام 2026