
01 تصدّر القائمة الكاملة في ثلاثة معايير قياسية، وحصول Thinker-WM على ثلاث مراكز أولى
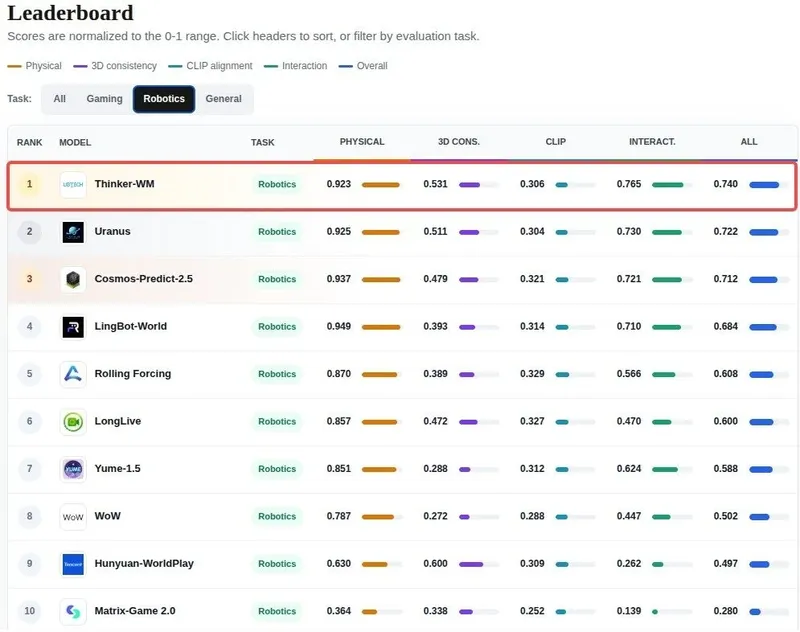
في الأيام الأخيرة، حقق Thinker-WM من UBTech المركز الأول في جميع التقييمات الثلاثة المعترف بها كمعايير قياسية لنماذج العالم المجسّدة، محققاً نتائج غير مسبوقة في القطاع:
WorldOlympiad:
حقق Thinker‑WM درجة إجمالية قدرها 0.740 ليحتل الصدارة. يعتمد هذا المعيار القياسي على كمية كبيرة من بيانات التفاعل الحقيقية للروبوتات، ويغطي أكثر من 10 أنواع من أجسام الروبوتات المختلفة وعدة إعدادات للكاميرات، مع تركيز على تقييم قدرة النموذج على التعميم عبر أشكال الروبوتات المختلفة والزوايا البصرية المختلفة. حقق النموذج اتساق 3D قدره 0.531 ودقة تفاعل قدرها 0.765، وحصل بهذين المؤشرين الفرعيين على المركز الأول بين جميع النماذج المشاركة، مما يعكس قدرة النموذج على النمذجة الدقيقة للبنية الهندسية 3D وعملية تفاعل الروبوت.
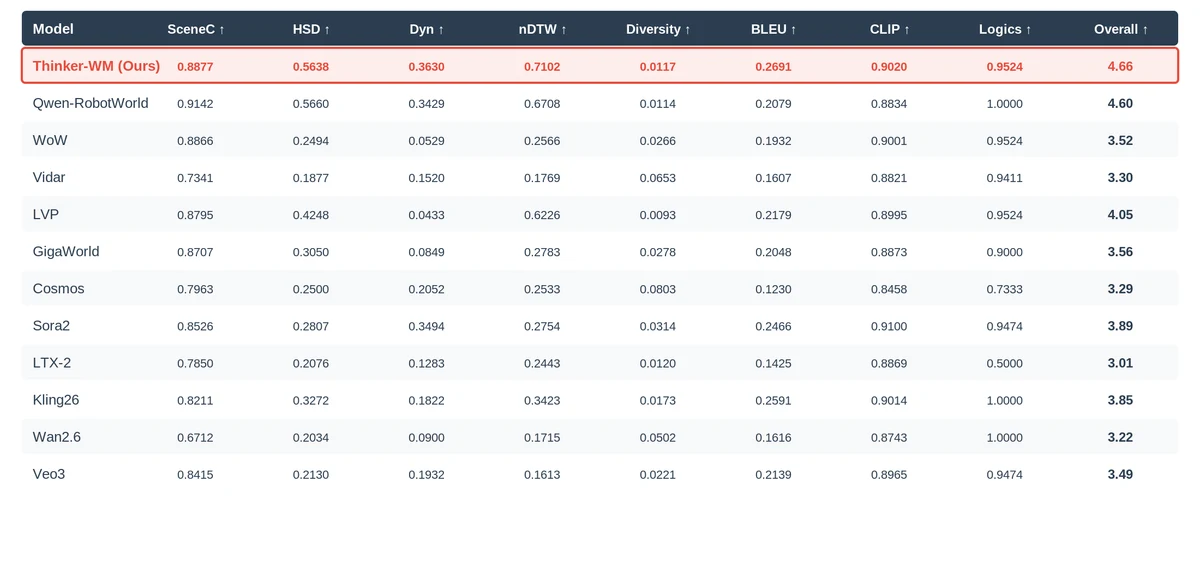
EWMBench:
حقق Thinker‑WM درجة إجمالية قدرها 4.66 متجاوزاً النماذج الرئيسية مثل Qwen‑RobotWorld وSora2. يقيّم EWMBench بشكل كامل ثلاثة أبعاد للقدرات: اتساق المشهد، وصحة حركة الطرف النهائي للروبوت، والمواءمة الدلالية للتعليمات. وبفضل النمذجة المشتركة متعددة الوسائط على مستوى التمثيل، حقق Thinker‑WM التقدم في المؤشرات الأساسية لحركة الروبوت مثل nDTW (التوافق الديناميكي الزمني المُطبَّع) الذي يعكس التطابق الزماني المكاني لمسار الروبوت، وDyn (اتساق الديناميكا) الذي يمثل معقولية السرعة والتسارع في الحركة.
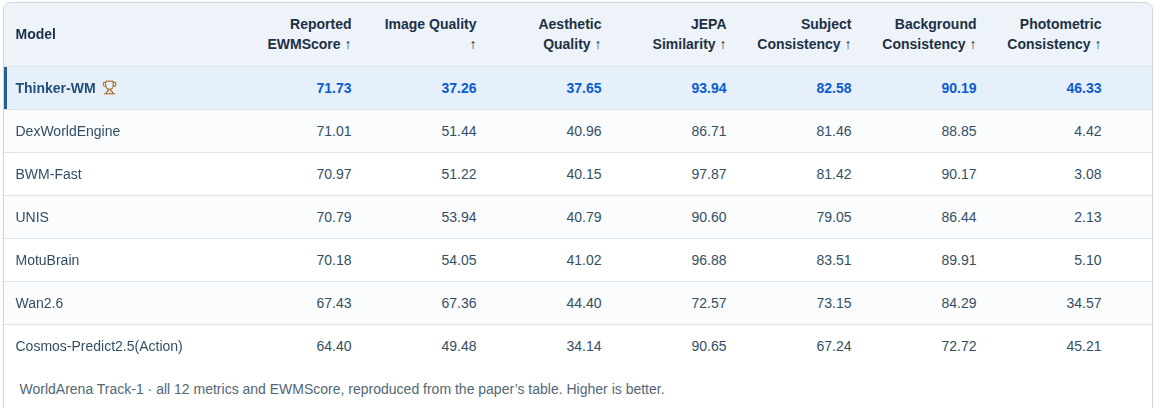
WorldArena1.0 Track-1:
في المعيار القياسي WorldArena Track‑1 للبيئات المحاكاة، تصدّر Thinker-WM بشكل عام في 12 بُعداً رئيسياً للتقييم تشمل جودة الصورة البصرية، واتساق المحتوى، والمعقولية الفيزيائية، والدقة الهندسية 3D، والالتزام بالتعليمات، محققاً التوازن بين جودة التوليد البصري ومصداقية التفاعل الفيزيائي في بيئات المحاكاة. يعتمد Thinker-WM على Unified Dynamic Transformer (UDT) الموحد على مستوى التمثيل، حيث يُدمج صور RGB والعمق المتري وأفعال الروبوت في مجموعة واحدة من التمثيلات الديناميكية المشتركة تتطور بشكل مشترك، محققاً الجمع بين قدرات متعددة مثل التوليد المشترك للفيديو والفعل، والتنبؤ بالعالم، والاستدلال بالسياسات، وتحويل الفيديو إلى أفعال، والديناميكا العكسية، ليقدم قاعدةً من الجيل الجديد لنموذج العالم الأساسي للذكاء المجسّد.
02 الاختراق التقني لـ Thinker-WM: تحقيق وحدة متعددة الوسائط للبصر والهندسة والحركة على مستوى التمثيل
أصعب ما في جعل الروبوتات تعمل في العالم الحقيقي ليس التعرف على الأجسام أمامها، بل التنبؤ بالتغيرات التالية في البيئة. وهذا هو بالضبط قيمة النموذج العالمي ومعناه، بينما اعتمدت النماذج العالمية السابقة عموماً على حل "التركيب": توليد الفيديو مسؤول عن الصور، والشبكة الاستراتيجية مسؤولة عن الأفعال، والتنبؤ الهندسي مسؤول عن المعلومات المكانية، حيث تُحسب الوحدات بشكل مستقل ثم تُدمج مخرجاتها عبر واجهات.
لكن مشكلة هذا النموذج التقني تكمن في أن الأفعال تُغيّر البيئة، والبيئة تقيّد الأفعال، والبنية الهندسية تؤثر في كليهما معاً، فتُفصل الإشارات المتقاربة فيزيائياً بين وحدات مختلفة، فتُفقد صلتها السببية الجوهرية.
على سبيل المثال، حدث "دفع كوب من على الطاولة" هو في اللغة جملة وصفية، وفي الأفعال سلسلة أوامر للمفاصل، وفي الفيديو حركة جسم تعبر المشهد، وفي العمق حقل مسافات متغير باستمرار. التعبيرات الأربعة تشير إلى الحدث نفسه، وليست أربعة كائنات مختلفة. لذلك، مطالبة النموذج بتوليد أيٍّ منها هي في جوهرها سؤال عن العملية نفسها.
لكن هذا التداخل غير كامل. فالأفعال لا تحمل المظهر ولا السياق؛ فنفس أوامر المفاصل تختلف معناها تماماً إذا نُفذت على طاولة فارغة أو على طاولة فوضوية. واللغة أيضاً لا تحمل التفاصيل الزمانية المكانية؛ فعبارة "الكوب دُفع من على الطاولة" لا تحدد من أي جهة دُفع، ولا بقوة كم، ولا بأي سرعة، كما لا تحدد المسار الدقيق لليد، ولا عدد دورات تقليب الكوب، ولا المكان الذي يهبط إليه في النهاية. والفيديو لا يحمل الهندسة الصريحة والقياسات، إذ يستخدم مجرد سلسلة من البكسلات، فلا يعرف حجم الكوب ولا بُعده. والعمق لا يحمل المظهر ولا الدلالات التسموية ولا النية؛ فهو يخبرك أين يقع السطح وكيف يحدث الحجب وكيف يحدث التلامس، لكنه لا يخبرك هل هو كوب أم مفرش طاولة، ناهيك عن إخبارك لماذا دُفع.
لمعالجة هذه المشكلة، قدّم فريق Thinker في UBTech حلاً جديداً كلياً: لا دمجاً بسيطاً عند الواجهات، بل تحقيق وحدة متعددة الوسائط على مستوى التمثيل. فـ Thinker-WM (Thinker World Model) بوصفه نموذج العالم الموحد متعدد الوسائط المطوَّر ذاتياً من UBTech، يُرمّز فيديو RGB والعمق وأفعال الروبوت في فضاء تمثيل وسيط واحد، يتطور بشكل مشترك اعتماداً على مجموعة من المعاملات المشتركة. لم يعد المظهر والهندسة والحركة ثلاثة خطوط أنابيب مستقلة، بل ثلاثة أشكال تعبيرية عن عملية تطور العالم نفسها. أي أنه يمكن تلخيص المنطق التصميمي الأساسي لـ Thinker-WM بما يلي: الوسائط المختلفة هي تعبيرات مختلفة عن العملية ذاتها؛ ويحاذي النموذج بينها في فضاء تمثيل مشترك، ويجري الاستدلال على هذا التمثيل المشترك، بدلاً من الدمج الشرطي عند واجهات الوسائط.
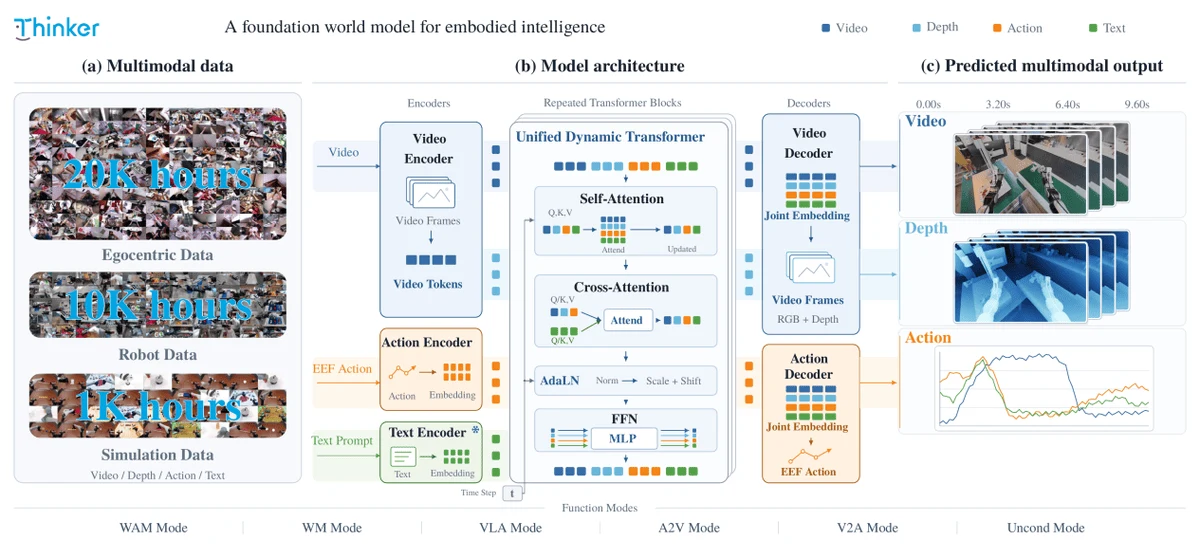
Thinker-WM: إطار نمذجة موحد للبصر والهندسة والحركة
وعلى وجه التحديد، تُحوَّل صور RGB ومعلومات العمق وأفعال الروبوت عبر مرمّزاتها الخاصة إلى فضاء كامن موحد، ثم تُدخل إلى Unified Dynamics Transformer (UDT) المشترك للنمذجة الزمنية المشتركة، وأخيراً يستعيد كل وحدة فك ترميز مخرجاتها: الفيديو، وخريطة العمق، وأفعال الروبوت القابلة للتنفيذ. هذا يعني أن التفاعل متعدد الوسائط يحدث داخل الـ Transformer نفسه، حيث تتبادل رموز البصر (visual tokens) والرموز الهندسية (geometry tokens) ورموز الأفعال (action tokens) المعلومات مباشرة عبر آلية الانتباه نفسها، بدلاً من الربط السطحي عند طبقات الإدخال أو الإخراج.
كما أن المعلومات الهندسية لم تعد مجرد إشارة إشراف مساعدة. فـ Thinker-WM يتعامل مع العمق كوسيلة توليد أصلية، تتشارك مع الفيديو البنية الكامنة والتنظيم الزماني المكاني نفسه. فالإشراف بالعمق يشكّل التمثيل المشترك مباشرة، بحيث تصبح البنية المكانية الفيزيائية "اللغة الأم" للنموذج العالمي، لا وحدة إضافية مُلحقة لاحقاً، مما يساعد الروبوتات البشرية أيضاً على فهم الفضاء الفيزيائي بدقة أكبر. وتتجلى قيمة النمذجة الموحدة أيضاً في الأداء الفعلي لتنفيذ الروبوت للمهام. في تجربة الاستئصال أحادية المهمة على RoboTwin، بعد إدخال وسيط العمق، ارتفع معدل نجاح العمليات مقارنةً بخط الأساس بدون عمق بمقدار 15 نقطة مئوية، مما يشير إلى أن المعلومات الهندسية المكانية لا تساعد النموذج على فهم المشهد فحسب، بل تحسّن أيضاً توليد الأفعال وتنفيذ المهام.
03: 30,000 ساعة من البيانات غير المتجانسة، لنموذج واحد يفتح ست قدرات
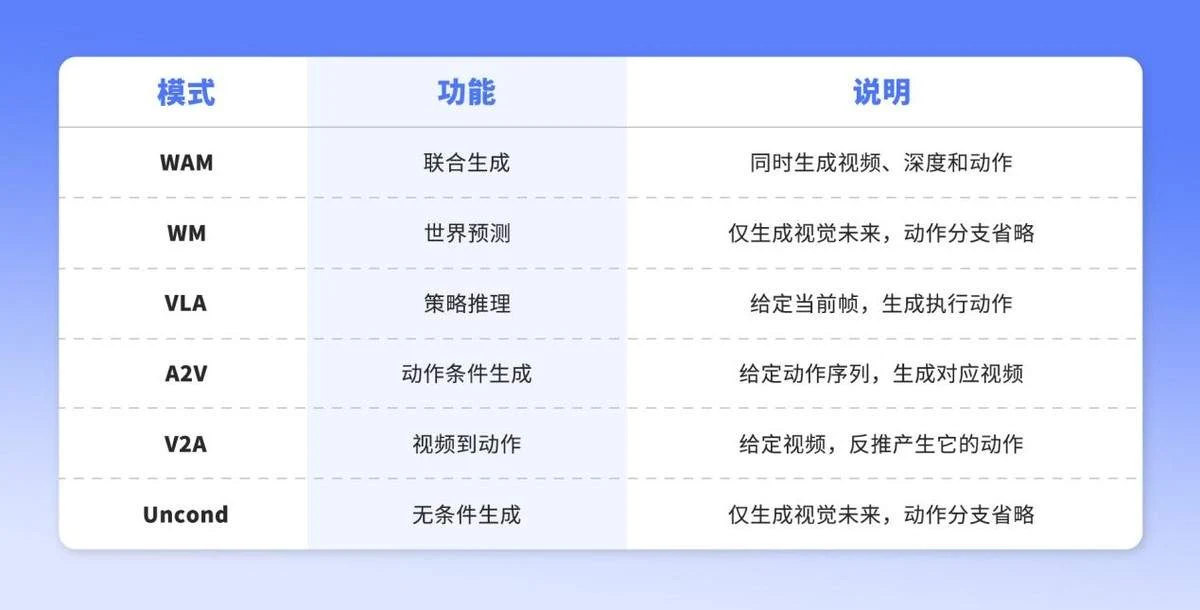
بفضل التمثيل الموحد متعدد الوسائط الذي تتشارك فيه جميع الوسائط المجموعة نفسها من المعاملات، يمكن لـ Thinker-WM دعم ستة أنماط من القدرات عبر التبديل المرن بين وسيط الشرط ووسيط التوليد.
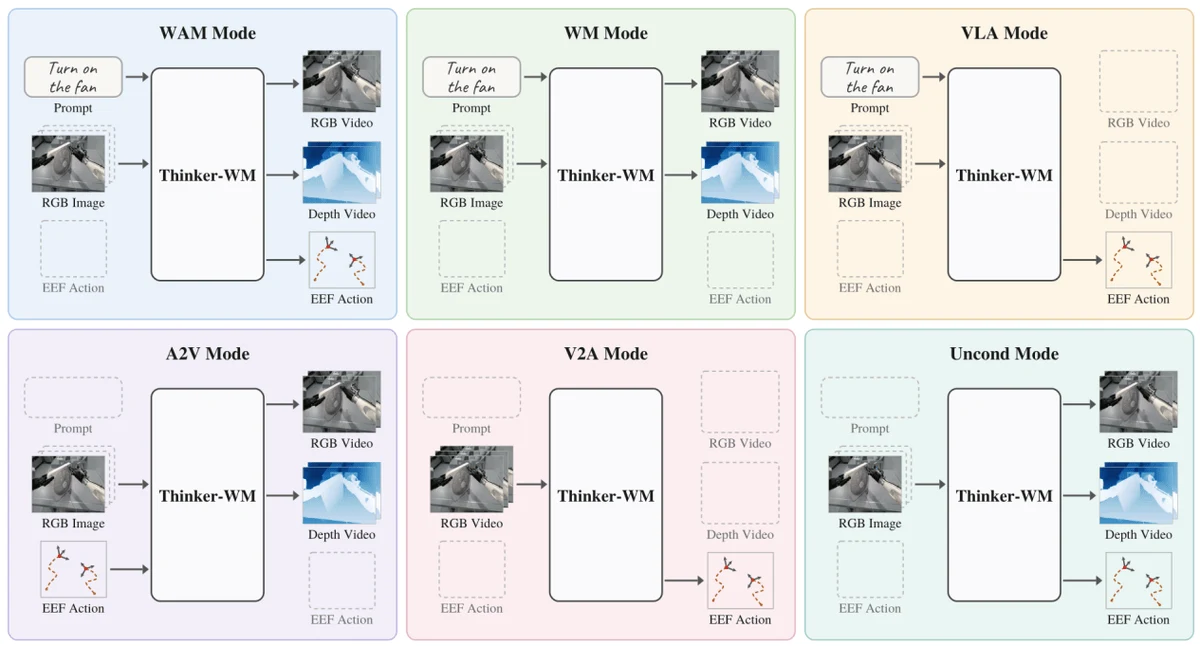
نفس الأوزان يمكنها التنبؤ وتخيّل المشاهد المستقبلية، والاستنتاج العكسي لمسار تنفيذ الروبوت، واستخراج معلومات الأفعال من الفيديو، وهذا هو العائد التقني الأساسي الذي يحققه التمثيل الموحد.
04: 30,000 ساعة من البيانات غير المتجانسة تدعم قاعدة نموذج العالم العام
خلف قدرة التمثيل الموحد يقف دعم بيانات تدريب ضخمة الحجم ومتنوعة الأنواع من UBTech. تتميز لغة تدريب Thinker-WM بحجم كبير في مجال الذكاء المجسّد:
- حوالي 20,000 ساعة من فيديوهات البشر بمنظور الشخص الأول: تغطي مناطق المنازل وتجارة التجزئة والصناعة وغيرها، وتعوّض صعوبة الحصول بتكلفة منخفضة عبر التشغيل البعادي للروبوتات على تنوع المهام والأجسام والمشاهد، مع ما يقارب 1,000 ساعة من بيانات العمق المتوافقة المصاحبة.
- حوالي 10,000 ساعة من بيانات الروبوتات الحقيقية: من عدة روبوتات بأشكال مختلفة، توفر إشرافاً مزدوجاً بين المشاهدات البصرية والأفعال القابلة للتنفيذ، منها حوالي 3,000 ساعة مصحوبة بتسميات عمق متوافقة.
- حوالي 1,000 ساعة من بيانات المحاكاة: توفير إشارات إشرافية هندسية وفيزيائية عالية الدقة.
تختلف مساحات أفعال الروبوتات المختلفة وأنظمة الإحداثيات وبروتوكولات التحكم اختلافاً كبيراً. لا تقتصر فكرة التوحيد في Thinker-WM على إطار النموذج فحسب، بل تُطبَّق أيضاً في اختيار البيانات. يستخدم هذا النموذج تمثيل وضعية النهاية (الـ end-pose) بشكل موحد للتعبير عن جميع أفعال الروبوتات، مع تضمين علامة مخصصة لكل روبوت داخل الـ token. وبهذا يمكن للروبوتات ذات الأشكال المختلفة أن تتشارك فضاء توليد واحداً، مع الاحتفاظ بقدرة تحكم دقيقة في الذات.
05 بنية البيانات التحتية: تمكين كميات هائلة من البيانات غير المتجانسة من دعم تدريب النموذج الموحد بكفاءة
يتطلب تحويل كميات هائلة من البيانات إلى قدرات للنموذج وجود بنية تحتية للبيانات مستقرة وعالية الكفاءة. وفي مواجهة الاختلافات في التنسيق والنمط والتوثيق بين بيانات الروبوتات المختلفة والفيديوهات البشرية وبيانات المحاكاة، أنشأ فريق Thinker من ubttech بنية Data Factory تفصل بين إدارة البيانات وأخذ العينات للتدريب، مما يتيح للبيانات متعددة المصادر أن تُدمَج بمرونة وفق احتياجات النموذج.
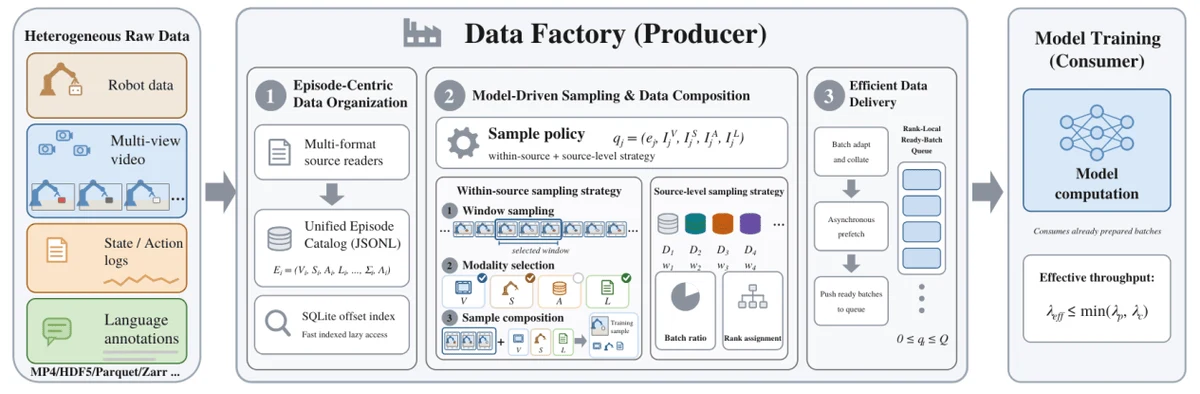
Data Factory: من البيانات غير المتجانسة متعددة المصادر إلى تدريب النموذج الموحد
يدعم Data Factory التدريب من خلال ثلاث حلقات رئيسية:التنظيم الموحدلمعلومات الفيديو والحالة والحركة واللغة، وتوليد العينات المطلوبة لأنماط التدريب المختلفة حسب الحاجة؛ ومن خلالفحص الجودة الهرميتصفية المقاطع الشاذة، وفحص محاذاة العمق مع الفيديو، لضمان موثوقية إشارات التدريب؛ ومن خلالالجلب المسبق غير المتزامن وإعادة استخدام الترميزتجهيز بيانات التدريب مسبقًا، مما يقلل الانتظار والحساب المتكرر.
تتيح هذه البنية التحتية للبيانات تنظيم البيانات متعددة المصادر وغير المتجانسة بشكل موثوق، واستدعائها بمرونة، وتوريدها بكفاءة، مما يوفر الدعم الهندسي للتدريب المشترك والتكرار المستمر لستة أنماط قدرات في Thinker-WM.
06 من خلال تصميم تجربة Motion Probe، تجربة خفيفة الوزن: التحقق من الاقتران الحقيقي للتمثيلات عبر الأنماط
توحيد الأنماط المتعددة على مستوى التمثيل يبدو ابتكارًا في تصميم البنية، لكن هناك سؤال جوهري: هل تعلم النموذج فعلًا الارتباطات الترابطية بين الرؤية والهندسة والحركة في الفضاء المشترك، أم أنه يكتفي بمعالجة متوازية لمسارات معلومات متعددة بوضع الأنماط المختلفة معًا بشكل بسيط؟
للإجابة عن هذا السؤال، صمّم فريق Thinker في UBTECH تجربة تحقق خفيفة الوزن تُسمى Motion Probe (مجس الحركة). قام فريق البحث بتوصيل رأس صغير جدًا للتنبؤ بالحركة فوق تمثيلات UDT البصرية المجمدة، ودرّب هذا الرأس فقط، لمعرفة ما إذا كان يمكنه استعادة إزاحة المشغّل النهائي من التمثيلات البصرية الخالصة.
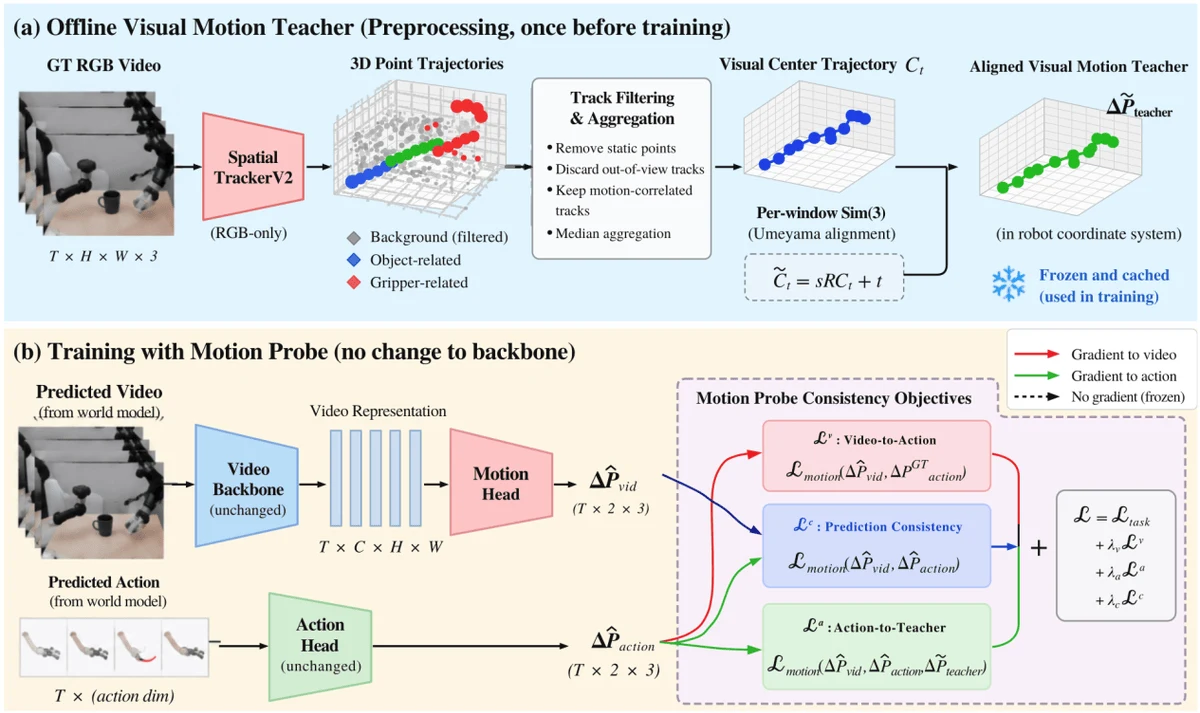
مخطط توضيحي لـ Motion Probe
أكدت النتائج التجريبية الفرضية: خطأ تنبؤ المجس منخفض جدًا. حتى بدون إشراف حركي، كانت التمثيلات البصرية قد شفّرت بالفعل معلومات حركية مرتبطة بالأفعال. تثبت هذه النتيجة مباشرة أن التوحيد متعدد الأنماط على مستوى التمثيل يعمل فعلًا، وأن الإدراك البصري وتخطيط الحركة ليسا مسارين مستقلين عن بعضهما، بل يحققان اقترانًا عميقًا داخل فضاء كامن مشترك.
07 ماذا يعني هذا
يوضح هذا أيضًا أن قيمة اختراق تقنية Thinker-WM هذه المرة تتجاوز بكثير مجرد نتيجة تصدّر للتصنيفات. فهو يحدد نموذجًا أوليًا جديدًا على المستوى الأساسي لنماذج العالم المجسدة:
لا ينبغي أن يكون نموذج العالم للذكاء المجسد مجرد تركيبة بسيطة من "مولّد فيديو + رأس سياسة"، بل عملية توليد واحدة كاملة وموحدة — فالملاحظات البصرية والبنية المكانية وتخطيط الحركة هي تعبيرات مختلفة عن عملية العالم الفيزيائي ذاتها.
حين يستطيع الروبوت أن يستنتج بشكل متزامن داخل نفس فضاء التمثيل التغيرات في الصورة والبنية المكانية ومسارات الحركة، فإنه يخطو خطوة كبيرة إلى الأمام في فهمه للمنطق السببي للعالم الفيزيائي. وهذه هي القفزة الجوهرية للانتقال من الروبوت الذي "يستطيع تنفيذ المهام والعمل" إلى الآخر القادر على "فهم العالم الحقيقي".
أكمل Thinker-WM بالفعل النشر والتحقق على منصة روبوتات UBTECH، وستستمر هذه التقنيات في تمكين أنظمة الذكاء المجسد من الجيل التالي.
لا تتوقف استكشافات Thinker-WM عند إصدار هذه النتائج. سيستمر تحديث تقرير تقنية النموذج وإصدارات التطوير اللاحقة في مجتمع المطورين للذكاء المجسد الرسمي التابع لـ UBTECH، Thinker Cosmos؛ وستُعلن خطة فتح قدرات التطوير الثانوي لنموذج العالم والبثوث التوضيحية التقنية للمطورين في أقرب وقت. نرحب بانضمامكم إلى Thinker Cosmos (https://thinkercosmos.ubtrobot.com/) لبناء بيئة الذكاء المجسد معًا.
رابط المشروع
رابط الورقة البحثية: https://arxiv.org/abs/2610.18447
عنوان المشروع: https://thinkercosmos.ubtrobot.com/thinker-wm
غيت هب: https://github.com/UBTECH-Robot/Thinker-WM
هاغينغ فيس: https://huggingface.co/UBTECH-Robotics/Thinker-WM
قدمت هذه المقالة شركة UBTECH، وحصلت QbitAI على إذن بإعادة نشرها، وآراء المقال تعود إلى مؤلفها الأصلي.