
النجم الشمالي
تواجه كل منظمة تتسابق لنشر وكلاء الذكاء الاصطناعي نفس المحصلة: وكيل يظهر بشكل رائع في العرض التجريبي يمكن أن يتدهور بصمت في الإنتاج، وبحلول الوقت الذي يلاحظ فيه إنسان ذلك، تكون الثقة قد انكسرت بالفعل. حيث تفشل البرمجيات التقليدية بشكل صاخب، يفشل الوكلاء بشكل خفي. يعيدون إجابة تبدو واثقة، وتُقرأ بطلاقة، وهي خاطئة. عندما تقود تلك الإجابة قرارًا تجاريًا حقيقيًا، فالتكلفة ليست ميزة معطلة، بل علاقة مكسورة مع المستخدم.
تلك هي مشكلة الجودة في جوهرها. لذلك فإن التحدي ليس بناء وكلاء يعملون مرة واحدة، بل إثبات أنهم يستمرون في العمل، على نطاق واسع، عبر كل وكيل فرعي، وسير عمل، وإصدار. الفرق التي ستفوز بعصر الوكلاء هي تلك التي تتعامل مع الجودة ليس كخطوة نهائية لضمان الجودة بل كنظام تشغيل للوكيل نفسه: تُقاس باستمرار، وتُدافع عنها تلقائيًا، وتتحسن مع كل تفاعل. في هذا المنشور، نعرض كيف بنينا حلقة جودة مستمرة لحلول الوكلاء الجاهزة للإنتاج على نطاق واسع باستخدام Amazon Bedrock AgentCore.
مشكلة الأعمال
يستخدم الحل Amazon Bedrock AgentCore وخدمات AWS أخرى للاستخدام الداخلي، بحيث يمكن للبائعين وقادة المبيعات طرح أسئلة تجارية باللغة الإنجليزية العادية من Amazon Quick. خلف تلك التجربة الواحدة، تعمل عدة وكلاء فرعيين متخصصين معًا: وكيل رؤى الأداء (Performance Insights Agent) للإيرادات والأداء ضمن نطاق المنطقة، ووكيل رؤى العملاء (Customer Insights Agent) لذكاء العملاء، ووكيل رؤى البيانات (Data Insights Agent) لتحويل النص إلى SQL فوق مجموعات البيانات الأساسية، إضافة إلى وصول مباشر إلى لوحات المعلومات. تُقيَّد الإجابات بمنطقة كل مستخدم وأمن مستوى الدور. تستخدم فرق الميدان هذه الإجابات للمساعدة في تخطيط استراتيجية الحسابات والاستعداد لاجتماعات العملاء، لذا يجب أن تكون الأرقام صحيحة. الفشل الأكثر ضررًا ليس انهيار النظام، بل إجابة طليقة وواثقة تكون خاطئة بصمت. قبل الإطلاق، عندما قيّمنا وكيل رؤى العملاء، وجدنا ذلك بالضبط:
- أفاد بمبلغ $410.08 من إيرادات عميل على مدى ثلاثة أشهر لخدمة معينة على أنها "$410.08 مليون".
- أفاد بإيرادات المبيعات (Sales Revenue) مصنفة بشكل خاطئ كإيرادات المبيعات باستثناء التعديلات (Sales Revenue excluding Adjustments).
- قدّم تقديرًا للإيرادات السنوية المتكررة (Annual Recurring Revenue) لم يكن موجودًا في أي مكان من البيانات.
- قدّم حساباته الخاصة كحقائق موثقة المصدر.
عبر التشغيلات المختلفة، بقي نظام المراقبة باللون الأخضر. كان يخبرنا بأن النظام قد استجاب، لا بما إذا كانت الإجابة صحيحة.
لو شُحنّت هذه الأخطاء دون اكتشافها، لكان الميدان قد دفع ثمنها. البائع الذي يكرر رقمًا مضخمًا قد يفقد مصداقيته لدى العميل. هذا بالضبط هو السبب وراء اكتشافنا له قبل الإطلاق. الخطر لا ينتهي عند الإطلاق: بل يتزايد مع كل وكيل جديد وكل تغيير في البيانات أو المطالبات أو الشيفرة أو النماذج. كما يتنامى دون أي إصدار، لأن خطوط المعالجة المنبعثة تُحدّث البيانات كل أسبوع. تُدخل الإصدارات المنسقة خطرًا ذا صلة: عندما يُفترض أن يُشحن تغيير في البيانات وتغيير في أداة وتحديث مقترن للمطالبة معًا لكنها تصل منفصلة، يعمل النظام بعناصر غير متطابقة حتى تلحق جميع التغييرات. في اختبار واحد قبل الإنتاج، أدى نافذة عدم التطابق تلك وحدها إلى انخفاض معدل النجاح من 78 بالمئة إلى 38 بالمئة. لاكتشاف إخفاقات كهذه، قبل كل إصدار وبشكل مستمر في الإنتاج، نحتاج إلى إطار يمكنه إظهار ما إذا كانت الإجابات مبنية على البيانات وصحيحة، وتتبع كل فشل إلى سببه الجذري في البيانات أو المطالبة أو شيفرة الوكيل.
في AWS، طوّر فريق عمليات المبيعات والتسويق والخدمات العالمية (SMGS) نظامًا إنتاجيًا متعدد الوكلاء يخدم فرق مبيعات AWS الميدانية في جميع أنحاء العالم. يخدم النظام جمهورين مختلفين. لفرق المبيعات الميدانية، يستبدل ساعات من تحليل البيانات اليدوي بذكاء محادثاتي عند الطلب، مما يساعد البائعين على فهم صحة أعمالهم، وإبراز المخاطر والفرص، واتخاذ الإجراء بسرعة أكبر. للقيادة، يشغّل إيقاعات إدارة الأعمال بما فيها مراجعات الأعمال الأسبوعية (WBRs)، مُبرزًا الإشارات المهمة عبر المحفظة دون الحاجة إلى إعداد تقارير يدوي. النظام الوكيل نفسه يخدم البائع في الخط الأمامي والقائد الذي يراجع الأداء على نطاق واسع.
ينسّق النظام الوكيل محفظة متنامية من الوكلاء الفرعيين المتخصصين، كل منهم يملك نطاق قدرة مميزًا. ومن بينهم: وكيل رؤى الأداء يُنشئ روايات ذكاء الأعمال باللغة الطبيعية من بيانات مبيعات معقدة، محوّلًا المقاييس الخام إلى رؤى قابلة للتنفيذ للبائعين. أما وكيل رؤى العملاء فيركّب رؤية 360 درجة لكل عميل عبر تجميع الإشارات من استخدام المنتجات وتاريخ الدعم وحالة العقود وبيانات التفاعل، مما يساعد البائعين على فهم موقع العميل في رحلته وما يحتاجه بعد ذلك. و وكيل رؤى البيانات هو وكيل نص-إلى-SQL تستخدمه فرق الحسابات للاستعلام عن بيانات التحليلات المهيكلة باللغة الإنجليزية العادية دون كتابة سطر واحد من SQL. هؤلاء الوكلاء الثلاثة هم المشار إليهم في بقية هذا المنشور.
لقد جعل التنسيق الموثوق لهذه الوكلاء على نطاق واسع أمرًا واحدًا واضحًا: جودة الوكيل لم تكن اهتمامًا تشغيليًا يُدار لاحقًا، بل كانت الشرط الأساسي للتشغيل. يمكن لوكيل فرعي واحد متدهور أن يفسد بصمت كل استجابة لاحقة، ولن تكشفه المراقبة التقليدية. هذه الحقيقة جعلت إطار تقييم دورة الحياة الكامل ضرورة لا خيارًا. وتُعد AgentCore Evaluations، وهي إحدى إمكانات Amazon Bedrock AgentCore، النسيج الضام الذي يشغّله، إلى جانب Amazon Bedrock Guardrails (السلامة)، وAmazon CloudWatch (المقاييس والتنبيهات والتتبع)، وAmazon Simple Storage Service (Amazon S3) وAmazon Redshift (استمرارية التقييم)، وAmazon Quick (لوحات المعلومات)، وAWS Lambda (المقيّمات المخصصة).
في هذا المنشور، نشارك كيف تعاملنا مع أصعب التحديات التشغيلية في تشغيل وكلاء الذكاء الاصطناعي على نطاق المؤسسات، وكيف أصبحت Amazon Bedrock AgentCore Evaluations العمود الفقري لجودة الوكلاء. وعلى وجه التحديد، نتناول:
- الوكلاء يخضعون لقواعد مختلفة – لماذا يطلب الوكلاء نظامًا تشغيليًا مختلفًا، ولماذا تتركك المراقبة التقليدية (زمن الاستجابة، معدلات الأخطاء، جهوزية التشغيل) عمياء أمام الإخفاقات الأكثر أهمية.
- خريطة للرحلة كاملة – إطار التقييم ذو المراحل التسع الذي بنيناه على AgentCore Evaluations، ويغطي كل مرحلة من مراحل دورة حياة تطوير الوكيل من أول التزام وحتى الإنتاج.
- من النظرية إلى التطبيق – أنماط ملموسة (بوابات الانحدار في التكامل المستمر والتسليم المستمر (CI/CD)، وتسجيل النسخ التجريبية الكنارية، واكتشاف الانحراف، وحلقات التغذية الراجعة المؤتمتة) وكيف تشغّل AgentCore Evaluations كلًا منها بدقة.
- مقاييس لها أهمية فعلية – الأثر القابل للقياس على الثقة في النشر، والوقاية من الانحدارات، وسرعة التكرار عبر محفظة وكلائنا.
لماذا يحتاج الوكلاء إلى إطار تقييم منظم
البرمجيات التقليدية حتمية: المدخل نفسه ينتج المخرج نفسه. وقد أدت نماذج تعلم الآلة (ML) إلى مخرجات احتمالية، فظهر MLOps لإدارة تدريبها وإصداراتها ومراقبتها وإعادة تدريبها. ويضيف وكلاء الذكاء الاصطناعي طبقة ثالثة من التعقيد التشغيلي: الاستدلال الذاتي متعدد الخطوات، حيث يتحول السؤال من «هل تعطل شيء ما؟» إلى «هل يتخذ الوكيل قرارات سليمة عبر سلسلة استدلاله بأكملها؟»
يرث الوكلاء المشكلات الصعبة لكل من سابقيه، ويقدمون بعض المشكلات الجديدة. فهم غير حتميين، إذ يتبعون مسارات استدلال مختلفة للمدخلات المتطابقة. ويتخذون قرارات متتالية عبر التوجيه واختيار الأدوات والتوليف، حيث يمكن لخطوة واحدة أن تفشل بصمت وتفسد كل ما يليها. والأهم من ذلك، أنهم يتدهورون بصمت: يبقى زمن الاستجابة منخفضًا، وتبقى معدلات الأخطاء مستقرة، لكن جودة استجابة الوكيل تتآكل، لأن الوكيل لا يزال يستجيب. إنه فقط يستجيب بشكل خاطئ.
تقييم الوكلاء هو ممارسة رصد هذا تحديدًا. وهو يشمل خمسة أبعاد: السلامة (هل يتصرف ضمن الحدود المحددة؟)، الجودة (هل ينتج الوكيل استجابات صحيحة ومتماسكة ومستندة إلى مصادر؟)، الأداء (هل هو سريع وموثوق بما يكفي؟)، التكلفة (هل يعمل بكفاءة على نطاق واسع؟)، و التحكم التشغيلي (هل يمكننا اكتشاف المشكلات وتشخيصها ومعالجتها بسرعة؟). وتعالج ممارسة التقييم الناضجة هذه الأبعاد الخمسة باستمرار، على مدار دورة حياة الوكيل الكاملة.
في هذا المنشور، نشارك كيف نضع أبعاد التقييم الخمسة موضع التشغيل عبر نظام إنتاجي متعدد الوكلاء. السلامة والأمان هما أولويتنا الأولى. لا يُطلق أي وكيل، ولا يستمر أي وكيل في العمل، إذا لم يستوفِ معيار السلامة الخاص به. وتحصل الجودة على أكبر حصة في هذا المنشور لأنها أصعب الأبعاد الخمسة إتقانًا وتستفيد أكثر من غيرها من إطار مخصص، لكنها لا تتفوق على السلامة. أما الأداء والتكلفة والتحكم التشغيلي فمنسوجة في كل مرحلة من مراحل دورة الحياة إلى جانبهما. والأهم من ذلك، أن هذا الإطار ينطبق على كل مستوى في التسلسل الهرمي للوكلاء. فعلى مستوى الأدوات، لكل قدرة (أداة لتوضيح غموض العملاء، أداة لاسترجاع الرسوم البيانية) عقد تقييم خاص بها. وعلى مستوى الوكيل، يُقيَّم كل وكيل فرعي من البداية إلى النهاية. وعلى مستوى الوكلاء المتعددين، يتم تقييم مسارات التنسيق من حيث الترابط، والتوجيه الصحيح، ودقة التوليف عبر حدود الوكلاء.
تنطبق المراحل التسع على ثلاثة مستويات في آنٍ واحد، وهذه التسلسل الهرمي ليس خاصًا بهذا المنتج. إنه النموذج الذهني الصحيح عندما نبني أو ندمج وكلاء إنتاج جددًا. تبدأ معظم الفرق بالتقييم على مستوى الوكيل وتتوقف عند ذلك. لكن جودة مستوى الوكيل لا تقل جودة عن الأدوات التي تعتمد عليها، وأنظمة الوكلاء المتعددين تُدخل سطح فشل ثالثًا لا يمكن لأي من المستويين رؤيته بمفرده. تغطي ممارسة التقييم القوية المستويات الثلاثة، حيث يدير كل مستوى مجموعته الذهبية الخاصة، ومقيّميه الخاصين، ومعايير الترويج الخاصة به عبر المراحل التسع.
إطار تقييم الوكيل: تسع مراحل، حلقة مغلقة واحدة
تتتبع هذه المراحل التسع دورة حياة الوكيل من أول إيداع (commit) إلى الإنتاج المباشر، وتجيب كل واحدة منها عن سؤال تواجهه الفرق مع نضج وكلائهم.
دورة حياة الوكيل والتسعة أسئلة الشائعة
يواجه كل فريق يبني وكلاء للإنتاج الأسئلة التالية مع نضج وكيلهم:
المرحلة 1: الأساس: «ما هو الشكل الجيد؟»
المرحلة 2: التجربة: «أي إصدار أفضل؟»
المرحلة 3: الدمج (CI): «هل كسرت شيئًا ما؟»
المرحلة 4: البوابة (CD): «هل هو آمن للإنتاج؟»
المرحلة 5: الكناري (Canary): «هل تعطل شيء ما بصمت؟»
المرحلة 6: الخصم: «ماذا لو حاول أحدهم كسره؟»
المرحلة 7: الانحراف: «هل تنحرف الجودة في البيئة المباشرة؟»
المرحلة 8: النبض: «كيف نعرف أنه يعمل الآن؟»
المرحلة 9: حلقة التغذية الراجعة: «كيف يتحسّن تلقائيًا؟»
نحن نبني إطار عمل واحدًا لكل مرحلة من مراحل دورة حياة الوكيل باستخدام AgentCore Evaluations. المراحل التسع ليست أدوات منفصلة تم تجميعها معًا لاحقًا. إنها تسع نقاط على سطح تقييم واحد ومستمر، مدعوم بـ AgentCore Evaluations من أول commit إلى استجابة الإنتاج، كما هو موضح في الشكل 1.
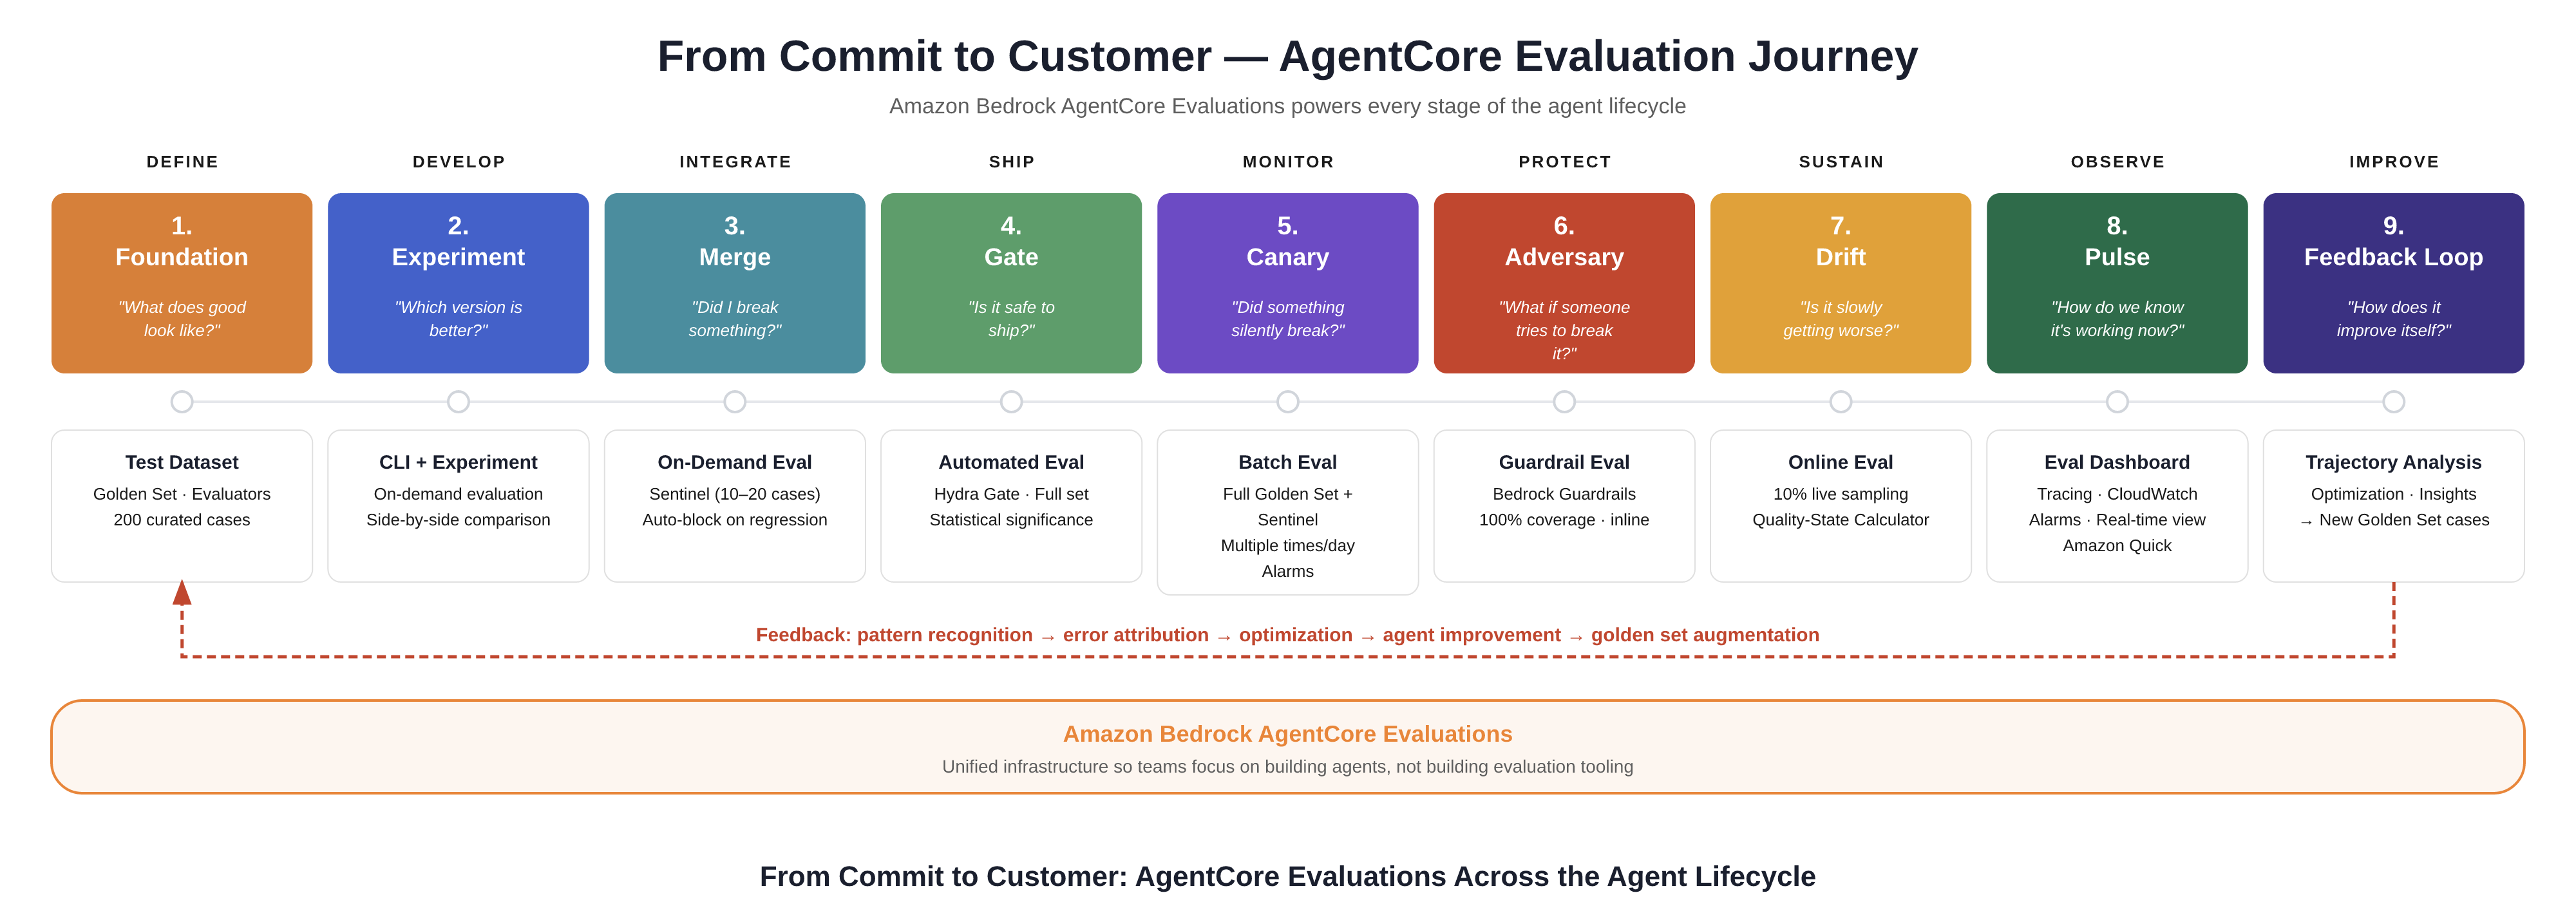
الشكل 1: رحلة AgentCore Evaluations ذات المراحل التسع، من Define عبر Improve
إليك كيف نتعامل مع كل واحدة منها: النمط الذي ينجح، وخدمات AgentCore الكامنة خلفه، وشكله عند تشغيله في الإنتاج، كما هو موضح في تصميم النظام في الشكل 2.
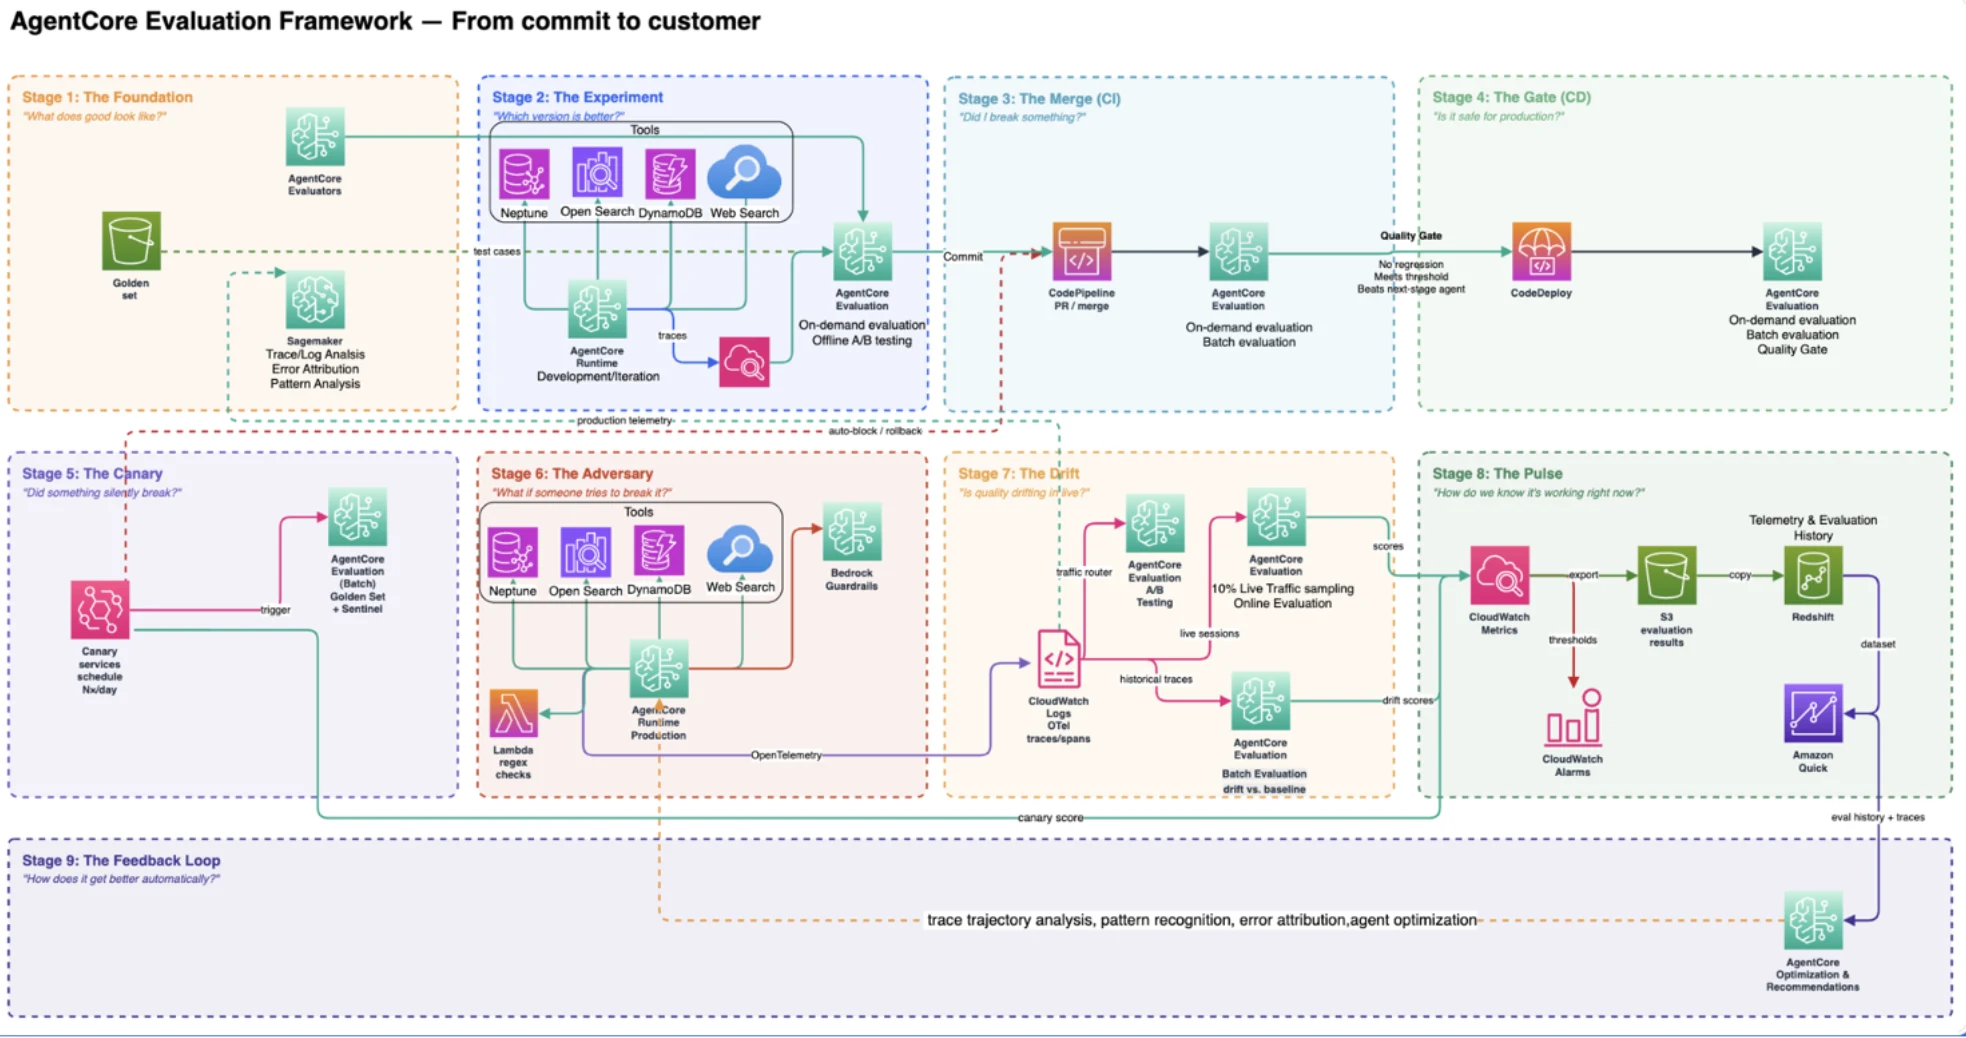
الشكل 2: تصميم نظام إطار عمل التقييم AgentCore
المرحلة 1: الأساس. حدّد الجودة
أساس تقييم الوكيل لا يتعلق باختيار الأدوات الصحيحة. بل يتعلق بطرح السؤال الصحيح: كيف يبدو النجاح لهذا الوكيل، وكيف نعرف متى يفشل؟ يجب أن يأتي الجواب من العميل، لا من النموذج. هذه عملية تكرارية. لقد صقل تعريفنا للنجاح كلما لاحظنا ما يفعله الوكيل فعليًا في الإنتاج. كل ما يُعرَّف هنا (عتبات الفشل، وحزمة المقيّمين، والمجموعة الذهبية، وقواعد السلامة، وميزانيات زمن الاستجابة، وأهداف التكلفة) هو العقد الذي تفرضه كل مرحلة لاحقة. إذا كانت المرحلة 1 غامضة، فإن كل بوابة لاحقة تكون مجرد تخمين.
المرحلة 1.1: حدّد مؤشرات أعمالك أولًا. ابدأ بالسؤال عما يوجد الوكيل لتقديمه. إن شخصيتا المستخدم النهائي تحددان النجاح بشكل مختلف:
- بالنسبة للبائعين، النجاح يعني الدخول في محادثة مع العميل بذكاء دقيق ومحدّث وبمستوى التفاصيل المناسبة وفي الوقت المناسب.
- بالنسبة للقيادة، النجاح يعني مدخلات مراجعة موثوقة أسبوعيًا وعبر الوحدات التجارية دون إعداد يدوي طويل. هذه نتائج أعمال، وليست خصائص نموذج.
المرحلة 1.2: ترجمة مؤشرات الأعمال تلك إلى مؤشرات تقييم. لكل نتيجة، حدّد الإشارة التي تؤكد أن الوكيل قد حققها. تصبح كل إشارة مؤشرًا متتبعًا مع عتبة صريحة وحالة إنذار. ذكاء الحساب الدقيق يقابله دقة حل الكيانات ومعدل التأسيس. ثقة البائع تقابلها الدقة الواقعية ومعدل الهلوسة. فعل البائع يقابله مفيدية الالتزام بالنطاق. موثوقية مراجعة القيادة يقابلها معدل نجاح الدقة وتغطية الاستجابة. يجب أن تغطي هذه الترجمة خمسة أبعاد: إلى جانب عتبات الجودة، حدّد سياسات حواجز السلامة، وضع أهداف زمن استجابة p50 وp90 وp99 لكل أداة ولكل وكيل، وضع ميزانيات التكلفة لكل استعلام، وحدّد اتفاقيات مستوى الخدمة (SLAs) التي تحدد متى يُطلق الإنذار وأي دليل تشغيل يُفعّل.
وبالنسبة للدقة تحديدًا، لأن الحل يُعلم مباشرة قرارات الإيرادات واستراتيجيات التجديد والمراجعات التنفيذية، فإن المعيار مرتفع. الإجابة الخاطئة بثقة لا تضيع وقت البائع فحسب، بل تؤدي إلى قرار خاطئ في لحظة عمل حقيقية. نحن نعرّف ستة أنواع من الفشل مستمدة من أخطاء إنتاج حقيقية، أي واحد منها يجعل الاستجابة غير دقيقة:
- تبديل المؤشر: العميل والفترة صحيحان، لكن المؤشر المُعاد خاطئ. يُتتبع كعدد الحالات لكل 100 استجابة.
- فترة خاطئة: بيانات من نافذة زمنية تُنسب إلى أخرى، على سبيل المثال رقم سنوي (YoY) يُعرض على البائع كرقم شهري (MoM)، أو العكس. يُتتبع كنسبة % تشير إلى النافذة الصحيحة.
- كيان خاطئ: أسماء حسابات أو شركات تابعة مختلطة. يُتتبع كنسبة دقة حل الكيانات %.
- هلوسة صرفة: أرقام غير مؤسسة بدون مصدر قابل للتتبع. يُتتبع كمعدل تأسيس %.
- رموز خاطئة: المؤشر صحيح، لكن رمز العملة أو الوحدة خاطئ. يُتتبع كمعدل الالتزام بالنطاق %.
- حساب غير مصرّح به: أرقام مشتقة غير معتمدة غير موجودة في البيانات المصدرية. يُتتبع كعدد الحالات لكل 100 استجابة.
معدل نجاح الدقة الإجمالي هو المؤشر الرئيسي. والتتبع لكل بُعد هو ما يجعله قابلاً للتنفيذ. إلى جانب الدقة، نتتبع أيضًا ملاءمة الاستجابة, الدقة الواقعية, المفيدية, اتباع التعليمات,دقة اختيار الأدوات. الإجابة الصحيحة المدفونة بين ثلاث فقرات، أو التي تصل متأخرة جدًا، تُعد هي الأخرى إخفاقًا للبائع.
المرحلة 1.3: بناء حزمة تقييم تعكس تلك المقاييس. لا يوجد نوع واحد من أدوات التقييم يغطي جميع أنماط الفشل الممكنة. نحن نجمع بين أربعة أنواع:
- المقيّمات المدمجة في AgentCore للتغطية الأساسية الشاملة. إن مقاييس الملاءمة والأمانة والفاعلية تتوافق مباشرة مع قوالب التقييم المتوفرة أصلًا في AgentCore Evaluations.
- مقيّمات مخصصة, واحد لكل نوع من أنواع الفشل في تصنيفنا: مقيّم استبدال مؤشر، ومقيّم فترة خاطئة، ومقيّم عميل خاطئ، ومقيّم هلوسة خالصة، ومقيّم رموز خاطئة، ومقيّم حساب غير مصرح به. لا يغطي أي من هذه الستة القوالب الأصلية. إنها إشارات خاصة بالمجال بنيناها فوق إطار عمل AgentCore. معرفة مسبقاً أي المؤشرات يغطيها القالب الأصلي بالفعل، وأيها يتطلب مقيّماً مخصصاً، هي في حد ذاتها جزء من قرار التصميم.
- مقيّمات الطرف الثالث، نشرنا المقيّمات المُدارة من مكتبتي المصادر المفتوحة للطرف الثالث DeepEval وAutoEval.
- المقيّمات الحتمية لعمليات التحقق من الحقيقة المرجعية حيث تُعرف الإجابة الصحيحة بدقة، مثل الإيرادات وتاريخ التجديد وحالة العقد.
أما حيث لا توجد إجابة صحيحة واحدة لجودة الاستدلال والفائدة، نستخدم بدلاً من ذلك معايير تقييم النموذج اللغوي كقاضٍ (LLM-as-judge)، مع معايير مدمجة للصلة والأمانة والفائدة بالإضافة إلى دعم معايير مخصصة بالكامل. يوفر AgentCore Evaluations كلاً من تقييم الحقيقة المرجعية وتقييم النموذج اللغوي كقاضٍ بشكل أصلي، وهو ما مكّننا من إقامة مسارَي التقييم معاً دون بناء أي من محركَي التسجيل بأنفسنا. التقييم الحتمي يمنح الدقة في الحقائق. والنموذج اللغوي كقاضٍ يمنح الاتساع في الاستدلال.
المرحلة 1.4: بناء مجموعة ذهبية لاختبار مؤشرات التقييم الخاصة بك. على مستوى الأدوات، كل أداة حرجة لديها أزواج حقيقة مرجعية حتمية خاصة بها: يجب أن يُحدد تعريف العميل الكيان المرجعي الدقيق وإلا يُعد فشلاً. وعلى مستوى الوكيل، يُنتج تحليل المواضيع على استعلامات مستخدمين حقيقية مجموعة بيانات عبر أربعة أنواع من الأسئلة (شاملة، وتقارير، واستدلالية، وغامضة)، كل منها يتطلب استراتيجية تقييم مختلفة، ويُعاد النظر فيها شهرياً. وعلى مستوى الوكلاء المتعددين، تلتقط سيناريوهات التنسيق من طرف إلى طرف الأخطاء التي تظهر فقط عند تفاعل الوكلاء. المجموعة الذهبية ليست مجرد مجموعة بيانات للجودة. إنها تشمل أيضاً حالات اختبار السلامة، وحالات قياس زمن الاستجابة المرجعي، وحالات مرجع التكلفة، بحيث يمكن للمرحلتين 3 و4 التحقق من خمسة أبعاد مقابل نفس مجموعة البيانات المنسقة.
المجموعة الذهبية وثيقة حية، مبنية من ثلاثة مصادر. الحالات المستمدة من الإنتاج تُسحب عينياً من استعلامات بائعين وقادة حقيقية، بما في ذلك الجلسات المباشرة منخفضة الدرجات التي تمت ترقيتها في المرحلة 7. والحالات المستمدة من الإخفاقات تأتي من كل انحدار تم رصده في بيئة الاختبار أو الإنتاج، بما في ذلك الحالات الحارسة التي تمت ترقيتها في المرحلة 3 وحمايات الانحدار الدائمة التي تمت ترقيتها في المرحلة 9. أما حالات الحواف الاصطناعية فهي مبنية عمداً لضمان تغطية السيناريوهات التي نعرف أنها مهمة لكن لا يمكننا انتظار مواجهتها في الواقع، مثل أنواع الأسئلة الأربعة المذكورة أعلاه وحالات التمييز بين الشركة الأم والفرعية وبين رموز الأسهم (ticker) في المرحلة 4. المجموعة تخضع للتحكم في الإصدارات والمراجعة والتوسيع المستمر عبر المصادر الثلاثة.
المرحلة 2: التجربة. اعرف أي إصدار يفوز
كل تغيير (تحديث توجيه، أداة جديدة، ترقية نموذج، تحديث لمجموعة بيانات) يطرح السؤال نفسه: هل هذا الإصدار أفضل فعلاً؟ في نظام يخدم الميدان في AWS على نطاق عالمي، الحدس ليس إجابة مقبولة.
قبل دمج أي تغيير، نشغّل تقييم AgentCore عند الطلب، مع تسجيل النتائج مقابل نفس المجموعة الذهبية وبنفس مجموعة المقيّمات. يستخدم فريق التطوير مؤشرات الجودة وزمن الاستجابة والتكلفة وسياق الرموز (context token) لتنظيم المقارنات اللاحقة، والتي تُقيَّم عبر خمسة أبعاد في آن واحد، كما هو معروض جنباً إلى جنب في الشكل 3. النموذج الذي يحسّن الدقة بنسبة 5 في المئة لكنه يضاعف زمن الاستجابة ويضاعف التكلفة ثلاث مرات لا يفوز تلقائياً.
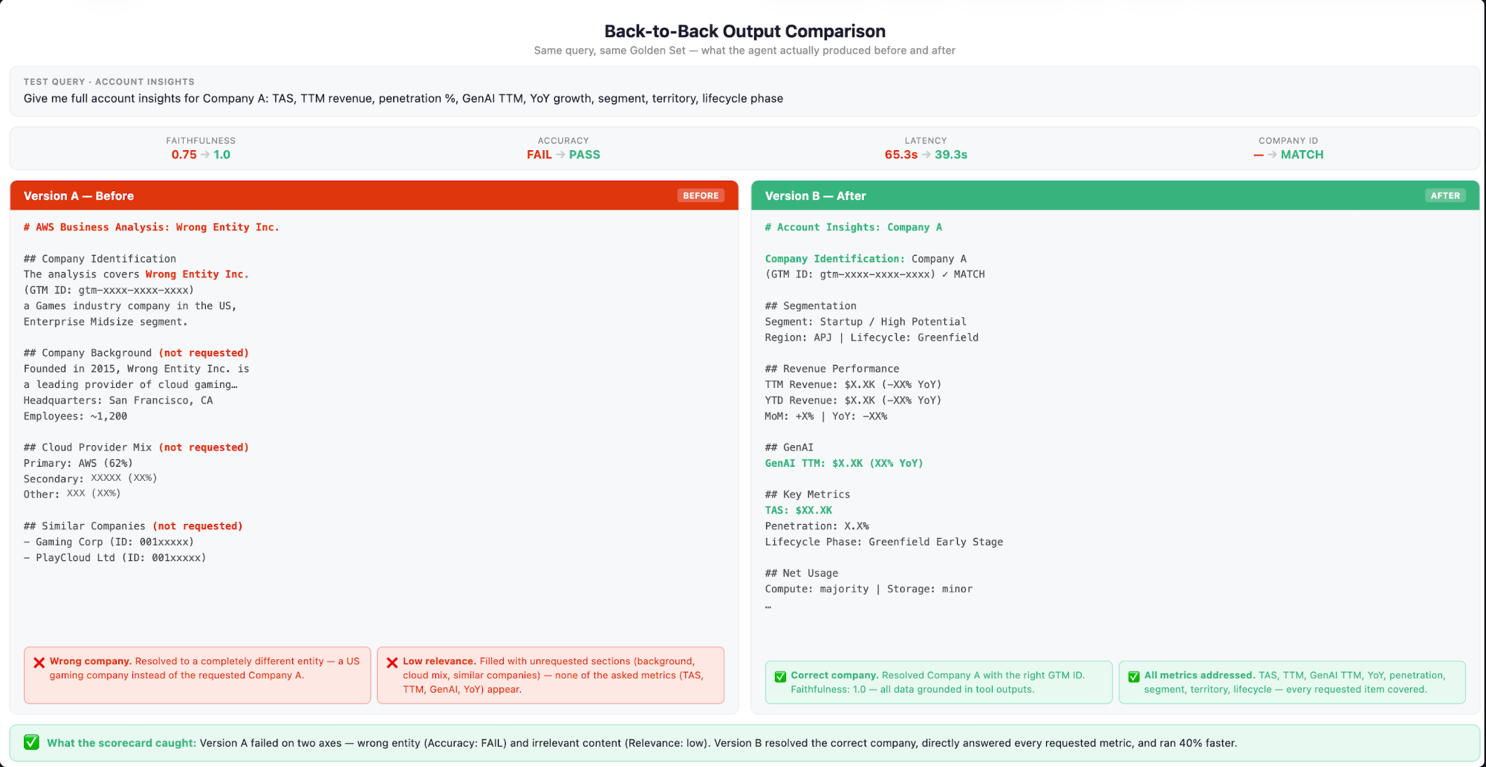
الشكل 3: مقارنة جنباً إلى جنب لاستجابتي وكيل مرشحين في تقييم AgentCore عند الطلب عبر الجودة وزمن الاستجابة والتكلفة. الأرقام والقيم في الشكل توضيحية.
نتتبع الجودة كبطاقة أداء شاملة، وليس كرقم واحد. معدل النجاح وحده لا يخبرك بما يكفي. كل تشغيل تقييم ينتج تفصيلاً كاملاً عبر كل فئة فشل في تصنيفنا: ليس فقط ما إذا تحسّت الجودة، بل أين ولماذا، كما هو موثق في بطاقة الأداء في الشكل 4. كل تقييم يُسجَّل أيضاً بالكامل: المدخلات والمخرجات والسياق المسترجع والدرجات وأسباب التقييم تُخزَّن في S3 وبحيرة بياناتنا، ما يوفر لنا طبقة رصد دائمة لتتبع الفشل حتى جذره: ما رآه الوكيل، وما أنتجه، ولماذا حدث الخطأ. على مدى ثلاثة أشهر من التحسين الموجّه، دفعت بطاقة الأداء هذه معدل النجاح من 93 في المئة إلى 96 في المئة مستقراً: انخفضت الهلوسة الخالصة من 138 إلى أقل من 52 لكل 10,000 استجابة، وانخفضت الحسابات غير المصرح بها من 59 إلى أقل من 44، ما أكد أن الاسترجاع كان سليماً وأن المكاسب جاءت من إصلاحات التوليد. بدون التفصيل حسب الفئة وبيانات التتبع التفصيلية وراءه، كنا سنحسّن معتمين.
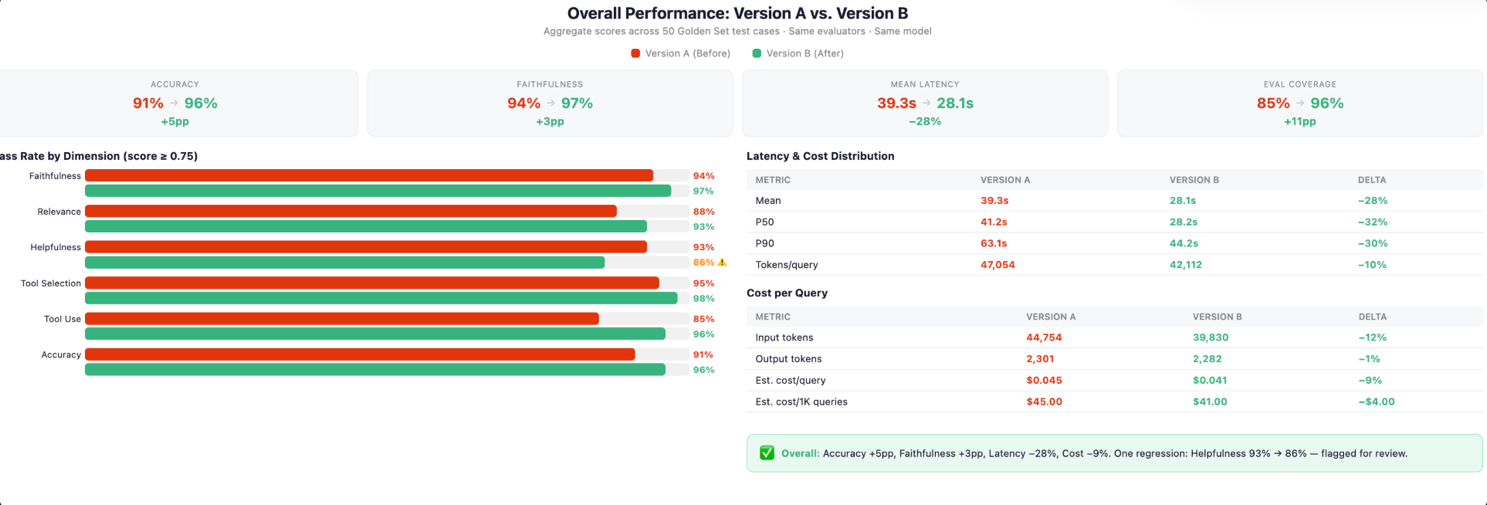
الشكل 4: بطاقة أداء التقييم مع تفصيل الإخفاقات حسب الفئة واتجاه معدل النجاح. الأرقام والقيم في الشكل توضيحية.
المرحلة 3: الدمج (CI). منع الانحدار عند وقت الدمج
المرحلة 3 هي بوابة ما قبل الإنتاج. تعمل في بيئة الاختبار، ويُطلقها تغيير الكود والتكوين، ومهمتها منع أي تغيير سيئ قبل وصوله إلى الإنتاج أبداً. إذا رصدت المرحلة 3 انحداراً، لا يُشحن شيء.
يغيّر المهندسون أو العلماء النظام بطرق عديدة: التوجيه، أو البيانات الأساسية، أو الأدوات، أو النموذج. يبدو التغيير نظيفاً محلياً وتنجح الاختبارات، لكن توجيهاً يحسّن الاستجابات لحسابات قطاع التقنية قد يُضعف بصمت الاستجابات لحسابات الخدمات المالية. بدون بوابة آلية، يُشحن هذا التغيير.
يُشغَّل تقييم التكامل المستمر (CI) الخاص بنا تلقائيًا عند كل عملية نشر إلى بيئة الاختبار المرحلي باستخدام AgentCore On-Demand Evaluation. لا يحتاج المهندسون إلى تذكّر تشغيل تقييم. لا يمكن لأي عملية نشر أن تتجاوز بوابة الفحص بصمت. تكتمل العملية في غضون دقائق لأنها تُقيّم مجموعة الحارس (sentinel set) فقط، وليس المجموعة الذهبية الكاملة. السرعة مقصودة: الحارس ضيق بما يكفي ليُشغَّل عند كل عملية نشر، لكنه ممثل بما يكفي لاكتشاف الإخفاقات الأكثر أهمية.
مجموعة الحارس هي انتقاء مدروس لأعلى السيناريوهات خطورة عبر خمسة أبعاد. أي تراجع في الجودة يتجاوز الحدود المسموحة يحجب النشر. وخرق حدّ السلامة يحجب النشر بنفس الصرامة. والتغيير الذي يضاعف زمن الاستجابة p90 لا يمر دون قرار متعمد. أما الارتفاعات في تكلفة الرموز (tokens) فتُرصد قبل أن تتراكم على نطاق واسع. كل تشغيل للحارس ينشر درجاته في CloudWatch كمقاييس مخصصة إلى جانب درجات الجودة، حيث يُرسَل زمن الاستجابة والتكلفة لكل استعلام ومعدل نجاح السلامة بعد كل تشغيل، وتُضبَط تنبيهات CloudWatch لتُطلق إذا اخترق أي مقياس عتبة المرحلة 1 الخاصة به. كما يُسجَّل ويُخزَّن كل تشغيل، فيغذّي مسار التدقيق الذي تعتمد عليه المرحلة 8 والمرحلة 9. نحن نحتفظ بحارس منفصل عند كل مستوى: الأداة، والوكيل، والوكلاء المتعددين. فالتغيير الذي يحسّن جودة مستوى الوكيل لكنه يُدهور أداة حرجة يحجب كذلك. ويُراجع الحارس شهريًا، وأي انحدار يفلوت إلى الإنتاج يُرقّى فورًا إلى حالة دائمة حتى لا يصل إلى المستخدمين مرتين.
مثال واحد على ما يكشفه هذا النظام. بعد تحديث لتطبيع البيانات، بدأت أداة ازدواج المعاني تُرجع كيانات غير محلولة لمجموعة فرعية من تنسيقات أسماء الحسابات. استجاب الوكيل، عند تلقيه كيانًا غير محلول، بأفضل تخمين مطابق، فأعاد بيانات حقيقية للعميل الخطأ. يتضمن حارسنا على مستوى الأداة بالضبط هذه الفئة من الحالات الحدّية: فشل فحص الحقيقة المرجعية لحل الكيان بالنسبة لتنسيقات أسماء الحسابات المتأثرة، وحُجبت عملية النشر تلقائيًا. لم يصل التغيير إلى الإنتاج أبدًا.
المرحلة 4: البوابة (CD). انشر بثقة كمية
يغطي الحارس 15 حالة. أما الإنتاج فيغطي عشرات الآلاف من أنماط الاستعلام عبر مئات أنواع الحسابات والجغرافيات وشرائح البائعين. اجتياز الحارس أمر ضروري. لكنه ليس كافيًا.
قبل نشر المرشّح، نُشغّل AgentCore On-Demand Evaluation على المجموعة الذهبية الكاملة عبر أبعاد المُقيّم. ونسمي هذا بوابة الجودة. وهي تستبدل عبارة "يبدو جيدًا" بقرار نشر كمي.
التنفيذ المعزول ومحاكاة الأدوات. فكّر فيها كإعادة تشغيل مسجّلة، وليس استدعاءً حيًا. مسبقًا، نجمّد مجموعة بيانات معروفة ومُرقّمة الإصدارات من السلوك الصحيح للأدوات. كل استدعاء أداة يجريه المرشّح أثناء الفحص يُعترض ويُجاب عليه من مجموعة البيانات المجمّدة تلك بدلًا من نظام حقيقي. نبني مجموعة البيانات المجمّدة تلك في خطوتين. أولًا، نختبر كل أداة على حدة: نرسل إليها مجموعة مدخلات محتجزة من مجموعتنا الذهبية حيث الإجابة الصحيحة معروفة سلفًا، ونقوّم ما تُرجعه فعليًا مقابل تلك الإجابة المعروفة. يخبرنا هذا ما إذا كانت الأداة نفسها تعمل (حل الكيان، الاسترجاع، توليد SQL) قبل إشراك الوكيل أصلًا. ثانيًا، بعد تأكيد صحة استجابات الأداة، نجمّد تلك الإجابات المتحقق منها نفسها في مجموعة بيانات إعادة التشغيل التي يراها الوكيل أثناء تقييم البوابة. هذا يعني أن الوكيل يُختبر بحتة على قدرته الاستدلالية الخاصة، وليس على سرعة الأدوات أو توفرها الحي، ولأن كل مرشّح يعيد التشغيل من مجموعة البيانات المجمّدة نفسها، فإن أي فرق في الدرجات وجهاً لوجه يعود إلى الوكيل، لا إلى تباين الأدوات.
التقييم الكلي من البداية إلى النهاية. تُجري البوابة أيضًا تمرينًا شاملاً: يجيب الوكيل المرشّح الكامل على 200 سؤال محتجز من البداية إلى النهاية، بتقييم معيار LLM-as-judge عبر جميع أبعاد المُقيّم. أي واحد من ثلاثة شروط يُغلق البوابة تلقائيًا: أن يتراجع الدرجة الإجمالية مقارنة بالتشغيل السابق للمرشّح نفسه، أو أن يفشل في تفوّقه على خط الأساس الحالي في الإنتاج، أو أن تتجاوز نسبة معرّفة من الأسئلة الـ200 العتبة المحددة لكل سؤال نزولًا. يجب على المرشّح اجتياز الشروط الثلاثة جميعًا، وهو ما يكشف ما يمكن أن يخفيه المتوسط البسيط: فالنموذج الذي يحسّن المتوسط بينما يفشل بصمت في حصة أكبر من الأسئلة الفردية لا يجتاز.
مثال واحد على ما يكشفه هذا النظام. هنا يختبر المحاكاة قدرة الوكيل الاستدلالية الخاصة، لا الأدوات تحته فقط. تتضمن مجموعتنا الذهبية حالة عدم تطابق هرمي: يعيد وكيل رؤى العملاء (Customer Insights Agent) ووكيل رؤى البيانات (Data Insights Agent) رقمي إيرادات مختلفين، وكلاهما صحيح فرديًا، لنفس العميل، أحدهما لنطاق الحساب الأم والآخر لشركة تابعة. لا رقم منهما خاطئ. تختبر الحالة ما إذا كان الوكيل يستنتج النطاق الصحيح من دلالات الاستعلام وشخصية الطالب (البائع غالبًا يريد الشركة التابعة، بينما استعلام القيادة غالبًا يريد التجميع للأم)، بدلًا من اللجوء إلى الخيار الافتراضي أو المتوسط أو مطالبة البائع بتوضيح الغموض. اجتاز المرشّح الفشل، فأعاد الرقم على مستوى الأب لسؤال نطاقه الشركة التابعة. تُحدد الحقيقة المرجعية للمجموعة الذهبية لهذه الحالة النطاق الذي يتوقعه السؤال، فأشارت بوابة الجودة فورًا إلى عدم التطابق: ليس رقمًا خاطئًا، بل الرقم الصحيح للنطاق الخطأ.
المرحلة 5: الكناري. كشف الإخفاقات الصامتة بعد النشر
المرحلة 5 هي مراقب ما بعد الإنتاج. تعمل باستمرار في بيئة الإنتاج مقابل الحركة الحية وحالات التقييم الاصطناعية، ومهمتها كشف المشكلات التي لم تُسبِبها أي تغيير في الشيفرة ولذلك لم ترها المرحلة 3. تحمي المرحلة 3 مما يغيّره المهندسون. وتحمي المرحلة 5 من كل شيء آخر، مثل تحولات البيانات في المنبع، أو تطور سلوك النموذج، أو تغييرات في الاعتماديات الخارجية، أو ظروف أخرى مثل زيادة زمن الاستجابة أو تحول أنماط الحركة التي تتجلى فقط تحت الحمل الواقعي.
يعمل المنتج على منصة بيانات تتغذى من آلاف المخططات (schemas) وخطوط البيانات المنبعثة. في يوم معين، تتحدث عشرات من هذه الخطوط دون أن يؤدي ذلك إلى تشغيل نشر أو بوابة CI. يبقى كود الوكيل دون تغيير، ويبقى النموذج دون تغيير، لكن البيانات التي يقوم بالاستدلال عليها قد تغيّرت، ويمكن أن تتدهور الجودة بصمت نتيجة لذلك. تعلمنا هذا بطريقة صعبة: تحدّث خط بيانات منبعث مع تغيير في المخطط، فبدأ الوكيل في الاستشهاد ببيانات من إطار زمني خاطئ، ووصلت أول إشارة عبر استفسار من بائع بدلاً من تنبيه آلي. المرحلة 5 هي كيف نكتشف هذا خلال نافذة التقييم الأولى البالغة 30 دقيقة بدلاً من ذلك.
نُشغّل AgentCore Batch Evaluation وفق جدولين متكاملين، وكان اختيار الإيقاع الزمني مقصوداً.
استقررنا على دورات مدتها 30 دقيقة بعد التعلم من الاتجاهين: 15 دقيقة أنتجت عدداً كبيراً جداً من الإنذارات الكاذبة؛ و60 دقيقة سمحت بمرور ساعتين قبل تسجيل تدهور حقيقي. نسمي كل دورة مدتها 30 دقيقة نافذة تقييم. تكشف الثلاثون دقيقة عن اتجاه حقيقي خلال 90 دقيقة (ثلاث نوافذ متتالية) مع ترشيح الضوضاء الناتجة عن استعلام واحد. تسجّل كل نافذة درجات لاختيار دوري (round-robin) عبر المجموعة الذهبية، مما يوفر تغطية كاملة خلال 24 ساعة.
الحدود المسموحة منخفضة عمداً مقارنة ببوابات CI/CD. فشل نافذة واحدة هو إشارة تشغيلية، وليس حادثاً. لا نستدعي المهندس المناوب (oncall) إلا بعد خرق ثلاث نوافذ متتالية للحدود. تعلمنا هذه القاعدة بطريقة صعبة: في الشهر الأول استخدمنا حدّاً لنافذة واحدة، فتوقف المناوب تماماً عن الثقة بالنظام. مرة واحدة يومياً، تُشغّل المجموعة الذهبية الكاملة عند حدود البوابة باعتبارها بطاقة الأداء اليومية الموثوقة. النوافذ ذات 30 دقيقة تكشف الاتجاه. التشغيل اليومي يؤكده وينشئ تذكرة.
تنشر كل عملية تشغيل إلى CloudWatch (الدقة، معدلات الهلوسة، معدل التأسيس، زمن الاستجابة، والتكلفة)، مع منطق إنذارات يميز بين الإيقاعين الزمنيين. يعمل الاختبار التجريبي (canary) على ثلاثة مستويات: درجات مستوى الأدوات تكشف عن أداة استرجاع متدهورة قبل أن تلوث استجابات مستوى الوكيل.
مثال آخر على ما يكشفه هذا. بعد تحديث لفهرس منبعث، بدأت أداة استرجاع في إرجاع أجزاء (chunks) ذات صلة فضفاضة بدلاً من السياق الدقيق اللازم للإجابة على الاستعلام. كان زمن الاستجابة طبيعياً. وكان معدل الأخطاء صفراً. واصل الوكيل إنتاج استجابات سلسة وواثقة من خلال الاستدلال على سياق ضعيف التأسيس، منتجاً إجابات تبدو صحيحة لكنها تستشهد بأرقام خاطئة. لم يُطلق أي إنذار من البنية التحتية. اكتشفه الاختبار التجريبي في نافذة 30 دقيقة الأولى: انخفض معدل التأسيس ودقة الاسترجاع عبر الحارس على مستوى الأداة، مما أطلق إنذار CloudWatch قبل أن يتصرف البائعون بناءً على الإجابات المتدهورة. أشارت درجة المُقيِّم المنخفضة إلى الأثر (trace) المسؤول بدقة. من هناك، فتح المهندس المناوب ذلك الأثر في AgentCore وتتبّع السياق المتدهور عائداً إلى أداة الاسترجاع في غضون دقائق.
المرحلة 6: الخصم. الحماية من سوء الاستخدام
ليست كل المخرجات السيئة ناتجة عن نموذج متدهور. فالاستعلامات المصممة لاستخراج بيانات حساب غير مصرح بها، وحقن الأوامر (prompt injections) المضمنة في المستندات المسترجعة، هي أنماط يمكن التنبؤ بها في نظام يخدم آلاف المستخدمين على بيانات أعمال حساسة.
السلامة ليست مرحلة. إنها تسري عبر جميع المراحل التسع. نطبق Amazon Bedrock Guardrails في نقطتين في كل تفاعل. عند الإدخال، نتحقق من نطاق الاستعلام ونفحص وجود حقن الأوامر. عند الإخراج، نتحقق من عدم كشف أي بيانات حساسة لمستخدمين غير مصرح لهم ومن أن الوكيل لم يُتلاعب به بما يؤدي إلى انتهاك سياسة. تُنفَّذ هذه الفحوصات على 100 بالمائة من حركة المرور، بشكل متزامن، قبل أن تصل الاستجابة إلى المستخدم.
نُهيّئ طبقتين من الحواجز الوقائية، تغطي كل منهما فئة تهديد مختلفة:
مرشحات المحتوى تكشف وتحجب المحتوى الضار أو غير اللائق في المدخلات والمخرجات معاً. نطبّق المرشحات عبر فئات تشمل VIOLENCE, HATE, SEXUAL, MISCONDUCTو INSULTS. يُحجب أي طلب أو استجابة يستدعي هذه المرشحات قبل أن يصل إلى البائع أو يُعرض على المستخدم.
مرشحات أمان الأوامر تحمي الوكيل من التلاعب العدائي ضمن فئة حاجز وقائي واحدة PROMPT_ATTACK تغطي ثلاثة أنواع فرعية: JAILBREAK (محاولات لتجاوز تعليمات النظام الخاصة بالوكيل أو التحايل على حدود التشغيل الخاصة به)، PROMPT_INJECTION (تعليمات غير مقصودة مضمنة في مستندات مسترجعة أو مخرجات أدوات أو استعلامات مستخدمين)، و PROMPT_LEAKAGE (محاولات لاستخراج أمر النظام أو الإعداد الداخلي). في نظام متعدد الوكلاء يستخدم التوليد المعزز بالاسترجاع (RAG)، يشكل حقن الأوامر عبر المحتوى المسترجع خطراً حقيقياً. فمستند غير مقصود في بيانات حساب بائع قد يحاول إعادة توجيه سلوك الوكيل في منتصف الاستدلال.
تُعرَّف قواعد السلامة في المرحلة 1، وتُفحص للكشف عن التراجعات في المرحلتين 3 و4، وتُطبَّق باستمرار في الإنتاج.
المرحلة 7: الانحراف. الحفاظ على الجودة والتحقق بحركة المرور الحية
تتدهور الجودة من اتجاهات متعددة: تغيّر البيانات المنبعثة دون أن يؤدي إلى تشغيل نشر، وتصبح النماذج قديمة، ويدفع المستخدمون بالحدود عبر استعلامات لا تتوقعها أي مجموعة ذهبية بشكل كامل. تكتشف المرحلة 7 ذلك قبل البائعين، وتتحقق من المرشحين مقابل حركة مرور المستخدمين الحقيقية قبل الطرح الكامل.
كشف الانحراف. باستخدام AgentCore Online Evaluation، نأخذ عينة من 10 بالمائة من حركة المرور الحية باستمرار عبر المُقيِّمات المختلفة المحددة في المرحلة 1، بحيث يصبح الانحراف مرئياً فوراً كانحراف عن الخطوط الأساسية المحددة دون اتصال. تتغذى الدرجات في حاسبة حالة الجودة (Quality-State Calculator) التي تراقب الجودة وزمن الاستجابة والتكلفة في النافذة نفسها.
مثال من الإنتاج. تم بناء المجموعة الذهبية لدينا للتعرف على العملاء من حالات حدية اصطناعية: تنويعات الأسماء، والبحث عن الشركات التابعة، والاختصارات. أدّت جيدًا في الاختبار دون الاتصال. لكن في حركة المرور الفعلية، استعلم البائعون برموز تيكر للأسهم («ما الذي يحدث مع AMZN؟»)، وأسماء مختصرة، وأخطاء إملائية لم تختبرها الحالات الاصطناعية. أظهر حاسبة حالة الجودة هذا الانحراف عبر ثلاث نوافذ متتالية مدة كل منها 30 دقيقة: 98 بالمئة في الساعة 1:30 فجرًا، ثم 81 بالمئة في الساعة 2:00 فجرًا، ثم 80 بالمئة في الساعة 2:30 فجرًا. قام CloudWatch بالاتصال بالمناوب عند تجاوز العتبة المتحركة. واستعلم المهندس المناوب الوكيل: «ماذا حدث لدقة التعرف على العملاء بين الساعة 1 صباحًا والساعة 3 صباحًا؟» وتلقى ملخصًا للاتجاه يحدد عمليات البحث برموز التيكر والأسماء المختصرة كسبب رئيسي للفشل. جعل تتبع الوكيل السبب الجذري مرئيًا فورًا. الحل: توسيع المجموعة الذهبية بجلسات الدردشة الفعلية منخفضة الدرجات، وتحديث أداة التوضيح لتوحيد صيغ المدخلات قبل الحل. تعافت الدقة إلى المستوى الأساسي ضمن دورة التقييم التالية.
تغذي حركة المرور الفعلية حلقتي تحسين مستمرتين: تتم ترقية الجلسات منخفضة الدرجات إلى المجموعة الذهبية كحالات حدية جديدة، وتُعلم عناقيد التتبعات منخفضة الدرجات مراجعات المطالبات وتحديثات الأدوات وتعديلات التوجيه.
اختبار A/B: بعد اجتياز مرشح لبوابة جودة، يقوم AgentCore Gateway، وهي إمكانية من Amazon Bedrock AgentCore، بتوجيه شريحة من حركة المرور الفعلية بين الوكلاء الحالي والمرشح. ويؤكد الاختبار عند الطلب عدم وجود تراجع في الحالات المعروفة. ويؤكد الاختبار عبر الإنترنت صموده أمام المدخلات طويلة الذيل والصياغات الجديدة التي ينتجها المستخدمون الحقيقيون فقط. يجب أن يفوز المرشح أو يتعادل عبر جميع أبعاد المقيّم قبل الطرح الكامل.
المرحلة 8: النبض. الرؤية الفورية للجودة
استدعاء واحد للوكيل قد يمس ثلاثة وكلاء فرعيين وخمس أدوات ومسارَي استرجاع. عند انطلاق إنذار جودة، فإن عبارة «شيء ما في خط أنابيب الوكيل» ليست دليل تشغيل. المرحلة 8 هي حيث تتقارب الإشارات من المراحل 5 و6 و7 في طبقة رصد ذات دقة كافية للتصرف.
يمثل AgentCore Observability، وهو إمكانية من Amazon Bedrock AgentCore، الأساس. بالنسبة للوكلاء المستضافين على بيئة تشغيل AgentCore، وهي إمكانية من Amazon Bedrock AgentCore، يتم قياس كل عملية تنفيذ تلقائيًا عبر OpenTelemetry، مع إصدار قياسات تتبع منظمة لكل خطوة استدلال: الأدوات المستدعاة، والترتيب، والمدخلات والمخرجات، و زمن الاستجابة، واستهلاك الرموز، تُنشر مباشرة إلى CloudWatch كمقاييس وسجلات مخصصة، بعد تمكين CloudWatch Transaction Search (خطوة إعداد لمرة واحدة). درجات المقيّم تتبع خط أنابيب منفصلًا: فهي تأتي من إعدادات التقييم، لا من قياس التنفيذ، وتستقر في مجموعة سجلات CloudWatch خاصة بها. كما تحفظ كل دورة تقييم مخرجاتها الكاملة في S3 وفي بحيرة بياناتنا، لتغذية لوحتي تحكم:
- لوحة تحكم تحادثية للاستعلام عن نتائج التقييم والرصد.
- لوحة تحكم من Amazon Quick لتحليل الاتجاهات، وتتبع بطاقات الأداء، والمقارنات عبر الوكلاء على مدى التاريخ الكامل.
توضع فوقها مشاهدات مناسبة لكل دور. يحصل مهندسو المناوب على مشهدة تتبع أولاً: نقرة واحدة من إنذار CloudWatch إلى تتبع AgentCore Observability الذي تسبب فيه. يعرض التتبع كل أداة مستدعاة، وبأي ترتيب، مع زمن الاستجابة لكل خطوة، واستهلاك الرموز، والتكلفة، وسياق الاستدلال الكامل: كل ما يلزم للانتقال من «انطلاق الإنذار» إلى «تحديد السبب الجذري» دون فتح أداة ثانية، كما هو موضح في الشكل 5.
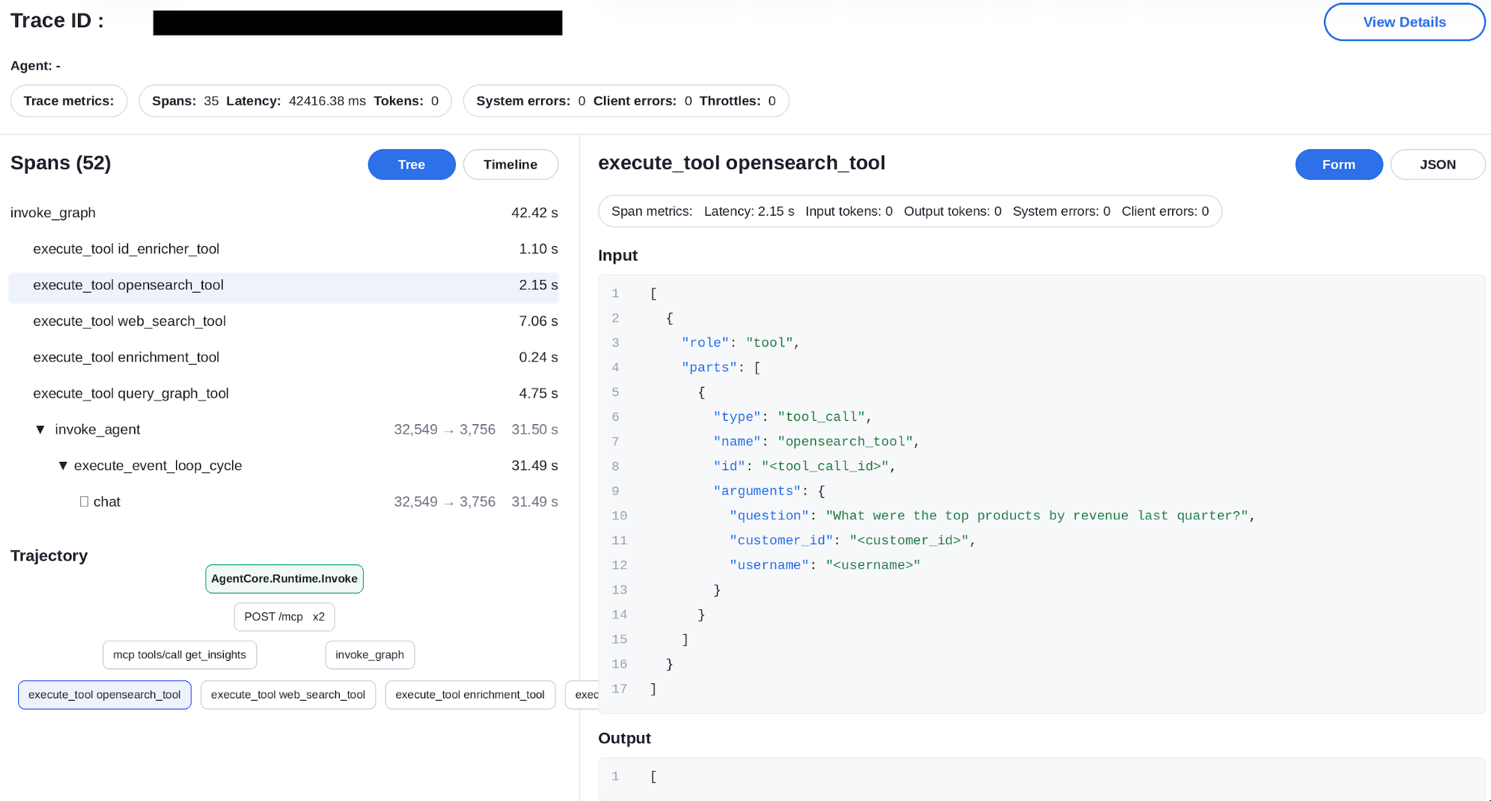
الشكل 5: تتبع تنفيذ AgentCore لوكيل رؤى العملاء (Customer Insights Agent)، يعرض شجرة الامتدادات والمسار ومقاييس مستوى الامتداد. الأرقام والقيم في الشكل توضيحية.
يحصل مديرو المنتجات على لوحات تحكم اتجاهات من Amazon Quick: درجات الجودة حسب الوكيل الفرعي والميزة، من إصدار إلى آخر. ويحصل القيادة على ملخص صحة من صفحة واحد متوافق مع المراجعات الأسبوعية والعابرة للأعمال عبر الأبعاد الخمسة جميعها، وهو فحص سريع يستغرق دقيقة واحدة يجيب على سؤال «كيف يؤدي وكلاؤنا؟»
يعرض الشكل 6 المشهدة العلوية للوحة تحكم التقييم الأسبوعية لدينا: معدل نجاح مدمج واحد مستمد من المقيّمين المخصصين ومقيّمات AgentCore المدمجة، إلى جانب زمن الاستجابة، لتشغيل الأسبوع. الأرقام والقيم في الشكل توضيحية.
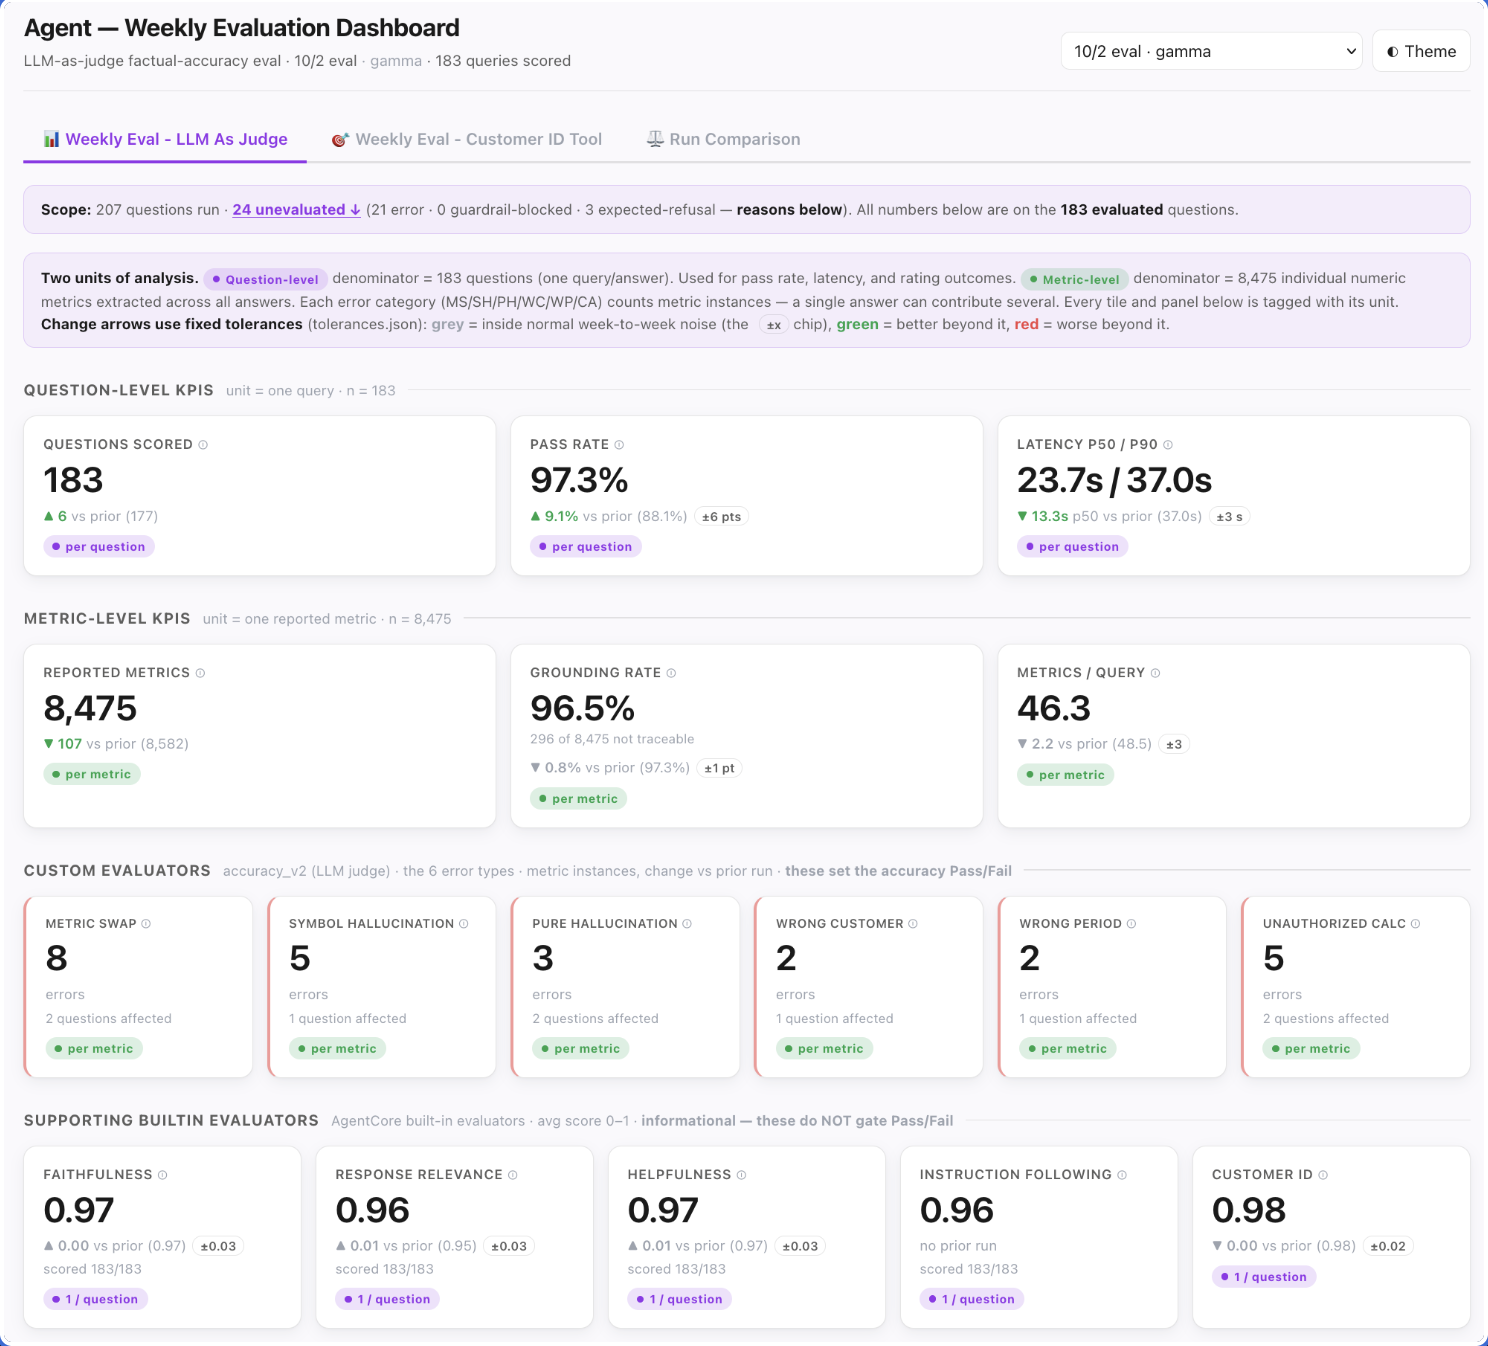
الشكل 6: لوحة تحكم التقييم الأسبوعي العلوية مع معدل النجاح المدمج وزمن الاستجابة. الأرقام والقيم في الشكل توضيحية.
يتعمق الشكل 7 في التشغيل نفسه على مستوى المقيّم المخصص وفئة الفشل، مفصّلاً بدقة أنواع الأخطاء التي تسبب الفجوة (تبديل المقاييس، والهلوسات، وإخفاقات تعريف العميل، وغيرها) وعدد الأسئلة التي يؤثر عليها كل منها. الأرقام والقيم في الشكل توضيحية.
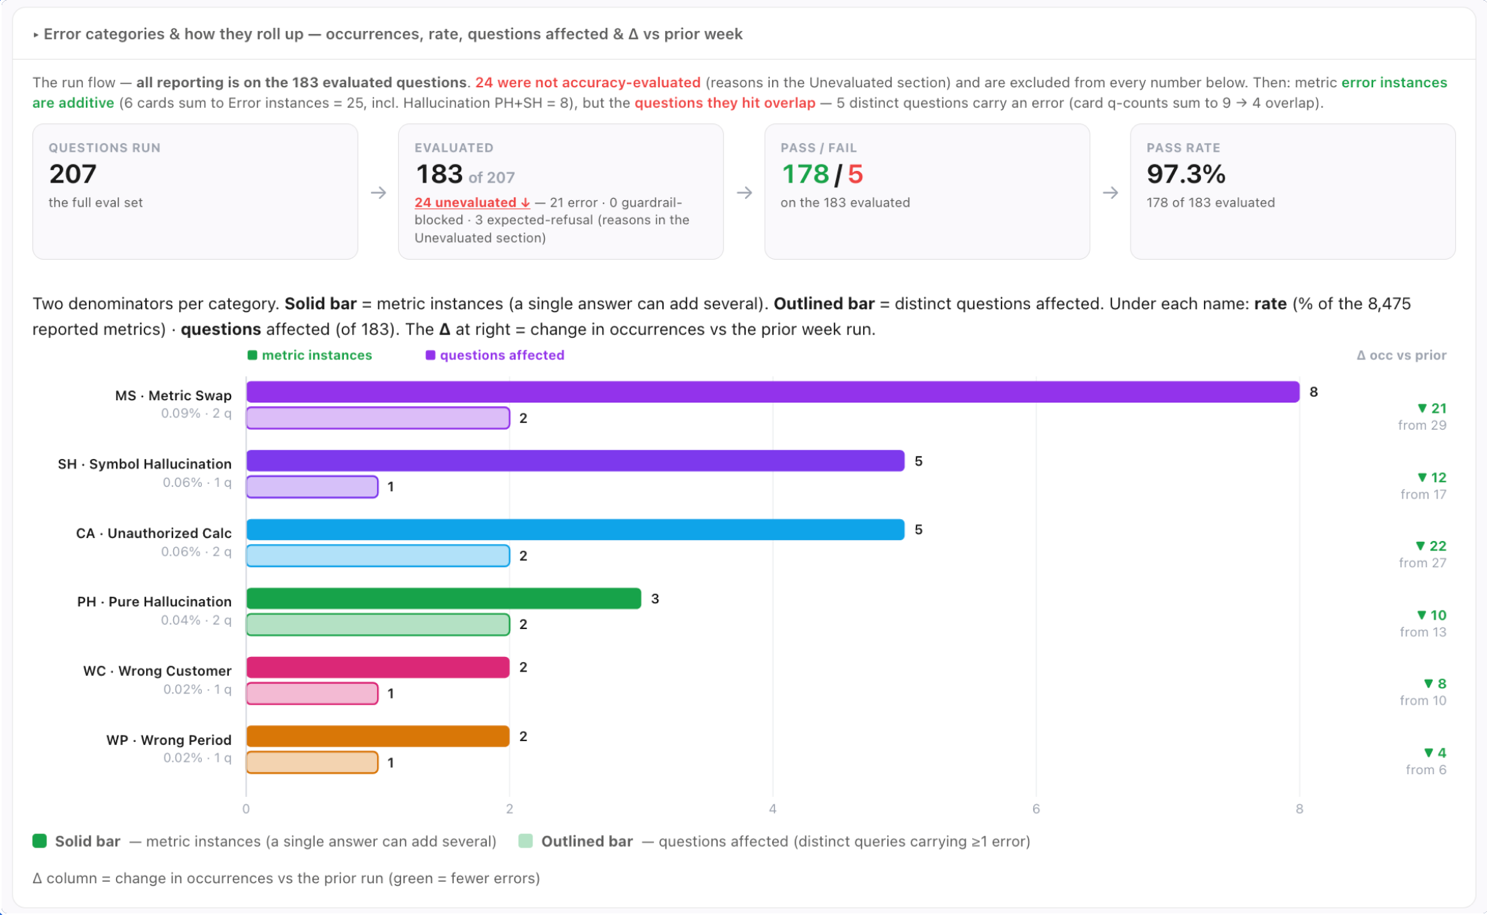
الشكل 7: لوحة تحكم تقارير الأخطاء الأسبوعية تفصّل حالات الفشل حسب الفئة. الأرقام والقيم في الشكل توضيحية.
قبل المرحلة 8، كان متوسط زمن الكشف (MTTD) يمتد من أيام إلى أسابيع. وبعد المرحلة 8، أصبح أقل من أربع ساعات، والإشارة الأولى هي إنذار CloudWatch مرفق به تتبع AgentCore.
المرحلة 9: حلقة التغذية الراجعة. التحسين المستمر
تحوّل هذه المرحلة الملاحظات إلى أفعال. النظام يراكم الجودة بمرور الوقت. نستخدم AgentCore optimization، وهي إمكانية من Amazon Bedrock AgentCore، لإغلاق الحلقة.
- توصية مطالبة النظام: تحلل تتبعات الوكيل وتولّد مطالبة نظام محسّنة قائمة على البيانات تحسّن الأداء على المقيّم المستهدف. يستخدم الحل أنماط الفشل ويضيف تعليمات سلوكية محددة.
- توصية وصف الأداة: تحلل تتبعات الوكيل وتولّد أوصاف أدوات مصقولة تقلل الالتباس في اختيار الأدوات. خصوصًا عندما يختار الوكيل الأداة الخاطئة للطلبات الغامضة.
لنلقِ نظرة على مثال:
AgentCore optimization في الواقع العملي
ما يجب تحسينه:
المقيّم المستهدف: الهلوسة: قيام النموذج بإعادة إنتاج القيم المضمّنة في الكود من أمثلة few-shot حرفيًا في سياقات غير ذات صلة.لماذا حدث ذلك: تحتوي أمثلة few-shot على مبالغ دولارية حقيقية وأسماء عملاء (على سبيل المثال، "$4.2M"، "Acme Corp") يحفظها النموذج ويكشفها في استعلامات غير ذات صلة.
كيفية الإصلاح: استبدل القيم المكتوبة بشكل ثابت في أمثلة few-shot بعناصر نائبة عامة (على سبيل المثال،
$[AMOUNT],[CUSTOMER_NAME]) حتى يتعلم النموذج بنية الاستجابة دون حفظ نقاط بيانات محددة.التأثير والنتيجة: تم تطبيق الإصلاح. انخفضت حالات الهلوسة الخالصة من 138 إلى أقل من 52 لكل 10,000 استجابة، وتحسن معدل الارتكاز الإجمالي من 93 في المئة إلى 96 في المئة.
يستخدم تحسين AgentCore التوصيات لإنتاج تغييرات في موجه النظام ووصف الأدوات تعتمد على البيانات، بناءً على آثار وكلاء حقيقية ومقيّم مستهدف. يستند تحسين AgentCore إلى AgentCore Evaluations . تتم ترقية الآثار ذات الدرجات المنخفضة إلى المجموعة الذهبية كحواجز انحدار دائمة حتى لا يصل كل فشل إلى المستخدمين مرتين.
المقاييس الرئيسية لتقييم الوكلاء في لمحة
يتم تعريف مقاييس التقييم في المرحلة 1، وتُطبَّق عبر المراحل التسع، وتُراقَب بشكل مستمر في الإنتاج. هذه المجموعة ليست ثابتة. بينما نتعلم من الوكيل في الإنتاج، تظهر أنماط فشل جديدة، وتصبح أبعاد جديدة قابلة للقياس، وتتطور المقاييس تبعًا لذلك. ما يلي هو نقطة البداية وما نتتبعه اليوم.
| المستوى | المقياس | ما يقيسه | يُتتبَّع كـ |
| الجودة: الوكيل | معدل اجتياز الدقة الإجمالية | % من الاستجابات الخالية من حالات فشل التصنيف | المقياس الرئيسي في بطاقة الأداء |
| الجودة: الوكيل | معدل تبديل المقاييس | العميل والفترة صحيحان، لكن المقياس المُعاد خاطئ | حالات لكل 100 استجابة |
| الجودة: الوكيل | معدل الفترة الخاطئة | بيانات من إطار زمني خاطئ | % تستشهد بإطار زمني صحيح |
| الجودة: الوكيل | معدل العميل الخاطئ | أسماء حسابات أو شركات تابعة مختلطة | دقة تحليل الكيانات % |
| الجودة: الوكيل | معدل الاستناد | أرقام قابلة للتتبع إلى مصدر مسترجع | نسبة الأرقام المُبلغ عنها المستندة إلى مصدر |
| الجودة: الوكيل | معدل الالتزام بالنطاق | الإجابات التي تعالج السؤال المطروح | % الإجابات المتعلقة بالموضوع |
| الجودة: الوكيل | معدل الحسابات غير المصرح بها | الأرقام المشتقة غير المعتمدة | الحالات لكل 100 إجابة |
| الجودة: الوكيل | الملاءمة / الوفاء / الفائدة | جودة الإجابة وفق أبعاد AgentCore المدمجة | درجة مقيّم AgentCore المدمج (0–1) |
| الجودة: الأداة | دقة تحديد هوية العميل | الأداة تصل إلى الكيان المرجعي الصحيح تمامًا | % الحلول الصحيحة (حتمية) |
| الجودة: الأداة | دقة اختيار الأداة | يختار الوكيل الأداة الصحيحة للاستعلام | درجة مقيّم AgentCore المدمج (0–1) |
| الجودة: الأداة | دقة الاسترجاع | السياق المسترجع يحتوي على المعلومات المطلوبة | % حالات الاسترجاع ذات السياق ذي الصلة |
| الجودة: الأداة | دقة توليد SQL | يولّد وكيل رؤى البيانات SQL صحيحًا | % مجموعات النتائج الصحيحة (حتمية) |
| الجودة: الأداة | معدل نجاح الأداة | % استدعاءات الأداة التي تُعيد استجابة صالحة | % النجاح لكل أداة |
| الجودة: تعدد الوكلاء | معدل نجاح الدقة من البداية إلى النهاية | مسار التنسيق الكامل ينتج استجابة صحيحة | % من السيناريوهات الناجحة في جميع المقيمين |
| الجودة: تعدد الوكلاء | دقة التوجيه | ينسّق المنسّق التوجيه إلى الوكيل الفرعي (الوكلاء الفرعيين) الصحيح | % توجيه صحيح (حتمي) |
| الجودة: تعدد الوكلاء | أمانة التركيب | دمج مخرجات الوكلاء الفرعيين دون تشويه | درجة LLM-as-judge عبر حدود الوكلاء |
| الجودة: تعدد الوكلاء | دقة نشر السياق | السياق المنقول بين الوكلاء صحيح وكامل | % من المسارات بدون فقدان سياق |
| السلامة | معدل حجب الحواجز الوقائية | % من الطلبات المحجوبة عند المدخلات أو المخرجات | لكل 1,000 طلب |
| السلامة | معدل انتهاك المدخلات / المخرجات | % من الاستعلامات أو الاستجابات المحددة كمخالفة للسياسة | % من إجمالي الطلبات / الاستجابات |
| السلامة | زمن استجابة الحواجز الوقائية | الزمن الإضافي المضاف بواسطة فحوصات الحواجز الوقائية | p99 (الهدف: أقل من 50ms) |
| الأداء | زمن الاستجابة من البداية إلى النهاية | من استلام الاستعلام إلى تسليم الاستجابة | p50، p90، p99 |
| الأداء | زمن الاستجابة لكل وكيل فرعي / أداة | لكل وكيل فرعي ولكل تنفيذ لأداة | p50 وp90 وp99 بشكل مستقل |
| الأداء | معدل تراجع زمن الاستجابة | تشغيلات CI التي تتجاوز عتبة زمن الاستجابة للمرحلة 1 | % من تشغيلات CI |
| التكلفة | التكلفة لكل استعلام | إجمالي تكلفة الرموز (tokens) لكل طلب مستخدم من البداية إلى النهاية | رموز الإدخال + الإخراج × السعر |
| التكلفة | التكلفة لكل استجابة ناجحة | التكلفة لكل استعلام مقسومة على معدل النجاح | يعاقب على الإخفاقات المكلفة |
| التكلفة | متوسط استدعاءات الأدوات لكل استعلام | كفاءة الاستدلال. ارتفاع عدد الاستدعاءات يشير إلى تدهور | المتوسط لكل استعلام |
| التحكم التشغيلي | MTTD / MTTR | الوقت لاكتشاف الأعطال ومعالجتها، حسب فئة كل عطل | ساعات (الهدف لـ MTTD: أقل من 4 ساعات) |
| التحكم التشغيلي | معدل الكشف الآلي | الحوادث التي يتم اكتشافها بواسطة التقييم مقارنةً بشكاوى المستخدمين | % (الهدف: أكثر من 95%) |
| التحكم التشغيلي | معدل الإنذارات الكاذبة | الإنذارات التي لا تقابلها حالات تدهور حقيقية | % من إجمالي الإنذارات |
الخلاصة
كان تأثير إطار التقييم ذي المراحل التسع للوكلاء ملموساً وقابلاً للقياس. حالات تراجع الجودة التي كانت تستغرق في السابق أياماً أو أسابيع لتظهر، وغالباً ما تصل عبر شكوى من بائع، يتم اكتشافها اليوم في أقل من أربع ساعات بواسطة التقييم الآلي. قرارات النشر التي كانت تعتمد يوماً ما على الحكم الذاتي تتطلب الآن اجتياز كل مقيّم لعتبة كمية. انخفضت دورات تكرار المطالبات (prompts) من أيام إلى دقائق. وانتقلت السلامة من عمليات تدقيق دورية إلى تغطية 100 percent بضوابط الحماية على كل طلب. يتم اكتشاف تراجعات زمن الاستجابة عند بوابة CI قبل وصولها إلى بيئة الإنتاج. والمفاجآت المتعلقة بالتكلفة التي كانت تظهر بعد أسابيع في الفواتير يتم الآن تقييمها في المرحلة الثانية ويتم فرضها عبر بوابة الجودة قبل شحن أي تغيير. وأصبح "شيء ما في خط أنابيب الوكيل" على بُعد نقرة واحدة من إنذار في CloudWatch إلى تتبع كامل لتنفيذ الوكيل مع إظهار كل خطوة استدلالية.
الدرس الأوسع هو درسٌ تعلّمه القطاع من قبل. علّمتنا DevOps أن شحن الكود بدون اختبارات مؤتمتة أمر متهوّر. علّمتنا MLOps أن نشر النماذج بدون مراقبة أمر خطير. وتعلّمنا AgentOps الشيء نفسه حول وكلاء الذكاء الاصطناعي: تشغيلهم بدون تقييم مستمر ومتعدد المستويات يعني الطيران دون رؤية.
الإطار ذو المراحل التسع الموصوف هنا ليس خاصاً بوكلاء استخبارات المبيعات. أي فريق ينشر أنظمة متعددة الوكلاء تستدلّ، وتستدعي وكلاء فرعيين وأدوات، وتركيب الاستجابات، سيواجه الأسئلة نفسها عبر دورة الحياة نفسها. ستختلف تصنيفاتك للأعطال، وستعكس مجموعة الاختبار الذهبية مجالك، وسيضبط كومة المقيّمات لديك وفق مستخدميك. ما يبقى ثابتاً هو المبدأ: التقييم ليس خطوة ضمان جودة نهائية، بل هو نظام التشغيل للوكيل نفسه، يُقاس باستمرار، ويُدافَع عنه آلياً، ويُحسَّن مع كل تفاعل.
إذا كنت تبني وكلاء إنتاجيين وترغب في إحضار هذا النوع من انضباط التقييم إلى نظامك، فإن Amazon Bedrock AgentCore Evaluations يمنحك المنصة لذلك: تقييم عند الطلب للتجارب، وتقييم دفعي للمراقبة المستمرة، وتقييم عبر الإنترنت لحركة المرور الحية، ومقيّمات مدمجة ومخصصة، وتقييم مجموعات البيانات (في المعاينة العامة)، وتكامل مع CloudWatch، وميزات التحسين في AgentCore من توصيات واختبارات A/B لإغلاق حلقة التغذية الراجعة. ابدأ بالمرحلة الأولى، وحدّد كيف يبدو الأداء الجيد لوكيلك، ودع الإطار يتولى الباقي.
هل أنت مستعد للبدء؟ راجع Evaluate agent performance في وثائق Amazon Bedrock AgentCore. وإذا كنت تبني وكلاء إنتاجيين وترغب في مناقشة كيفية تطبيق هذا الإطار على نظامك، فنحن سعداء بالماعدة. تواصل معنا مباشرة أو عبر فريق حساب AWS الخاص بك.
لمعرفة المزيد عن Amazon Bedrock AgentCore Evaluations، راجع Evaluate agent performance في وثائق AWS. وللحصول على مقدمة تقنية، اقرأ Build reliable AI agents with AgentCore Evaluations. لمعرفة كيف بنينا وكيل Performance Insights Agent، اقرأ كيف تستخدم AWS SMGS مساعدًا محادثاتيًا مدعومًا بالذكاء الاصطناعي لتحويل إدارة الأعمال باستخدام Amazon Bedrock AgentCore. لمعرفة المزيد عن التوصيات والتحسين في AgentCore، اقرأ تحسين AgentCore: تحسين حلقة جودة الوكيل من خلال التوصيات واختبارات A/B
شكر وتقدير
نوجه خالص شكرنا وامتناننا إلى رعاتنا التنفيذيين وموجّهينا الذين جعلت رؤيتهم وتوجيهاتهم هذه المبادرة ممكنة: Damien Forthomme، مدير III، العلوم التطبيقية؛ Akhand Singh، رئيس هندسة البيانات؛ Sujit Narapareddy، مدير AWS Insights؛ Monica Jain، مدير منتجات أول – التقنية، و Norman Braddock، مدير أول لإدارة منتجات الذكاء الاصطناعي في AWS؛ Muhammad Umar Javed، عالم تطبيقي III، المستوى L6.