
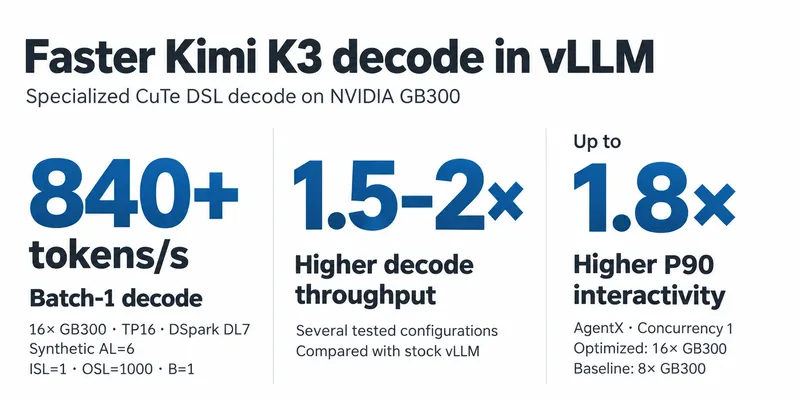
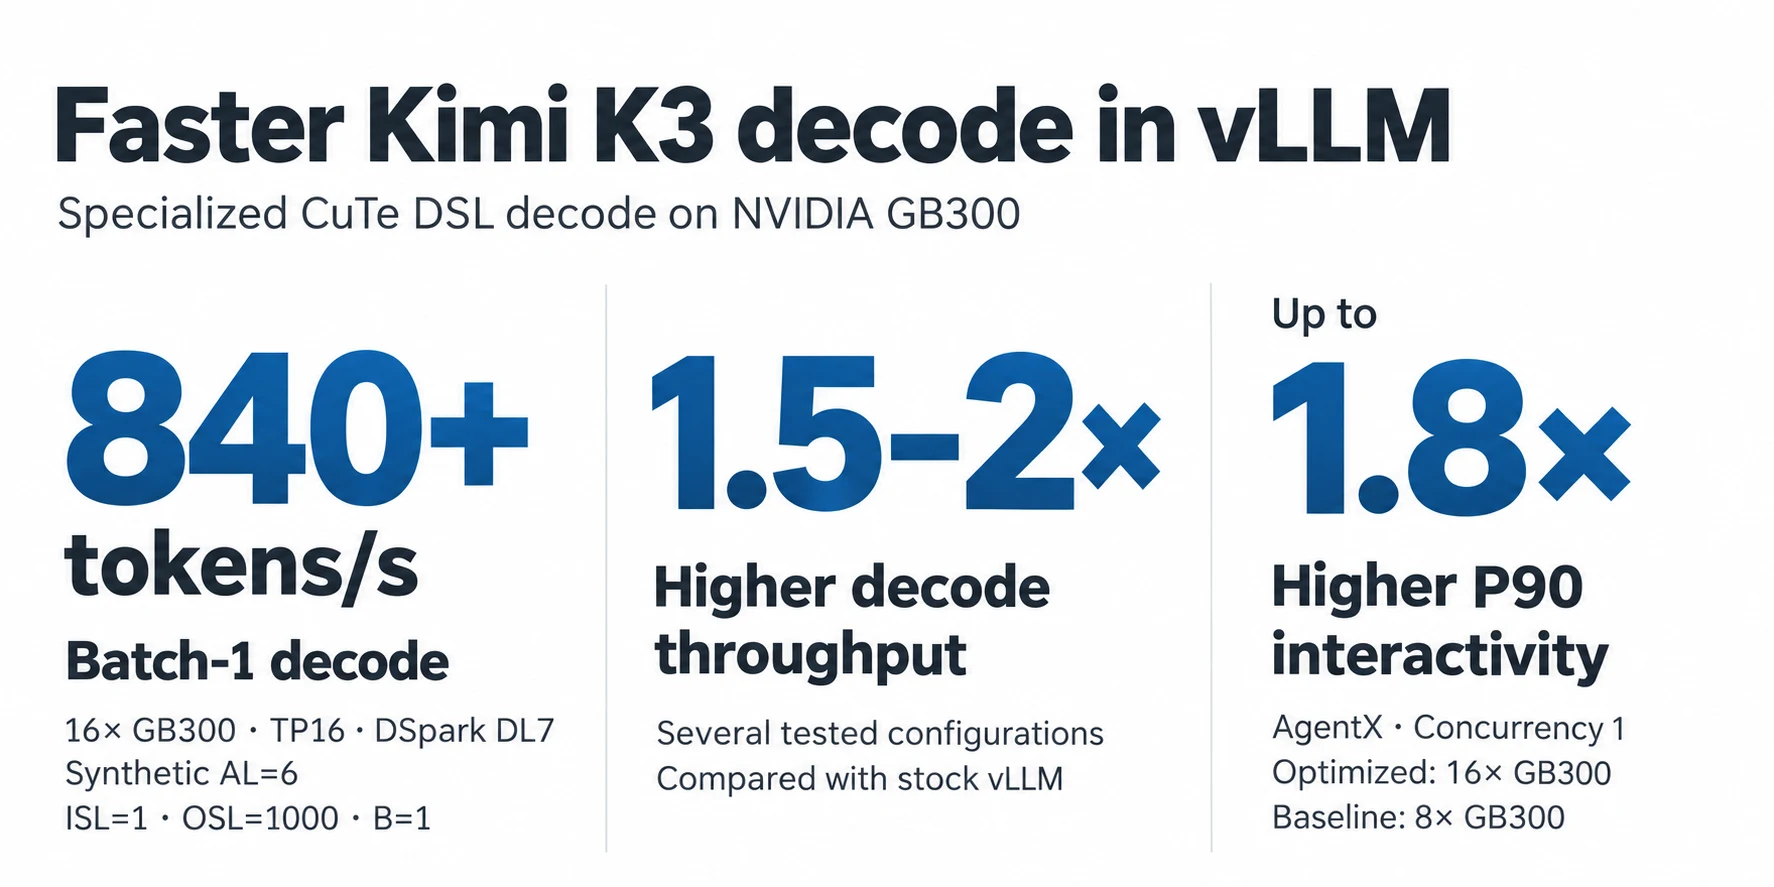
يمكن لوكلاء البرمجة الآن المساعدة في بعض أصعب جوانب تحسين النماذج: كتابة نوى GPU المعقدة، وإجراء الدمج بين العمليات المختلفة، وتداخل الحسابات مع الاتصالات، وضبط التنفيذ عبر أحجام دفعات وتكوينات GPU مختلفة. بالنسبة إلى Kimi K3، استخدمنا التطوير المدعوم بالوكلاء لبناء مسار فك ترميز موحّد بـ CuTe DSL على NVIDIA GB300، يغطي الانتباه وMoE والاتصالات عبر 8 أو 16 وحدة GPU. توفر هذه التحسينات أكثر من 840 tokens/s عند batch 1 على 16 وحدة NVIDIA GB300 GPU مع DSpark (AL اصطناعي =6)، 1.5–2× وزيادة في معدل نقل فك الترميز في عدة تكوينات مختبرة، وبحد أقصى 1.8× تحسن في P90 للتفاعلية على حمل العمل AgentX.
شِفرة الاستدلال المحسّنة بواسطة الوكلاء تتفوق على سير عمل المراجعة والصيانة لدينا. عملية المراجعة اليدوية المتمثلة في فهم كل سطر من كل نواة، ورسم المشاكل المحتملة، واختبار كل تكوين مدعوم، هي عمل شاق للغاية. ومن ناحية أخرى، إذا أغفلنا هذا العمل فإننا نخاطر بإطلاق برمجيات معيبة قد تفشل في بيئة الإنتاج.
هناك طريق واضح ومباشر لتحقيق الهدفين معًا: نحتاج إلى تغيير طريقة تنظيم عمل الأداء. إلى جانب التحسين الوكيل، نحتاج إلى تصميم أنظمة تتيح التحقق التلقائي من الموثوقية والأداء، وهيكلة البرمجيات لفرض العزل وتقليل المخاطر بالتصميم.
يوفر مسودة RFC للتحسين السريع للنماذج أساسًا لهذا النهج. مبدأنا الموجّه هو تقليل عبء المراجعة مع إدارة المخاطر. ولتحقيق ذلك، نقوم بما يلي:
- عزل التغييرات. إبقاء التحسينات ضمن شِفرة النموذج نفسه.
- تحديد النطاق والحفاظ على الميزات الأساسية. تحديد العتاد وأحمال العمل المدعومة مع الحفاظ على الميزات الضرورية لاستخدام نماذج LLM في الإنتاج.
- التحقق من الصحة بشكل منهجي. تشغيل مجموعة معتمدة من معايير الأداء والصحة لضمان السلامة والموثوقية، وأداء أفضل بصرامة على جميع التكوينات المدعومة.
- توسيع نطاق التحقق. تمكين المساهمين من تشغيل تقييمات قياسية على وحدات GPU الخاصة بهم ومشاركة نتائج قابلة لإعادة الإنتاج قبل طلب انتباه المشرفين.
Kimi K3 هو أول إسهام لدينا وفق هذا النهج. تتناول هذه التدوينة كيفية تحسين Kimi K3، وكيف نبني الثقة اللازمة لإطلاق تلك التحسينات وصيانتها، بالإضافة إلى نتائج الأداء.
جدول المحتويات
الجزء 1: تحسين Kimi K3
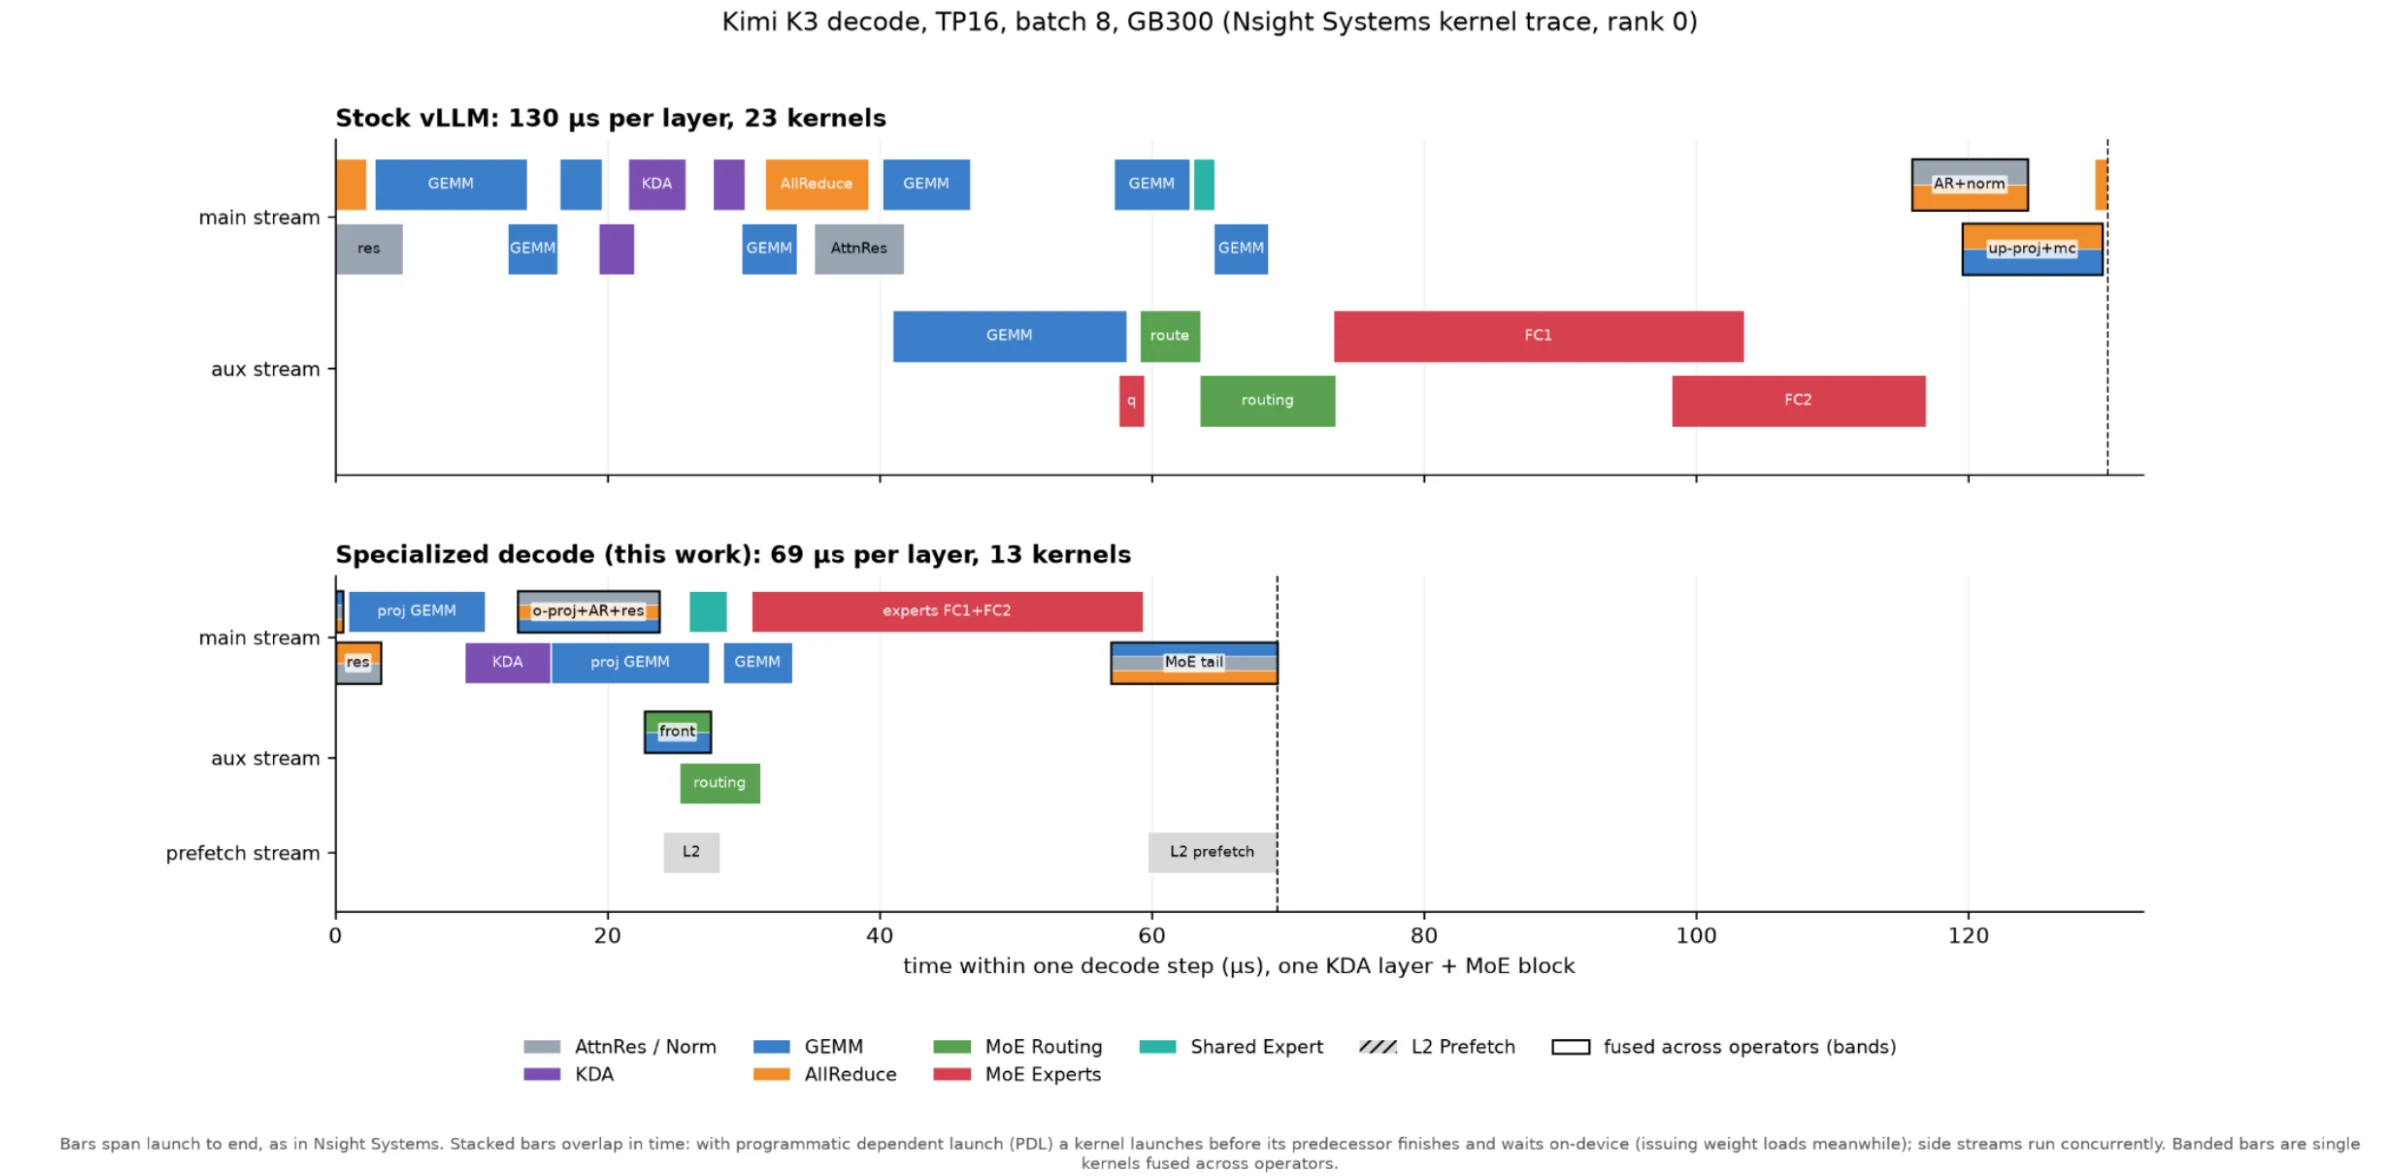
تقدّم هذه المساهمة مسار فك ترميز (decode) جديد لـ Kimi K3 يدمج ويستبدل جميع العمليات تقريبًا بنوى (kernels) مخصّصة من CuTe DSL، مضبوطة لمشكلات فرعية محددة. وهو يستهدف وحدات معالجة الرسومات NVIDIA Blackwell بعدد 8 أو 16 وحدة، وأحجام فك ترميز (decode batches) من 1 إلى 64، مع توازي سياق فك الترميز الاختياري (decode context parallelism) للسياقات الطويلة. تتشارك وحدات المعالجة نطاق NVLink واحدًا مع دعم البث المتعدد. لمزيد من التفاصيل، يُرجى الرجوع إلى الـ PR.
1. ضبط الأشكال بما يتناسب مع عبء العمل
تحتاج أحجام الدفعات المختلفة إلى اختيارات مختلفة للنوى. بالنسبة لإسقاطات مدخلات الانتباه، نستخدم نوى مصفوفات صغيرة متخصصة عند أحجام الدفعات 1–2 ونوى split-K عند الدفعات الأكبر، والتي توزّع ضرب المصفوفات عبر عدد أكبر من عمال معالجة الرسومات. وقد تم ضبط جميع هذه الإسقاطات بدقة لإطلاق نوى بأحجام مناسبة تستغل موارد وحدة معالجة الرسومات بالكامل وتُداخل عمليات قراءة الذاكرة / الاتصال وأعمال الحساب إلى أقصى حد ممكن.
KDA يستخدم أيضًا نواة فك ترميز محسّنة من CuTe DSL، مع جدولة مضبوطة وفق حجم الدفعة وعدد رؤوس الانتباه في كل وحدة معالجة رسومات.
بالنسبة للسياقات الطويلة، يقسّم توازي سياق فك الترميز (DCP) ذاكرة KV المؤقتة عبر وحدات معالجة الرسومات. تحسب كل وحدة الانتباه على جزئها المحلي، وتجمع نواة مدمجة مضبوطة النتائج الجزئية مع v-proj والتوجيه (gating).
2. تداخل الحساب والاتصال
ندمج إسقاط مخرجات الانتباه مباشرةً مع عملية all-reduce الخاصة به وحساب الباقي (attention-residual) التالي. تنشر نوى وحدة المعالجة النتائج الجزئية في مخازن مؤقتة يمكن الوصول إليها عبر NVLink، وتجمع النوى المستقبِلة تلك النتائج وتواصل الحساب. في بعض تهيئات الدفعات الصغيرة، يُدمج المنتج والمستهلك في نواة واحدة. ويتم تبادل البيانات بأسلوب خالٍ من الحواجز (fence-less) وبأقل قدر من النفقات الإضافية.
عند أحجام الدفعات الأكبر، تنتقل التنفيذات إلى اختزال على مرحلتين: تقوم وحدات المعالجة الرسومية أولاً بدمج الأجزاء المخصصة من المخرجات، ثم توزع النتائج. هذا يقلل من حركة البيانات بين وحدات المعالجة الرسومية.
3. تحسين جدولة MoE والتداخل
على الرغم من أن الخبراء يستخدمون بالفعل التوازي الشبكي، فإن النسخة الأساسية تحسب درجات الموجّه الكاملة وإسقاط المدخلات الكامنة على كل وحدة معالجة رسومية. نقوم بتقسيم هذه الحسابات عبر رتب TP ودمج حصة كل رتبة في عملية ضرب مصفوفات واحدة. تتبادل وحدات المعالجة الرسومية النتائج عبر NVLink. هذا يقلل من الحسابات المتكررة، وقراءات الأوزان، وإطلاقات النوى قبل بدء تنفيذ الخبراء.
يعمل الخبير المشترك على مسار منفصل. يتداخل عمله مع التوجيه أو حساب الخبراء الموجَّهين، حسب الإعدادات. يتحكم الجدول في مقدار موارد وحدة المعالجة الرسومية التي تستخدمها كل عملية، وقد تم ضبطه بعناية لضمان توازٍ متوازن دون تنافس. التفاصيل في experts_runtime.
4. الجلب المسبق للأوزان القادمة إلى الذاكرة المؤقتة
في الاستدلال بدفعات صغيرة، كثيراً ما نكون محدودين بالذاكرة: أي محدودين بسرعة تحميل الأوزان من الذاكرة. بعض المراحل لا تستطيع استغلال عرض النطاق الترددي المتاح للذاكرة بشكل كامل، مثل الاتصالات: أثناء حدوث هذا العمل يمكننا تشغيل نواة مخصصة على مسار جانبي لضمان أنه عند اكتمال الاتصال، تكون معدلات إصابة الذاكرة المؤقتة لأوزان العملية التالية أعلى بكثير.
الجزء 2: التحرك بسرعة وبمسؤولية
Kimi K3 هو مجرد واحد من الأمثلة الأولى. نحن نؤمن بأن المجتمع يمكنه بناء هذا معاً، لجلب المزيد من النماذج ووحدات المعالجة الرسومية وأحمال العمل نحو سرعة الضوء.
سوف يجد المساهمون/الوكلاء المختلفون فرصاً مختلفة: جدولة اتصالات أفضل، أو دمج يساعد نشراً معيناً. لكن إذا وصلت كل مساهمة بافتراضات مختلفة، واختبارات غير مكتملة، ومعيار قياس يصعب إعادة إنتاجه، فإن أعمال التحقق والصيانة ستصبح بسرعة عنق الزجاجة، أو نخاطر بشف رمز معطوب. نحتاج إلى طريقة مشتركة لتحويل تلك الأفكار إلى تحسينات يمكن للمستخدمين الاعتماد عليها في حالات استخدامهم الإنتاجية طويلة الأمد.
هذا يغيّر ما نطلبه من الوكلاء. يجب أن نضع توقعات واضحة بشأن الاختبار والتحقق والمتطلبات للكود الذي ينتجه الوكلاء. سيقوم الوكلاء ببناء الاختبارات، وتشغيل تقييمات ومعايير قياس شاملة، والتحقيق في حالات الفشل، وتوثيق الظروف التي يعمل فيها التحسين. لا يزال المراجعون البشريون يحاكمون التصميم والأدلة، لكن يمكنهم البدء من تجريد عالي المستوى، بدلاً من مراجعة الكود سطراً بسطر.
بناءً على المقترح fast-track RFC, ننظم هذا العمل حول أربعة مبادئ.
1. عزل التغييرات
احتفظ بالتحسينات الخاصة بالنموذج داخل كود النموذج. هذا يجعل المسارات المتأثرة أسهل في التحديد ويقلل من نطاق التأثير الذي يحتاج المراجع إلى أخذه في الاعتبار.
يحتاج العزل أيضاً إلى البقاء قائماً وقت التشغيل. يجب أن يتمكن المراجعون من تتبع متى يتم اختيار المسار المحسّن، وما الحالة التي يغيّرها، وكيف يعود التنفيذ إلى المسار القياسي.
هذا القيد يستبعد بعض التحسينات فعلاً: يمكن أن يتسبب تحضير المدخلات، وأخذ العينات، وإدارة ذاكرة KV المؤقتة في تكاليف إضافية يستبعدها العزل. هذه نتيجة للتصميم وهي مقصودة إلى حد كبير: هذه المكونات مشتركة بين معظم عمليات نشر vLLM، وتغييرها للتحسين من أجل حمل عمل معين يهدد بكسر عشرات التكوينات الأخرى المستقرة لـ vLLM. العمل على هذه المكونات مهم، ويجب أن يشرك المشرفين الأساسيين بشكل أقرب بكثير مما سيسمح به المسار السريع.
2. تحديد النطاق، مع الحفاظ على ميزات المستخدم
لا يحتاج التحسين إلى تحسين كل عملية نشر ليكون مفيداً. يمكنه استهداف وحدة معالجة رسومية معينة، أو إعداد توازٍ محدد، أو نطاق من أحجام الدفعات. الحدود الواضحة تجعل العمل أسهل في الضبط وتمنحنا مجموعة محددة من التكوينات للتحقق منها.
بالنسبة إلى K3، يغطي التحقق المبدئي من العتاد GB300 مع TP8 وTP16، ودفعات فك التشفير حتى 64، وفك التشفير التخميني بأطوال مسودة متنوعة، وتكوينات التوازي السياقي لفك التشفير ضمن نطاق NVLink واحد.
تصف هذه الحدود أين ينطبق التحسين، وليس تقليص ‘تغطية الميزات’. نشر الإنتاج يحتاج إلى ميزات أساسية تجعل نقطة النهاية مفيدة. ميزات مثل خدمة السياق الكامل، وأخذ العينات الحراري، والمخرجات المهيكلة لا يمكن ‘إزالتها بالتحسين’ أو ‘جعلها اختيارية’، فهي ميزات خدمة من الدرجة الأولى وتنتمي إلى خطة التحقق إلى جانب أشكال النوى والفحوصات العددية.
3. التحقق من الصحة
اختبارات النوى وتقييمات النماذج تجيب عن أسئلة مختلفة. تتحقق اختبارات النوى من النتائج العددية عبر الأشكال وقيم المدخلات. تتحقق تقييمات النماذج مما إذا كان مسار التنفيذ الكامل يحافظ على إجابات النموذج. نحتاج إلى كليهما.
يجب أن تمارس الاختبارات الكود المغيّر فعلياً. يحتاج تحسين الدفعات الصغيرة إلى تقييم عند الدفعات الصغيرة. يحتاج تغيير نواة الانتباه إلى تغطية للسياقات الطويلة. الاختبارات التي تستخدم المسار القياسي بصمت لا توفر دليلاً يُذكر عن التحسين وهي فخ شائع.
تطوير K3 يوضح لماذا يهم هذا. اكتشفت مراجعتنا أن المترجم نقل قراءات التنشيط إلى ما قبل انتظار تزامن. قيّد الإصلاح نوع التحميل هذا إلى الأوزان الثابتة. مثل هذه الأخطاء يمكن أن تنجو من الفحوصات الوظيفية البسيطة وتتطلب تحقيقاً موجهاً.
بالإضافة إلى ذلك، كشفت تقييمات السياق الطويل والتوليد الطويل مثل MRCR و AIME25 عن مشكلات رقمية حساسة في أنوية الانتباه والتواصل لم تكن قابلة لإعادة الإنتاج في اختبارات الأنوية المستقلة باستخدام مدخلات وهمية و/أو توقيتات إطلاق متسقة.
4. تحقق من الأداء على نطاق واسع
التسريع الرئيسي هو نقطة بداية فقط. ونحتاج أيضًا إلى معرفة كيف يتصرف التغيير عبر أحمال العمل التي يؤثر عليها. هذا يعني مسح أحجام الدفعات وأطوال السياق وتكوينات التوازي المدعومة. يجب أن تتضمن قياسات MoE مطالبات حقيقية لأن اختيار الخبراء يؤثر على الأوزان التي تُقرأ وعلى مقدار العمل الذي يمكن إعادة استخدامه. كما ينبغي تمييز نتائج فك الترميز الخالصة عن أحمال العمل التي تمزج بين التعبئة المسبقة وفك الترميز.
يتطلب التحقق الموثوق أيضًا وقتًا على GPU. تقترح وثيقة Bring-Your-Own-GPU evaluation RFC ذات الصلة صور تقييم قياسية يمكن للمساهمين تشغيلها على أجهزتهم الخاصة. وستجعل حزم النتائج القابلة لإعادة الإنتاج والطلبات المرتبطة بـ GitHub PRs الأدلة أكثر سهولة في الوصول بكثير. وتساعد مستويات التقييم المختلفة والحوسبة المجتمعية المشتركة على توسيع التغطية مع إدارة الطلب على GPU وتخفيف الضغط على CI الممول من المشروع.
الجزء 3: تحليل معمّق للأداء
أداء فك الترميز مع DSpark
مع DSpark، يحقق Kimi K3 842 رمزًا في الثانية على 16 من وحدات NVIDIA GB300 GPUs في معيار AL=6 المضبوط. أي أنه أسرع بمقدار 1.73× من vLLM الأصلي مع نفس إعداد فك الترميز التخميني. راجع الـ PR للاطلاع على جدول النتائج الكامل.
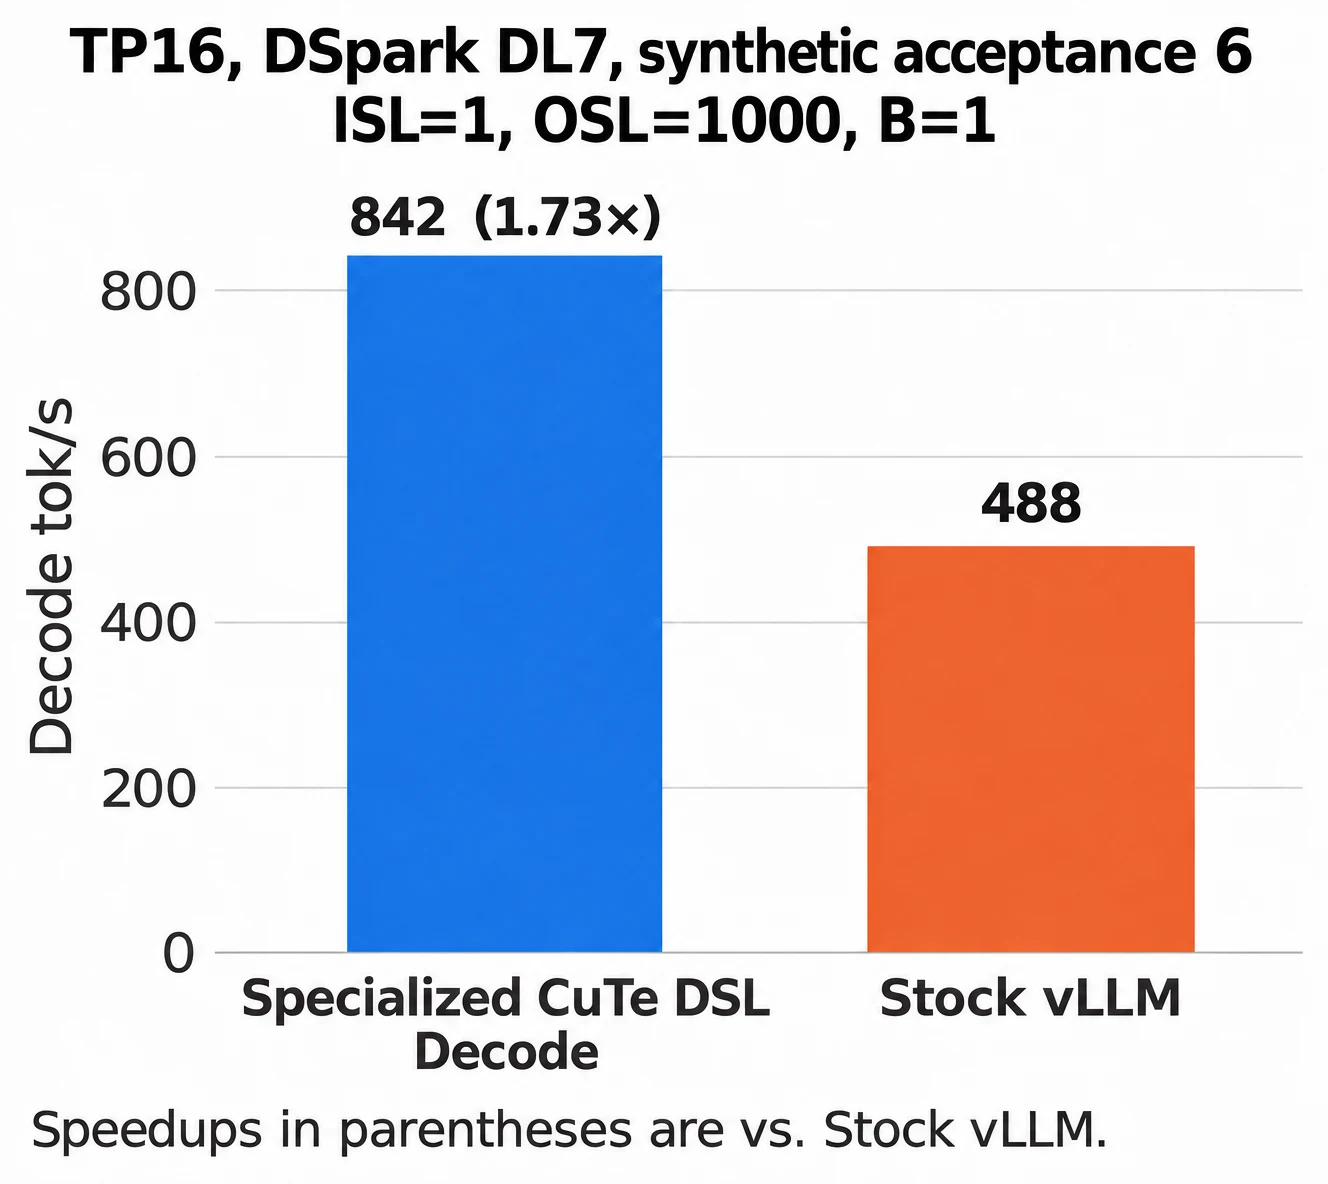
الإعداد: TP16، DSpark مع سبعة رموز تخمينية، طول قبول تخليقي قدره 6، DL=7، ISL=1، OSL=1k، حجم دفعة 1. يقيس TPS إنتاجية فك الترميز الإجمالية ويستثني التعبئة المسبقة.
أداء فك الترميز دون تخمين
تمتد التحسينات عبر نطاق الدفعات المختبر بالكامل. يحافظ TP16 على مكسب بمقدار 1.62–1.71× عند الدفعات 16–64، بينما يوفر TP8 1.31–1.43× على نفس النطاق.
| حجم الدفعة | TP8 tokens/s | تسريع TP8 | TP16 tokens/s | تسريع TP16 |
|---|---|---|---|---|
| 1 | 193.3 | 1.58× | 256.4 | 1.88× |
| 2 | 317.8 | 1.50× | 436.7 | 1.92× |
| 4 | 540.6 | 1.55× | 702.5 | 1.81× |
| 8 | 820.1 | 1.45× | 1,157.9 | 1.79× |
| 16 | 1,274.8 | 1.43× | 1,758.3 | 1.71× |
| 32 | 1,702.6 | 1.33× | 2,550.9 | 1.64× |
| 64 | 2,375.9 | 1.31× | 3,606.1 | 1.62× |
بدون فك ترميز تخميني. الإنتاجية لمجموعة TP بأكملها.
التحسن على AgentX
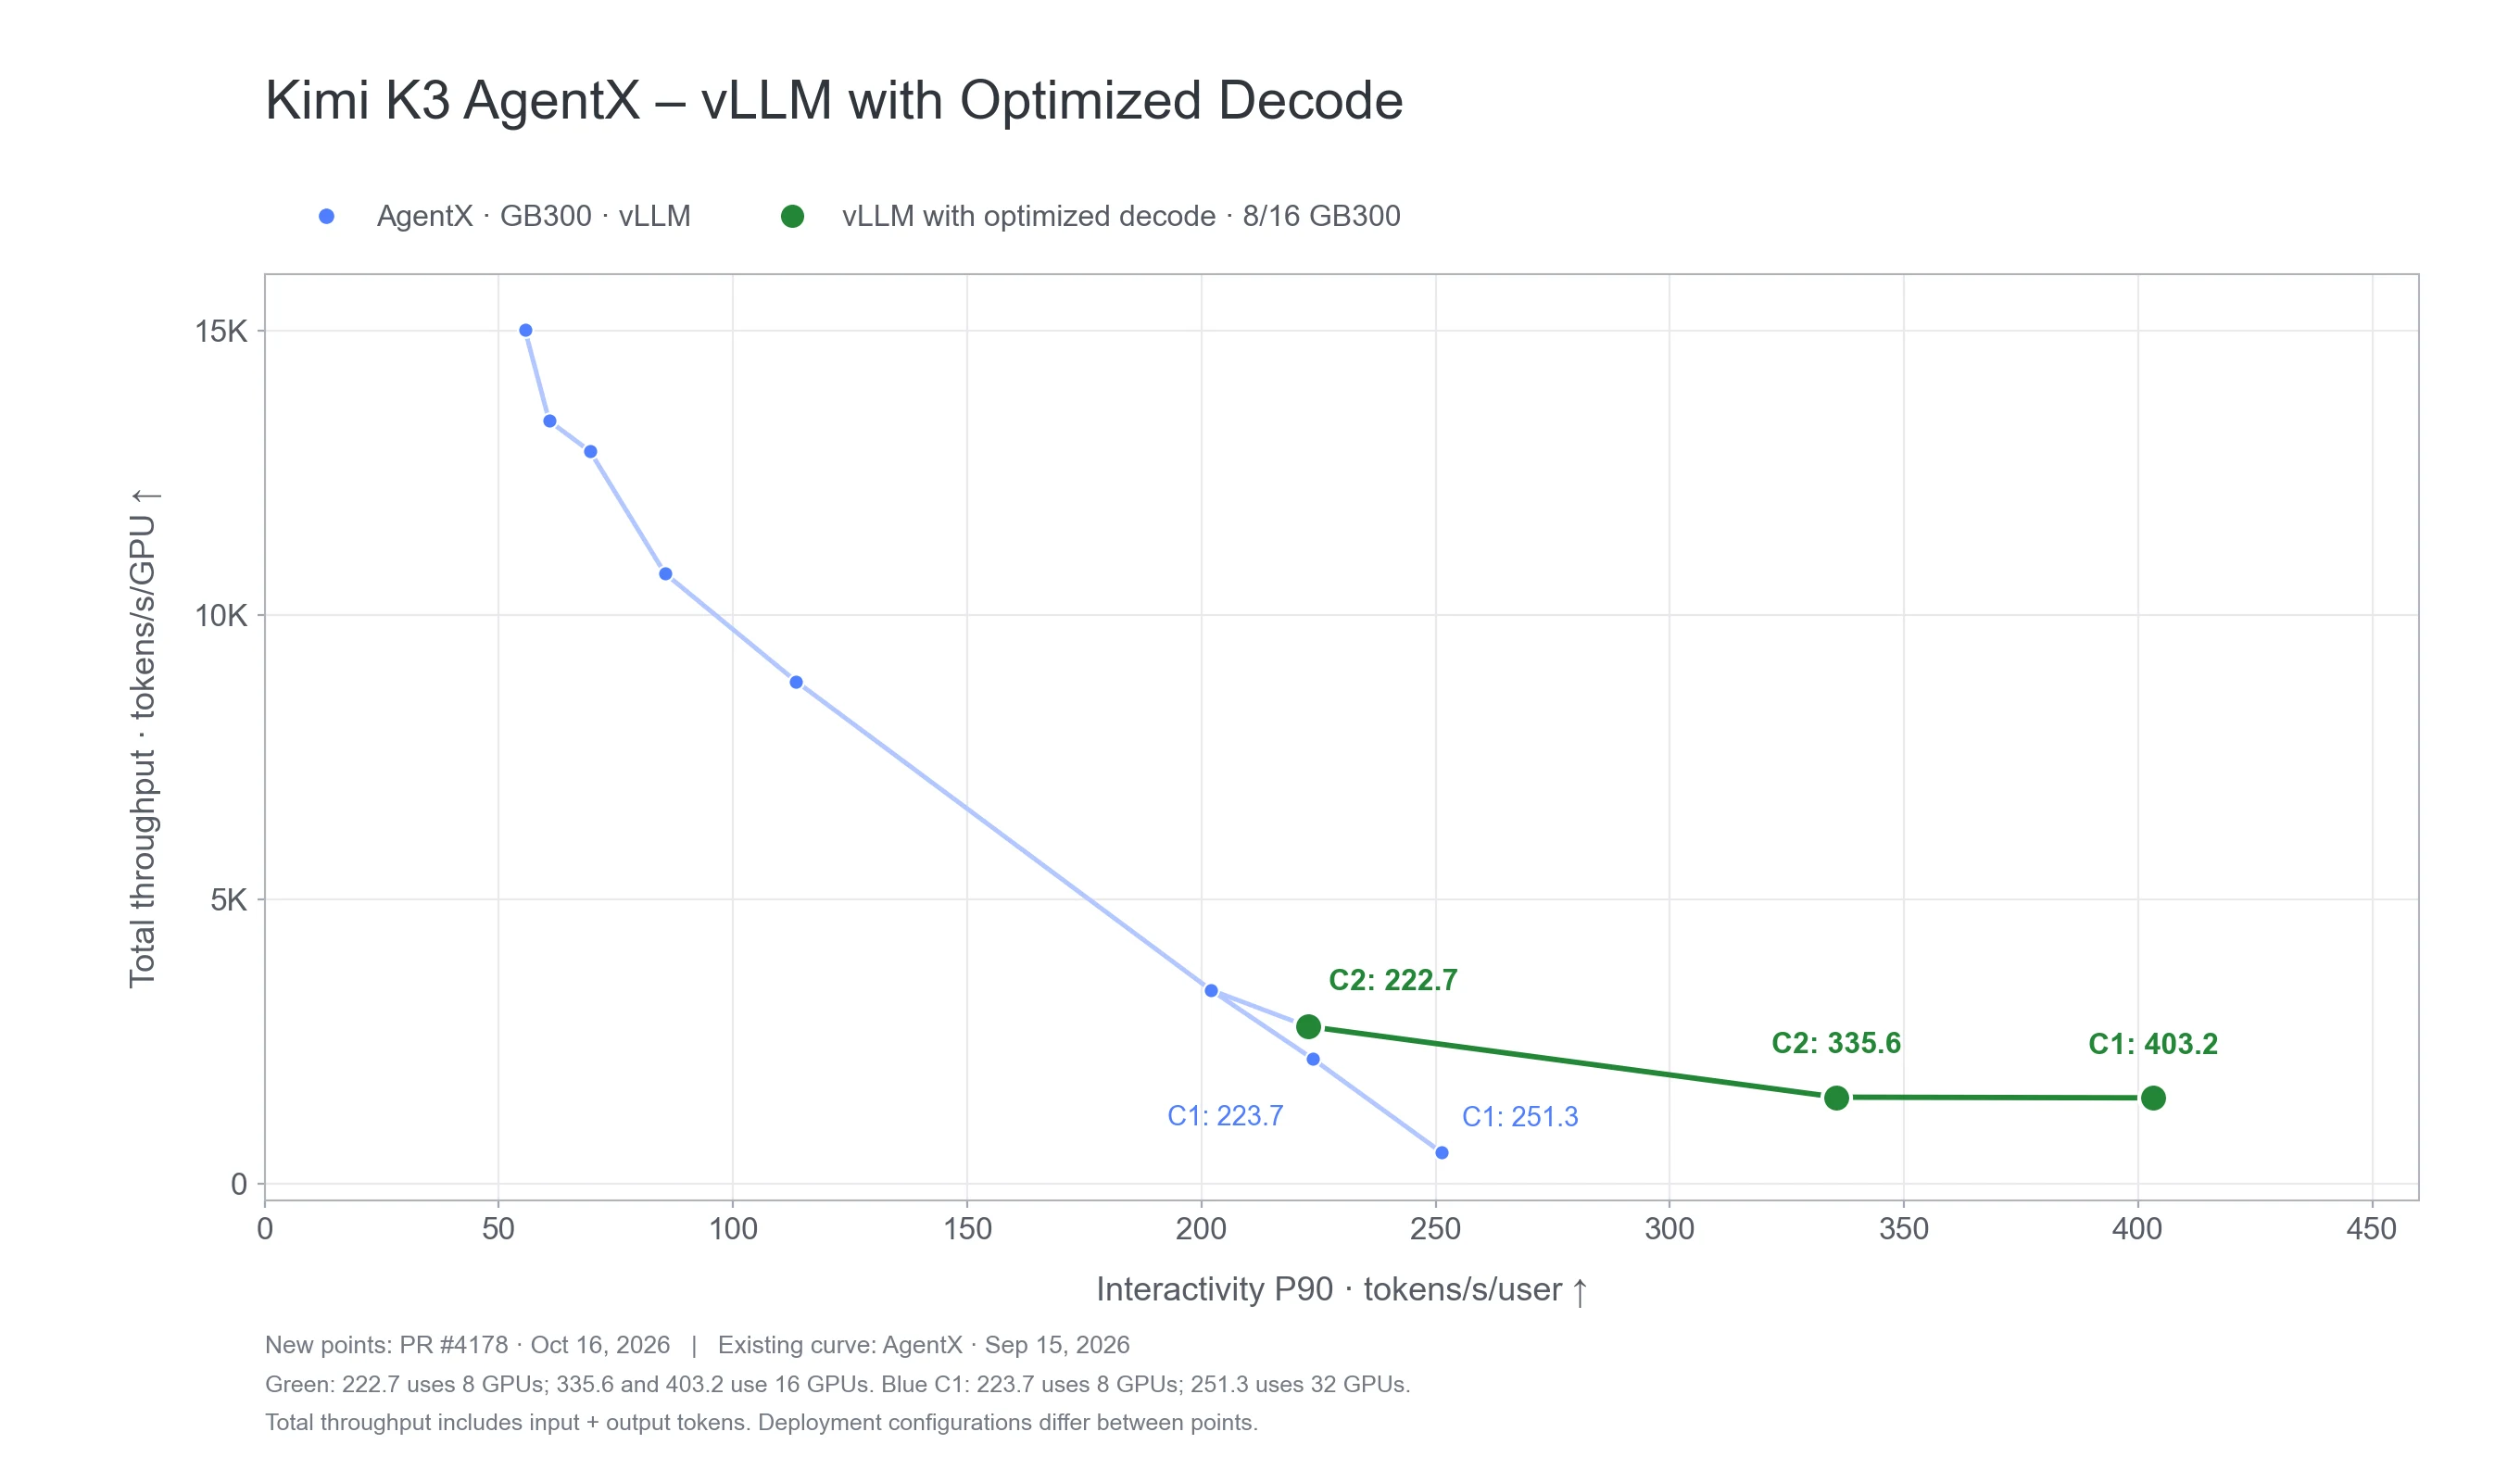
يوفر تنفيذنا المحسّن لـ Kimi K3 أيضًا تفاعلية P90 أعلى بمقدار 1.8× عند التزامن 1 على AgentX: 403.2 مقابل 223.7 tokens/s/user. يقارن هذا بين التشغيل المُحسَّن على 16 من وحدات GB300 والنتيجة السابقة عبر vLLM على 8 من وحدات GB300.
يعيد AgentX إنتاج أنماط حركة المرور من جلسات حقيقية لعملاء البرمجة الذاتيين، بما في ذلك السياقات الطويلة، وتعدد أدوار المحادثة، وتوقفات الأدوات، والوكلاء الفرعيين المتوازيين، وإعادة استخدام KV-cache. فهو يحافظ على هذه الأنماط من أحمال العمل مع استبدال المحتوى الخاص بنصوص اصطناعية، لاختبار نظام الخدمة تحت حركة مرور واقعية للوكلاء. منهجية AgentX.
ما التالي
بالنسبة إلى DeepSeek-V4.1-Flash، #61868 يتبع أنماط تصميم K3: خلف نفس الخيار الاختياري decode_backend: latency_specialized المفتاح (switch)، كما يدعم التنفيذ أيضًا حتى 64 طلبًا متزامنًا، والتراجع السلس للـ prefills والدفعات المختلطة، وفك الترميز التخميني (speculative decoding). وبدلًا من مطاردة نقطة ساخنة واحدة، يقلّل هذا المنفّذ من النوى (kernels) والعمل على المضيف: فهو يدمج all-reduce + mHC عند حدود كل طبقة فرعية، ويستبدل MoE للدفعات الكبيرة وGEMMs بأنوية Cute DSL مبنية لزمن استجابة منخفض، ويزيل التكرار ويقسّم عمل المفهرس (indexer)، ويأخذ العمل لكل خطوة الذي يشغّله vLLM القياسي بشكل مباشر (eagerly) على المعالج المركزي ويعيد تشغيله كرسم بياني CUDA بدلًا من ذلك.
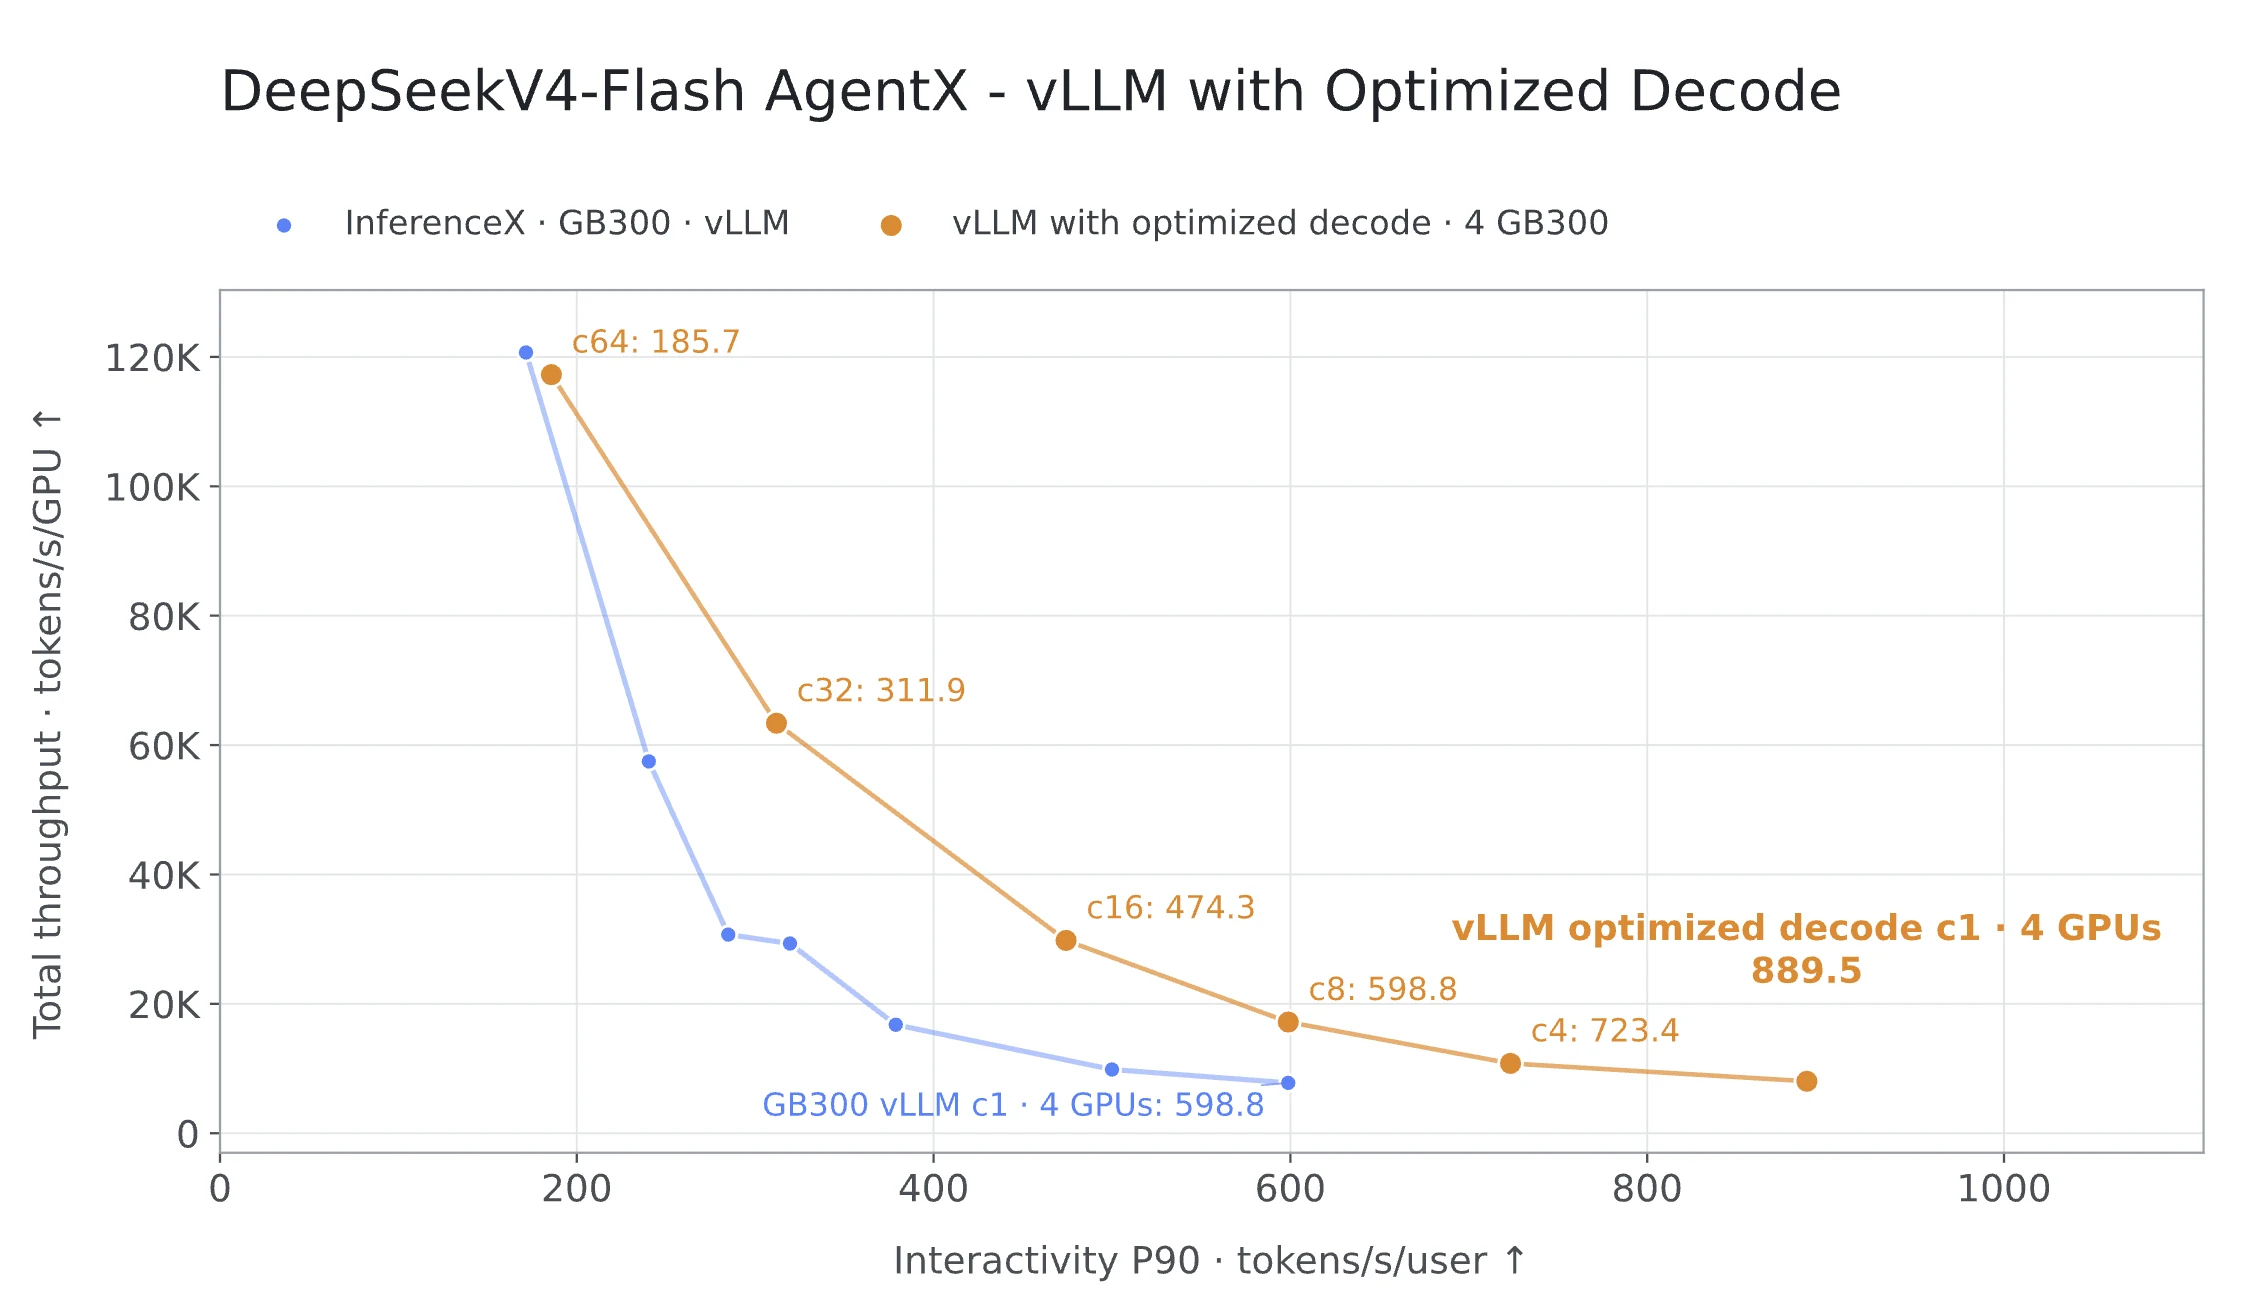
خلال يومين من إعلان ميتا Muse Spark Open الإصدار، وقد تجاوزت نتائجنا المبكرة بالفعل 950 رمزاً في الثانية لكل مستخدم, مع سبع رموز مسودة (K=7) وطول قبول قدره ستة (AL=6). تجري المزيد من التحسينات حاليًا.
نطلق أيضًا آلية مماثلة لتحسين زمن فك الترميز لـ GLM5.3 في سيناريو التزامن المنخفض. سنشارك تفاصيل تحسينها ونتائج أدائها في متابعة لاحقة.
لكل مساهمة، سنواصل التركيز على المكاسب الملموسة في الأداء، ودعم الميزات في بيئة الإنتاج، والفحوصات القابلة للتكرار للصحة والأداء.
شكر وتقدير
ودود أن نشكر Rohan Varma (NVIDIA) وAlex Steiner (NVIDIA) على مساهماتهما في هذا العمل.
ودّنا أيضًا أن نتقدم بالشكر إلى Woosuk Kwon (Inferact)، وMichael Goin وLucas Wilkinson (Red Hat)، على إعادة هيكلة النموذج وعلى ملاحظاتهم القيّمة ودعمهم.