
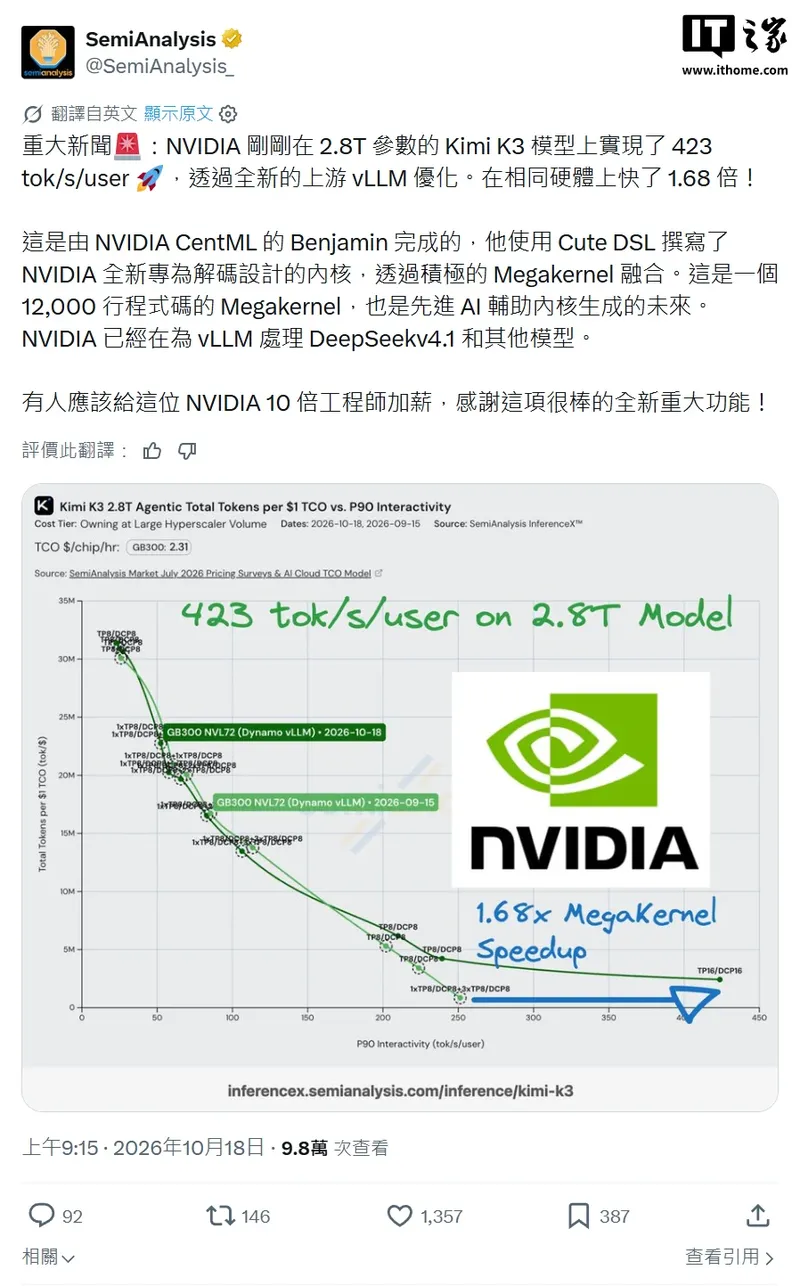
IT之家، وفقًا للأخبار الصادرة في 18 أكتوبر، أعلنت شركة SemiAnalysis أن نفيدا تمكن من تحسين vLLM الأولي، مما جعل نموذج Kimi K3 الذي يحتوي على 2.8 تريليون خاصية، يحقق سرعة استدلال تبلغ 423 tok/s/user (كل توكين في الثانية لكل مستخدم)، مما يعني تحسنًا بنسبة 1.68 مرة في الأداء مقارنة بنفس الأجهزة (GB300 NVL72).
وفقًا للتقرير، تم إنجاز هذا التحسين من قبل مهندس شركة نفيديا CentML، بنجامين. ومن خلال دمج كبير لـ Megakernels، تم كتابة النواة المخصصة لتفكيك البيانات التي طرحتها نفيديا باستخدام Cute DSL. يتضمن هذا Megakernel 12,000 سطرًا من الكود، ويمثل ذلك اتجاهًا مستقبليًا لإنشاء النواة الحسابية المتقدمة بمساعدة الذكاء الاصطناعي. وقد حسنت نفيديا سرعة استدلال نموذج Kimi K3، حيث تضاعفت بـ 1.68 مرة.
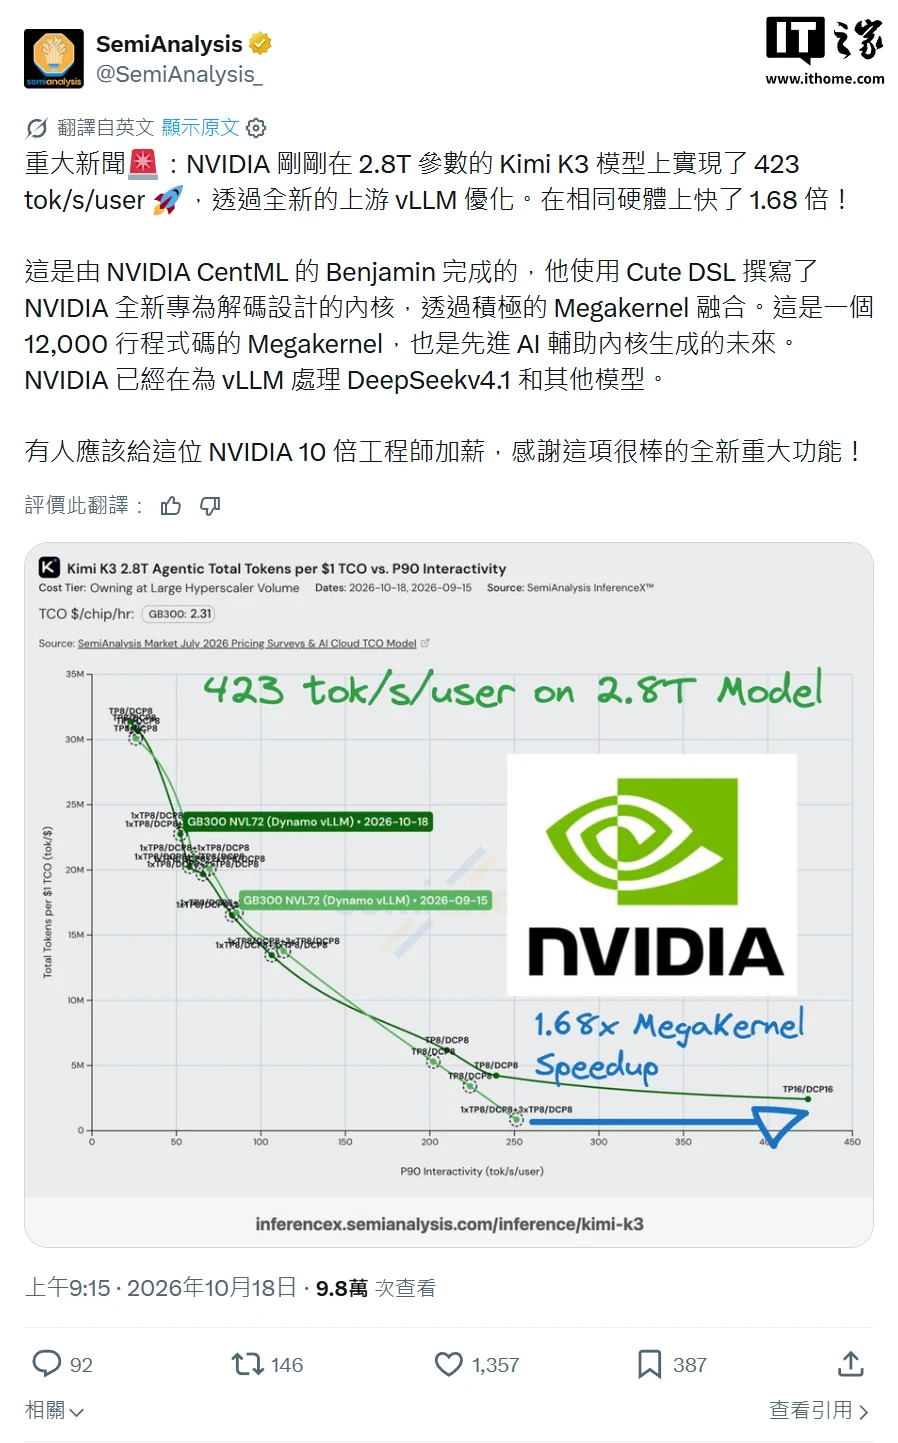
لاحظت شركة IT之家 أن نوصال، بالإضافة إلى ذلك، تعمل أيضًا على تحسين النماذج الأخرى مثل DeepSeek V4.1 من خلال vLLM.