
في 16 أكتوبر، انعقد مؤتمر CSDI Summit العاشر للذكاء والابتكار في البحث والتطوير البرمجي في الصين بمدينة شنتشن. وخلال المنتدى الرئيسي، ألقى شيوان شان مينغ، نائب رئيس SenseTime BigDevice والمدير التنفيذي للتقنية (CTO)، خطابه الرئيسي بعنوان «ممارسات واتجاهات البنية التحتية للذكاء الاصطناعي في عصر Agentic»، تناول خلاله موضوعات مثل اتجاهات نمو التوكن في عصر Agentic، وممارسات عناقيد الاستدلال غير المتجانسة، واستكشاف تقنيات جديدة في البنية التحتية للذكاء الاصطناعي، مشاركًا استكشافات SenseTime BigDevice التقنية وممارساتها في مجال خدمات الاستدلال واسعة النطاق.
شيوان شان مينغ، نائب رئيس SenseTime BigDevice والمدير التنفيذي للتقنية (CTO)
أشار شيوان شان مينغ إلى أنه مع انتقال تطبيقات الذكاء الاصطناعي من الأسئلة والأجوبة الحوارية تدريجيًا نحو التعاون متعدد الوكلاء وتنفيذ المهام الطويلة، يتضاعف الطلب على التوكن بمستويات تبلغ ألف مرة، وتواجه البنية التحتية للذكاء الاصطناعيوضعًا جديدًا تتواجد فيه انفجار الطلبات مع قيود عرض القدرة الحاسوبية معًاوفي المستقبل، لن يكون مفتاح المنافسة في القطاع هو امتلاك قدر حاسوبي بقدر ما سيكون الأمر يتعلق بكيفية تحقيق ذلك من خلال الابتكار المعماري، والتنسيق غير المتجانس، وجدولة الموارد، لإنتاجتوكن عالي الجودة باستمرار بتكلفة أقل وكفاءة أعلى واستقرار أكبر.
من حجم القدرة الحاسوبية إلى طاقة إنتاج التوكن: البنية التحتية للذكاء الاصطناعي تشهد تحولًا في الكفاءة
مقارنةً بالأسئلة والأجوبة الحوارية التقليدية، فإن استدعاء الأدوات بواسطة وكيل واحد، والتعاون متعدد الوكلاء، وتنفيذ المهام الطويلة دون إشراف بشري، تنطوي على استدعاءات نموذجية أكثر وجولات استدلال ومعالجة سياق أكبر، مما يؤدي إلى نمو استهلاك التوكن بمستويات تبلغ ألف مرة. وفي الوقت نفسه، فإن محدودية عرض الرقائق عالية الأداء، وعدم تطابق القدرة الحاسوبية القائمة مع متطلبات موارد مهام الاستدلال وغيرها من المشكلات، تجعل من الصعب توسيع العرض الحاسوبي بالوتيرة نفسها. وتُظهر بيانات القطاع أن نفقات الاستدلال من المتوقع أن تمثل 55% من إجمالي نفقات AI IaaS في عام 2026، مع توقع ارتفاعها إلى 59% في عام 2027.
وفي الوقت نفسه، تختلف احتياجات التطبيقات المختلفة من التوكن بوضوح. فالأسئلة والأجوبة الأساسية تهتم أكثر بتكلفة الوحدة وقدرات التزامن، بينما تفرض سيناريوهات مثل وكلاء المكاتب وخدمة العملاء متطلبات أعلى فيما يتعلق بتأخير الاستجابة وسرعة التوليد، أما السيناريوهات عالية القيمة مثل الاستكشاف العلمي والم量化 المالية ف تولي أهمية أكبر لدقة النتائج وقابلية التدقيق وقابلية التتبع. وتحدد مؤشرات مثل تأخير أول توكن (TTFT)، وسرعة التوليد (OTPS)، وذاكرة التخزين المؤقت للسياق الطويل، وقدرات التزامن، ومعدل نجاح الاستدعاء، معًا جودة خدمات التوكن وتكلفتها.
ذكر شيوان شان مينغ: «هذا يعني أن البنية التحتية للذكاء الاصطناعي لم تعد قادرة على الاعتماد على تكوين عتادي واحد لتلبية جميع المهام، بل تحتاج إلى تنظيم موارد الحوسبة وفقًا لمتطلبات الخدمة لكل سيناريو من خلالالتنظيم الطبقي والجدولة الدقيقة。والتحول من التوسع في الحجم إلى تحسين الكفاءة، ومن استبدال العتاد الأحادي إلى التنسيق غير المتجانسوهذا يصبح اتجاهًا تنمويًا مهمًا للبنية التحتية للذكاء الاصطناعي في عصر Agentic».
فصل PD كنواة لبناء عنقود استدلال غير متجانس بمستوى 10,000 بطاقة
لمواجهة التناقض بين قيود عرض القدرة الحاسوبية عالية الأداء ونمو الطلب على الاستدلال، استكشفت SenseTime BigDevice بنية استدلال منفصلة،من خلال فصل PD والجدولة الهجينة غير المتجانسة، بحيث تتولى أنواع القدرات الحاسوبية المختلفة المهام الأنسب لها.
في عملية الاستدلال بالنماذج الكبيرة، يتولى Prefill معالجة توكن المدخلات ويتميز بخصائص مكثفة حسابيًا؛ بينما يتولى Decode توليد توكن المخرجات تدريجيًا ويتطلب قراءة مستمرة لذاكرة التخزين المؤقت للسياق، مما يفرض متطلبات عالية على عرض نطاق ذاكرة الفيديو. ويفصل PD بين المهمتين: تتولى القدرات الحاسوبية المحلية الملائمة مهام Prefill بشكل مركز، وتتولى بطاقات GPU عالية الأداء ذات النطاق العريض مهام Decode، ثم يتم ربط المرحلتين عبر نقل KV Cache. وهذا الحل لا يقتصر على الجمع البسيط بين رقائق مختلفة، بل يعيد تنظيم موارد الحوسبة حول الخصائص الحسابية وعرض نطاق ذاكرة الفيديو ومتطلبات المهام. وبذلك تنتقل القدرات الحاسوبية المحلية من تولي مهام الاستدلال الأساسية إلى المشاركة في خدمات الاستدلال عالية المستوى، مما يحسن الكفاءة الإجمالية والقيمة مقابل التكلفة للعنقود الهجين مع تلبية متطلبات جودة الخدمة للسيناريوهات المختلفة.
استنادًا إلى هذا النهج، واصلت SenseTime BigDevice ممارسات الاستدلال غير المتجانس في مركز Lingang AIDC، وبنت عنقود استدلال غير متجانس بمستوى 10,000 بطاقة. ويتطلب تحقيق هذه البنية حل مشكلات الترابط بين قدرات حاسوبية من أجيال وأنواع مختلفة، ودمج شبكات بمواصفات مختلفة مثل 800G و400G و200G في العنقود نفسه، لضمان النقل الفعال لـ KV Cache بين عقد Prefill وعقد Decode.
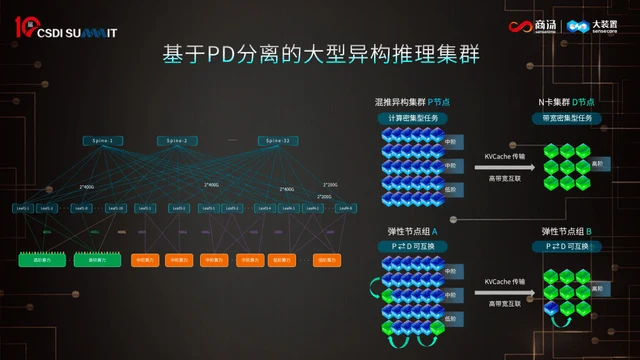
ومع ذلك، مع توسع حجم العنقود، أصبحت أعطال العقد والموارد الخاملة تحديات هندسية جديدة. على سبيل المثال، في بعض التكوينات غير المتجانسة، قد تكون هناك حاجة إلى 30 إلى 50 عقدة Prefill متوسطة أو منخفضة المستوى لمطابقة قدرة معالجة عقدة Decode واحدة. وبمجرد تعطل عقدة Decode، قد تصبح كمية كبيرة من موارد Prefill خاملة، مما يؤثر على كفاءة الخدمة الإجمالية.
وبشأن ذلك، طبقت SenseTime BigDevice طريقتين للتحسين. الأولى هي حجز قدرات حاسوبية عالية الأداء محدودة في مجمع موارد Prefill، بحيث يمكن تعبئة العقد عالية الأداء سريعًا عند حدوث أعطال في عقد Decode؛ والثانية هي تمكين العقد في العنقود من القدرة على التبديل الديناميكي بين أدوار Prefill وDecode، بحيث يتم تعديل توزيع العقد بمرونة وفقًا للأحمال الفعلية وضغط الموارد، لتحقيق التدفق الديناميكي للموارد الحاسوبية والجدولة المرنة. ومن خلال هاتين الطريقتين، يمكن ضمان الإنتاج المستقر والمستمر لتوكن عالي الجودة من عنقود غير متجانس واسع النطاق مع خفض التكاليف.
استنادًا إلى هذه الممارسات، بنت SenseTime BigDevice بشكل أكبربنية معمارية من ست طبقاتتغطي مرافق الطاقة، وترابط الموارد، ومستوى بيانات KV، ووقت تشغيل الاستدلال، وجدولة الخدمات، وطبقة التسليم، لتنظيم العتاد غير المتجانس في نظام خدمة استدلال قابل للجدولة الموحدة والتشغيل المرن.
وبحسب شيوان شان مينغ، في تكوين اختباري محدد، مقارنةً بالحل المرجعي، وباستخدام نفس عدد بطاقات الرائد عالية الأداء، يمكن من خلال الاستدلال غير المتجانس والتنسيق بين الموارد،زيادة إجمالي معدل نقل التوكن إلى 5 أضعاف القيمة الأصلية.
من فصل PD عبر النطاقات إلى فصل AF: مواصلة توسيع حدود بنية الاستدلال
على أساس الاستدلال غير المتجانس واسع النطاق، تواصل SenseTime BigDevice استكشافاتجاهات تقنية مثل فصل PD عبر النطاقات وفصل AFلإطلاق المزيد من إمكانات التنسيق بين موارد الحوسبة الموزعة.
تهدف فصل PD عبر النطاقات إلى كسر حدود الموارد لمركز بيانات واحد. يذكر شوان شان مينغ أنه بعد تحقيق فصل PD داخل مركز بيانات واحد، فإن الخطوة التالية للاستكشاف هي فصل PD عبر النطاقات، وذلك لتنشيط موارد الحوسبة في مناطق مختلفة بشكل أكبر. تتعاون SenseCore (商汤大装置) مع الحكومات المحلية في أنحاء البلاد، ومن خلال التعاون عبر النطاقات، يمكن أن تتولى حوسبة محلية متوسطة أو منخفضة المستوى مهمة Prefill، ثم يتم نقل KV Cache إلى عنقود حوسبة عالي المستوى في منطقة أخرى لإتمام Decode،محققةً تنسيقاً للاستدلال يتجاوز العناقيد ومراكز البيانات بل وحتى المناطق الجغرافية.
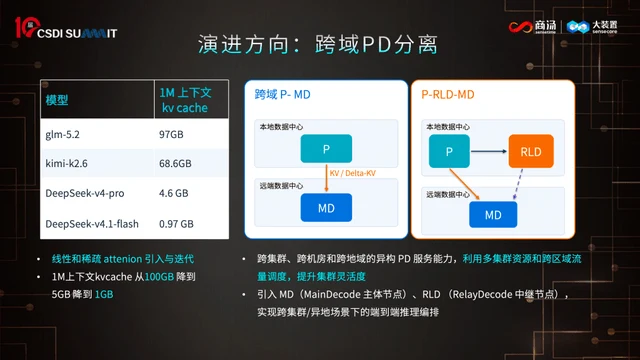
ترتبط جدوى هذا الاتجاه أيضاً ارتباطاً وثيقاً بتطور بنية النماذج، إذ انخفض حجم KV Cache لسياق 1M في بعض النماذج من نحو 100GB إلى حوالي 1GB، مما قلل بشكل كبير من ضغط النقل عبر النطاقات. كما تستكشف SenseCore إدخال عقد Decode رئيسية (MD) وعقد Decode وسيطة (RLD) لدعم تنسيق الاستدليل في السيناريوهات عن بُعد، بحيث حتى لو كانت المنطقة تفتقر إلى قدرة حوسبة عالية المستوى كاملة، يمكنها من خلال دمج موارد حوسبة بمقاييس وأداء مختلفة دفع شبكة الحوسبة المتكاملة من ربط الموارد نحو تعاون المهام، وتحقيق خدمة Token ذات إنتاجية أعلى وجودة أفضل.
أما فصل AF فيقوم بفك الارتباط بين مهام الحساب المختلفة في عملية الاستدلال بشكل أعمق. في مرحلة Decode، تتولى آلية Attention بشكل رئيسي معالجة السياق واستخراج المعلومات الأساسية، ولها متطلبات عالية من سعة الذاكرة وعرض النطاق؛ بينما تؤدي FFN عمليات ضرب مصفوفات كثيرة ولها متطلبات أعلى من القدرة الحسابية. البنية التقليدية تربط الاثنين معاً على نفس موارد GPU، مما قد يتسبب في تنافس على الموارد. فصل AF ينشر Attention وFFN على عتاد أكثر ملاءمة لخصائص كل مهمة، محققاً توسعاً مستقلاً وتحسيناً للموارد.
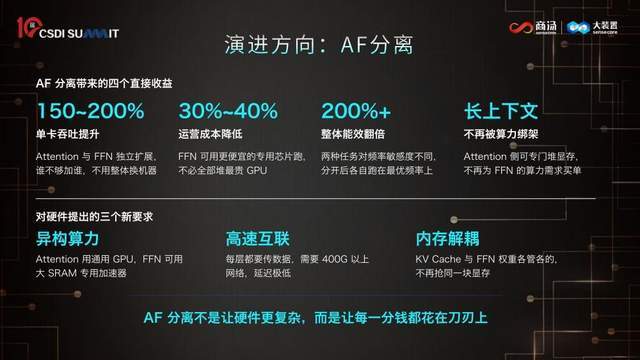
في المستقبل، من المتوقع أن يحقق فصل AF زيادة في إنتاجية البطاقة الواحدة بنسبة 150% إلى 200%، وانخفاض التكاليف التشغيلية بنسبة 30% إلى 40%، ورفع الكفاءة الطاقية الإجمالية إلى أكثر من ضعف القيمة الأصلية. لا تزال هذه المكاسب مرهونة ببنية النموذج المحددة وتكوين العتاد وتنفيذ النظام، لكن فكرتها التقنية واحدة: الاستمرار في تحديد اختناقات الأداء في عملية الاستدلال، ومن خلال تقسيم أكثر دقة للمهام وتخصيص الموارد، رفع كفاءة النظام الإجمالية.
من فصل PD إلى فصل PD عبر النطاقات ثم فصل AF، من المتوقع أن يواصل تطور بنية الاستدلال في المستقبل إطلاق مزايا الأداء والتكلفة للبنية التحتية للاستدلال.
من فن ضبط المعلمات إلى الهندسة النظامية: قياس قيمة الاستدلال بـ SLA والتكلفة
يرى شوان شان مينغ أن تحسين البنية التحتية للاستدلال يجب أن يعود إلى مؤشرين أساسيين: الأول هو جودة الخدمة من الطرف إلى الطرف، أي قدرة النظام على تلبية سرعة الاستجابة وكفاءة التوليد وقدرة التزامن ونسبة نجاح الاستدعاء المتفق عليها؛ والثاني هو التكلفة، أي كمية Token الفعالة التي يمكن أن ينتجها الاستثمار وحدةً في ظل تلبية متطلبات جودة الخدمة تلك.
وهذا يفرض متطلبات أعلى على البنية التحتية. إذ تحتاج الحوسبة المحلية والحوسبة المتقدمة والنماذج المختلفة إلى توافق مستمر، كما أن التكرار السريع للنماذج والتطبيقات يزيد من تعقيد التحسين. فقط بإدخال تكوين العتاد وخصائص النموذج ومتطلبات المهام واستراتيجيات الجدولة في نظام موحد يمكن الاستمرار في إيجاد حلول أفضل من بين توليفات متعددة الأبعاد.
حالياً، تعمل SenseCore على رفع قدرات خدمات الاستدلال واسعة النطاق من خلال نموذج مصنع Token. وقد بلغ متوسط حجم خدمات Token اليومية لمنصة SenseCore 6 تريليون، ويُتوقع أن يحقق حجم خدمات Token على مدار عام 2026 نمواً بمقدار 25 ضعفاً، ليصل في الربع الرابع إلى 10 تريليون Token يومياً.
يعتقد شوان شان مينغ أن ما هو نادر في عصر Agentic ليس الرقائق، بلقدرة النظام على الإنتاج المستمر والمستقر لـ Token بتكلفة منخفضة ومستوى عالٍوهي تغطي منظومة متكاملة تشمل كفاءة النظام والابتكار المعماري وقدرة التسليم الصناعي. ومن الممارسة التقنية إلى تسليم الأعمال، تأمل SenseCore في دفع البنية التحتية للاستدلال من عملية ضبط معلمات معتمدة على الخبرة نحوهندسة نظامية قابلة للقياس والتحسين والقبولبحيث تتحول الاستثمارات في الحوسبة في النهاية إلى طاقة إنتاج مستقرة لخدمات Token.
تم توفير هذا المقال من قبل SenseTime، وأذِنت Quantum Bit بإعادة نشره، وترجع الآراء إلى مؤلفها الأصلي.