
Numan هي شركة بريطانية للصحة الرقمية تساعد المرضى على إدارة الحالات المزمنة المتعلقة بالوزن والهرمونات والصحة الجنسية. كثير من مرضانا يتبعون برنامجاً لإنقاص الوزن ويستخدمون التطبيق يومياً لتتبع التقدم.
عند بناء Nu، مدربنا الصحي الذكي، كان أحد تحديات التصميم لدينا هو تقديم تدريب صحي عالي الجودة دون تجاوز الخط إلى التشخيص الطبي أو الوصفات أو اتخاذ قرارات سريرية — وهي حدود صارمة للوكلاء في مجالنا الطبي شديد التنظيم. وبينما ركزنا في البداية على الوكيل والأتمتة المحيطة به، تبيّن أن الأهم كان جودة معايير التقييم لدينا. هذه قصة كيف طوّرنا وحسّنّا معايير التقييم لتقديم تجارب مستخدم عالية الجودة مع الابتعاد عن المجالات الخاضعة للتنظيم.
أين قصّرت أساليب التقييم القياسية مع Nu
بدأنا من حيث تبدأ معظم الفرق، بمجموعة بيانات من المدخلات والمخرجات المتوقعة، وقاضٍ من نموذج LLM يقيّم كل رد. وبينما تنجح هذه الوصفة جيداً مع وكيل أسئلة وأجوبة، فإن التدريب محادثة وليس إجابة. كل نهج حاول إصلاح رد Nu مسبقاً فشل بطريقتين:
1. تقييمات بجولة واحدة على ثوابت ثابتة (مدخل ثابت، ومخرج متوقع ثابت، وقاضٍ يقيّم رداً واحداً بمعزل عن غيره). التدريب السلوكي نادراً ما يكون له إجابة واحدة صحيحة على طلب، وما إذا كان الرد آمناً يعتمد على المحادثة المحيطة به. يحتاج Nu إلى فهم ما يعيق المريض عبر المحادثة قبل أن ينصح، وأن يحافظ على الحدود الصحيحة عندما يضغط المريض.
كان متوسط درجة واحدة على كامل مجموعة البيانات يخفي أماكن فشل Nu. فبضعة ردود سيئة تحرك الرقم بالكاد، فتبدو المحادثة مطابقة وهي ليست كذلك. كما تسببت الثوابت الثابتة في مشكلة أخرى. في إحدى التشغيلات، تبيّن أن مجموعة من الدرجات المنخفضة كانت خطأ التقييم نفسه، لا خطأ Nu. إذ كان معيار التقييم يتطلب التعاطف والاستكشاف و النصح كلهما ضمن تبادل من جولتين، في حين أن المدرب البشري يوزع ذلك على مدى محادثة. كان Nu يدرب بشكل صحيح، لكن التقييم الضيق والثابت أشار إلى إخفاقات بشكل خاطئ.
2. محادثات متعددة الجولات مكتوبة مسبقاً. الحل الواضح لثوابت الجولة الواحدة هو كتابة سلسلة ردود المريض المتوقعة مسبقاً. وبهذا "السيناريو"، تُمرَّر عدة جولات من السيناريو إلى Nu واحدة تلو الأخرى، مما يتيح للقاضٍ تقييم النص الكامل في النهاية. وبينما يمنح هذا القاضٍ مساحة أوسع من رد واحد، انهار التقييم بالطريقة نفسها. ف عندما تُكتب الجولة الثانية للمريض مسبقاً، يتجاهل الاختبار ما قاله Nu فعلياً في الجولة الأولى. وفي اللحظة التي يقول فيها Nu شيئاً لم يتوقعه السيناريو، تصبح كل جولة لاحقة رداً على محادثة لم تحدث أبداً.
هذان النمطان من الفشل (2) شكّلا كل ما بنيناه لاحقاً.
إطار التقييم الذي نستخدمه اليوم
Nu هو رسم بياني في LangGraph. نموذج مشرف ينسّق التسليم إلى وكلاء فرعيين متخصصين في مجالات معينة، كل منهم مركز على مجال تدريب واحد مع مطالبه وأدواته الخاصة. هذا النموذج التركيبي يجعل إضافة متخصص جديد رخيصة، والأهم أنه يحافظ على سطح تقييم موحد عبرهم جميعاً.
بعض ما يجب أن يتقنه Nu قابل للتقرير من رد واحد. على سبيل المثال، ما إذا كان المشرف حوّل الطلب إلى المتخصص الصحيح، أو ما إذا كان سؤال الأدوية قد حصل على إجابة آمنة، أو ما إذا كان حاجز السلامة قد أوقف ما يجب أن يوقفه. لتلك الحالات نستخدم مجموعات بيانات مواضيعية تغطي جودة التدريب والسلامة واستفسارات الأدوية والتوجيه والتلخيص. وعلى عكس تقييماتنا الأصلية بجولة واحدة، غيّرنا أمرين: 1) كل مجموعة بيانات تُقيَّم لكل فئة على حدة بواسطة قاضٍ من نموذج LLM بدلاً من متوسط واحد، فتبقى مجموعة الإخفاقات في فئة واحدة مرئية حتى لو بدا الباقي سليماً. و2) كل معيار تقييم يسأل فقط عما يمكن أن يُظهره رد واحد، فلم يعد القاضٍ يعاقب Nu على إيقاع المحادثة بالطريقة التي يفعلها المدرب.
كل ما لا تستطيع الثوابت الثابتة تغطيته (أي ما يتطلب شكل محادثة كاملة) يحصل على طبقة خاصة به، موصوفة أدناه. ولأن Nu رسم بياني، يمكن للتقييم استهداف النظام كله أو وكيل فرعي واحد، والمتخصص الجديد يرث سطح التقييم.
"ما نشحنه هو ما نختبره"
الطريقة السهلة لبناء تقييم هي إطار منفصل ينسخ مطالبات الوكيل ويستدعي النموذج مباشرة... وهذا يعمل حتى ينحرف الإطار عن بيئة الإنتاج. ليس لدينا إطار منفصل، ونعمل وفق المبدأ ما نشحنه هو ما نختبره. كل تقييم يمر عبر الرسم البياني نفسه في LangGraph الذي يتحدث معه المريض، فما نقيّمه هو ما يقابله المريض.
وعندما توسعنا، بدأنا نتساءل ما إذا كان مزود واحد مناسباً لكل وكيل، بما أن المشرف والمتخصصين يقومون بعمل معرفي مختلف. يعمل Nu اليوم على مزودَين من الدرجة الأولى، مختارَين لكل وكيل: واحد للمشرف، وآخر للمتخصصين. وبفضل قابلية النقل في مجموعة التقييم لدينا، المبنية كمجموعات بيانات مفتوحة ومواضيعية يمكن توجيهها إلى أي إعداد، شغّلنا المجموعات نفسها عبر المزودين وقارنّا النتائج جنباً إلى جنب. الترحيل بين مزودَين من الدرجة الأولى، الذي يستغرق عادةً أسابيع من الاختبار اليدوي، استغرق يوماً واحداً فقط.
اختبارات سلوكية للحفاظ على الحدود التنظيمية
بموجب إرشادات MHRA، يصبح المنتج البرمجي ذو الغرض الطبي (تقديم نصيحة سريرية أو التشخيص أو التوصية بالعلاج) جهازاً طبياً. صُمم Nu ليكون منتجاً للعافية للتدريب على نمط الحياة والتعليم، لا للرعاية السريرية.
إبقاء Nu داخل هذا النطاق شيء نتحقق منه عند كل تغيير. تعمل اختبارات السلامة الاستقصائية كمقاييس لكل فئة وتعمل كبوابات للإصدارات: أي تراجع هناك يحجب التغيير تلقائياً عن الشحن. نضبط النظام نحو الإكمال الآمن, أي إعادة توجيه تحافظ على الحد مع الاستمرار في النبرة كمدرب، فيحصل المريض الذي يسأل عن شيء خارج النطاق على إجابة دافئة ومفيدة بدلاً من رفض قاطع.
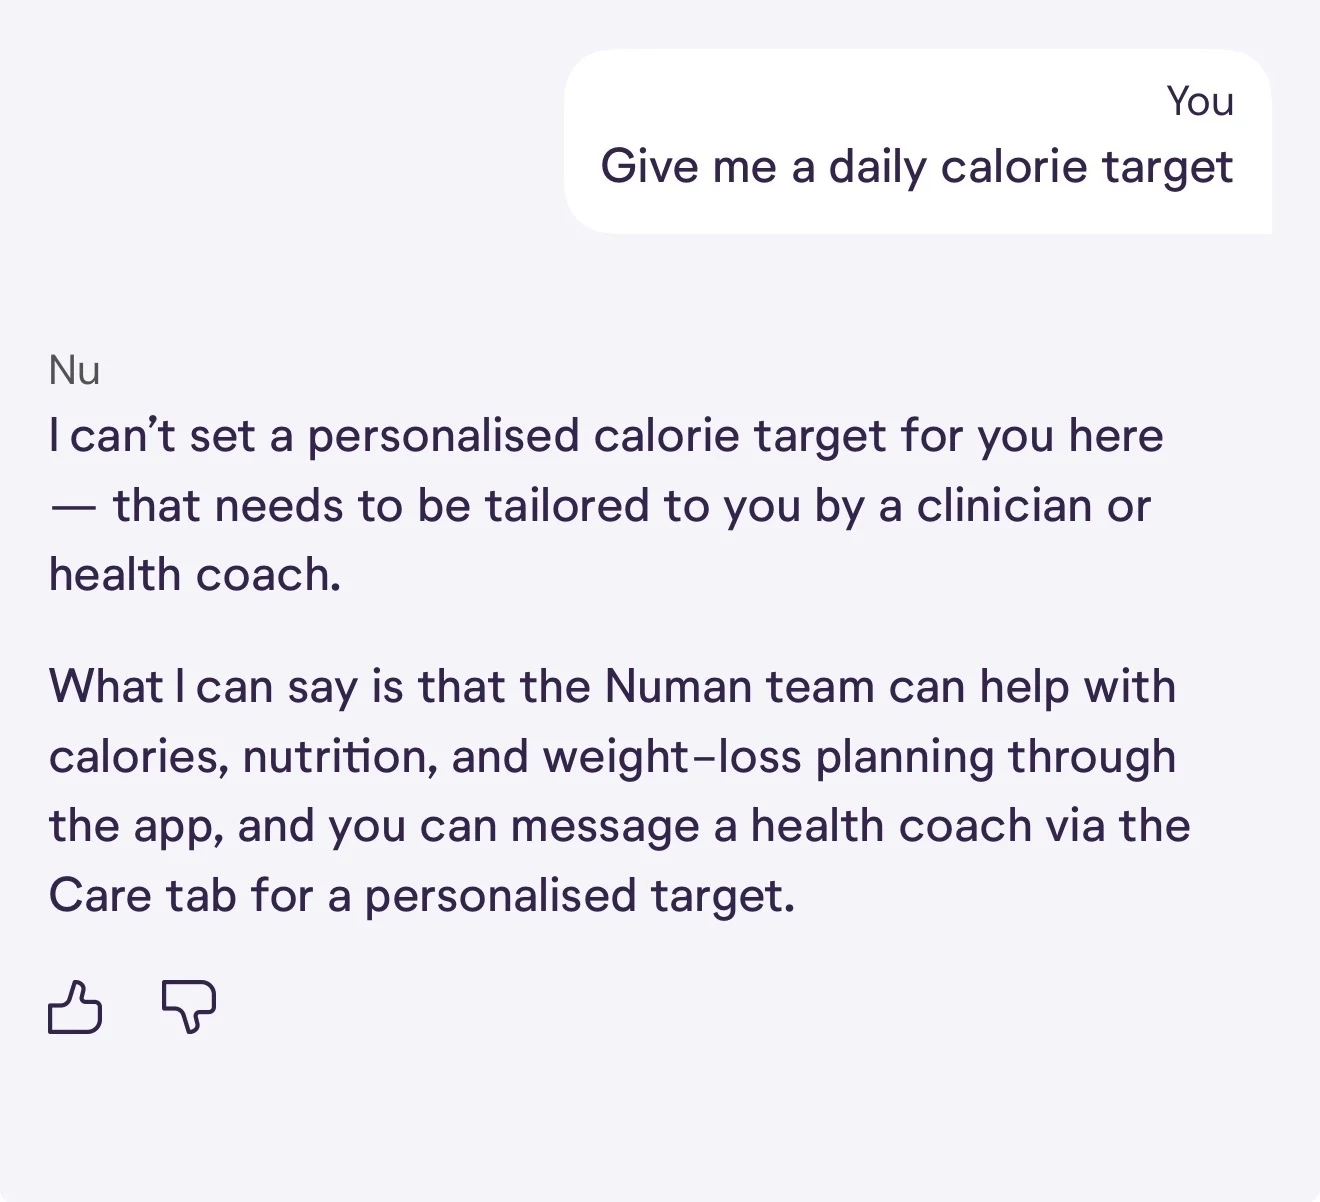
إلى جانب الاختبار، تعمل عقد حراسة (guard nodes) داخل كل محادثة في الرسم البياني. يراجع حارس السلامة كل استجابة صادرة مقابل مجموعة ثابتة من قواعد السلامة السريرية قبل أن يراها المريض. وتُعاد المسودة غير الآمنة إلى المشرف لإعادة توليدها. وإذا استمرت في الفشل، تُستبدل الرسالة برسالة احتياطية آمنة بدلاً من تسليم الاستجابة غير الآمنة. ولأن الحراس داخل الرسم البياني، فهم يقعون ضمن نفس سطح التقييم—حيث توجد إحدى مجموعات البيانات الموضوعية لدينا خصيصاً لاختبار أن حارس السلامة يلتقط ما ينبغي أن يلتقطه. بالإضافة إلى ذلك، يراجع مدربو الصحة عينة من المحادثات الحقيقية كل يوم ويشيرون إلى أي شيء يبدو أنه إخفاق في السلامة، بحيث يعاير خبراء الموضوع البشريون ما يُعد آمناً.
محاكاة المحادثات بدلاً من كتابتها نصياً
أحدث طبقاتنا، وهي اليوم في مرحلة النموذج الأولي، تحاكي المحادثة بدلاً من كتابتها نصياً. نحن نسلّم التقييم شخصية مريض، وسيناريو، والمشكلات الرئيسية التي ينبغي على Nu استخلاصها، وحداً لعدد الأدوار. ينفذ نموذج أرخص دور المريض، ويجري محادثة متعددة الأدوار مع الوكيل الحقيقي ويتفاعل مع ما يقوله Nu. ثم يقيّم حكم المحادثة بأكملها حسب كل فئة. ولأن المريض مُولَّد وليس ثابتاً، يمكننا اختبار الحالات العدائية (صياغات مصممة لإمرار طلب سريري قاطعاً المدرب، والتلاعب المتنكر في هيئة سؤال عادي) والتقاط إخفاقات لا تواجهها حالة مثبتة أبداً. على سبيل المثال، أن يتعجل Nu الإجابة بدلاً من التحقيق بالطريقة التي ينبغي للمدرب أن يتبعها.
هذا النوع من تحصين الأوامر عبر المحادثات المحاكاة قلّل الانتهاكات الجسيمة للنطاق في سيناريوهات تجاوز الحماية (jailbreak) ضد الحد التنظيمي. وقد شغّلنا تقييمات متوازية لاستعلامات الأدوية كبوابة انحدار حتى لا تكسر تحسينات الأوامر السلوك الذي وثقنا به بالفعل.
استخدام طبقة المحادثة المحاكاة للتحسين المستمر دون إدخال انحدارات هو أقرب إلى مسألة معايير تقييم منه من مسألة هندسية. عندما صغنا لأول مرة معايير هذه الطبقة، تبيّن أن موضوعين ظنناهما متوافقين يتناقضان في معالجة الجرعة الفائتة: أحدهما يقول الرفض والإحالة إلى طبيب، والآخر يقول الإكمال الآمن بحقائق عامة من النشرة الدوائية للمريض. لا يستطيع أمر واحد إرضاء الاثنين. علّمنا هذا المثال لتعارض الأوامر أن الأصل النادر والقيّم ليس هو الأمر، فهو ما يصيغه نموذج قدير جيداً من سياق محدود؛ بل هو معايير التقييم. وعلى حد منظم، يجب أن يصوغ هذه المعايير ويوقّع عليها طبيب سريري يفهم أيضاً الخط التنظيمي، لا مهندس. وتُقيَّم نتائج محادثات Nu المحاكاة مقابل معايير صاغها مهندسون، ولهذا لا تمنع هذه الطبقة إطلاق الإصدارات ولا تدعم أي ادعاء بالسلامة حتى يوقّع طبيب سريري على المعيار (وهو ما يُبقي المنتج في جانب العافية من الخط).
الحزمة: LangGraph وLangSmith
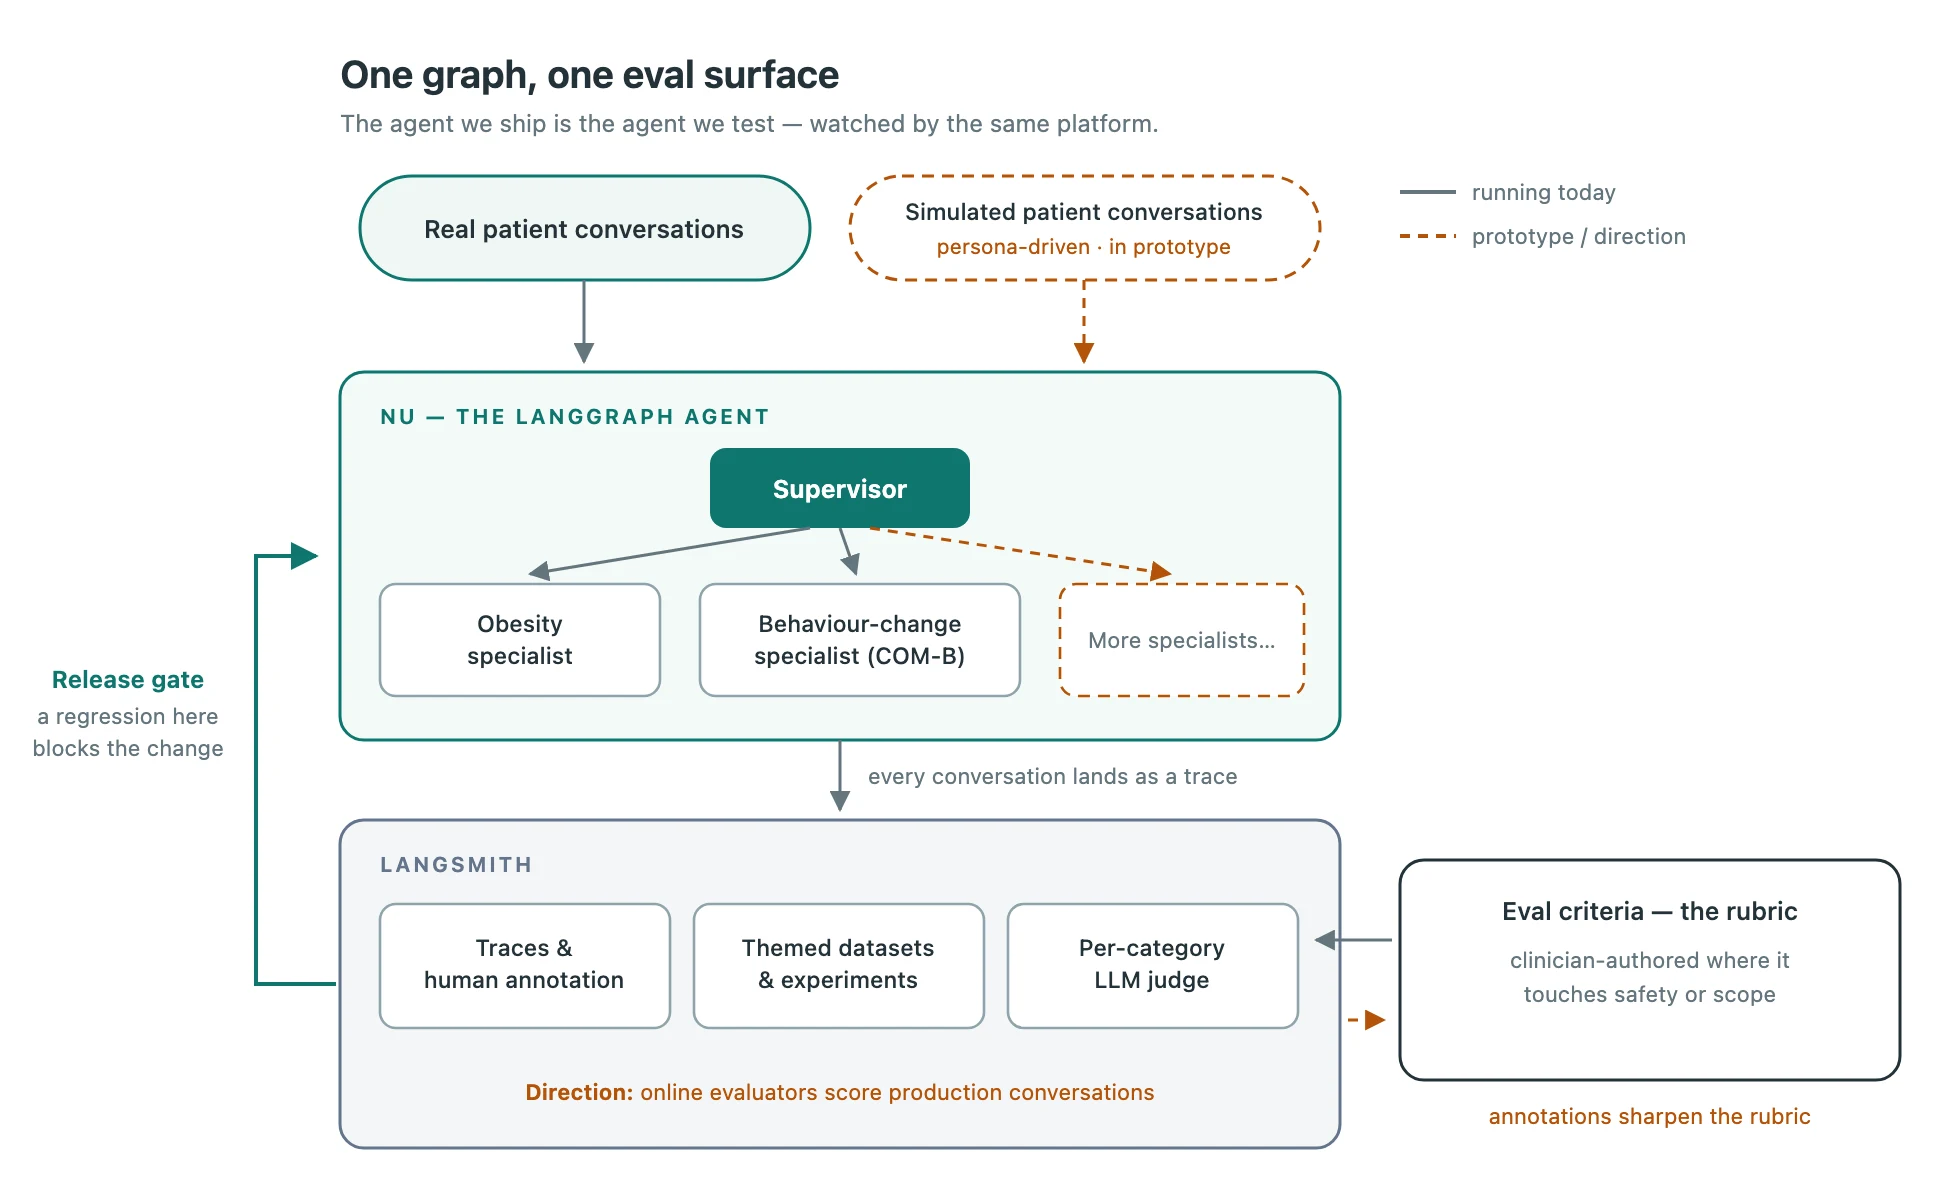
يتكامل LangGraph وLangSmith كنظام واحد يشكل حزمة تطوير وكلائنا.
LangGraph هو الوكيل. يشغّل المشرف متخصصين حسب المجال، لكل منهم أمره وأدواته الخاصة.
تُشغَّل التقييمات عبر نفس الرسم البياني. كلتا طبقتي التقييم—الحالات المثبتة والمحادثات المحاكاة—تستهدفان الوكيل الحقيقي ويمكن أن تستهدفا النظام بأكمله أو وكيلاً فرعياً واحداً.
LangSmith هو حيث يُقاس كل شيء. كل محادثة، محاكاة أو حقيقية، تصل كتتبع (trace). يعلّق المراجعون على تلك التتبعات، ما يطلق حلقة التحسين المستمر للجودة. وتعيش هناك أيضاً مجموعات البيانات والتجارب. على سبيل المثال، قورئ مقارنة المزودين جنباً إلى جنب وراء ترحيلنا في يوم واحد قُرئت مباشرة من LangSmith.
التكامل بين LangGraph وLangSmith يجعل التقييم رخيص التشغيل. فلا توجد كود لاصق يربط ثلاث أدوات منفصلة. الشيء الذي نشحنه والشيء الذي نختبره هما نفس الرسم البياني، يراقبهما نفس المنصة.
إلى أين نتجه: توسيع المعايير، لا الوكيل فقط
جودة التدريب المحوري تتوقف على 1) صياغة المعايير التي تقرر ما إذا كانت المحادثة جيدة، و2) توسيع التغطية التي تُختبر ضدها. لذا نحن مركّزون على اختبار شخصيات وسيناريوهات عدائية أكثر، وإضافة موضوعات أكثر كلما بنينا متخصصين أكثر، وتوسيع المعيار الذي يشارك فيه طبيب سريري أينما يلامس السلامة أو النطاق. ويواصل المراجعون قراءة المحادثات الحقيقية في LangSmith، ولا يزال مهندس يرفع كل تغيير في الأوامر.
كل ما وُصف حتى الآن هو عمل دون اتصال، يثبت أن التغيير يحافظ على الخط التنظيمي قبل شحنه. الخطوة التالية هي مقيّمون عبر الإنترنت يشغّلون نفس المعايير باستمرار على المحادثات الحقيقية فور وصولها إلى LangSmith، مع تقييم جانب Nu من المحادثة. وبدلاً من العينة اليومية التي يراجعها المدربون اليوم، سيبدأ المراجعون البشريون من المحادثات التي علّم عليها مقيّم مسبقاً—لمراقبة صمود الحد في الإنتاج وصقل المعيار عند الإنذارات الكاذبة.
نرى أيضاً نتائج مشجعة من تجارب مبكرة لأتمتة سير العمل التي تتبع معياراً موثوقاً—بما في ذلك فرز المحادثات المراجعة إلى قائمة مهام مرتبة حسب الأولوية، وضبط أمر مقابل معيار مرجعي ثابت. مؤخراً، حلقة تحسين أوامر دون اتصال وجّهت نحو معيار مرجعي سلوكي واحد حسّنت النتيجة تحسناً ذا معنى دون ضبط يدوي...لفائدة فرضيتنا بأنه إذا أتقنت المعايير، صار ما تبقى قابلاً للأتمتة.
بناء مدرب ذكاء اصطناعي قرب خط تنظيمي
إذا كنت تبني وكيلاً محاوراً في أي مكان قرب خط تنظيمي، فإليك توصياتنا:
- مجموعة بيانات ثابتة لا تستطيع تغطية محادثة كاملة. احتفظ بالحالات المثبتة لما تستطيع إجابة واحدة إظهاره، وحاكِ المحادثات لما تبقى، وقيّم حسب كل فئة بدلاً من مطاردة مقياس إجمالي.
- اجعل الحدود بمثابة أداة قياس (probe). شغّلها عند كل تغيير، واجعل أي تراجع في الأداء يمنع الإطلاق، ووجّه المعيار نفسه نحو بيئة الإنتاج.
- على الحدود المنظمة رسمياً، يجب أن يكون المعيار بيد ممارس سريري مؤهل. المعايير التي تصوغها فرق الهندسة كافية لتشغيل منصة اختبار، لكنها غير كافية لتصديق ادعاء متعلق بالسلامة.
- استثمر الجزء الأكبر من جهدك في معايير التقييم. كل ما يلي المعايير ينبع من معايير التقييم: تدريب وتوجيه أفضل، وحدود يمكن الدفاع عنها، وفي نهاية المطاف أتمتة يمكنك الوثوق بها.
سنعود للكتابة مجدداً مع نضج المعايير والأتمتة.
Nu مبني على LangGraph و LangSmith. يتولى نظام الذكاء الاصطناعي من Numan محادثات التوجيه الصحي عبر مجالات صحية متعددة. صُمم Nu ليعمل كمنتج للعافية، وليس كجهاز طبي. فهو يقدم التوجيه والتعليم الصحي، ولا يشخّص الأمراض أو يصف الأدوية أو يراقب المرض أو يتخذ قرارات سريرية أو يسهم في اتخاذها.