
تبني أعباء العمل الوكيلية متعددة الأدوار على سياق متراكم بينما يستدل الوكيل ويستدعي الأدوات ويضمّن النتائج السابقة. مع كل دور جديد، يعيد العميل إرسال سجل المحادثة، بما في ذلك تعليمات النظام والمطالبات السابقة ونتائج الأدوات واستجابات النموذج، مما يتسبب في معالجة السياق المتنامي بشكل متكرر. في تفكيك التعبئة المسبقة وفك الترميز (P-D)، يُقسَّم كل طلب عبر عُقد متخصصة: تعالج عقدة التعبئة المسبقة المطالبة وتبني ذاكرة الاسمية-القيمة (KV) المؤقتة الخاصة بها، ثم تسترجع عقدة فك الترميز كتل KV تلك وتولّد الاستجابة.
غير أنّ الخدمة المفكّكة التقليدية تنقل ذاكرة KV المؤقتة في اتجاه واحد فقط: من عقدة التعبئة المسبقة إلى عقدة فك الترميز. هذا التدفق أحادي الاتجاه يخلق قصورين في أعباء العمل متعددة الأدوار. أولًا، بعد توليد استجابة، تحتفظ عقدة فك الترميز بإدخالات ذاكرة KV المؤقتة لكل من المطالبة والرموز المولّدة حديثًا. وعند معالجة الدور التالي، لا تستطيع عقدة التعبئة المسبقة استرجاع تلك الإدخالات، فتضطر إلى إعادة حساب إسقاطات KV لرموز الاستجابة السابقة. ثانيًا، تحتفظ عقدة فك الترميز بحالة الجلسة بينما لا تفعل عقد التعبئة المسبقة، مما يزيد احتمال إخلاء ذاكرة التخزين المؤقت للجلسات النشطة على عقد التعبئة المسبقة. وفي حال عدم توفر في الذاكرة المؤقتة بالكامل، يجب على عقدة التعبئة المسبقة إعادة حساب إسقاطات KV لسجل المحادثة بأكمله، بما في ذلك تعليمات النظام وطلبات المستخدم السابقة ونتائج الأدوات والاستجابات المولّدة من النموذج. ومع نمو المحادثة، يستهلك هذا العمل الزائد المزيد من سعة المسرّع ويزيد زمن الوصول إلى الرمز الأول (TTFT).
عند بنائك للمساعدين المحادثاتيين والتطبيقات الوكيلية، يمكن لسجلات التفاعل الأطول أن تزيد زمن الاستجابة وتستهلك سعة المسرّع من خلال حساب التعبئة المسبقة المتكرر. في هذه المقالة، نوضح كيف يتيح نقل ذاكرة KV المؤقتة ثنائي الاتجاه لعُقد التعبئة المسبقة وفك الترميز إعادة استخدام السياق المحسوب مسبقًا عبر الأدوار، مما يحسّن استغلال المسرّع ويساعد التطبيقات في الحفاظ على TTFT سريع الاستجابة مع نمو المحادثات.
في معايير الأداء متعددة الأدوار لدينا على نشر 1P1D باستخدام مثيلات Amazon Elastic Compute Cloud (Amazon EC2) P5en، خفّض نقل KV ثنائي الاتجاه TTFT بمقدار يصل إلى 1.6x لـ Qwen3-32B وحتى 3.3x لـ zai-org/GLM-5-FP8 (انظر قسم بيانات الأداء). وتختلف النتائج تبعًا لعبء العمل والتكوين. المثيلات متصلة عبر AWS Elastic Fabric Adapter (AWS EFA)، وهي شبكة وصول مباشر للذاكرة عن بُعد (RDMA) منخفضة زمن الاستجابة تُستخدم عبر الخوادم في AWS. وعلى أنواع المثيلات المدعومة، يدعم AWS EFA تقنيتي GPUDirect RDMA وNeuron Direct RDMA لنقل كتل KV مباشرة بين ذاكرة وحدة معالجة الرسومات أو جهاز AWS Trainium على عُقد التعبئة المسبقة وفك الترميز.
بنينا الميزة في الأصل وثبّقناها على عناقيد مثيلات AWS Trainium المتصلة عبر EFA وساهمنا بها في vLLM كقدرة مستقلة عن نوع المسرّع. النتائج المعروضة هنا من عنقود GPU على Amazon EC2 P5en مع EFA، مما يبيّن أن الفوائد تنطبق أيضًا على وحدات معالجة الرسومات. تشرح هذه المقالة بنية نقل KV ثنائي الاتجاه، وتدفق بيانات وصف الموجّه، وضوابط الاحتفاظ بكتل KV وإعادة الحساب، ونتائج الأداء، وكيفية إعادة إنتاج المعيار.
نقل KV ثنائي الاتجاه
نقل KV ثنائي الاتجاه هو آلية تُعيد بها عقدة فك الترميز KV المحسوب مسبقًا إلى عقدة التعبئة المسبقة في الأدوار اللاحقة من المحادثة. يتجنّب ذلك إعادة حساب السياق المشترك على عقدة التعبئة المسبقة ويحكمه حدّ قابل للتهيئة لإعادة حساب KV. تخفّف هذه الآلية من كلا سيناريوَي التكرار الحسابي الموصوفين سابقًا. ولكي تعمل، يجب أن تنجُو KV بعد الدور الذي أنتجه وأن تنتقل في الاتجاه المعاكس، بتنسيق من موجّه واعٍ بذاكرة KV المؤقتة.
تحسينات موصّل NIXL KV للنقل ثنائي الاتجاه
وسّعنا مكتبة NVIDIA Inference Xfer Library (NIXL) موصّل KV لتمكين عُقد التعبئة المسبقة من استهلاك كتل KV البعيدة، على غرار الطريقة التي تستهلك بها عُقد فك الترميز بالفعل كتل KV التي توفرها عقدة التعبئة المسبقة. وليس هذا تغييرًا بسيطًا، لأن نوعي العُقد مختلفان معماريًا: تحسب عُقد التعبئة المسبقة تمثيلات KV لرموز المطالبة الجديدة ويمكنها توفير كتل KV كاملة للمطالبة. أما عُقد فك الترميز فتفتقر إلى القدرة (أو الكفاءة) على توليد تمثيلات KV كاملة ولا يمكنها سوى تقديم كتل KV المخزّنة مؤقتًا سابقًا. نتيجة لذلك، تحتفظ عُقد التعبئة المسبقة وفك الترميز بأدوارها ومنطقها الخاص لحساب البيانات الوصفية لكتل KV البعيدة والمحلية. لكن آلية نقل KV الفعلية (NIXL READ) مشتركة بين كلا الاتجاهين P->D و D->P الاتجاه الآخر.
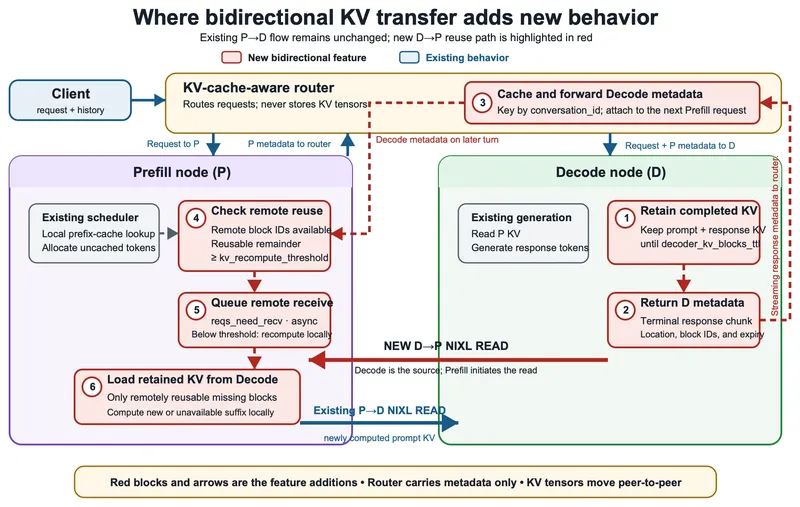
يوضّح المخطط التالي أولاً التدفق الحالي باللون الأزرق. يرسل الموجّه الطلب إلى عقدة prefill، فتحسب عقدة prefill الـ KV الخاص بالـ prompt وتُعيد بياناتها الوصفية للكتل، ثم يعيد الموجّه توجيه الطلب والبيانات الوصفية إلى عقدة decode لإجراء NIXL READ القياسي من النوع P→D. يوضّح المسار الأحمر المرقّم الإضافات الخاصة بنقل KV ثنائي الاتجاه: (1) تحتفظ عقدة decode بكتل KV المؤهلة بعد التوليد، (2) تُعيد بياناتها الوصفية في استجابة البث، و(3) يخزّن الموجّه تلك البيانات الوصفية مؤقتاً لطلب prefill التالي. ثم (4) تتحقق عقدة prefill من الـ KV القابل لإعادة الاستخدام عن بُعد بعد تطبيق مطابقات ذاكرة التخزين المؤقت المحلية، (5) تضع استقبالاً غير متزامن في قائمة الانتظار عندما يبلغ عدد الرموز القابلة لإعادة الاستخدام الحد المحدد، و(6) تُجري NIXL READ من النوع D→P قبل حساب اللاحقة المتبقية.
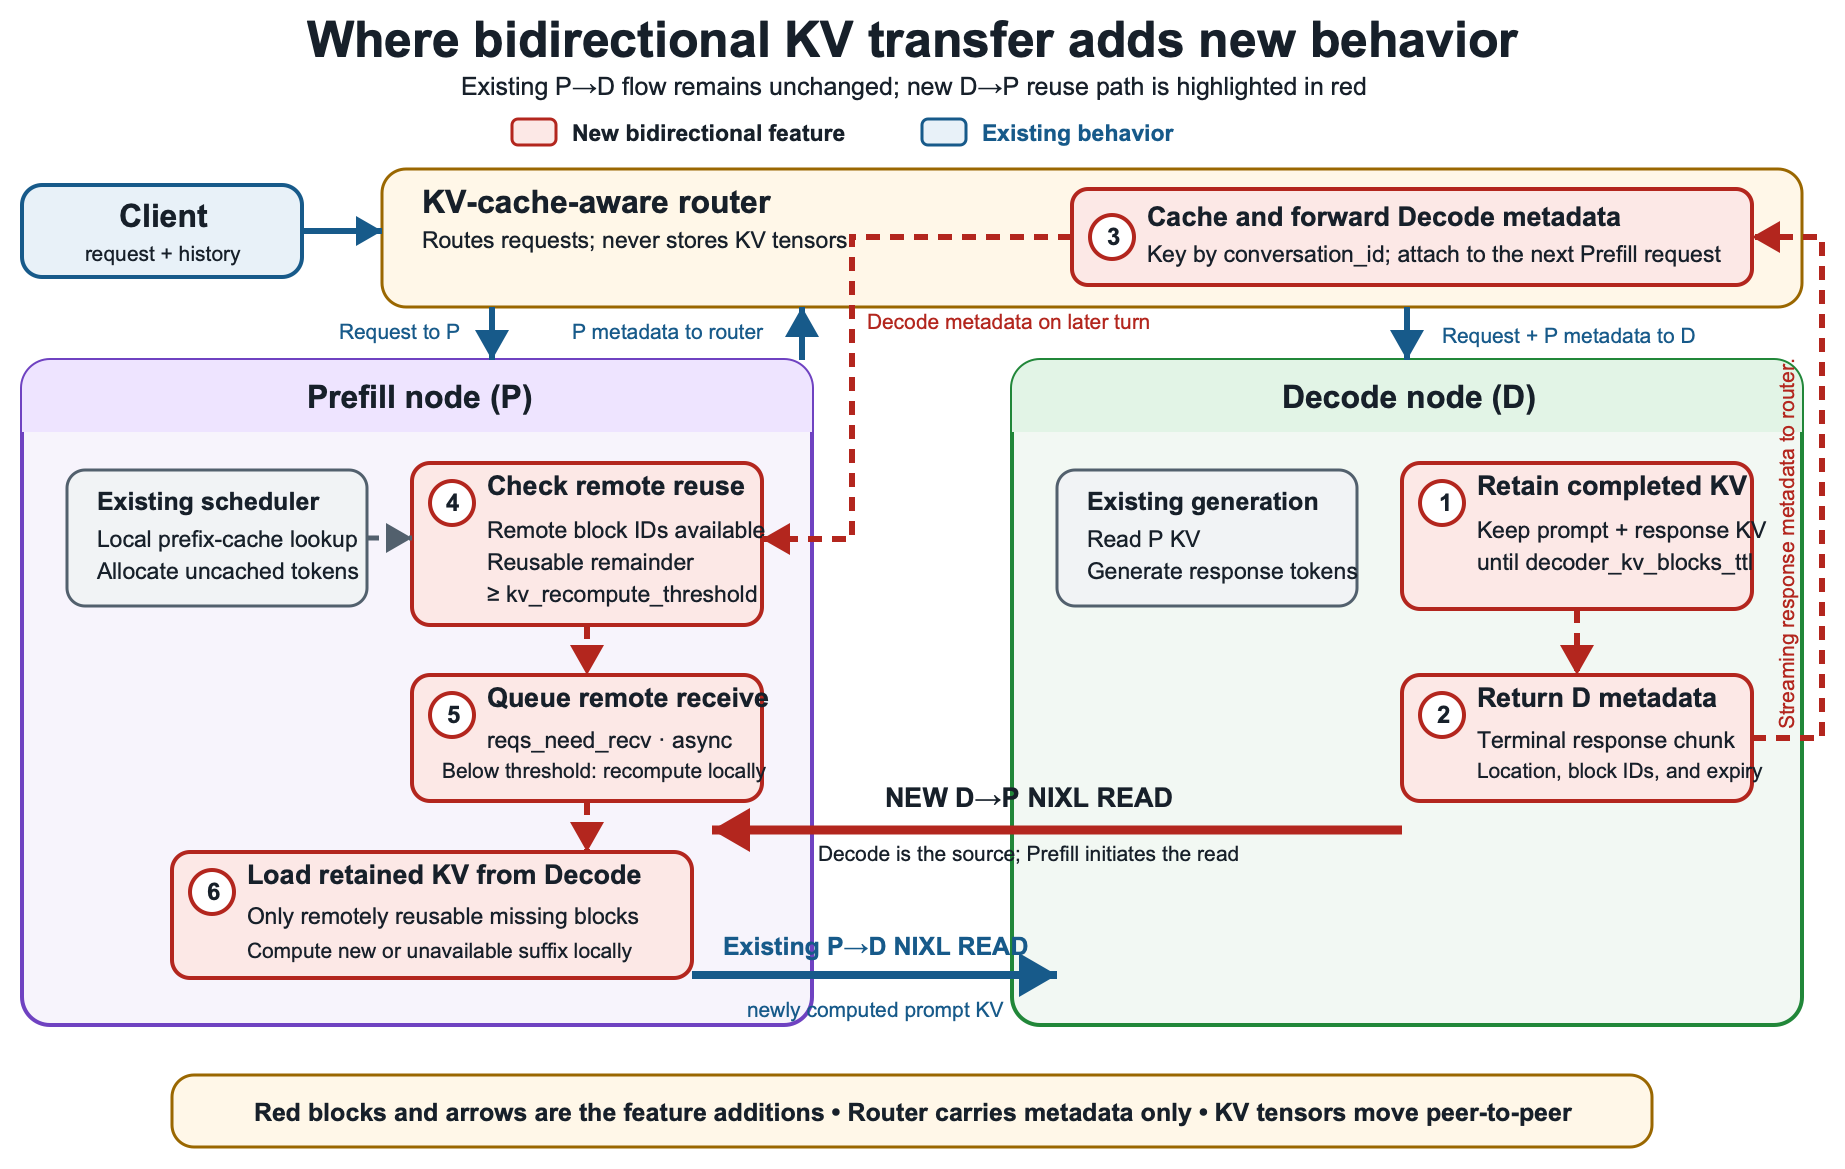
الشكل 1: تدفق prefill-to-decode القياسي (باللون الأزرق) والإضافات الخاصة بنقل KV ثنائي الاتجاه (باللون الأحمر)
موجّه يدرك ذاكرة التخزين المؤقت للـ KV
تتضمن vLLM دعماً من جهة الموصل لنقل KV ثنائي الاتجاه، بينما تتطلب تنسيق إعادة استخدام KV عبر أدوار المحادثة وجود موجّه يدرك ذاكرة التخزين المؤقت للـ KV. يوفّر GitHub الخاص بـ vLLM بروكسي مثالاً يطبّق التدفق المستخدم في هذا المقال ويمكن تكييفه ليناسب بيئتك.
الموجّه الذي يدرك ذاكرة التخزين المؤقت للـ KV هو مكوّن خفيف الوزن وذو حالة في مستوى التحكم بين العميل وعقدتي prefill وdecode. يحتفظ بخرائط في الذاكرة من conversation_id الذي يقدّمه العميل إلى kv_transfer_paramsالخاص بـ decode. يخزّن الموجّه بيانات موقع الكتل الوصفية فقط، وليس مصفوفات KV، ويحصل على تلك البيانات الوصفية من تدفق الاستجابة بدلاً من الاستعلام عن عقدة decode بشكل منفصل.
يوضّح المخطط التالي كيف يدير الموجّه البيانات الوصفية للـ KV عبر أدوار المحادثة. في الدور الأول، تُفشل عملية البحث في ذاكرة التخزين المؤقت ويتبع الطلب تدفق P→D القياسي. ثم يحفظ الموجّه البيانات الوصفية الخاصة بـ decode من تدفق الاستجابة. في الأدوار اللاحقة، يسترجع الموجّه تلك البيانات الوصفية باستخدام conversation_id بحيث يمكن لـ prefill إعادة استخدام KV من decode. ثم يحدّث البيانات الوصفية بعد التوليد استعداداً للدور التالي.
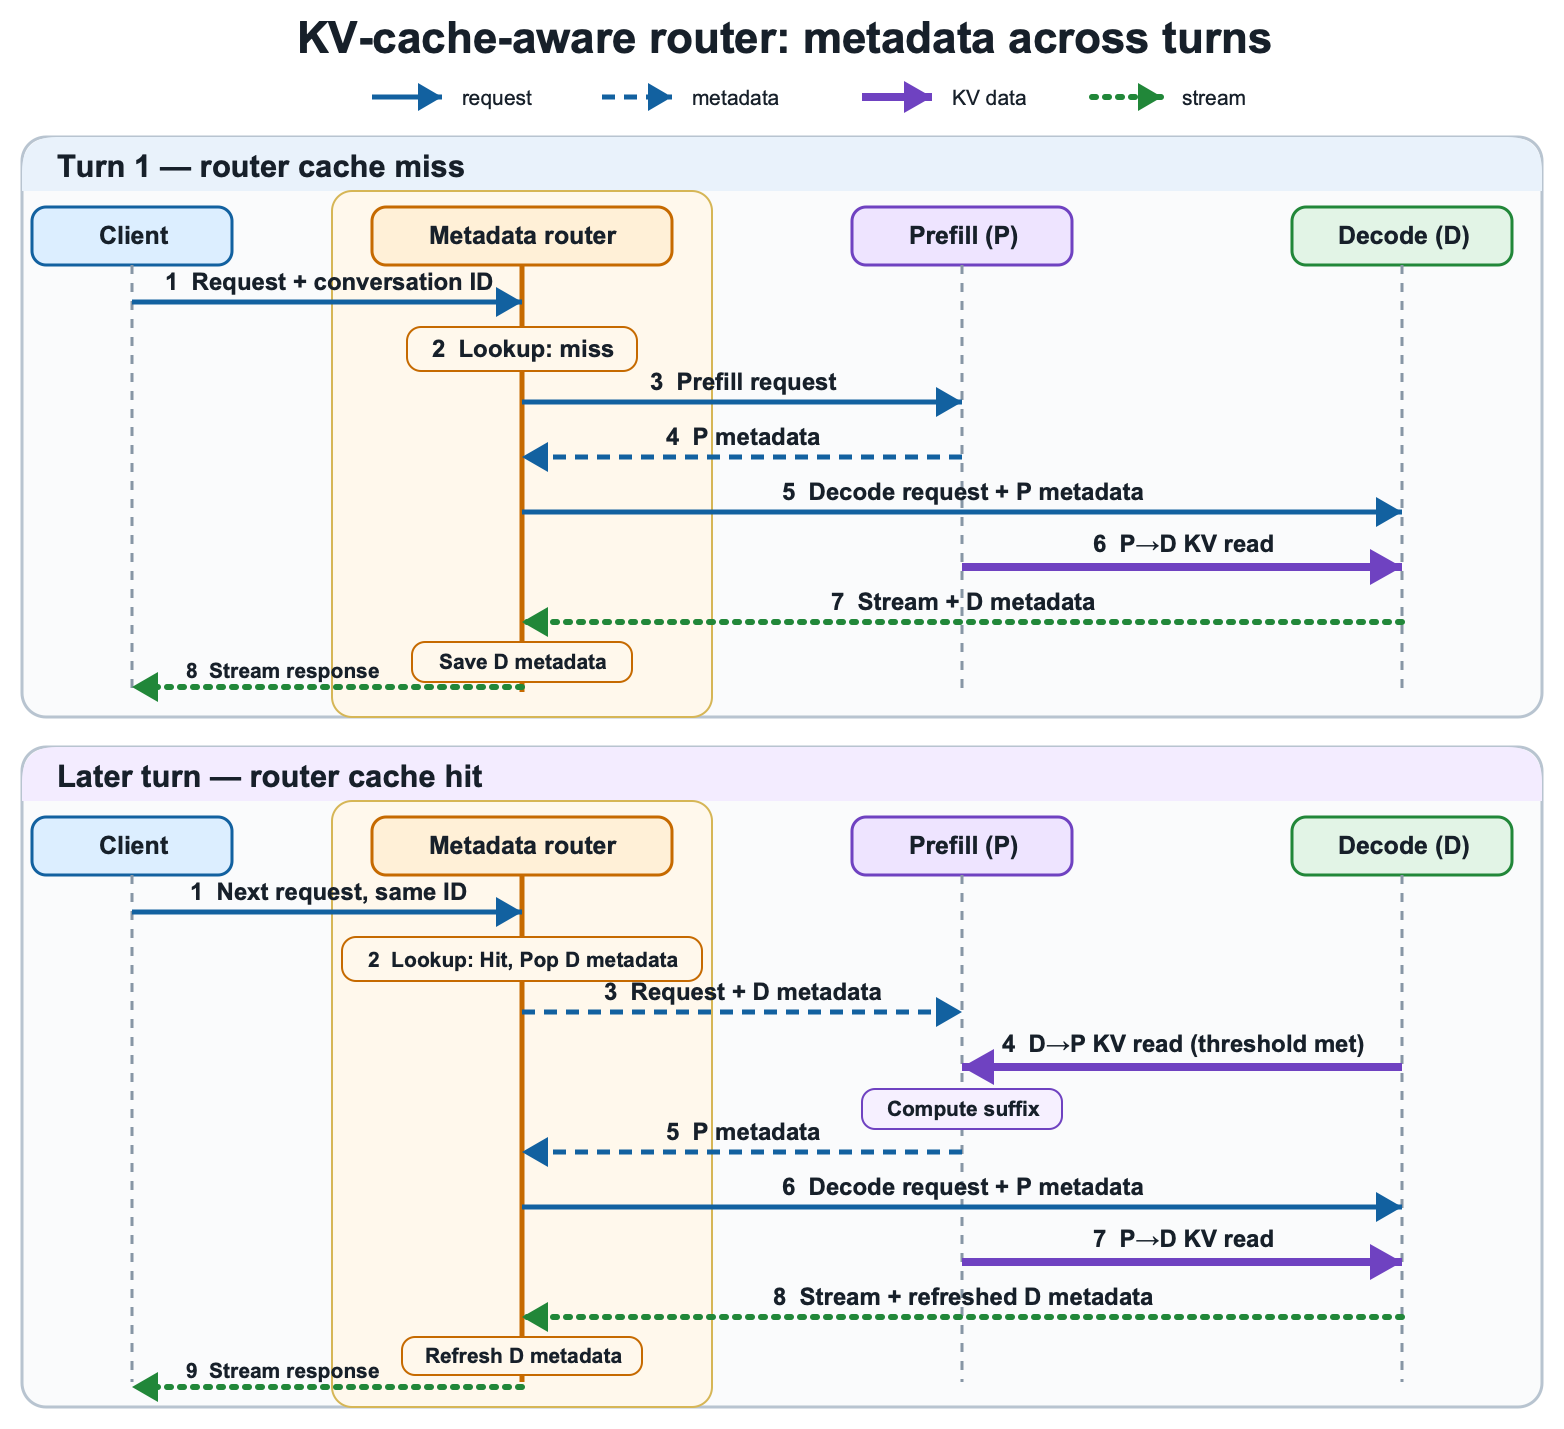
الشكل 2: تدفق البيانات الوصفية للموجّه الذي يدرك ذاكرة التخزين المؤقت للـ KV عبر أدوار المحادثة
مدة احتفاظ TTL للكتل
في الأحوال العادية، تحرّر نسخة decode كتل الطلب فور انتهاء التوليد. في وضع نقل KV ثنائي الاتجاه، تحتفظ بها لمدة قابلة للتهيئة (decoder_kv_blocks_ttl، افتراضياً 480 ثانية) وتنشر موقعها وموعد انتهاء صلاحيتها. وهكذا يبقى KV المحادثة، بما يشمل بادئة الـ prompt والاستجابة المولّدة، متاحاً للدور التالي. أما الدور الذي يصل قبل انتهاء مدة البقاء (TTL) فتعيد عقدة prefill استخدام الـ KV فيه، بينما يعود الدور الذي يصل لاحقاً إلى prefill العادي. ولأن مدة البقاء هذه ثابتة وغير متجددة، اضبطها وفق الوقت المتوقع بين الأدوار لموازنة إعادة استخدام الـ KV مقابل استهلاك ذاكرة المسرّع. التحسين الطبيعي التالي هو تمديد عقد الإيجار المتجدد عبر إشارة نبض الجهاز إلى جانب decode، بحيث تستطيع نسخة decode حينئذٍ استعادة الكتل بمجرد أن تصبح المحادثة خاملة بدلاً من نهاية مؤقّت ثابت.
حد إعادة حساب الـ KV
إعادة استخدام الـ KV ليست دائماً أسرع من إعادة الحساب المحلي. فبالنسبة لبادئة قصيرة قابلة لإعادة الاستخدام، قد تتجاوز تكاليف الترابط والتنسيق الوقت اللازم لإعادة حساب الرموز. ويتحكم في هذا القرار إعداد kv_recompute_threshold ، الذي تبلغ قيمته الافتراضية 64 رمزاً. تعيد عقدة prefill الحساب عندما يكون عدد الرموز المطلوب حسابها أقل من الحد، وتسحب الـ KV من عقدة decode عندما يساوي الحد أو يتجاوزه. ويمكن للأنظمة المنشورة ضبط هذه القيمة بناءً على زمن حساب النموذج وحجم الـ KV وأداء الترابط.
بيانات الأداء
للتقييم، استخدمنا نموذجي Qwen3-32B وGLM-5-FP8 على نشر 1P1D باستخدام نسخ Amazon EC2 P5en المتصلة عبر EFA. ولمحاكاة السيناريوهات التي تكون فيها عقدة prefill قد أزالت ذاكرة التخزين المؤقت المحلية أو يختار فيها الموجّه عقدة prefill مختلفة لا تحتوي كتل KV الخاصة بالمحادثة، عطّلنا التخزين المؤقت للبادئات على عقدة prefill باستخدام --no-enable-prefix-caching.
في كلا النموذجين، يؤدي تشغيل نقل KV ثنائي الاتجاه إلى تقليل حساب prefill في المحادثات متعددة الأدوار، وتنمو الفائدة عادةً مع طول الـ prompt. مع إيقاف الميزة، تعيد نسخة prefill حساب السياق الكامل المتنامي في كل دور، فيرتفع زمن TTFT بشكل حاد. يصعد Qwen3-32B من 158 مللي ثانية عند 2k إلى 778 مللي ثانية عند 24k، بينما يرتفع GLM-5-FP8 من 500 مللي ثانية عند 2k إلى 2,334 مللي ثانية عند 20k. وعند تشغيله، تُعاد استخدام الـ KV المحتفظ به لدى نسخة decode بدلاً من إعادة حسابه، فيبقى زمن TTFT أكثر استواءً بكثير. يرتفع Qwen3-32B فقط من 122 مللي ثانية إلى 460 مللي ثانية عبر النطاق نفسه (أي انخفاض بنحو 1.6x عند أطول prompt)، بينما يرتفع GLM-5-FP8 من 358 مللي ثانية إلى 702 مللي ثانية ويعمل بمعدل ينخفض حتى 3.3x عن مسار إعادة الحساب عند الـ prompts الطويلة. ويوضّح تفصيل مدة prefill سبب ذلك.
يضيف النقل ثنائي الاتجاه زمناً صغيراً لنقل الـ KV (نحو 30 مللي ثانية إلى 130 مللي ثانية لـ Qwen3-32B؛ ونحو 29 مللي ثانية إلى 110 مللي ثانية لـ GLM-5-FP8)، لكن حساب prefill الذي يُزيله يفوق ذلك الزمن بكثير. ونتيجة لذلك، تبقى مدة prefill الإجمالية مع تشغيل النقل (Qwen3-32B: من 128 مللي ثانية إلى 414 مللي ثانية؛ GLM-5-FP8: من 316 مللي ثانية إلى 541 مللي ثانية) أقل بكثير من مسار إعادة الحساب فقط (Qwen3-32B: من 153 مللي ثانية إلى 744 مللي ثانية؛ GLM-5-FP8: من 500 مللي ثانية إلى 2,331 مللي ثانية). ويُظهر النموذج الأكبر GLM-5-FP8 فجوة أكبر مطلقة ونسبية، إذ إن زمن إعادة الحساب الأعلى لكل رمز يجعل إعادة استخدام الـ KV أكثر جدوى مع توسّع النماذج والسياقات.
Qwen3-32B
يرسم المخطط التالي علاقة TTFT بطول الـ prompt لـ Qwen3-32B، مقارنةً بين تشغيل نقل KV ثنائي الاتجاه وإيقافه.
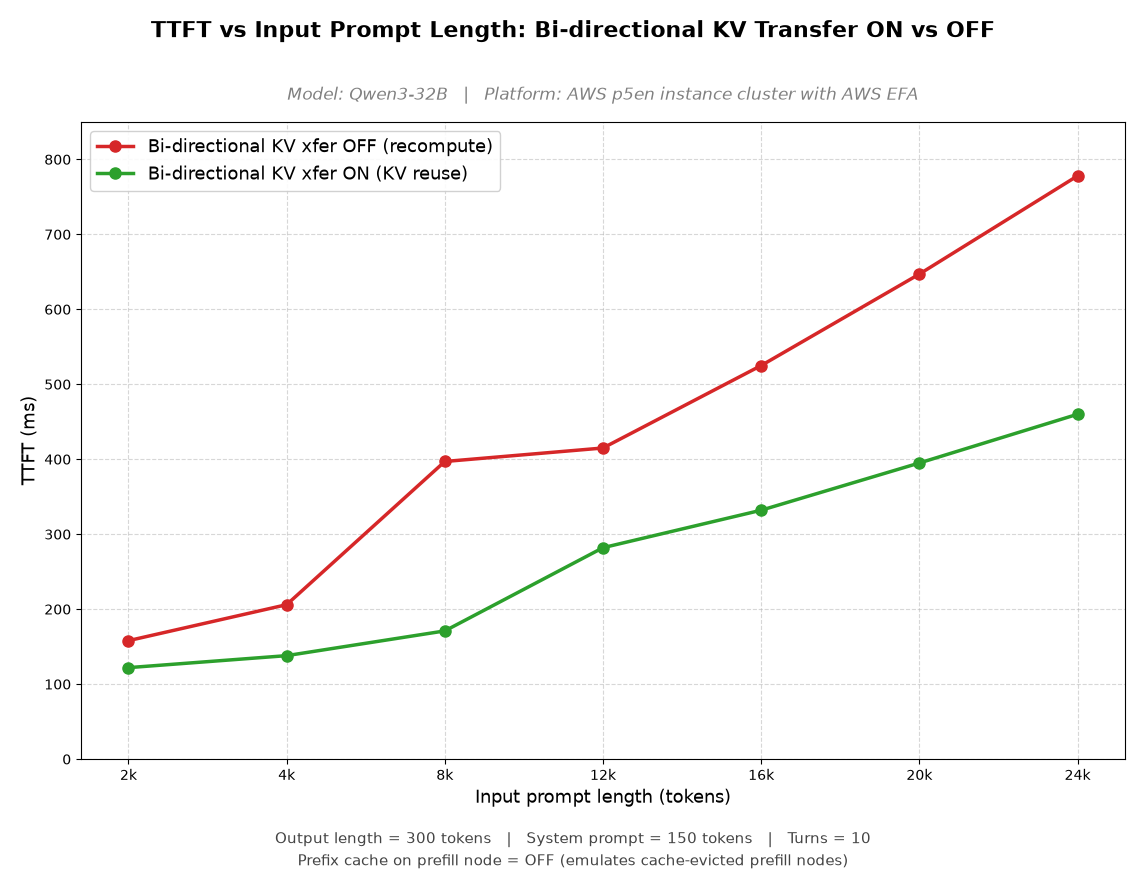
الشكل 3: TTFT مقابل طول الـ prompt لنموذج Qwen3-32B مع تشغيل نقل KV ثنائي الاتجاه وإيقافه
يفصّل المخطط التالي مدة prefill للتجارب نفسها إلى مكوّني إعادة الحساب ونقل الـ KV.
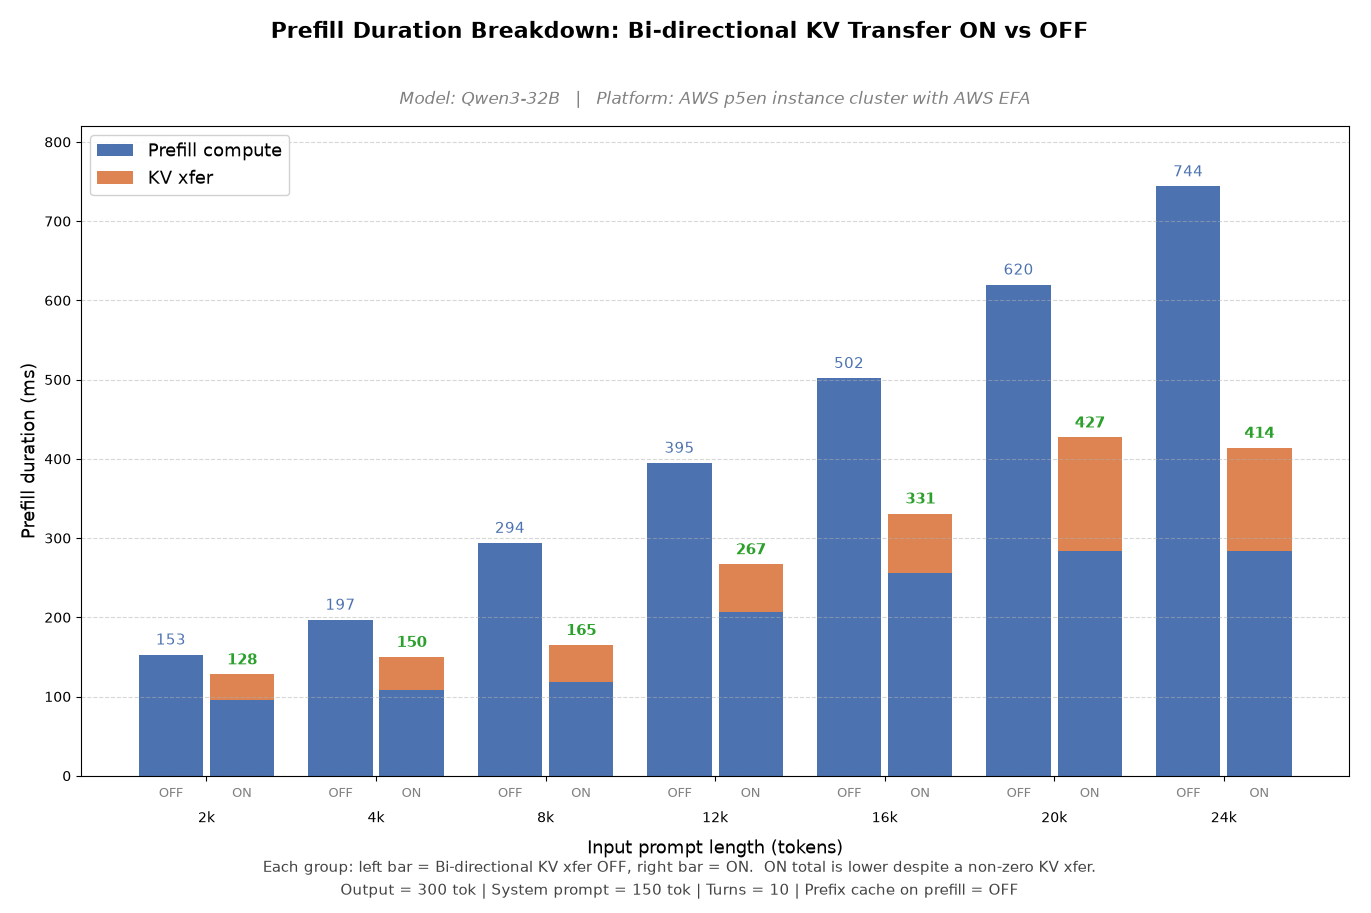
الشكل 4: تقسيم مدة prefill لنموذج Qwen3-32B إلى مكونَي إعادة الحساب ونقل الـ KV
تُظهر الرسوم البيانية معًا أن TTFT يبقى شبه ثابت مع تشغيل الميزة بينما يرتفع المسار في وضع OFF بشكل حاد مع نمو السياق، لأن وقت نقل KV الصغير تفوقه بكثير إعادة الحساب التي تلغيها.
zai-org/GLM-5-FP8
تتبع العرضان نفسهما لـ GLM-5-FP8. يرسم الأول TTFT مقابل طول المطالبة مع تشغيل الميزة وإيقافها.
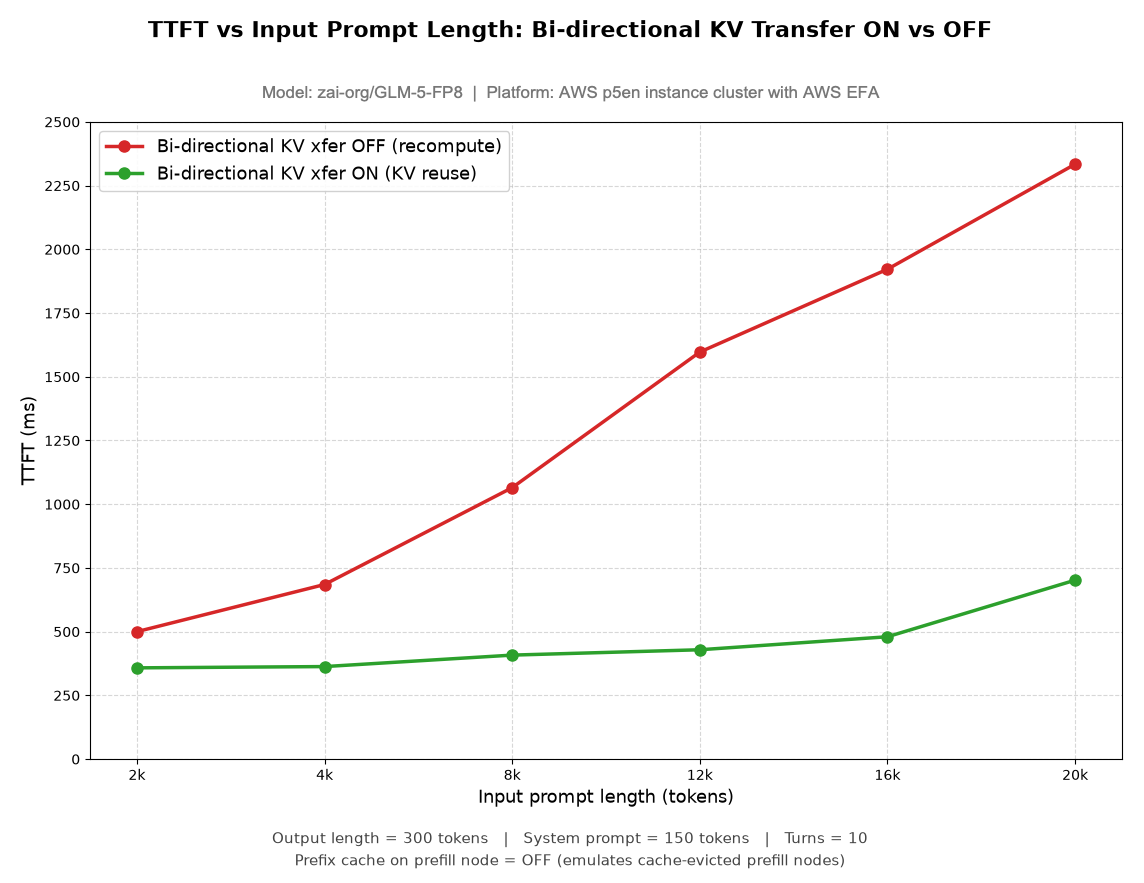
الشكل 5: TTFT لـ zai-org/GLM-5-FP8 مع تشغيل وإيقاف إعادة استخدام KV
يفصل الثاني مدة prefill إلى مكوني إعادة الحساب ونقل KV.
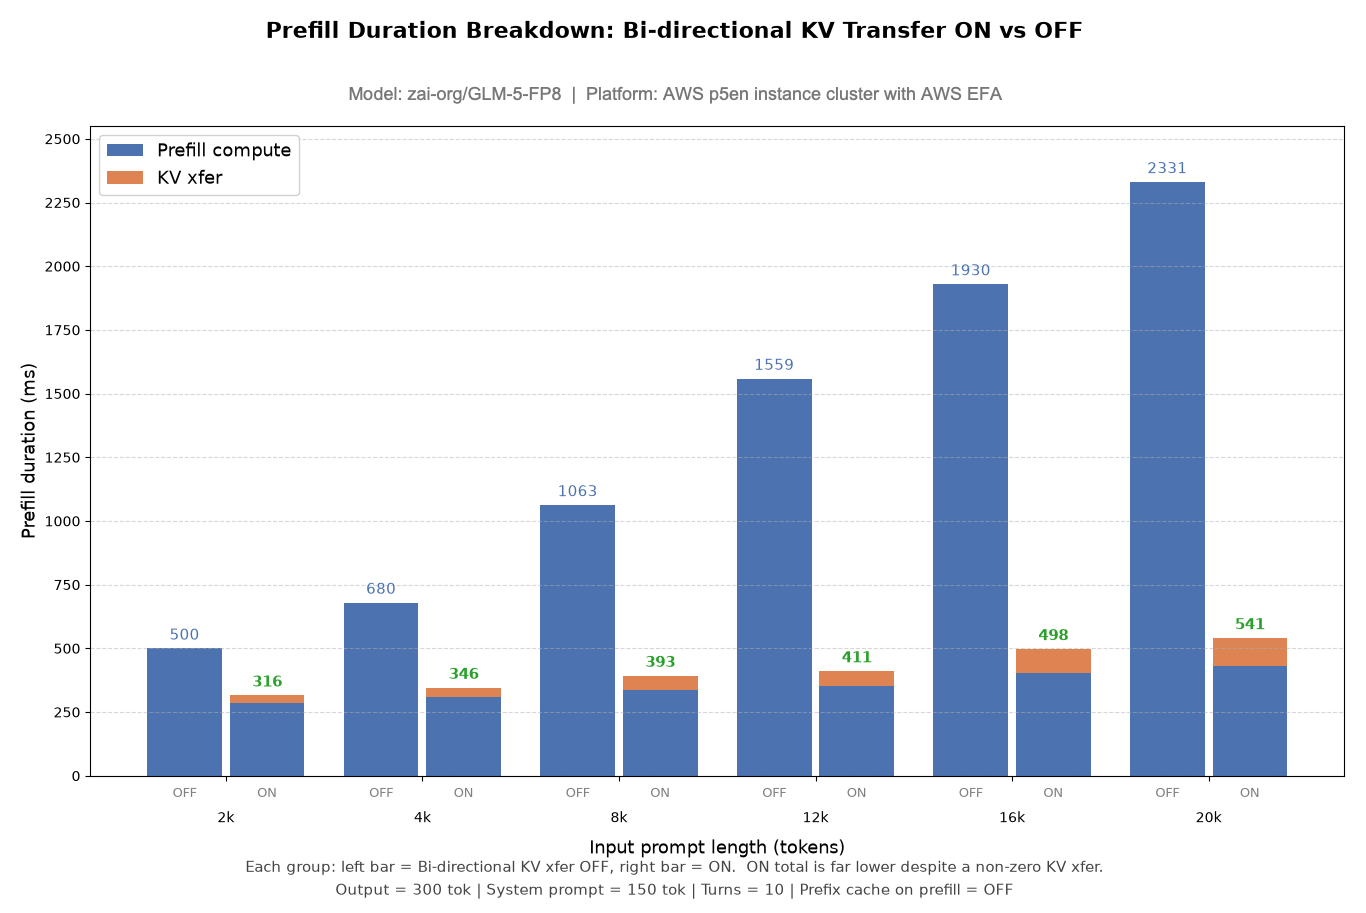
الشكل 6: تفصيل مدة prefill لـ zai-org/GLM-5-FP8
يُظهر GLM-5-FP8 فجوة أكبر بكثير من Qwen3-32B، تصل إلى انخفاض TTFT بنحو 3.3x عند المطالبات الطويلة، لأن وقت إعادة الحساب الأعلى لكل رمز يجعل إعادة استخدام KV أكثر ربحية مع نمو طول السياق.
كيفية تشغيل الاختبار المعياري
لإعادة إنتاج إعداد الاختبار المعياري 1P1D لدينا، عقدة prefill واحدة وعقدة decode واحدة، باستخدام نسخ Amazon EC2 P5en مع EFA، اتبع التعليمات خطوة بخطوة في دليل إعادة إنتاج نتائجنا. يغطي الدليل إعداد البيئة، وتشغيل خوادم vLLM للـ prefill والـ decode، وتشغيل الاختبار المعياري، وجمع النتائج. يمكن تشغيل الميزة على إعدادات مدعومة أخرى، لكن ستختلف نتائج الأداء حسب العتاد والنموذج وحمل العمل وإعداد الشبكة.
الخلاصة
في هذه التدوينة، أوضحنا كيف يمكن لنقل ذاكرة KV cache ثنائي الاتجاه أن يقلل TTFT مع نمو سجل محادثة الوكيل. في نشرات P-D المنفصلة، تتيح الميزة لعقدة prefill إعادة استخدام كتل KV المحفوظة بواسطة عقدة decode عبر الأدوار، مما يقلل الحساب المتكرر. تحدد عتبات الاحتفاظ بالكتل وإعادة الحساب القابلة للتهيئة متى يحدث إعادة الاستخدام. في نشر 1P1D باستخدام نسخ Amazon EC2 P5en المتصلة عبر EFA، وعند أطوال المطالبات الأطول التي اختبرناها، لاحظنا انخفاضات في TTFT بمقدار 1.6x لـ Qwen3-32B و3.3x لـ zai-org/GLM-5-FP8. تعتمد النتائج على حمل العمل وإعداد النشر. لتنفيذ هذا في بيئتك، استخدم vLLM v0.21.0 أو أحدث مع NixlConnector، وفعّل bidirectional_kv_xfer على كل من خوادم prefill وdecode، واستخدم موجّهًا مدركًا لذاكرة kv-cache، واتبع دليل إعادة الإنتاج على GitHub.
موارد ذات صلة
شكر وتقدير
نشكر مجتمع vLLM على دعمهم في صيانة هذه الميزة.