
مع أصبح الصوت وسيلة من الطراز الأول للذكاء الاصطناعي، فإن نماذج Deepgram تشمل تحويل الكلام إلى نص، وتحويل النص إلى صوت، ووكلاء الصوت. تُعالج هذه النماذج الآن أربعة تريليونات من كلمات الصوت سنويًا لـ 200,000 مطور و1,400 منظمة. يستخدم العملاءها من خلال واجهة Deepgram API أو يقومون بتشغيلها في بيئاتهم الخاصة، بما في ذلك Amazon SageMaker AI.
بالنسبة لـ Deepgram، فإن كفاءة التقديم تحدد حجم الصوت الذي يمكن للنظام معالجته ضمن ميزانية البنية التحتية المحددة. تفرض أعمال العمل الضخمة عالية الحجم ضغطًا شديدًا على هذه الميزانية، لذا كلما تم استخدام ساعات التسريع بكفاءة أكبر، كان بإمكان Deepgram تقديم المزيد من الصوت في نفس القوات. هذا جعل كفاءة الاستدلال هدفًا طبيعيًا، ولذلك انتقلت Deepgram إلى شريحة AWS AI لتحسينها. عملوا مع AWS لجلب نموذج Nova-3 للترجمة الصوتية إلى النص إلى AWS Trainium2 لأعمال الحزمة الجماعية خارج الشبكة مثل تحليل مراكز الاتصال والتدوين الطبي.
بدأت العملية من خلال تقديم Deepgram لـ Nova-3 ككود قياسي لبرنامج PyTorch. على مدى عدة أشهر، قامت Deepgram وفريق AWS Forward Deployed Engineering (FDE) بنقل Nova-3 إلى AWS Trainium2 باستخدام برنامج PyTorch، وتعديلها لكي تعمل على الأجهزة الجديدة. التكوين النهائي يعمل ثمانية نسخ من النموذج على مثال Amazon Elastic Compute Cloud (Amazon EC2) trn2.3xlarge. في أعمال البتات الموجهة للإنتاجية دون الاتصال بالشبكة الخارجي لـ Deepgram، قام هذا الإعداد بتحليل 11–70% أكثر صوتًا لكل دولار مقارنة بخيارات الحوسبة التي كانت تستخدمها Deepgram. قمنا بقياس ذلك باستخدام أسعار المثال في وقت التقييم. هذه الفوائد تساعد Deepgram على التوسع بكفاءة، والحفاظ على نقل النماذج الأفضل، وتقديمها للعملاء بأسعار أقل. يمكن أن تمتد هذه الفوائد إلى العملاء الذين يستضيفون نماذج Deepgram في السحابة الخاصة الافتراضية الخاصة بهم على Amazon SageMaker AI. هناك، تواصل Deepgram وAWS تحسين سهولة الإعداد، والموثوقية، والقدرة على المراقبة.
في هذا المقال، نتعرض لعملية التحسين الكامل للاستدلال في Trainium: نقل Nova-3 إلى مجموعة برمجيات AWS Neuron، التعديلات على مستوى النواة التي تمت بعد ذلك، ووقت التنفيذ المتوازي للمعلومات باستخدام Rust الذي يسمح لخادم النموذج الخاص بـ Deepgram بالاتصال بـ Trainium، بالإضافة إلى نتائج الكفاءة والتكلفة التي قمنا قياسها في عملية النسخ التدريجي.
تحسين Nova-3 إلى Trainium2 باستخدام PyTorch الأصلي
بدأنا بكود معياري من PyTorch، واستخدمنا TorchNeuron، وهو التكامل الأصلي لبرنامج Neuron Compiler مع PyTorch، والذي يدعم كلاً من التنفيذ الفوري وtorch.compile. قمنا أولاً بتشغيل Nova-3 في الوضع الفوري على Trainium2، وتحققنا من العمليات التي تنتقل إلى CPU، ثم قمنا بتحميل الكود باستخدام torch.compile. الكود المُحمَّل أدى جميع عمليات النموذج على Trainium2 دون اكتشاف أي انتقال إلى CPU.
قمنا بتجميع محول الكود وداخل الكود باستخدام رسومات الشكل الثابت المنفصلة باستعمال torch.compile. خلال العملية، قمنا بالتحقق من دقة الأرقام على مستويين: اتساق الإخراج على مستوى الطبقات مقارنةً بالمعالج المعلوماتي (CPU)، ومعدل الخطأ في كلمات الكلام من البداية إلى النهاية (WER)، والذي كان يجب أن يتبع القيم المرجعية والأهداف لـ Deepgram.
من هذا الأساس العمل، بدأنا عمل التحسينات باستبدال عدة طبقات بكريستالات مدمجة من مكتبة NKI العامة (NKILib)، وهي مجموعة من الكريستالات المرجعية المُنشأة مسبقًا باستخدام واجهة كريستالات Neuron (NKI). تشمل الكريستالات هذه العمليات مثل الإسقاطات QKV المدمجة، طبقات الشبكة المدفوعة مباشرة (FFN) المدمجة، والتمفصل 1D عميق.
قمنا بتحسين الأداء من حيث الإنتاجية، وبالتالي كفاءة التكلفة، مع التركيز على أعمال الاستدلال الخاملة لشركة Deepgram. يتم الإبلاغ عن الإنتاجية كمكسب نسبي مقارنةً بالإعدادات الأساسية، وليس كعدد الأصوات المعالجة بالثانية المطلق، وقمنا بدراسة أحجام الدفعات من 1 إلى 128 للعثور على حجم الدفعات الذي يعزز الإنتاجية.
تعديل مستوى النواة باستخدام Neuron Explorer وNAD
تفعيل الحايلات النشطة هو الخطوة الأولى في دفلو عجلة التحسين: تفعيل حايلة NKI (مخصصة أو من NKILib)، تحليل حمل العمل، ثم إما تعديل الحايلة الموجودة أو استبدالها بحايلة جديدة بناءً على نتائج التحليل. يكرر هذا الدورة حتى يتم تحقيق هدف الأداء. في كل خطوة، جزء مختلف من حزمة Neuron يساعد على تسريع العمل: يوفر NKILib محركات بديلة سهلة التثبيت، أما Neuron Explorer فهو الأداة المفضلة لفحص أعمال Neuron، كما أن حزمة Development Agentic of Neuron (NAD) تسرع تحليل الفحص وتعديل المحركات من خلال مهاراتها في الفحص وكتابة المحركات.
في حالتنا، ساعدتنا وحدات NKILib في جزء كبير من العمل، وأظهر التحليل البرمجي الأماكن التي يمكن فيها استخدام وحدة مكتوبة يدويًا بشكل أفضل. في كل مرة، قادتنا مهارات تحليل NAD من 프로필 Neuron Explorer إلى السبب الجذري للمشكلة، وساعدت مهارات كتابة وحدات NAD في إنتاج الوحدات البديلة.
| الطبقة | ما وجدناه وما غيرناه | الفائدة |
| FFN | قام جدول تنظيم تقسيم الحاوية المرجعية بإعادة تحميل مجموعة كاملة من أوزان الإسقاط من الذاكرة خارج الشريحة لكل تليت، مما أدى إلى تقييد معدل الإنتاجية بسبب زيادة عدد العلامات. يقوم الحاوية المعدلة يدويًا بتحميل كل تليت من الأوزان مرة واحدة، واستخدامها في عدة تليتات متعددة، وتوجيه قراءة الأوزان مع الحساب داخل الشريحة. | 2.0x انخفاض في التاخير مقارنة بالنواة المرجعية عند حجم الدفعة 96 |
| عمقيا conv1d | تم تطبيق النواة التجريبية NKILib على طريقة ضرب مصفوفة عامة ضمنية (GEMM)، مما أدى إلى انخفاض استغلال محرك Tensor Engine. قمنا بإعادة كتابة النظام على شكل حلقة ضرب وتراكم مشترك على محرك Vector، مما أدى إلى استغلال كامل لمحرك Vector، وهو ما يعادل أكثر من ما يمكن أن يساعد في تعويض انخفاض معدل التدفق الأقصى لدى محرك Vector. | تسريع بنسبة 1.5 ضعف مقارنة بالنواة المرجعية عند حجم الدفعة 96 |
| Conv2d | تواجه طبقات conv2d في النموذج عائق في التجميع: بعد حجم الدفعة 32، تمنع هذه الطبقات النموذج من التجميع كرسم واحد. وبما أن NKILib لا يحتوي على نواة conv2d، كتبنا نواة من الصفر في NKI. مرت النواة بعد عدة تكرارات استنادًا إلى مخططات الأداء كما تم وصفه سابقًا، مما أدى إلى إمكانية استخدام حجم دفعة فوق 32. | حتى 50 مرة على وحدة التكرار في أحجام الدفعة ≤32 |
دورة التشغيل المتوازية للبيانات في روستا
كل جهاز Trainium2 يحتوي على ثمانية نواة NeuronCores فعلية، والتي تظهر بشكل افتراضي كأربع نواة NeuronCores منطقية (LNC2). وبما أن كل مثال من نموذج Nova-3 يتناسب بشكل مريح على نواة فعلية واحدة، فقد قللنا عدد النواة الفعلية لكل نواة منطقية إلى واحدة (LNC1). هذه التكوين يسمح لنا باستضافة ثمانية نسخ من النموذج (DP8) لكل جهاز Trainium2. يتم معالجة المدخلات بشكل متزامن، مما يزيد من إنتاجية الجهاز. تُدار عملية التشغيل المتوازية للبيانات بواسطة طابور استعارة العمل، حيث يوجد خيط واحد لكل نسخة.
تم كتابة طبقة الإنتاج والخدمة في Deepgram باستخدام لغة Rust، لذلك كان نقل Nova-3 إلى Trainium2 يتطلب أكثر من مجرد تجميع النموذج: كان يجب أيضًا تشغيله بدون استخدام Python أو PyTorch في مسار الخدمة. لذلك، بنينا وحدة تشغيل خفيفة حيث يقوم Rust بتنسيق نسخ النموذج من خلال صف طرد العمل المشترك. الطبقة C تقوم بتحميل وتنفيذ ملف تنفيذ Neuron مُجمع مسبقًا باستخدام تنسيق NEFFs مباشرة عبر واجهة برمجة التطبيقات لوحدة تشغيل Neuron (libnrt)۔ تندمج وحدة التشغيل مباشرة مع بنية الخدمة في Deepgram، وتحقق من التسلسلات للمعلمات المرجعية بدقة عند كل حجم دفعة اختبار.
قمنا بمقارنةه مع أوقات تشغيل البيانات المتوازية في بايثون ذات الطبقة المتعددة (MT) وأوقات التشغيل المتعدد الإجراءات (MP). مقارنةً بالأساس الخاص بـ MP، يزيل وقت التشغيل الخاص بـ Rust كل الأثر الإضافي لمفسر بايثون. ومقارنةً بالأساس الخاص بـ MT، يخفف أيضًا من تداخل قفل المفسر العالمي (GIL) في التسلسل، بحيث لا تحدث منافسة بين مطالبات النقل من خيوط العمل المتزامنة داخل عملية واحدة. هذه الفوائد مهمة لأن Nova-3 يقوم بسلسلة من دعوات فك التشفير الصغيرة لكل قطعة صوتية، مما يجعل تنظيم العمل على جانب المضيف هو العائق عند حجمات الدفعات المنخفضة. لذلك، تكون تحسين معدل الإنتاج الأكبر هناك، ويظل ذا معنى حتى عند حجم الدفعات الذي يحسن معدل الإنتاج. هناك، قدمت وحدة تشغيل Rust تحسينًا في معدل الإنتاج بنسبة 7.5% مقارنة بالأساس الخاص ببرنامج Python المتعدد الإدخال.
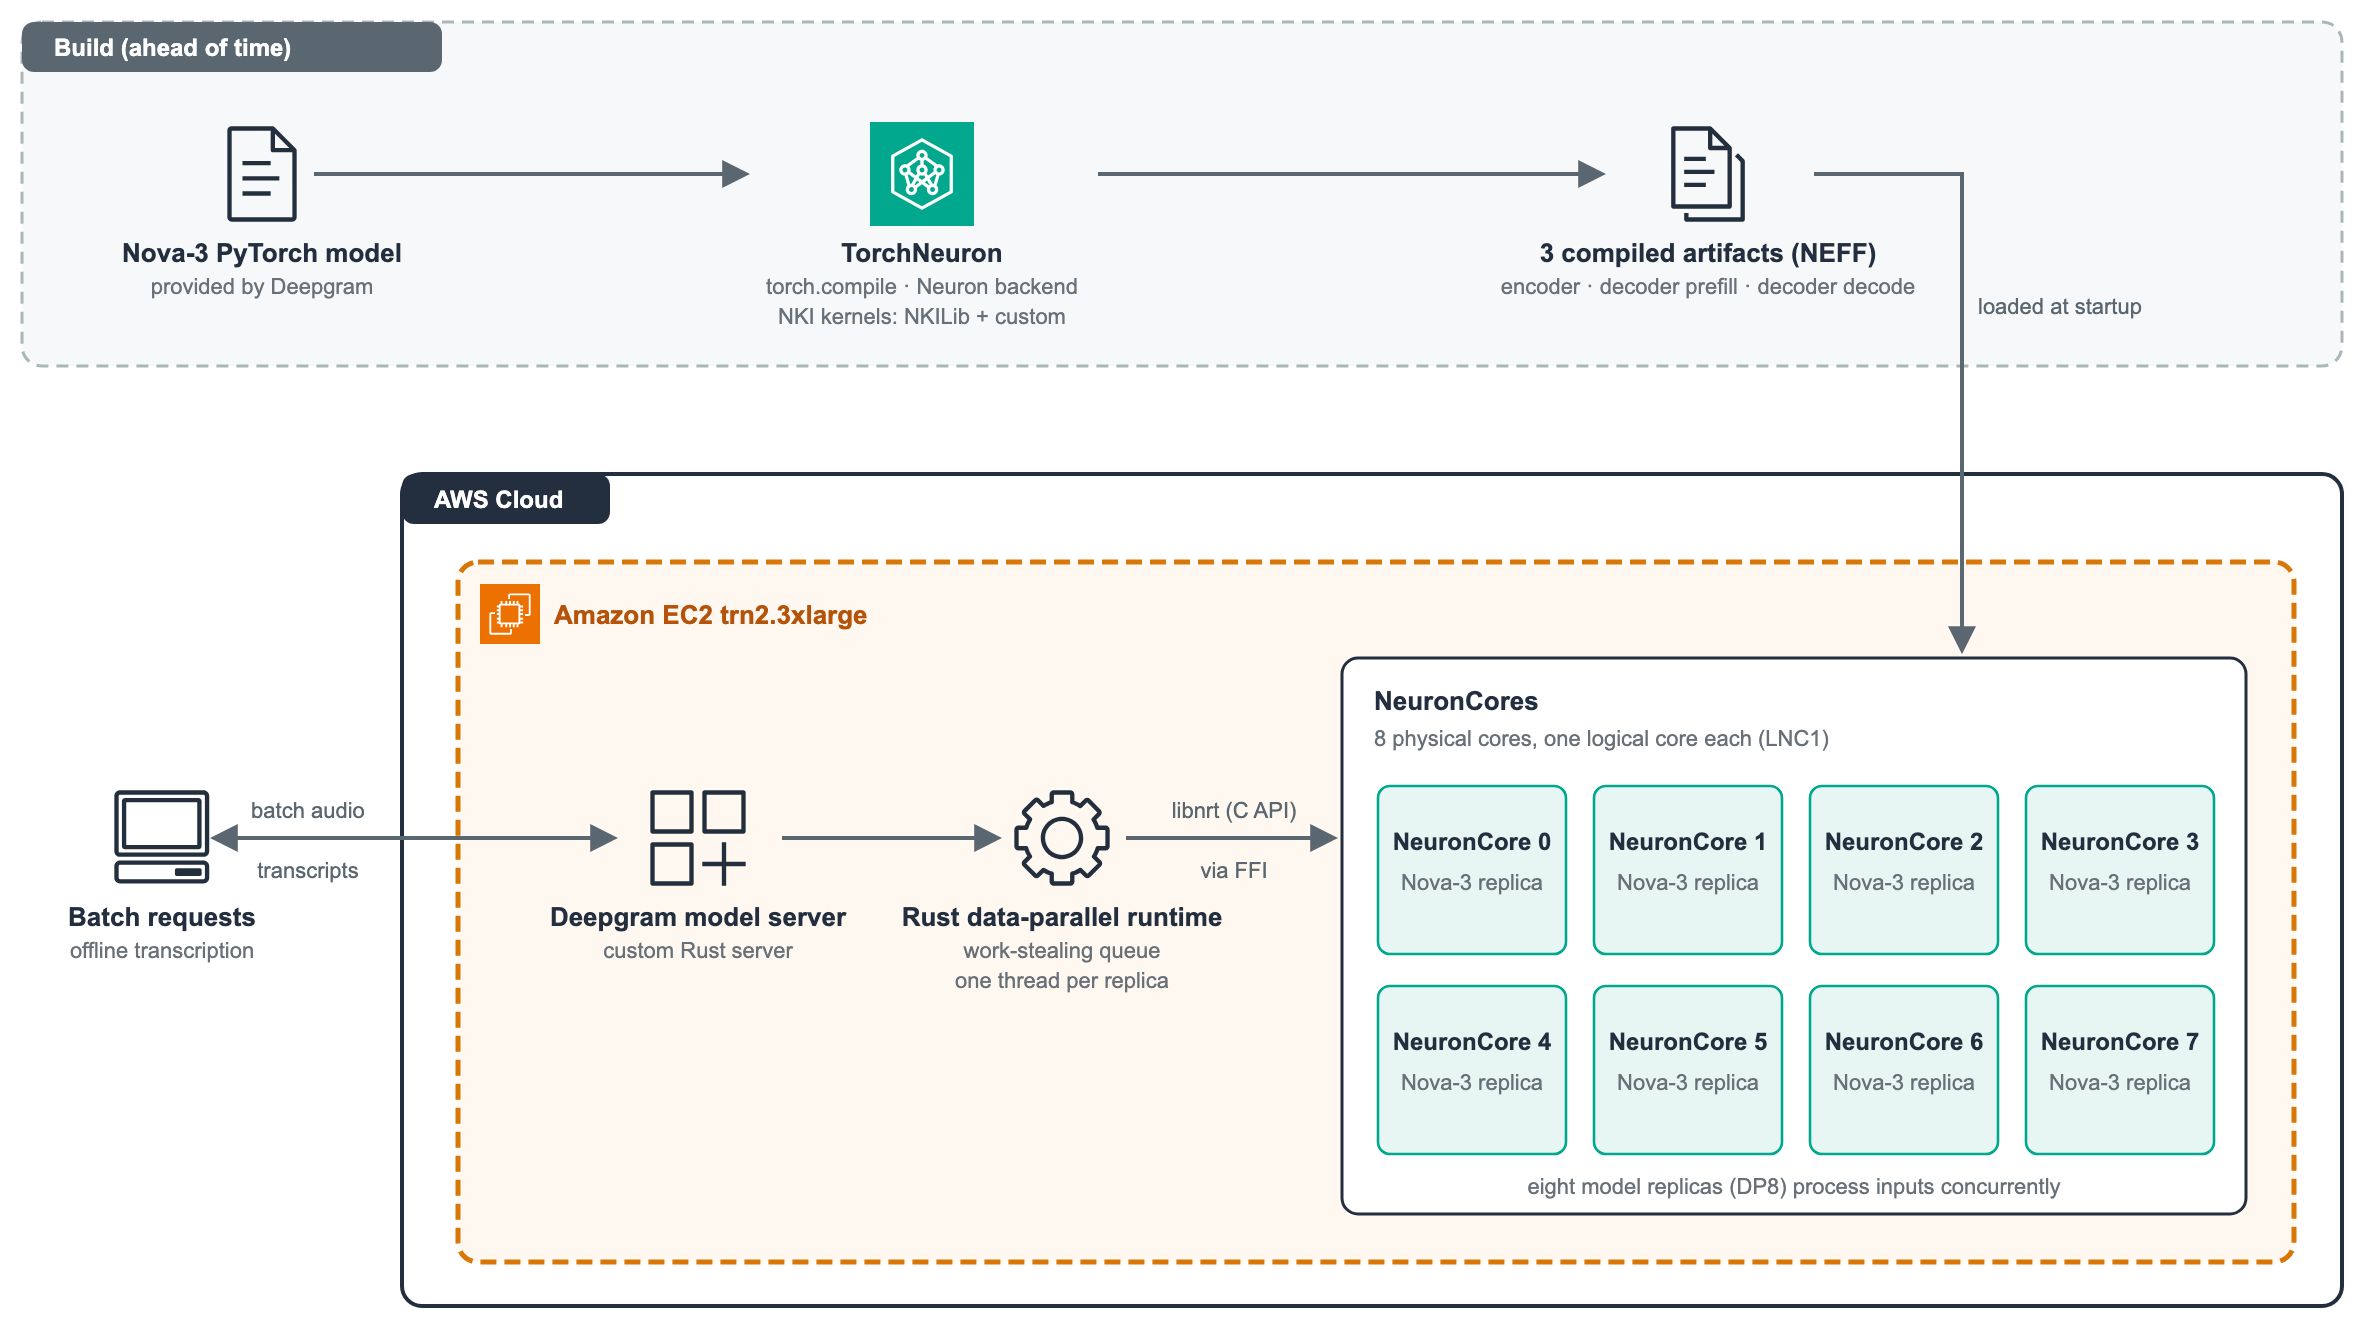
الشكل 1: Deepgram Nova-3 على AWS Trainium2، تم تجميعه مسبقًا وتم تقديمه من خلال Rust
تأثير توفير التكاليف
قمنا بقياس القيمة مقابل الأداء على أساس عدد الإعدادات الصوتية لكل دولار. في أعمال العمل الخاصة بعمليات المعالجة غير المتصلة على منصة Deepgram، والتي تركز على الإنتاجية، فإن إعداد Trainium2 لجهاز واحد (trn2.3xlarge) قام بمعالجة 11–70 بالمئة أكثر إعدادات صوتية لكل دولار مقارنة بالخيارات الحاسوبية التي كانت تستخدمها Deepgram.
الخلاصة
في هذا البوست، أظهرنا كيف قامت Deepgram وAWS FDE بنقل نموذج Nova-3 للترجمة الصوتية إلى النص باستخدام PyTorch إلى معدات Trainium باستخدام TorchNeuron، الذي يوفر تكاملًا طبيعيًا مع إطار عمل PyTorch لمنصة AWS Trainium. قمنا بتحسين الأداء عن طريق استبدال الطبقات مباشرة بكريستالات مُصممة مسبقًا من NKILib. ثم قمنا بتقييم الأداء باستخدام Neuron Explorer، واستعملنا مهارات تطوير Neuron Agentic Development (NAD) لاستعلام بيانات التحليل والتسريع في تشخيص أخطاء الأداء. على أساس هذه الفهمات، قمنا بتكييف كود المصدر للنواة باستخدام مهارات كتابة النواة NAD. أخيرًا، بنينا واجهة تشغيل خفيفة من Rust لتطبيق AWS Trainium، حيث نستخدم واجهة API Neuron Runtime من خلال Rust. أظهر إعدادنا توفير في التكاليف في السيناريوهات التي تتعلق بالإنتاجية دون اتصال، مما يؤكد أن AWS Trainium هو خيار فعال وكفء لأعمال الاستدلال في Deepgram.
لتجربة هذه الطريقة على نماذجك الخاصة، ابدأ بالوثائق المتاحة في وثائق AWS Neuron، والتي تغطي المترجم ووقت التشغيل والأطراف المدعومة. يشرح دليل واجهة NKI لNeuron Kernel كيفية كتابة النواة المذكورة في هذه المقالة، ويحتوي مخزن عينات NKI على النواه الخاصة التي بدأنا بها. تغطي وثائق أدوات مطوري Neuron تحليل الأداء والأدوات المستخدمة هنا، بما في ذلك Neuron Explorer وNeuron Agentic Development. للحصول على معلومات حول الأحجام والتسعيرات، راجع مشتلات Amazon EC2 Trn2. للحصول على مساعدة في تطوير نفس النوع من المنصات، اتصل بقسم الهندسة التطبيقية في AWS Forward Deployed.