
مينيماك إم 3.1 فلش يُظهر أن سباق أسعار الذكاء الاصطناعي في الصين لا يوجد له حد أدنى في المستقبل.
 ماتياس باستيان
عرض ملف ماتياس باستيان على لينكد إن
19 أكتوبر 2026
 نانو بانانا برو يُطلب من خلال DECODER
ما مدى تخفيض تكلفة إنتاج الذكاء الاصطناعي؟ الصين: نعم!
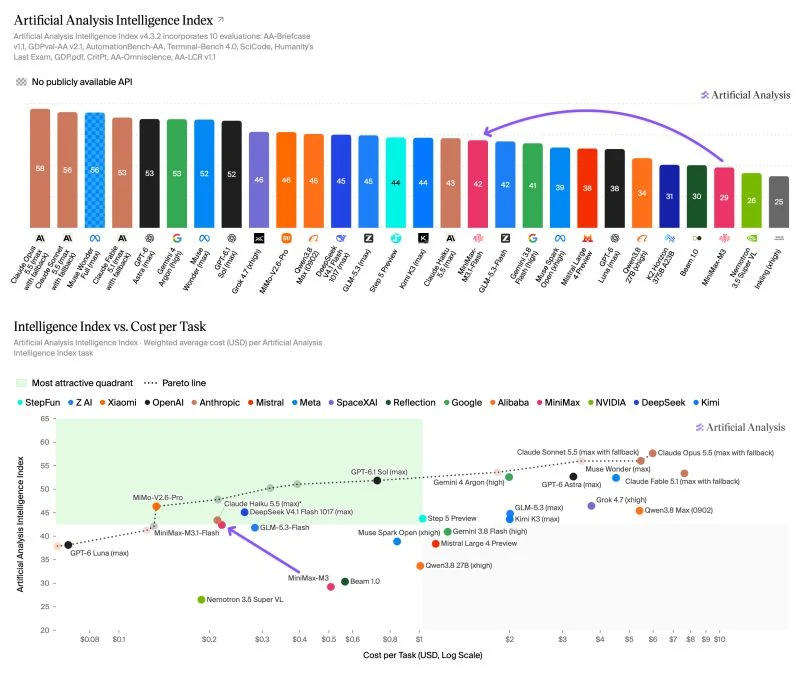
أصدرت MiniMax M3.1 Flash، نموذج تفكير جديد يحصل على 42 نقطة في مؤشر الذكاء الاصطناعي للتحليل. وهذا يعادل 13 نقطة أعلى من النموذج السابق M3، مع تكلفة أقل من نصف تكلفة المهمة الواحدة. يتوافق النموذج مع GLM-5.3-Flash، ويتجاوز Gemini 3.8 Flash (41)، ويخلف Deepseek V4.1 Flash بـ 1017 (45).
شهد التفكير المعقد تحسنًا كبيرًا. في اختبار "آخر امتحان للبشرية"، يصل تقييم M3.1 Flash إلى 48%، متجاوزًا كل من Deepseek وGLM. كما يحقق نسبة 22% في معيار CritPt، الذي يختبر التفكير الفيزيائي على مستوى البحث في 71 مشكلة معقدة. هذا يجعله متقدمًا على GLM-5.3-Flash (15%) وGemini 3.8 Flash (18%)، وخلف Deepseek (24%). من حيث الدقة الواقعية في اختبار AA-Omniscience، يجيب M3.1 Flash عن 56% من الأسئلة بشكل صحيح، وهو أعلى بكثير من GLM-5.3-Flash (28%) وDeepseek (43%).
تستخدم النموذج أيضًا عددًا أقل بكثير من توكينات الإخراج مقارنة بالمنافسين، مما يقلل تكلفة كل مهمة إلى حوالي 0.22 دولار. تقول MiniMax إنها تعمل أسرع ثلاث مرات من M3. نقطة ضعف هي معدل الخطأ البالغ 93 بالمئة، حيث تحاول النموذج الإجابة على كل سؤال اختبار بدلاً من الرفض عند عدم اليقين، وفقًا لـ Artificial Analysis.
النموذج يتعامل مع ما يصل إلى مليون توكين من السياق، ويمكنه استيعاب النصوص والصور. أسعار API تبلغ 0.15 دولار لكل مليون توكين من المدخلات و0.60 دولار لكل مليون توكين من المخرجات، بينما تكون تكلفة المدخلات المحفوظة 0.015 دولار. خطة MiniMax لتوزيع النموذج كأوزان مفتوحة في 23 أكتوبر. API متاح على platform.minimax.io، ويقدم MiniMax أيضًا تطبيقًا على الجهاز الكمبيوتر باسم MiniMax Code.
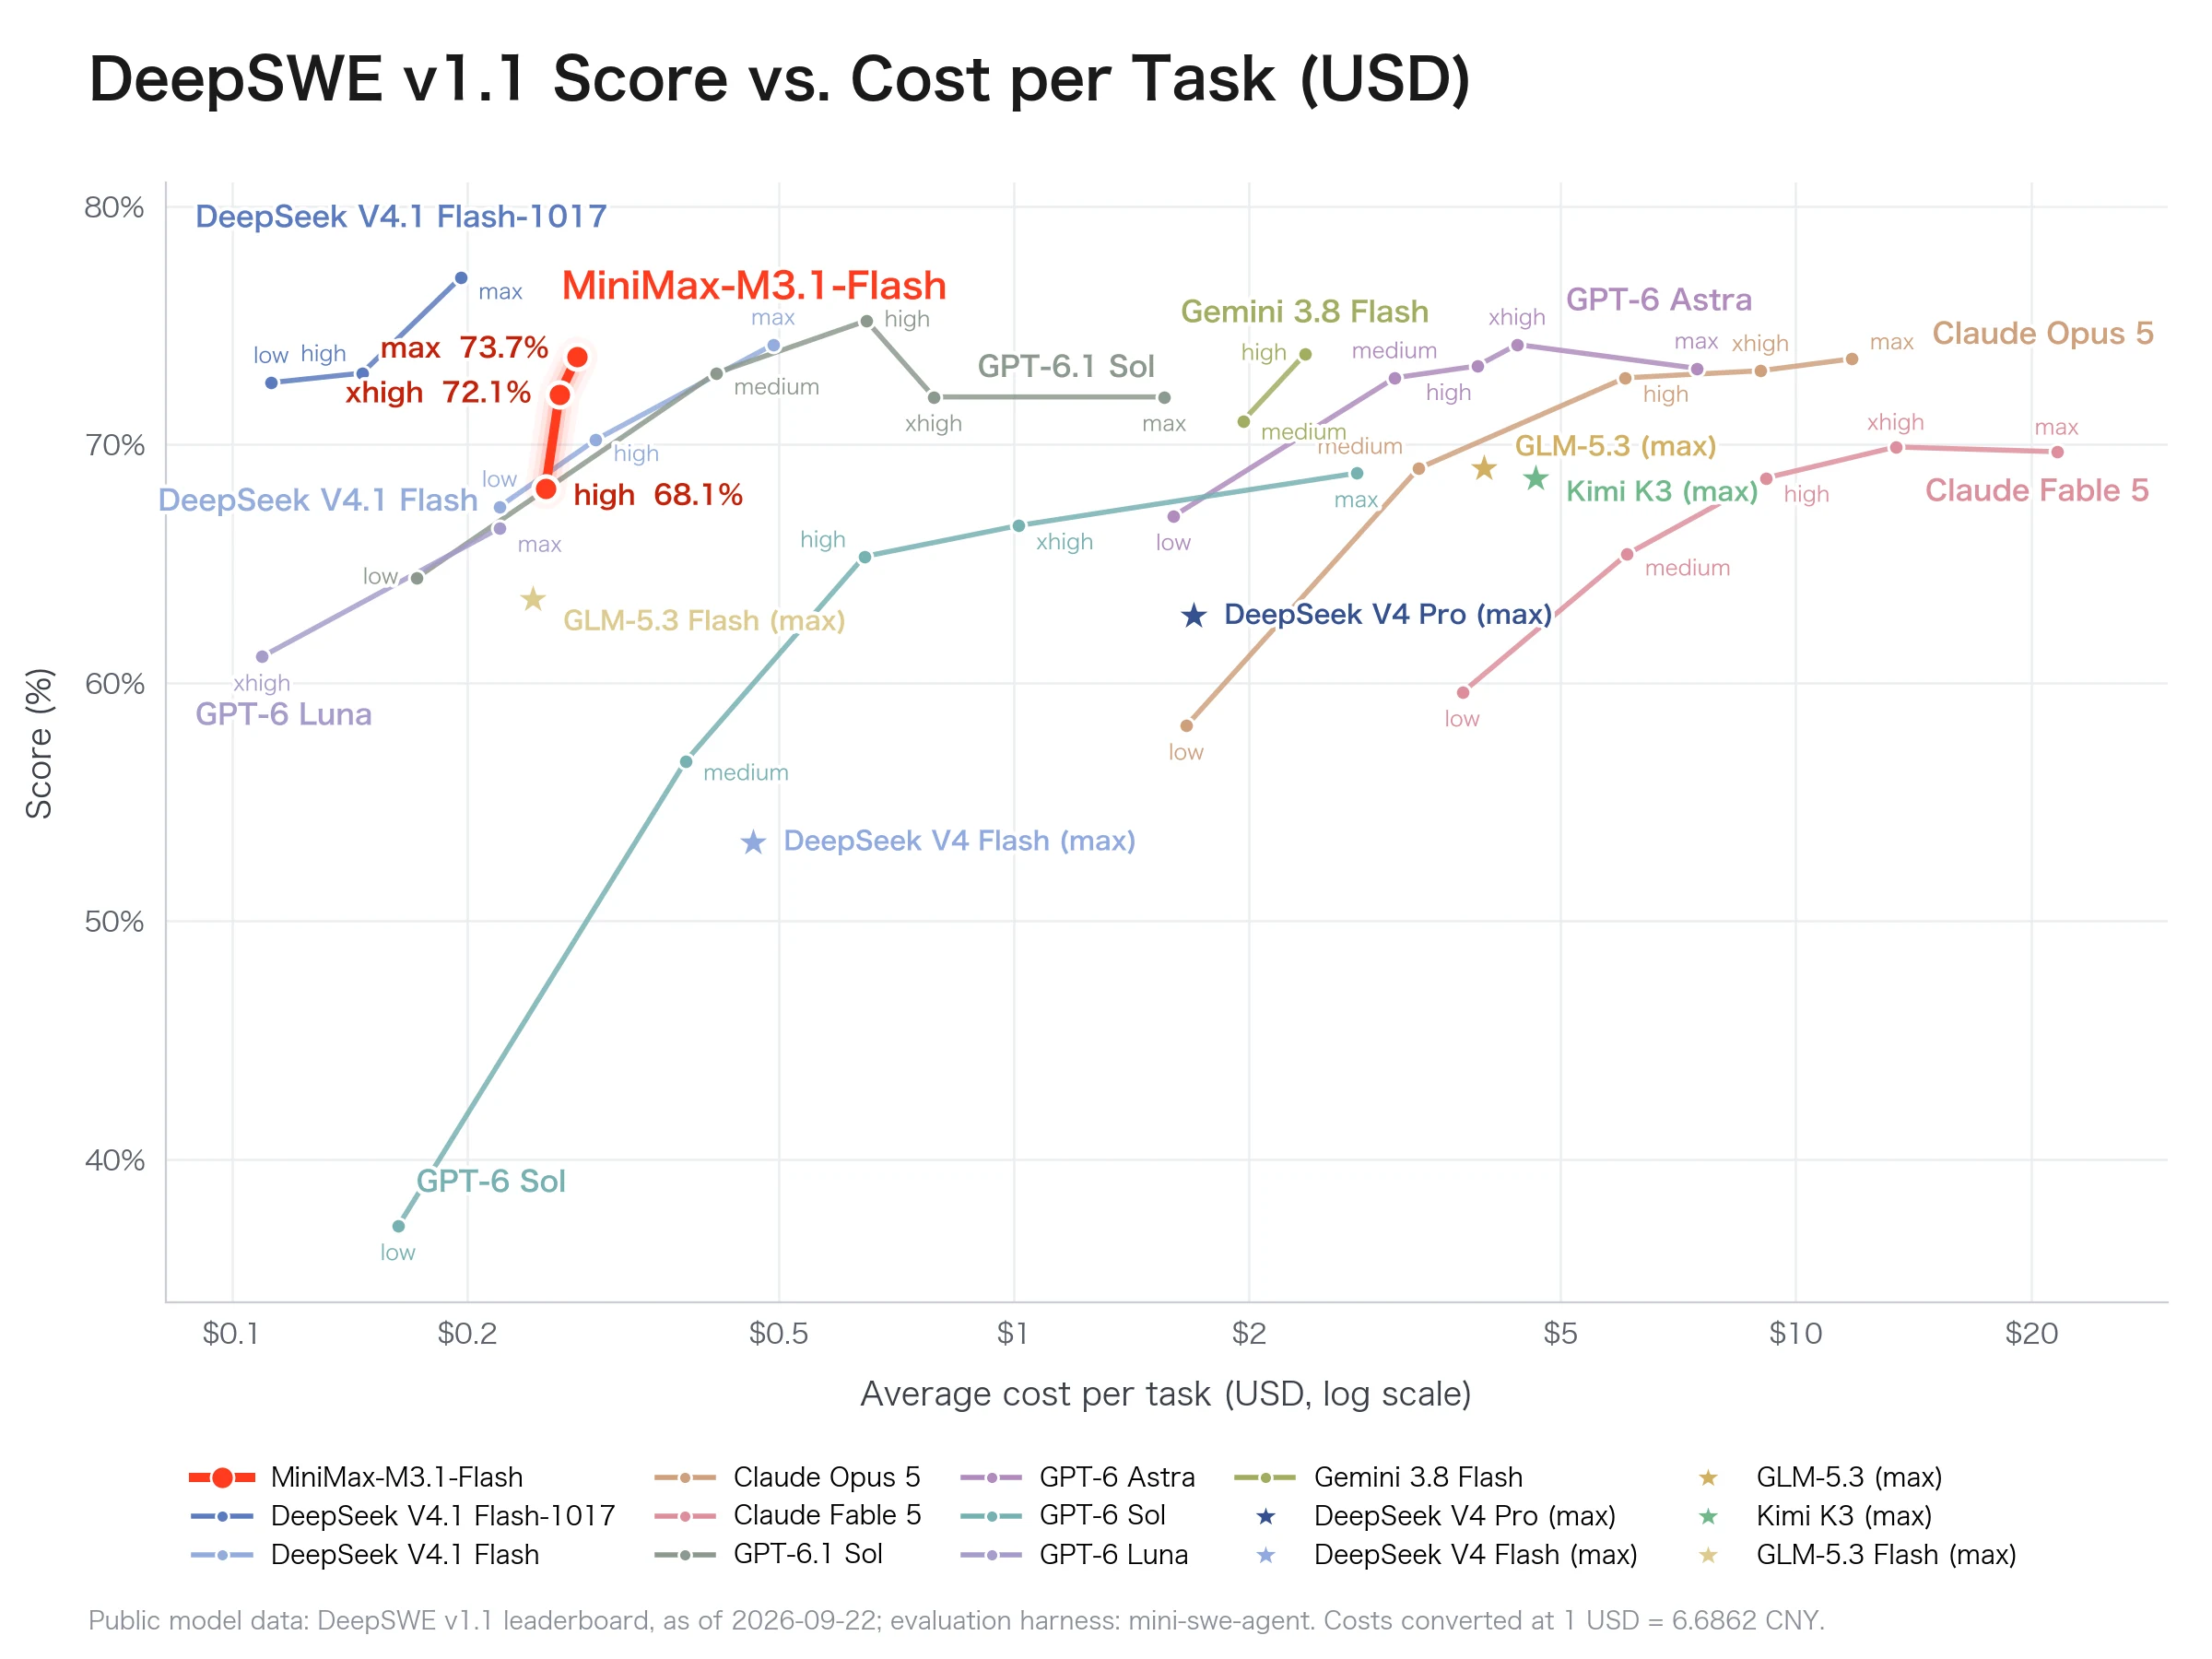
تقسيم نتائج Deepseek وMiniMax في معركة التسعير الأحدث في الصين
مقارنةً بالنموذج الذي تم إصداره مؤخرًا Deepseek V4.1 Flash 1017، لا يفوز أي من النموذجين بشكل كامل. تتقدم Deepseek في مؤشر الذكاء بـ 45 نقطة مقابل 42 نقطة لـ MiniMax، ولديها ميزة طفيفة في اختبار CritPt بنسبة 24 بالمائة مقابل 22 بالمائة.
تتقدم MiniMax في الاختبارات الأخرى. حققت نسبة 48% في اختبار “اختبار الإنسانية الأخير”, بينما حققت Deepseek نسبة 43%. من أجل الدقة الواقعية في اختبار AA-Omniscience، يجيب MiniMax بنسبة 56% من الأسئلة بشكل صحيح مقابل 43% لـ Deepseek. كما أن تكلفة MiniMax للعملية الواحدة أقل قليلاً، عند 0.22 دولار مقارنة بـ 0.26 دولار لـ Deepseek، حيث تحتاج إلى عدد أقل من كلمات الإخراج على المقياس، حوالي 189 مليون كلمة مقابل 224 مليون كلمة لـ Deepseek.
كلا النموذجين سيصدران بوزن مفتوح. Deepseek متاح بالفعل على Hugging Face، وسيصدر MiniMax في 23 أكتوبر.
أخبار الذكاء الاصطناعي بدون الضجة الشرسة – مُختار من قبل البشر
اشترك في THE DECODER للقراءة بدون إعلانات، إلى نشرة أخبار الذكاء الاصطناعي الأسبوعية، إلى تقرير "AI Radar" الحصري الست مرات في السنة، إلى الوصول الكامل للأرشيف، وإلى الوصول إلى قسم التعليقات.
المصدر: التحليل الاصطناعي | مينيماكس