
يوفر TorchNeuron واجهة خلفية جديدة مدمجة لبرنامج PyTorch على AWS Trainium. يدعم Transformers وDiffusers وKernels هذه الواجهة بشكل أساسي، مما يجعل تشغيل النماذج على Trainium ومشاركتها على محور HF أسهل من أي وقت مضى.
TorchNeuron
TorchNeuron هو برنامج إضافي لـ PyTorch يوفر واجهة خلفية جديدة لـ Trainium، مما يسمح بالدعم لوضع التدريب الفوري، ودالة torch.compile، والواجهات البرمجية الموزعة الأصلية مثل FSDP و TP.
اقرأ البلاוג الخاص بـ Pytorch لتعرفي أكثر على TorchNeuron لفهم المزيد عنه.
ابتداءً من 20 أكتوبر 2026، سيكون TorchNeuron متاحًا كإصدار تجريبي عام. يمكن للباحثين والمطورين تثبيته باستخدام pip install torch-neuronx.
خدمة back-end جديدة، وواجهة أصلية في مكتبات HF
حتى الآن، تم توفير تجربة Hugging Face على AWS Trainium وInferentia — شريحة AI مصممة على التوالي للتدريب والتحليل بكفاءة من حيث التكلفة على نطاق واسع — من خلال optimum-neuron. تعتمد هذه المكتبة على حزمة torch-neuronx، التي تعتمد على PyTorch XLA. كان هذا الخيار الطبيعي في ذلك الوقت، لكنه يعني التفكير كمترجم: تورتينجات كسولة بدلاً من التنفيذ الفوري، أشكال ثابتة فقط، إعادة تحرير الكود لكل انقطاع في الرسم البياني. وكان Optimum Neuron موجودًا لتغطية هذه التعقيدات، ويعمل على الحفاظ على كود مخصص (فئات النموذج، المدربون، إلخ) لتحقيق ذلك.
يقوم TorchNeuron بتغيير ذلك. فهو يدمج بشكل مباشر مع PyTorch، ويكشف عن neuron كجهاز أصلي، مع تنفيذ سريع، والأساسيات الموزعة الخاصة بـ PyTorch (DTensor، FSDP2)، بالإضافة إلى torch.compile.
بالنسبة لمكتبات Hugging Face، يصبح Trainium جهازًا مثل أي جهاز آخر: تُشغَل أدوات Transformers وDiffusers وAccelerate وPEFT وTRL علىه مباشرة، مع نفس الفئات والسكريبتات التي تستخدمها على أي جهاز آخر. من الآن فصاعدًا، نوصي مستخدمي Neuron باستخدام هذه المكتبات مباشرة بدلاً من استخدام Optimum Neuron.
تركيبات (Transformers)
التحليل العملي
يتم دعم توليد النصوص بشكل أساسي في Transformers لطائفة واسعة من النماذج. مع TorchNeuron، يتم دعم 89% من أبرز 100 طريقة بناء نماذج توليد النصوص المتكررة مباشرة، مقارنة بـ 46% في Optimum Neuron v0.4.5. كل ما عليك فعله هو تمرير معلمة device_map=neuron في كودك، وسوف يتم نقل النموذج إلى أجهزة Neuron.
النص التالي هو مثال على توليد النص باستخدام التوازي التراكتيبي للتنسورات، والذي سيسمح بالاستفادة الكاملة من مثيلتك Neuron. لاحظ أنه يستخدم سلة ذاكرة ثابتة لعملية التوليد، وذلك بناءً على توصية قوية من Neuron لمنع إعادةCompilation المتكررة.
import os

import torch
import torch.distributed as dist
import torch_neuronx  # noqa: F401
from torch.distributed import DeviceMesh
from transformers import AutoModelForCausalLM, AutoTokenizer, GenerationConfig
from transformers.distributed import DistributedConfig
from transformers.generation.configuration_utils import CompileConfig

MODEL_ID = "Qwen/Qwen3.8-27B"
MAX_SEQ_LEN = 1024
PREFILL_CHUNK_SIZE = 512

dist.init_process_group(backend="neuron")
world_size = dist.get_world_size()

model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID,
    dtype=torch.bfloat16,
    distributed_config=DistributedConfig(tp_size=world_size),
    device_mesh=DeviceMesh("neuron", list(range(world_size))),
).eval()

tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
if tokenizer.pad_token is None:
    tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "left"

inputs = tokenizer.apply_chat_template(
    [{"role": "user", "content": "The future of AI is"}],
    add_generation_prompt=True,
    padding=True,
    tokenizer_kwargs={"pad_to_multiple_of": PREFILL_CHUNK_SIZE},
    return_tensors="pt",
)

generation_config = GenerationConfig(
    max_new_tokens=128,
    do_sample=False,
    use_cache=True,
    pad_token_id=tokenizer.pad_token_id,
    eos_token_id=tokenizer.eos_token_id,
    cache_implementation="static",
    max_cache_len=MAX_SEQ_LEN,
    prefill_chunk_size=PREFILL_CHUNK_SIZE,
    compile_config=CompileConfig(backend="neuron", fullgraph=False, dynamic=False),
)

with torch.no_grad():
    output_ids = model.generate(
        inputs["input_ids"],
        attention_mask=inputs["attention_mask"],
        generation_config=generation_config,
    )

if dist.get_rank() == 0:
    prompt_len = inputs["input_ids"].shape[1]
    print(tokenizer.decode(output_ids[0, prompt_len:], skip_special_tokens=True))
> التدريب
الآن، بما أن Neuron هو جهاز أصلي من PyTorch، فإن التدريب على Trainium يستخدم نفس مكتبات Hugging Face مثل أي محرك تدريب آخر: Transformers، Accelerate، PEFT وTRL. لم تعد بحاجة إلى مدرب مخصص أو تفرع خاص للنموذج على Neuron. يمكن تنفيذ برنامج تعديل TRL القياسي على مثال Trainium باستخدام بعض الإعدادات الخاصة بNeuron فقط.
هذا هو برنامج التعديل الدقيق تحت إشراف، مبني على SFTTrainer من TRL. إذا كنت قد قمت بتعديل النموذج باستخدام TRL على وحدات الرسومات الطرفية (GPUs) من قبل، فمن المفترض أن يكون هذا البرنامج مألوفًا لك.
import os

import torch
from datasets import load_dataset
from transformers.distributed import DistributedConfig

from trl import ModelConfig, ScriptArguments, SFTConfig, SFTTrainer, TrlParser


def main(script_args, training_args, model_args):
    # The Neuron backend can't compile Dynamo's automatic dynamic shapes yet (https://github.com/huggingface/trl/issues/7660)
    torch._dynamo.config.automatic_dynamic_shapes = False

    training_args.model_init_kwargs = {
        "revision": model_args.model_revision,
        "trust_remote_code": training_args.trust_remote_code,
        "attn_implementation": model_args.attn_implementation,
        "dtype": model_args.dtype,
        "device_map": None,
    }
    if int(os.environ.get("WORLD_SIZE", "1")) > 1:
        # The model is sharded on the TP x FSDP grid as its weights are loaded
        training_args.model_init_kwargs["distributed_config"] = DistributedConfig(
            tp_size=int(os.environ.get("TP_SIZE", "1")),
            fsdp_size=int(os.environ.get("FSDP_SIZE", "1")),
        )

    # Prepare dataset
    train_dataset = load_dataset(
        script_args.dataset_name,
        name=script_args.dataset_config,
        split=script_args.dataset_train_split,
    )
    # UltraChat also has a string `prompt` column, which makes TRL treat it as a prompt-completion dataset.
    train_dataset = train_dataset.select_columns(["messages"])

    # Training
    trainer = SFTTrainer(
        model=model_args.model_name_or_path,
        args=training_args,
        train_dataset=train_dataset,
    )

    trainer.train()
    trainer.save_model(training_args.output_dir)
    trainer.end()


if __name__ == "__main__":
    parser = TrlParser((ScriptArguments, SFTConfig, ModelConfig))
    script_args, training_args, model_args = parser.parse_args_and_config()
    main(script_args, training_args, model_args)
يتم التعامل مع التوازي بشكل طبيعي بواسطة ترانسفورمرز. أنت تضع DistributedConfig مع أحجام التنسور التوازي (TP) وFSDP model_init_kwargs, SFTTrainer يسلمه إلى from_pretrained، ويتم تفصيل النموذج عند تحميل أوزانه. يرى المحاضر التدريب أن النموذج موزع بالفعل ولا يحتاج إلى تفصيله مرة أخرى. لا حاجة لك بذلك. --fsdp علامة أو إعداد تسريع FSDP.
لا شيء في البرنامج مرتبط بـ Trainium: نفس الكود يعمل على أي معدات. هناك بعض الأمور التي تستحق معرفتها عند تشغيله على Trainium:
- الأشكال الثابتة. يقوم البرنامج بإيقاف الأشكال الديناميكية التلقائية في
torch.compile، ويستخدم طريقة التعبئة المغلفة لإنتاج تسلسلات تصل إلى 2048 توكين. عندما يكون TRL ≥ 1.16، يتم تعبئة الدفعات على Neuron بكمية متعددة من 128 توكين، مما يحد من عدد أشكال الإدخال. تُعاد استخدام الرسومات المترجمة للخطوات اللاحقة بأشكال مماثلة. torch.compileمفعول. كل ما يحتاجه هو تمرير--torch_compile true؛ على نسخة Trainium، يقومtorch.compileبتحديد الجهاز وتعيين واجهة Neuron تلقائيًا، دون الحاجة إلى أي تكوين إضافي.- تم إيقاف تحميل الوزن بشكل غير متزامن. لا يتم دعم التحميل غير المتزامن للوزن المدمج في Transformers على Neuron، لذا في الوقت الحالي نقوم بإيقافه باستخدام
HF_DEACTIVATE_ASYNC_LOAD=1.
الأمر التالي يبدأ التدريب باستخدام torchrun، حيث يتم بدء عملية واحدة لكل Core للNeuron. تحدد TP_SIZE وFSDP_SIZE ترتيب التوازي، وقيمة حاصل ضربهما هي عدد العمليات: هنا 4 × 8 = 32، وهو ما يتطابق مع --nproc_per_node. تشكل العمليات الـ 32 شبكة من 4 × 8. يقوم التوازي في تركيبات Tensor بتقسيم كل طبقة على 4 أقسام من Core، بينما يقوم FSDP بتوزيع المعلمات والتراكبات وحالة المحسِّن على 8 مجموعات من TP.
TP_SIZE=4 FSDP_SIZE=8 HF_DEACTIVATE_ASYNC_LOAD=1 uv run torchrun --nproc_per_node=32 sft_neuron_example.py \
    --model_name_or_path Qwen/Qwen3-8B \
    --dataset_name HuggingFaceH4/ultrachat_200k \
    --dataset_train_split train_sft \
    --output_dir Qwen3-8B-sft-tp4-fsdp8 \
    --dtype bfloat16 \
    --max_length 2048 \
    --packing true \
    --packing_strategy wrapped \
    --learning_rate 2e-5 \
    --warmup_steps 0.03 \
    --num_train_epochs 1 \
    --logging_steps 2 \
    --per_device_train_batch_size 4 \
    --gradient_accumulation_steps 4 \
    --save_only_model true \
    --torch_compile true
قمنا بتشغيله على 8 شريحة Trainium2 (32 نواة عصبية)، وهو نصف مثال على instance trn2.48xlarge.
تم إكمال التدريب، ويقوم trainer.save_model بكتابة نسخة من نظام Transformers قياسية. لا شيء فيها مرتبط بـ Neuron: يمكن تضمينها في Hub Hugging Face كما هي، واستخدامها على أي أجهزة أخرى.
Diffusers
التحليل الإدراكي
العديد من خطوط الأنابيب في مكتبة Diffusers متوافقة مع TorchNeuron في وضع الحرص والوضع المُجمّع. FLUX.1-dev، FLUX.2، Qwen-Image، Qwen-Image-2.1 وH3 أيضًا متوافقة مع التوازي التنسوري لتحقيق أقصى استفادة من أجهزة Neuron الخاصة بك. التالي مثال يوضح كيف يمكنك استخدام TP:
import torch, torch.distributed as dist, torch_neuronx # TP
from torch.distributed.device_mesh import DeviceMesh # TP
from diffusers import QwenImage21Pipeline, QwenImage21Transformer2DModel, TensorParallelConfig

# Distributed devices initialization
dist.init_process_group(backend="neuron") # TP
dev = torch.neuron.current_device()
mesh = DeviceMesh("neuron", list(range(8))) # TP=8

# Pipeline initialization
model = "Qwen/Qwen-Image-2.1"
transformer = QwenImage21Transformer2DModel.from_pretrained(
    model,
    subfolder="transformer",
    torch_dtype=torch.bfloat16,
    parallel_config=TensorParallelConfig(mesh=mesh), # TP
)
pipe = QwenImage21Pipeline.from_pretrained(
    model,
    transformer=transformer,
    torch_dtype=torch.bfloat16,
)
pipe.vae.to(dev)
pipe.transformer.compile_repeated_blocks(backend="neuron", fullgraph=True, dynamic=False)

# Image generation
emb, mask, _ = pipe.encode_prompt(prompt="A capybara wearing a wizard hat, oil painting", device="cpu")  # text encoder stays on CPU
image = pipe(
    prompt_embeds=emb.to(dev),
    prompt_embeds_mask=mask.to(dev) if mask is not None else None,
    height=1024,
    width=1024,
    num_inference_steps=40,
    generator=torch.Generator("cpu").manual_seed(0), # same noise on every rank
).images[0]
if dist.get_rank() == 0:
    image.save("out.png")
يمكنك تشغيل هذا الجزء من الكود باستخدام: NEURON_LOGICAL_NC_CONFIG=2 torchrun --nproc_per_node=8 run.py.
ستصبح المزيد والمزيد من خطوط الأعمال متوافقة مع TP. إذا لم تكن خطوة الأعمال التي تفضلها متوافقة، يمكنك أيضًا إضافة دعم لها وفقًا هذا الدليل.
الخوارزميات
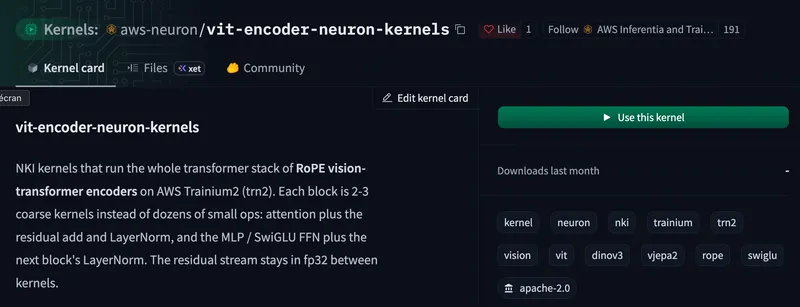
تأكد من زيارة مكتبات الفريق Neuron، حيث ستتوفر مزيد من مكتبات Neuron على Hub لتسريع نماذجك. يمكن كتابة مكتبات Neuron باستخدام واجهة مكتبات Neuron (NKI)، والتي توفر تحكمًا أقل لتحسين العمليات. بهذه الطريقة، يمكن للمستخدمين تشغيل عملياتهم المخصصة ومشاركتها على Hub.
يمكنك استخدام على سبيل المثال هذا النواة لتسريع أجهزة تحويل الصور الخاصة بك، مع تحسين سرعة العمل بنسبة تصل إلى 2.4 مرة على منصة Trainium!

الشكر والتقدير
شكر خاص لفريق AWS على عملهم في TorchNeuron وعلى رد فعلهم الاستجابي تجاه تعليقاتنا لتحسين تكامل HF إلى أقصى حد ممكن.