
تقليديًا، كان تغيير عدد وحدات GPU في خدمة vLLM يتطلب إضافة أو إزالة نسخ نموذجية كاملة أو إعادة تشغيل المحرك بعدد مختلف من وحدات GPU. ومع نمو النماذج أكبر، تحتاج كل نسخة إلى المزيد من وحدات GPU، لذا فإن التوسّع عبر النسخ يضيف أو يزيل وحدات GPU بزيادات كبيرة على نحو متزايد. كانت إعادة تشغيل vLLM لتوسيع DeepSeek V4 Pro من 16 إلى 20 وحدة GB200 GPU توقف الخدمة لمدة 197 ثانية (انظر قسم الأداء للتفاصيل)، تاركةً تلك وحدات GPU المكلفة مخصصة دون توليد أي رموز.
في منشورنا الأول عن Elastic EP، أظهرنا كيف يمكن لـ vLLM إضافة أو إزالة وحدات GPU من نشر DEP قيد التشغيل (اهتمام متوازٍ بالبيانات مع MoE متوازٍ بالخبراء) دون إعادة التشغيل. وعلى الرغم من أننا تجنبنا إعادة التشغيل، ظل تقديم الخدمة متوقفًا طوال إعادة التكوين بينما كنا نهيئ العاملين الجدد، ونجهّز مجموعات الاتصال الموسعة، ونحمّل أوزان النموذج، ونكرر تسخين النوى والتقاط رسوم CUDA البيانية. في معيار قياس DeepSeek V4 Pro لدينا، استمرت هذه الوقفة 100 ثانية عند التوسع من 16 إلى 20 وحدة GPU و 56 ثانية عند العودة إلى 16 وحدة GPU (التفاصيل الكاملة في قسم الأداء).
في هذا المنشور، نصف كيف مكّن التحضير غير المتزامن و NIXL EP من إعادة تكوين Elastic EP بوقت توقف يقارب الصفر. في المعيار القياسي نفسه، خفّضنا وقت التوقف إلى 0.82 ثانية عند التوسع من 16 إلى 20 وحدة GPU و 1.96 ثانية عند العودة إلى 16 وحدة GPU، مما سمح لنا بالتوسع صعودًا وهبوطًا دون أي تأثير يُذكر على أداء تقديم الخدمة.
تداخل تحضير الطوبولوجيا مع تقديم الخدمة
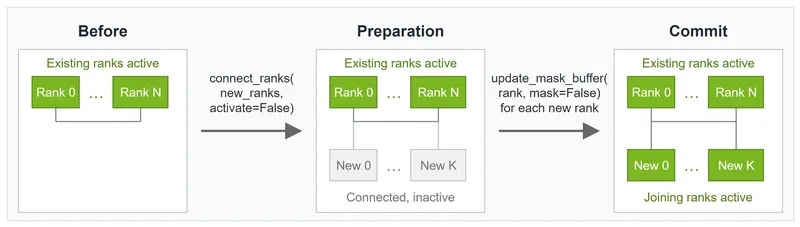
أعدنا تنظيم تدفق إعادة التكوين في vLLM إلى مرحلتين: تحضير في الخلفية والتزام قصير. يستخدم العاملون الحاليون خيوط خلفية منفصلة لتحضير الاتصال المستهدف وتسخينه، ونقل أوزان النموذج، ومزامنة المعلومات المتعلقة بالتنفيذ (مثل نتائج الضبط التلقائي) مع العاملين المنضمين، مع الاستمرار في خدمة الطلبات بمجموعات الاتصال الحالية ورسوم CUDA البيانية. وبالتوازي، يهيئ العاملون المنضمون أنفسهم، ويستلمون أوزان النموذج، ويحضّر اتصالاتهم وتنفيذ GPU. خلال مرحلة الالتزام، توقف vLLM مجدوليه باختصار، وفعّل الطوبولوجيا المحضّرة، ثم استأنف تقديم الخدمة. تم تقديم هذه التغييرات في التحضير غير المتزامن و تحسينات التحضير/الالتزام.
يشمل التحضير أربع مهام رئيسية:
- تهيئة العاملين المنضمين. بدء عملياتهم وتخصيص وحدة التخزين للنموذج والتنفيذ.
- تحضير الاتصال. إعداد مجموعات الاتصال الهدف وتوسيع مُتصل EP.
- نقل أوزان النموذج. نقل الأوزان المطلوبة من العاملين القائمين إلى العاملين المنضمين عبر NVLink أو RDMA.
- التحضير للتنفيذ. إكمال التجميع المطلوب وإحماء النوى (kernel warmup) وإعداد الضبط وبناء رسوم CUDA graph على العاملين المنضمين.
بعد مرحلة الالتزام (commit)، يتيح موازنة حمل الخبراء المتوازية غير المتزامنة (EPLB) للعاملين الجدد البدء في معالجة الانتباه بينما يتولى العاملون القائمون حساب الخبراء. ثم يعيد EPLB توزيع الخبراء عبر المجموعة الموسعة في الخلفية.
التحدي الرئيسي هو تهيئة الاتصال وتنفيذ GPU دون إشراك العاملين الذين يخدمون الطلبات أو تعطيل عملهم.
توسيع اتصال EP في مكانه
قبل NIXL EP، كانت أنظمة الاتصال الخلفية لـ EP المتوفرة في vLLM تستخدم عضوية ثابتة: حيث تُنشأ كل نسخة لمجموعة محددة من الرتب (ranks). وإضافة الرتب أو إزالتها تتطلب نسخة جديدة. وحتى عندما يمكن إنشاء تلك النسخة في الخلفية، تبقى مشكلتان.
أولاً، تحتاج النسختان القديمة والجديدة إلى مخازن مؤقتة للاتصال وموارد أخرى منفصلة، بما في ذلك تسجيلات الذاكرة ومقابض IPC وأزواج قوائم انتظار RDMA (QPs). والحفاظ على كلتا النسختين حيتين يزيد من استخدام ذاكرة الاتصال ويتطلب إعادة الإعداد بدلاً من إعادة استخدام الموارد القائمة.
ثانياً، يؤدي تبديل مُتصلات EP إلى تغيير المخازن المؤقتة وحالة الاتصال التي تستخدمها نوى اتصال EP. وهذا يجعل رسوم CUDA graph الملتقطة سابقاً غير صالحة، ويجب إعادة التقاطها قبل استئناف الخدمة. وهو ما يتطلب تكرار الإحماء وبناء الرسوم لعدد كبير من أشكال الدفعات عبر جميع العاملين المحتفظ بهم. في معيار الأداء الخاص بنا على DeepSeek V4 Pro، وحتى مع التحضير غير المتزامن، أدى إجراء الإحماء وإعادة التقاط الرسوم أثناء مرحلة الالتزام إلى توقفات في الخدمة بلغت 58 ثانية أثناء التوسع بالزيادة و 44 ثانية أثناء التوسع بالنقصان.
لحل هذه المشكلات، صممنا NIXL EP، وهي مكتبة اتصال EP مصممة خصيصاً لـ Elastic EP. فهي تضيف الرتب أو تزيلها في مكانها، مع إعادة استخدام نفس وكيل NIXL والمخازن المؤقتة والاتصالات. ويمكن ربط النظراء الجدد بينما يواصل العاملون القائمون تقديم الخدمة، ولا يحتاج سوى النظراء المنضمين إلى اتصالات وتسجيلات جديدة. كما يحافظ NIXL EP على صلاحية مدخلات الإرسال (dispatch) والدمج (combine) لـ EP الملتقطة عبر عمليات إعادة التهيئة، مما يتيح للعاملين المحتفظ بهم إعادة استخدام رسوم CUDA graph القائمة لديهم.
أثناء التحضير، يتصل خيط الخلفية في vLLM بنظراء الانضمام دون تفعيلهم. ثم تُفعِّل مرحلة الالتزام (commit) النظراء المُحضَّرين دون استبدال المُتصل (communicator).
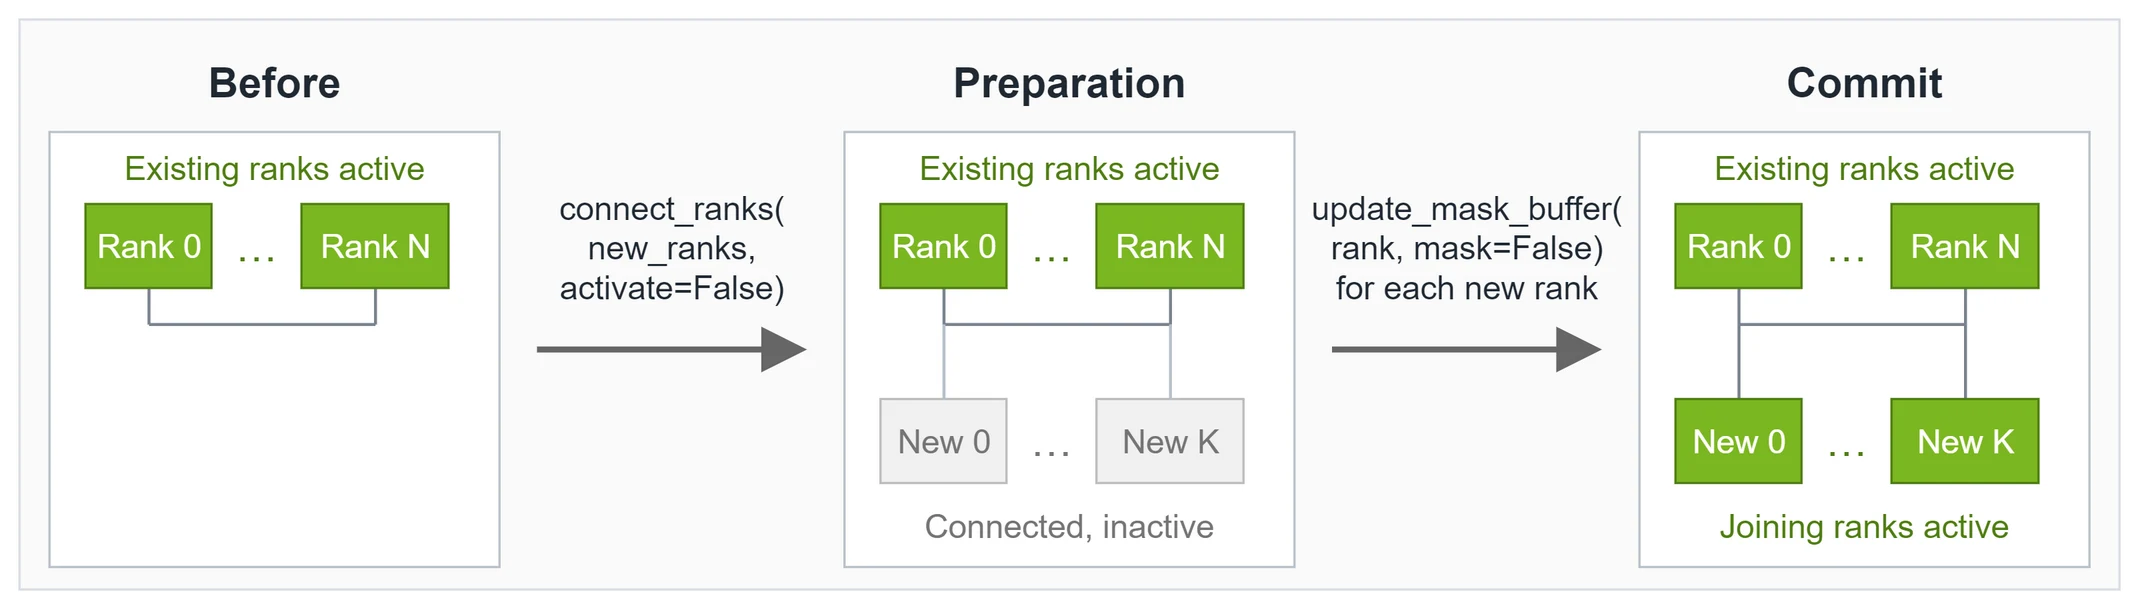
الشكل 1. توصيل وتفعيل نظراء EP جدد. الرتب الخضراء نشطة؛ والرتب الرمادية متصلة لكنها مُقنَّعة. خلال مرحلة الالتزام، تُفعَّل النظراء الجدد دون استبدال الوكيل أو المخازن المؤقتة.
لا يزال vLLM ينشئ مجموعات تنسيق DP جديدة ومجموعات EPLB للطوبولوجيا المستهدفة، لكن اتصالاتها تجري خارج تمريرة التغذية الأمامية المُلتقَطة للنموذجلذا فإن التحويل إليها لا يُبطل رسوم CUDA البيانية.
الحفاظ على رسوم CUDA البيانية في عمّال العمل القائمين
تُسجِّل صورة CUDA البيانية عمليات وحدة معالجة الرسومات (GPU) بحيث يمكن لـ vLLM إعادة تشغيل تمريرة أمامية دون إطلاق كل عملية مرارًا من وحدة المعالجة المركزية. تتضمن عقدة النواة المُلتقَطة إعدادات إطلاقها وقيم وسائطها، بما في ذلك المؤشرات إلى موترات المدخلات والمخرجات. يمكن أن يتغيّر محتوى الذاكرة بين عمليات إعادة التشغيل، لكن يجب أن تبقى المؤشرات المُسجَّلة صالحة. هذه المتطلبات جزء من عقد تنفيذ رسوم CUDA البيانية.
يلتقط vLLM رسومًا بيانية منفصلة لأشكال الدفعات المختلفة وأنماط التنفيذ ويُشغِّل تمريرات أمامية للتسخين قبل كل عملية التقاط.
الحفاظ على رسوم CUDA البيانية المُلتقَطة يتطلب أكثر من مجرد إبقاء كائن المُتصل حيًّا. كما يحافظ NIXL EP أيضًا على إعدادات إطلاق النوى، ووسائط الاتصال المرئية للرسم البياني، وعناوين موترات المدخلات والمخرجات مستقرة عبر إعادة التهيئة. وتقرأ نواياه عضوية المجموعة النشطة من حالة الجهاز التي يمكن تحديثها في مكانها.
كما غيّرنا vLLM لإبقاء الوسائط المُلتقَطة وإعدادات الإطلاق وعناوين موترات المدخلات والمخرجات لنوى الحساب المحيطة مستقرة عبر إعادة التهيئة:
- نُعيد استخدام كائنات تنفيذ fused-MoE لعمّال العمل المحتجَزين بدلًا من إعادة بنائها لحجم EP نشط مختلف.
- نُبقي عناوين وتخطيطات مساحات العمل المرئية للرسم البياني ومخرجات الإرسال (dispatch) مستقرة عبر إعادة التهيئة حتى تتمكن نوى الخبراء المُلتقَطة من مواصلة استخدامها. وتُستخدم مخرجات الإرسال أيضًا كمدخلات لحساب الخبراء. لو تغيّرت عناوينها أو تخطيطاتها مع حجم EP، فستظل نوى الخبراء المُلتقَطة تستخدم المؤشرات والإزاحات القديمة.
- نحافظ على مساحة التخزين الداعمة لموترات توجيه الخبراء ونُحدِّث التعيينات في مكانها. وهذا يتيح لـ EPLB تغيير محتويات التعيين دون نقل الموترات المستخدمة من قِبل النوى المُلتقَطة.
تسمح هذه التغييرات مجتمعةً لعمّال العمل المحتجَزين بـ إعادة استخدام رسوم CUDA البيانية الحالية لديهم بعد التوسّع والتقليص معًا.
تجهيز عمّال الانضمام بشكل مستقل
عمّال العمل القائمون لديهم رسوم بيانية يجب الحفاظ عليها. أمّا عمّال الانضمام فليس لديهم أي منها.
يُجهِّز عمّال الانضمام عادةً من خلال تشغيل تمريرات أمامية للنموذج مع إرسال ودمج EP، وكذلك تبادل معلومات الدفعات مع عمّال آخرين. تتطلب هذه الخطوات مشاركة عمّال آخرين، لكن عمّال العمل القائمين مشغولون بالفعل بخدمة طلبات حقيقية على الطوبولوجيا الحالية.
يتيح NIXL EP لكل عامل انضمام أن يُقنِّع مؤقتًا كل نظير EP بعيد أثناء التسخين وتجهيز الرسم البياني. تكون رتبته المحلية فقط هي النشطة لاتصالات EP. كما عدّلنا vLLM بحيث لا تنتظر تمريرات التجهيز هذه معلومات الدفعات من DP من عمّال آخرين. هذا يتيح لعمّال الانضمام تشغيل دفعاتهم الوهمية والتقاط رسوم CUDA البيانية دون اشتراط مشاركة عمّال العمل القائمين.
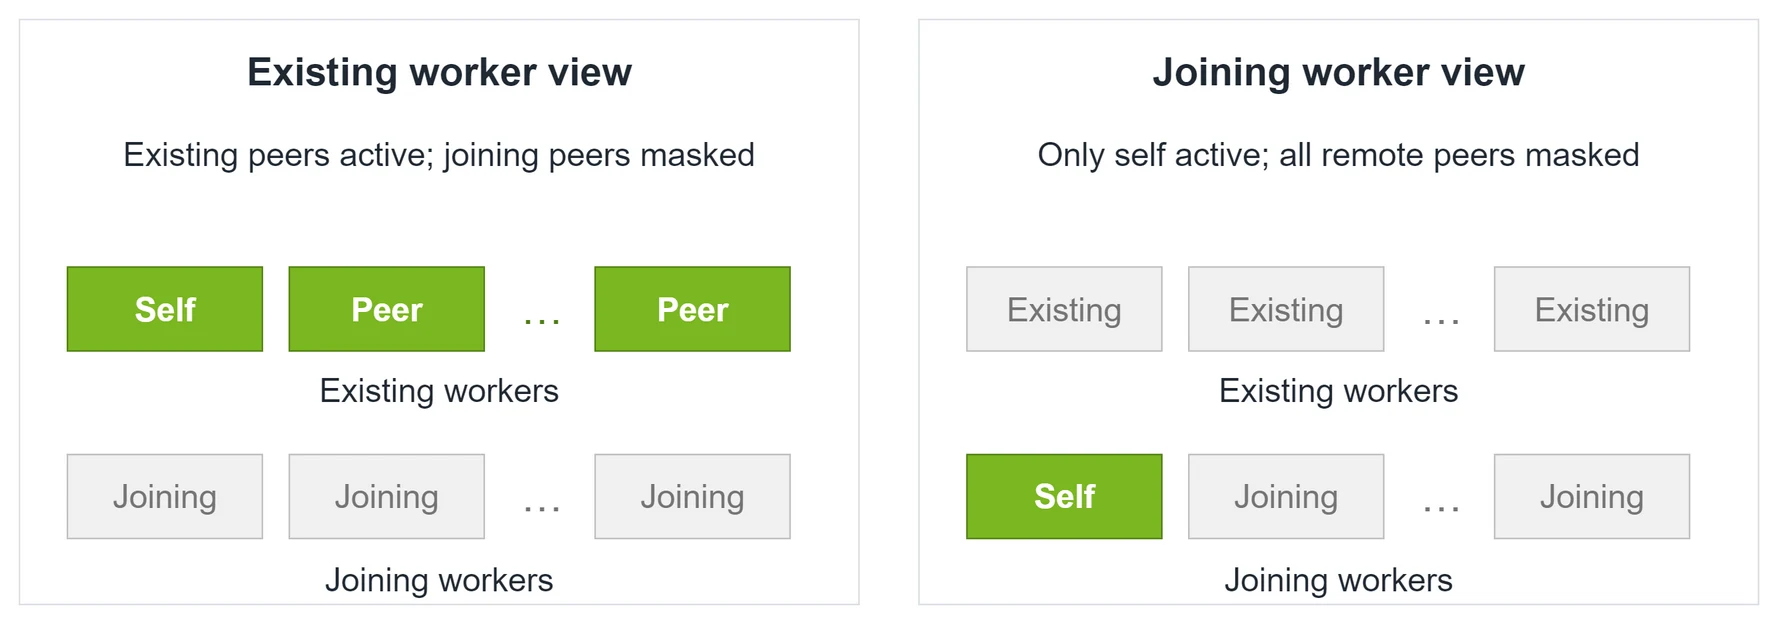
الشكل 2. الرتب الخضراء نشطة لاتصالات EP؛ والرتب الرمادية مُقنَّعة. يخدم عمّال العمل القائمون معًا بينما يُقنِّع كل عامل انضمام كل نظراء EP البعيدين لأغراض التجهيز.
بعد الالتقاط، يمكن لـ NIXL EP إعادة تفعيل النظراء دون إبطال الرسوم البيانية. ويُعيد عمّال الانضمام استخدام رسومهم البيانية المُلتقَطة محليًا عندما يبدؤون الخدمة كجزء من المجموعة الموسَّعة.
الأداء على DeepSeek V4 Pro
استخدمت جميع التجارب في هذا القسم DeepSeek V4 Pro على وحدات GB200 GPU، بأحجام TP=1 و DP/EP قدرها 16 و20. نُزِّلت أوزان النموذج مسبقًا بصيغة safetensors على تخزين Lustre مشترك وتم تحميلها باستخدام الإعداد الافتراضي --load-format auto. استخدمت القياسات ذاكرات تخزين مؤقت دافئة لتجميع النوى (Triton و TileLang و FlashInfer).
توقيتات التوسع والتصغير
يعرض الجدول المراحل التي تعمل أثناء إيقاف الخدمة مؤقتًا والتي تعمل في الخلفية بينما يستمر العاملون الحاليون في تقديم الخدمة.
| المرحلة | أ: حاجب | ب: تحضير غير متزامن | ج: تحضير غير متزامن + إعادة استخدام الرسم البياني |
|---|---|---|---|
| تهيئة العاملين المنضمين | الخدمة متوقفة مؤقتًا | الخلفية | الخلفية |
| تهيئة الاتصال بالهدف | تم إيقاف الخدمة مؤقتًا | في الخلفية | في الخلفية |
| نقل أوزان النموذج | تم إيقاف الخدمة مؤقتًا | في الخلفية | في الخلفية |
| التسخين والتقاط الرسم البياني على العمال المنضمين | تم إيقاف الخدمة مؤقتًا | تم إيقاف الخدمة مؤقتًا | في الخلفية |
| التسخين والتقاط الرسم البياني على العمال الحاليين | تم إيقاف الخدمة مؤقتًا | تم إيقاف الخدمة مؤقتًا | غير مطلوب (تبقى الرسوم البيانية الحالية صالحة) |
| تنشيط الهيكل المستهدف | تم إيقاف الخدمة مؤقتًا | تم إيقاف الخدمة مؤقتًا | تم إيقاف الخدمة مؤقتًا |
الإعداد C مدعوم فقط بواسطة NIXL EP.
- وقت التوقف: انقطاع الخدمة المُلاحظ، عندما تتوقف الطلبات الجارية عن التقدم ولا يتم قبول الطلبات الجديدة.
- الوقت الإجمالي: مدة عملية التوسّع الكاملة، بما في ذلك التحضير.
تُقاس المددتان بشكل منفصل.
| المقياس | A: حظر | B: تحضير غير متزامن | C: تحضير غير متزامن + إعادة استخدام الرسم البياني |
|---|---|---|---|
| من 16 إلى 20 GPU: وقت التوقف | 99.62 ثانية | 58.04 ثانية | 0.82 ثانية |
| من 20 إلى 16 وحدة معالجة رسومية: وقت التوقف | 56.25 ثانية | 44.07 ثانية | 1.96 ثانية |
| من 16 إلى 20 وحدة معالجة رسومات: إجمالي الوقت | 99.72 ثانية | 97.27 ثانية | 92.34 ثانية |
| من 20 إلى 16 وحدة معالجة رسومية: الوقت الإجمالي | 56.21 ثانية | 51.46 ثانية | 9.32 ثانية |
نجحت جميع التكوينات في اختبارات الصحة الرقمية، بما في ذلك الفحوصات على كل عامل انضمام.
الحفاظ على SLO أثناء إضافة وحدات معالجة الرسومات (GPUs)
قمنا بتشغيل DeepSeek V4 Pro على 16 وحدة معالجة رسومات (GPU)، ثم زدنا تدريجياً معدل الطلبات الواردة من حوالي 8 إلى 16 طلباً في الثانية. أعدنا تشغيل نفس السيناريو المكون من 11,391 طلباً على ثلاث عمليات نشر: واحدة بقيت على 16 وحدة معالجة رسومات، وأخرى أُعيد تشغيلها بـ 20 وحدة، وثالثة توسعت إلى 20 وحدة باستخدام Elastic EP مع NIXL EP. وكان الهدف على مستوى الخدمة (SLO) هو أن يبقى زمن الوصول إلى الرمز الأول عند المئين 95 المتحرك أقل من 5 ثوانٍ.
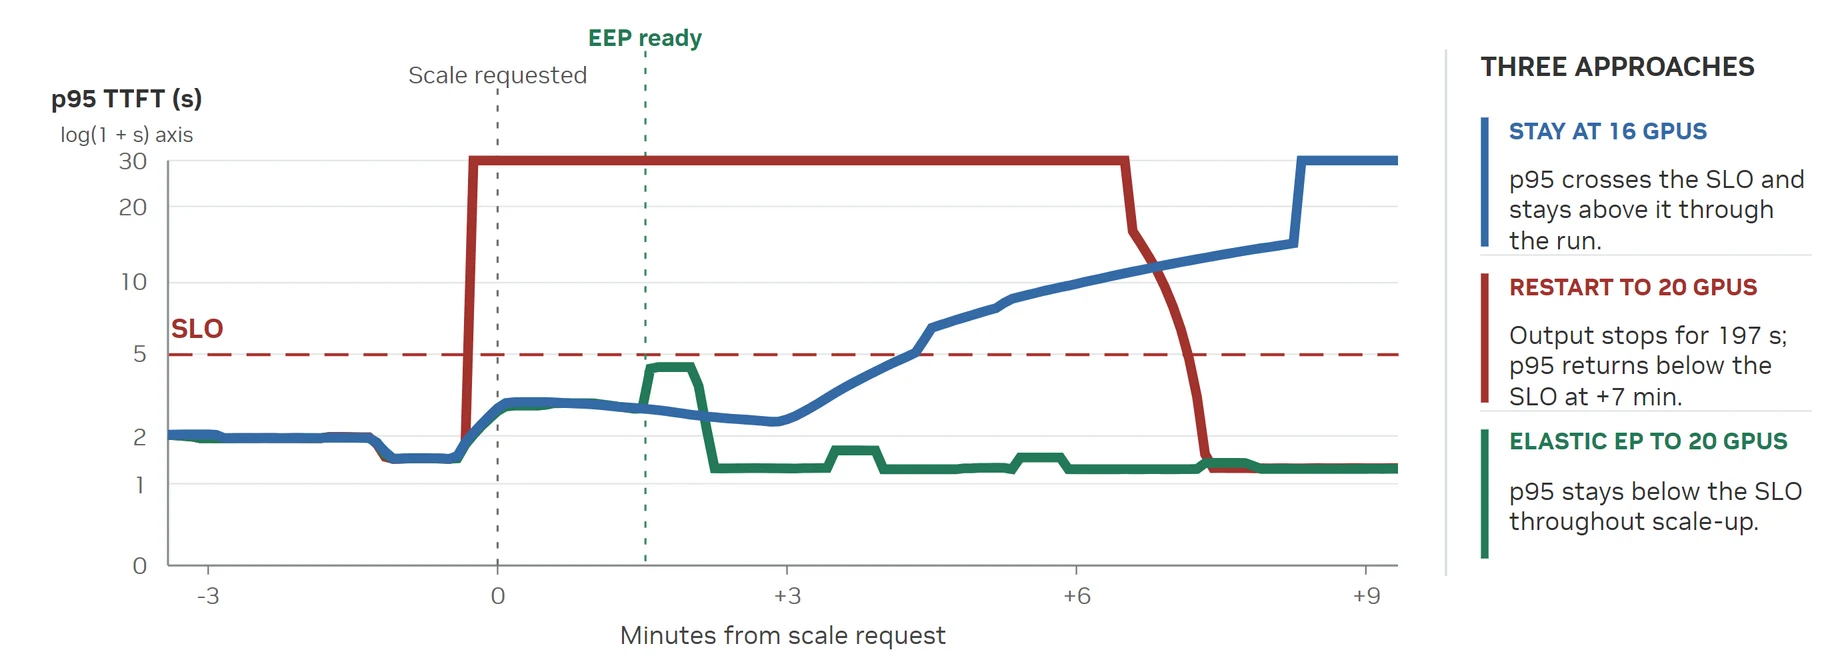
الشكل 3. الخدمة من البداية إلى النهاية تحت تزايد حمل الطلبات. تُظهر المنحنيات نتائج p95 المتداولة خلال 30 ثانية، مع إسناد عقوبة مدتها 30 ثانية للطلبات الفاشلة بدلاً من قياس TTFT فعلي.
- أكملت Elastic EP جميع الطلبات البالغ عددها 11,391 وبقيت دون حد الـ SLO طوال السيناريو.
- أثناء التحضير، طابق Elastic EP أداء الخدمة للنشر الثابت المكون من 16 وحدة معالجة رسومية، دون أي تدهور ملحوظ ناتج عن التحضير في الخلفية.
- بعد التوسيع، طابقت Elastic EP أداء نشر الـ 20 وحدة معالجة رسومية المستعاد، دون أي تدهور مرئي بعد التوسيع.
جرّب Elastic EP
تُتاح اليوم إجراءات التحضير المسبق، وإعادة استخدام الرسوم البيانية في CUDA، والالتقاط المستقل للرسوم البيانية على العاملين المنضمين في أحدث vLLM و NIXL الإصدارات. ثبّتها باستخدام pip وابدأ في استخدام Elastic EP.
للاطلاع على مثال استخدام كامل، انظر cuda_graphs_heavy_nixl_ep حالة في اختبار Elastic EP الخاص بـ vLLM. يتضمن المثال إعدادات الخادم واستدعاءات واجهة برمجة التطبيقات للتوسعة. يقوم بالتوسع من وحدتي معالجة رسومات إلى أربع ثم العودة أثناء إرسال الطلبات، مع التحقق من تقديم الخدمة أثناء التجهيز ودقة النموذج حول كل عملية تغيير حجم.
ماذا سيأتي بعد ذلك
استعادة العاملين الدافئين باستخدام Dynamo Snapshot
لقد حللنا بفعالية مشكلة الانقطاع الطويل. التحدي التالي هو تجهيز السعة الجديدة بسرعة أكبر. نخطط لدمج Dynamo Snapshot حتى يتمكن العمال المنضمون من استعادة حالة العملية والحالة المُهيّأة لـ CUDA بدلاً من تكرار الترجمة والتسخين الأولي للنوى وبناء الرسم البياني وأعمال بدء التشغيل الأخرى.
يجب تجهيز الاتصال للطوبولوجيا المستهدفة بشكل منفصل لأنه لا يُستعاد من اللقطة. يمكن أن تستغرق استعادة أوزان النماذج الكبيرة من وحدة تخزين نقاط التفتيش معظم وقت الاستعادة، لذلك نخطط للاحتفاظ بنقل الأوزان من GPU إلى GPU في Elastic EP من العمال الحاليين بدلاً من ذلك.
تحقيق اتصال EP من الطراز الأول مع NIXL EP
نسعى إلى تحقيق أداء من الطراز الأول في عمليتي الإرسال والدمج مع NIXL EP مع الحفاظ على الدعم الكامل لـ Elastic EP وتحمل الأعطال. التحديث القادم لأداء NIXL EP هو الخطوة التالية نحو هذا الهدف (انظر خارطة طريق NIXL EP RFC).
ربط Elastic EP بتنسيق Dynamo و llm-d
مع توفر القدرة على مستوى المحرك، فإن الخطوة التالية هي استخدام Elastic EP من أدوات التوسع التلقائي في المنسّقين. العمل على هذا التكامل جارٍ بالفعل عبر مجتمعات vLLM و Dynamo و llm-d.
تشمل هذه الجهود عمل vLLM على موازن التحميل الخارجي و مقترح Elastic EP في Dynamo.
إذا كنت تشغّل الاستدلال (inference) على نطاق واسع، فنشجعك على تجربة Elastic EP ومشاركة أحمال العمل ومتطلبات التشغيل الخاصة بك. وإذا كنت تبني بنية تحتية للاستدلال، فنرحب بمساهماتكم في vLLM Elastic EP وNIXL EP. لنجعل Elastic EP يعمل في بيئة الإنتاج.
شكر وتقدير
- لـ Tyler Michael Smith وSage Moore من Red Hat على ملاحظاتهم القيّمة ومراجعاتهم الدقيقة على مدار هذا العمل.
- لـ Linoy Geva (NVIDIA) على عملها في أداء الخدمة أثناء مرحلة التحضير.
- لفريق NIXL بأكمله على جهوده في NIXL EP.
- لـ Tzu-Ling Kan وJulien Mancuso وفريق Dynamo بأكمله على جهودهم لدعم Elastic EP في Dynamo.