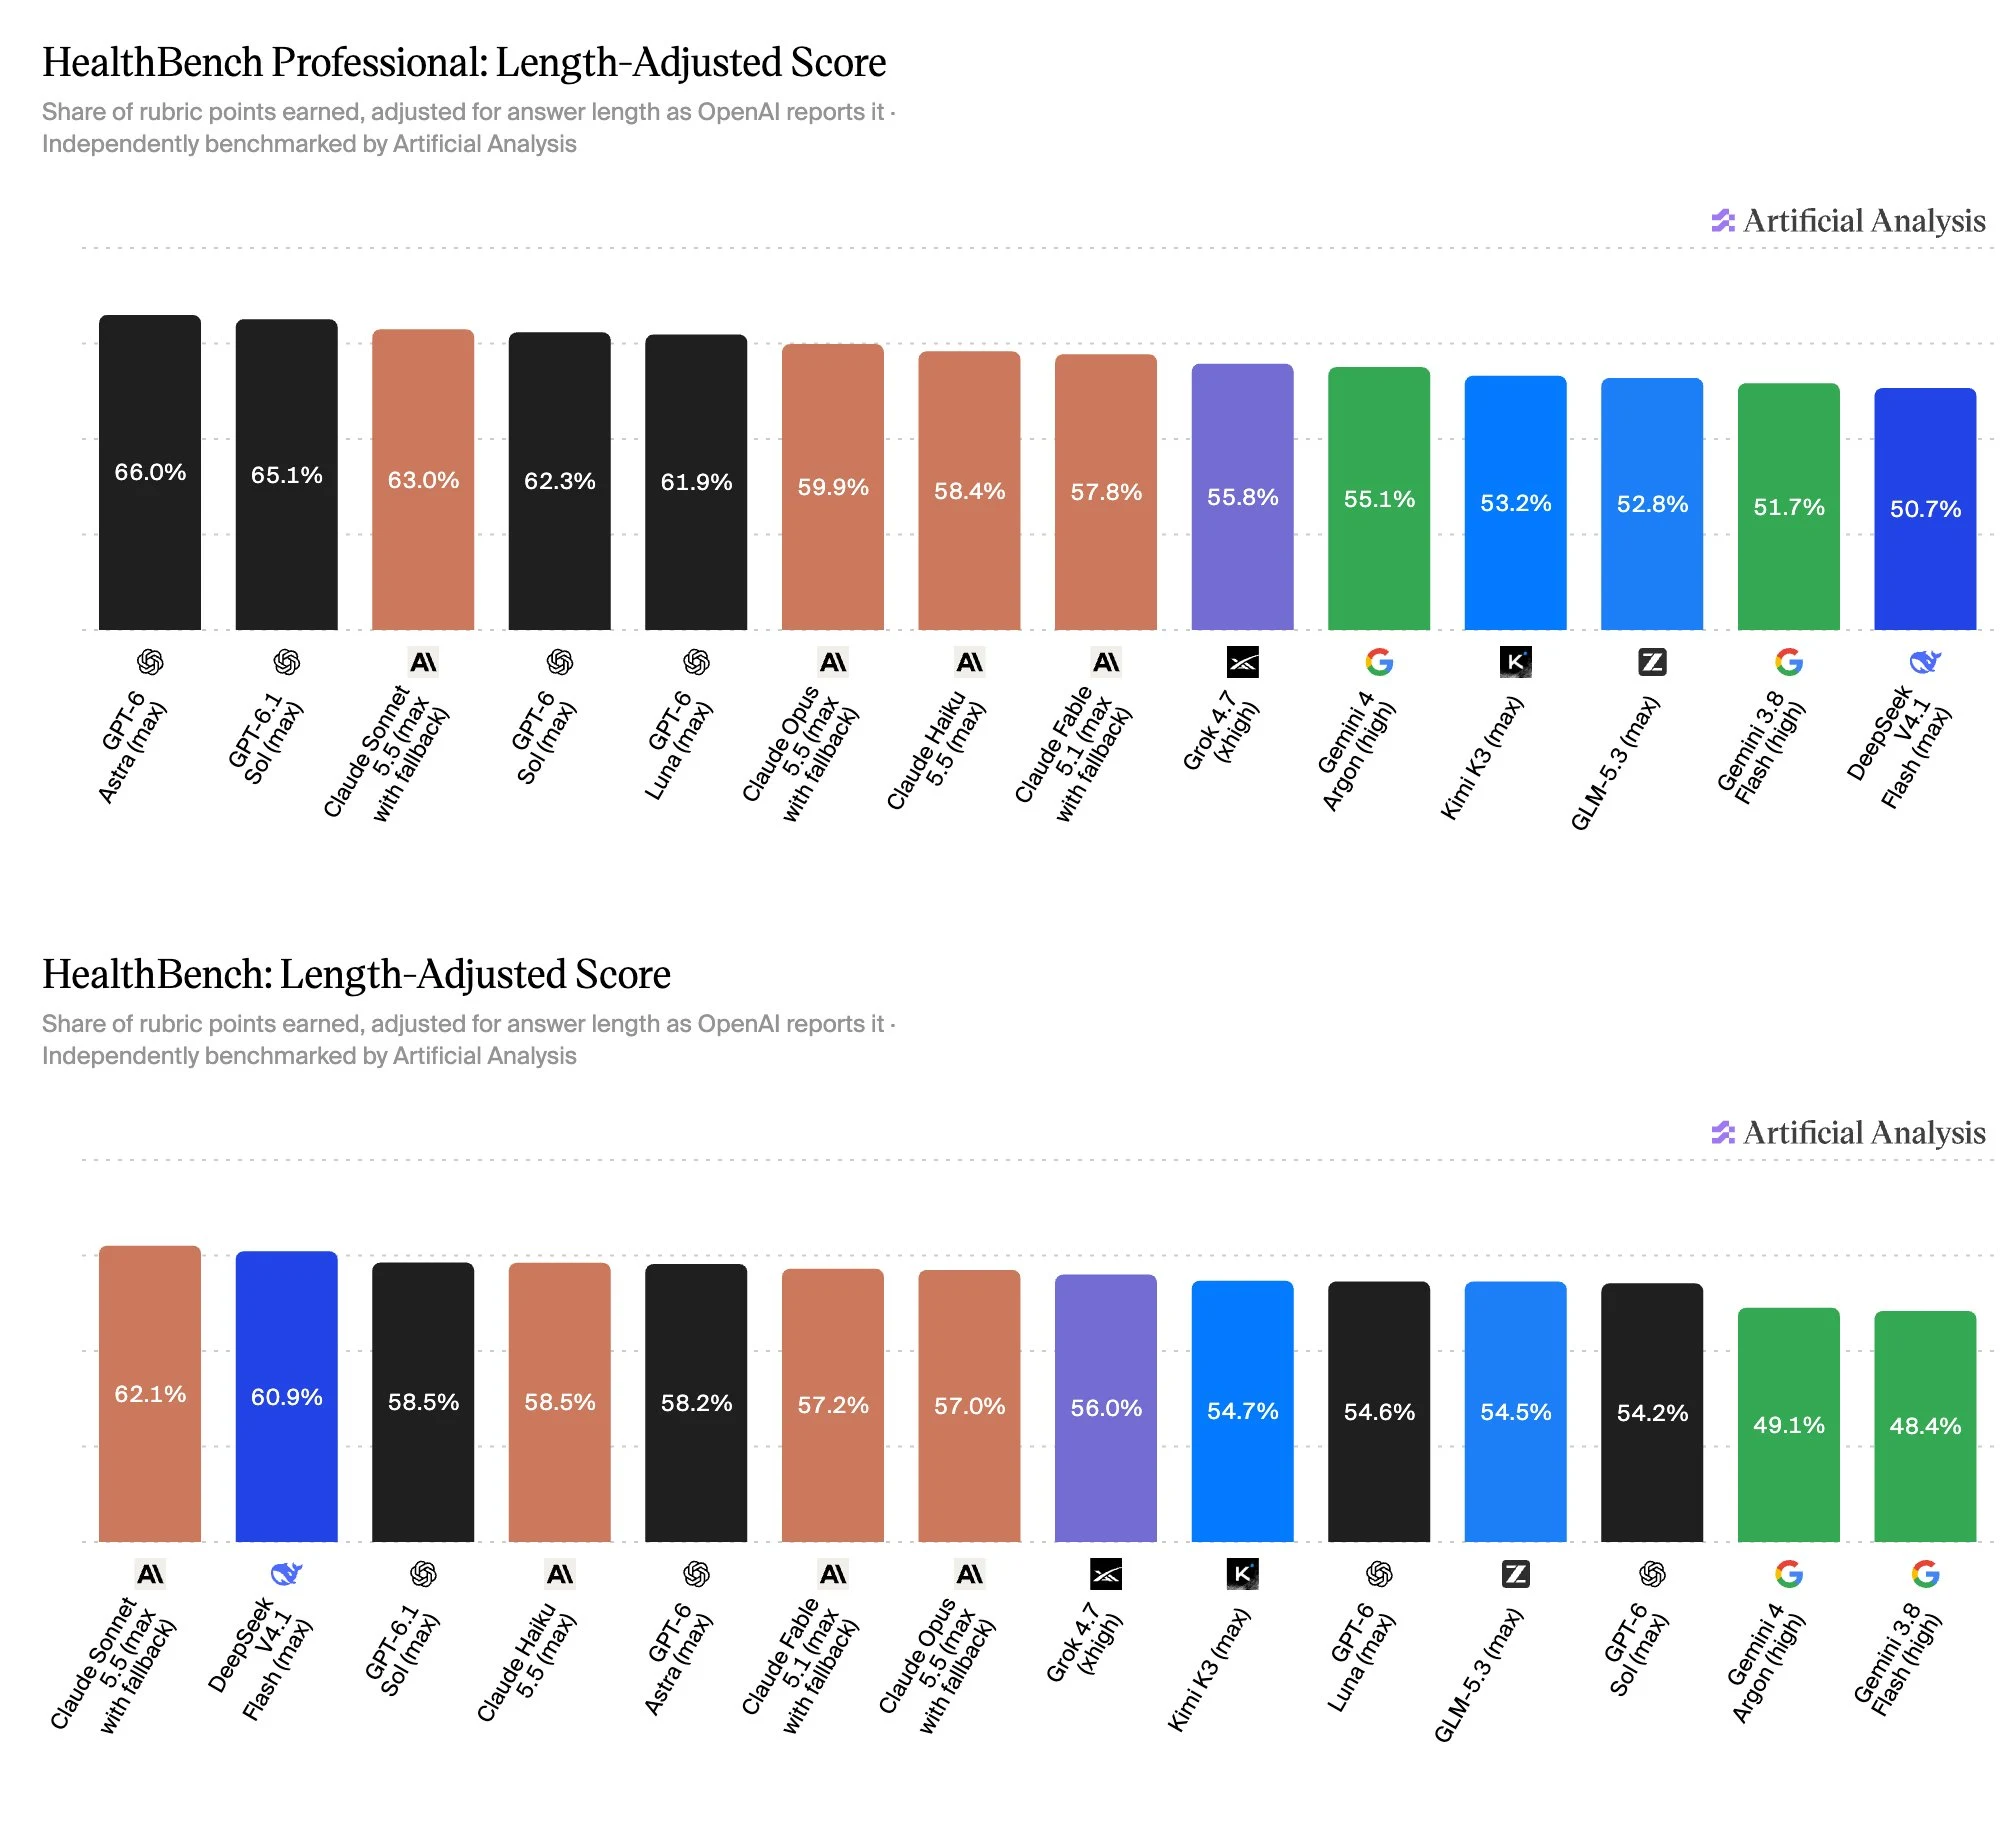
نطلق لوحات صدارة لمعياري HealthBench وHealthBench Professional، وهما معياران يقيّمان كيفية استجابة نماذج الذكاء الاصطناعي في محادثات صحية واقعية
HealthBench وHealthBench Professional هما معياران من @OpenAI يقيّمان ردود النماذج على محادثات صحية واقعية وفق معايير وضعها أطباء.
يختبر HealthBench النماذج على 5,000 محادثة صحية مع مستخدمين عاديين وعاملين صحيين. وتغطي هذه المحادثات سبعة مواضيع، من الإحالات الطارئة إلى الصحة العالمية، وكل معيار في المطاطة يندرج تحت أحد خمسة محاور: الدقة، والاكتمال، وجودة التواصل، والوعي بالسياق، واتباع التعليمات. أما HealthBench Professional فهو مجموعة أصغر من 525 محادثة، على خلاف HealthBench، فهي جميعًا مع ممارسين سريريين. وتغطي مهام الاستشارة والكتابة والبحث، وتتضمن محادثات عدائية وصعبة مصممة لتحدي النماذج.
نعرض كل من الدرجة الخام (نسبة نقاط المطاطة المكتسبة) والدرجة المعدّلة حسب الطول التي تعرضها OpenAI. تخفض الدرجة المعدّلة حسب الطول درجات الردود الأطول من 2,000 حرف وترفع درجات الردود الأقصر. وبما يتوافق مع التنفيذ الأصلي من OpenAI، يتم تقييم الردود بواسطة GPT-5.4 (low) (من أجل HealthBench Professional) وGPT-4.1 (من أجل HealthBench).
أبرز نتائج HealthBench Professional:
➤ يتصدّر GPT-6 Astra وGPT-6.1 Sol لوحة الصدارة: يحصل GPT-6 Astra (max) على 66.0% في الدرجة المعدّلة حسب الطول، وهي نتيجة مماثلة لنتيجة GPT-6.1 Sol (max، 65.1%) ومتقدمة على Claude Sonnet 5.5 (max with fallback، 63.0%)
➤ تشكّل نماذج OpenAI بأكملها حدود باريتو للدرجة مقابل التكلفة لكل مهمة: تتألف حدود باريتو من GPT-6 Luna (max، 61.9%، $0.004 لكل مهمة) عبر GPT-6 Sol (max، 62.3%، $0.036) وGPT-6.1 Sol (max، 65.1%، $0.047) وصولًا إلى GPT-6 Astra (max، 66.0%، $0.27). يحصل GPT-6 Luna (max) على درجة أقل بـ 4 نقاط من GPT-6 Astra (max) بتكلفة تقل عن 2% من التكلفة
➤ يتلقى Claude Opus 5.5 وClaude Fable 5.1 أكبر عقوبات مرتبطة بالطول: يبلغ متوسط كليهما نحو 5,900 حرف لكل إجابة، أي ما يقارب 3 أضعاف عتبة الـ 2,000 حرف، ويخسران أكثر من 11 نقطة بعد التعديل. يمتلك Claude Opus 5.5 (max with fallback) أعلى درجة خام (71.4%) لكنه يتراجع إلى المرتبة السادسة (59.9%). GPT-6 Sol (max) هو النموذج الوحيد الذي يقل متوسطه عن 2,000 حرف (نحو 1,600)، وهو الوحيد الذي ترتفع درجته
أبرز نتائج HealthBench:
➤ يتصدّر Claude Sonnet 5.5 معيار HealthBench: يحصل Claude Sonnet 5.5 (max with fallback) على 62.1% في الدرجة المعدّلة حسب الطول، متقدمًا على DeepSeek V4.1 Flash (max، 60.9%) وGPT-6.1 Sol (max، 58.5%)
➤ يشكّل GPT-6 Luna وDeepSeek V4.1 Flash وClaude Sonnet 5.5 حدود باريتو للدرجة مقابل التكلفة لكل مهمة: يحصل GPT-6 Luna (max) على 54.6% بتكلفة $0.002 لكل مهمة، ويحصل DeepSeek V4.1 Flash (max) على 60.9% بتكلفة $0.005 لكل مهمة. أما Claude Sonnet 5.5 (max with fallback) فيبلغ متوسط التكلفة لكل مهمة لديه $0.08، أي أغلى بنحو 16 مرة من DeepSeek V4.1 Flash مقابل زيادة في الدرجة تبلغ نحو 1 نقطة
➤ الإجابات الأقصر تضحّي بالاكتمال مقابل جودة التواصل: كل عنصر في مطاطة HealthBench مصنّف تحت أحد خمسة محاور. يتحقق الاكتمال مما إذا كان الرد يتضمن جميع المعلومات المهمة، بينما تتحقق جودة التواصل مما إذا كان الرد واضحًا ومنظمًا جيدًا وبالطول ومستوى التفاصيل المناسبين. يكتب GPT-6 Sol (max) أقصر الإجابات (نحو 1,000 حرف) وله أعلى درجة خام في جودة التواصل (81%)، لكنه الأدنى في درجة الاكتمال (34%). أما Claude Sonnet 5.5 (max with fallback) فيتقدم في الاكتمال (63%)