
إذا قمت بتشغيل النماذج على جهاز ماك أو استخدمت MPS كأداة للتعجيل الرئيسية للحوسبة، فهناك الكثير مما يمكن الاستمتاع به في PyTorch 2.15! وصل FP8 إلى MPS، وأصبح تفكيك نماذج اللغة أسرع من خلال الطبقات الخطية وsoftmax، كما أن الحسابات الجديدة لـ Metal تعالج بعض الأجزاء المكلفة بشكل مدهش في الصوت والفيديو وأعمال التدريب.
كلمة قصيرة حول من نحن: نحن فريق PyTorch في Hugging Face. نساهم في مجال PyTorch، ومن مجالات تركيزنا أحدها لوحة التحكم MPS، حيث الهدف هو جعل جهاز الكمبيوتر الخاص بك مكانًا ممتازًا لتشغيل وتدريب نماذج PyTorch. في بداية عام 2026، كان تشغيل النماذج الصغيرة على MPS غالبًا يتطلب التعامل مع عمليات غير مدعومة، وانخفاض في الأداء، وزيادة غير متوقعة في الذاكرة. لذلك نقوم بتشغيل النماذج الحقيقية من هوجينغفينغ فير هاب، في مجالات اللغة والصورة والفيديو، ونكتشف أين تكون MPS غير كافية، ونصحح ذلك في PyTorch من المصدر، وذلك بشكل متزايد عن طريق استبدال MPSGraph بعوامل Metal المتخصصة. جزء كبير من هذا المقال هو نتيجة لهذا العمل، الذي تم إنجازه مع أمناء PyTorch والمتطوعين في المجتمع.
ملخص مختصر
- FP8 يصل إلى ماك: يمكن تخزين قيم
float8_e4m3fnفي نصف المساحة مقارنة بـ BF16، واستخدام ضرب المصفوفات المقسمة وجميع العمليات الأخرى المدعومة على CUDA/CPU! - نماذج MoE تفكيك البيانات بسرعة 5–6.5 مرة أسرع من في 2.14: Qwen3.6-35B-A3B يزداد من 9.4 إلى 61.3 توكين/ثانية على M3 Ultra، بفضل دالة matmul المجمعة المدمجة والطريق المخصص للتفكيك، وعدد أقل من تنسيقات GPU-CPU، وتوجيه أسرع للأكثر كمية.
- قصر الوقت لكل توكين في كل نموذج LLM: تستخدم الطبقات الخطية ذات الصف واحد محيطات متخصصة من مصفوفات ومصفوفات، وعمل دالة softmax على المفردات أسرع بحوالي 8×.
- مزيد من الجبر الخطي على الشريحة GPU: حلول LU المعقدة والثلاثية، استدعاءات المصفوفات الصغيرة بشكل أسرع، وتحليل QR الأسرع.
- الصوت، الفيديو، والتدريب يحظون أيضًا بالاهتمام: مسارات أسرع للاستدخالات، التسوية، الخسارة، التداخل العكسي والتخفيضات. تصل قيمة الذاكرة لفك تشفير VAE الفيديو في Wan2.2 إلى 8 جيجابايت بدلاً من 270 جيجابايت.
- مزيد من السيطرة بواسطة بايثون: تدفقات MPS العامة وأوقات حدث أكثر موثوقية.
- المتطلبات المحدثة: الآن يتطلب MPS الإصدار 15 من macOS أو أحدث؛ ويتطلب PyTorch 2.15 الإصدار 3.11 من Python أو أحدث.
- نظرة على 2.16: التركيز الكامل على Metal، المزيد من عمليات الانتقال من MPSGraph إلى Metal، وتشفير أسرع للLLM.
ما يعنيه ذلك بالنسبة لك
إذا قمت بتشغيل النماذج على ماك باستخدام ترانسفورمرز أو ديفيودرز أو أدوات مثل ComfyUI، فهذه هي التغييرات التي تحدث في الممارسة العملية مع الإصدار 2.15:
- نماذج LLM المحلية أسرع بكثير. نماذج خليط الخبراء تفكيك النصوص بسرعة 5–6.5 مرة أسرع من في 2.14: على جهاز M3 Ultra مع
torch.compile، يرتفع مستوى Qwen3.6-35B-A3B من 9.4 إلى 61.3 توكين/ثانية، ونموذج LFM2.5-8B-A1B من 23.6 إلى 123.6 توكين/ثانية. تستفيد النماذج الكثيفة أيضًا، من واجهات خطية أسرع وخاصية softmax أسرع بـ 8 مرة لعملية العينة. (مزيد) - إنشاء فيديو يتناسب مع حجم الذاكرة. فك رمز الفيديو باستخدام VAE الموزع من Wan2.2 كان يدفع ذاكرة المحرك إلى 270 جيجابايت؛ أما الآن فإن الذاكرة تصل إلى حوالي 8 جيجابايت. (مزيد)
- تحرير الصور بشكل صحيح باستخدام Qwen-Image-2.1. في تاريخ 2.14، قام محول VAE Qwen-Image-2.1 VAE بتشويه الصور بشكل خفي على ملفات MPS، مما أدى إلى تدمير عمليات تحرير الصور (تم الإبلاغ عنه في ComfyUI). التغيير نفسه في التسوية يُصلح ذلك: الآن يتطابق عمليتي الترميز والتفكيك مع CPU عند 29.95 dB PSNR، مقارنة بـ 10.06 dB.
- أوزان FP8 على جهاز ماك الخاص بك. تستهلك الأقطاب الكبيرة من نوع FP8 نصف الذاكرة مقارنةً بـ BF16، ويقوم
F.scaled_mmبضربها مباشرة على الجهاز العصبي. (مزيد من المعلومات)
المحتوى
- بدء العمل
- FP8 يصل إلى MPS
- تشفير نموذج اللغة الأسرع
- الجبر الخطي يحصل على دعم إضافي
- الدوال المتكررة، التسطيح، والتدريب
- السوفتماكس والاستردادات
- حيز ذاكرة أصغر بكثير لفك التشفير للفيديو
- مزيد من السيطرة على تدفقات MPS
- المزيد من العمليات تعمل على MPS
- مشاهدة سريعة لبرنامج PyTorch 2.16
- ختام
بدء العمل
ستحتاج إلى جهاز Mac من نوع Apple Silicon مع macOS 15 أو أحدث وPython 3.11 أو أحدث (راجع مصفوفة التوافق للإصدار 2.15). إذا كان نظام التشغيل قديمًا جدًا أو لا يوجد GPU Metal متاح، فإن فحص توافر MPS يوضح سبب ذلك.
لتجربة المرشح المؤقت للإصدار في بيئة منفصلة:
uv pip install torch==2.15.0 --index-url https://download.pytorch.org/whl/test/cpu
يصبح FP8 متاحًا في MPS
FP8 يوفر لك طريقة أخرى لتوفير الذاكرة على جهاز ماك الخاص بك. يضيف PyTorch 2.15 تونسات torch.float8_e4m3fn على MPS: بايت واحد لكل قيمة، وهو نصف حجم التخزين المطلوب لـ FP16 أو BF16.
يمكنك ضرب هذه التنسورات بـ F.scaled_mm، والتي تدعم التمييز على مستوى التنسورات وعلى مستوى الصفوف. إليك مثالًا صغيرًا حيث هناك تمييز واحد لكل تنسور:
import torch
import torch.nn.functional as F

def quantize_fp8(x):
    limit = torch.finfo(torch.float8_e4m3fn).max
    scale = x.abs().amax().clamp_min(1e-12) / limit
    return (x / scale).to(torch.float8_e4m3fn), scale

x = torch.randn(1, 1024, device="mps", dtype=torch.float32)
weight = torch.randn(1024, 1024, device="mps", dtype=torch.float32)
x_fp8, x_scale = quantize_fp8(x)
w_fp8, w_scale = quantize_fp8(weight)

y = F.scaled_mm(
    x_fp8,
    w_fp8.t(),
    scale_a=x_scale,
    scale_recipe_a=F.ScalingType.TensorWise,
    scale_b=w_scale,
    scale_recipe_b=F.ScalingType.TensorWise,
    output_dtype=torch.bfloat16,
)
print(y.shape, y.dtype)
تحليل فوري لمعالجة نماذج اللغة
لكل نموذج ذكاء اصطناعي من نوع LLM مرحلة مُحضّرة مسبقة ومرحلة تفكيك. أثناء عملية التفكيك، يخضع كل توكين جديد للنموذج كصفحة واحدة، بحيث تتحول عمليات الضرب الكبيرة على المصفوفة إلى منتجات مصفوفة-خط. تقوم إصدار PyTorch 2.15 بتسريع كلا النوعين من الطبقات التي تهيمن على هذه الخطوة: الطبقات الخطية الكثيفة والطبقات المختلطة من الخبراء.
طبقات خطية
لقد كان لدى MPS محركات GEMV للـ torch.mm منذ الإصدار 2.14، لكن F.linear لا يزال يمر عبر MPSGraph. في PyTorch 2.15، يقوم بالربط بينهما وبين F.linear، لذا فإن المدخلات المشتركة [1, 1, hidden_size] تُستخدم مباشرة، مع دمج إضافات الانحراف المؤهلة فيها. على طول أشكال الطبقات 96 BF16 من النماذج الحقيقية، يكون ذلك تحسينًا بمعدل 1.23× في السرعة. تتمثل الفوائد الكبرى في الإسقاطات الصغيرة، مثل البوابات في نماذج MoE، حيث ترك الطريق القديم معظم عبء التخزين غير مستغَل. أما الطبقات الكبيرة ورؤوس LM فكانت بالفعل قريبة من حدود عبء التخزين، لذا تظل عند مستوى 1×.
طبقات الخبراء المختلطة
يُرسل طبقة مزيج من الخبراء عددًا مختلفًا من الترميزات إلى كل خبير. يتعامل برنامج Grouped matmul مع هذه المجموعات غير المتساوية في عملية واحدة، ويوفر 2.15 لـ MPS تنفيذًا أصليًا .
في الإصدار 2.14، قامت عملية matmul المجمعة بنقل توقيتات المجموعات إلى المعالج الدقيق (CPU) وتمت مراجعة المجموعات بشكل متكرر. تقرأ العمليات النواة الجديدة لبرنامج Metal التوقيتات مباشرة على GPU، باستخدام مبادئ الأداء الأساسية لبرنامج Metal عند توافرها، وبطريق Metal منفصل في حالات أخرى. بالنسبة للمجموعات الصغيرة، وهي الحالة الشائعة أثناء التشفير، يحصلون أيضًا على نواة خاصة بهم.
على سبيل المثال، يمكن تقسيم 64 توكينًا إلى مجموعات من 16 و32 و16.
import torch
import torch.nn.functional as F

tokens = torch.randn(64, 64, device="mps", dtype=torch.bfloat16)
weights = torch.randn(3, 128, 64, device="mps", dtype=torch.bfloat16)
ends = torch.tensor([16, 48, 64], device="mps", dtype=torch.int32)

out = F.grouped_mm(tokens, weights.transpose(-2, -1), offs=ends)
print(out.shape)  # torch.Size([64, 128])
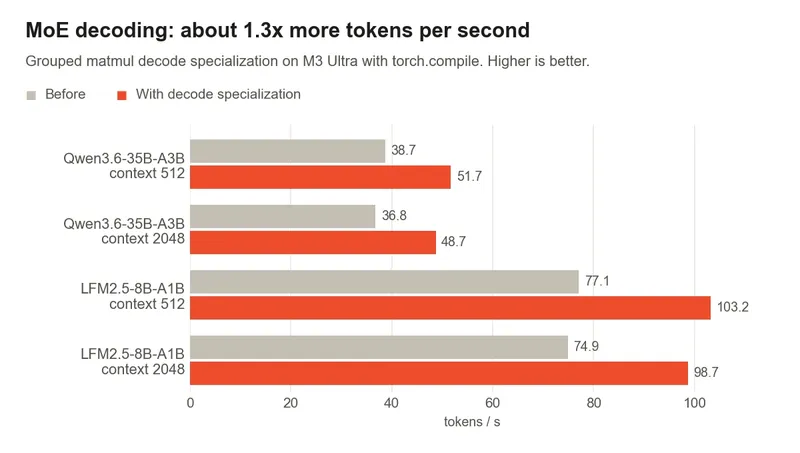
يظهر نواة التشفير مباشرة في معدل الإنتاجية للتلميحات. على جهاز M3 Ultra مع torch.compile، تولد نماذج MoE حوالي 1.3× أكثر تلميحات في الثانية:

يتحسن الجبر الخطي
حسابات ذات القيم المركبة
أصبح التعامل مع التوترات المعقدة أسهل. complex64 تحليل LU، حل مشكلات LU، وحل مشكلات مثلثية تُنفَّذ الآن على MPS، مما يفتح أيضًا أمام العمليات والتراكبيات المبنية عليها، مثل المحددات المعقدة. إليكم نظام صغير تم حله مباشرة على GPU:
import torch

a = torch.randn(8, 8, device="mps", dtype=torch.complex64)
a = a + 8 * torch.eye(8, device="mps", dtype=torch.complex64)
b = torch.randn(8, 2, device="mps", dtype=torch.complex64)

lu, pivots = torch.linalg.lu_factor(a)
x = torch.linalg.lu_solve(lu, pivots, b)
print((a @ x - b).abs().max().item())
المصفوفات الصغيرة والحلول الأكبر
تحصل المصفوفات الصغيرة أيضًا على نواقل سريعة. بالنسبة لهندسة الكاميرا وتحويلات الصور، يتم تحويل دفعات من مصفوفات FP32 التي تصل إلى 4 × 4 في نواقل Metal مقلوبة دفعة واحدة تجمع بين التحليل والتحليل السريع. وتحظى المشاكل الأكبر أيضًا بالاهتمام: يتم حجب التحديثات في QR، وحلول المصفوفات الثلاثية تحول جزءًا كبيرًا من عملهم إلى ضرب مصفوفات بشكل فعال.
تحصل أعمال العملاء في Gated DeltaNet على طريق سريع مخصص لدفعات من أنظمة مثلثية FP32 بأحجام 16 × 16، 32 × 32 و64 × 64، مع وجود على الأقل ثمانية جوانب يمينية.
SVD أكثر متانة عند القيم القصوى العددية. الآن يقوم بشكل صحيح بالتعامل مع القيم الفردية الصغيرة جدًا، القيمات الكبيرة جدًا أو الصغيرة جدًا للمدخلات، وإكمال القاعدة مع full_matrices=True، مما يجعل نتائج التحويل العكسي الزائف وأداء أدنى مساحة أكثر موثوقية.
المعالجات التكرارية، التسطيح، والتدريب
أنماط الصوت، ومفسرات الفيديو، ودوارات التدريب تحتوي على عمليات باهظة الثمن. يوفر هذا الإصدار مسارات جديدة لعدة منها من خلال Metal:
| عملية | ما الذي يتغير في 2.15 |
|---|---|
conv1d forward |
تحل العمليات الأساسية المتخصصة محل MPSGraph، بالإضافة إلى مسار im2col-plus-matmul للنتائج القصيرة. مفيد لأشكال الصوت والنماذج المتدفقة. |
| الدعامة الثابتة | تحرك نحو نواة Metal، وتصحيح الزيادة المفرطة في محركات الذاكرة خلال تفسير الفيديو VAE المُنقسم (سيتم شرح التفاصيل أدناه). |
| تعبئة التفكير وإعادة النسخ | تطبيقات المعدن الجديدة التي تعمل بشكل أسرع وتصحح الصحة التراجعية. |
| إزالة الضوضاء خارج المكان الطبيعي | nn.Dropout وF.dropout الآن تستخدم النواة المدمجة الموجودة بالفعل. |
| التقريب للخلف | يحل محل مسار تكبير الانحدار في MPSGraph نواة جمع المعدن. |
القنوات الأخيرة لعملية conv2d إلى الخلف |
تظل على مسار قنوات الكفاءة الأولي بدلاً من الرسم البياني NCHW مع الوصول المكلف بالتحريك. |
السوفتماكس والاستخلاصات
تتسارع عملية أخذ العينات للعملات في الإصدار 2.15 أيضًا. softmax و log_softmax الآن يعمل على نواة Metal المخصصة، والمفردات الكبيرة تستفيد أكثر: دالة softmax FP32 على [1, 128256] سلسلة من اللوجيتات تنزل 57 ميكروثانية إلى 7 ميكروثانية، حول أسرع بـ 8 أضعاف أكثر من نسخة MPSGraph. تظل السرعة المضافة موجودة عند أحجام المفردات الشائعة الأخرى:

> استهلاك للذاكرة أقل بكثير لتحليل الفيديو
أحد النتائج الأكثر لفتًا في هذا الإصدار يأتي من تغيير التداخل المستمر. يقوم فك التشفير VAE في Wan-AI/Wan2.2-TI2V-5B-Diffusers بـ8,764 مرة للتداخل خلال فك التشفير الكامل الذي يتكون من 28 بلاطة. مع التداخل على نظام Metal، ينخفض الذاكرة القصوى لمحرك النقل من حوالي 270 جيجابايت إلى 8 جيجابايت:

| مقياس الذاكرة | MPSGraph padding | تغليف المعدن |
|---|---|---|
| ذروة تخصيص المصفوفات الحالية | 4.422 جيبي تريليونات البت | 4.095 جيجابايت |
| مصدر محجوز للقمة | 8.070 جي بي إي | 8.070 جي بي إي |
| المتوسط الإجمالي لقمع السائق-الذاكرة | 270.135 جيبي تيرا | 8.108 جيجابايت |
مزيد من السيطرة مع تدفقات MPS
يمكنك الآن اختيار تدفق MPS الذي يقوم بتنفيذ عملك، مباشرة من بايثون. torch.mps.Stream و torch.mps.stream context manager يوفران واجهة، بينما Tensor.record_stream يسمح لجهاز التخصيص بتتبع استخدام العنصر على تدفق آخر.
هذا مثال صغير يرسل العمل إلى تدفق منفصل ويتزامن قبل قراءة النتائج:
import torch

x = torch.randn(1024, device="mps")
torch.mps.synchronize()
worker = torch.mps.Stream()

with torch.mps.stream(worker):
    y = x.square()
    x.record_stream(worker)

del x
worker.synchronize()
print(y.cpu().shape)
العديد من العمليات تعمل على MPS
تم تنفيذ عدة عمليات أخرى على MPS الآن: torch.frexp، torch.logspace، torch.take و Tensor.put_، torch.heaviside، torch.special.laguerre_polynomial_l، و مقارنات الأعداد الصحيحة غير الموجبة. لا يدعم logspace بعد الإخراجات الصحيحة أو منطقية التي تحتوي على أكثر من عنصر.
تحتوي الانتباه أيضًا على تصحيح للدقة: تنفيذ حساب النقاط المشتق في الرياضيات MPS لانتباه الانتباه الآن تتعامل بشكل صحيح مع البث الجماعي والبث للرأس.
> نظرة سريعة على PyTorch 2.16
العمل على الإصدار 2.16 قد بدأ بالفعل بشكل جيد. بعض التغييرات المذكورة أدناه قد تم تطبيقها على main وهي متاحة في الوقت الحالي؛ بينما البعض الآخر لا يزال قيد المراجعة، لذا قد تتغير التفاصيل قبل الإصدار.
تشفير LLM أسرع
عندما لا تحتوي مسار فك التشفير للنموذج على أي عمليات MPSGraph، يبدأ الرسيفر GPU العمل فقط بعد أن ينتهي المعالج الدقيق من تشفير جميع الخطوات. PyTorch 2.16 يقوم بإنشاء مخزن الأوامر كل 16 كريستاللذلك، يعمل الجهاز العرضي (GPU) بينما لا يزال المعالج المركز (CPU) يقوم بتشفير الباقي. بالنسبة لتفكيك BF16 المُترجم في سياق يتكون من 2048 كلمة:
| الموديل | قبل | بعد | تغيير |
|---|---|---|---|
| LFM2.5-8B-A1B | 108.8 توكينات/ثانية | 126.0 توكينات/ثانية | +16% |
| Qwen3.6-35B-A3B | 52.9 توكينات/ثانية | 62.8 توكينات/ثانية | +19% |
| كوين3.8-27بي | 12.1 توكينات/ثانية | 12.6 توكينات/ثانية | +4% |
تدور انتباه العملية بالكامل على بروتوكول Metal
التفكير بالتوازي المنظم للنقاط هو إلغاء استخدام MPSGraph تمامًا: كل شكل من الأشكال سيعمل على النواقل Metal، مع نواقل متخصصة للنواقل المتجهية لعملية التفكير وفرادات الأداء Metal لتعبئة النصوص بنصف دقة في إصدارات macOS الجديدة. الأشكال التي كانت تلجأ إلى MPSGraph تستفيد أكثر من ذلك. على جهاز M5 Pro، يقل الوقت اللازم لعملية التفكير بالاستعلام المجمع (32 رأس استعلام، 8 رؤوس KV، بُعد الرأس 80، 4K سياق) من 465 ميكروثانية إلى 65 ميكروثانية، ويتحسن عملية التعبئة 4K × 4K مع بُعد الرأس 40 من 42 مللي ثانية إلى 6 مللي ثانية.
مزيد من عمليات تحويل MPSGraph إلى Metal
يستمر التخلي عن MPSGraph. تمت معالجة تنشينات القياس الدفعية والعكسية، بينما تمت معالجة خسارة MSE (أسرع بـ 12 مرة على المدخلات الصغيرة)، std_mean وvar_mean (أسرع بـ 4 مرة)، وbincount تم تطبيقه بالفعل. bincount هو الأكثر إثارة للإعجاب: عندما تنتمي معظم القيم إلى حجرة واحدة، كان عداد الأعداد الصحيحة 4 مليونًا يستغرق 6.8 ثانية، والآن يستغرق نصف مللي ثانية.
> تثبيت أصغر حجمًا
سيتم بناء الشادرات المجمعة بشكل افتراضي لـ Metal 3.1، بينما يتم تجميع الإصدارين من Metal 4 فقط للخوارزميات التي تحتاجها. وهذا يقلل حجم libtorch_cpu.dylib بحوالي 25%، من 384 ميجابايت إلى 287 ميجابايت، ويضع الأساس لشادرات Metal 4.1 التي تتميز بمضاعفات مصفوفات أسرع وطريقة FP8 الأصلية.
اختتام
تجلب PyTorch 2.15 استخدام FP8 على الآيباد، تفسير أسرع للنماذج LLM للنماذج الكثيفة والنماذج التي تعتمد على MoE، جبر خطي أكثر على GPU، بالإضافة إلى قائمة طويلة من العمليات التي تم نقلها من MPSGraph إلى مكينات Metal المخصصة. جرب النسخة الاختبارية من الإصدار!
ما هو التالي بالنسبة لنا
- مزيد من MPS: 2.16 سيُركّز بالكامل على Metal، وسنواصل نقل العمليات من MPSGraph.
torch.compile: نحاول التخلص من انقطاعات الرسم البياني، بحيث يمكن تجميع المزيد من النماذج بالكامل.- أفكارك: ما الذي يجب أن نعمل عليه أيضًا في PyTorch؟ إذا كان شيء بطيء أو مفقود أو معطل، سواء على MPS أو في أي مكان آخر، أغلق قضية على GitHub من خلال فتح قضية على GitHub وأخبرنا.
شكر كبير لـ نيكيتا شولغا، كورت موهلر، وآرون جوكاسلان على مراجعتهم جزء كبير من هذا العمل، ولجميع الأشخاص الذين ساهموا في إصدار MPS هذه المرة.