
Angenommen, Sie bauen einen Agenten, der Fragen zu einer von einem Kunden hochgeladenen CSV beantwortet. Das Modell muss Python ausführen, um die Antwort zu erhalten. Wo läuft dieser Code?
Eine Option ist, ihn selbst auszuführen. Das bedeutet eine Sandbox-Plattform wie E2B oder Modal, oder Ihren eigenen Container unter Docker, plus die Arbeit, ihn von Ihrer Datenbank und dem Internet fernzuhalten, seine Laufzeit zu begrenzen und das Image zu patchen.
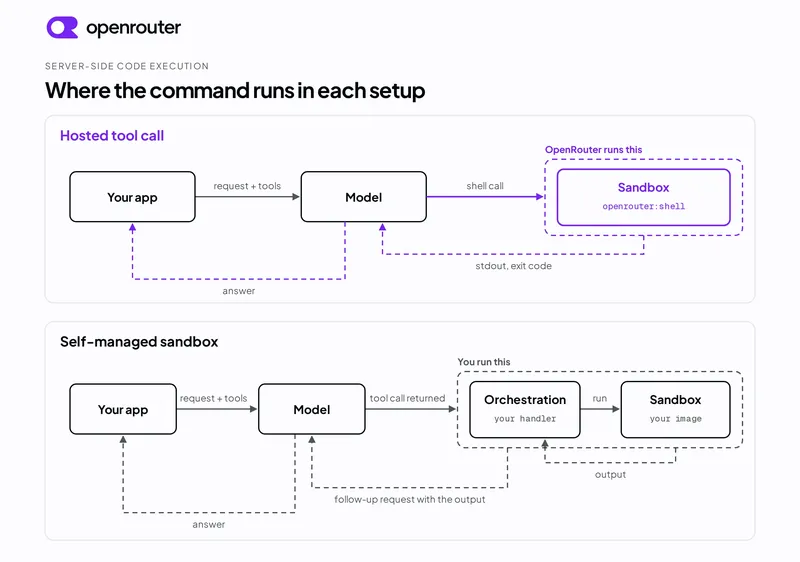
Ein serverseitiges Code-Ausführungstool ist die andere Option. Sie fügen das Tool Ihrer API-Anfrage hinzu, das Modell entscheidet, wann es etwas ausführen muss, und der Anbieter führt die Befehle in seiner eigenen Sandbox aus und gibt die Ausgabe innerhalb derselben Anfrage an das Modell zurück. Eine Sandbox bedeutet hier einen isolierten Linux-Container mit eigenem Dateisystem, einem Zeitlimit und standardmäßig ohne Netzwerkzugriff.
Dieser Artikel behandelt vier Anbieter, die heute serverseitige Code-Ausführung anbieten, was jede Sandbox kann und was nicht, was sie an Latenz und Geld kostet, und die Aufgaben, die weiterhin eine Sandbox erfordern, die Sie selbst betreiben.
Kurz zusammengefasst
- Ein serverseitiges Code-Ausführungstool führt die Befehle des Modells während Ihrer API-Anfrage in der Sandbox des Anbieters aus. Sie müssen keinen Container bereitstellen, patchen oder absichern.
- OpenAI, Anthropic und Google führen jeweils Code für ihre eigenen Modelle aus. Unser Tool openrouter:shell führt Befehle für jedes Modell auf den Responses- und Messages-APIs aus, und unser Tool openrouter:bash tut dasselbe nur auf der Messages-API. Beide Tools befinden sich in der Beta.
- Unsere Sandbox ist ein isolierter Container, der auf Ihr Konto und Ihren Workspace beschränkt ist, mit standardmäßig deaktiviertem ausgehendem Netzwerkzugriff und limits pro Befehl für Laufzeit und Ausgabegröße. Sandbox-Zeit wird mit $0.0001 pro Sekunde abgerechnet, mit einem Minimum von 30 Sekunden für einen neuen oder schlafenden Container.
- Eine Sandbox-Plattform, die Sie selbst betreiben, ist weiterhin die richtige Wahl für ein benutzerdefiniertes Basis-Image, GPU-Arbeit oder eine Sitzung, die stundenlang läuft.
Was serverseitige Code-Ausführung bedeutet
Ein Modell führt niemals selbst etwas aus. Wenn es ein Tool aufruft, gibt es eine Anfrage aus, die das Tool und die Argumente benennt, und etwas muss das ausführen. Bei einem clientseitigen Tool ist dieses Etwas Ihr Anwendungscode oder das Agent-Framework, auf dem Sie aufbauen. Ihre Anwendung empfängt den Aufruf, führt ihn aus und sendet das Ergebnis in einer Folgeanfrage zurück. Bei einem serverseitigen Tool führt der Anbieter den Aufruf auf seiner eigenen Infrastruktur aus und gibt das Ergebnis innerhalb derselben Anfrage an das Modell zurück, sodass Ihre Anwendung dafür keinen Handler hat. Serverseitige Code-Ausführung ist die zweite Art.
Möglicherweise verwenden Sie bereits Tools, die auf diese Weise funktionieren. Web search ermöglicht einem Modell, etwas im Live-Web nachzuschlagen, und web fetch ermöglicht ihm, den Inhalt einer URL zu lesen. In beiden Fällen fügen Sie einen Eintrag zur Anfrage hinzu und der Anbieter erledigt den Rest. Code-Ausführung wendet dasselbe Muster auf das Ausführen von Befehlen an.
Wie aus einem Tool-Aufruf ein ausgeführter Befehl wird
Diese Schritte gelten für jedes serverseitige Code-Ausführungstool. Wo ein Feldname erscheint, ist es der, den unser Shell-Tool verwendet.
- Sie fügen das Tool in das
tools-Array der Anfrage ein. - Das Modell entscheidet, dass es etwas ausführen muss, und gibt einen Aufruf mit einem oder mehreren Shell-Befehlen aus.
- Der Anbieter führt diese Befehle der Reihe nach in einem sandboxed Container aus.
- Die Standardausgabe, Standardfehlerausgabe und das Ergebnis jedes Befehls gehen zurück an das Modell. Das Ergebnis ist entweder ein Exit-Code oder ein Timeout.
- Das Modell liest die Ergebnisse und antwortet Ihnen entweder oder führt weitere Befehle in derselben Anfrage aus.
Die Schritte zwei bis fünf wiederholen sich, bis das Modell antwortet. Das Modell führt etwas aus, liest die Ausgabe, entscheidet, ob es einen weiteren Befehl benötigt, und macht erneut weiter. In dieser Schleife beweist ein Code-Ausführungs-Tool seinen Wert, denn das Modell kann seine Arbeit anhand echter Ausgaben überprüfen, statt zu raten.
Wir begrenzen diese Schleife. Das max_tool_calls Feld legt fest, wie viele Server-Tool-Schritte eine Anfrage maximal umfassen darf. Unsere Server-Tools-Referenz setzt sowohl den Standardwert als auch das Maximum auf 30.
Wie sich eine gehostete Sandbox von einer selbst betriebenen unterscheidet
Eine eigene Sandbox zu betreiben bedeutet, die Teile selbst zu verantworten, die sonst der Anbieter übernehmen würde. Sie wählen ein Basis-Image aus, stellen die Rechenressourcen bereit, binden ein SDK ein, um Ausführungen zu starten und Ausgaben zu lesen, und verwalten den Lebenszyklus jeder Ausführung. Außerdem sind Sie für die Sicherheitsgrenze verantwortlich.
Ein gehostetes Tool tauscht diese Kontrolle gegen einen einzelnen Eintrag in einem JSON-Array. Sie dimensionieren den Container nicht, patchen ihn nicht und betreiben ihn nicht. Wir haben openrouter:shell für den Fall gebaut, bei dem die Arbeit aus einer Handvoll kurzer Befehle pro Anfrage besteht.
Wer heute gehostete Code-Ausführung anbietet
Dieser Artikel behandelt OpenAI, Anthropic, Google und OpenRouter. Agent-SDKs und dedizierte Sandbox-Plattformen sind separate Kategorien und folgen später im Artikel. Was die vier Anbieter unterscheidet, ist, für welche Modelle jeder einzelner Code ausführt.
OpenAI betreibt eine gehostete Shell für OpenAI-Modelle
OpenAIs Shell-Tool führt Befehle in einem von OpenAI verwalteten Container über die Responses API aus. OpenAI dokumentiert die gehostete Laufzeitumgebung als Debian 12 mit einem Standard-Arbeitsverzeichnis von /mnt/data. Befehle werden ohne sudoausgeführt, und interaktive TTY-Sitzungen werden nicht unterstützt. Zu den in der Dokumentation aufgeführten vorinstallierten Sprachen gehören Python 3.11, Node.js 22.16, Java 17, PHP 8.2, Ruby 3.1 und Go 1.23.
Gehostete Container haben standardmäßig keinen ausgehenden Netzwerkzugriff. Um ihn zu aktivieren, konfiguriert ein Organisationsadministrator eine Allowlist im OpenAI-Dashboard, und Sie setzen network_policy in der Container-Umgebung der Anfrage. Ein Container kann über Anfragen hinweg wiederverwendet werden, indem seine ID in einer container_reference -Umgebung übergeben wird; sein Ablaufdatum wird bei der Erstellung des Containers festgelegt. OpenAI bietet außerdem ein separates Code-Interpreter-Tool für Python an.
Anthropic führt Python und Bash für Claude-Modelle aus
Anthropics Code-Ausführungstool führt Python und Bash in einer von Anthropic verwalteten Sandbox über die Messages API aus. Die dokumentierte Umgebung ist ein Linux-x86_64-Container mit Python 3.11, 5 GiB RAM, 5 GiB Workspace-Speicher und einer CPU. Der Internetzugang ist deaktiviert und es sind keine ausgehenden Verbindungen erlaubt, sodass Claude mit den vorinstallierten Bibliotheken arbeitet und während eines Laufs kein Paket installieren kann.
Es gibt drei Tool-Versionen , und jedes unterstützte Modell akzeptiert alle drei. code_execution_20250825 unterstützt Bash-Befehle und Dateioperationen. code_execution_20260120 fügt einen Python-Interpreter-Zustand hinzu, der zwischen Anfragen bestehen bleibt; dies hängt von Anthropics programmatischem Tool-Calling ab und ist auf Claude Haiku 4.5 nicht verfügbar. Container laufen 30 Tage nach ihrer Erstellung ab. Nach etwa 5 Minuten Inaktivität wird ein Container mit einem Checkpoint gesichert, und eine Anfrage mit seiner ID innerhalb des 30-Tage-Fensters stellt ihn wieder her.
Google führt Python für Gemini-Modelle aus
Googles Code-Ausführungstool führt Python in einer von Google verwalteten Sandbox aus und wird mit einem code_execution -Eintrag in den Tools der Anfrage aktiviert. Die Dokumentation besagt, dass das Modell nur Python generieren und ausführen kann, dass die Code-Umgebung eine maximale Laufzeit von 30 Sekunden hat und dass Sie keine eigenen Bibliotheken installieren können. Google veröffentlicht die Liste der Bibliotheken, die die Umgebung enthält.
Wir betreiben eine gehostete Shell für jedes Modell
Die drei oben genannten Tools funktionieren jeweils nur mit den Modellen eines Unternehmens. Unseres funktioniert mit jedem Modell der Responses- und Messages-APIs, weil wir die Sandbox auf der Routing-Ebene betreiben und nicht innerhalb eines einzelnen Modell-Anbieters.
Wir liefern zwei Code-Ausführungstools. openrouter:shell spiegelt die Form von OpenAIs gehostetem Shell-Tool wider und funktioniert sowohl mit der Responses API und die Messages API. openrouter:bash spiegelt die Form von Anthropics bash-Tool wider und funktioniert nur mit der Messages API.
Beide Tools befinden sich in der Beta, daher kann sich die API ändern. Sandboxed execution läuft nur auf dem globalen openrouter.ai Endpunkt. Die regionsspezifischen Endpunkte bieten das Shell-Tool nicht an, und Chat Completions weist beide Tools mit einem 400 zurück, in dem die APIs genannt werden, die sie unterstützen.
Setzen Sie engine auf openrouter bei einem der Tools, dann werden die Befehle in unserer Sandbox ausgeführt. Der Standardwert engine ist auto. Bei openrouter:shell, auto behält den nativ gehosteten Shell-Dienst eines Anbieters bei, sofern vorhanden, und leitet andernfalls an unsere Sandbox weiter. Bei openrouter:bash, auto gibt den Tool-Aufruf zur clientseitigen Ausführung an Ihre Anwendung zurück, und auf unseren Servern wird nichts ausgeführt.
Einen Befehl in unserer Sandbox ausführen
Hier ist eine vollständige Anfrage, die zwei Befehle ausführt und die Ergebnisse zurückliest.
import os
import requests

response = requests.post(
    "https://openrouter.ai/api/v1/responses",
    headers={"Authorization": f"Bearer {os.environ['OPENROUTER_API_KEY']}"},
    json={
        "model": "anthropic/claude-sonnet-4.5",
        "input": "Run `cat /etc/os-release` and `python3 --version`, then tell me the OS and Python version in one sentence.",
        "tools": [
            {"type": "openrouter:shell", "parameters": {"engine": "openrouter"}}
        ],
    },
)

for item in response.json()["output"]:
    if item["type"] == "openrouter:shell":
        print(item["container_id"], item["action"]["commands"])
        for result in item["output"]:
            print(result["stdout"], result["outcome"])
Wir haben diese Anfrage am 22. September 2026 ausgeführt. Das Modell hat beide Befehle in einem einzigen Shell-Aufruf gesendet, und jeder Befehl kam mit seinem eigenen Ergebnis zurück. Die vollständige os-release Ausgabe erstreckt sich über mehrere Zeilen und ist hier auf die ersten zwei gekürzt.
{
  "type": "openrouter:shell",
  "container_id": "sess_art10-418b8597e044",
  "action": { "commands": ["cat /etc/os-release", "python3 --version"] },
  "output": [
    {
      "stdout": "PRETTY_NAME=\"Ubuntu 22.04.5 LTS\"\nNAME=\"Ubuntu\"\n",
      "stderr": "",
      "outcome": { "type": "exit", "exit_code": 0 }
    },
    {
      "stdout": "Python 3.11.14",
      "stderr": "",
      "outcome": { "type": "exit", "exit_code": 0 }
    }
  ]
}
Die Sandbox meldete am diesem Datum Ubuntu 22.04.5 LTS mit Python 3.11.14. Das Runtime-Image kann sich ändern, lesen Sie die Version daher aus dem Container aus, statt sie fest zu hinterlegen. Die Server-Tools-Referenz beschreibt die übrigen Parameter.
Agent-SDKs, die eine Sandbox für Sie kapseln
Wenn Sie auf einem Agent-SDK aufbauen, statt eine API direkt aufzurufen, kapseln einige SDKs eines dieser Tools.
Das OpenAI Agents SDK wird ausgeliefert CodeInterpreterTool, das Code in OpenAIs Sandbox ausführt, und ShellTool, das je nach Konfiguration seiner Umgebung entweder in Ihrer lokalen Laufzeit oder in einem von OpenAI gehosteten Container läuft. Prüfen Sie, welchen Modus Sie konfiguriert haben, bevor Sie annehmen, dass ein Befehl remote ausgeführt wurde. Auf unserer Seite ist openrouter:shell ein Eintrag im tools -Array wie jeder andere, sodass er in eine OpenRouter Agent SDK -Schleife eingeht, genauso wie er in eine rohe Anfrage eingeht.
Was weiterhin eine eigene Sandbox benötigt
Ein gehostetes Tool eignet sich für kurze, begrenzte Arbeiten wie das Ausführen eines Skripts, das Transformieren einer Datei oder das Prüfen eines Ergebnisses. Alles, was ein bestimmtes Basis-Image oder eine GPU benötigt, fällt außerhalb aller vier gehosteten Tools und benötigt eine Sandbox-Plattform, die Sie selbst betreiben.
Vergleich
Jede Zelle zu gehosteten Tools stammt aus der eigenen Dokumentation des Anbieters, die oben verlinkt ist, mit Ausnahme der Zelle zur OpenRouter-Laufzeit, die das angibt, was die Sandbox meldete, als wir die obige Anfrage ausführten. Die Spalte zur Selbstverwaltung beschreibt eine Sandbox, die Sie selbst betreiben, und nicht eine bestimmte Plattform.
| OpenRouter | OpenAI | Anthropic | Selbstverwaltet | ||
|---|---|---|---|---|---|
| Wer betreibt es | Wir | OpenAI | Anthropic | Sie | |
| Modelle | Jedes Modell der Responses- und Messages-APIs | OpenAI-Modelle | Claude-Modelle | Gemini-Modelle | Jedes Modell |
| APIs | Responses und Messages. openrouter:bash nur mit Messages | Responses | Nachrichten | Gemini API | Beliebig |
| Sprachen | Beliebiger Shell-Befehl. Ubuntu 22.04.5 mit Python 3.11.14, gemeldet am 22. September 2026 | Shell-Befehle auf Debian 12. Python, Node.js, Java, PHP, Ruby und Go vorinstalliert | Python und Bash | Nur Python | Was auch immer Sie bauen |
| Dateisystem | Eigenes Container-Dateisystem, auf Ihr Konto und Ihren Workspace beschränkt. Dateien im Home-Verzeichnis werden nach jedem Befehl gespeichert | Eigenes Container-Dateisystem mit einem Standard-Arbeitsverzeichnis von /mnt/data. Daten werden gelöscht, wenn der Container abläuft | Isolierter Container mit 5 GiB Workspace-Speicher. Container laufen 30 Tage nach Erstellung ab | Nicht dokumentiert | Was auch immer Ihr Image und Ihre Mounts definieren |
| Ausgehendes Netzwerk | Standardmäßig aus. Allowlist von bis zu 50 Hostnamen auf den Ports 80 und 443 | Standardmäßig aus. Organisations-Allowlist plus eine pro Anfrage network_policy | Deaktiviert | Nicht dokumentiert | In Ihrer Verantwortung zu konfigurieren |
| Pakete zur Laufzeit installieren | Ja, mit den Paket-Hosts in der Allowlist | Ja, mit den Paket-Hosts in der Allowlist | Nein | Nein | Ja |
| Sitzungspersistenz | Container, gekennzeichnet durch die Container-ID. Ruht nach 5 Minuten Inaktivität. Gespeicherte Dateien bleiben 30 Tage nach letzter Nutzung erhalten | Container wird über die ID wiederverwendet durch container_reference. Ablauf am Container festgelegt | Container wird innerhalb von 30 Tagen nach Erstellung über die ID wiederhergestellt. Interpreter-Zustand bleibt erhalten auf code_execution_20260120 und später mit programmatischem Tool-Aufruf | Maximal 30 Sekunden Laufzeit pro Ausführung. Zustandspersistenz zwischen Anfragen nicht dokumentiert | Bis zum Limit der jeweiligen Plattform |
| Kostenmodell | Inferenz-Tokens plus Sandbox-Zeit zu $0.0001 pro Sekunde, mit einem Minimum von 30 Sekunden für einen neuen oder schlafenden Container | In der Dokumentation des Shell-Tools nicht angegeben | 1,550 kostenlose Stunden pro Organisation und Monat, danach 0.05 $ pro Stunde und Container, mit einer Mindestdauer von 5 Minuten pro Ausführung | Keine zusätzlichen Kosten. Generierter Code und Ausgaben werden als Tokens abgerechnet | Rechenzeit, während die Sandbox läuft |
Was unsere Sandbox durchsetzt
Der Sinn einer Sandbox ist, dass Sie dem Modell nicht vertrauen müssen. Ein Befehl, den Sie nie beabsichtigt haben, kann weder das Netzwerk noch den Container einer anderen Person erreichen, und er stoppt an einer harten Grenze für Laufzeit und Ausgabemenge. Alles in diesem Abschnitt beschreibt unsere Sandbox. Die Tabelle oben zeigt, wo sich die anderen drei unterscheiden.
Die Grenzen, die für jeden Befehl gelten
Wir führen jeden Befehl in einem isolierten Container aus, getrennt von der Infrastruktur, die Ihre Anfrage bedient, und von Ihrem Rechner, und abgestimmt auf Ihr Konto und Ihren Workspace. Sie setzen Ihre eigenen Obergrenzen mit timeout_ms für die maximale Laufzeit eines Befehls und max_output_length für die maximale Ausgabemenge. timeout_ms hat einen Standardwert von 120,000 ms und darf 300,000 ms nicht überschreiten. max_output_length hat einen Standardwert von 16,384 Zeichen pro Stream und darf 65,536 nicht überschreiten. Ein Shell-Aufruf mit mehr als 100 Befehlen wird abgelehnt.
Ausgehender Netzwerkzugriff ist deaktiviert, sofern Sie ihn nicht einschalten. Wir haben dies am September 22, 2026 überprüft, indem wir eine Anfrage ohne network_policy sendeten und das Modell baten, https://example.com abzurufen, mit curl, wobei nur der HTTP-Statuscode ausgegeben und nach 5 Sekunden abgebrochen wurde. Der Befehl gab 000aus, was curl ausgibt, wenn keine Antwort eintrifft, und beendete sich mit Code 28, einem curl timeout.
{ "stdout": "000", "stderr": "curl: (28) Failed to connect to example.com port 443 after 5206 ms: Connection timed out", "outcome": { "type": "exit", "exit_code": 28 } }Um das Netzwerk zu öffnen, legen Sie eine network_policy allowlist mit bis zu 50 Hostnamen oder Glob-Mustern fest. Nur die Ports 80 und 443 sind erreichbar, und die Richtlinie wird beim Start des Containers festgelegt. pip install benötigt sowohl pypi.org als auch files.pythonhosted.org in der Allowlist.
Prompt Injection und was die Sandbox begrenzt
Wenn man einem Modell eine Shell gibt, setzt man sich Prompt Injectionaus. Wenn Ihr Agent eine Webseite, ein Support-Ticket oder eine von jemandem hochgeladene Datei liest, kann ein Angreifer Anweisungen in diesem Text verstecken, die das Modell anweisen, Ihren Prompt zu ignorieren und etwas anderes auszuführen.
Die oben genannten Grenzen gelten unabhängig davon, ob das Modell Ihrem Prompt oder dem eines Angreifers folgt. Ein Befehl, der unter einer eingeschleusten Anweisung ausgeführt wird, kann keinen Host außerhalb der von Ihnen konfigurierten network_policy erreichen und hat keinen Netzwerkzugriff, wenn Sie die Richtlinie deaktiviert lassen. Er kann den Container eines anderen Mandanten nicht erreichen und stoppt am selben Timeout. Eine Allowlist erweitert, was ein eingeschleuster Befehl erreichen kann, und allowed_domains: ["*"] erlaubt uneingeschränkten ausgehenden Datenverkehr, daher sollte die Allowlist auf die Hosts beschränkt bleiben, die der Job benötigt.
Sie können auch einen Versuch erkennen, der in der Anfrage selbst ankommt. Erkennung von Prompt Injection in einer workspace guardrail prüft den benutzerdefinierten Nachrichteninhalt jeder eingehenden Anfrage anhand von Regex-Mustern für gängige Injektionstechniken, bevor wir die Anfrage an das Modell weiterleiten. Es überprüft nicht, was ein Server-Tool danach abruft, daher benötigt eine Seite, Datei oder Befehlsausgabe, die das Modell über ein Tool liest, eine eigene Kontrolle Ihrerseits, wie etwa die Überprüfung der Sandbox-Ausgabe, die Ihre Anwendung erhält. Bei einer Übereinstimmung geschieht eines von drei Dingen, abhängig von der von Ihnen konfigurierten Aktion.
- Flag zeichnet die Erkennung auf und leitet die Anfrage unverändert weiter.
- Redact ersetzt den übereinstimmenden Textabschnitt durch
[PROMPT_INJECTION]und leitet die bereinigte Anfrage weiter. - Block lehnt die Anfrage mit einem 403 ab, bevor sie das Modell erreicht.
Wenn mehr als eine Schutzmaßnahme greift, setzt sich die strengste Maßnahme durch, in der Reihenfolge Block, Schwärzung (Redact), Markierung (Flag). Die Erkennung ist nicht erschöpfend und kann Fehlalarme erzeugen, daher sollten Sie die Trefferquote anhand Ihres eigenen Datenverkehrs im Flag-Modus messen, bevor Sie Redact oder Block erzwingen. Einen Fehlalarm können Sie auf der Seite Logs melden.
Was Ihnen eine gehostete Sandbox an Sekunden und Dollar kostet
Eine gehostete Sandbox fügt einer Anfrage Sekunden hinzu und hinterlässt keine Infrastruktur, die Sie betreiben müssten. Sie gibt Ihnen außerdem einen Container, zu dem Sie zurückkehren können.
Dateien bleiben zwischen Anfragen erhalten
Befehle, die in /workspace/home, und wir speichern die geänderten Dateien nach jedem Befehl in diesem Verzeichnis. Senden Sie eine stabile session_id, oder legen Sie eine Container-ID im „]-Feld des Werkzeugs fest Umwelt Konfiguration, und jede Anfrage mit dieser ID erreicht denselben Container und dieselben Dateien. Ein session_id darf nur Buchstaben, Ziffern, _, und -. Eine ID mit anderen Zeichen wird ignoriert, und wir wählen den Container so aus, als hätten Sie keine gesendet session_id, was bedeutet, dass die zuletzt verwendete container_id in der wiedergegebenen Konversation verwendet wird, falls vorhanden, andernfalls ein neuer Container für diese Anfrage. Wenn eine session_id länger als 20 Zeichen ist, verwenden wir nur die letzten 20, sodass zwei lange ids, die auf dieselbe Weise enden, sich einen Container teilen. Eine container_reference id kann 1 bis 40 Zeichen aus demselben Zeichensatz umfassen und wird nicht gekürzt, verwenden Sie sie daher, wenn die id exakt sein muss. Wir haben dies am 22. September 2026 bestätigt, indem wir eine Datei in einer Anfrage schrieben und sie in einer zweiten Anfrage, die dieselbe session_id.
Ein Container schläft nach 5 Minuten Leerlauf ein, und die Leerlaufzeit ist nicht konfigurierbar. Der Schlafmodus löscht die Dateien nicht. Wenn später eine Anfrage mit derselben id eingeht, startet eine neue Sandbox und lädt zuerst die gespeicherten Dateien. Offene Prozesse, Umgebungsvariablen und installierter Systemzustand werden nicht wiederhergestellt, behandeln Sie einen aufgeweckten Container also wie eine frische Maschine, auf der Ihre Dateien liegen. Gespeicherte Dateien werden 30 Tage nach der letzten Nutzung des Containers aufbewahrt. Um ein Artefakt herauszuziehen, GET /api/v1/containers/{container_id}/files listet auf, was ein Container erzeugt hat, und der promote-Endpunkt kopiert eine Datei in Ihre Workspace-Dokumente, wo sie nicht abläuft.
Was Sie im Nachhinein überprüfen können
Jedes Shell-Tool-Ergebnis in der Antwort enthält die vom Modell ausgeführten Befehle sowie stdout, stderr und Ausgang jedes Befehls, sodass Ihre Anwendung sie auf dieselbe Weise protokollieren kann wie den Rest der Antwort. Input & Output Logging speichert Ihre Prompts und Completions auf OpenRouter zur Überprüfung auf der Logs-Seite, und Guardrail-Erkennungen erscheinen dort ebenfalls. Für Produktionsmonitoring, Broadcast streamt Traces zu einer externen Observability-Plattform, während Anfragen abgeschlossen werden.
Wenn Sie in-regionrouten, ist das Shell-Tool nicht verfügbar und Input & Output Logging wird übersprungen, selbst wenn es aktiviert ist. Broadcast unterstützt In-Region-Routing, und jedes Ziel ist mit den Datenregionen konfiguriert, aus denen es Traces empfängt.
Was der Round Trip Sie kostet
Eine Anfrage, die einen sandboxierten Befehl ausführt, dauert länger als dieselbe Anfrage ohne einen solchen. In einer Reihe einzelner Anfragen, die wir am 22. September 2026 gesendet haben, kehrte eine Anfrage ohne Shell-Tool in etwa 2 Sekunden zurück, und Anfragen mit einem Shell-Aufruf kehrten in 8 bis 21 Sekunden zurück, je nach Modell. Das sind Einzelstichproben aus einer Sitzung, kein Benchmark. Planen Sie mehrere Sekunden Overhead pro Shell-Aufruf ein.
Sandbox-Zeit wird mit $0.0001 pro Sekunde abgerechnet. Die Uhr startet, wenn eine Anfrage zum ersten Mal einen Sandbox-Befehl ausführt, und stoppt, wenn die Antwort abgeschlossen ist. Eine Anfrage, die einen neuen oder schlafenden Container startet, wird mit mindestens 30 Sekunden abgerechnet, und spätere Anfragen, die denselben warmen Container wiederverwenden, zahlen nur ihre gemessene Zeit. Die obige Anfrage startete einen neuen Container, und ihr Nutzungsobjekt meldete eine server_tool_cost von 0.003, was dem 30-Sekunden-Minimum entspricht. Ein Container, der zwischen Anfragen inaktiv ist, wird nicht abgerechnet.
Modell wechseln, ohne Ihren Tool-Code anzufassen
Tauschen Sie das Modell aus, und Ihre Tool-Definition bleibt dieselbe.
Wir haben einen Anfragekörper am 22. September 2026 sechsmal gesendet und dabei nur das model -Feld geändert, und jedes Modell gebeten, python3 -c "print(sum(range(1, 101)))" in der Sandbox auszuführen. Jedes Modell machte einen Shell-Aufruf und gab 5050 zurück.
| Modell | Ergebnis |
|---|---|
| openai/gpt-5.4-mini | 5050 |
| google/gemini-3.5-flash | 5050 |
| anthropic/claude-haiku-4.5 | 5050 |
| deepseek/deepseek-v3.2 | 5050 |
| moonshotai/kimi-k2.6 | 5050 |
| qwen/qwen3-coder | 5050 |
Alle sechs liefen in derselben Sandbox mit derselben Tool-Definition, was auch immer ihr eigener Anbieter nativ anbietet, denn die Sandbox gehört uns und nicht dem Anbieter des Modells. Testen Sie das Modell, das Sie verwenden möchten, bevor Sie darauf aufbauen, da die Zuverlässigkeit des Tool-Callings zwischen Modellen variiert. Unser Tool-Calling-Leitfaden beschreibt, wie Server-Tools und Ihre eigenen Funktions-Tools sich ein tools Array teilen.
Wenn Sie eine eigene Sandbox-Plattform möchten
Wählen Sie eine dedizierte Sandbox-Plattform, wenn Sie etwas benötigen, das ein gehostetes Tool nicht bietet. Modal dokumentiert Sandboxes, die aus benutzerdefinierten Images erstellt wurden, mit einer konfigurierbaren Lebensdauer von bis zu 24 Stunden und GPU-Ressourcen. Daytona dokumentiert Sandboxes, die aus einem öffentlichen Container-Image erstellt werden, einschließlich GPU-Sandboxes. E2B dokumentiert Sandboxes, die im Pro-Plan bis zu 24 Stunden und im Basisplan 1 Stunde laufen, mit Pause und Fortsetzen für längere Workloads.
Fazit
Für kurze, begrenzte Befehle innerhalb einer Modell-Anfrage verwenden Sie ein gehostetes Tool. Sie fügen einen Eintrag zum tools Array hinzu und erhalten einen isolierten Container mit deaktiviertem ausgehendem Netzwerkzugriff, und Sie zahlen für Inferenz plus die Sekunden, die die Sandbox läuft. Planen Sie mehrere Sekunden Overhead pro Shell-Aufruf ein und verwenden Sie einen Container wieder, wo möglich.
Wechseln Sie zu einer selbst betriebenen Sandbox-Plattform, wenn ein Job ein benutzerdefiniertes Basis-Image, eine GPU, eine Sitzung, die Stunden läuft, oder die Kontrolle über die Sicherheitsgrenze selbst benötigt. Prüfen Sie in beiden Fällen vor einer Entscheidung die aktuelle Dokumentation des Anbieters, da unsere beiden Tools sich in der Beta befinden und sich die Tools der anderen drei Anbieter ebenfalls ändern.
Häufig gestellte Fragen
Gibt es ein gehostetes Sandbox-Shell-Tool, das Modelle direkt während einer Anfrage aufrufen können?
Ja. Unser openrouter:shell Server-Tool gibt einem Modell eine sandboxed Linux-Shell, die während der Anfrage auf unserer Infrastruktur läuft, sowohl auf der Responses API als auch auf der Messages API. Setzen Sie engine auf openrouter und die Befehle laufen in einem isolierten Container, wobei stdout, stderr sowie das Ergebnis der Ausführung oder des Timeouts jedes Befehls an das Modell zurückgegeben werden. OpenAI, Anthropic und Google bieten jeweils ein gehostetes Code-Ausführungs-Tool für ihre eigenen Modelle an.
Kann ich einem Modell eine sandboxed Shell geben, in der es Befehle ausführen kann?
Ja. Fügen Sie {"type": "openrouter:shell", "parameters": {"engine": "openrouter"}} zum tools -Array einer Responses- oder Messages-API-Anfrage hinzu. Das Modell kann dann Shell-Aufrufe ausgeben, wir führen die Befehle in einem isolierten Container aus und geben die Ausgabe jedes Befehls an das Modell zurück. Der Container hat keinen ausgehenden Netzwerkzugriff, sofern Sie keine network_policy -Allowlist konfigurieren.
Welche SDKs oder Plattformen bieten serverseitige Code-Ausführung standardmäßig?
Unser openrouter:shell-Server-Tool führt Befehle für jedes Modell auf den Responses- und Messages-APIs aus, und unser openrouter:bash-Server-Tool tut dasselbe nur auf der Messages-API. OpenAI, Anthropic und Google führen jeweils Code für ihre eigenen Modelle über das Shell-Tool der Responses-API, das Code-Ausführungs-Tool und das Gemini-API-Code-Ausführungs-Tool aus. Das OpenAI Agents SDK kapselt die gehosteten Tools von OpenAI als CodeInterpreterTool und ShellToolein. E2B, Modal und Daytona sind Sandbox-Plattformen, die Sie selbst integrieren und betreiben, und keine Tools, die ein Anbieter innerhalb des API-Aufrufs ausführt.
Welche Sandbox eignet sich am besten für KI-Agenten?
Das hängt davon ab, wie lange die Arbeit läuft und wie viel Kontrolle Sie über die Laufzeitumgebung benötigen. Für kurze Befehle innerhalb einer Anfrage bedeutet ein gehostetes Tool wie openrouter:shell, dass Sie keine Infrastruktur betreiben. Für ein benutzerdefiniertes Basis-Image, GPU-Zugriff oder eine Sitzung, die stundenlang läuft, bietet Ihnen eine von Ihnen betriebene Sandbox-Plattform wie Modal oder Daytona diese Kontrollmöglichkeiten.
Wie sandboxt man einen KI-Agenten?
Sie führen die Befehle des Agenten in einer von Ihren eigenen Systemen isolierten Umgebung aus und beschränken, was diese Umgebung erreichen kann. Bei einem gehosteten Tool übernimmt der Anbieter dies. Bei OpenRouter sind Container von unserer Infrastruktur und von Ihrer Maschine isoliert, auf Ihr Konto und Ihren Workspace beschränkt, der ausgehende Netzwerkzugriff ist standardmäßig deaktiviert, jeder Befehl ist durch timeout_msbegrenzt, und die Ausgabe ist durch max_output_lengthgedeckelt. Workspace-Guardrails fügen vor dem Modell eine Prompt-Injection-Erkennung hinzu.
Was ist ein sandboxed KI-Tool?
Es ist ein Tool, dessen Nebeneffekte auf eine isolierte Umgebung statt auf Ihre Produktionssysteme beschränkt sind. Bei der Code-Ausführung laufen die Befehle des Modells in einem Container mit eigenem Dateisystem, eingeschränktem Netzwerkzugriff und einem Zeitlimit, und nur die Befehlsausgabe gelangt zurück zum Modell. Unsere Shell- und Bash-Server-Tools funktionieren auf diese Weise.