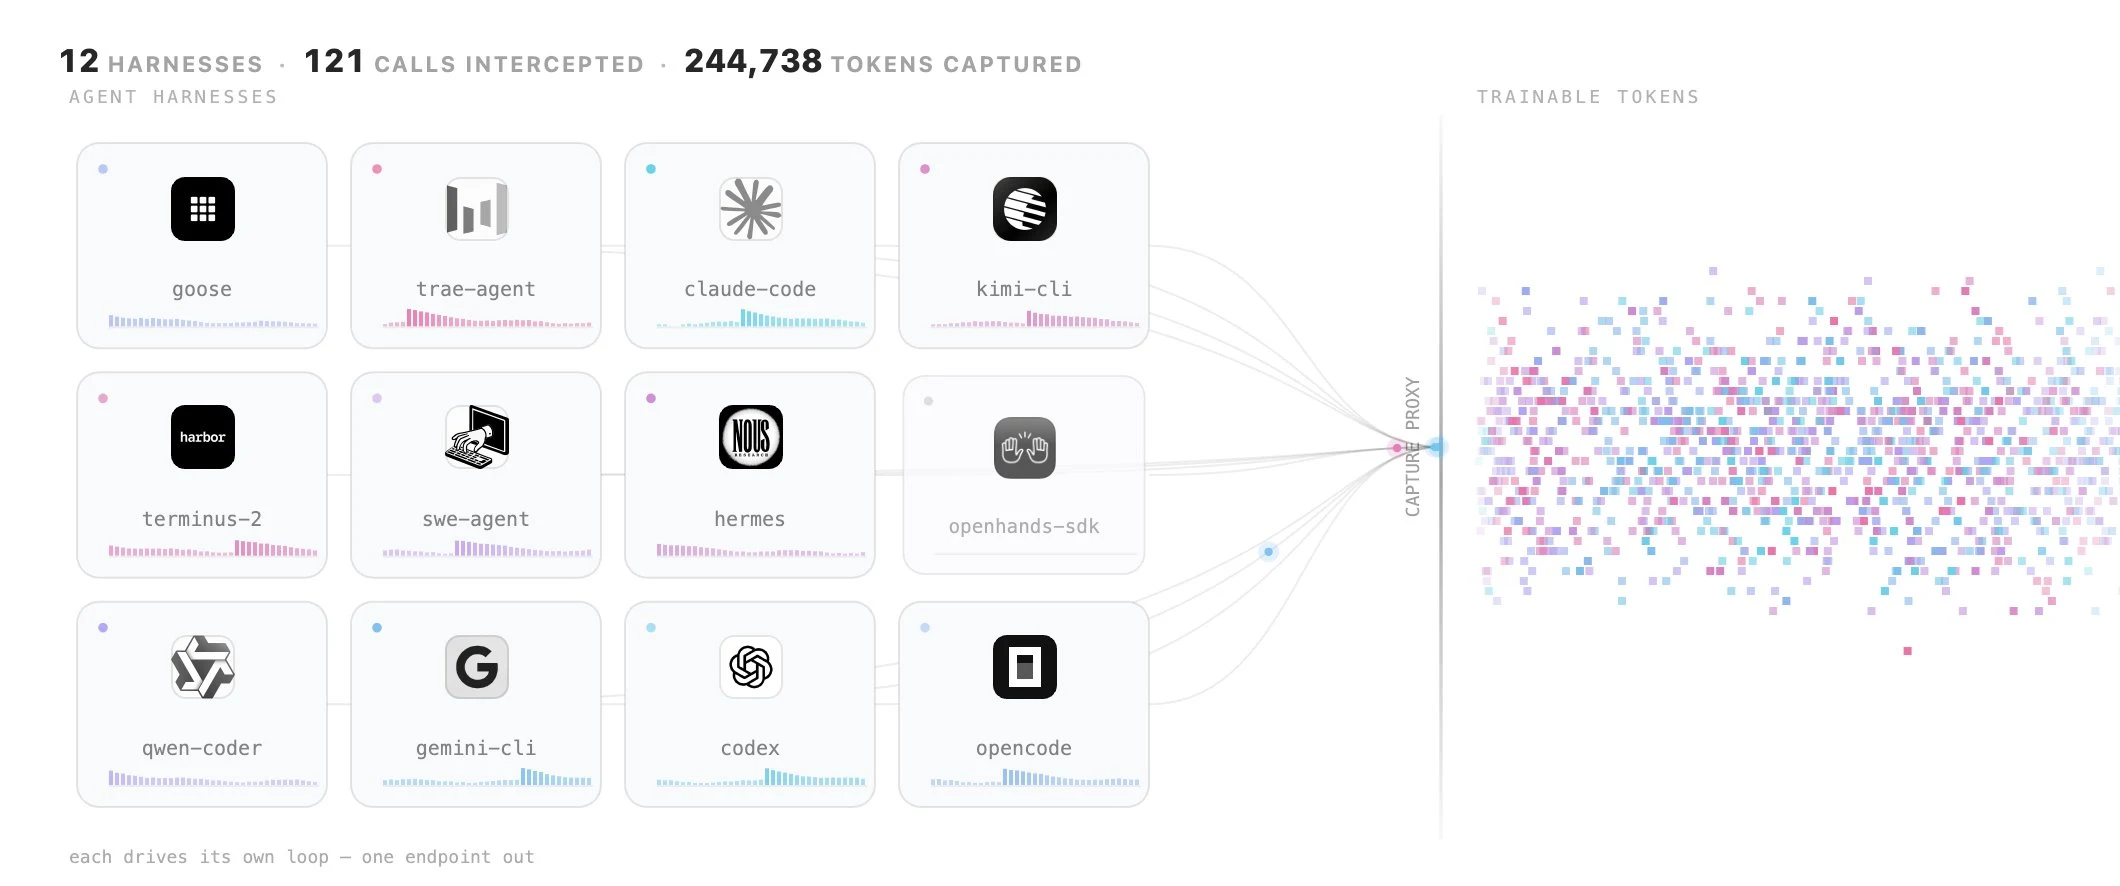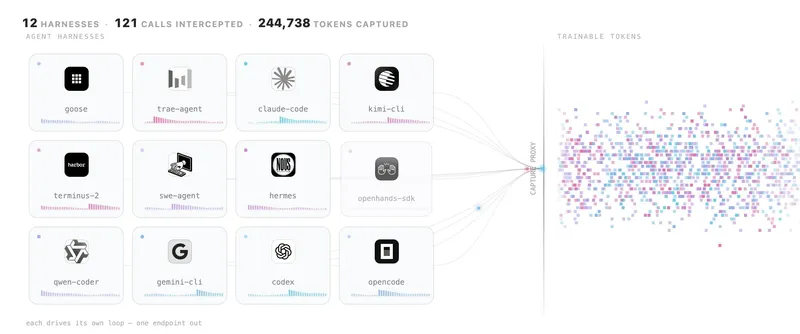
Wir haben Claude Code, Codex, Hermes, Pi, @opencode und andere Coding-Harnesses in RL-Umgebungen verwandelt. Keine Änderungen an den Harnesses, keine Änderungen am Trainingscode. Jedes offene Modell, jeder Task-Satz, vollständig open source, meine Freunde!
Gleiches Modell, gleiche Gewichte: 62% unter Mini-SWE-Agent, 33% unter Claude Code. Aber Training innerhalb eines echten Harnesses bedeutet normalerweise, ihn als Umgebung nachzuimplementieren, sodass die meisten Modelle in einem Scaffold trainiert werden, den niemand wirklich ausliefert.
Die Lösung ist ein Proxy, kein Rewrite. Der Harness glaubt, mit einer Modell-API zu sprechen. Tatsächlich spricht er mit einem Capture-Proxy, der die 4 Formate beherrscht, die Coding-Agents verwenden (OpenAI Chat Completions, OpenAI Responses, Anthropic Messages, Gemini), an @vllm_project weiterleitet, die exakten Token-IDs und Logprobs aufzeichnet, die vLLM gesampelt hat, und TRL Sequenzen übergibt, auf denen es trainieren kann. Das Harness wird zur Umgebung. 10 Harnesses laufen heute durch ihn, keiner wurde modifiziert.
Und weil Sie die Reward-Funktion kontrollieren, können Sie Verhaltensweisen formen, die das Harness nie angefordert hat. Wir haben einen kleinen Bonus für das Lösen einer Aufgabe mit weniger Tool-Aufrufen hinzugefügt: Bei Aufgaben, die es bereits gelöst hat, verwendet das Modell jetzt 31% weniger Aufrufe, in jedem Harness, und etwa die Hälfte unter Codex.
Getestet auf LFM2.5-2.6B von @liquidai:
→ Training in einem Harness: Verbesserung hauptsächlich in diesem Harness (OpenCode 34% → 58%).
→ Training in 4 gleichzeitig: Verbesserung in allen 4 (42% → 54%).
→ Stattdessen SFT auf 3,189 Rollouts von Qwen3.8-27B: Plateau bei 47.5%, unter beiden RL-Läufen.
Alles ist offen und reproduzierbar: der Capture-Proxy in OpenEnv, der Trainer in TRL, die Aufgaben, die SFT-Daten, der Trainingscode und alle 7 trainierten Modelle. Größere Modelle und größere Läufe als Nächstes.
Vollständige Anleitung: https://huggingface.co/spaces/FineEnvs/multi-harness-rl