
Eine zentrale Herausforderung, die entsteht, wenn Multi-Agenten-Systeme von der Experimentierphase in die Produktion überführt werden, besteht darin, sicherzustellen, dass diese Systeme in realen Szenarien konsistent hilfreich, genau und erklärbar sind. Unternehmen setzen zunehmend Multi-Agenten-Systeme ein, um komplexe Probleme der realen Welt zu lösen, die ein Schlussfolgern über Datenquellen, Werkzeuge und Geschäftsbeschränkungen hinweg erfordern. Von der Lieferkettenplanung über Finanzanalysen bis hin zu Kundenoperationen gehen diese Systeme über einfache Frage-Antwort-Szenarien hinaus. Sie koordinieren mehrere spezialisierte Agenten, um Entscheidungen zu treffen, Workflows auszuführen und umsetzbare Empfehlungen zu generieren.
Während große Sprachmodelle flüssige Antworten generieren können, erfordern Unternehmensanwendungen weitaus tiefere Garantien, bei denen Agenten Anweisungen zuverlässig befolgen müssen, die richtigen Werkzeuge auswählen, Einschränkungen einhalten und eine klare Begründung für ihre Ergebnisse liefern müssen.
Amazon Bedrock AgentCore ist eine Plattform zum Aufbau, zur Verbindung und zur Optimierung von Agenten in großem Maßstab, mit jedem Framework oder Modell. Amazon Bedrock AgentCore Evaluations, eine Funktion von Amazon Bedrock AgentCore, wurde entwickelt, um diese Herausforderung als vollständig verwaltete Funktion zur Bewertung der Agentenleistung in Entwicklung und Produktion anzugehen, sodass Teams Genauigkeit, Aufgabenerfolg und Verhalten über mehrere Qualitätsdimensionen hinweg messen können. Herkömmliche Bewertungsansätze, die sich nur auf die Qualität der Modellantworten konzentrieren, sind für agentische Systeme unzureichend, bei denen die Korrektheit von der Werkzeugauswahl, der Workflow-Ausführung und der Einhaltung von Geschäftsbeschränkungen abhängt. Neben der Bewertung erfordert die Produktionsbereitstellung agentischer Systeme auch Kontrollen für verantwortungsvolle KI. Amazon Bedrock Guardrails bietet konfigurierbare Schutzmaßnahmen wie Inhaltsfilterung, Erkennung verweigerter Themen und Grounding-Validierung, die das Bewertungsframework ergänzen. Während Bewertungen die Qualität von Agenten nach der Ausführung beurteilen, setzen Guardrails Sicherheitsbeschränkungen während der Ausführung durch. In diesem Beitrag konzentrieren wir uns auf die Operationalisierung dieses Bewertungsframeworks mit Amazon Bedrock AgentCore Evaluations, das sowohl integrierte Evaluatoren als auch benutzerdefinierte Evaluatoren unterstützt. Integrierte Evaluatoren bieten vordefinierte Bewertungen für gängige Qualitätsdimensionen wie Hilfsbereitschaft, Aufgabenerfolg und Befolgung von Anweisungen, sodass Teams die Leistung von Agenten ohne zusätzlichen Aufwand schnell als Basislinie erfassen können. Unternehmensanwendungen erfordern jedoch tiefere, domänenspezifische Validierung. Benutzerdefinierte Evaluatoren lösen dies, sodass Sie geschäftsorientierte Prüfungen definieren können.
Wir konzentrieren uns auch speziell auf Erklärbarkeit als eigenständige Bewertungsdimension. Wir zeigen, wie integrierte Evaluatoren die allgemeine Antwortklarheit beurteilen können. Wir veranschaulichen, wie benutzerdefinierte Evaluatoren verwendet werden, um zu überprüfen, ob Agenten ihre Entscheidungslogik explizit darlegen, unterstützende Daten oder Werkzeugausgaben referenzieren und Abwägungen wie Kosten versus Serviceniveau erklären. Durch die Kombination dieser Evaluatoren zeigen wir, wie AgentCore Evaluations über oberflächliche Antwortqualität hinausgehen und strukturierte, messbare Einblicke darin liefern kann, wie und warum Agenten zu ihren Entscheidungen gelangen.
Um diese Konzepte konkreter zu machen, führen die folgenden Abschnitte durch eine Referenzarchitektur und eine Implementierung, die zeigt, wie diese Komponenten in der Praxis zusammenwirken.
Lösungsübersicht
Für diesen Beitrag verwenden wir ein fiktives globales Einzelhandelsunternehmen namens AnyCompany Retail, ein multinationales Einzelhandelsunternehmen, das E-Commerce-Kanäle, regionale Erfüllungszentren, Distributionszentren und Tausende von physischen Geschäften betreibt. AnyCompany erlebt häufige Bestandsungleichgewichte: In einigen Regionen kommt es während Aktionen zu Lieferengpässen, während andere über übermäßige Bestände verfügen. Transportteams müssen außerdem Liefergeschwindigkeit, Transporteurkapazität und Kosten ausbalancieren. Das Unternehmen möchte einen agentischen Assistenten, der Planern helfen kann, die Bestandszuweisung zu optimieren, Distributionsanpassungen zu empfehlen, die Bestandsgesundheit zu analysieren und Routing- oder Erfüllungsszenarien zu simulieren.
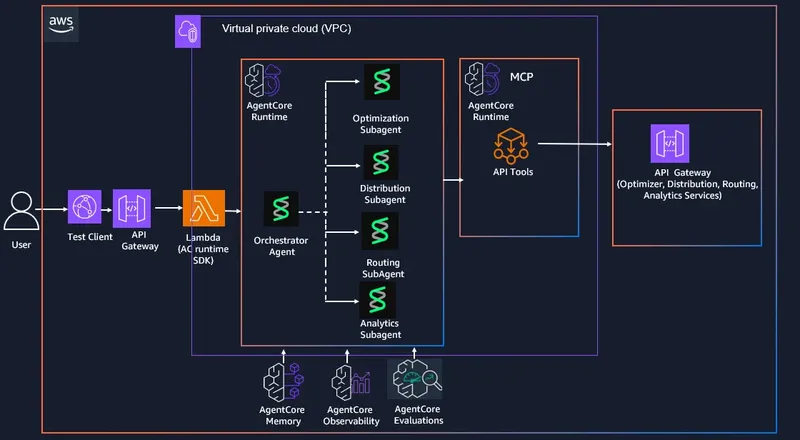
Sie werden ein Multi-Agenten-System für Entscheidungen in der Lieferkette aufbauen und bewerten, das Strands Agents SDK, Amazon Bedrock AgentCore MCP Server und Amazon Bedrock AgentCore Evaluations verwendet. Die Lösung nutzt Strands Agents mit einem Orchestrator-Agenten und vier spezialisierten Unteragenten: einem Optimierungsagenten, einem Distributionsagenten, einem Routing-Agenten und einem Analyse-Agenten. Jeder Agent läuft in der Amazon Bedrock AgentCore runtime mit aktiviertem Amazon Bedrock AgentCore memory und Amazon Bedrock AgentCore Observability .
Der Orchestrator-Agent erhält die Anfrage des Planers und delegiert Arbeit an spezialisierte Agenten, die als Tools bereitgestellt werden. Der Optimierungsagent ruft MCP-Tools auf, die durch Mock- Amazon API Gateway REST-Schnittstellen-backed sind, die Optimierungsentscheidungen zurückgeben. Der Distributionsagent ruft Empfehlungs-APIs auf, um eine Neuausrichtung des Bestands über Fulfillment-Center, Geschäfte und digitale Kanäle hinweg vorzuschlagen. Der Routing-Agent ruft Logistik-APIs auf, um Carrier- und Routenoptionen zu empfehlen, und der Analytics-Agent beantwortet Diagnosefragen zur Lieferkette. Diese Lösung verwendet Foundation Models auf Amazon Bedrock für die Agentenschleife. Informationen zur Modellverfügbarkeit nach Region finden Sie unter Supported models by AWS Region in Amazon Bedrock.
Die Lösung verwendet integrierte Evaluator-Instanzen (Built-in Evaluators), die allgemeine Qualitätsdimensionen wie Hilfsbereitschaft und Aufgabenerfüllung bewerten. Sie bietet außerdem benutzerdefinierte Evaluator-Instanzen, die lieferkettenspezifisches Verhalten bewerten, z. B. Einhaltung von Nebenbedingungen, Routenmachbarkeit, SQL-Korrektheit, Bestandsverankerung und Erklärungsqualität. AnyCompany kann sowohl die sprachliche Qualität der Antwort als auch die geschäftliche Gültigkeit der Entscheidung des Agenten bewerten.
Die Lösung unterstützt sowohl den On-Demand- als auch den Online-Modus mit Amazon Bedrock AgentCore Evaluations. Der On-Demand-Modus ist für Entwicklungsbenchmarks, Regressionstests sowie Continuous-Integration- und Continuous-Delivery-Gates (CI/CD) gedacht. Der Online-Modus dient der kontinuierlichen Produktionsüberwachung und Alarmierung. Beide Modi helfen Ihnen, die Schleife zu schließen und auf Feedback Ihrer Nutzer zu reagieren. Dieselben benutzerdefinierten Evaluator-Instanzen (wie die Evaluator-Instanzen für Nebenbedingungen, Routenmachbarkeit, SQL-Korrektheit und Erklärbarkeit aus Ihrer Lieferkettenlösung), die für On-Demand-Bewertungen verwendet werden, werden mit einem OnlineEvaluationConfig-Objekt wiederverwendet, das auf die Amazon Resource Names (ARNs) der Evaluator-Instanzen verweist und eine Sampling-Rate (z. B. 1–10 % der Produktions-Traces) zusammen mit optionalen Sitzungsfiltern angibt. Der Dienst liest dann automatisch Traces aus AgentCore Observability, bewertet sie und streamt die Ergebnisse zu Amazon CloudWatch Dashboards und Alarmen. In diesem Beitrag verwenden Sie den On-Demand-Modus, um die Lösung zu testen.
Das folgende Architekturdiagramm veranschaulicht die verschiedenen Komponenten unserer Lösung.
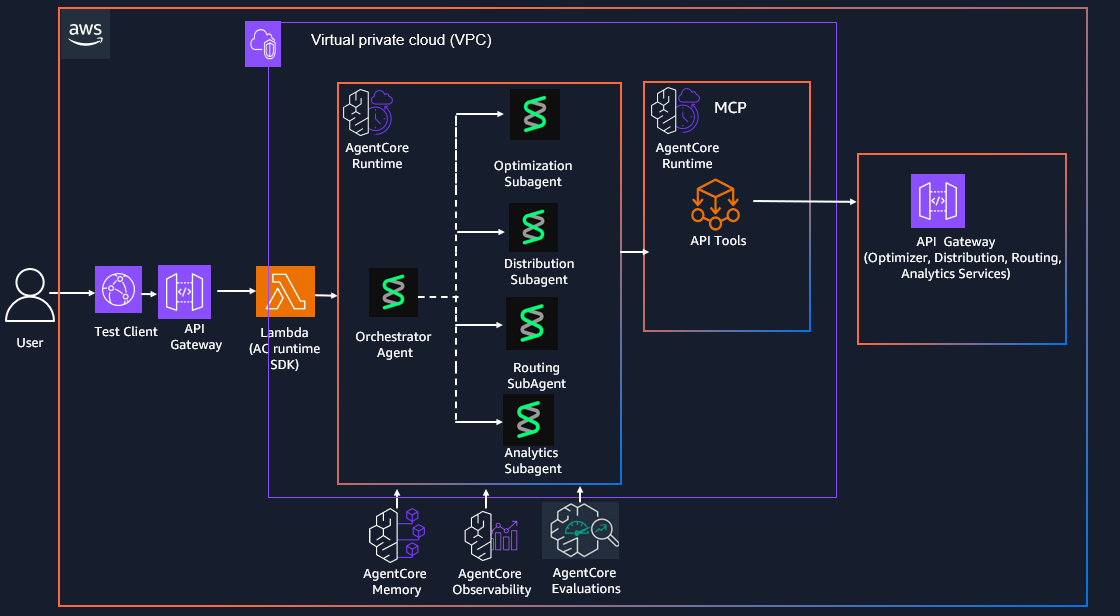
Abbildung 1: Architektur der Multi-Agenten-Lieferketten-Entscheidungslösung
Evaluierungsframework
In diesem Beitrag verwenden Sie einen dreiSchichtigen Bewertungsansatz für Multi-Agenten-Systeme, der schrittweise Unternehmensvertrauen aufbaut. Der Ansatz folgt einer klaren Progression, die mit integrierten Evaluator-Instanzen für allgemeine Qualität beginnt, dann benutzerdefinierte Evaluator-Instanzen für geschäftliche Genauigkeit hinzufügt und schließlich Erklärbarkeits-Evaluator-Instanzen für Vertrauen und Nachvollziehbarkeit ergänzt.
Die erste Schicht verwendet integrierte Evaluator-Instanzen, die keine Einrichtung erfordern. Wir wenden Helpfulness als universelle Basislinie an, plus eine zweite agentenspezifische Evaluator-Instanz, die den primären Fehlermodus jedes Agenten anspricht: Tool Selection Accuracy für den Orchestrator, Response Relevance für Optimierung und Distribution, Instruction Following für Routing und Faithfulness für Analytics.
Die zweite Schicht fügt benutzerdefinierte Evaluator-Instanzen hinzu, die domänenspezifische Geschäftsregeln abbilden: Nebenbedingungserfüllung für Optimierung, Datenverankerung für Distribution, Routenmachbarkeit für Routing, SQL-Korrektheit für Analytics und Plankohärenz für Orchestrierung. Diese validieren die geschäftliche Gültigkeit: Hat die Empfehlung die Budgetgrenzen eingehalten, echte Bestandsdaten verwendet und operationell korrekte Ergebnisse erzeugt?
Die folgende Tabelle ordnet die beiden integrierten Evaluator-Instanzen und die benutzerdefinierte Evaluator-Instanz zu, die für jeden Agenten ausgewählt wurden, den Sie hier implementieren werden. Die zweite integrierte Evaluator-Instanz richtet sich nach dem primären Fehlermodus jedes Agenten, während die benutzerdefinierte Evaluator-Instanz domänenspezifische Geschäftsregeln abbildet, die die operationelle Korrektheit validieren.
| Agent | Integrierte Evaluator-Instanzen | Benutzerdefinierte Evaluator-Instanzen |
| Orchestrator-Agent | Helpfulness; Tool Selection Accuracy | Plan-Kohärenz-Evaluator: Hat er die Ausgaben der Sub-Agenten zu einer gültigen, widerspruchsfreien Empfehlung kombiniert? Tool-Trajektorien-Evaluator: Hat er zum richtigen Sub-Agenten weitergeleitet? |
| Optimierungsagent | Helpfulness; Response Relevance | Nebenbedingungserfüllungs-Evaluator: Budget, Bestandsabdeckung (Nachfrage ≤ qty ≤ 2× Nachfrage) und Lagerkapazitätsnebenbedingungen. KPI-Erreichungs-Evaluator (Key Performance Indicator): Erreichtes Ziel bei Füllgrad-/Umsatzverbesserung. |
| Distributionsagent | Helpfulness; Response Relevance | Empfehlungsverankerungs-Evaluator: Die Empfehlung ist in aktuellen Bestands-/Nachfragedaten verankert. Risikowirkungs-Evaluator: Die Empfehlung verringert das Risiko von Lieferengpässen/Überbeständen. |
| Routing-Agent | Helpfulness; Instruction Following | Routenmachbarkeits-Evaluator: Die Route beachtet Lieferfenster, Kosten, Carrier-Kapazität und Regionnebenbedingungen. SLA-Evaluator (Service Level Agreement): Die voraussichtliche Lieferung erfüllt den Ziel-Servicestand. |
| Analytics-Agent | Helpfulness; Faithfulness | SQL-Korrektheits-Evaluator: Die Abfrage entspricht der Absicht des Nutzers. Datenverankerungs-Evaluator: Die Antwort wird durch die Abfrageergebnisse von Amazon Relational Database Service (Amazon RDS) gestützt. Evaluator für nicht gestützte Behauptungen. |
Erklärbarkeit
Die dritte Schicht unseres Bewertungsansatzes setzt Erklärbarkeitsevaluatoren als eigenständige, übergreifende Prüfungen über die Agents hinweg ein. Diese bewerten unabhängig voneinander, ob Agents die Entscheidungsrationale artikulieren, unterstützende Belege aus Tool-Ausgaben zitieren, erklären, welche Constraints die Antwort geprägt haben, Zielkonflikte zwischen konkurrierenden Zielen darlegen, klarstellen, warum bestimmte Sub-Agents aufgerufen wurden, und Annahmen offenlegen, wenn Daten unvollständig sind. Indem wir Erklärbarkeit in eine eigene Evaluierungsschicht auslagern, können wir Transparenz unabhängig messen. Eine Empfehlung kann korrekt, aber unerklärbar sein (eigene Evaluatoren bestehen, aber an der Erklärbarkeit scheitern), was Teams umsetzbare Signale darüber liefert, ob Agents eine bessere Begründungsartikulation statt einer besseren Entscheidungslogik benötigen.
Die folgende Tabelle definiert die sechs unabhängigen Erklärbarkeitsevaluatoren, die Sie hier implementieren und die als übergreifende Schicht über die Agents hinweg angewendet werden. Diese prüfen, ob Agents ihr reasoning artikulieren, Belege zitieren, Constraints und Zielkonflikte erklären und Annahmen offenlegen. Sie werden getrennt von der Genauigkeit gemessen, damit Teams unerklärbar-aber-korrekte Antworten von gut erklärten-aber-falschen Antworten unterscheiden können.
| Evaluator | Agents | Was geprüft wird |
| Qualität der Entscheidungsrationale | Alle | Hat der Agent erklärt, warum er die Empfehlung abgegeben hat? |
| Belegzuordnung | Analytics, Distribution, Routing | Hat er die verwendeten Datenfelder, API-Antworten oder SQL-Ergebnisse zitiert? |
| Constraint-Reasoning | Optimization, Routing | Hat er erklärt, welche Constraints die endgültige Antwort geprägt haben? |
| Erklärung von Zielkonflikten | Optimization, Distribution, Routing | Hat er die Zielkonflikte zwischen Kosten, Serviceniveau und Inventarrisiken erklärt? |
| Erklärbarkeit der Tool-Nutzung | Orchestrator | Hat er erklärt, warum jeder Sub-Agent oder jedes MCP-Tool aufgerufen wurde? |
| Offenlegung von Annahmen | Alle Agents | Hat er klar Annahmen angegeben, wenn Daten unvollständig waren? |
Voraussetzungen
Bevor Sie diese Lösung bereitstellen, richten Sie Ihre Entwicklungsumgebung mit den folgenden Tools ein.
- Installieren Sie die AWS Command Line Interface (AWS CLI)
- Installieren Sie die AWS Serverless Application Model (AWS SAM) CLI v1.100.0+
- Installieren Sie Docker v20.x+
- Installieren Sie Node.js v18.x+
- Installieren Python v3.11+
Abhängigkeiten
Die Strands-Agents-Implementierung benötigt außerdem die folgenden Abhängigkeiten, die in der DockerFile gepackt sind:
- strands-agents # Strands Agents Multi-Agent-Framework
- strands-agents-tools # Strands Agent-Tools und Hilfsprogramme
- requests # HTTP-Bibliothek für API-Aufrufe
- bedrock-agentcore # Amazon Bedrock Agent-Core-Funktionalität
- boto3 # AWS SDK für Python (Boto3)
Lösung bereitstellen und ausführen
Die Lösung steht zum Download bereit über unser GitHub-Repository und bietet eine Ein-Schritt-Bereitstellung, um die Lösung in Ihrer AWS-Umgebung bereitzustellen und darauf zuzugreifen:
# Edit terraform.tfvars: set vpc_id and runtime_subnet_azs
cd terraform
cp terraform.tfvars.example terraform.tfvars
terraform init
terraform apply
Die Ausgaben umfassen Runtime-ARNs, die AnyCompany Retail API-URL, die Evaluator-API-URL und den Memory-ARN.
Lösung ausführen
Führen Sie die folgenden Schritte aus, um die Lösung auszuführen:
Der Ordner test_client/ enthält ein Python-Skript, das den bereitgestellten Supply-Chain-Agenten mit 20 Beispielabfragen (5 pro Sub-Agenten) aufruft, um die End-to-End-Funktionalität zu validieren. Jede Kategorie läuft als Multi-Turn-Session, und die Session-IDs werden am Ende zur Verwendung mit der Evaluators-API ausgegeben.
cd test_client
pip install -r requirements.txt
cd terraform
terraform output supply_chain_arn
Alle Abfragen ausführen (20 insgesamt, 4 Sessions)
cd test_client
python test_agent.py --runtime-arn "<supply_chain_arn>" --region <your_region>
Bestimmte Sub-Agenten-Kategorien ausführen
#Only optimization queries (1 session, 5 turns)
python test_agent.py --runtime-arn "<supply_chain_arn>" --category optimization
#Only routing and analytics (2 sessions, 5 turns each)
python test_agent.py --runtime-arn "<supply_chain_arn>" --category routing analytics
Der Test-Client gibt jede Abfrage und die vollständige Antwort des Agenten aus. Am Ende gibt er die Session-IDs zur Verwendung mit den Evaluators aus.
Evaluierungen erstellen und ausführen
Der Ordner test_evaluators/ enthält Skripte zum Ausführen von Evaluierungen gegen Agenten-Sessions. Diese Evaluierungen laufen asynchron, und die Ergebnisse werden als Markdown-Dateien in S3 gespeichert.
Sie müssen zunächst die Multi-Agent-Lösung für Supply-Chain-Entscheidungen wie zuvor beschrieben aufrufen, um Agenten-Sessions mit Traces zu erzeugen, und sich die am Ende des Test-Client-Laufs ausgegebenen Session-IDs notieren. Warten Sie abschließend 3-5 Minuten nach dem Ausführen der Lösung, damit die Traces an CloudWatch übermittelt werden.
cd test_evaluators
pip install -r requirements.txt
cd terraform
terraform output evaluators_api_url
Benutzerdefinierte Evaluatoren erstellen
python test_evaluator.py --api-url "https://<evaluators-api-url>" createDies registriert benutzerdefinierte Evaluatoren und gibt deren IDs aus. Speichern Sie diese für die Verwendung mit dem run-Befehl.
Evaluierungen ausführen
Übergeben Sie eine kommagetrennte Liste von Evaluator-IDs (benutzerdefiniert oder integriert). Mindestens 1 ist erforderlich:
# Run custom + built-in evaluators
python test_evaluator.py --api-url "https://<evaluators-api-url>" run \
--agent-id "supply_chain_orchestrator_agent-<id>" \
--session-id "<session-id-from-test-client>" \
--evaluators " sc_optimization_constraint-<id>,sc_distribution_groundedness-<id>,Builtin.Correctness,Builtin.GoalSuccessRate"
Die API gibt sofort 202 zurück. Die Ergebnisse werden asynchron in S3 unter folgendem Pfad gespeichert:
s3://<amzn-s3-demo-agent-source-bucket>/evaluations/<session-id>/<timestamp>/EvaluationResults.mdEvaluatoren löschen
python test_evaluator.py --api-url "https://<evaluators-api-url>" delete \
--evaluator-ids "sc_optimization_constraint-<id>,sc_distribution_groundedness-<id>"
Eine Optimierungs-Evaluierung ausführen
Nun, da Sie das Evaluierungs-Framework kennen und die Lösung bereitgestellt haben, führen wir eine gezielte End-to-End-Evaluierung des Optimierungsagenten durch. Diese Demonstration zeigt, wie man einen benutzerdefinierten Evaluator für fachliche Genauigkeit (Layer 2) mit Erklärbarkeits-Evaluatoren (Layer 3) kombiniert, um sowohl die Korrektheit als auch die Transparenz von Optimierungsentscheidungen zu bewerten.
Schritt 1: Optimierungsabfragen ausführen
Rufen Sie zunächst den Test-Client nur mit der Kategorie optimization auf, um eine gezielte Session zu erzeugen:
cd test_client
python test_agent.py --runtime-arn "<supply_chain_arn>" \
--category optimization \
--region <your_region>
Dies führt 5 Optimierungsabfragen als Multi-Turn-Session aus. Der Agent verarbeitet Anfragen wie „What is the optimal inventory level for prod-001 over the next 30 days?“. Jede Abfrage erfordert, dass der Optimierungsagent MCP-Tools aufruft, Nachfrageprognosen abruft und Einlagerungsempfehlungen erstellt, die Budget-, Bestandsabdeckungs- und Lagerkapazitätsbeschränkungen einhalten. Am Ende des Laufs gibt der Test-Client die Session-ID der Optimierung aus.
Schritt 2: Den Constraint-Satisfaction-Evaluator ausführen (Layer 2: fachliche Genauigkeit)
Nachdem die Optimierungssession erzeugt wurde, führen Sie den benutzerdefinierten Constraint-Satisfaction-Evaluator aus, um zu prüfen, ob die Einlagerungsempfehlungen des Agenten die Geschäftsregeln einhalten. Dieser Evaluator prüft drei Beschränkungen gleichzeitig:
- Budget: Passt der inkrementelle Haltekostenbetrag in das verbleibende Budget (budget_limit − budget_used)?
- Bestandsabdeckung: Liegt der empfohlene Pegel ≥ Nachfrageprognose (vermeidet Stockout) und ≤ 2× Nachfrage (vermeidet Überbestand)?
- Lagerkapazität: Passt die empfohlene Menge in den verfügbaren Lagerraum?
Führen Sie den Evaluator zusammen mit den integrierten Evaluatoren Helpfulness und Response Relevance aus:
cd test_evaluators
python test_evaluator.py --api-url "https://<evaluators-api-url>" run \
--agent-id "supply_chain_orchestrator_agent-<id>" \
--session-id "<optimization-session-id>" \
--evaluators "sc_optimization_constraint-<id>,Builtin.Helpfulness,Builtin.ResponseRelevance"
Die API gibt sofort HTTP 202 zurück. Auswertungen laufen asynchron. Die Ergebnisse werden in S3 gespeichert:
s3://<amzn-s3-demo-agent-source-bucket>/evaluations/<optimization-session-id>/<timestamp>/EvaluationResults.mdSchritt 3: Explainability-Evaluatoren ausführen (Schicht 3: Vertrauen und Nachvollziehbarkeit)
Nachdem bestätigt wurde, dass der Optimierungs-Agent constraint-erfüllende Empfehlungen erzeugt, stellt sich die nächste Frage: Erklärt es seine Entscheidungsfindung? Eine Empfehlung kann korrekt, aber intransparent sein. Eine solche Empfehlung besteht den Constraint-Evaluator, vermag aber nicht zu begründen, warum sie ein bestimmtes Inventarniveau gewählt hat.
Mit derselben Optimierungs-Sitzungs-ID aus Schritt 1 führen Sie nun die beiden Explainability-Evaluatoren aus, die auf den Optimierungs-Agent anwendbar sind:
- Decision Rationale Quality — Hat der Agent erklärt, warum er die Empfehlung abgegeben hat? (zum Beispiel: „Empfehlung von 1,500 Einheiten, weil die Nachfrageprognose 1,200 beträgt und wir einen Sicherheitsfaktor von 1.25× ansetzen“)
- Constraint Reasoning — Hat der Agent erklärt, welche Constraints die endgültige Antwort geprägt haben? (zum Beispiel: „Das Budget erlaubt bis zu 1,800 Einheiten, aber die Lagerkapazität begrenzt uns auf 1,600, daher empfehlen wir 1,500“)
python test_evaluator.py --api-url "https://<evaluators-api-url>" run \
--agent-id "supply_chain_orchestrator_agent-<id>" \
--session-id "<optimization-session-id>" \
--evaluators "sc_decision_rationale-<id>,sc_constraint_reasoning-<id>"
Diese Evaluatoren bewerten die Transparenz unabhängig. Sie werden getrennt von der Genauigkeit gemessen.
Interpretation der kombinierten Ergebnisse
Durch die Ausführung aller drei Evaluatoren gegen dieselbe Optimierungs-Sitzung erhalten Sie ein vollständiges Bild der Agent-Qualität in zwei Dimensionen:
| Dimension | Evaluator | Beantwortete Frage |
| Geschäftliche Genauigkeit (Schicht 2) | Constraint Satisfaction | Sind die Empfehlungen operativ korrekt? |
| Explainability (Schicht 3) | Decision Rationale Quality | Warum trifft der Agent diese Empfehlung? |
| Explainability (Schicht 3) | Constraint Reasoning | Welche Constraints haben die Antwort geprägt? |
Tabelle 3: Abdeckung der Evaluierung über Qualitätsdimensionen hinweg
Dieser geschichtete Ansatz ermöglicht gezielte Verbesserungen. Wenn die Constraint-Satisfaction-Werte hoch, die Explainability-Werte jedoch niedrig sind, ist die Entscheidungslogik des Agenten solide, aber seine Kommunikation muss verbessert werden. Umgekehrt gilt: Wenn die Explainability hoch ist, aber Constraints verletzt werden, formuliert der Agent seine Begründung gut, wendet jedoch fehlerhafte Logik an. Jeder Fehlermodus hat einen anderen Sanierungspfad, und das Evaluierungs-Framework macht diese Unterscheidung messbar.
Aufräumen
Um wiederkehrende Kosten zu vermeiden, räumen Sie Ihr AWS-Konto nach dem Ausprobieren der Lösung in einem einzigen Schritt auf.
terraform destroyFazit
In diesem Beitrag haben wir gezeigt, wie man ein Multi-Agenten-System für Entscheidungen in der Lieferkette mit Amazon Bedrock AgentCore Evaluations aufbaut und evaluiert, mit dem Fokus darauf zu überprüfen, dass das Verhalten des Agenten nicht nur funktional, sondern auch hilfreich, genau und nachvollziehbar ist. Anhand des Szenarios der AnyCompany Retail Group haben wir gezeigt, wie ein Orchestrator-Agent und spezialisierte Sub-Agents zusammenarbeiten, um komplexe Probleme wie Inventarzuweisung, Distributionsplanung, Routenoptimierung und Lieferkettendiagnostik zu lösen, während sie sich in Unternehmensdatenquellen und APIs integrieren. Wie in der gesamten Architektur verdeutlicht, geht Korrektheit in agentischen Systemen über die Antwortqualität hinaus. Sie hängt von der Auswahl der richtigen Tools, der Ausführung des korrekten Workflows, der Einhaltung von Geschäftsconstraints und der Verankerung der Ausgaben in Daten ab.
Durch die Kombination integrierter Evaluatoren mit benutzerdefinierten Evaluatoren können Teams sowohl die allgemeine Antwortqualität als auch die domänenspezifische Entscheidungsgenauigkeit systematisch validieren. Die Einbindung von Explainability-orientierten Evaluatoren stellt außerdem sicher, dass Agenten ihre Begründung klar darlegen, unterstützende Daten referenzieren und Trade-offs in einer Weise erklären, die Geschäftsnutzer vertrauen und umsetzen können. Dieser evaluierungsgesteuerte Ansatz ermöglicht kontinuierliche Verbesserung anhand echter Ausführungsdaten, etabliert Qualitäts-Gates vor dem Produktionsrollout und bietet ein skalierbares Framework für die Bereitstellung konsistenter, transparenter und geschäftsorientierter Multi-Agenten-Systeme.
Um loszulegen, erkunden Sie Amazon Bedrock AgentCore Evaluations und wenden Sie diese Muster auf Ihre eigenen Multi-Agent-Anwendungen an. Den vollständigen Quellcode finden Sie im Amazon Bedrock AgentCore samples repository auf GitHub. Beginnen Sie mit der Aktivierung von Observability, definieren Sie zentrale Evaluierungsdimensionen für Ihren Anwendungsfall und führen Sie schrittweise integrierte und benutzerdefinierte Evaluatoren ein, um das zu messen, was am wichtigsten ist.
Um mehr zu erfahren, besuchen Sie die Amazon Bedrock AgentCore Serviceseite oder legen Sie direkt in der Amazon Bedrock console los.
Ähnliche Beiträge:
- Zuverlässige KI-Agents mit Amazon Bedrock AgentCore Evaluations entwickeln
- Hochskalierbare serverlose LangGraph-Multi-Agent-Systeme in AWS mit Amazon Bedrock AgentCore entwickeln
- Bewertung von KI-Agents: Praxiserfahrungen aus dem Aufbau agentischer Systeme bei Amazon