
Wenn ein Nutzer den Support-Assistenten fragt – eine mit LangChain entwickelte Retrieval Augmented Generation (RAG)-Anwendung – zwei Produkte über drei Dimensionen hinweg zu vergleichen, stellt er effektiv sechs Fragen gleichzeitig. Die Ähnlichkeitssuche verwendet einen einzigen Abfragevektor, um alle Absichten zusammenzufassen. Der Retriever erzeugt dann die beste Approximation des Durchschnitts dieser Absichten. Die resultierende Antwort fällt knapp aus. Die Suche wird ohne Fehler ausgeführt. Die Relevanzwerte wirken plausibel. Doch die abgerufenen Chunks decken zwar thematisch Relevantes ab, aber nur einen Bruchteil dessen, was die Frage tatsächlich verlangt hat.
In diesem Beitrag zeigen wir eine RAG-Anwendung auf einer Amazon Bedrock Managed Knowledge Base mit LangChain. Wir führen dieselbe mehrteilige Frage durch Standard- und agentic Retrieval und lesen die Trace-Ereignisse, um den vom Modell erzeugten Plan zu sehen. Wir behandeln auch, was die beiden Retrieval-Pfade kosten und wann der günstigere die richtige Wahl ist.
Agentic Retrieval ist auf Amazon Bedrock Managed Knowledge Base verfügbar. Statt einer einzigen Suche plant Amazon Bedrock Managed Knowledge Base das Retrieval. Es zerlegt die Frage in Teilabfragen, führt diese aus, beurteilt, ob ausreichend Belege vorliegen, und sucht erneut, falls nicht. Das langchain-aws -Paket stellt sowohl agentic als auch standardmäßiges Retrieval bereit, sodass Sie beides aus einer LangChain-Anwendung nutzen können.
Lösungsübersicht
Amazon Bedrock Managed Knowledge Base, die vollständig verwaltete RAG-Funktion in Amazon Bedrock, entfernt den selbst verwalteten Vektorspeicher, Embeddings und Re-Ranking-Modelle aus der RAG-Architektur. Sie konfigurieren eine Datenquelle, und Amazon Bedrock Managed Knowledge Bases übernimmt Chunking, Embedding, Speicherung und Retrieval. Dieser Walkthrough verwendet Amazon Simple Storage Service (Amazon S3).
Amazon Bedrock Managed Knowledge Bases stellt zwei APIs bereit. Wir gehen in diesem Beitrag kurz auf diese Unterschiede ein. Die Retrieve -API führt eine hybride Suche aus und gibt bewertete Chunks zurück. Die AgenticRetrieveStream -API führt eine Planungsschleife aus und streamt die Schritte als Trace-Ereignisse an Sie zurück. Im langchain-aws -Paket ist die erste ein standardmäßiger LangChain-Retriever, den Sie direkt in eine Chain einfügen können. Die zweite ist eine Funktion, die direkt aus einer Knowledge Base abruft.
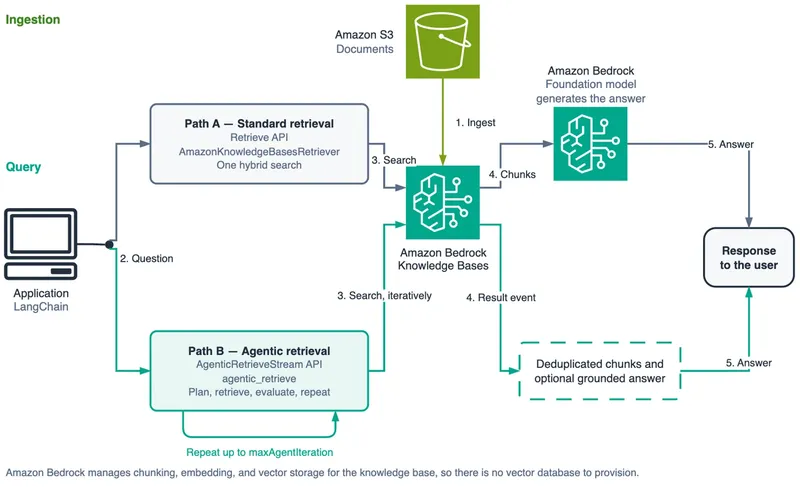
Das folgende Diagramm zeigt die Lösungsarchitektur. Die Anwendung fragt Amazon Bedrock Knowledge Bases entweder über die Retrieve-API (standardmäßig, Single-Shot) oder die AgenticRetrieveStream-API (mehrstufige Planungsschleife) ab. Beide Pfade geben Dokumenten-Chunks aus der Knowledge Base zurück, die die Anwendung dann verwendet, um eine fundierte Antwort zu generieren.
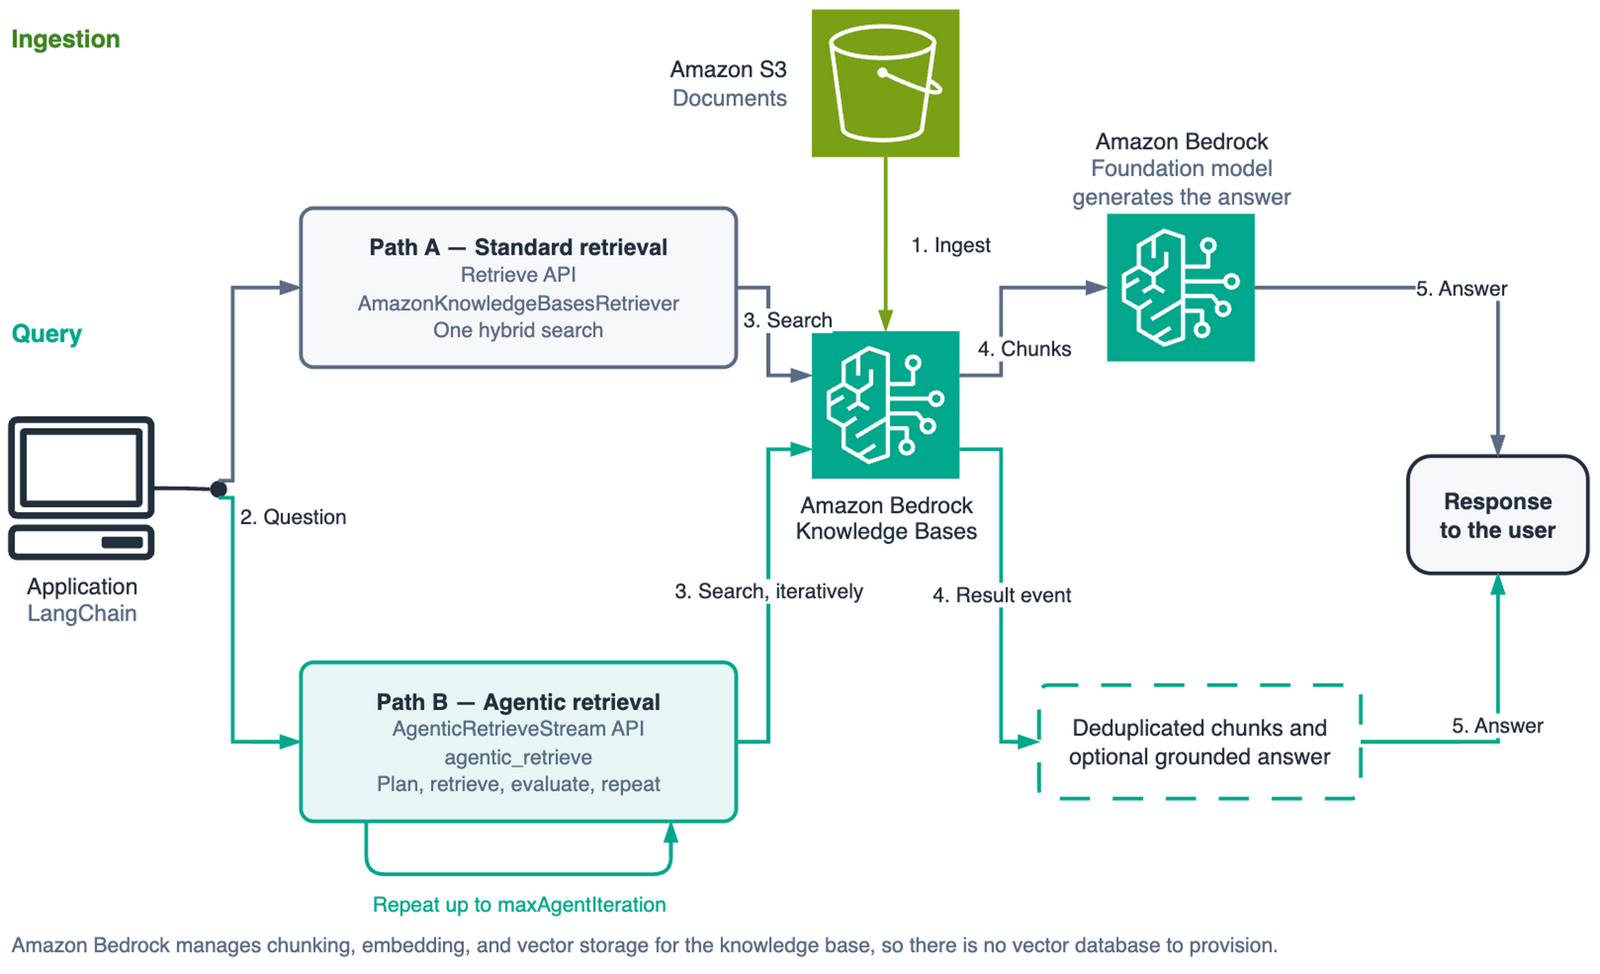
Abbildung 1: Lösungsarchitektur für die Abfrage von Amazon Bedrock Knowledge Bases mit den APIs Retrieve und AgenticRetrieveStream
Implementierungs-Walkthrough
Die folgenden Abschnitte führen Sie durch die Erstellung einer Knowledge Base, die Abfrage mit beiden Retrieval-Methoden und das Lesen der Trace-Ereignisse, die der agentic Planner erzeugt.
Voraussetzungen
Um mitzumachen, benötigen Sie:
- Ein AWS-Konto mit Zugriff auf Amazon Bedrock in einer Region, in der Amazon Bedrock Managed Knowledge Bases und agentic Retrieval verfügbar sind. Dieser Walkthrough verwendet die Region USA Ost (N. Virginia) (
us-east-1) und der Code geht davon durchgehend aus. Prüfen Sie die AWS- Dokumentation zur Verfügbarkeit und Unterstützung in anderen Regionen. - Zwei AWS Identity and Access Management (IAM)-Identitäten, die im nächsten Abschnitt beschrieben werden: eine Servicerolle, die die Knowledge Base annimmt, und Berechtigungen für die Identität, von der aus Sie die APIs aufrufen.
- Python 3.12 oder höher.
- Ein S3-Bucket, der die Beispieldokumente enthält. Das Korpus benötigt mehrere Dokumente, die sich überschneidende Themen abdecken, damit eine vergleichende Frage irgendwo hin geleitet werden kann. Ein einzelnes flaches Dokument kann kein Query-Planning demonstrieren.
Installieren Sie die Pakete. Die Boto3 -Version ist entscheidend: agentic_retrieve_stream existierte vor 1.43.32 nicht.
langchain-aws>=1.6.3
langchain>=1.0
boto3>=1.43.32
Berechtigungen
Es sind zwei Identitäten beteiligt, und ihre Trennung sollte man bewusst vornehmen. Die Knowledge Base nimmt eine Servicerolle an, um Ihre Dokumente zu lesen und das Embedding-Modell aufzurufen. Ihre Anwendung verwendet eine AWS Security Token Service (AWS STS)-Caller-Identität, um Abfragen auszuführen. Keine der beiden benötigt die Berechtigungen der anderen.
Amazon Bedrock erstellt die Servicerolle für Sie, wenn Sie dies zulassen. Um Ihre eigene bereitzustellen, geben Sie ihr eine Trust Policy, die es Amazon Bedrock erlaubt, sie anzunehmen. Beschränken Sie sie mit aws:SourceAccount und aws:SourceArn damit ein anderes Konto sie nicht als Confused Deputy missbrauchen kann:
{
    "Version": "2012-10-17",
    "Statement": [{
        "Effect": "Allow",
        "Principal": {"Service": "bedrock.amazonaws.com"},
        "Action": "sts:AssumeRole",
        "Condition": {
            "StringEquals": {"aws:SourceAccount": "111122223333"},
            "ArnLike": {
                "aws:SourceArn": "arn:aws:bedrock:us-east-1:111122223333:knowledge-base/*"
            }
        }
    }]
}
Die Servicerolle benötigt außerdem s3:ListBucket auf Ihrem Bucket und s3:GetObject auf dessen Inhalten, jeweils mit der Bedingung aws:ResourceAccount. Beschränken Sie das knowledge-base/* -Wildcardzeichen auf bestimmte Knowledge Base-IDs, nachdem Sie diese erstellt haben.
Die AWS STS-Caller-Identität benötigt einen anderen Satz. bedrock:AgenticRetrieveStream und bedrock:InvokeModelWithResponseStream lassen sich nicht auf den Amazon Resource Name (ARN) einer Knowledge Base beschränken. bedrock:Retrieve und bedrock:GetDocumentContent können das:
{
    "Version": "2012-10-17",
    "Statement": [
        {
            "Sid": "AgenticRetrievalAndPlannerModel",
            "Effect": "Allow",
            "Action": [
                "bedrock:AgenticRetrieveStream",
                "bedrock:InvokeModelWithResponseStream"
            ],
            "Resource": "*"
        },
        {
            "Sid": "RetrieveAndFullDocumentExpansion",
            "Effect": "Allow",
            "Action": ["bedrock:Retrieve", "bedrock:GetDocumentContent"],
            "Resource": "arn:aws:bedrock:<region>:111122223333:knowledge-base/<knowledge-base-id>"
        },
        {
            "Sid": "GenerateAnswersInTheChains",
            "Effect": "Allow",
            "Action": ["bedrock:InvokeModel", "bedrock:Converse", "bedrock:ConverseStream"],
            "Resource": "*"
        }
    ]
}
bedrock:GetDocumentContent wird häufig übersehen. Agentic Retrieval ruft es auf, wenn ein FullDocumentExpansion -Schritt entscheidet, dass ein Absatz nicht den Kontext zur Antwort liefert. Eine Policy mit nur bedrock:Retrieve funktioniert, bis der Planner ein ganzes Dokument anfordert, und scheitert dann mitten in einer Abfrage.
Um die Knowledge Base selbst zu erstellen und zu verwalten, benötigt die aufrufende Rolle zusätzlich bedrock:CreateKnowledgeBase auf *sowie die GetKnowledgeBase, UpdateKnowledgeBase, DeleteKnowledgeBase, StartIngestionJob, GetIngestionJob- und ListIngestionJobs -Aktionen auf knowledge-base/*. Wenn Sie Guardrails verwenden, fügen Sie bedrock:GetGuardrail und bedrock:ApplyGuardrail.
Die Durchführung dieses Walkthroughs kann Kosten für Dokumentspeicherung und -aufnahme in der Knowledge Base, Retrieval-Aufrufe und Foundation Model (FM)-Inferenz verursachen.
Weitere Informationen zu Preisen finden Sie im Abschnitt Knowledge Bases unter Amazon Bedrock pricing.
Löschen Sie die Ressourcen, sobald Sie dieses Experiment abgeschlossen haben.
Erstellen und Befüllen der Knowledge Base
Erstellen Sie die Knowledge Base mit einem managedKnowledgeBaseConfiguration. Wenn Sie embeddingModelType auf MANAGED verwendet das dienstverwaltete Embedding-Modell.
import boto3
import os

REGION = os.environ["AWS_REGION"]
bedrock_agent = boto3.client("bedrock-agent", region_name=REGION)

response = bedrock_agent.create_knowledge_base(
    name=KB_NAME,
    roleArn=KB_ROLE_ARN,
    knowledgeBaseConfiguration={
        "type": "MANAGED",
        "managedKnowledgeBaseConfiguration": {
            "embeddingModelType": "MANAGED",
        },
    },
)
KB_ID = response["knowledgeBase"]["knowledgeBaseId"]
Es gibt kein storageConfiguration in dieser Anfrage. Bei einer selbst verwalteten Wissensbasis würde man eines übergeben, das Ihren Vektorspeicher beschreibt. Amazon Bedrock Managed Knowledge Base nimmt keines entgegen, was das deutlichste Signal in der API ist, dass Amazon Bedrock die Speicherschicht besitzt.
Hängen Sie den S3-Bucket als Datenquelle an und starten Sie anschließend einen Ingestion-Job. Die Ingestion erfolgt asynchron, daher fragen Sie den Status ab, bis der Job einen Endzustand erreicht, statt für ein festes Intervall zu schlafen und es zu hoffen.
import time

SUCCESS_STATES = frozenset({"COMPLETE"})
FAILURE_STATES = frozenset({"FAILED", "STOPPED"})

def wait_for_ingestion(kb_id, ds_id, job_id, timeout_s=1800):
    """Poll an ingestion job until it reaches a terminal state."""
    deadline = time.time() + timeout_s
    while time.time() < deadline:
        job = bedrock_agent.get_ingestion_job(
            knowledgeBaseId=kb_id,
            dataSourceId=ds_id,
            ingestionJobId=job_id,
        )["ingestionJob"]
        status = job["status"]
        if status in SUCCESS_STATES:
            return job
        if status in FAILURE_STATES:
            reasons = job.get("failureReasons") or ["no reason reported"]
            raise RuntimeError(f"Ingestion job {job_id} finished as {status}: " + "; ".join(reasons))
        time.sleep(15)
    raise TimeoutError(f"Ingestion job {job_id} did not finish in {timeout_s}s")
Die vollständige Datenquellen-Konfiguration und Fehlerbehandlung finden Sie im Sample-Repository.
Abfragen mit dem LangChain-Retriever
AmazonKnowledgeBasesRetriever wickelt die Retrieve-API ein und verhält sich wie jeder andere LangChain-Retriever. Übergeben Sie für Amazon Bedrock Managed Knowledge Bases managedSearchConfiguration. Das ist die Stelle, an der viele stolpern: vectorSearchConfiguration ist der frühere Pfad für Wissensbasen, bei denen Sie Ihren eigenen Vektorspeicher betreiben. Es ist das, was die meisten vorhandenen Beispiele zeigen.
from langchain_aws.retrievers import AmazonKnowledgeBasesRetriever

SIMPLE_QUERY = "What is the restore time objective for the checkout service?"

retriever = AmazonKnowledgeBasesRetriever(
    knowledge_base_id=KB_ID,
    region_name=REGION,
    retrieval_config={
        "managedSearchConfiguration": {
            "numberOfResults": 5,
        }
    },
)
docs = retriever.invoke(SIMPLE_QUERY)
Jedes Ergebnis kommt als LangChain Documentzurück. Der Relevanzwert steht in metadata["score"], und die eigenen Metadaten des Quelldokuments liegen unter metadata["source_metadata"], umbenannt, damit es nicht zu Kollisionen kommt. Wenn Sie Ergebnisse mit niedriger Konfidenz ausschließen möchten, setzen Sie min_score_confidence am Retriever, statt im Nachhinein zu filtern.
Für eine Frage mit einer klaren Absicht ist dies das richtige Werkzeug. Es ist ein einziger Aufruf. Die Latenz ist die niedrigste der beiden Optionen, und Sie behalten die volle Kontrolle darüber, wie die Antwort generiert wird. Die meisten Abfragen, die ein Produktionsassistent erhält, haben diese Form, und für sie eine Planungsschleife zu verwenden verschwendet Geld und Zeit.
Wo Single-Shot-Retrieval an seine Grenzen stößt
Stellen Sie nun demselben Retriever eine Frage mit mehreren Teilen:
COMPLEX_QUERY = (
    "Compare the checkout and inventory services across on-call escalation, backup and "
    "restore targets, and deployment rollback procedure. Where do they differ?"
)

docs = retriever.invoke(COMPLEX_QUERY)
Fünf Chunks kommen zurück, sortiert nach Hybrid-Score gegenüber einem Embedding der gesamten Frage.
Diese Frage enthält sechs Absichten: zwei Dienste über drei Dimensionen. Die Bewertung des abgerufenen Texts auf Belege für jede einzelne davon liefert ein konkretes Maß dafür, was ein einzelnes Embedding wiederfindet.
| numberOfResults | Chunks | Anteil am Korpus | Abgedeckte Sub-Intents | Fehlend |
| 5 | 5 | 10% | 4 von 6 | checkout on-call, inventory restore |
| 10 | 10 | 19% | 6 von 6 | keine |
Bei fünf Ergebnissen verfehlt ein Embedding, das für sechs Intents steht, zwei davon. Bei zehn werden alle sechs abgedeckt, mit sichtbarer Verschwendung: zwei Sub-Intents werden doppelt abgedeckt und ein Chunk enthält keinen.
Der Retriever hat seine Aufgabe erfüllt. Die Einschränkung ist strukturell: Ein einzelner Vektor kann sechs Intents nicht repräsentieren, und es gibt keinen Schritt im Prozess, der danach fragt, ob die zurückgegebenen Evidenzen ausreichen, um die Frage zu beantworten.
Agentic Retrieval ausführen
Agentic retrieval ist kein LangChain-Retriever, sondern ein Feature von Amazon Bedrock Managed Knowledge Bases. Das langchain-aws Paket stellt es als eigenständige Funktion bereit, agentic_retrieve, weil die zugrunde liegende API ihre Ergebnisse streamt und nicht zum synchronen BaseRetriever Interface passt. Es gibt kein Flag auf AmazonKnowledgeBasesRetriever , das die Funktion einschaltet.
from langchain_aws.retrievers.bedrock import agentic_retrieve

result = agentic_retrieve(
    knowledge_base_id=KB_ID,
    query=COMPLEX_QUERY,
    region_name=REGION,
    generate_response=True,
    number_of_results=10,
)
print(result["generatedResponse"]["answer"])
Mit generate_response=Truegibt der Service eine begründete Antwort und Zitate zusammen mit den abgerufenen Chunks zurück, sodass Sie eine Antwort erhalten, ohne einen separaten Modellaufruf verdrahten zu müssen. Die Funktion funktioniert nur mit einer Amazon Bedrock Managed Knowledge Base.
Intern plant der Service, ruft Daten ab, bewertet, ob die Evidenz ausreichend ist, und iteriert, falls nicht. Der Helper verbirgt all das und liefert die finalen Chunks zurück, was praktisch ist, aber bedeutet, dass Sie den Plan nicht sehen können.
Die Trace-Events lesen
Um zu beobachten, wie das Modell die Frage zerlegt, rufen Sie agentic_retrieve_stream auf dem bedrock-agent-runtime Client direkt auf. Dies ist die einzige Stelle in diesem Walkthrough, an der wir langchain-awsumschreiten, weil der Helper Trace-Events verwirft und weder maxAgentIteration noch ein benutzerdefiniertes Planner-Modell bereitstellt.
runtime = boto3.client("bedrock-agent-runtime", region_name=REGION)

response = runtime.agentic_retrieve_stream(
    messages=[{"role": "user", "content": {"text": COMPLEX_QUERY}}],
    retrievers=[{
        "configuration": {
            "knowledgeBase": {
                "knowledgeBaseId": KB_ID,
                "retrievalOverrides": {"maxNumberOfResults": 10},
            }
        }
    }],
    agenticRetrieveConfiguration={
        "foundationModelType": "MANAGED",
        "rerankingModelType": "MANAGED",
        # 5 is the API default. Below 4 the planner stops decomposing entirely.
        "maxAgentIteration": 5,
    },
    generateResponse=False,
)

for event in response["stream"]:
    if "traceEvent" in event:
        attrs = event["traceEvent"]["attributes"]
        print(f"{attrs.get('step')}: {attrs.get('status')}")
        for action in attrs.get("actions", []) or []:
            if "retrieve" in action:
                query = action["retrieve"].get("inputQuery", {}).get("text", "")
                print(f" sub-query: {query}")
    elif "result" in event:
        for chunk in event["result"].get("results", []):
            print(chunk.get("content", {}).get("text", "")[:120])
Setzen Sie generateResponse auf False , wenn Sie nur das Retrieval-Verhalten möchten. Die API erzeugt standardmäßig eine begründete Antwort, was einen zusätzlichen Modellaufruf kostet, den Sie beim Inspizieren des Plans möglicherweise nicht benötigen.
Das step eines Trace-Events verrät Ihnen, wo sich der Planner befindet. SpeculativeRetrieval läuft vor dem ersten Plan, um Latenz zu reduzieren, und zählt nicht gegen Ihr Iterationsbudget. Planning ist der Punkt, an dem das Modell die Frage und vorherige Ergebnisse liest und Teilabfragen ausgibt. Retrieval wird einmal pro Teilabfrage ausgelöst. FullDocumentExpansion erscheint, wenn das Modell entscheidet, dass ein Abschnitt nicht den Kontext zur Beantwortung liefert, und stattdessen das gesamte Dokument zieht. Jedes trägt einen Status von IN_PROGRESS, SUCCEEDED, oder FAILED, plus eine menschenlesbare Nachricht.
Die finalen Chunks kommen separat an. Das result ist ein eigener Event-Typ und kein fünfter Schritt, und es enthält die deduplizierten Chunks aus jeder Iteration zusammen mit der begründeten Antwort, wenn die Antwortgenerierung aktiviert ist. Verzweigen Sie auf dem Event-Key, wie die vorstehende Schleife zeigt, statt einen terminalen Schritt-Wert zu erwarten.
Der Sub-Query-Text ist der Teil, der die Protokollierung wert ist. Er steht in attributes.actions[].retrieve.inputQuery.text, nicht in den Trace-Feldern der obersten Ebene, sodass ein Handler, der nur step liest, status zeigt Ihnen, dass eine Planung stattgefunden hat, aber nicht, was sie entschieden hat.
Das folgende Diagramm zeigt die agentischen Retrieval-Planning-Loop, einschließlich der Schritte für spekulative Retrieval, Planung, Sub-Query-Retrieval, Bewertung und optionales Re-Planning.
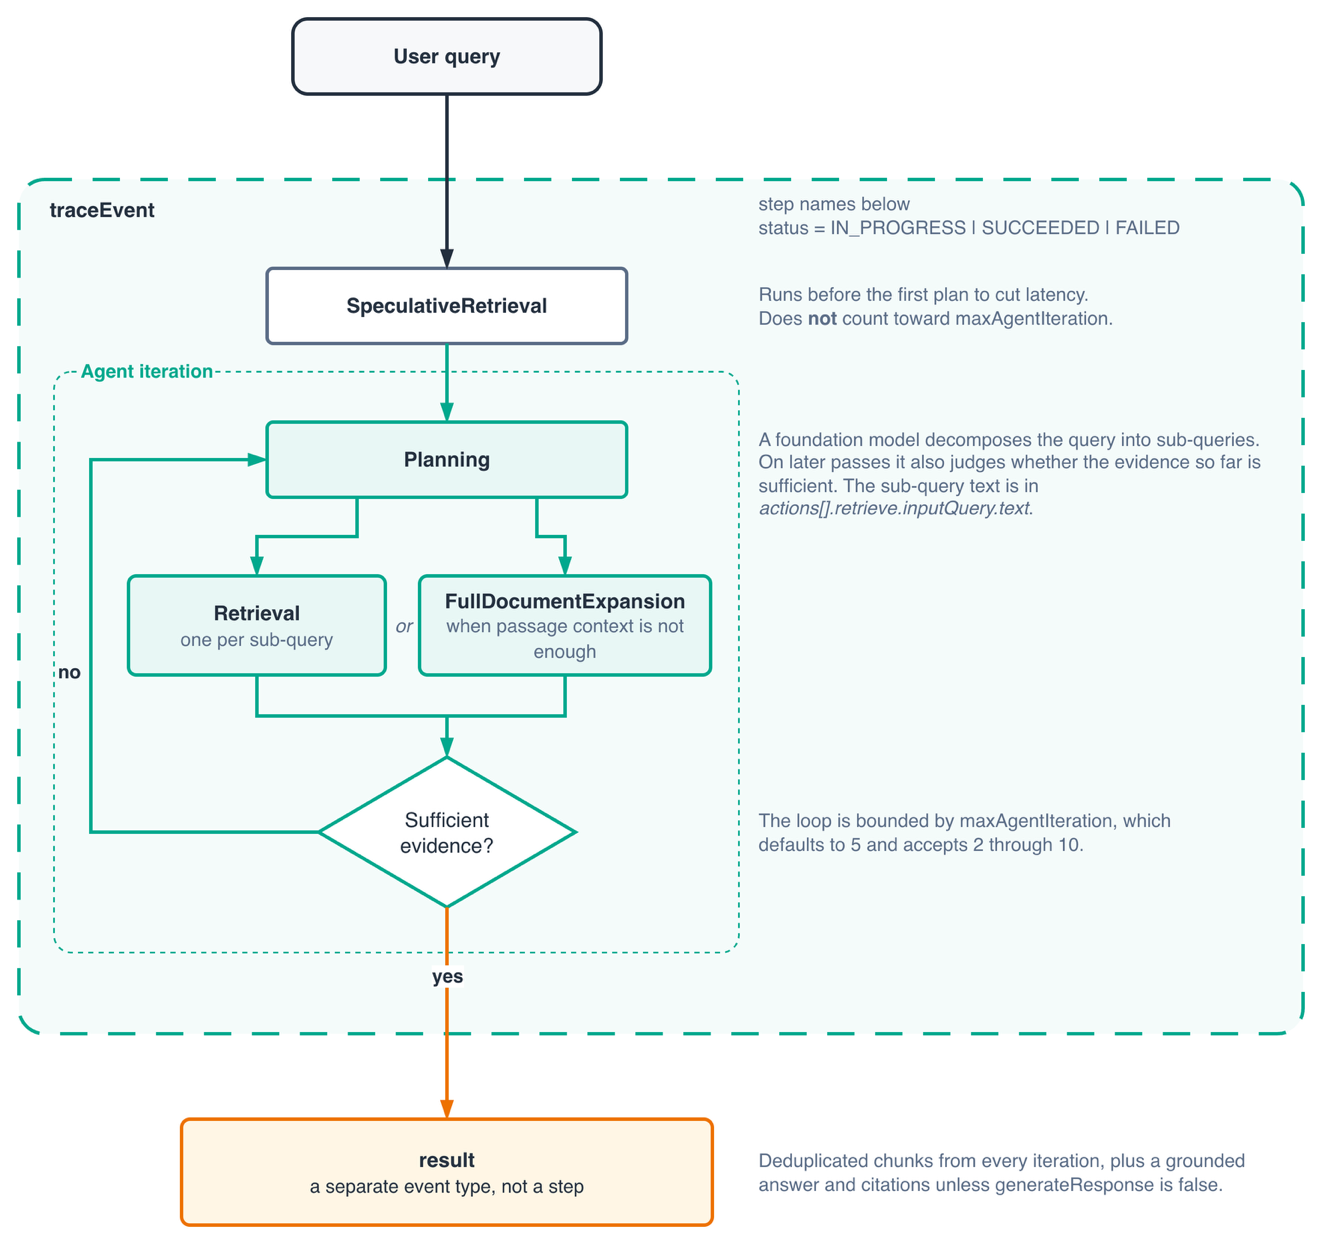
Abbildung 2: Schritte im agentischen Retrieval-Planning-Loop
Zwei Details sollte man kennen, bevor man darauf aufbaut. Die Deduplizierung gilt nur für das result -Ereignis, sodass ein Chunk, der von drei Sub-Queries abgerufen wurde, am Ende einmal, aber in den Traces dreimal erscheint.
Das zweite betrifft die Scores. Eine Retrieve-Antwort gibt jedem Chunk ein typisiertes score -Feld, das seine Relevanz für die Query enthält. Ergebnisse des agentischen Retrieval tragen content, metadataund sourceRetriever, ohne ein entsprechendes typisiertes Feld. Code, der result["score"] nach dem Wechsel der APIs liest, erhält nichts. Wenn Sie nach Relevanz ranken oder filtern, planen Sie diesen Unterschied ein.
In der Produktion verwenden Sie Amazon Bedrock Guardrails, um Inhaltsrichtlinien und Grounding-Prüfungen für generierte Antworten durchzusetzen. Beide Retrieval-Pfade unterstützen Guardrails. Agentisches Retrieval unterstützt Guardrails über policyConfiguration.bedrockGuardrailConfiguration statt über das guardrail_config -Argument, das der LangChain-Retriever entgegennimmt, und unterstützt nur den BLOCK -Modus. Wenn Sie auf den MASK -Modus angewiesen sind, ist das ein Grund, bei der Retrieve API zu bleiben.
maxAgentIteration akzeptiert Werte von zwei bis zehn und hat den Standardwert fünf. Lassen Sie ihn auf dem Standardwert. Bei zwei oder drei führt der Planner einen Zyklus aus, erzeugt keine Sub-Queries und gibt das zurück, was der Schritt der spekulativen Retrieval bereits gefunden hat. Das ist Einzeldurchlauf-Verhalten zum agentischen Preis. Die Dekomposition beginnt bei vier. Der Planner stoppt oft früh, wenn er die Evidenz für ausreichend hält, daher ist die Obergrenze eine Schranke und kein Ziel.
Vergleich der beiden Retrieval-Pfade
Zur Einordnung, wie sich dies bei großen Mengen verhält, hat AWS agentisches Retrieval auf MuSiQue evaluiert, einem öffentlichen Multi-Hop-Benchmark. Die Evaluation zeigte einen verbesserten Recall gegenüber dem Einzeldurchlauf-Retrieval, mit den größten Zuwächsen bei den schwersten Fragen. Single-Hop-Fragen verzeichneten Zuwächse von unter fünf Punkten. Diese letzte Zahl entspricht der Form des Trade-offs: Dekomposition hilft, wenn es etwas zu dekomponieren gibt.
Aufbau der RAG-Kette
Für den Standard-Retriever funktioniert die übliche LangChain Expression Language (LCEL) -Komposition direkt:
from langchain_aws import ChatBedrockConverse
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnablePassthrough

def format_docs(docs):
    return "\n\n".join(doc.page_content for doc in docs)

llm = ChatBedrockConverse(model=MODEL_ID, region_name=REGION)
prompt = ChatPromptTemplate.from_template(PROMPT_TEMPLATE)

chain = (
    {"context": retriever | format_docs, "question": RunnablePassthrough()}
    | prompt
    | llm
    | StrOutputParser()
)
format_docs wichtiger, als es aussieht. Das direkte Übergeben Document von Objekten in einen Prompt macht deren reprund das Modell erhält Metadaten-Rauschen, das in den Kontext gemischt wird.
Um das agentische Retrieval in dieselbe Position zu bringen, wickeln Sie es in einen RunnableLambda, da es eine Funktion und kein Retriever ist:
from langchain_core.runnables import RunnableLambda

def agentic_context(question: str) -> str:
    result = agentic_retrieve(
        knowledge_base_id=KB_ID,
        query=question,
        region_name=REGION,
        number_of_results=10,
    )
    return "\n\n".join(
        item.get("content", {}).get("text", "")
        for item in result.get("results", [])
    )

agentic_chain = (
    {"context": RunnableLambda(agentic_context), "question": RunnablePassthrough()}
    | prompt
    | llm
    | StrOutputParser()
)
Beachten Sie, dass generate_response hier deaktiviert ist. Der Dienst kann die Antwort selbst generieren, aber innerhalb einer Chain möchten Sie normalerweise Ihren eigenen Prompt und Ihr eigenes Modell verwenden, daher nehmen Sie die Chunks und generieren nachgelagert. Verwenden Sie die Dienstgenerierung, wenn Sie einen einzigen Aufruf und weniger Code wollen, und die umschlossene Version, wenn Sie die Kontrolle über den Prompt haben.
Wahl zwischen Standard-Retrieval und agentischem Retrieval
Verwenden Sie Retrieve für kurze, klar abgegrenzte Fragen. Es ist günstiger, schneller, funktioniert mit selbst verwalteten Wissensbasen und liefert Scores in den Ergebnissen. Der Großteil des Produktionsverkehrs sieht so aus.
Verwenden Sie AgenticRetrieveStream, wenn Fragen mehrteilig, vergleichend oder explorativ sind oder wenn die Belege sich über mehr als eine Wissensbasis erstrecken. Es registriert bis zu fünf Wissensbasen in einer einzigen Anfrage und leitet Sub-Queries anhand einer Beschreibung in natürlicher Sprache weiter, die Sie jeder Wissensbasis zuordnen. Die andere API kann dies überhaupt nicht. Es kostet mehr pro Aufruf, macht mehrere Modellaufrufe und hat von beiden die höhere Latenz.
Routing anhand der Query-Form statt eine einzige Option für alles zu wählen ist das Muster, das wir empfehlen. Ein Klassifikator oder eine Heuristik für die Frage kann den Großteil des Verkehrs auf den günstigen Pfad leiten und den Planner für Fragen reservieren, die ihn benötigen.
Ressourcen bereinigen
Löschen Sie die Wissensbasis, ihre Datenquelle, die S3-Objekte und den Bucket sowie die IAM-Rolle, die Sie erstellt haben. Eine Wissensbasis mit Dokumenten verursacht weiterhin Speicherkosten.
bedrock_agent.delete_data_source(knowledgeBaseId=KB_ID, dataSourceId=DS_ID)
bedrock_agent.delete_knowledge_base(knowledgeBaseId=KB_ID)
Das Repository enthält ein Cleanup-Skript, das auch den Bucket leert und die Rolle entfernt.
Fazit
Wir haben gezeigt, wie man eine RAG-Anwendung auf Amazon Bedrock Knowledge Bases mit LangChain baut und wie agentisches Retrieval mehrteilige Fragen behandelt, die Single-Shot-Retrieval schlecht beantwortet. Wir haben auch die Reibung in der aktuellen Integration gezeigt. Agentisches Retrieval ist eine Funktion und kein LangChain-Retriever, daher benötigt es einen RunnableLambda , um in einer Chain zu sitzen. Die Trace-Ereignisse, die den Query-Plan zeigen, erfordern einen direkten boto3 -Aufruf.
Agentisches Retrieval tauscht höhere Kosten pro Aufruf gegen ein verbessertes Recall bei Multi-Hop-Fragen ein und nutzt ein integriertes Modell für das Query-Planning. Der nächste sinnvolle Schritt ist, Ihre eigene Query-Verteilung zu messen, bevor Sie alles durch einen Planner leiten.
Um loszulegen, sehen Sie sich die Dokumentation zu Amazon Bedrock Knowledge Bases und den zugehörigen Beispielcode an. Wenden Sie sich für Hilfe bei der Anwendung auf Ihre eigene Workload an Ihr AWS-Account-Team.