
Wir wechseln schnell in eine Computing-Welt, die von hochgeneralisierten, zunehmend autonomen Agenten definiert ist. Getrieben durch große Sprachmodelle (LLMs), die dynamisch Pläne erstellen und externe Tools aktivieren können, bieten diese Systeme die Möglichkeit, dass KI unsichtbar komplexe, mehrstufige Aufgaben übernehmen kann. Doch die Realisierung dieses Potenzials erfordert die Lösung eines wichtigen Problems: Die Fähigkeit der Agenten zu ermöglichen, gleichzeitig sicherzustellen, dass sie richtig handeln.
Heute teilen wir einen umfassenden neuen Workshopbericht mit dem Titel "Open and Emergent Problems in Agentic Privacy and Security: A Contextual Angle“, das das Ergebnis einer kooperativen Anstrengung ist, an der mehr als 50 akademische und industrielle Führungskräfte aus zahlreichen Institutionen beteiligt waren. Wir trafen uns beim Google Contextual Agent Privacy and Security (CAPS) Workshop, der Ende 2025 in New York City stattfand. In diesem Bericht finden Sie eine Übersicht über die grundlegenden Privatsphäre- und Sicherheitsherausforderungen, denen autonome Agenten heute ausgesetzt sind, die koordinierte Verteidigungsmaßnahmen auf Ebene des Systems, des Modells, des Benutzers und des Ökosystems erfordern.
Agentische Abwägungen
Die Kernaufgabe der agentischen KI besteht darin, dass ein Agent, um nützlich zu sein, Zugang zu persönlichen Daten und die Fähigkeit haben muss, im breiten Spektrum von Kontexten konsequente Handlungen auszuführen. Allerdings erfordern dieser Zugang und die Verhaltensflexibilität der Agenten methodische Ansätze, die sich deutlich von denen in traditionellen Softwaresystemen unterscheiden. Im Gegensatz zu traditionellen deterministischen Softwaresystemen unterscheiden sich Agenten in drei wichtigen Aspekten, die es der Forschungsgemeinschaft erfordern, gemeinsam anzugehen:
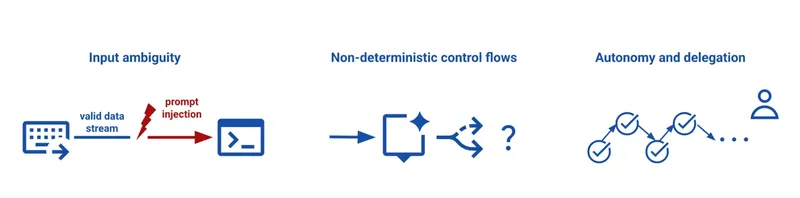
- Unstrukturierte Interferenzen und Unklarheit bei der Eingabe: Agenten verarbeiten Anweisungen in Form von natürlicher Sprache und Bildern, was es schwierig macht, das „erwartete Verhalten“ zu definieren oder gegen Konfrontationsmanipulationen wie Prompt-Injektion zu schützen.
- Probabilistische Kontrollflüsse: Generatives Planen führt zu probabilistischen Ausführungswegen, die traditionelle Testmethoden nicht leicht sicherstellen können.
- Autonomie und Delegation: Wenn Agenten längere Aufgaben bearbeiten und Unteraufgaben an andere Agenten delegieren, wird die traditionelle Überwachung durch den Benutzer weniger effektiv und möglicherweise unzureichend, was das Risiko von „Bestätigungsmüdigkeit“ darstellt.
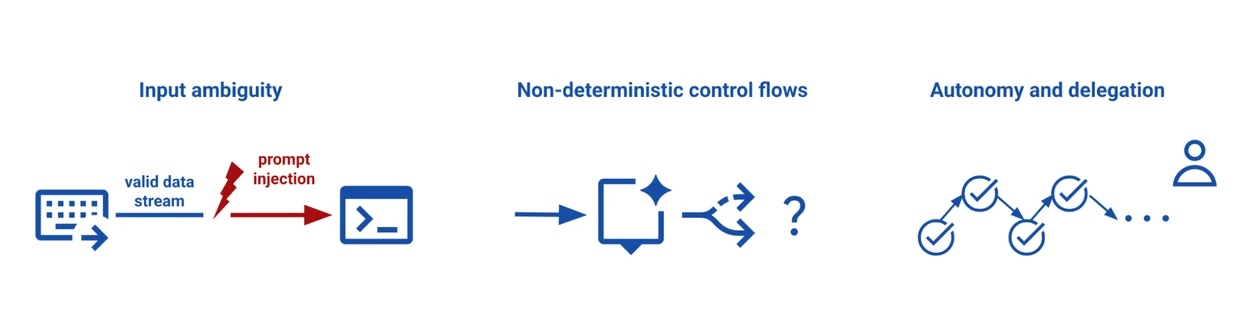
Herausforderungen im Bereich der Privatsphäre und Sicherheit bei agentischer KI.
Die Kontextbrille
Da nützliche Agenten möglicherweise Daten teilen und Aufgaben erledigen müssen, glauben wir, dass die Zukunft vertrauenswürdiger Agenten von ihrer Fähigkeit abhängt, über die sozialen Normen und die Angemessenheit ihrer Handlungen nachzudenken, sie zu verstehen und durch diese Einschränkungen gebunden zu sein – für den bestimmten Kontext, in dem sie agieren.
Aber wie lehren wir einen Agenten, „Kontext“ und Angemessenheit zu verstehen? Unser Bericht basiert auf der Theorie von Kontextuale Integrität (CI), die Privatsphäre nicht nur als Geheimhaltung oder Kontrolle, sondern als „angemessenen Informationsfluss“ nach etablierten und gerechtfertigten sozialen Normen definiert. Eine kontextspezifische Informationsnorm wird durch ihre Akteure (wer sendet und welche Personen empfangen die Informationen), die Arten von Informationen (bestimmte Kategorien von Informationen, wie medizinische oder finanzielle Aufzeichnungen) und die Übertragungsprinzipien (die Regeln, die den Fluss bestimmen, wie Vertraulichkeit oder Gegenseitigkeit) definiert. Zum Beispiel wäre es möglich, seine Geschenkliste mit einem virtuellen Einkaufsassistenten zu teilen, aber nicht mit Familie und Freunden. Unser Bericht erweitert und generalisiert kontextuale Integrität für Informationsaustausch auf kontextuale Sicherheit, also die Angemessenheit von Agentenhandlungen. Durch die Verankerung von Privatsphäre und Sicherheit von Agenten in CI untersuchen wir, wie wir Systeme entwerfen können, die bewerten, ob eine Handlung sozial und kontextual angemessen ist, bevor sie ausgeführt wird.
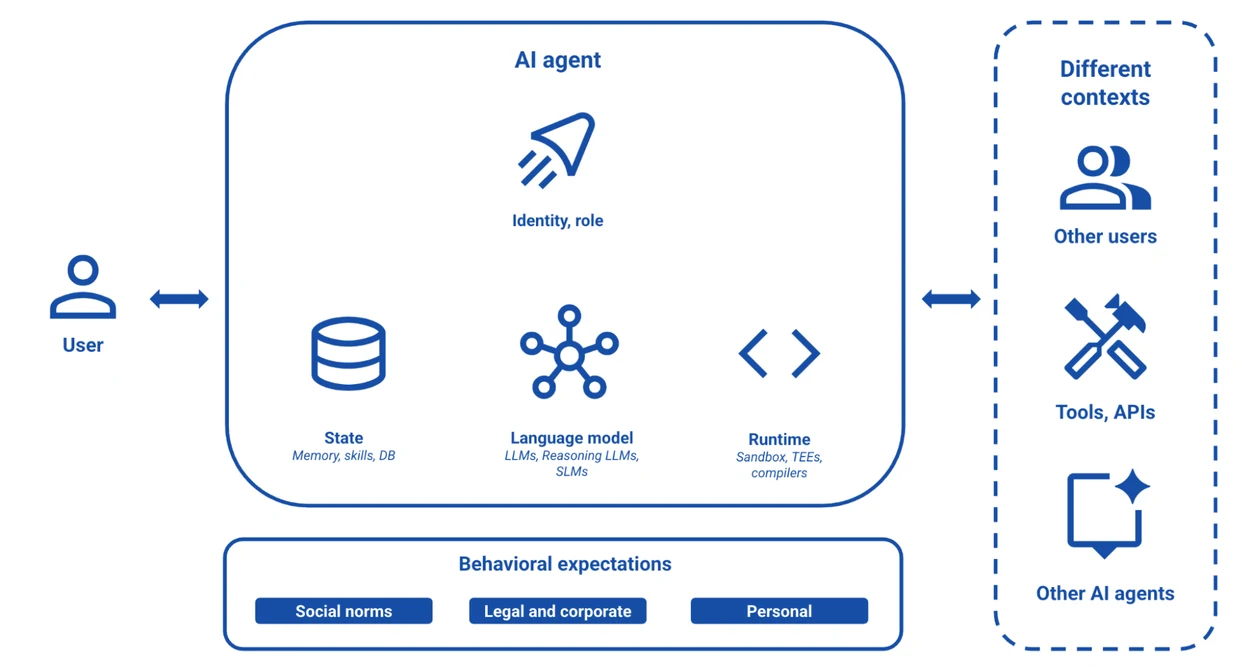
Modell eines allgemeinen KI-Agenten, der mit anderen Benutzern, Werkzeugen und Agenten in verschiedenen Kontexten interagiert.
Operative Umsetzung der Kontextintegrität
Zum ersten Mal seit der Entwicklung der Theorie der Kontextualen Integrität bieten LLMs die Möglichkeit, politische Richtlinien zu erstellen, die wirklich von dem Kontext abhängig sind. Historisch gab es eine semantische Lücke zwischen den hohen Kontextnormen und den niedrigen Systemberechtigungen. Zum Beispiel erfordert „Meine Daten schützen, während ich meine Reise für eine Konferenz organisiere“ spezifische Anweisungen dazu, welche Benutzerinformationen angemessen sind, um Flüge zu buchen, Visaverfahren zu beantragen und mit den Organisatoren zu kommunizieren.
Traditionelle Methoden wie manuelle Berechtigungen oder von Experten verfasste Richtlinien können nicht auf eine Zukunft reagieren, in der AI-Agenten selbstständig mehrere komplexe, langfristige Aufgaben ausführen. Da Sprachmodellen nun CI verstehen, argumentieren wir, dass diese Lücke überbrückt werden kann. Unser Bericht befürwortet die Kombination von Modell- und Benutzerinteraktionen mit einem kontextuellen Policy-Engine, das Teil einer Überwachungsschicht ist, um die Angemessenheit der Handlungen zu überwachen und zu verhindern. Dieses Policy-Engine enthält einen dynamischen Policy-Generierungszyklus, der in Echtzeit funktioniert (wie unten dargestellt), um Policies an die Benutzeranforderung sowie an offene, dynamische Kontexte anzupassen – einschließlich neu entdeckter Tools und Fähigkeiten während des Betriebs. Dadurch kann das System bewerten, ob der gewünschte Datenfluss angemessen ist, bevor irgendeine Information den Arbeitsbereich des Benutzers verlässt.
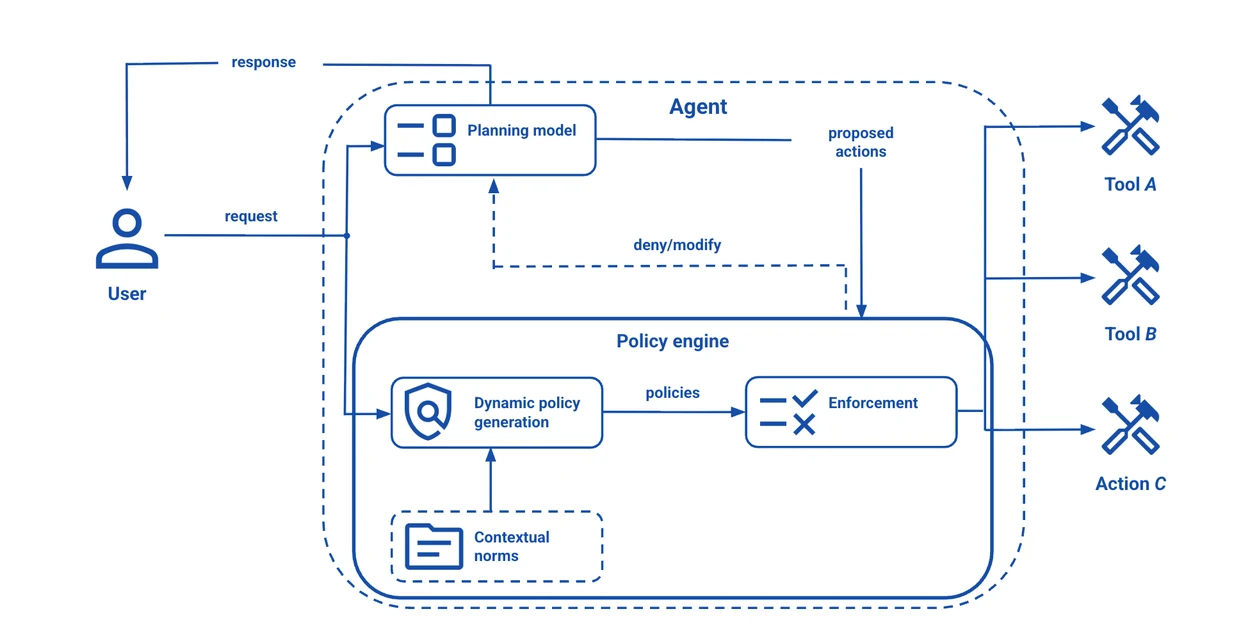
Ein exemplarisches Beispiel dafür, wie eine Kontextpolitische Engine-Architektur in einem agentischen System implementiert werden könnte.
Mehrlayerige Herangehensweise an agentische Privatsphäre und Sicherheit
Im Zuge der Entwicklung von Kontextpolitischen Enginen sowie der notwendigen Fortschritte auf Modell- und Benutzerebene wird ein mehrschichtiges Ansatz verfolgt. Unser Bericht beschreibt die Möglichkeiten für Innovationen im gesamten Bereich.
- Systemseitiges Sandboxing: Das Ausführungsumfeld kann zusätzliche Sicherheitsmaßnahmen einführen, um den Einfluss von Fehlern des Agenten oder Modells zu begrenzen und die Erkennung sowie die Reaktion zu erleichtern. Traditionelle Betriebssysteme verwenden Sandbox-Anwendungen, indem sie den Zugriff statisch beschränken – beispielsweise auf Dateien oder Netzwerke. Für Agenten untersuchen wir dynamische Beschränkungen der Agentfähigkeiten, die Festlegung der Identität des Agenten sowie die Genehmigung oder Verweigerung von Zugriff auf Daten basierend auf Veränderungen im Kontext.
- Modellebene-Logik: Ein Agent, der komplexe Aufgaben ausführt, muss die Angemessenheit seiner Handlungen beurteilen, wie zum Beispiel das Teilen von Benutzerdaten. Zukünftige Forschungen sollten es den Modellen ermöglichen, unklare Benutzeranweisungen zu vermeiden und unter wechselnden Kontextnormen über die Angemessenheit nachzudenken.
- Benutzerzentrierte Steuerungen: Das traditionelle „Warnung und Wahl“-Modell geht davon aus, dass Personen fein abgestimmte Entscheidungen über Handlungen, die persönliche Daten betreffen, treffen können, und stützt sich auf die Annahme der Vorhersehbarkeit. Das Verhalten autonomer Agenten ist jedoch von Natur aus probabilistisch, hochvolumig und generativ. Wir untersuchen den Übergang zu interaktiven, kontextuellen und personalisierten Steuermechanismen, die mit den mentalen Modellen der Benutzer übereinstimmen.
- Interaktionen zwischen Multi-Agenten: Damit AI-Agenten sicher zusammenarbeiten können bei komplexen Aufgaben, müssen wir effektive Sicherheitsmaßnahmen entwickeln, um verhindern, dass die Agenten zusammenarbeiten und die Kontextnormen verletzen.
- Ecosystem Governance: Wir untersuchen die Herausforderungen in den Governance-Mechanismen, um eine Reihe kontextueller Normen zu entwickeln, die von allen Akteuren gesammelt und geteilt werden. Darüber hinaus können die Normen in verschiedenen Bereichen und Entitäten unterschiedlich sein; daher benötigen wir Mechanismen, die es uns ermöglichen, Konflikte zu lösen, Normveränderungen zu verhandeln und die Einhaltung zu überprüfen.
dynamische Messung von Privatsphäre und Sicherheit
Schließlich schlagen wir die Entwicklung neuer Ansätze für Sicherheitsbewertungen vor, die direkt auf hochautonome, multiagenten Systeme angewandt werden können. Unser Bericht betont die Notwendigkeit von standardisierten, multiagenten Benchmarks – dynamischen „Agent Gym“-Umgebungen, in denen Forscher über längere Zeiträume sicher komplexe, kaskadierende Interaktionen simulieren können. Mit diesen Open-Source-Sandboxes können wir eine robuste, gemeinsame Grundlage für Privatsphäre, Sicherheit und Sicherheit in der Wissenschaft und Industrie schaffen.
Ein Aufruf zur Handlung
Dies ist ein ehrgeiziges Projekt, aber ein sicherer, sicher und vertrauenswürdiger agentischer Ökosystem ist eine zu große Aufgabe für jede einzelne Disziplin, Organisation oder Branche. Der Bericht fordert neue Ideen und beispiellose Kooperationen und stellt grundlegende Möglichkeiten dar; es ist eine Aufforderung an die breitere Forschungsgemeinschaft aus Wissenschaft, Regierung, Zivilgesellschaft und Industrie, die notwendigen Grundlagen für einen sicheren, sichern und Datenschutz respektierenden Ökosystem zu entwickeln. Wir laden Sie ein, den technischen Bericht zu lesen.
Danksagungen
Wir möchten Lillian Tsai dafür danken, dass sie als Mitautorin fungiert hat, und Sarah de Haas dafür, dass sie die Workshop-aktivitäten, den Berichtsschreibprozess und den Blogbeitrag koordiniert hat. Kassem Fawaz, Stefan Mellem, Helen Nissenbaum und Nina Taft haben zur Konzeption sowie zum Schreiben der verschiedenen Abschnitte beigetragen und den Schreibprozess unterstützt. Sebastian Benthall, Madiha Zahrah Choksi, Seliem El-Sayed, Ferdinando Fioretto, Adrià Gascón, Ashish Hooda, Ivan Petrov, Francesco Pinto, Octavian Suciu, Trishita Tiwari, Harold Triedman, Ren Yi und Wen Zhang haben als Abschnittleiter fungiert. Wir sind dankbar für die Beiträge der über 50 Forscher, akademischen Partnern und Industriellen, die den Bericht gemeinsam verfassten oder an den Workshopdiskussionen teilnahmen. Diese Arbeit wurde von Daniel Ramage, Corinna Cortes, Yossi Matias, Pushmeet Kohli, Hank Levy, Raluca Ada Popa, Amanda Walker, Brendan McMahan und James Manyika unterstützt.