
Kodierung und agentische Arbeitslasten verlangen von AI-Modellen mehr als je zuvor: Reformieren Sie ein Repository, das Hunderte von Dateien umfasst, unterhalten einen mehrmalige Stunden dauernden agentischen Workflow ohne Kontextverlust und denken Sie über komplexe Systemprobleme nach, indem Sie bei jedem Schritt Werkzeuge verwenden. Um diese Anforderungen mit offenen Modellen zu erfüllen, bedeutet es historisch gesehen, die eigene Inferenz-Infrastruktur bereitzustellen und zu betreiben.
GLM 5.3 von Z.ai (Zhipu AI) ist jetzt verfügbar auf Amazon Bedrock. GLM 5.3, wie es auf dem Hugging Face Hub veröffentlicht wurde, ist ein 753B-Parametern-Mix-of-Experts-Modell, das für Kompilieren und langfristige agentische Aufgaben optimiert ist. Insbesondere hat Z.ai berichtet, dass das Modell bemerkenswerte Cyber-Sicherheitsfähigkeiten aufweist. Auf Amazon Bedrock kann man es jetzt über vollständig verwaltete APIs mit Interregionaleinführung, Prompt-Caching und Service-Tiers nutzen. Man muss keine Infrastruktur verwalten. Der Zugang zu GLM 5.3 auf Bedrock ist für geeignete Unternehmenskunden verfügbar.
In diesem Beitrag zeigen wir Ihnen, wie Sie GLM 5.3 auf Amazon Bedrock mit den OpenAI-kompatiblen APIs verwenden und durch Prompt-Caching Kosten sowie Latenzzeiten reduzieren können. Anschließend setzen wir das Modell in einen realistischen agentischen Workflow ein: Wir führen eine autorisierte Sicherheitsprüfung Ihres eigenen Applications mit Strix, einem open-source AI-Penetrationstesting-Agenten, durch.
Was ist neu im Vergleich zu GLM 5
GLM 5 kam Anfang dieses Jahres auf Amazon Bedrock. GLM 5.3 basiert auf derselben Linie und bietet eine Reihe wichtiger Verbesserungen:
- Stärkere Programmierung: Z.ai behauptet, dass sie in einer Reihe von Programmierbenchmarken, einschließlich DeepSWE, Terminal Bench 3.0 und FrontierSWE, einen konkurrenzfähigen Leistungseffekt erzielt. Sie berichten auch über eine 50%-Verbesserung gegenüber GLM 5.2 in ihrem eigenen internen Benchmark. Direkte Vergleiche mit GLM 5 wurden nicht gemeldet, da die Stärke der Verbesserungen dazu führten, dass die Benchmark-Tests selbst aktualisiert werden mussten, seit dem Ankündigung von GLM 5.1.
- Entstehende Cybersicherheitsfähigkeiten: Die gemeldeten Benchmarkleistungen in Bezug auf Sicherheitsaufgaben sind herausragend, was das Modell zu einer natürlichen Lösung für defensive Sicherheitsprozesse macht. Zum Beispiel messte Z.ai bei der Veröffentlichung einen führenden Wert von 84,5 im CyberGym-Benchmark.
- Weitere Integration mit Amazon Bedrock: Cross-Region-Inferenzprofilien, impliziter und expliziter Prompt-Caching sowie verbesserte Feature-Ergebnisse für die OpenAI-kompatiblen Responses- und Chat Completions-APIs neben Invoke und Converse.
Wichtige Funktionen
- Frontier-Programmierung und agentische Leistung. GLM 5.3 ist für komplexe Systemingenieurarbeit und langfristige agentische Aufgaben konzipiert. Dazu gehören mehrstufiges Denken, workflow-gestützte Prozesse mit Hilfe von Werkzeugen sowie eine nachhaltige Kontextverwaltung über große Codebasen.
- Flexibles Zugriff auf die API. Sie können GLM 5.3 über die mit OpenAI kompatiblen Responses- und Chat Completions-APIs oder über die Amazon Bedrock Invoke- und Converse-APIs aufrufen.
- Prompt-Caching. GLM 5.3 unterstützt standardmäßig die implizite (automatische) Prompt-Caching, sowie explizite Cache-Kontrollen (empfohlen) für die Responses- und Chat-Completions-APIs. Für agentische Arbeitslasten, bei denen große System-Prompts oder Repository-Kontexte jede Runde erneut gesendet werden, reduziert die Caching reduziert sowohl die Latenz als auch die Eingabekosten.
- Kontinentale Inferenz. GLM 5.3 ist über Profile für kontinentale Inferenz in den USA (
us.zai.glm-5.3) und globale kontinentale Inferenz (global.zai.glm-5.3) verfügbar. Sie senden Anfragen an die von Ihnen gewählte „Quellen“-AWS-Region und Amazon Bedrock leitet jede Anfrage sicher weiter, um sie zu verarbeiten. Für weitere Details siehe Amazon Bedrock User Guide. - Diensttiern. Wählen Sie Flex, um die Kosten für Workloads mit geringer Zeitdringlichkeit zu optimieren, Priority, um Anfragen mit hoher Latenzkritikalität zu priorisieren – gegen eine höhere Preisstruktur – oder Standard, um einen normalen Ausgleich zwischen Preis und Geschwindigkeit zu erreichen.
Voraussetzungen
Für die folgenden Anwendungsbeispiele benötigen Sie:
- Ein AWS-Konto mit Zugang zu Amazon Bedrock.
- AWS Identity and Access Management (IAM) Rechte, um das Basismodell und das Ziel-Inference-Profil aufzurufen:
bedrock:InvokeModel,bedrock:InvokeModelWithResponseStreamundbedrock:CallWithBearerToken. - (Für die auf Code basierten Demos) Python 3.10 oder neuer.
- (Für die optionalen Sicherheitstest-Demo nur) Installieren Sie Docker und Strix mit dem Bedrock-Extra.
Versuchen Sie GLM 5.3 auf der Amazon Bedrock-Konsole
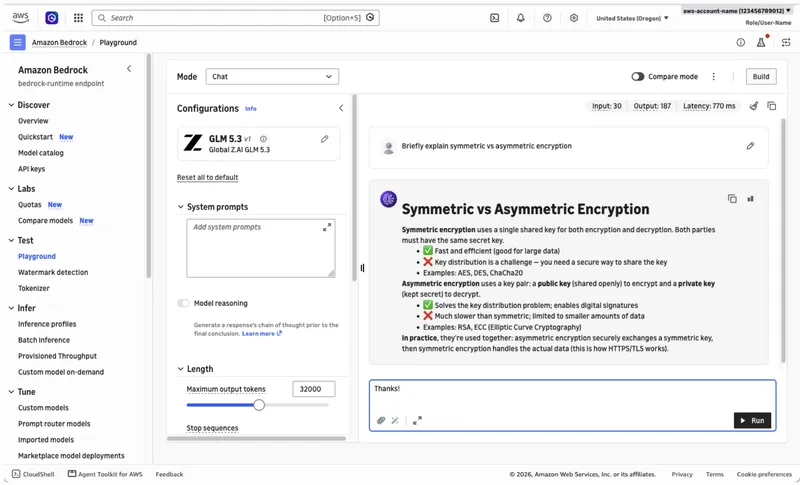
Sie können mit der Sendung von Anweisungen an GLM 5.3 im AWS Management Console beginnen, ohne Code schreiben oder Entwicklungswerkzeuge installieren zu müssen. Um zu starten, gehen Sie zu Amazon Bedrock und wählen anschließend aus dem linken Sidebar-Menü Test > Playground.
Von dieser Spielerlebnis-Oberfläche können Sie aus der Modellliste GLM 5.3 auswählen und Ihre ersten Anfragen über die Chat-Oberfläche senden, wie im folgenden Screenshot dargestellt ist:
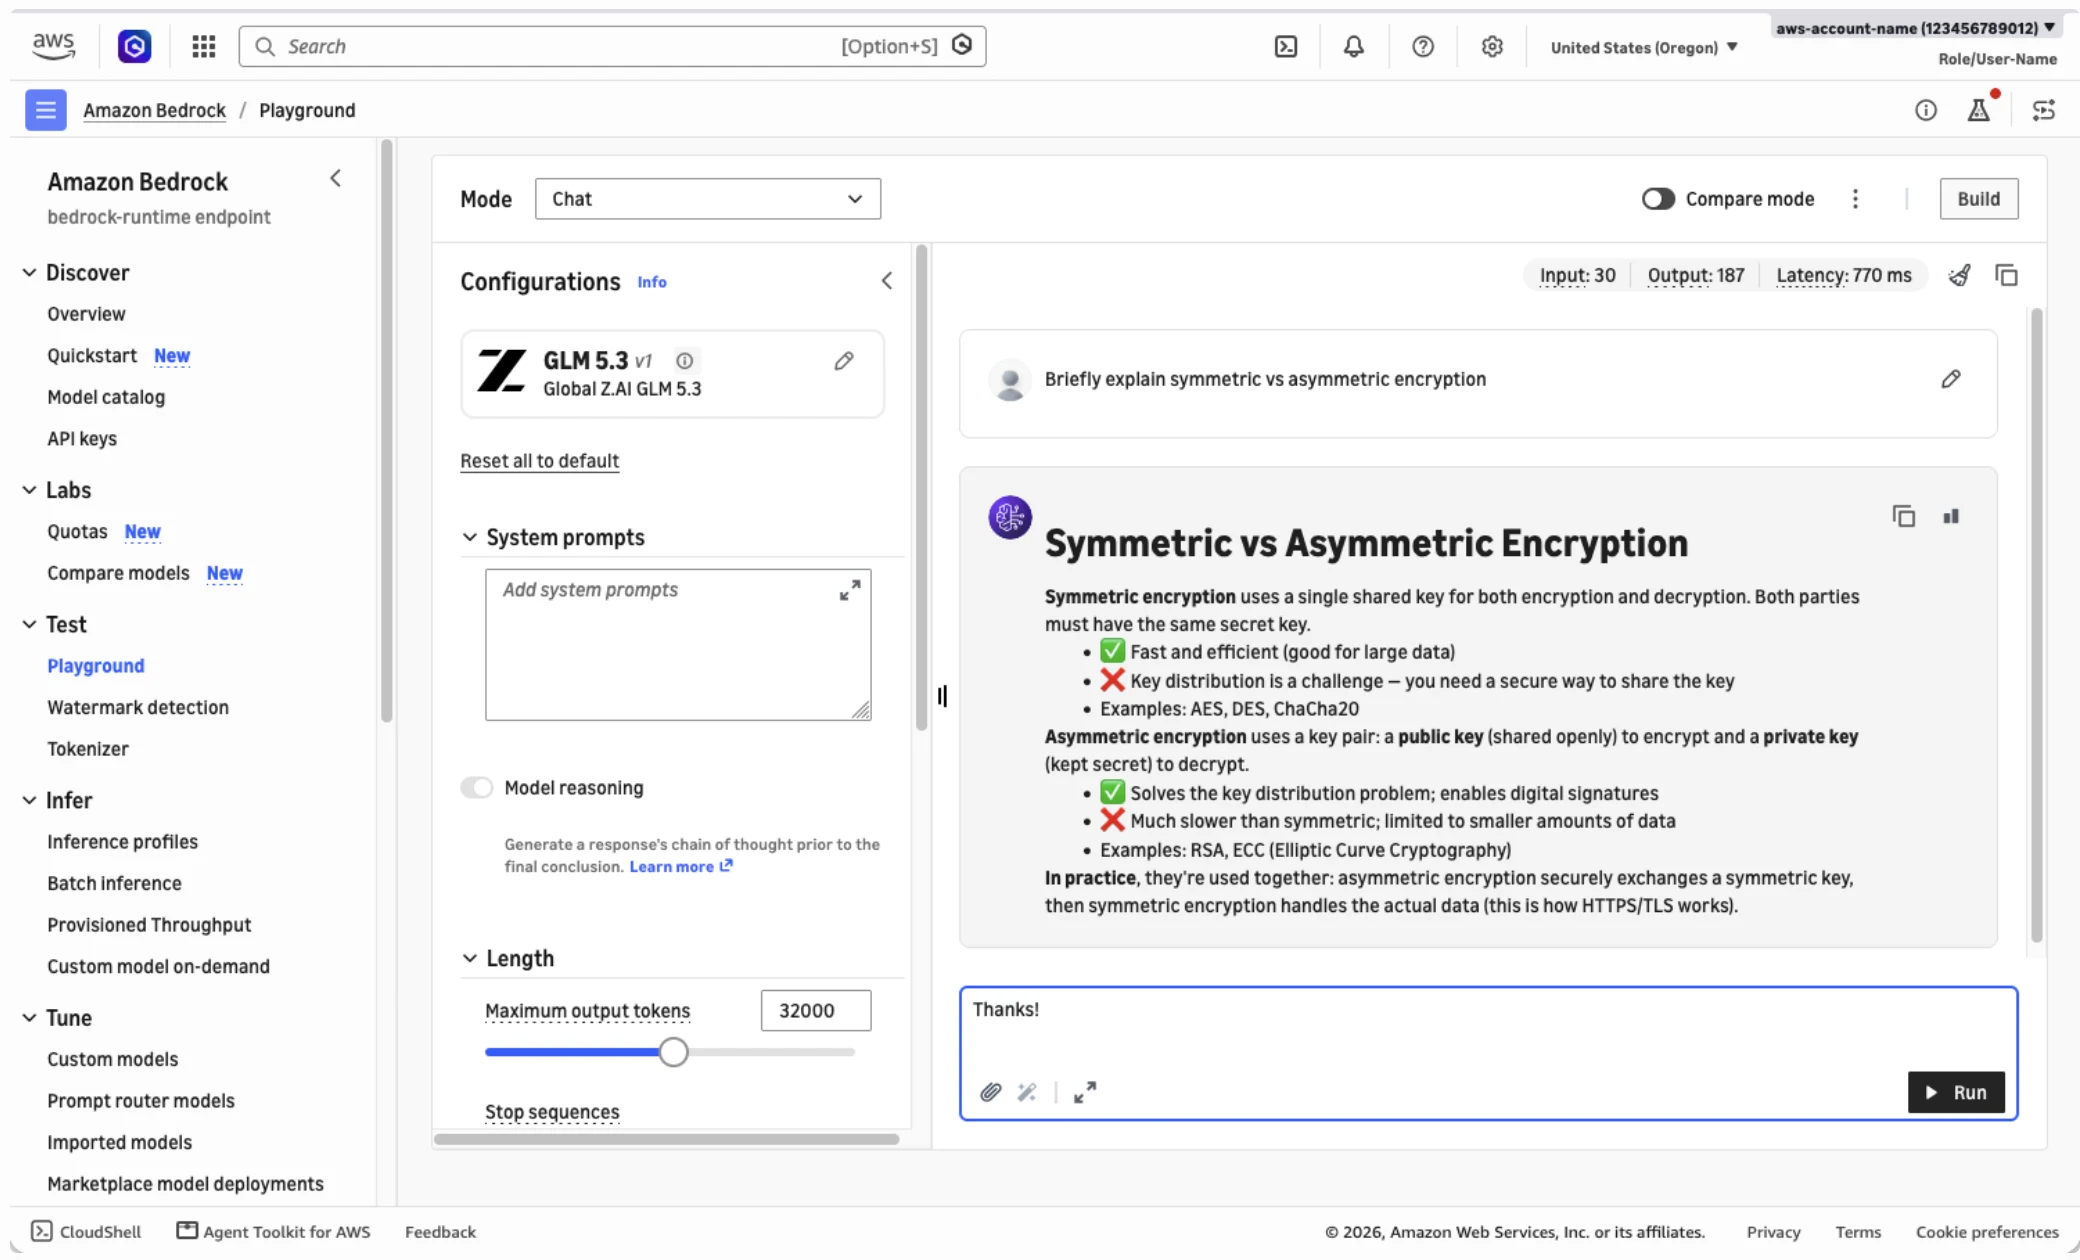
Abbildung 1: Gespräch mit GLM 5.3 auf der Amazon Bedrock-Konsole
Beginnen Sie mit der Responses-API
Programmierend können Sie das Modell über den bedrock-runtime Endpunkt aufrufen. Dies unterstützt sowohl die mit OpenAI kompatiblen Responses- und Chat Completions APIs als auch die Amazon Bedrock Invoke- und Converse APIs für GLM 5.3. Für neue Anwendungen werden die mit OpenAI kompatiblen APIs empfohlen, da sie eine umfassendere Ausstattung an Funktionen bieten.
Amazon Bedrock unterstützt die Erstellung von API-Schlüssen für OpenAI-kompatible Integrationen, die diese benötigen. Wir empfehlen jedoch, wo möglich, kurzlebige Zugangsdaten anstelle von langfristigen API-Schlüssen zu verwenden.
Im folgenden Beispiel werden wir die Responses-API aus Python verwenden, indem wir das OpenAI-Python-SDK und die aws-bedrock-token-generator-Bibliothek nutzen, um kurzfristige Tokens aus den standardmäßigen AWS Command Line Interface (AWS CLI) Kreditkarten zu generieren.
- Installieren Sie die erforderlichen Pakete.
pip install -U openai aws-bedrock-token-generator - Speichern Sie den folgenden Code als
bedrock-request.py.from aws_bedrock_token_generator import provide_token from openai import OpenAI region = "us-west-2" # Your source AWS Region client = OpenAI( api_key=provide_token(region=region), base_url=f"https://bedrock-runtime.{region}.amazonaws.com/openai/v1", ) resp = client.responses.create( input="Refactor this Python function to be iterative instead of recursive: ...", model="global.zai.glm-5.3", ) print(resp.output_text) - Führen Sie den Skripten, der die Ausgabe des Modells anzeigt.
python bedrock-request.py
Optimieren der Inferenz durch expliziten Prompt-Caching
Lange laufende Programmier- und Wissensarbeiten senden oft stabilen Kontext über mehrere Gesprächsspannen aus, wie beispielsweise Systemanweisungen, Tooldefinitionen oder Repository-Dateien.
GLM 5.3 auf Amazon Bedrock unterstützt standardmäßig den impliziten Prompt-Caching, was dazu beiträgt, die Antwortlatenz und die Kosten für Eingabetoken bei wiederholten Anfragen mit dem gleichen Anfangsprompt zu reduzieren.
Mit dem ausdrücklichen Prompt-Cachingmodus identifizieren Sie speziell die wiederverwendbaren Prompt-Prefixe, was die Cache-Hit-Rate weiter verbessert (und somit auch die Latenz und Kosteneinsparungen erhöht) im Vergleich zum impliziten Caching.
Um explizite Prompt-Caching mit GLM 5.3 zu verwenden, wie im folgenden Beispiel dargestellt:
- Wählen Sie den expliziten Cachingmodus über
prompt_cache_optionsauf Ihrem Request aus. - Fügen Sie ein oder mehrere
prompt_cache_breakpointMarkierungen auf den Eingabebereichsblöcken hinzu, um das Ende (einschließlich) der wiederverwendbaren Prompt-Prefixe anzugeben. Jeder Breakpoint muss mindestens 1.024 Tokens enthalten, um für die Caching geeignet zu sein.
resp = client.responses.create(
    model="global.zai.glm-5.3",
    # Enable explicit caching mode:
    extra_body={"prompt_cache_options": {"mode": "explicit"}},
    input=[
        {
            "type": "message",
            "role": "system",
            "content": [
                {
                    "type": "input_text",
                    "text": SYSTEM_PROMPT,
                    # A long, static system prompt is a great target for caching:
                    "prompt_cache_breakpoint": {"mode": "explicit"},
                },
            ]
        },
        {
            "type": "message",
            "role": "user",
            "content": [
                {
                    "type": "input_text",
                    "text": USER_INPUT,
                    # Multiple breakpoints can also be defined, for layered cache:
                    "prompt_cache_breakpoint": {"mode": "explicit"},
                },
            ],
        },
    ],
)

if resp.usage.input_tokens_details.cached_tokens:
    print("Hit cache!")
Für weitere Informationen siehe den Abschnitt über Caching von Anweisungen im Amazon Bedrock User Guide.
Beispielhafte agentische Arbeitslast: Genehmigte Sicherheitstests mit Strix
Eine Arbeitslast, die direkt von den Vorteilen von GLM 5.3 profitiert, ist die automatische Sicherheitsprüfung Ihrer eigenen Anwendungen. Strix ist ein Open-Source-AI-Penetrationstesting-Agent, der Ihren Code dynamisch ausführt, Schwachstellen findet und diese mit Proof-of-Concept-Tests validiert. Gegenwärtig verwendet die Dokumentation von Strix den GLM 5.3 als Standardmodell. Sie können Strix so konfigurieren, dass er GLM 5.3 auf Amazon Bedrock anstelle eines Drittanbieter-Inferenzproviders verwendet, sodass die Modellinferenz unter den Kontrollen Ihres AWS-Kontos stattfindet.
Testen Sie nur Anwendungen, die Sie selbst besitzen oder von Ihnen ausdrücklich genehmigt wurden. Die unbefugte Sicherheitstestung von Systemen, die Sie nicht besitzen, ist in den meisten Jurisdiktionen illegal und verstößt gegen die AWS Acceptable Use Policy. In diesem Leitfaden ist das Ziel die OWASP Juice Shop, eine absichtlich anfällige Beispielanwendung, die lokal auf Ihrem Computer läuft.
Wenn Sie vollständig verwaltete, kontinuierliche Sicherheitstests benötigen – und nicht selbst Open-Source-Agenten laufen lassen möchten –, bietet AWS Continuum auf Anfrage erbrachte Penetrationstests und andere Sicherheitsanalysen als verwaltetes Dienstleistung. Die beiden Ansätze sind ergänzend: Open-Source-Agenten wie Strix ermöglichen entwicklergesteuerte, in-the-loop- und tief individualisierbare Tests gegen lokale Builds, während AWS Continuum großflächige verwaltete Bewertungen durchführt.
Um eine autorisierte Sicherheitsprüfung durchzuführen
- Starte das Beispiel-Anwendungsprojekt Juice Shop lokal.
docker run --rm -p 3000:3000 bkimminich/juice-shop - Konfigurieren Sie Strix, damit sie GLM 5.3 auf Amazon Bedrock verwendet. Strix nutzt im Hintergrund LiteLLM (wie in ihrer Dokumentation für Amazon Bedrock beschrieben), sodass Ihre AWS CLI-Kennungen automatisch erfasst werden. Das bedeutet, dass keine API-Schlüssel erforderlich sind, aber Sie könnten Umgebungsvariablen wie
AWS_PROFILEundAWS_REGIONsetzen, um die Verbindung zu konfigurieren. Zum Zeitpunkt der Erstellung von diesem Text löst LiteLLM noch nichtbedrock/global.zai.glm-5.3aus. Bis dies behoben wird, können Sie explizit den Converse-API-Routen und das Inference-Profile Amazon Resource Name (ARN) angeben, wie im folgenden Codebeispiel gezeigt:# Fill in the REGION and ACCOUNT_ID placeholders below before running! export STRIX_LLM="bedrock/converse/arn:aws:bedrock:{AWS_REGION}:{AWS_ACCOUNT_ID}:inference-profile/global.zai.glm-5.3" - Führen Sie Strix gegen das lokale Ziel aus.
strix --target http://localhost:3000 - Warten Sie darauf, dass der Wurzele-Agent von Strix abgeschlossen ist, dann prüfen Sie die Ergebnisse.
Strix schafft eine Gruppe von Unteragenten, um die Bedrohungsfläche zu kartieren, eine Reihe potenzieller Schwachstellenkategorien zu untersuchen und jede Erkenntnis mit einer funktionierenden Konzeptbeweis zu validieren. Dies hilft dabei, die Zeit für die Bewertung falscher Positiven zu reduzieren. Ein erfolgreicher Betrieb erzeugt einen Bericht, der die Schweregrad, Beweise und Korrektionshinweise für jede Erkenntnis enthält.
Das folgende Video zeigt den vollen Prozess von der Einrichtung bis zur Ausführung von Strix gegenüber der Beispielanwendung sowie die Untersuchung der Ergebnisse:
Abbildung 2: Durchführung eines Beispielsicherheitstests mit GLM 5.3 und Strix
Saubermachen
Stoppen Sie den Juice Shop-Container mit Ctrl+C im Terminal, in dem es läuft, oder ausführen docker ps Um die Container-ID zu finden und ihn zu stoppen: docker stop <container-id>. Die Amazon Bedrock-Inferierung ist eine Pay-per-Token-Lösung ohne dauerhafte Ressourcen, sodass keine weiteren Kosten entstehen, nachdem Ihre Anfragen abgeschlossen sind. Wenn Sie für diese Schritt-für-Schritt-Anleitung eine Amazon Bedrock-API-Kennung erstellt haben und sie nicht mehr benötigen, löschen Sie sie auf der Amazon Bedrock-Konsole.
Verfügbarkeit
Probieren Sie GLM 5.3 im Amazon Bedrock-Console aus, nutzen Sie es über Code-Assistenten wie OpenCode, wie in unserem jüngsten Artikel mit Kimi K3, oder verbinden Sie Ihre eigene Anwendungen über die unterstützten APIs.
Interessiert an der Möglichkeit, wie Amazon Bedrock Ihr Team unterstützen kann? Kontaktieren Sie uns um das Gespräch zu beginnen.