
Le Chonk
Heute starten wir eine öffentliche Vorprobe von Mistral Large 4. Unoffiziell als ML4, sehr offiziell: le Chonk. ML4 bringt die Grenzen der open-weight-Leistung auf eine neue Ebene. Sie können die Vorprobe-API bereits heute in Mistral Studio ausprobieren. Die Gewichte werden Ende dieses Monats verfügbar sein.
Frontier Leistung
ML4 ist ein 1 Billionen-Parametergesetztes nativ multimodales Modell mit 49 Milliarden aktiven Parametern. Es ist unser größtes und leistungsfähigstes Modell bisher, und es verbessert sich weiterhin schnell, während wir es weiterentwickeln.
Das Modell zeigt außergewöhnliche Leistungen in Bezug auf Programmierung, agentische Arbeitsabläufe und multimodale Verständnisfähigkeit. Es erreicht bereits Leistungen, die mit den stärksten Open-Source-Modellen weltweit vergleichbar sind, und übertrifft dabei deutlich alle in den USA oder Europa entwickelten Open-Weigh-Modelle. Bei kritischen Unternehmensaufgaben, einschließlich Cybersicherheit, Finanzen und Recht, ist es unter den Open-Modellen als am neuesten Stand der Technik zu bewerten. In einigen Bereichen wie der visuellen Grundlage wird es noch weiter gehen, und es übertrifft sogar die offenen Grenzmodelle.
Wir werden die Gewichte gegen Ende des Monats veröffentlichen. Bis dahin führen wir das Modell in realen Umgebungen mit Sicherheitsspezialisten, geprüften Partnern und staatlichen Behörden durch, die auf dasselbe Modell zugreifen können, wobei die Moderation reduziert und die Cyberfähigkeiten erweitert werden.
Demos
Gefertigt in Europa. Entwickelt für die Souveränität der KI.
ML4 wurde von Grund auf mit 3.800 NVIDIA Grace Blackwell-GPUs in den eigenen Datenzentren von Mistral in Europa trainiert. Die öffentliche Vorstellung wird über dieselbe Infrastruktur bereitgestellt. Es ist ein bedeutender Meilenstein in unserem langfristigen Investitionsprogramm in Bezug auf Infrastruktur, Forschung und Produktentwicklung: erstklassige Leistung in wichtigen Bereichen, erbracht durch offene Gewichte, die es den Kunden ermöglichen, die Kontrolle über ihre KI zu behalten.
Dies ist besonders wichtig im Sicherheitsbereich, wo Ablehnungen auf Provider-Ebene die legitime Schwachstellenforschung und die Reaktion auf Vorfälle blockieren können, und wo das Verlieren des Zugangs zu einer Funktion während eines Vorfalls selbst zu einem kritischen Sicherheitsrisiko werden kann. ML4 verbindet eine hohe KI-Sicherheitsleistung mit offenen Gewichten und Selbstdeployment, sodass Organisationen sowohl die Fähigkeit als auch die Autonomie erhalten, fortgeschrittene Sicherheitsarbeit unter ihren eigenen Richtlinien durchzuführen.
Das Modell wird in mehreren Regionen weltweit verfügbar sein, einschließlich einer europäischen Implementierung, bei der Mistral die Dienstleistung end-to-end selbstständig und unabhängig von anderen digitalen Dienstleistern sowie unter europäischem Recht ausführt. Interessantes Detail: Ein erheblicher Teil der Trainingsdaten von ML4 war mehrsprachig und umfasste mehr als 160 Sprachen, einschließlich aller offiziellen Sprachen der Europäischen Union.
Wir haben eng mit führenden Unternehmen weltweit in den Bereichen Finanzen, Ingenieurwesen, Herstellung, Logistik, Pharmazie, Wissenschaft, Schifffahrt, öffentlicher Sektor und anderen missionkritischen Branchen zusammengearbeitet, um ML4 zu trainieren. Tatsächlich verwendet das Modell dieselbe Trainierung, Anpassung und RL-Umgebung, die wir unseren Kunden über Mistral Forge. anbieten.
Probieren Sie es heute aus
Es gibt noch mehr zu kommen. Wenn wir daran arbeiten, die Gewichte veröffentlichen, werden wir weitere Details zur Modellarchitektur, zusätzliche Benchmarks und unsere Post-Training-Methodik teilen.
Dieses Modell wird auch als Grundlage für eine neue Generation von spezialisierten und optimierten Mistral-Modellen dienen. In der Zwischenzeit laden wir Sie ein, die Preview-API auszuprobieren und Ihre Rückmeldungen auf den sozialen Medien mit uns zu teilen.
Fähigkeitsdurchdringung
Cybersecurity
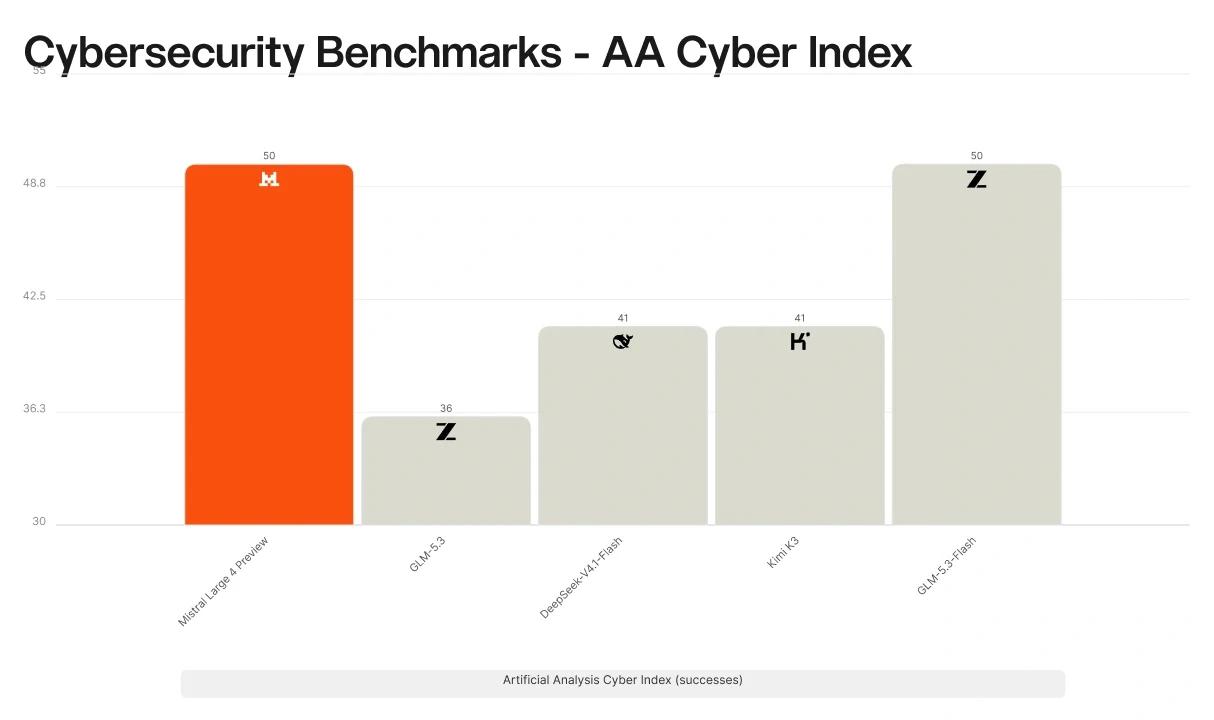
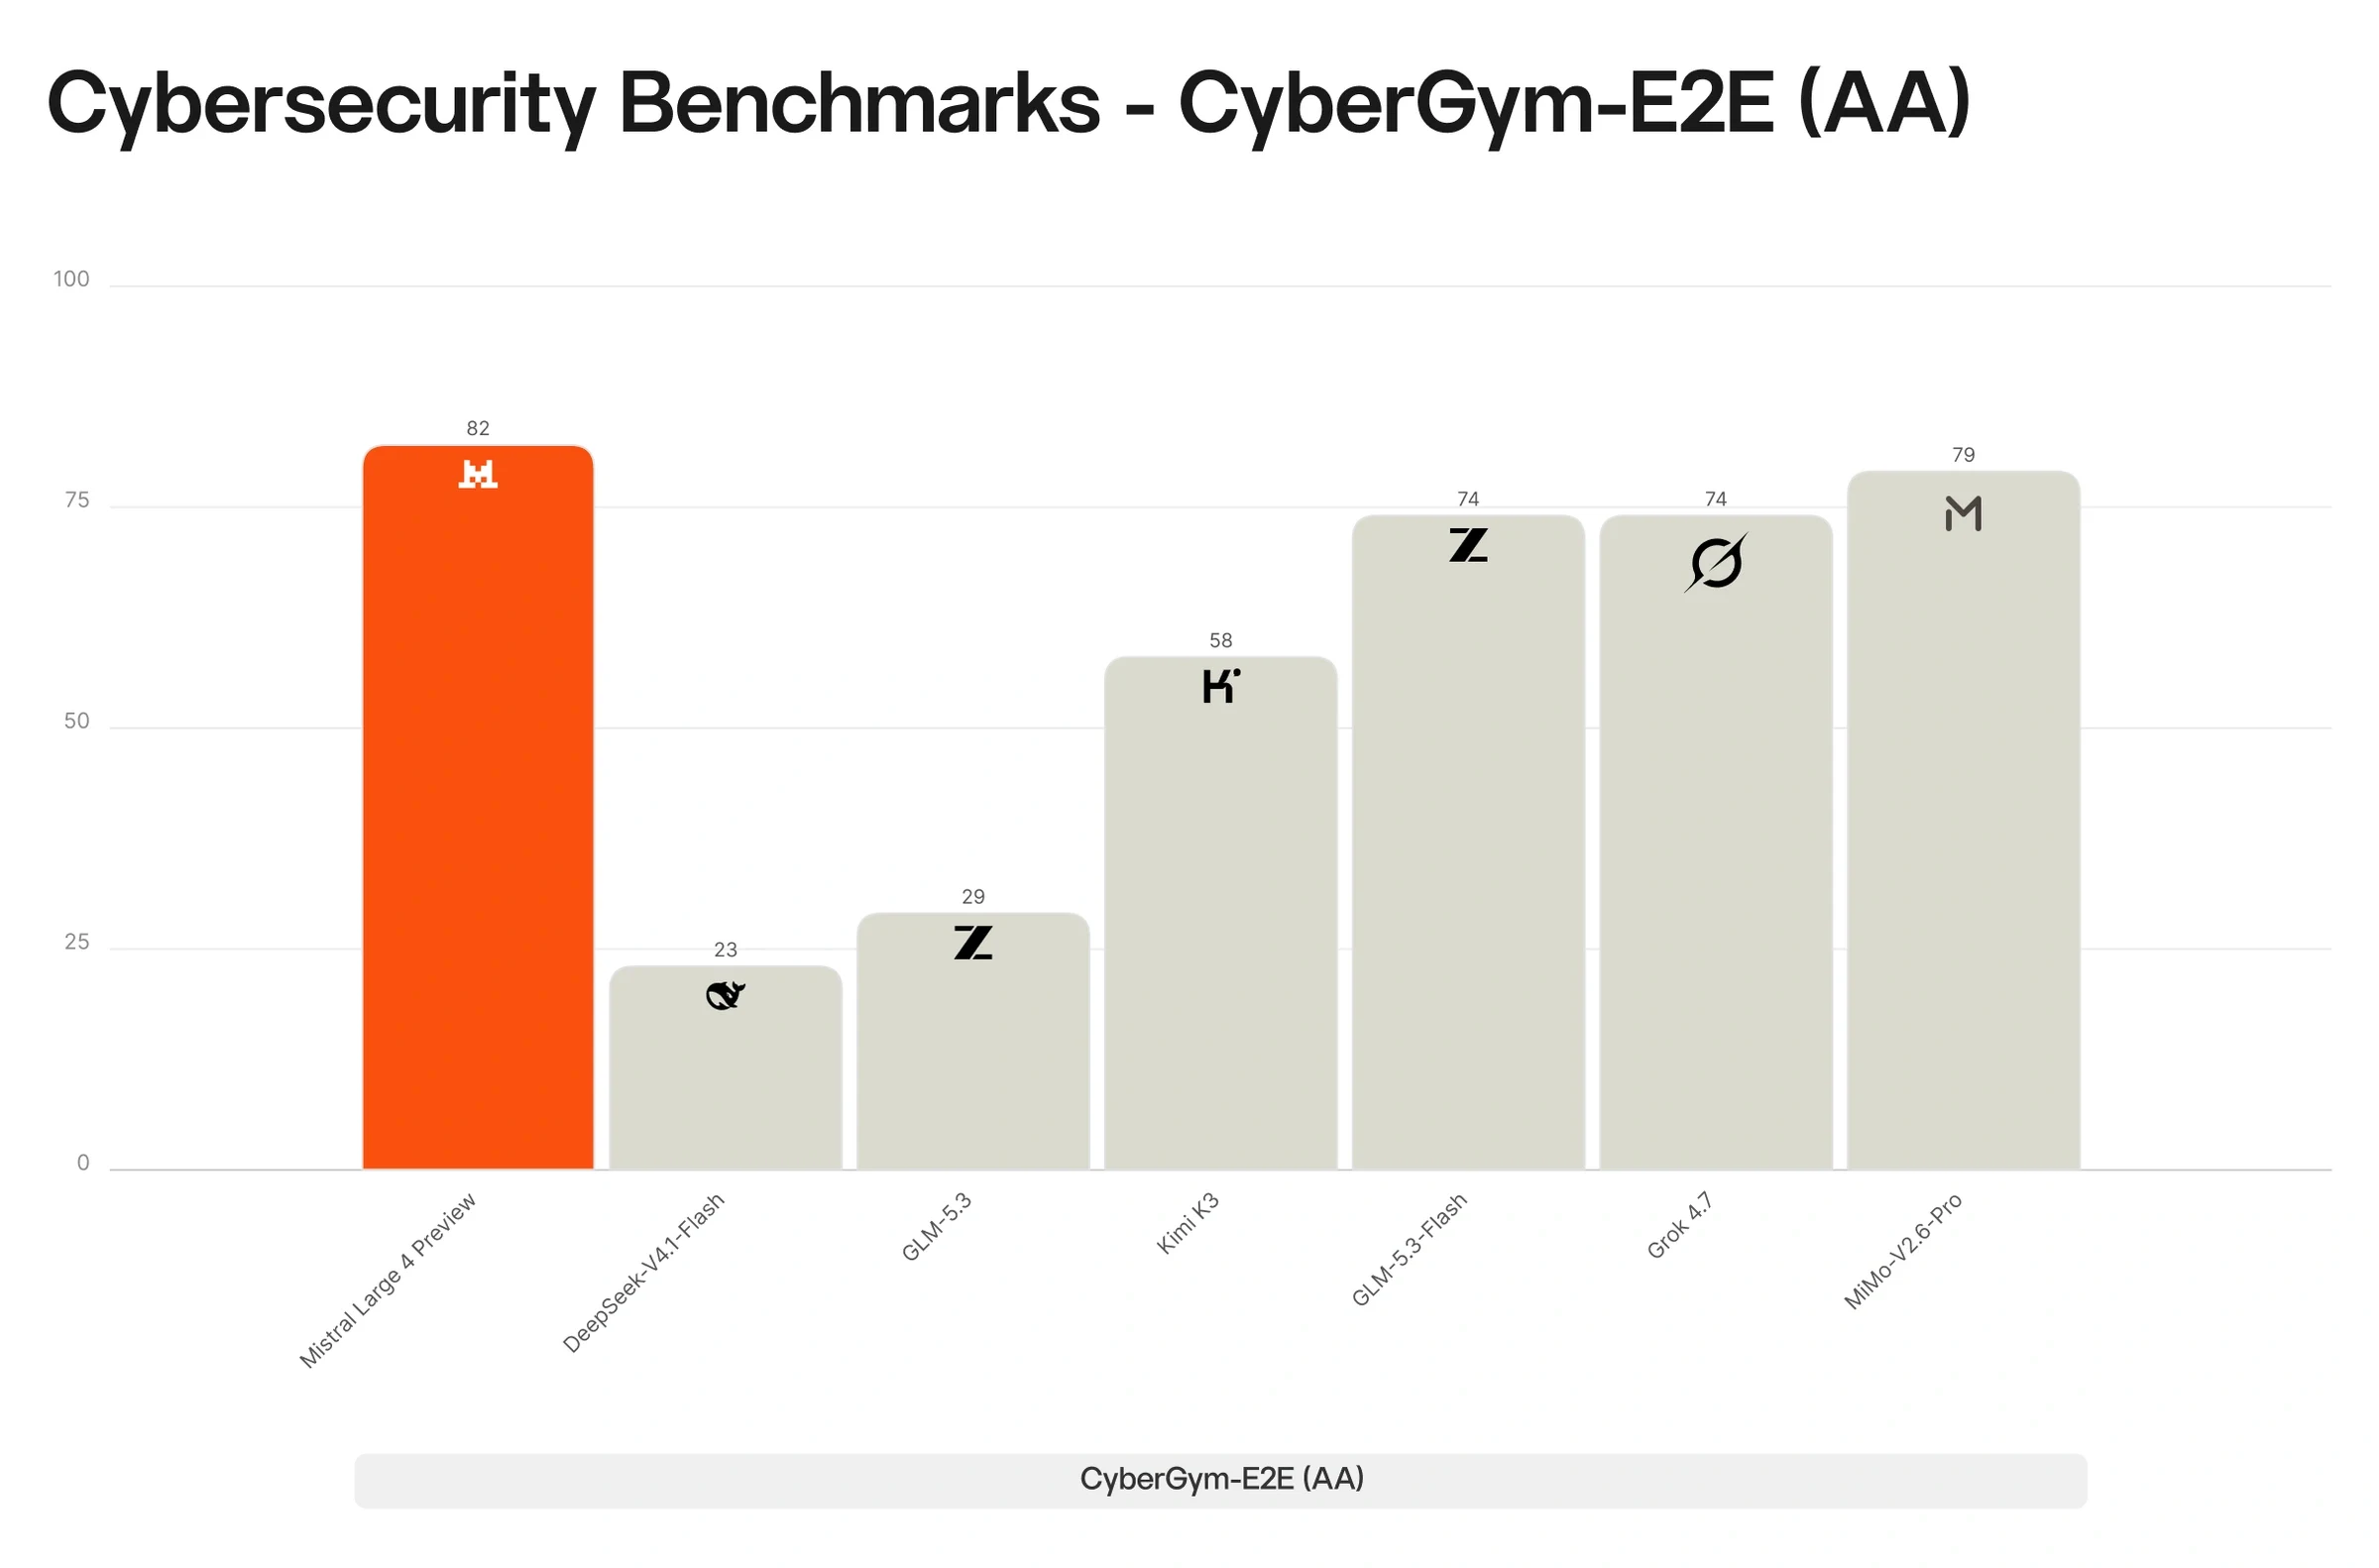
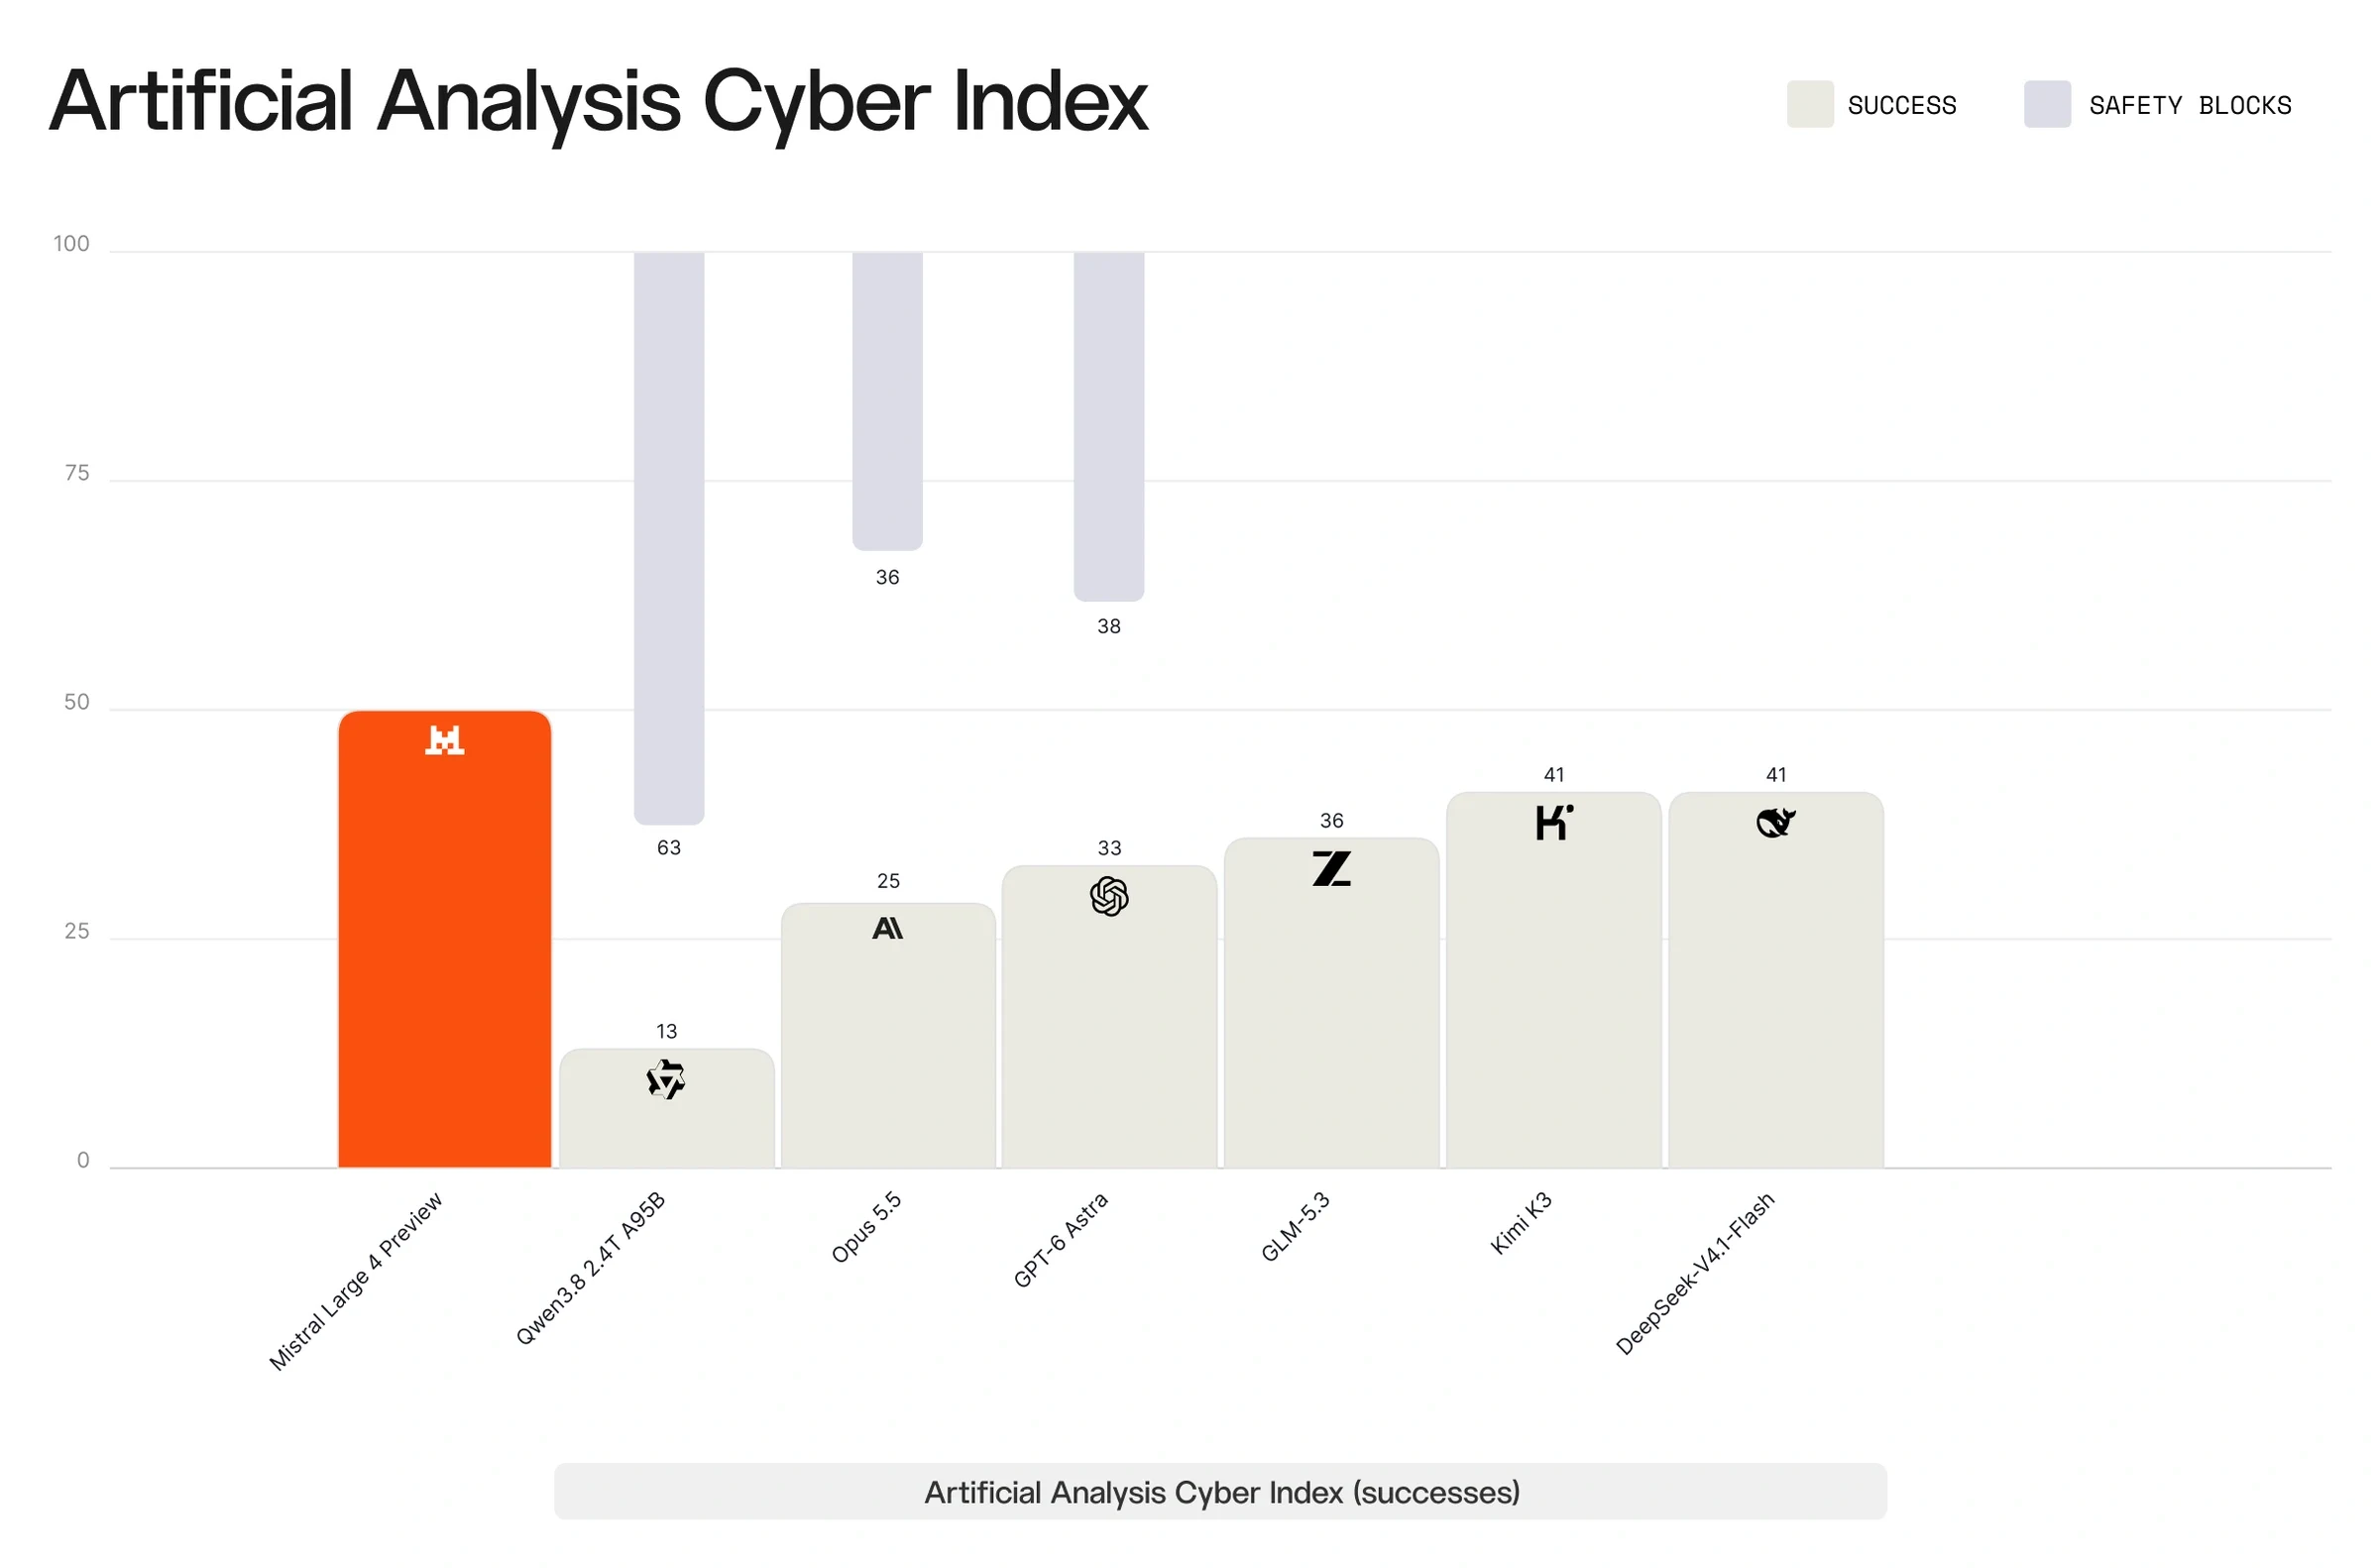
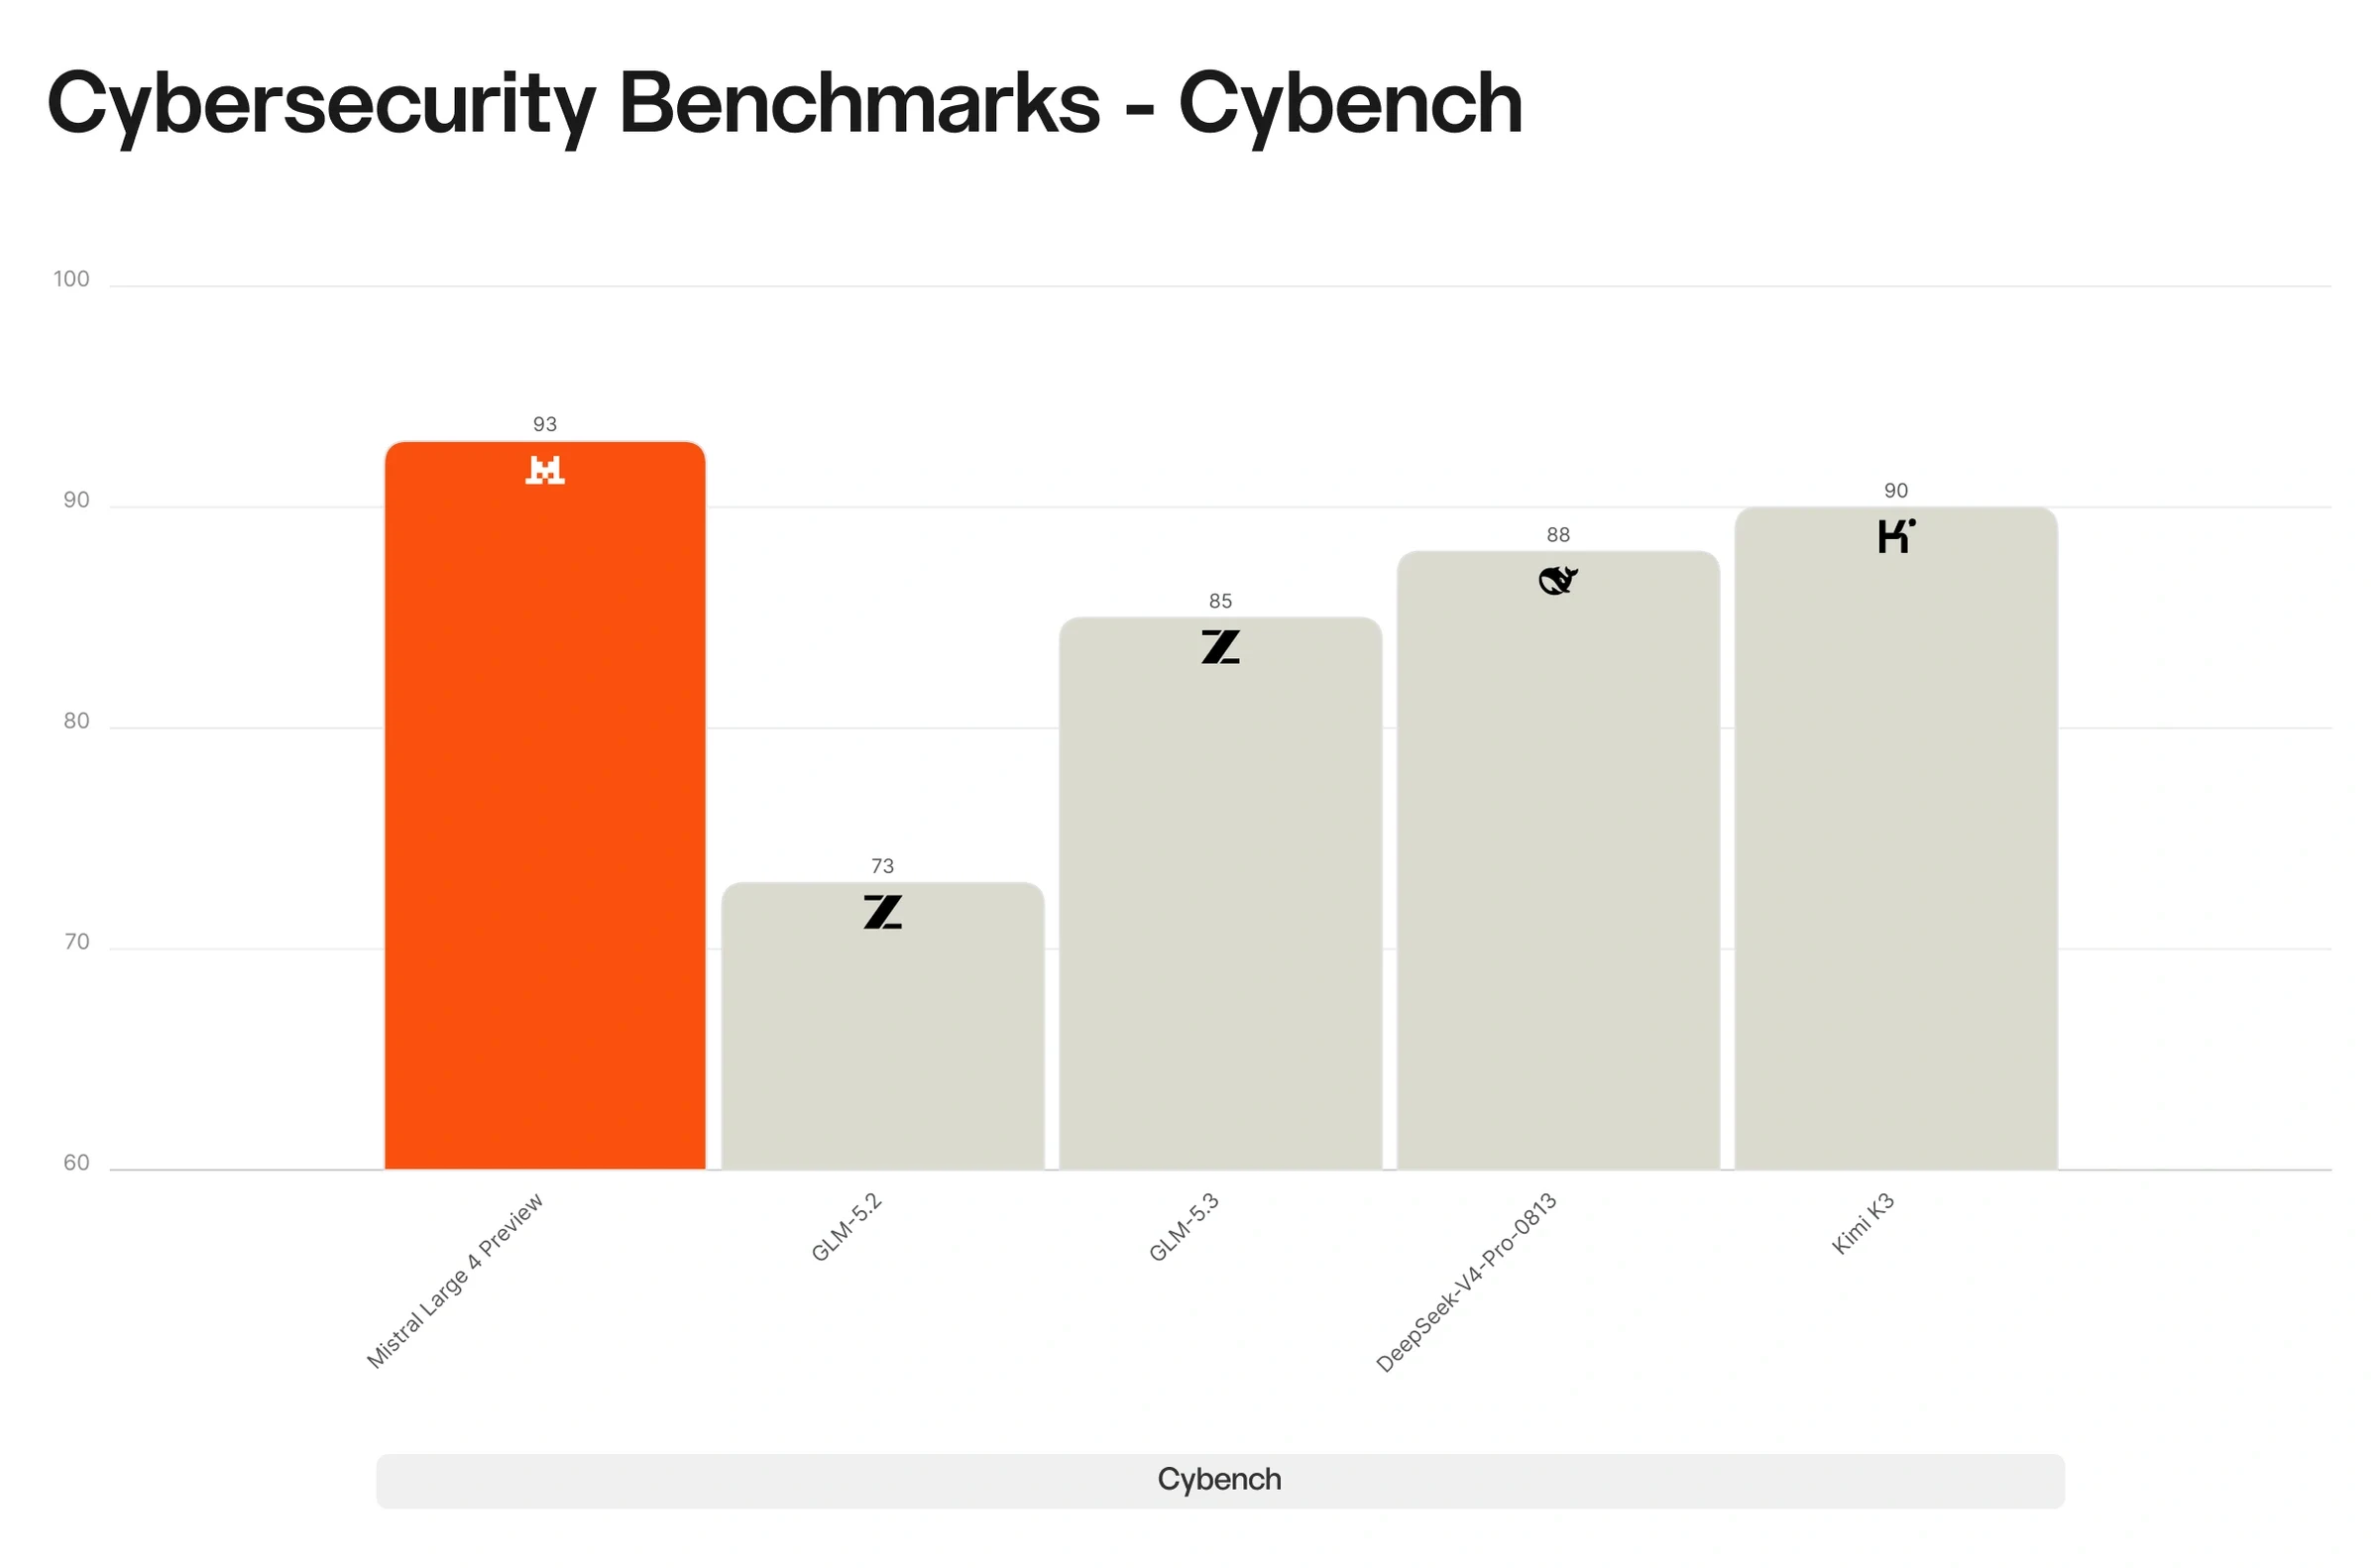
ML4 ist eines der stärksten AI-Modelle weltweit für Cybersicherheit. Im Artificial Analysis Cyber Index, einer unabhängigen Bewertung, wie gut AI-Modelle Sicherheitslücken in echten Softwareen erkennen und beheben, gehört es zu den fünf besten Modelle weltweit und führt mit einem großen Vorsprung die offenen-Modell-Entwicklungen außerhalb Chinas an. Bei einer der Tests im Index, bei der das Modell eine echte Schwachstelle in Open-Source-Software nachbilden und anschließend korrigieren muss, erreicht ML4 einen Score von 82 %, den höchsten aller Modelle. Es löst auch 93% der Herausforderungen in Cybench, einer Sammlung von 40 Übungen, die aus Sicherheitswettbewerben stammen, ab – eine der höchsten Punktzahlen, die für ein offenes Modell gemeldet wurden.
Dieser höchste Score spiegelt einen praktischen Vorteil wider. Mehrere führende geschlossene Modelle, einschließlich Claude Opus 5.5 und GPT-6 Astra, erzielen bei demselben Test nahe Nullpunkte, weil sie sich weigern, die Aufgabe auszuführen. Doch der Schutzsoftware beginnt oft damit, zu beweisen, dass ein Fehler real ist – genau die Art von Arbeit, die Sicherheitsfilter in geschlossenen Modellen blockieren können. Dies ist noch wichtiger, da Bedrohungsakteure zunehmend diese Modelle zur Freigabe bringen, um offensive Cyberaktivitäten zu unterstützen: Die Verteidiger benötigen Systeme, die diese Fähigkeiten nutzen können, ohne von denselben Ablehnungen eingeschränkt zu werden. ML4 kann diese Aufgabe übernehmen, und seine Fähigkeiten gehen über das hinaus, für das es explizit trainiert wurde: In internen Tests erwies sich es als nützlich für die Analyse von Malware, die Priorisierung von Sicherheitslücken und die Erstellung von Detektionregeln. Für Organisationen, die eine souveräne, nachvollziehbare KI für Sicherheitsoperationen benötigen, kann diese auf einem privaten Cloud oder vor Ort betrieben werden.
ML4 gegen das Feld: effizientes Denken über vielfältige komplexe Herausforderungen
Malware-Reverse-Engineering: Lösung eines Untersuchungsauftrags aus dem Ausland
Agentischer Codeing
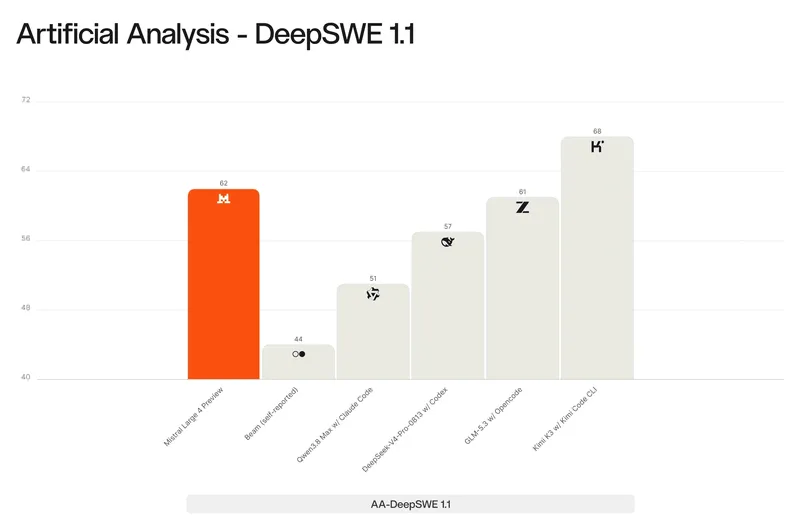
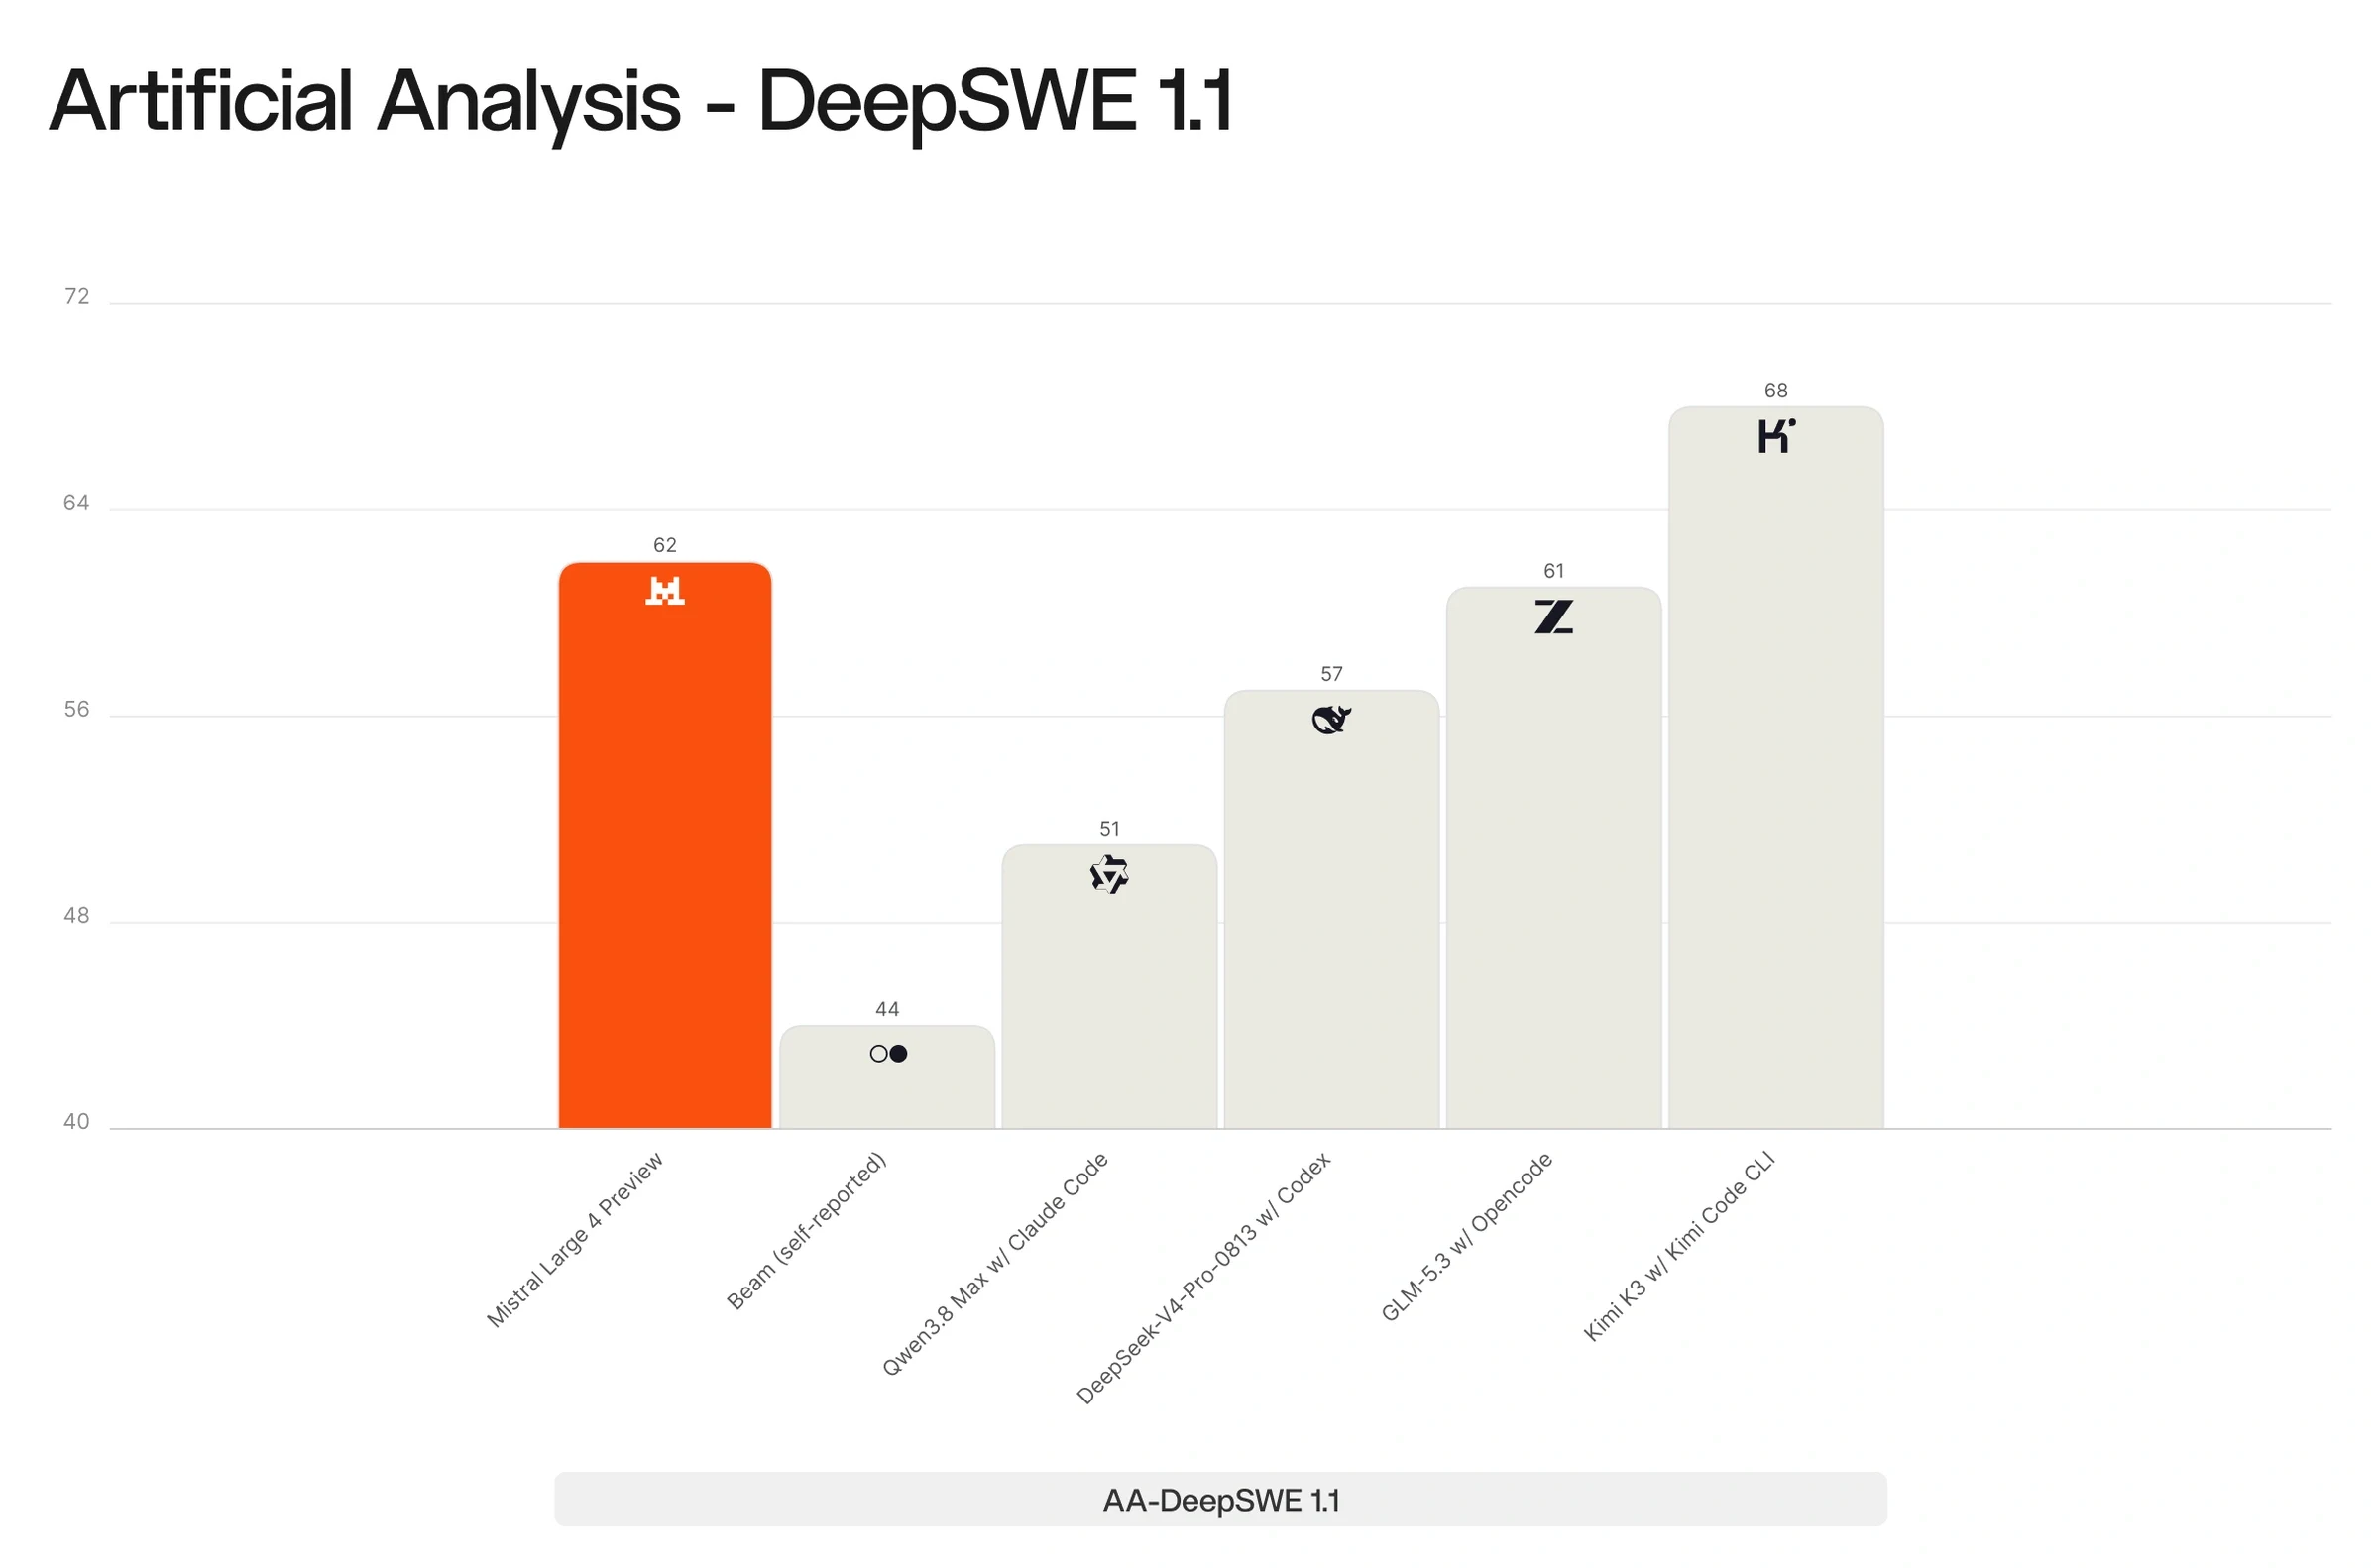
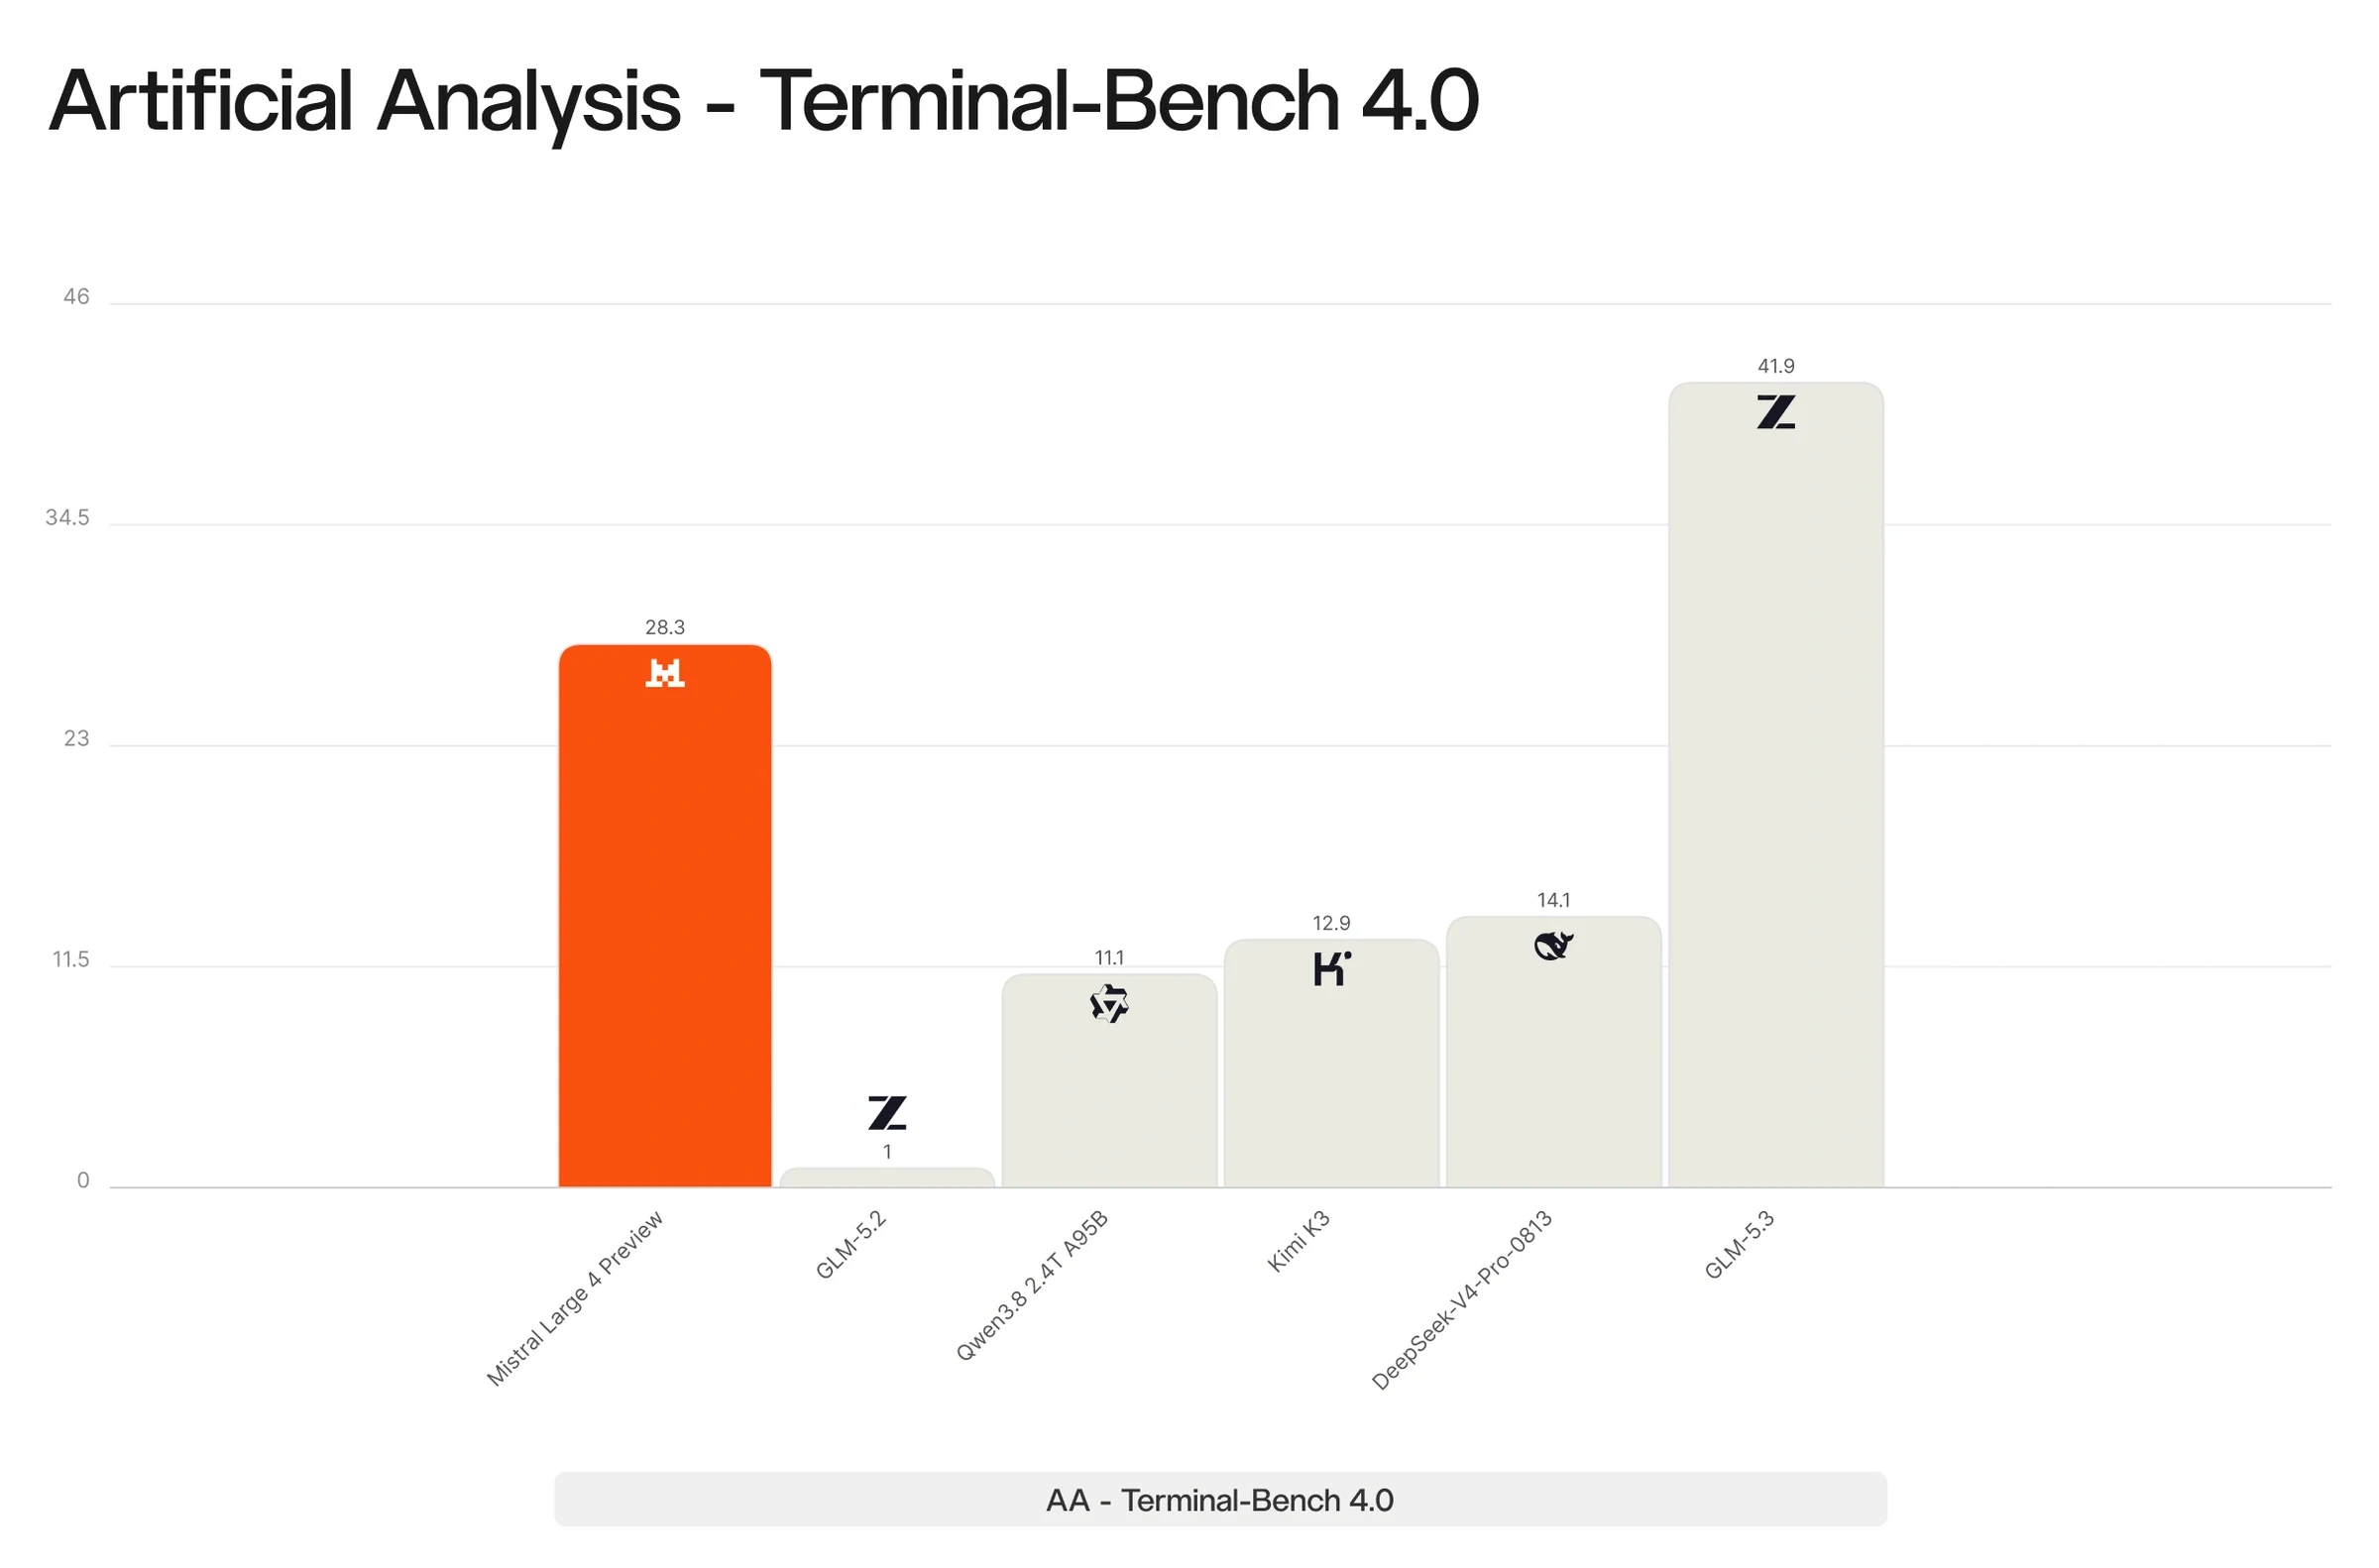
ML4 ist in der Softwareentwicklung, im Verständnis von Repositories und in komplexen Terminal-Arbeitsabläufen herausragend – mit einer Punktzahl von 61,7% bei DeepSWE v1.1, 59,4% bei SWE-Atlas-QnA und 28,3% bei Terminal-Bench 4. Der zusammengerechnete Index des Coding Agent Index beträgt 49,8%, wodurch es sich vor DeepSeek V4 Pro 0813 und Qwen3.8 Max befindet.
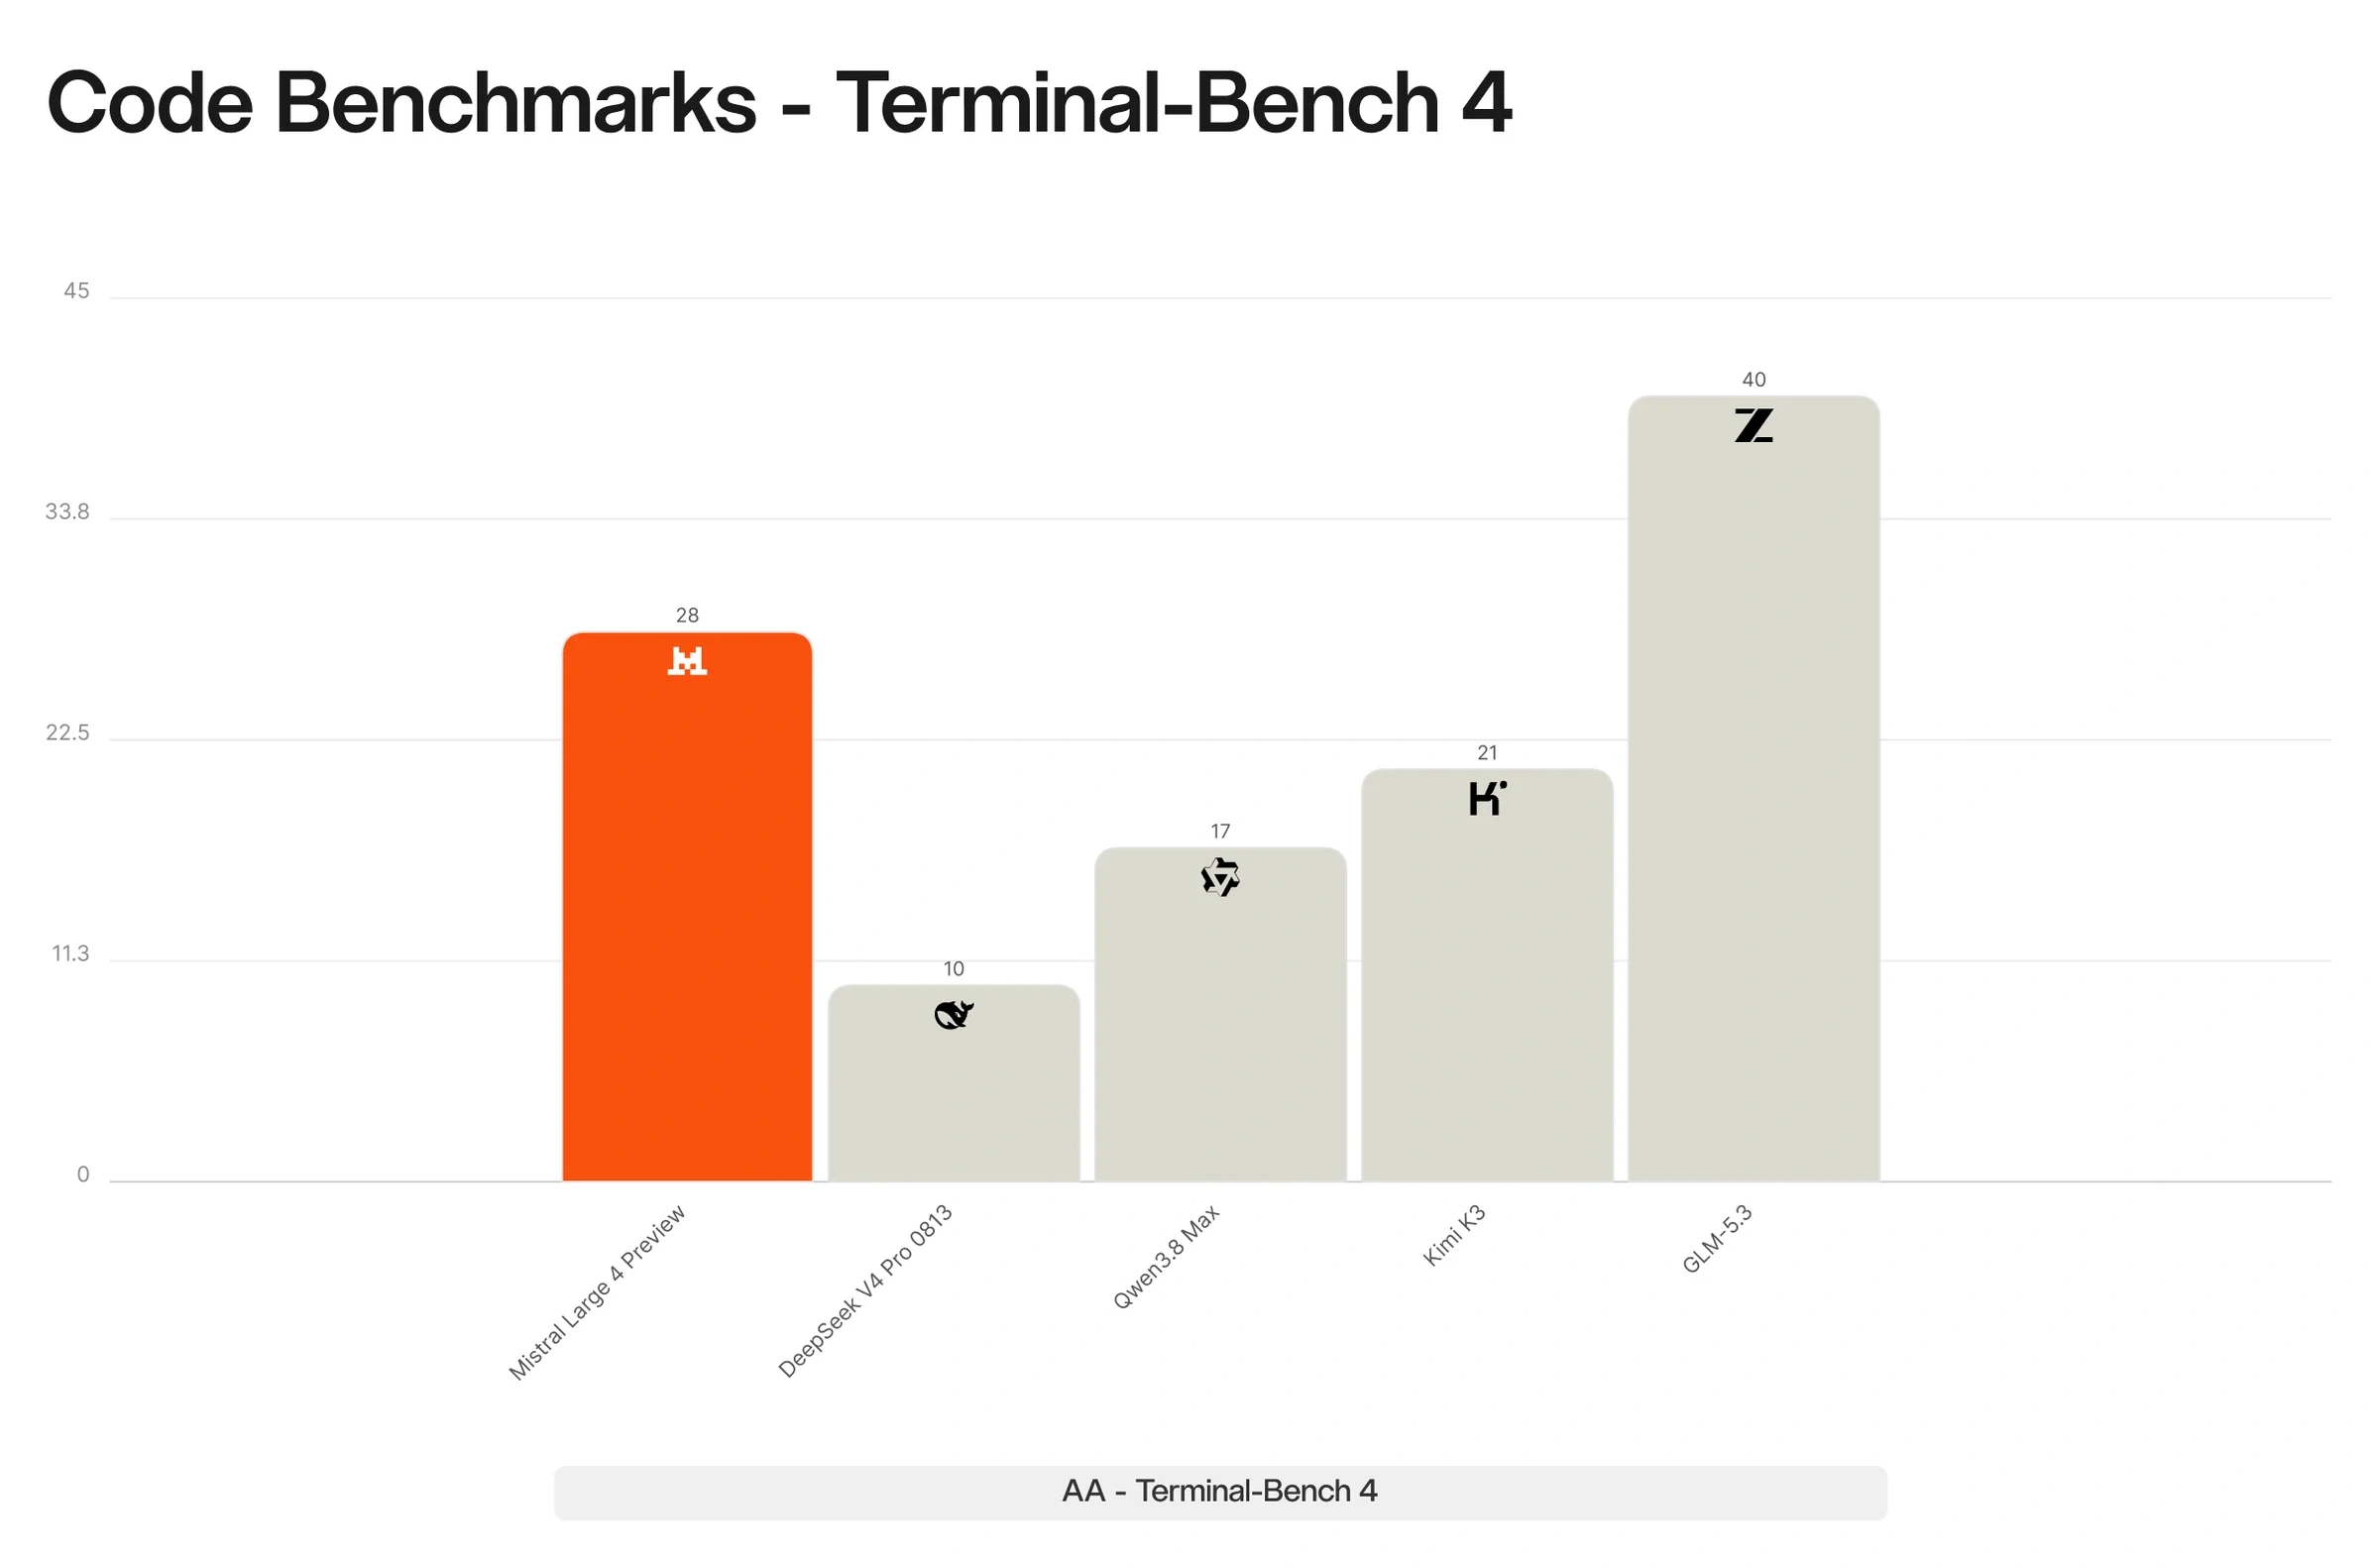
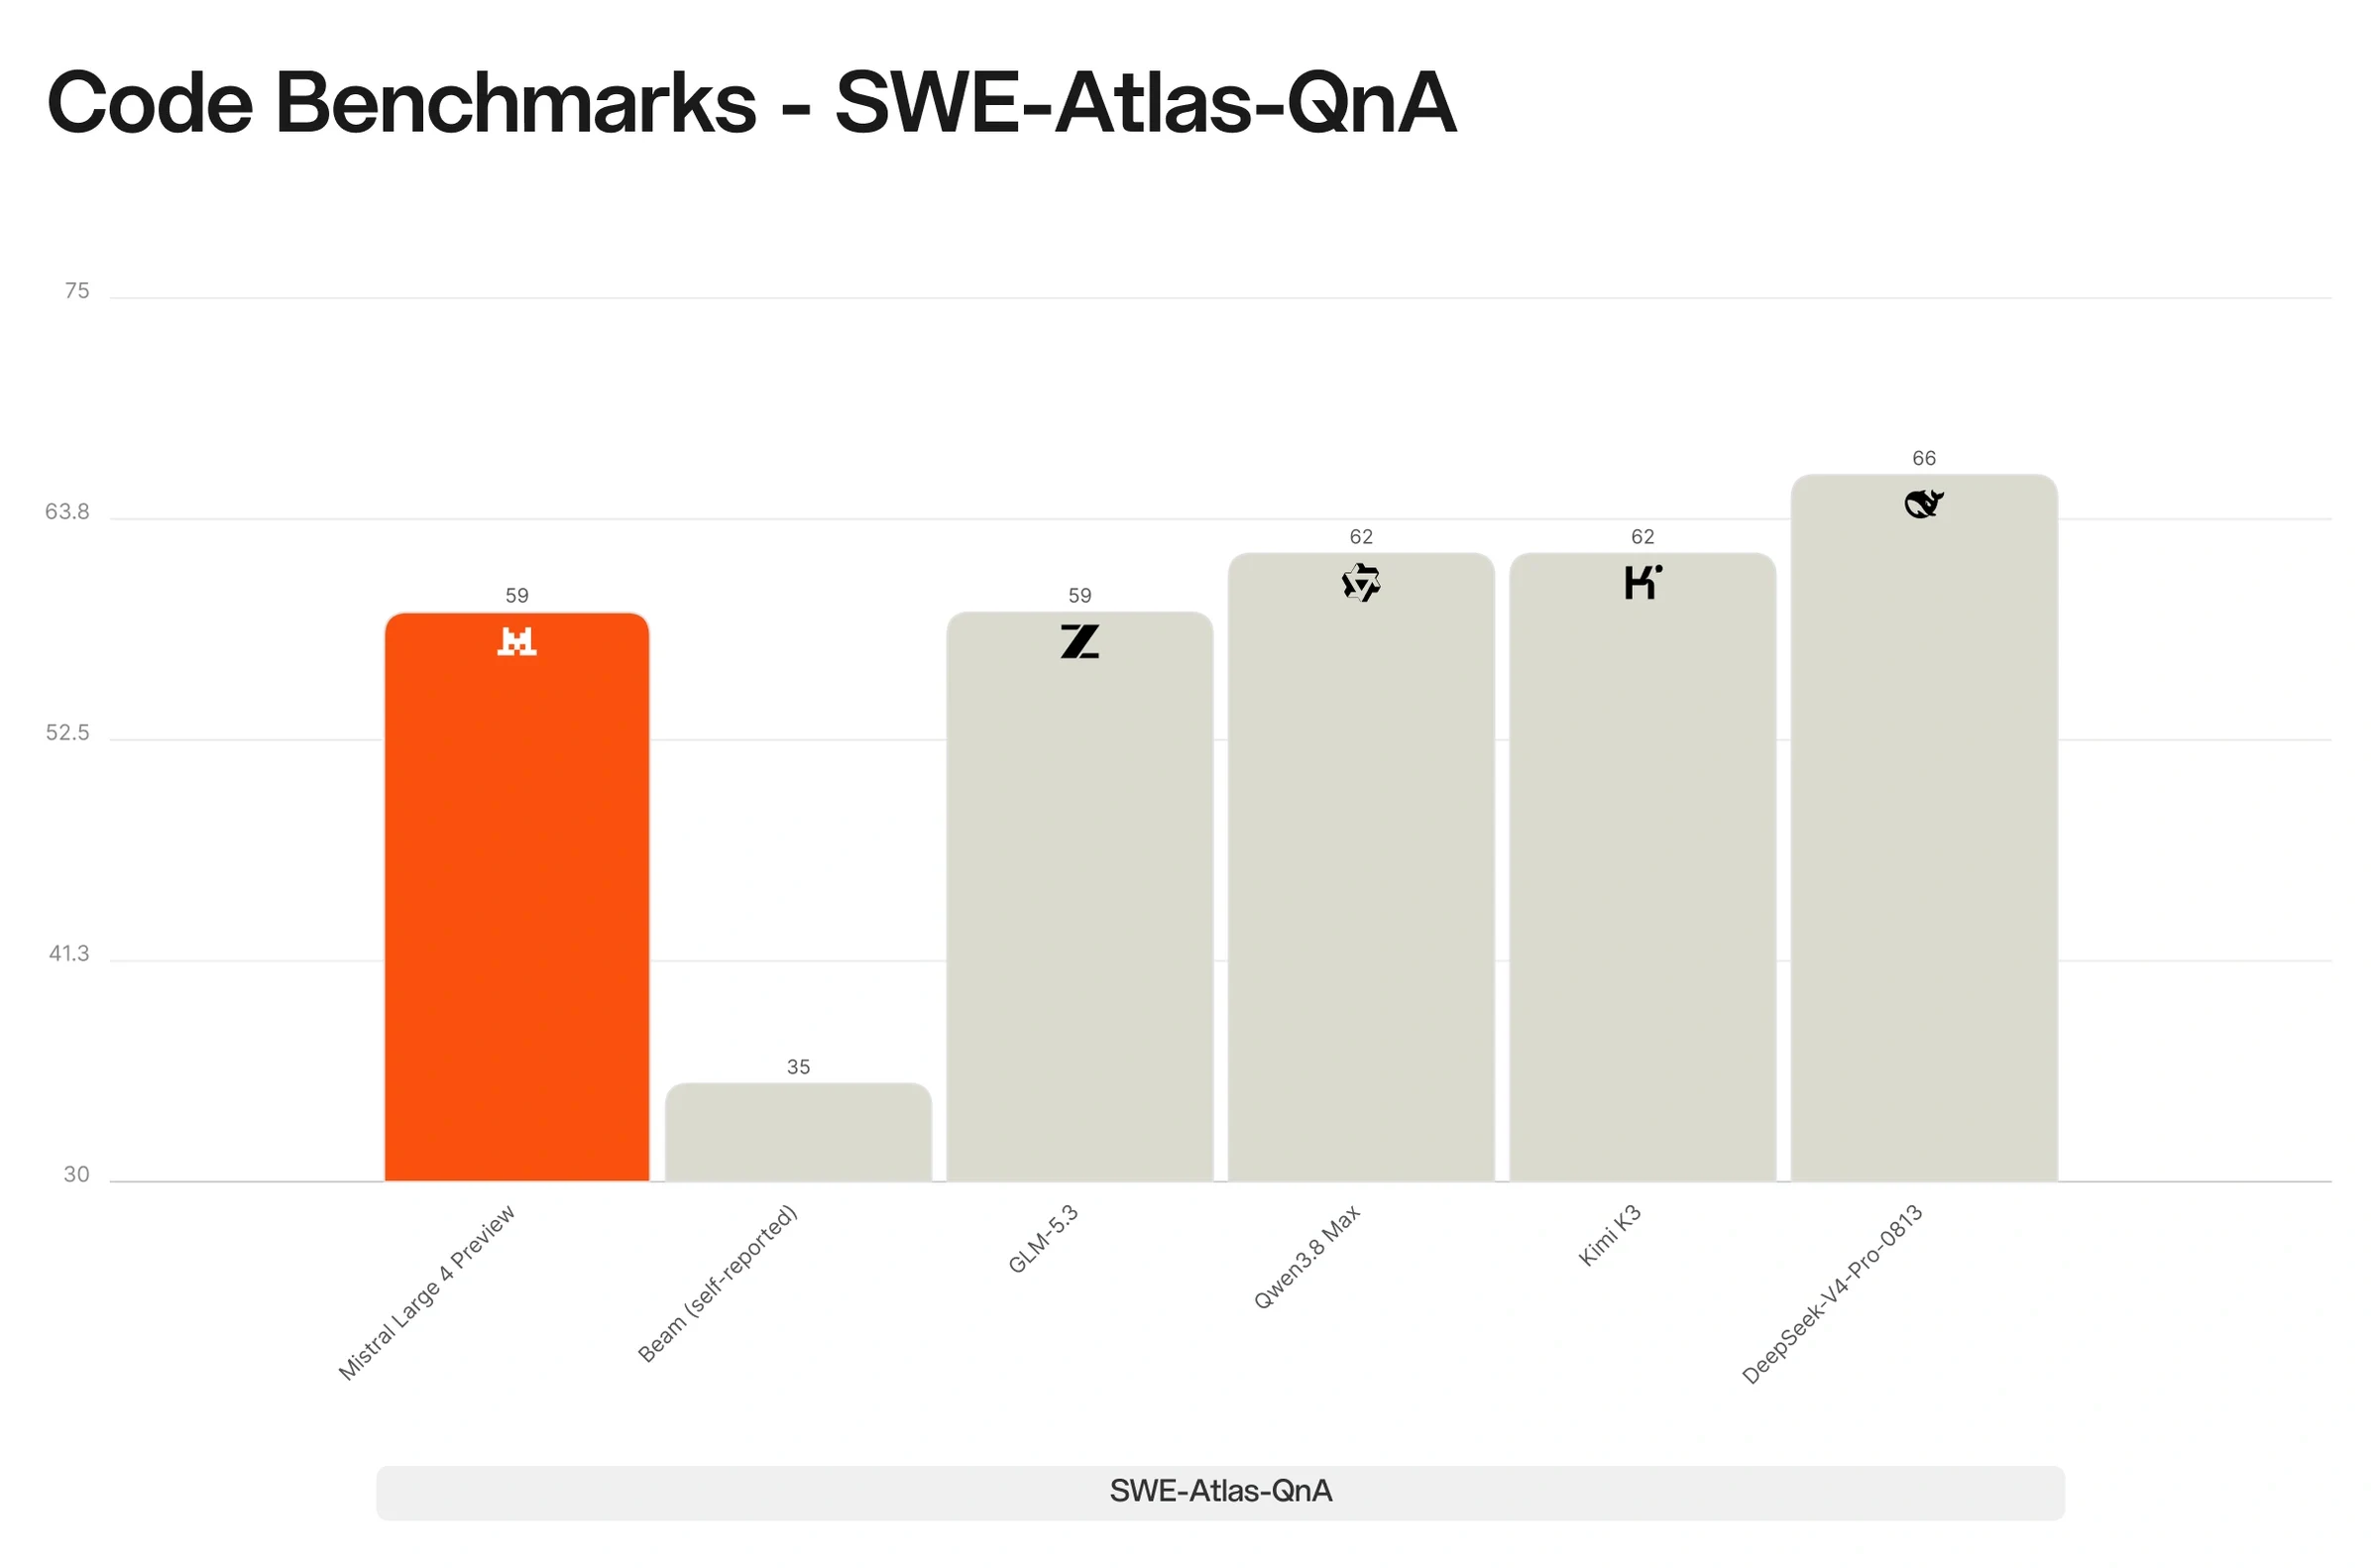
* Die Ergebnisse auf DeepSWE, Terminal-Bench 4 und SWE Atlas QnA verwenden die Zahlen, die durch den ArtificialAnalysis-Kodierindex angegeben werden. Vibe Code Bench v1.1 verwendet die Zahlen, die von vals.ai angegeben werden.
Wir führten auch eine blinde menschliche Bewertung mit Surge AI bezüglich der Komplexität des Codes durch: Professionelle Annotatoren bewerteten die Modellausgaben auf einer Skala von 1–5, wobei die Identitäten der Modelle verborgen waren. ML4 Preview erreichte den zweiten Platz unter den fünf Modellen (3,74), vor Kimi K3 (3,59), GLM-5.3 (3,60) und GLM-5.2 (3,40), und nur hinter Claude Opus 5 (4,22).
Agentische Workflows
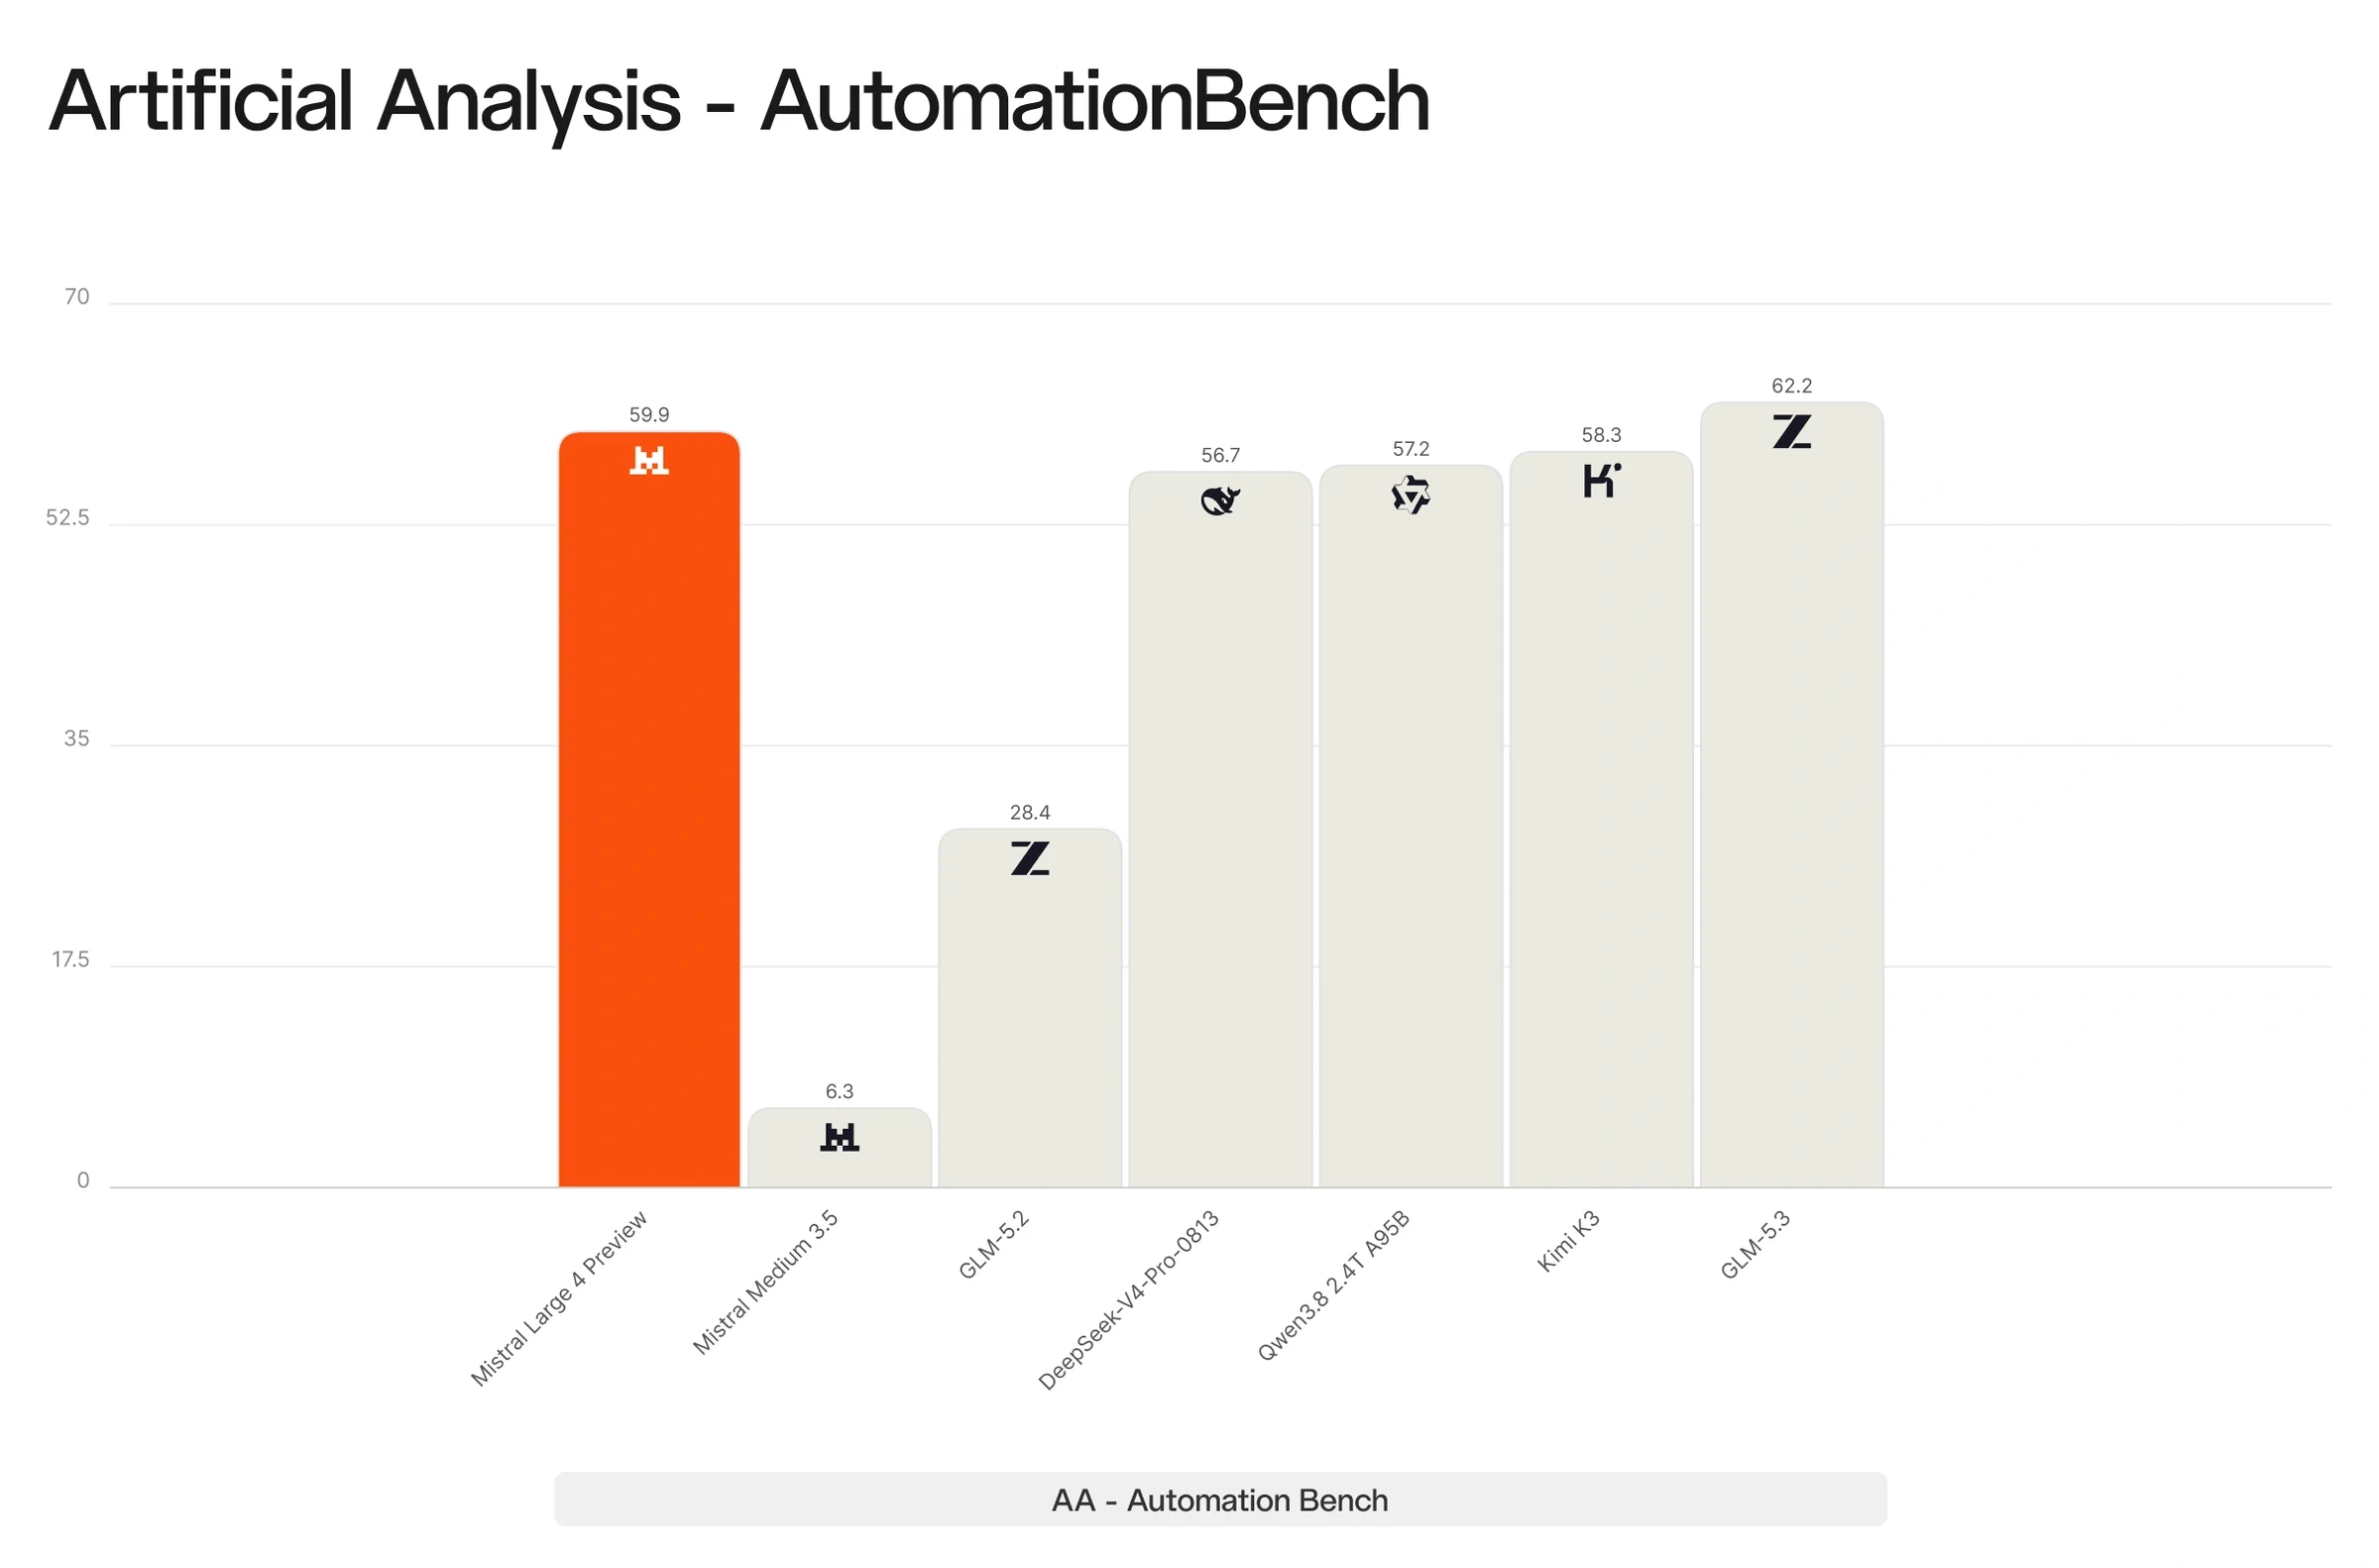
ML4 führt allgemeinnutzende Agenten ein, die Informationen sammeln, Werkzeuge verwenden und fertige Ergebnisse in komplexen Workflows erbringen. Auf AutomationBench – 657 Geschäftsworkflows in Apps wie Gmail, Google Sheets, Slack und Salesforce – erreicht es einen Score von 59,9%, der über Kimi K3, MiMo-V2.6-Pro und DeepSeek V4 Pro liegt.
Es ist genauso stark bei den professionellen Leistungen, die das Wissensthema tatsächlich erzeugt: Tabellen, Präsentationen und PDFs. Bei AA-Briefcase, das langfristiges Wissensthema bewertet, erreicht es 1.393 Elo, was über dem DeepSeek V4 Pro liegt.
Multimodales
ML4 ist ein bedeutender Fortschritt in der Fähigkeit unserer Modelle, Bilder zu verstehen. Es kann auf komplexen Dokumenten, Diagrammen und natürlichen Bildern effektiv rechnen und bringt Sehkraft in Branchen ein, in denen Wahrnehmung von entscheidender Bedeutung ist – wie z. B. Ingenieurwesen, Herstellung und Erdebeobachtung.
Das Modell kann zudem visuelle Grundlagen mit agentischen Fähigkeiten kombinieren: von der Untersuchung gigapixelgroßer Satellitenbilder – um Teams bei der Katastrophenbekämpfung zu unterstützen, wenn Zeit entscheidend ist – bis zur Analyse technischer Zeichnungen – durch Zoom, Inspektion und Überprüfung bis zum exakten Ergebnis. In unseren Demonstrationen nutzt ML4 dichte natürliche Szenen, verifiziert mechanische Komponenten in technischen Zeichnungen, extrahiert Beweise aus PDF-Dateien und scannt riesige geografische Bilder nach den schwierigsten Objekten.
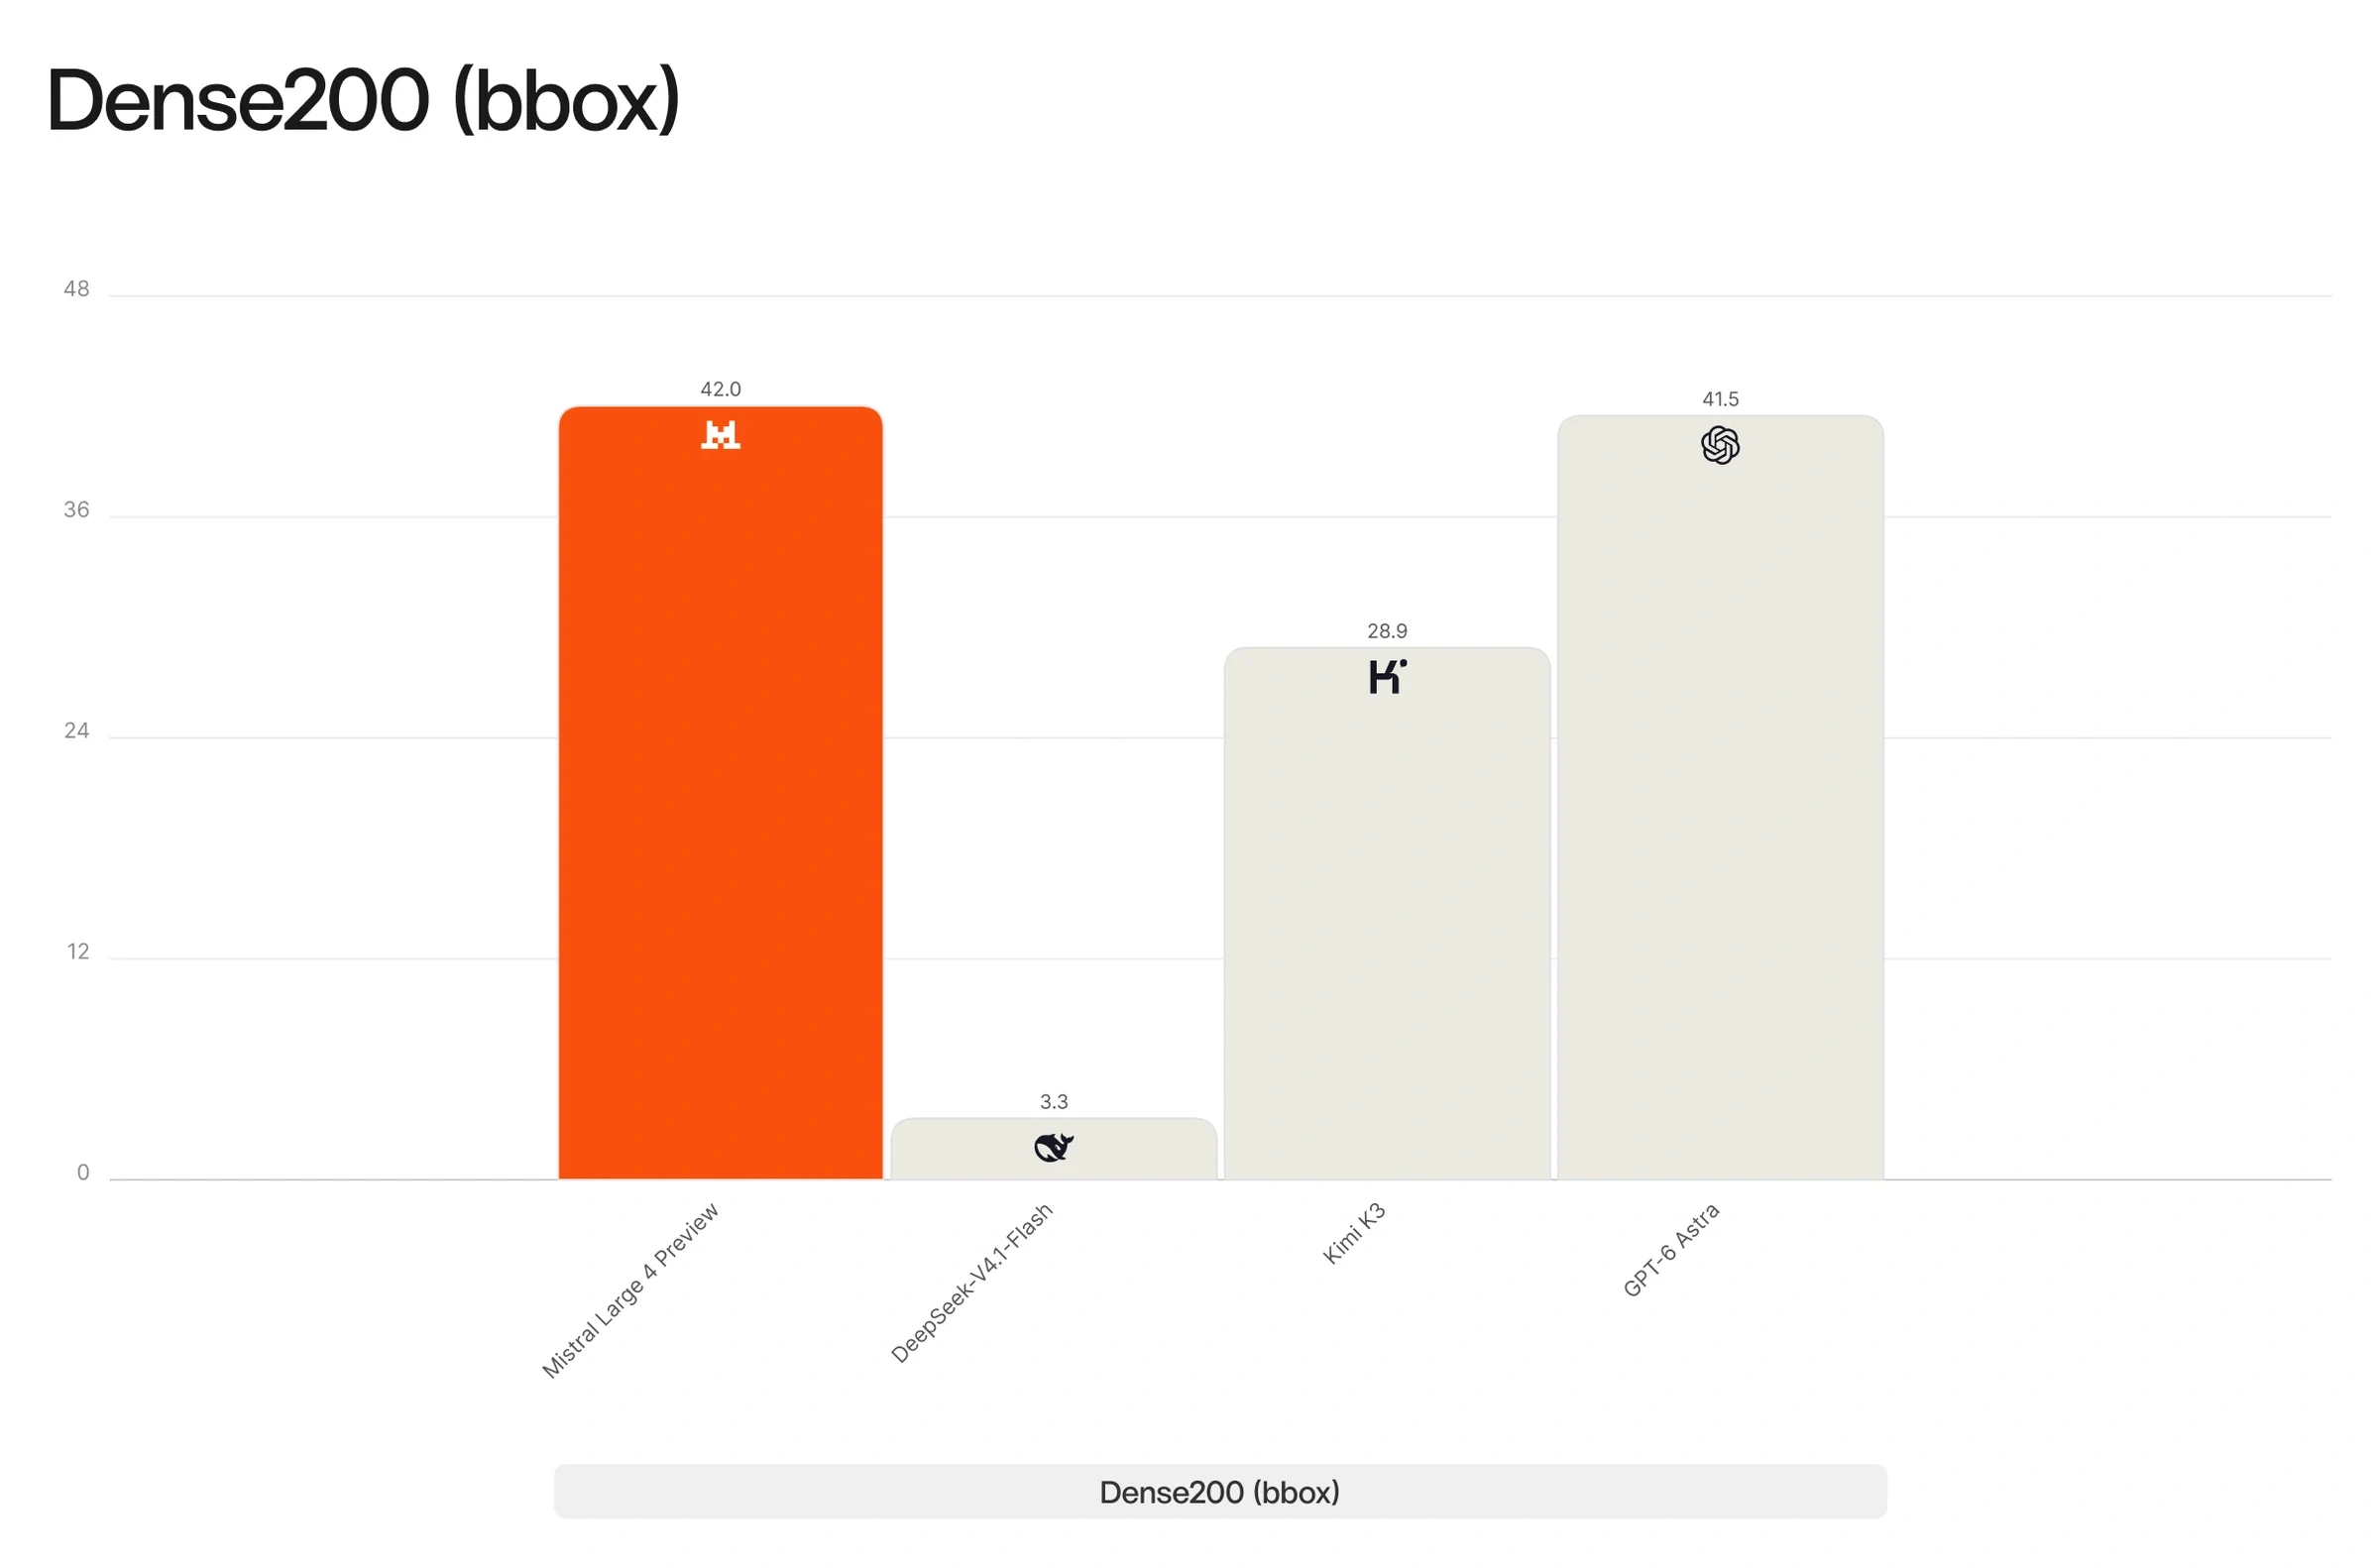
Insbesondere im Bereich der visuellen Grundlage zeigt sich, dass ML4 eines der leistungsfähigsten Modelle ist, die wir getestet haben – es übertrifft beispielsweise GPT-6-Astra bei Dense 200 (42% gegenüber 41%).
Wissenschaft und Mathematik
ML4 bietet starke wissenschaftliche Fähigkeiten, die durch die Kombination von AI-gestützten Methoden mit der Expertise unserer Forscher in Mathematik, Physik und Chemie entstehen.
Es ist sehr kompetent bei der agentischen Programmierung für wissenschaftliche Aufgaben wie Datenanalyse, Modellierung und Simulation physikalischer Realität, was Forschern ermöglicht, sich auf die Fragen zu konzentrieren, anstatt auf die technische Umsetzung. In Benchmarktests ist ML4 bei open-weight-Modellen in SciCode-Verified hochmodern. In der Praxis kann es eine vollständige Hartree–Fock-Simulation in einem Schritt erzeugen – eine komplexe, mehrstufige chemische Aufgabe, die aus einer Reihe fortgeschrittener Routinen besteht.
ML4s Mathematik ist ebenfalls stärker – sowohl im formellen Logieren als auch in angewandter Mathematik. In unseren menschlichen Bewertungen denkt es präziser und strukturierter als GLM-5.3 nach, und es kann lange, spezifische anwendungsorientierte mathematische Aufgaben bewältigen, einschließlich Arbeiten im Bereich der theoretischen Physik an der Grenze.
Gemeinsam ermöglichen diese Fähigkeiten ML4 eine starke Forschungsassistentin im gesamten technischen Workflow – von der ersten Frage bis zum endgültigen Ergebnis.
SciCode-Verified testet die Fähigkeiten von Modellen, um komplexe wissenschaftliche Workflows in Code für Bereiche wie Physik, Mathematik, Materialwissenschaften und Biologie umzusetzen.
Interne Evaluierung auf STEM-Aufgaben (Mathematik und Physik) von ML4 gegenüber GLM5.3
Wissensarbeit
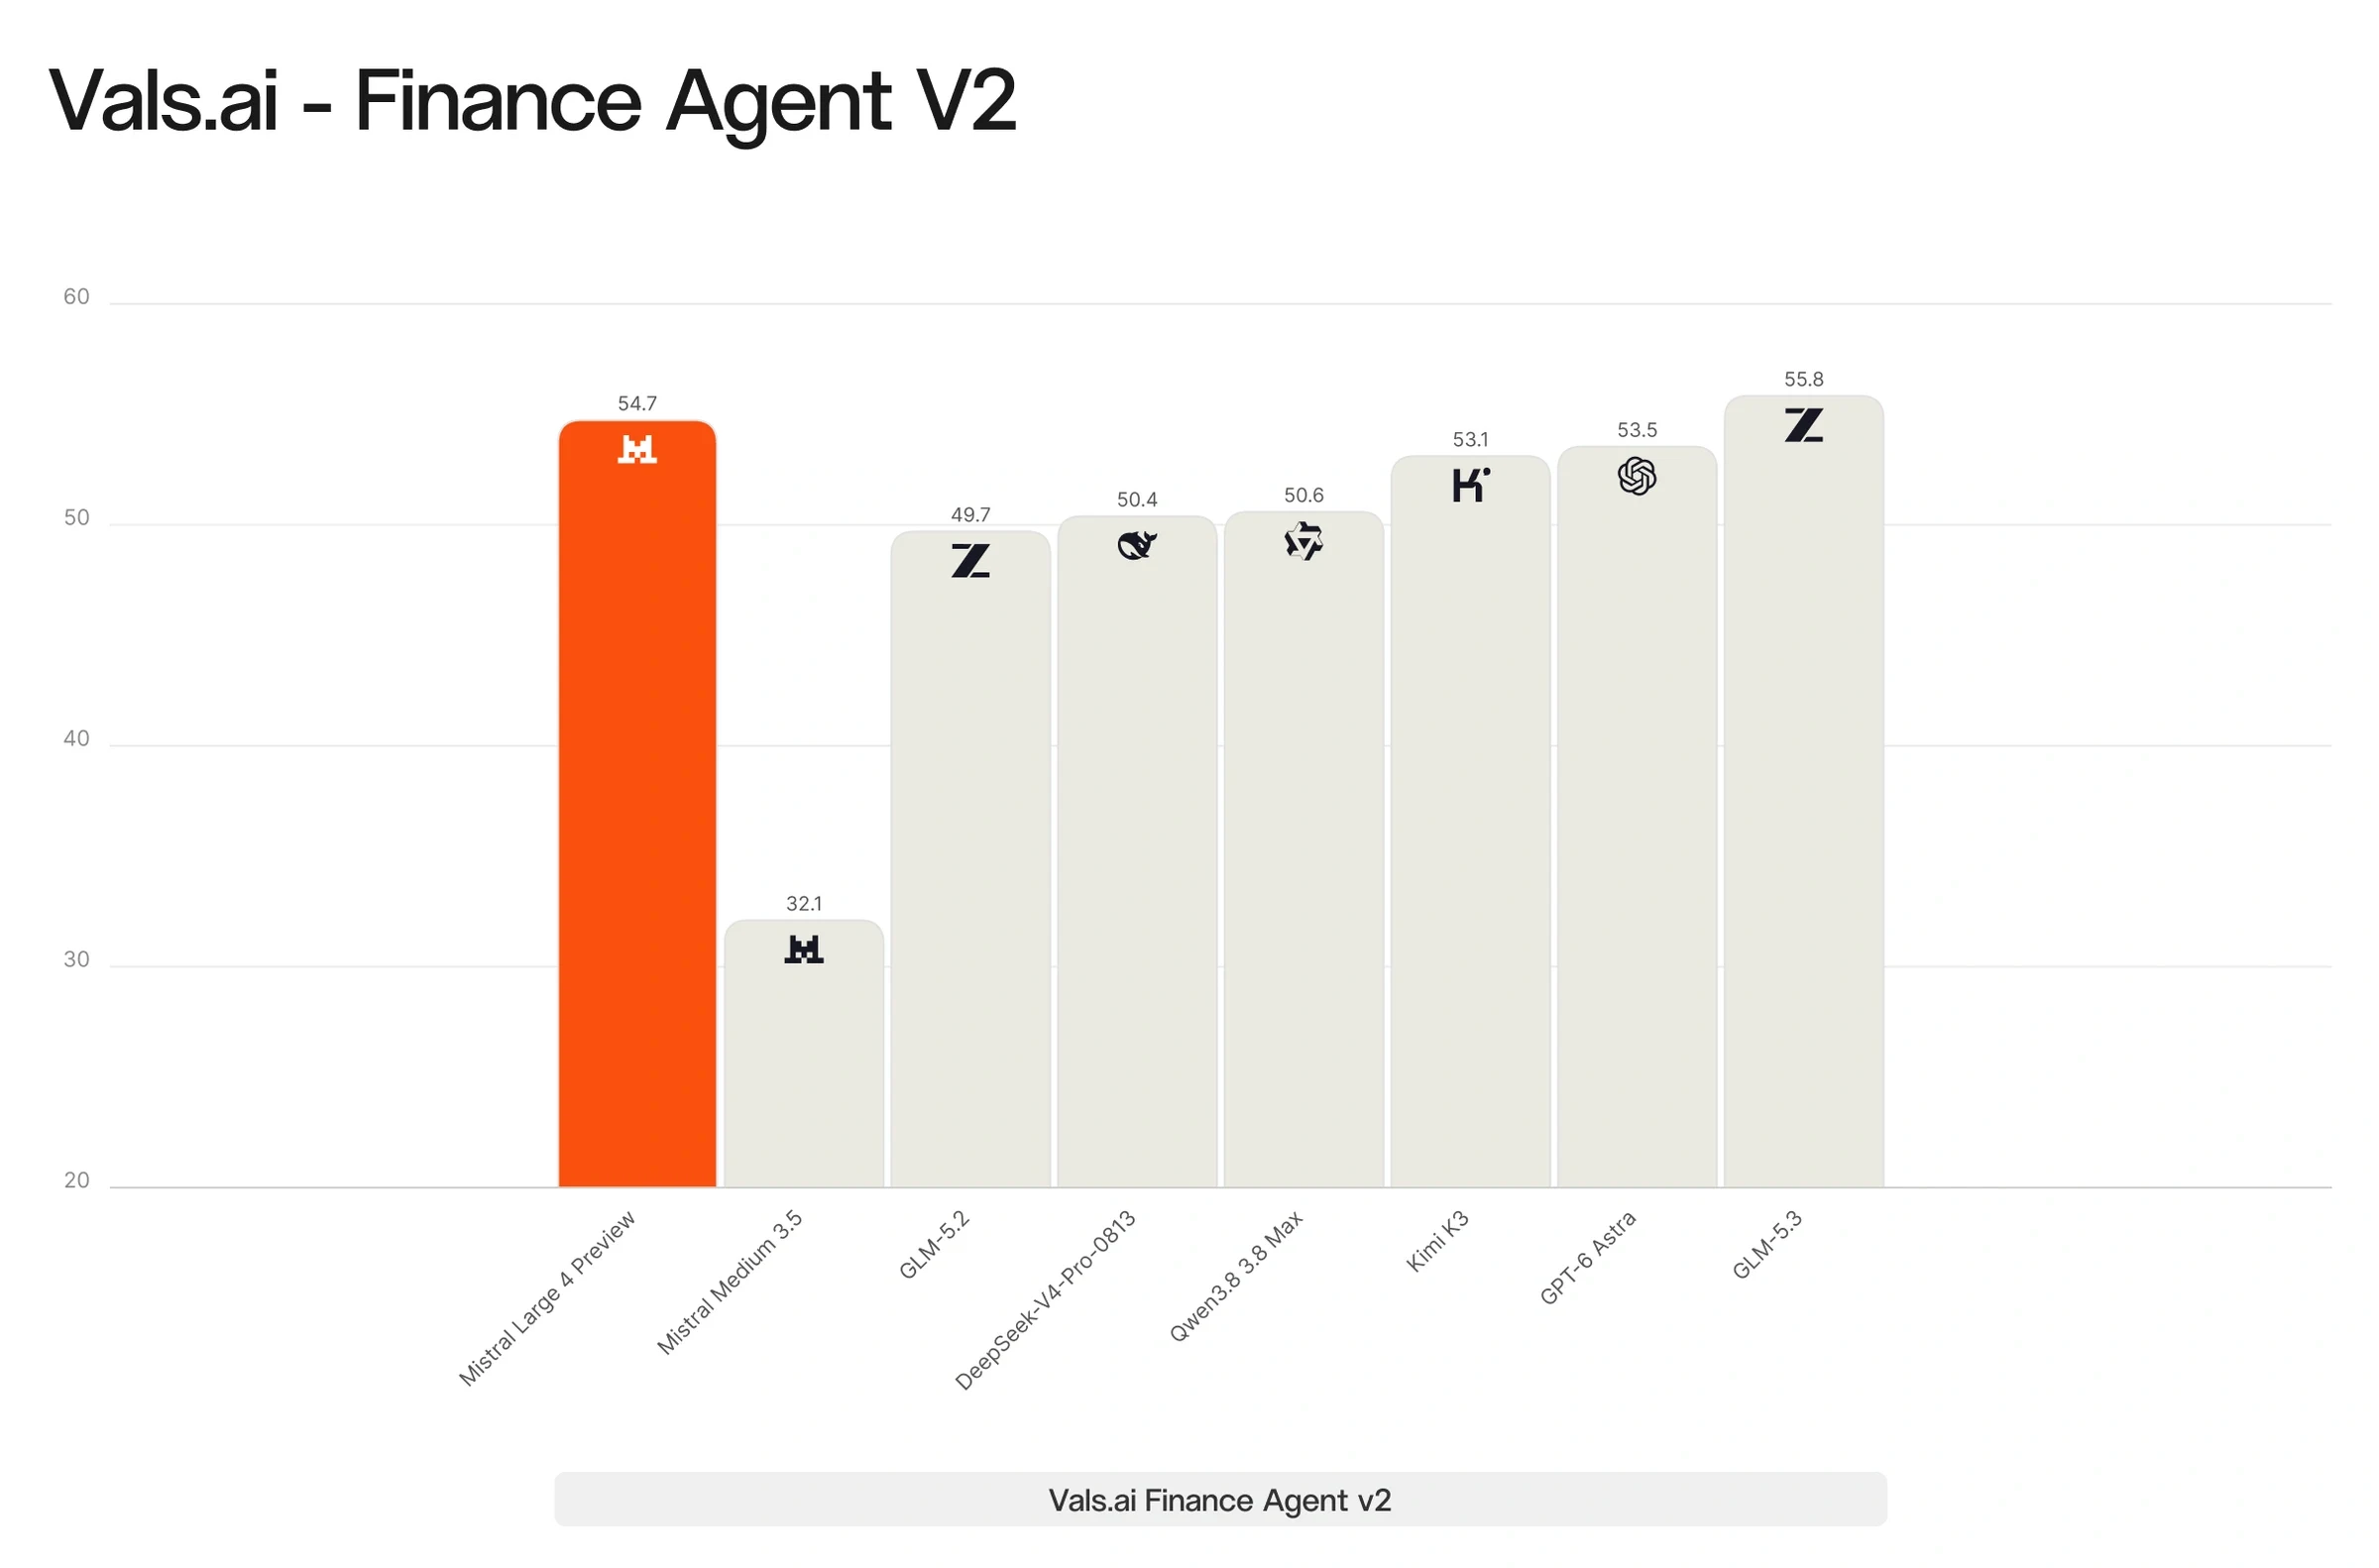
ML4 ist unser leistungsstärkstes Modell für die in der Realwelt durch Fachleute erledigten Aufgaben. Es kann komplexe Tabellen und Dokumente erstellen, bearbeiten und korrigieren, und zeigt hervorragende Leistungen sowohl bei rechtlichen als auch bei finanziellen Kriterien.
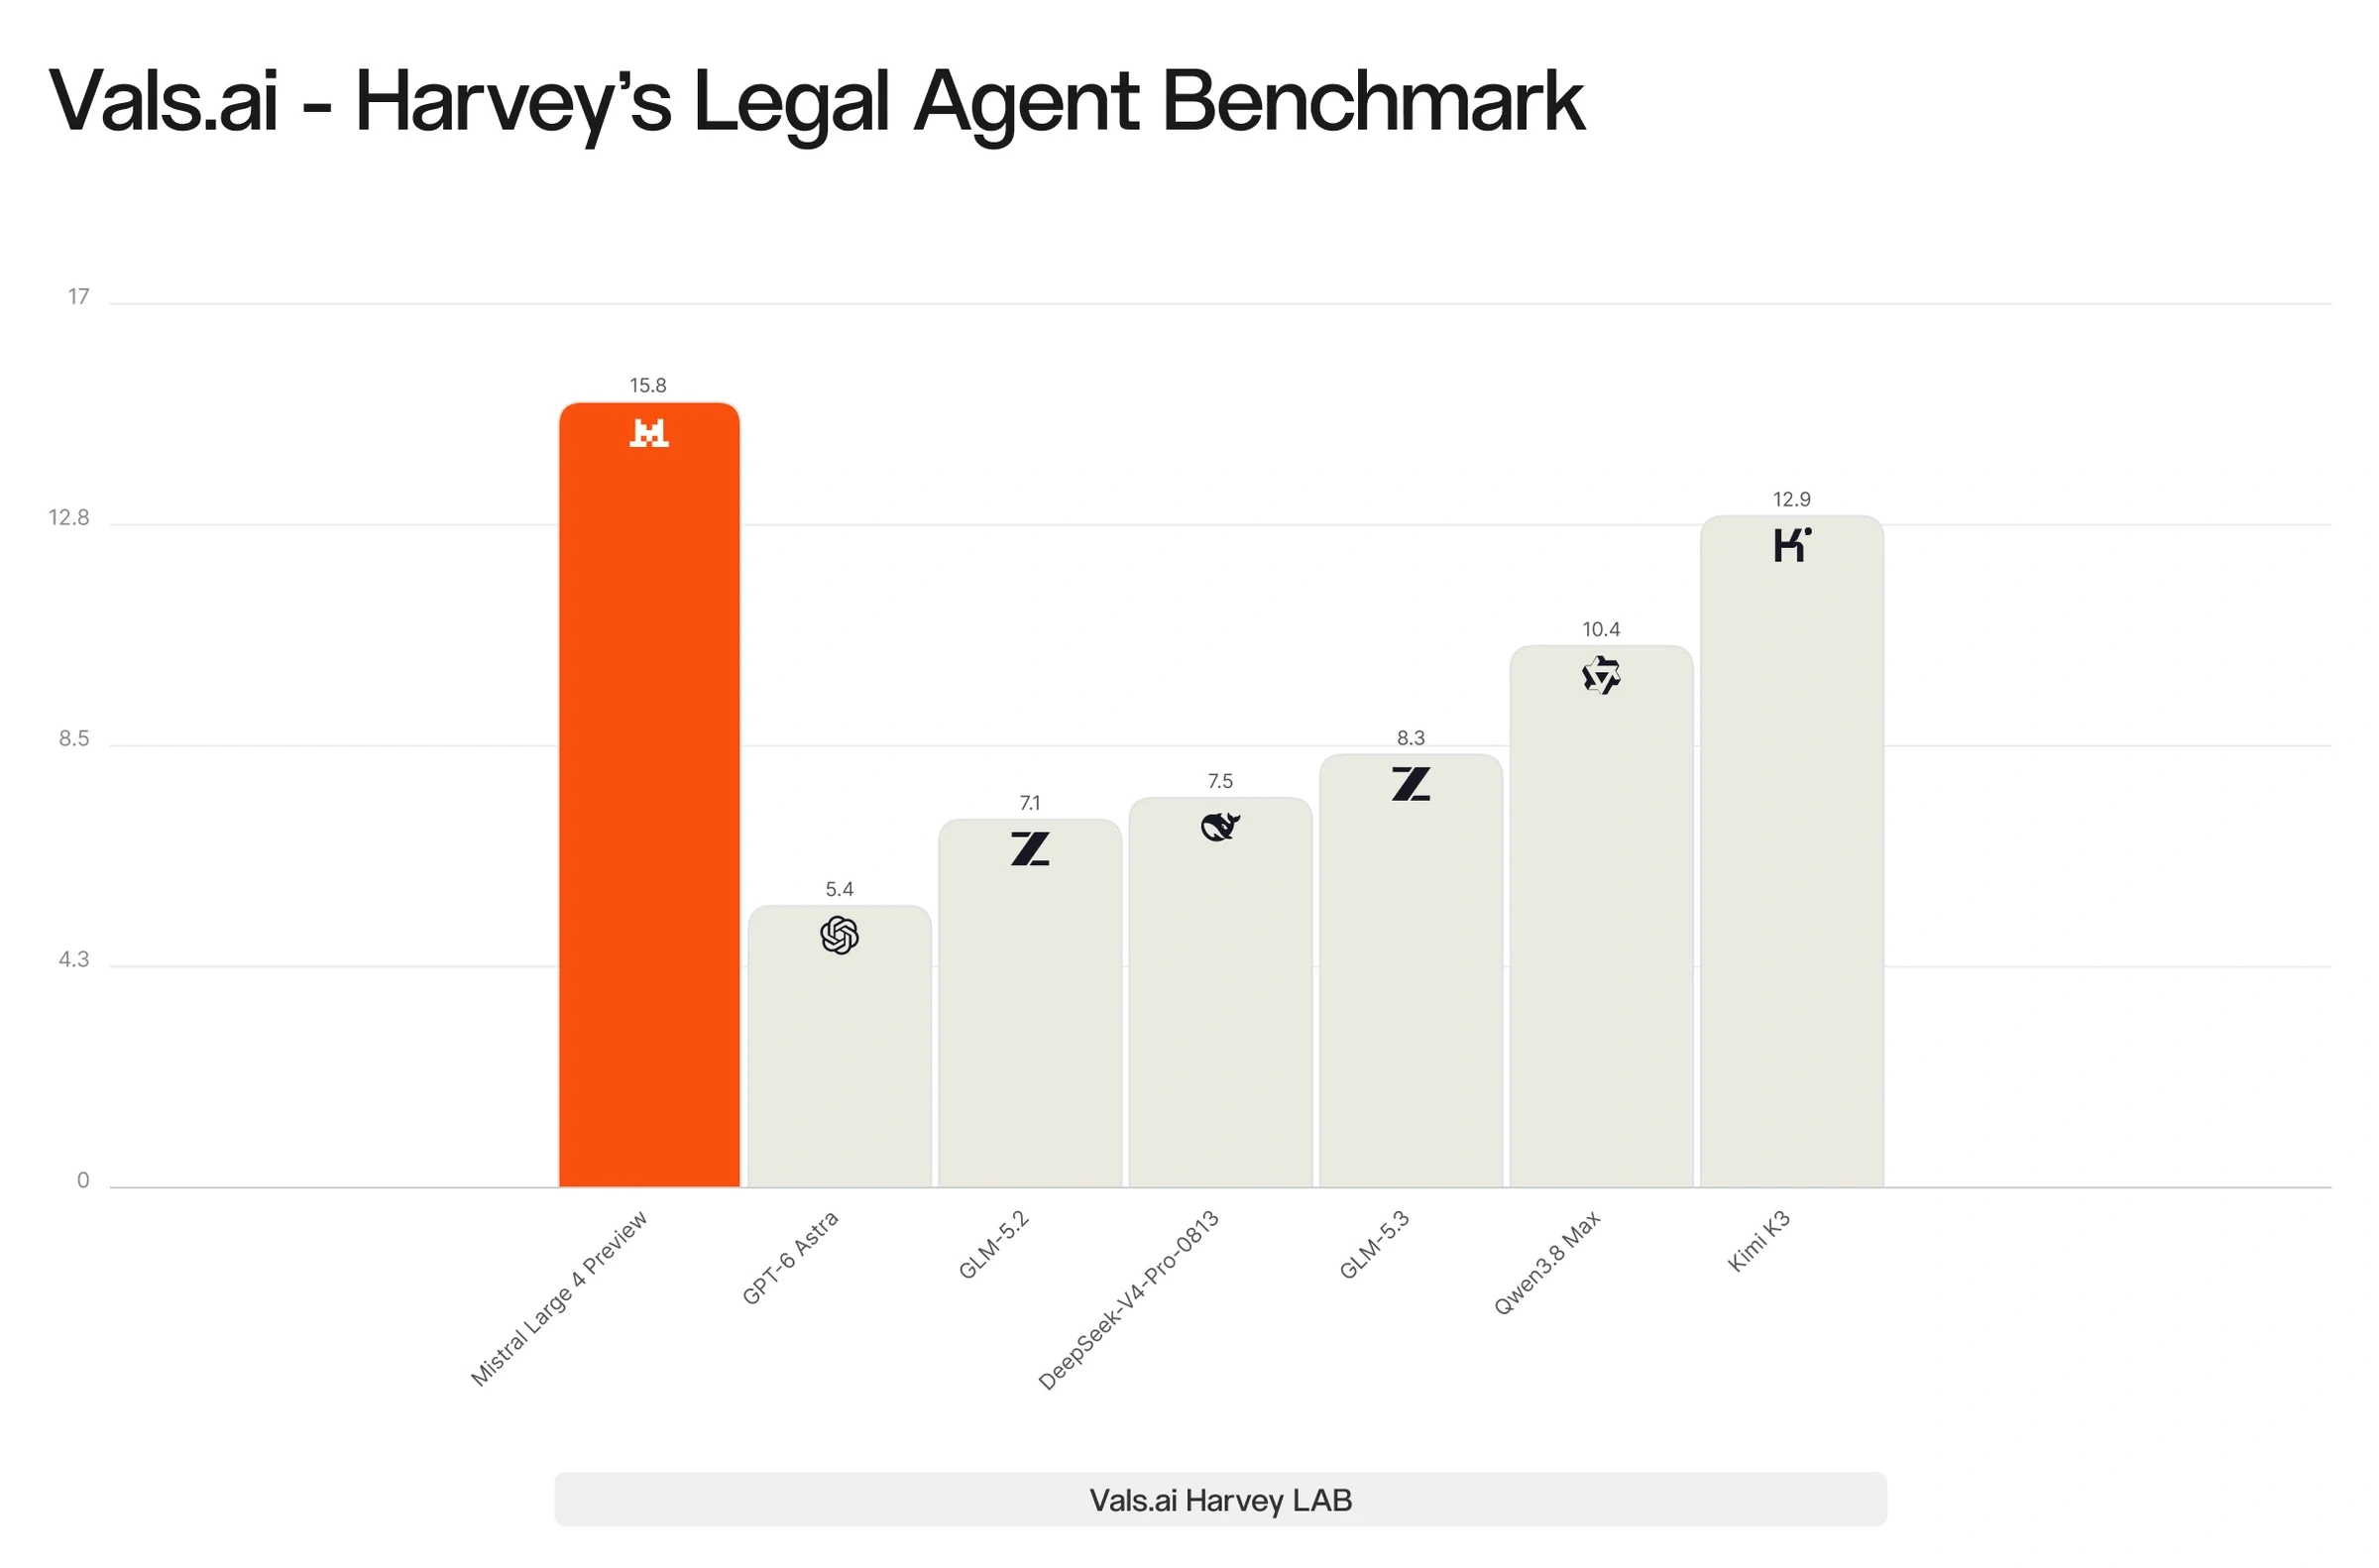
Besonders ist, dass wir ML4 durch Drittexperten (vals.ai) bei repräsentativen Aufgaben sowohl im juristischen als auch im finanziellen Bereich bewerteten und festgestellt haben, dass das Modell in beiden Fällen dem GPT-6-Astra übertrifft. Bei der Benchmark „Legal Agent“ von HarveyAI übertrifft ML4 alle Open-Source-Modelle.
FinWorkBench testet die Funktionalität des Modells bei der Erstellung und Bearbeitung von Tabellenkalkulationen in realen Finanz- und Buchhaltungsanwendungen.
Finanzanalyse erfordert Präzision und die Fähigkeit, Informationen aus verschiedenen Quellen zu synthetisieren – ein Prozess, der heutzutage bei vielen Finanzinstituten zeitaufwendig bleibt. In dieser Demonstration übernehmen ML4 und Mistral Medium 3.5 die gleiche mehrstufige Unternehmensfinanzaufgabe: Sie durchsuchen öffentliche Unternehmensunterlagen und Finanzberichte, wie z. B. die, die über EDGAR und vergleichbare europäische Datenbanken verfügbar sind. Eine animierte semantische Karte zeigt den Weg jedes Modells zum Lösungsansatz und hebt alle auf dem Weg gesammelten Dokumente hervor. Die Position jeder Route spiegelt die gesammelten Beweise, die Ergebnisse der Berechnungen und die ungelösten Fragen wider. Zuschauer können verfolgen, wie die Untersuchungen sich entwickeln, und die unterschiedlichen Wege jedes Modells vor dem Eintreffen in die endgültige Antwort vergleichen.
Modell Sicherheit
ML4 hat unsere Benchmarks bezüglich der Robustheit gegen indirekte Prompt-Einbringungen erreicht und steht somit an der Spitze der OSS-Modelle (im Vergleich zu GLM-5.2, GLM-5.3, Kimi-K2.6, Kimi-K3 und DS-V4-Pro-0813). Im öffentlichen B3 AI Security Benchmark von Lakera widersteht ML4 93,3% der Angriffe – wir sehen keine höheren Ergebnisse bei den Konkurrenten.
ML4 interagiert auch verantwortungsvoller mit den Nutzern als alle unsere vorherigen Modelle. Wir heben unsere Ergebnisse auf dem KORA Benchmark hervor, wo ML4 erneut mit der höchsten gemessenen Punktzahl unter den OSS-Modellen liegt (1,691, wobei 2 das maximale Niveau darstellt und als „Exemplarisch“ bezeichnet wird).
Besonders relevant ist die Neigung des Modells, böswillige Anfragen im Bereich Cybersicherheit abzulehnen. Trotz der starken Leistung bei Cyber-Benchmarks ist die durchschnittliche Ablehnungsrate des Models bei cyberbasierten Anfragen von JailbreakBench, StrongREJECT und AgentHarm höher als bei allen OSS-Modellen.
Menschliche Bewertung
Wir führten eine interne Bewertung durch, bei der Experten annotierende Mitarbeiter aus den Bereichen Programmierung, computerunterstütztes Design (CAD), Finanzen, Mathematik und Physik den Mistral Large 4 mit GLM-5.3 verglichen. Im CAD und in den STEM-Bereichen wurde ML4 bevorzugt, während er in den Finanzen und der Programmierung auf gleichem oder nahezu dem von GLM-5.3 Niveau war.
Skalierbares Reinforcement Learning
Die Grundmodelle verbessern sich schnell, und unser Post-Training muss mit dem gleichziehen. Ein Rezept, das für das vergangene Modell angepasst wurde, lässt die Fähigkeiten bei der heutigen Grenze zurück, weil die ursprünglichen Ground-Truth-Samples, die einst das Modell auf seine Grenzen brachten, nicht mehr vorhanden sind. Wir verwenden Verstärkungslernen (RL), weil es sich wie das Modell anpasst: Wir trainieren auf den Ergebnissen der eigenen Versuche des Modells und können die Schwierigkeit sowie die Breite der Aufgaben erhöhen, je stärker es wird.
Unsere RL-Bibliothek wurde entwickelt, um die Hinzufügung neuer Umgebungen sowie die Ausführung von Trainings in großem Maßstab zu erleichtern. Eine gemeinsame, komponierbare Schnittstelle ermöglicht es, bei einer einzigen Trainingsrunde Aufgaben von einzelnen Gesprächen bis hin zu komplexen wissenschaftlichen Problemlösungen sowie Sicherheitsanpassungen, Wahrheitlichkeit und langfristiger Toolnutzung zu kombinieren. Diese Umgebungen teilen Schutzräume und Ressourcen wie Code-Sandboxes, Web-Suche und externe APIs. Die gleiche Komponierbarkeit erstreckt sich auch auf die Überprüfung, wobei Belohnungsmodelle, Unit-Tests, LLM-Judge-Software und statische Prüfungen je nach Aufgabe gegebenenfalls kombiniert werden.
Beim Ausführen wird eine Autoskalierungseinheit von Akteuren Hunderttausende paralleler Rollouts erzeugen, während das Modelltraining asynchron stattfindet. Der Generierungs- und Trainingsprozess ist für lange Trajektorien optimiert, was es ermöglicht, Budgets von Millionen von Tokens über mehrere Compactions zu verwalten, während die Verwirrung niedrig bleibt. Neue Methoden und Optimierungen in beiden Phasen minimieren den Off-Policy-Drift und ermöglichen eine stabile RL über lange Horizonte.
Bei unserer aktuellen Größe (3k GPUs) erzeugt eine einzige Trainingsrunde etwa 33 Milliarden Tokens pro Tag, von denen etwa 16 Milliarden trainierbare Komplettierungstoken Nach der Filterung und Maskierung können wir den Laufverlauf direkt in den Trainingsprotokollen sehen: Die Trainingsbelohnungen steigen in mehreren repräsentativen Umgebungen, während die Policy lernt, immer komplexere Aufgaben zu lösen. Unten sind einige Beispiele aufgeführt.
Die Verbesserungen sind nicht spezifisch für die Umgebungen, auf denen wir trainiert haben; sie übertragen sich auf die nachfolgenden Tests, und das endgültige Modell ist dafür in beiden Nachtrainingsphasen (supervisiertes Fine-Tuning und RL) verantwortlich, wie in den Diagrammen gezeigt wird.
Was kommt als Nächstes
Dies ist nur der Anfang. ML4 ist das erste Meilenstein auf dem Roadmap, der mit unserem 3 Milliarden Euro umfassenden Series D-Fonds finanziert wird – der größten Kapitalrunde, die je von einem europäischen Technologieunternehmen eingeworben wurde. Dieses Kapital wird bereits eingesetzt: Wir erweitern unsere Rechenkapazität in unseren eigenen europäischen Datenzentren erheblich, und in den kommenden Monaten werden noch viel mehr online gehen.
Mehr Rechenleistung bedeutet mehr Training. Der Reinforcement-Learning-Prozess hinter dieser Vorhersage ist noch im Gange, und das Modell zeigt keine Anzeichen von Überlastung – es gibt weiterhin viel Raum für Verbesserungen. Wenn wir das Training auf unserer erweiterten Infrastruktur ausweiten, erwarten wir in den kommenden Wochen und Monaten große und schnelle Verbesserungen.
Wir werden die Gewichte Ende des Monats veröffentlichen, zusammen mit weiteren Details zur Architektur, zusätzlichen Benchmarkdaten und unserer nachtrainingsorientierten Methode. Und ML4 ist nur die Grundlage: Sie wird als Basis für eine neue Generation spezialisierter und optimierter Mistral-Modelle dienen, die für die Branchen und Arbeitslasten entwickelt werden, die unsere Kunden am meisten schätzen.
Der Fortschrittsrhythmus von hier aus wird schnell sein. Bleiben Sie auf dem Laufenden.
Mistral Large 4
Neues
Open-gewichtiges Hybrid-MoE mit multimodalem Eingang; vereint Anweisungen, Rätsellösung und agentische Fähigkeiten in einem einzigen Modell – am neuesten Stand der Technik bei Open-Weights im Bereich Cybersicherheit, Finanzen und Produktionierung. Nativ fließend in 160+ Sprachen.
Multimodales
Rechnung
Kodierung
Agentisches
Cybersecurity
Eingabe (/M-Token)
$1.36
Output (/M Tokens)
$4.18
Lesen Sie mehr